Экспорт Rockchip RKNN
RKNN — формат моделей для NPU в процессорах Rockchip, таких как RK3588 и RK3566. Экспорт модели Ultralytics YOLO26 с помощью format="rknn" создает каталог yolo26n_rknn_model/, в котором находится файл .rknn, собранный для одного чипа Rockchip. Чип выбирается аргументом name; доступна точность FP16 или INT8.
Краткий обзор#
| Свойство | Описание |
|---|---|
Аргумент format | rknn |
| Результат | yolo26n_rknn_model/ — каталог с yolo26n-rk3588.rknn и metadata.yaml; при экспорте моделей обнаружения, сегментации, позы и OBB в INT8 добавляется tail.onnx |
| Поддерживаемые устройства | NPU одного чипа Rockchip для каждого экспорта: RK3588, RK3576, RK3566, RK3568, RK3562, RK2118, RV1126B, RV1103, RV1106, RV1103B или RV1106B; см. целевые чипы |
| Среда выполнения | RKNN Toolkit Lite2 (пакет Python rknn-toolkit-lite2) на устройстве Rockchip |
| Точность | FP16 (по умолчанию) и INT8; INT8 доступен только на RV1103, RV1106, RV1103B и RV1106B. Экспорт в FP32 не поддерживается. Модель YOLO26n для RK3588 занимает 7,4 МБ в FP16 и 4,3 МБ в INT8. |
| Среда для экспорта | Linux x86-64 с Python 3.12 или более ранней версией. Выполни экспорт на ПК и скопируй экспортированный каталог на устройство Rockchip. |
Ultralytics Platform может экспортировать обученную модель в RKNN для выбранного тобой чипа Rockchip, поэтому локальная среда для экспорта не нужна.
Быстрый старт#
Установи пакет Ultralytics в отдельную виртуальную среду на компьютере с Linux x86-64 вместе с версиями protobuf и numpy, которые требуются RKNN Toolkit:
pip install ultralytics "protobuf<7" "numpy<2.4"При первом экспорте устанавливаются onnx, onnxslim, onnxruntime и rknn-toolkit2 с зависимостями, если они отсутствуют. В обычной среде pip install ultralytics первый экспорт также заменяет numpy, protobuf и setuptools, если их версии не входят в указанные ниже диапазоны, поэтому используй отдельную среду. Если требуется заменить protobuf или numpy, экспорт завершается с ошибкой, а следующий запуск в новом процессе проходит успешно. Для экспорта требуются следующие версии:
| Пакет | Требуемая версия |
|---|---|
| Python | 3.12 или более ранняя версия — самая новая версия, для которой rknn-toolkit2 2.3.2 имеет сборки |
rknn-toolkit2 | 2.3.2 — единственный выпуск на PyPI в требуемом диапазоне (2.3.2 или новее, но ниже 2.5) |
onnx | 1.16.1 или новее, но ниже 1.19.0 |
numpy | ниже 2.4 |
protobuf | ниже 7 |
setuptools | ниже 82 |
Другие способы установки описаны в руководстве по установке. Затем экспортируй модель на ПК, скопируй экспортированный каталог на устройство Rockchip и загрузи его там, чтобы запустить инференс или проверить точность.
from ultralytics import YOLO

# Загрузи модель YOLO26
model = YOLO("yolo26n.pt")

# Экспортируй модель в формат RKNN для RK3588 с точностью FP16
model.export(format="rknn", name="rk3588")  # creates 'yolo26n_rknn_model/'

# Или экспортируй квантованную модель RKNN в INT8, указав данные калибровки
model.export(format="rknn", name="rk3588", quantize=8, data="coco8.yaml")  # creates 'yolo26n_rknn_model/'
Оба экспорта записывают данные в один и тот же каталог yolo26n_rknn_model/, поэтому второй заменяет первый. Predict и Validate запускаются только на устройстве Rockchip:
from ultralytics import YOLO

# Загрузи экспортированную модель RKNN на устройстве Rockchip
model = YOLO("yolo26n_rknn_model")

# Выполнить инференс
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Загрузи экспортированную модель RKNN на устройстве Rockchip
model = YOLO("yolo26n_rknn_model")
# Проверить точность на наборе данных COCO8
metrics = model.val(data="coco8.yaml")Поддерживаемые задачи#
Экспорт RKNN поддерживает все семь задач Ultralytics для моделей YOLOv8, YOLO11 и YOLO26: обнаружение объектов, сегментацию, семантическую сегментацию, оценку глубины, классификацию, оценку позы и OBB. Семантическая сегментация и оценка глубины доступны только в YOLO26 — единственном семействе с такими головами.
Аргументы экспорта#
| Аргумент | Тип | По умолчанию | Описание |
|---|---|---|---|
format | str | 'rknn' | Целевой формат экспортируемой модели, определяющий совместимость с различными средами развертывания. |
name | str | 'rk3588' | Чип Rockchip, для которого собирается модель; регистр букв не важен. См. целевые чипы. |
imgsz | int или tuple | 640 | Размер входного изображения модели: целое число для квадратных изображений или кортеж (height, width). Если значение не задано, при экспорте используется размер, на котором обучалась контрольная точка. В официальных контрольных точках YOLO26 используется 640 для моделей обнаружения, сегментации и позы, а также для семантических моделей, предобученных на ADE20K; 1024 — для моделей OBB и семантических моделей, предобученных на Cityscapes; 768 — для оценки глубины; 224 — для классификации. |
quantize | int или str | None | Точность: значение 16 или отсутствие значения создает модель FP16, а 8 создает модель INT8 с калибровкой на data. Для чипов, поддерживающих только INT8, отсутствие значения включает INT8, а 16 вызывает ошибку. 32 вызывает ошибку; контрольную точку, обученную с quantize=8, нельзя экспортировать в RKNN. См. ограничения и устранение неполадок. Заменяет устаревшие флаги half/int8. |
data | str | None | YAML-файл датасета для калибровки INT8; для классификации вместо него укажи каталог датасета или встроенное название датасета. Для калибровки используется раздел val, если не задан split. Если quantize=8 не указан, Ultralytics использует небольшой датасет по умолчанию для задачи модели, например coco8.yaml для обнаружения объектов. |
fraction | float, int или list | 1.0 | Подмножество для калибровки: доля, количество изображений (целые числа больше 1) или список [train, val, test]; в последнем случае используется запись для разбиения калибровки. |
batch | int | 1 | Размер пакета экспортированной модели, фиксированный во входной форме. |
simplify | bool | True | Упрощает промежуточный граф ONNX с помощью onnxslim. |
opset | int | None | Версия ONNX opset промежуточного графа ONNX. Если значение не задано, используется 19, а более высокие значения снижаются до 19. |
nms | bool, необязательно | None | Модели RKNN всегда возвращают исходные предсказания для внешнего NMS. Голова без NMS (False) и встроенный NMS (True) недоступны; см. ограничения и устранение неполадок. |
device | str | None | Устройство для трассировки промежуточного графа ONNX: cpu (по умолчанию) или 0 для GPU CUDA. |
Аргументы, общие для всех форматов, описаны в документации по режиму экспорта.
Целевые чипы#
Файл .rknn собирается для одного чипа, который выбирается с помощью name. Размеры указаны для модели обнаружения YOLO26n, экспортированной с imgsz=640, если quantize не задан:
name | Точность | При отсутствии quantize создается | Файл YOLO26n | Размер |
|---|---|---|---|---|
rk3588 | FP16, INT8 | FP16 | yolo26n-rk3588.rknn | 7.4 MB |
rk3576 | FP16, INT8 | FP16 | yolo26n-rk3576.rknn | 10.5 MB |
rk3566 | FP16, INT8 | FP16 | yolo26n-rk3566.rknn | 6.8 MB |
rk3568 | FP16, INT8 | FP16 | yolo26n-rk3568.rknn | 6.8 MB |
rk3562 | FP16, INT8 | FP16 | yolo26n-rk3562.rknn | 6.8 MB |
rk2118 | FP16, INT8 | FP16 | yolo26n-rk2118.rknn | 6.8 MB |
rv1126b | FP16, INT8 | FP16 | yolo26n-rv1126b.rknn | 7.1 MB |
rv1103 | INT8 | INT8 | yolo26n-rv1103.rknn | 4.2 MB |
rv1106 | INT8 | INT8 | yolo26n-rv1106.rknn | 4.2 MB |
rv1103b | INT8 | INT8 | yolo26n-rv1103b.rknn | 4.2 MB |
rv1106b | INT8 | INT8 | yolo26n-rv1106b.rknn | 4.2 MB |
Для четырех чипов, поддерживающих только INT8, калибровка выполняется на наборе coco8.yaml по умолчанию из этой таблицы; при экспорте также записывается tail.onnx.
Квантование#
quantize задает точность файла .rknn. Размеры указаны для экспорта с imgsz=640 и batch=1:
quantize | Точность | Данные калибровки | Файлы для YOLO26n и rk3588 | Размер |
|---|---|---|---|---|
не задано или 16 | FP16 | Нет | yolo26n-rk3588.rknn | 7.4 MB |
8 | INT8 | Да | yolo26n-rk3588.rknn и tail.onnx | 4,3 МБ и 0,2 МБ |
- FP16: точность по умолчанию для семи чипов, которые ее поддерживают. Данные калибровки не нужны.
- INT8:
quantize=8прогоняет изображения для калибровки через модель и сохраняет веса и активации в виде 8-битных целых чисел. Экспорт выполняет калибровку на разбиенииvalнабораdataили на разбиении, заданном черезsplit, и выводит предупреждение, если изображений меньше 300. Используйfraction, чтобы ограничить количество изображений. - Смешанная точность: на семи чипах с поддержкой FP16 при экспорте в INT8 RKNN Toolkit оставляет некоторые слои в FP16, если квантование слишком сильно меняет их выходные данные (
auto_hybrid). На четырех чипах, поддерживающих только INT8, этот этап пропускается. - Голова обнаружения: для моделей обнаружения, сегментации, позы и OBB файл
.rknnв INT8 заканчивается на выходных сверточных слоях головы. Операции декодирования этих выходов в рамки сохраняются вtail.onnxи выполняются на CPU устройства с плавающей точкой, потому что INT8 с масштабированием на тензор не может представить значения в диапазоне пикселей, необходимые для декодирования рамок. - Модели глубины: при экспорте моделей глубины в INT8 для калибровки используются изображения набора данных глубины, к которым приложены карты глубины. Выбирай изображения для калибровки, охватывающие ближний и дальний диапазоны глубины в сцене развертывания. При использовании набора
depth8.yamlпо умолчанию, содержащего 4 проверочных изображения, модель YOLO26n-depth INT8 в симуляторе rknn-toolkit2 вернула глубину до 3,9 для уличного изображения, тогда как модель FP16 вернула значение до 13,9. - Проверка на устройстве: экспорты INT8 для всех задач запускались в симуляторе rknn-toolkit2 и сравнивались с моделью ONNX на одном изображении. Их точность не измерялась на наборе данных или оборудовании Rockchip, поэтому перед развертыванием проверь модель INT8 на своем устройстве и собственных данных.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# Выполнить калибровку на 10% валидационных изображений COCO (500 изображений); замени coco.yaml на собственный датасет
model.export(format="rknn", name="rk3588", quantize=8, data="coco.yaml", fraction=0.1)
Формат вывода#
При экспорте создается один каталог:
| Файл | Содержимое |
|---|---|
yolo26n-rk3588.rknn | Модель; чип, заданный через name, указан в имени файла |
tail.onnx | Только для моделей обнаружения, сегментации, позы и OBB в INT8: операции декодирования выходов головы в исходные предсказания, выполняемые на CPU |
metadata.yaml | Названия классов, задача, размер изображения, размер пакета, шаг и аргументы экспорта, которые Ultralytics считывает при загрузке модели |
Промежуточный файл yolo26n.onnx остается рядом с каталогом. Модель .rknn принимает один вход с формой (batch, height, width, 3): RGB, каналы в последнем измерении (NHWC), uint8 со значениями от 0 до 255. Деление на 255 встроено в модель, поэтому не масштабируй изображение самостоятельно. Это отличается от экспорта ONNX, который принимает изображения с каналами в первом измерении float32, масштабированные в диапазон 0–1.
Выходы зависят от задачи и точности. Ниже указаны формы для официальных контрольных точек YOLO26n при размере экспорта по умолчанию; для семантической сегментации используется контрольная точка Cityscapes yolo26n-sem.pt:
| Задача | imgsz по умолчанию | Выход FP16 и выход tail.onnx для INT8 | Выход .rknn в INT8 |
|---|---|---|---|
| Обнаружение | 640 | (1, 84, 8400) | 6 тензоров головы, декодируемых с помощью tail.onnx |
| Сегментация | 640 | (1, 116, 8400) и (1, 32, 160, 160) | 9 тензоров головы и (1, 32, 160, 160), декодируемые с помощью tail.onnx |
| Семантическая | 1024 | (1, 19, 1024, 1024): оценка для каждого класса и пикселя | Как для FP16 |
| Глубина | 768 | (1, 1, 768, 768): карта глубины | Как для FP16 |
| Классификация | 224 | (1, 1000): вероятности классов | Как для FP16 |
| Поза | 640 | (1, 56, 8400) | 9 тензоров головы, декодируемых с помощью tail.onnx |
| OBB | 1024 | (1, 20, 21504) | 9 тензоров головы, декодируемых с помощью tail.onnx |
- Исходные предсказания: модели FP16 и
tail.onnxдля моделей INT8 возвращают те же исходные предсказания, что и экспорт ONNX по умолчанию: для каждого якоря — центр рамки по x, центр по y, ширина и высота в пикселях входного изображения, затем оценки классов, затем значения задачи (32 коэффициента маски, 17 × 3 значения ключевых точек или угол OBB в радианах). Примени NMS самостоятельно. Формат выходных данных для каждой задачи см. в разделе формат выходных данных ONNX. - Тензоры головы INT8: модель обнаружения INT8 возвращает по два тензора для каждого из трех масштабов обнаружения — один со значениями рамок, другой с оценками классов; модели сегментации, позы и OBB возвращают по одному дополнительному тензору на масштаб со значениями соответствующей задачи. Передай их в
tail.onnxв порядке, в котором модель их возвращает; модель сегментации также передает прототипы масок черезtail.onnxбез изменений. - Семантическая сегментация: выход содержит оценку для каждого класса и пикселя, а не карту классов, как при экспорте ONNX, поэтому вычисли argmax по оси классов в своем коде.
- NMS: выход без NMS и выход со встроенным NMS недоступны; см. ограничения и устранение неполадок.
YOLO("yolo26n_rknn_model") считывает структуру из metadata.yaml, запускает tail.onnx и применяет NMS, поэтому эти детали нужны только при запуске модели в собственном коде. Ключи metadata.yaml включают names, task, imgsz, stride, batch, end2end, args и, для моделей позы, kpt_shape.
Запуск с RKNN Toolkit Lite2#
Чтобы запускать модель на устройстве вне пакета Ultralytics, загрузи ее с помощью пакета rknn-toolkit-lite2. Для модели обнаружения, сегментации, позы или OBB в INT8 передай ее выходы в tail.onnx, используя ONNX Runtime:
# Сначала выполни экспорт: yolo export model=yolo26n.pt format=rknn name=rk3588 quantize=8 data=coco8.yaml
import numpy as np
import onnxruntime as ort
from rknnlite.api import RKNNLite

rknn = RKNNLite()
assert rknn.load_rknn("yolo26n_rknn_model/yolo26n-rk3588.rknn") == 0
assert rknn.init_runtime() == 0

image = np.zeros((1, 640, 640, 3), dtype=np.uint8)  # изображение с добавленными полями: RGB, NHWC, 0–255
outputs = rknn.inference(inputs=[image])  # шесть тензоров головы для модели обнаружения INT8

tail = ort.InferenceSession("yolo26n_rknn_model/tail.onnx", providers=["CPUExecutionProvider"])
feed = {t.name: x.astype(np.float32) for t, x in zip(tail.get_inputs(), outputs)}
predictions = tail.run(None, feed)[0]  # форма (1, 84, 8400), исходные предсказания, для которых требуется NMS
assert predictions.shape == (1, 84, 8400), "export a detection model at imgsz=640 with quantize=8"
Размер пакета tail.onnx всегда равен 1 независимо от значения экспорта batch, поэтому для модели, экспортированной с большим размером пакета, запускай ее отдельно для каждого изображения. У модели FP16 нет tail.onnx, а outputs[0] уже содержит исходные предсказания.
Разверни#
На устройстве Rockchip установи пакет с помощью pip install ultralytics и скопируй на него каталог yolo26n_rknn_model/; версии protobuf и numpy из краткого руководства нужны только для экспорта. Затем YOLO("yolo26n_rknn_model") запускает модель на NPU с помощью пакета Python rknn-toolkit-lite2, который Ultralytics устанавливает при первом использовании вместе с onnxruntime, если в каталоге есть файл tail.onnx. На устройстве должна быть установлена Python 3.12 или более ранняя версия — самая новая версия, для которой rknn-toolkit-lite2 имеет сборки.
- Требуется устройство Rockchip: Ultralytics загружает модель RKNN только на 64-разрядных системах Linux ARM, в дереве устройств которых строка
compatibleзаканчивается одним из поддерживаемых названий чипов. Во всех остальных случаях загрузка завершается ошибкой; см. ограничения и устранение неполадок. Уrknn-toolkit-lite2также есть сборки только для 64-разрядного Linux ARM, поэтому на целевой системе, не отвечающей этим условиям, запусти файл.rknnчерез C API Rockchip и запускайtail.onnxлибо реализуй такое же декодирование в собственном коде. - Соответствие чипа: при экспорте укажи
nameчипа, установленного на плате. - Фиксированная входная форма: модель всегда запускается с параметрами экспорта
imgszиbatch, которые Ultralytics считывает изmetadata.yaml. Значениеimgsz, переданное вpredictилиval, игнорируется. Пакеты большего размера разбиваются на части размером с пакет экспорта, а меньшие дополняются, поэтому можно обрабатывать любое количество изображений. device: устройство выбирать не нужно. Модель.rknnработает через среду выполнения RKNN, аtail.onnxзапускается на CPU с помощью ONNX Runtime.
Предыдущую версию этого процесса проверяли на Radxa Rock 5B (RK3588) и Radxa Zero 3W (RK3566). Текущий экспорт INT8 еще не запускали на оборудовании.
Руководства по развертыванию#
- Настройка платы: сначала установи операционную систему, как описано в руководствах по началу работы для Radxa Rock 5B и Radxa Zero 3W.
- RKNN Toolkit2 на GitHub: инструментарий преобразования, среда выполнения RKNN Toolkit Lite2 и библиотека среды выполнения
librknnrt.soс C API. - RKNN Model Zoo: примеры развертывания Rockchip на C и Python.
- Развертывание Ultralytics YOLO на Rockchip: обзор процесса в блоге Ultralytics.
- Варианты развертывания моделей: сравнение RKNN с другими форматами экспорта.
Ограничения и устранение неполадок#
-
Компьютер для экспорта: выполняй экспорт на компьютере с Linux x86-64. На macOS экспорт не может установить
rknn-toolkit2и завершается с ошибкойNo module named 'rknn'; для пакета нет сборок под macOS или Windows. Экспорт на Linux ARM64, в том числе на платах Rockchip, не проверялся и не поддерживается: Ultralytics тестирует экспорт RKNN только на Linux x86-64. -
Версия Python: для
rknn-toolkit22.3.2 есть сборки под Python 3.12 и более ранние версии. Если у тебя более новая версия Python, создай среду с Python 3.12. -
Первый экспорт в новой среде: если в среде нет версий
protobufиnumpyиз краткого руководства, во время первого экспорта эти пакеты заменяются, и экспорт завершается с ошибкой. Если заменяетсяprotobuf7, который pip устанавливает вместе сonnx, возникает ошибкаAttributeError: 'google._upb._message.FieldDescriptor' object has no attribute 'label'; если заменяется толькоnumpy, возникает ошибкаTypeError: only 0-dimensional arrays can be converted to Python scalars. Запусти экспорт повторно в новом процессе (в ноутбуке для этого перезапусти ядро) или установи"protobuf<7" "numpy<2.4"перед первым экспортом, как описано в кратком руководстве. -
Модели RKNN не запускаются на ПК: предсказание или проверка с помощью
YOLO("yolo26n_rknn_model")завершается ошибкойRKNN inference is only supported on Rockchip devices.на ПК и на плате, строка/proc/device-tree/compatibleкоторой не заканчивается одним из поддерживаемых названий чипов. Выведи эту строку с помощьюcat /proc/device-tree/compatible. -
FP32:
quantize=32завершается с ошибкойquantize=32 (FP32) is not supported; format='rknn' supports quantize=16 (FP16), 8 (INT8). -
Чипы, поддерживающие только INT8: для
rv1103,rv1106,rv1103bиrv1106bэкспорт безquantizeвыводитRockchip target 'rv1106' requires INT8 quantization, enabling it.и создает модель INT8, аquantize=16завершается с ошибкойRockchip target 'rv1106' only supports INT8, but got quantize=16. -
Отсутствующий или неверный
name: если не указанname, при экспорте выводитсяRockchip RKNN export requires a missing 'name' arg for processor type. Using default name='rk3588'.. Неизвестное значение приводит к ошибкеInvalid processor name 'rk9999' for Rockchip RKNN export., после которой выводятся допустимые названия. -
Голова без NMS: модели RKNN всегда возвращают исходные предсказания, для которых требуется NMS. При значении
nms=Falseэкспорт модели YOLO26 или YOLOv10 выводитThis export format does not support end2end models, disabling the end2end branch.и использует голову «один ко многим»; для других моделей обнаружения, сегментации, позы и OBB, например YOLO11, выводитсяThis model has no one-to-one head; using one-to-many outputs.. Классификация, семантическая сегментация и модели глубины игнорируютnms=False. -
Встроенный NMS:
nms=Trueвыводитformat=rknn does not support embedded NMS; exporting native outputs for external NMS.и записывает исходный выход. -
Контрольные точки, обученные с
quantize=8: контрольная точка, дообученная с помощью обучения с учетом квантования, завершается с ошибкойformat='rknn' cannot export a QAT model: its Q/DQ ranges are only read by the 'onnx' and 'engine' backends. Вместо нее экспортируй контрольную точку, от которой ты начал дообучение, указавquantize=8. -
RT-DETR: с
rknn-toolkit22.3.2 экспорт модели RT-DETR завершается ошибкой внутри Toolkit и при FP16, и при INT8 дляrtdetr-l.ptна этапеimgsz=640сValueError: operands could not be broadcast together with shapes (256,256) (8400,1). -
Фиксированная входная форма:
dynamic=Trueзавершается с ошибкойargument 'dynamic' is not supported for format='rknn'. Повтори экспорт, чтобы изменить размер изображения или размер пакета. -
Калибровка без
data: экспорт модели обнаружения вquantize=8выводитINT8 export requires a missing 'data' arg for calibration. Using default 'data=coco8.yaml'.и выполняет калибровку на этом небольшом наборе данных; для остальных задач указываются их собственные наборы данных по умолчанию. Передайdataс изображениями, которые представляют данные для развертывания. -
Размер калибровочного набора: если в разбиении для калибровки меньше 300 изображений, при экспорте выводится
>300 images recommended for INT8 calibration, found 4 images.. Вcoco8.yamlвсего 4 проверочных изображения: их достаточно, чтобы проверить экспорт, но недостаточно для калибровки модели перед развертыванием. -
Каталог выходных данных: каждый экспорт одной контрольной точки записывает данные в один и тот же каталог
yolo26n_rknn_model/независимо от значенийname,quantize,imgszиbatch; перед этим предыдущее содержимое удаляется. Перед экспортом для второго чипа или другой точности переименуй каталог и оставь в его имени_rknn_model, напримерyolo26n_rk3566_rknn_model/, поскольку Ultralytics распознает формат по этой части имени. -
Опсет ONNX: опсет
opsetвыше 19 записывает в журналrknn-toolkit2 requires opset<=19, setting opset=19. -
Модели INT8 из более ранних версий: повторно экспортируй модели детекции, сегментации, поз и OBB в INT8, экспортированные до версии
ultralytics8.4.191, в которой появилась поддержкаtail.onnx. Эти модели возвращают координаты рамок и ключевых точек относительно размера входных данных, а текущие версии больше не масштабируют их, поэтому модели загружаются без ошибки, но возвращают неправильные рамки. -
Несовпадение версий среды выполнения: если в журнале устройства указано, что версия среды выполнения RKNN не совпадает с версией RKNN Toolkit, и инференс завершается с ошибкой, замени
/usr/lib/librknnrt.soофициальным файломlibrknnrt.so.
Другие ошибки описаны в руководстве по распространённым проблемам.
Бенчмарки#
Приведенные ниже тесты производительности YOLO26 команда Ultralytics провела на Radxa Rock 5B с Rockchip RK3588, используя формат модели rknn для измерения скорости и точности.
| Модель | Формат | Точность | Статус | Размер (МБ) | mAP50-95(B) | Время инференса (мс/изобр.) |
|---|---|---|---|---|---|---|
| YOLO26n | rknn | FP16 | ✅ | 7.2 | 0.477 | 58.5 |
| YOLO26n | rknn | INT8 | ✅ | 4.1 | 0.463 | 41.2 |
| YOLO26s | rknn | FP16 | ✅ | 21.0 | 0.569 | 93.8 |
| YOLO26s | rknn | INT8 | ✅ | 12.0 | 0.554 | 61.9 |
| YOLO26m | rknn | FP16 | ✅ | 43.0 | 0.608 | 226.3 |
| YOLO26m | rknn | INT8 | ✅ | 22.0 | 0.603 | 122.0 |
| YOLO26l | rknn | FP16 | ✅ | 53.0 | 0.628 | 264.7 |
| YOLO26l | rknn | INT8 | ✅ | 28.0 | 0.617 | 145.3 |
| YOLO26x | rknn | FP16 | ✅ | 113.0 | 0.664 | 655.4 |
| YOLO26x | rknn | INT8 | ✅ | 58.0 | 0.649 | 287.4 |
Проверено с помощью ultralytics 8.4.60
Валидация приведенных выше бенчмарков выполнялась на наборе данных COCO128. Время инференса не включает предварительную и последующую обработку. Значения INT8 будут обновлены после проверки текущего пути экспорта INT8 (декодирование на хосте и auto_hybrid) на оборудовании Rockchip.
Размеры в таблице указаны для той более ранней версии; размеры в остальных разделах этой страницы — это размер файла .rknn при текущем экспорте, в МБ (10^6 байт). На странице моделей YOLO26 указана точность контрольных точек PyTorch на полном проверочном наборе COCO.
О RKNN#
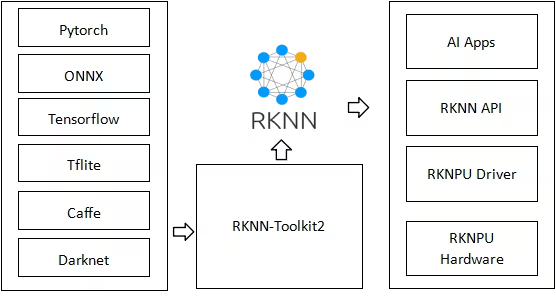
Rockchip разрабатывает однокристальные системы на базе ARM со встроенными NPU. Они используются в одноплатных компьютерах и встраиваемых устройствах таких компаний, как Radxa, ASUS, Pine64, Orange Pi, Odroid, Khadas и Banana Pi. RKNN, сокращение от Rockchip Neural Network, — это формат моделей для этих NPU, а RKNN Toolkit преобразует модели в этот формат на ПК и запускает их на устройстве.
Часто задаваемые вопросы#
Используй название процессора на плате, а не название самой платы: например,
rk3588для Radxa Rock 5B илиrk3566для Radxa Zero 3W. На платеcat /proc/device-tree/compatibleвыводит строку, по которой Ultralytics определяет чип. Модель, экспортированная для одного чипа, не подходит для другого, поэтому экспортируй модель отдельно для каждого чипа. Допустимые названия смотри в разделе Target Chips.Начни с FP16 — это значение по умолчанию. Для него не нужны калибровочные данные, и он возвращает исходные предсказания без дополнительной модели на CPU. Выбирай INT8 (
quantize=8), если нужна более компактная и быстрая модель или если чип поддерживает только INT8: YOLO26n для RK3588 занимает 4.3 МБ в INT8 против 7.4 МБ в FP16, а в результатах тестирования, полученных с более ранним экспортом, YOLO26n в INT8 обрабатывала одно изображение за 41.2 мс против 58.5 мс в FP16. Для INT8 нужны репрезентативные калибровочные данные, а для моделей детекции, сегментации, поз и OBB декодирование рамок выполняется на CPU с помощьюtail.onnx. Прежде чем выбирать, измерь задержку и точность на своём устройстве.Нет,
YOLO()загружает модели RKNN только на устройствах Rockchip. Чтобы проверить саму модель на ПК, проверь контрольную точку PyTorch или промежуточный файлyolo26n.onnx, который экспорт сохраняет рядом с каталогом, с помощью ONNX Runtime: модель RKNN преобразуется из этого графа. Такая проверка не заменяет проверку на устройстве, особенно для INT8, поскольку квантование меняет выходные данные.Да, используй формат экспорта для соответствующего ускорителя: модель RKNN работает только на NPU Rockchip. См. TensorRT для NVIDIA Jetson, Hailo, Axelera, DeepX и Coral Edge TPU или ознакомься с обзором в руководстве по вариантам развёртывания моделей.


Комментарии45
Задай вопрос, поделись результатами или помоги кому-нибудь.
as-jackson
We are pleased to confirm that the following ArmSoM boards based on Rockchip RK3576 have been successfully tested with Ultralytics projects (e.g., YOLO11n):
Validation Scope:
Model training/inference pipeline
1yizi72
I tried to convert the yolo11n.pt into a rknn model through codes below: from ultralytics import YOLO model = YOLO("yolo11n.pt") model.export(format="rknn", name="rk3588") and everything went correct. A rknn model named yolo11n-rk3588.rknn was build and used to infer a very traditional yolo demo image "bus"(a blue bus with several people in front of it), but no detection result was obtained.
I tried to convert the yolol11n.pt into onnx model through above codes firstly, and then used a convert.py offered by rknn_model_zoo/examples/yolo11/python,
import sys from rknn.api import RKNN
DATASET_PATH = '../../../datasets/COCO/coco_subset_20.txt' DEFAULT_RKNN_PATH = '/home/yizi/model/yolo11/yolodet.rknn' DEFAULT_QUANT = False
def parse_arg(): if len(sys.argv) < 3: print("Usage: python3 {} onnx_model_path [platform] [dtype(optional)] [output_rknn_path(optional)]".format(sys.argv[0])) print(" platform choose from [rk3562,rk3566,rk3568,rk3588,rk3576,rk1808,rv1109,rv1126]") print(" dtype choose from [i8, fp] for [rk3562,rk3566,rk3568,rk3588,rk3576]") print(" dtype choose from [u8, fp] for [rk1808,rv1109,rv1126]") exit(1)
model_path = sys.argv[1]
platform = sys.argv[2]

do_quant = DEFAULT_QUANT
if len(sys.argv) > 3:
    model_type = sys.argv[3]
    if model_type not in ['i8', 'u8', 'fp']:
        print("ERROR: Invalid model type: {}".format(model_type))
        exit(1)
    elif model_type in ['i8', 'u8']:
        do_quant = True
    else:
        do_quant = False

if len(sys.argv) > 4:
    output_path = sys.argv[4]
else:
    output_path = DEFAULT_RKNN_PATH

return model_path, platform, do_quant, output_path
if name == 'main': model_path, platform, do_quant, output_path = parse_arg()
# Create RKNN object
rknn = RKNN(verbose=False)

# Pre-process config
print('--> Config model')
rknn.config(mean_values=[[0, 0, 0]], std_values=[[255, 255, 255]], target_platform=platform)
print('done')

# Load model
print('--> Loading model')
ret = rknn.load_onnx(model=model_path)
if ret != 0:
    print('Load model failed!')
    exit(ret)
print('done')

# Build model
print('--> Building model')
ret = rknn.build(do_quantization=do_quant, dataset=DATASET_PATH)
if ret != 0:
    print('Build model failed!')
    exit(ret)
print('done')

# Export rknn model
print('--> Export rknn model')
ret = rknn.export_rknn(output_path)
if ret != 0:
    print('Export rknn model failed!')
    exit(ret)
print('done')

# Release
rknn.release()
Still everything went correct. A rknn model was created and applied to "bus.jpg", and there was no detection at all. I wonder what's wrong in the whole process?
1 Glenn JocherUltralytics
@yizi72 thanks for the detailed report. For RKNN inference issues with YOLO11, please ensure:
- You're using matching RKNN Toolkit and runtime versions (update both if needed)
- Input images are 640x640 with pixel values normalized 0-255
- You load models via
YOLO('./yolo11n_rknn_model')as shown in our RKNN deployment docs
If issues persist, please share your full environment details and validation results from both export methods.
1、I used rknn-toolkit2-2.3.0 which is the latest version ,bu I still did "pip install rknn-toolkit2 --upgrade" again. 2、The input image is 640*640, uchar, 0-255. 3. I used the following setting to transfer yolo11n.pt to onnx, from ultralytics import YOLO
加载一个模型,路径为 YOLO 模型的 .pt 文件
model = YOLO("yolo11n.pt")
导出模型,设置多种参数
model.export( format="onnx", imgsz=(640, 640),
keras=False,
optimize=True,
half=False,
int8=False,
dynamic=False,
simplify=True,
opset=12,
#workspace=4.0,
nms=False,
batch=1
) and applied the following codes to verify yolo11n.onnx model:from ultralytics import YOLO from PIL import Image
Load a model
model = YOLO("/home/yizi/models/yolo11/yolo11n.onnx") # load an official model
Predict with the model
results = model("bus.jpg") # predict on an image #results = rknn_model("bus.jpg")
Access the results
for result in results: xywh = result.boxes.xywh # center-x, center-y, width, height xywhn = result.boxes.xywhn # normalized xyxy = result.boxes.xyxy # top-left-x, top-left-y, bottom-right-x, bottom-right-y xyxyn = result.boxes.xyxyn # normalized names = [result.names[cls.item()] for cls in result.boxes.cls.int()] # class name of each box confs = result.boxes.conf # confidence score of each box
The results are good. All objects in bus.jpg were detected. Then I run the following code to transfer onnx to rknn:
from rknn.api import RKNN import cv2 import numpy as np
if name == 'main': rknn = RKNN(verbose=True,verbose_file="log.txt") rknn.config( mean_values=[[0, 0, 0]], std_values=[[255, 255, 255]], target_platform="rk3588", optimization_level=3 )
rknn.load_onnx(
    model="/home/yizi/models/yolo11/yolo11n.onnx",
    input_size_list=[[1,3,640,640]],
)
rknn.build(
    do_quantization=False
)

rknn.export_rknn(
    export_path="/home/yizi/models/yolo11/yolo11n.rknn"
)

rknn.release()
The transferring process went smooth, two problems appeared.
Firstly,when this rknn model was pushed into a rk3588 tablet, and run with a binary executable file generated by cross-compilation, no result was detected.
Secondly, I tried to run the following codes:
from ultralytics import YOLO from PIL import Image
rknn_model = YOLO("/home/yizi/models/yolo11/yolo11n.rknn", task=detect)
results = model("bus.jpg")
An error message, "model='/home/yizi/models/yolo11/yolo11n.rknn' is not a supported model format. Ultralytics supports: ('PyTorch', 'TorchScript', 'ONNX', 'OpenVINO', 'TensorRT', 'CoreML', 'TensorFlow SavedModel', 'TensorFlow GraphDef', 'TensorFlow Lite', 'TensorFlow Edge TPU', 'TensorFlow.js', 'PaddlePaddle', 'MNN', 'NCNN', 'IMX', 'RKNN') See https://docs.ultralytics.com/modes/predict for help. " appeared.
Last question, how many outputs does yolo11 yield? one or six?
- Glenn JocherUltralytics
@yizi72 thank you for the detailed report. For RKNN deployment issues:
- When using Ultralytics RKNN export, load models via the exported directory (not .rknn file), as shown in our RKNN deployment docs:
model = YOLO('./yolo11n_rknn_model') # directory path-
Ensure your RK3588 runtime uses matching librknnrt.so versions with your RKNN Toolkit 2.3.0 installation
-
YOLO11 detection models output 3 tensors by default (different from older YOLO versions). For conversion issues, we recommend using our native
model.export(format='rknn')rather than manual ONNX conversion.
Let me know if you still face issues after verifying these points.
Thanks for replies. I did verify all points you've mentioned above. When running model("bus.jpg"), error messages show:
File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/ultralytics/engine/model.py", line 182, in call return self.predict(source, stream, **kwargs) File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/ultralytics/engine/model.py", line 543, in predict self.predictor.setup_model(model=self.model, verbose=is_cli) File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/ultralytics/engine/predictor.py", line 378, in setup_model self.model = AutoBackend( File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/torch/utils/_contextlib.py", line 116, in decorate_context return func(*args, **kwargs) File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/ultralytics/nn/autobackend.py", line 495, in init raise OSError("RKNN inference is only supported on Rockchip devices.") OSError: RKNN inference is only supported on Rockchip devices.
It's very strange because I did connect a RK3588 tablet with my virtual machine.
I still have a quesiton on yolo11n output: yolo11n.pt has one output with shape (1, 84, 8400), and yolo11n-rk3588.rknn has one output with shape (1,84, 8400, 0). Are they correct? If so, can I use the similar codes to analyze rknn output, such as :
for result in results: xywh = result.boxes.xywh # center-x, center-y, width, height xywhn = result.boxes.xywhn # normalized xyxy = result.boxes.xyxy # top-left-x, top-left-y, bottom-right-x, bottom-right-y xyxyn = result.boxes.xyxyn # normalized names = [result.names[cls.item()] for cls in result.boxes.cls.int()] # class name of each box confs = result.boxes.conf
- Glenn JocherUltralytics
@yizi72 thanks for the details. For the RKNN inference error: ensure your Python script is running directly on the RK3588 hardware (not through a VM) as RKNN models require native Rockchip NPU access. Regarding outputs, YOLO11 detection models produce 3 output tensors by default (see our RKNN deployment docs), but your code should work if using the exported RKNN directory with the included postprocessing. Let me know if you still face issues after verifying native hardware execution.
 Yufeng Wu
Hello, Ultralytics team. I wonder if it's possible to port yolo26n-pose to rknn? I'm not sure if it's difficult to work out on my own? Is there any model architecture problems that prevent porting the pose models to rknn?
- Glenn JocherUltralytics
@kamosmkey exports fine. See https://platform.ultralytics.com/glenn-jocher/example-project/exp-24?tab=export
2
montemadjo
It appears it does not support rv1106 platform yet
When I try to export the model using this command
model.export(format="rknn", name="rv1106", imgsz=320)It gives the following error
E build: Current target_platform(rv1106) not support do_quantization = False!
E export_rknn: RKNN model does not exist, please load & build model first!
🤔
- Glenn JocherUltralytics(изменено)
rv1106is an INT8-only target, so it needs a quantized RKNN build. Older Ultralytics releases always built withdo_quantization=False, which fails with the message you saw. Current releases support it: upgrade withpip install -U ultralyticsand export withquantize=8plus calibration data:model.export(format="rknn", name="rv1106", imgsz=320, quantize=8, data="coco8.yaml")See the Rockchip RKNN export guide. If it still fails, share your
!yolo checksoutput andrknn-toolkit2version here and we can sanity-check the environment.1 Here's the quick workaround for those who want to work with yolo26 on RV1106 chip (like Luckfox pico etc). I ran into a couple of issues there, including quantization erasing my confidence results.
Long story short - first you need to monkey-patch head.Detect.forward function in order to get two tensors - one for bboxes and one for scores. That way you escape all the heavy non-supported tensor functions. Then you export your yolo26 model to onnx format and finally to rknn like this
import torch
from ultralytics.nn.modules import head

# 1. First we monkey-patch the forward function
def patched_forward(self, x):
    if self.end2end:
        h = self.one2one
    else:
        h = self.one2many

    box_head = h["box_head"]
    cls_head = h["cls_head"]

    if box_head is None or cls_head is None:
        raise RuntimeError("Head moduls are None")

    bs = x[0].shape[0]
    boxes = torch.cat([box_head[i](x[i]).view(bs, 4 * self.reg_max, -1) for i in range(self.nl)], dim=-1)
    scores = torch.cat([cls_head[i](x[i]).view(bs, self.nc, -1) for i in range(self.nl)], dim=-1)

    preds = {"boxes": boxes, "scores": scores, "feats": x}
    y = self._inference(preds)

    # We are splitting into 2 tensors - both gets its own scale/zp at INT8 quantization
    bboxes = y[:, :4, :]   # [1, 4, 2100] — range 0-640
    scores = y[:, 4:, :]   # [1, 1, 2100] — range 0-1 (already sigmoid-ed)
    score_max_idx = scores[0, 0, :].argmax()
    return bboxes, scores

head.Detect.forward = patched_forward

# 2. Then we export to onnx model (we got best.pt model from ultralytics platform)
from ultralytics import YOLO
model = YOLO("best.pt")
model.export(format="onnx", dynamic=False, opset=12, imgsz=320)

# 3. Then we export to RKNN format
from rknn.api import RKNN

rknn = RKNN()

# 3.1. Konfiguracija specifična za RV1106
rknn.config(
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
    target_platform='rv1106',
    quantized_algorithm='normal', # Ili 'mmse' za bolju preciznost
    quantized_dtype='asymmetric_quantized-8'
)

# 3.2. Load the ONNX model
print("Loading ONNX model...")
rknn.load_onnx(model='best.onnx')

# 3.3. Build modela sa INT8 kvantizacijom
# calib.txt should contain paths to calibration images
print("Building RKNN model with quantization...")
rknn.build(do_quantization=True, dataset='./calib.txt')

# 3.4. Exporting final .rknn file
print("Exporting RKNN model...")
rknn.export_rknn('./yolo26_rv1106_model_optimized.rknn')

rknn.release()
After this you need to postprocess those two outputs like this
yolo26_postprocess.h
/**
 * YOLO26 Post-processing header for Fish Counter
 *
 * Supports YOLO26 2-output format: boxes [1, 4, N] + scores [1, nc, N]
 *
 * Based on the working rknn_minimal_test example.
 */

#ifndef _YOLO26_POSTPROCESS_H_
#define _YOLO26_POSTPROCESS_H_

#include <stdint.h>
#include <vector>
#include "rknn_api.h"
#include "rknn_detector.h"

// YOLO26 model configuration defaults
#define YOLO26_CONF_THRESHOLD 0.25f
#define YOLO26_NMS_THRESHOLD 0.45f

// Detection result (same structure as postprocess.h for compatibility)
typedef struct
{
    float x1, y1, x2, y2; // Bounding box (in model coordinates)
    float confidence;
    int class_id;
} yolo26_detection_t;

// YOLO26 context for format detection and caching
typedef struct
{
    int num_predictions;
    int num_classes;
    bool boxes_transposed; // true = [1, 4, N], false = [1, N, 4]
} yolo26_context_t;

/**
 * Initialize YOLO26 post-processing
 * Detects the output format from model attributes
 *
 * @param app_ctx The RKNN app context with model info
 * @param yolo26_ctx Output: YOLO26 context for format info
 * @return 0 on success, -1 on error
 */
int yolo26_init_postprocess(rknn_app_context_t *app_ctx, yolo26_context_t *yolo26_ctx);

/**
 * Deinitialize YOLO26 post-processing
 */
void yolo26_deinit_postprocess();

/**
 * YOLO26 post_process: processes model outputs and returns detections
 * Uses 2-output format: boxes [1, 4, N] + scores [1, nc, N]
 *
 * @param app_ctx The RKNN app context
 * @param yolo26_ctx YOLO26 context from init
 * @param outputs Pointer to output tensor memory array
 * @param letter_box Letterbox transform info for coordinate mapping
 * @param conf_threshold Confidence threshold
 * @param nms_threshold NMS threshold
 * @param od_results Output: detection results (compatible with existing code)
 * @return 0 on success, -1 on error
 */
int yolo26_post_process(rknn_app_context_t *app_ctx, yolo26_context_t *yolo26_ctx,
                        void *outputs, letterbox_t *letter_box,
                        float conf_threshold, float nms_threshold,
                        object_detect_result_list *od_results);

#endif // _YOLO26_POSTPROCESS_H_
yolo26_postprocess.cc
/**
 * YOLO26 Post-processing for Fish Counter on RV1106
 *
 * Supports YOLO26 2-output format: boxes [1, 4, N] + scores [1, nc, N]
 *
 * Based on the working rknn_minimal_test example.
 */

#include "yolo26_postprocess.h"

#include <math.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <algorithm>
#include <vector>

// Clamp value to range
inline static int clamp(float val, int min, int max)
{
    return val > min ? (val < max ? val : max) : min;
}

// Dequantize INT8 to float
static inline float dequantize(int8_t qnt, int32_t zp, float scale)
{
    return ((float)qnt - (float)zp) * scale;
}

// Sigmoid function
static inline float sigmoid(float x)
{
    return 1.0f / (1.0f + expf(-x));
}

// Calculate IoU between two boxes
static float calculate_iou(float x1_a, float y1_a, float x2_a, float y2_a,
                           float x1_b, float y1_b, float x2_b, float y2_b)
{
    float x1 = std::max(x1_a, x1_b);
    float y1 = std::max(y1_a, y1_b);
    float x2 = std::min(x2_a, x2_b);
    float y2 = std::min(y2_a, y2_b);

    float inter_w = std::max(0.0f, x2 - x1);
    float inter_h = std::max(0.0f, y2 - y1);
    float inter_area = inter_w * inter_h;

    float area_a = (x2_a - x1_a) * (y2_a - y1_a);
    float area_b = (x2_b - x1_b) * (y2_b - y1_b);
    float union_area = area_a + area_b - inter_area;

    return union_area > 0 ? inter_area / union_area : 0;
}

// Non-Maximum Suppression for YOLO26 detections
static std::vector<yolo26_detection_t> yolo26_nms(std::vector<yolo26_detection_t> &detections, float nms_threshold)
{
    // Sort by confidence (descending)
    std::sort(detections.begin(), detections.end(),
              [](const yolo26_detection_t &a, const yolo26_detection_t &b)
              { return a.confidence > b.confidence; });

    std::vector<yolo26_detection_t> result;
    std::vector<bool> suppressed(detections.size(), false);

    for (size_t i = 0; i < detections.size(); i++)
    {
        if (suppressed[i])
            continue;

        result.push_back(detections[i]);

        for (size_t j = i + 1; j < detections.size(); j++)
        {
            if (suppressed[j])
                continue;

            // Only suppress same class
            if (detections[i].class_id != detections[j].class_id)
                continue;

            float iou = calculate_iou(
                detections[i].x1, detections[i].y1, detections[i].x2, detections[i].y2,
                detections[j].x1, detections[j].y1, detections[j].x2, detections[j].y2);

            if (iou > nms_threshold)
            {
                suppressed[j] = true;
            }
        }
    }

    return result;
}

// Parse YOLO26 2-output format: boxes [1, 4, N] + scores [1, nc, N]
static std::vector<yolo26_detection_t> parse_yolo26_2output(
    rknn_tensor_mem **output_mems,
    rknn_tensor_attr *output_attrs,
    int model_width, int model_height,
    float conf_threshold, int num_classes,
    bool boxes_transposed)
{
    std::vector<yolo26_detection_t> detections;

    int8_t *boxes_data = (int8_t *)output_mems[0]->virt_addr;
    int32_t boxes_zp = output_attrs[0].zp;
    float boxes_scale = output_attrs[0].scale;

    int8_t *scores_data = (int8_t *)output_mems[1]->virt_addr;
    int32_t scores_zp = output_attrs[1].zp;
    float scores_scale = output_attrs[1].scale;

    // Determine number of anchors
    int num_anchors;
    if (boxes_transposed)
    {
        num_anchors = output_attrs[0].dims[2];
    }
    else
    {
        num_anchors = output_attrs[0].dims[1];
    }

    // Check if scores are already sigmoid or logits
    float scores_min = 9999, scores_max = -9999;
    for (int i = 0; i < (int)output_attrs[1].n_elems; i++)
    {
        float val = dequantize(scores_data[i], scores_zp, scores_scale);
        if (val < scores_min)
            scores_min = val;
        if (val > scores_max)
            scores_max = val;
    }
    bool scores_are_sigmoid = (scores_min >= -0.1f && scores_max <= 1.1f);

    for (int i = 0; i < num_anchors; i++)
    {
        // Get box coordinates
        float x1, y1, x2, y2;
        if (boxes_transposed)
        {
            // [1, 4, N] - channel first
            x1 = dequantize(boxes_data[0 * num_anchors + i], boxes_zp, boxes_scale);
            y1 = dequantize(boxes_data[1 * num_anchors + i], boxes_zp, boxes_scale);
            x2 = dequantize(boxes_data[2 * num_anchors + i], boxes_zp, boxes_scale);
            y2 = dequantize(boxes_data[3 * num_anchors + i], boxes_zp, boxes_scale);
        }
        else
        {
            // [1, N, 4] - anchor first
            x1 = dequantize(boxes_data[i * 4 + 0], boxes_zp, boxes_scale);
            y1 = dequantize(boxes_data[i * 4 + 1], boxes_zp, boxes_scale);
            x2 = dequantize(boxes_data[i * 4 + 2], boxes_zp, boxes_scale);
            y2 = dequantize(boxes_data[i * 4 + 3], boxes_zp, boxes_scale);
        }

        // Check if format is xywh instead of xyxy
        if (x2 < x1 || y2 < y1)
        {
            // Assume xywh format: convert to xyxy
            float cx = x1, cy = y1, w = x2, h = y2;
            x1 = cx - w / 2.0f;
            y1 = cy - h / 2.0f;
            x2 = cx + w / 2.0f;
            y2 = cy + h / 2.0f;
        }

        // Find max class score
        float max_score = -9999;
        int max_class = 0;
        for (int c = 0; c < num_classes; c++)
        {
            float score;
            if (boxes_transposed)
            {
                // [1, nc, N]
                score = dequantize(scores_data[c * num_anchors + i], scores_zp, scores_scale);
            }
            else
            {
                // [1, N, nc]
                score = dequantize(scores_data[i * num_classes + c], scores_zp, scores_scale);
            }

            if (!scores_are_sigmoid)
            {
                score = sigmoid(score);
            }

            if (score > max_score)
            {
                max_score = score;
                max_class = c;
            }
        }

        if (max_score < conf_threshold)
            continue;

        // Clamp to model bounds
        x1 = std::max(0.0f, std::min(x1, (float)model_width));
        y1 = std::max(0.0f, std::min(y1, (float)model_height));
        x2 = std::max(0.0f, std::min(x2, (float)model_width));
        y2 = std::max(0.0f, std::min(y2, (float)model_height));

        // Skip invalid boxes
        if (x2 <= x1 || y2 <= y1)
            continue;

        yolo26_detection_t det;
        det.x1 = x1;
        det.y1 = y1;
        det.x2 = x2;
        det.y2 = y2;
        det.confidence = max_score;
        det.class_id = max_class;

        detections.push_back(det);
    }

    return detections;
}

int yolo26_init_postprocess(rknn_app_context_t *app_ctx, yolo26_context_t *yolo26_ctx)
{
    if (!app_ctx || !yolo26_ctx)
    {
        printf("[YOLO26] ERROR: Invalid parameters\n");
        return -1;
    }

    memset(yolo26_ctx, 0, sizeof(yolo26_context_t));

    int n_output = app_ctx->io_num.n_output;

    printf("[YOLO26] Initializing 2-output format (%d outputs)...\n", n_output);

    // Print output tensor info
    for (int i = 0; i < n_output; i++)
    {
        printf("  Output %d: dims=[%d,%d,%d,%d], size=%d\n", i,
               app_ctx->output_attrs[i].dims[0],
               app_ctx->output_attrs[i].dims[1],
               app_ctx->output_attrs[i].dims[2],
               app_ctx->output_attrs[i].dims[3],
               app_ctx->output_attrs[i].size);
    }

    if (n_output != 2)
    {
        printf("[YOLO26] ERROR: Expected 2 outputs (boxes + scores), got %d\n", n_output);
        return -1;
    }

    // Parse 2-output format: boxes + scores
    int boxes_dim1 = app_ctx->output_attrs[0].dims[1];
    int boxes_dim2 = app_ctx->output_attrs[0].dims[2];
    int scores_dim1 = app_ctx->output_attrs[1].dims[1];
    int scores_dim2 = app_ctx->output_attrs[1].dims[2];

    if (boxes_dim1 == 4)
    {
        // [1, 4, N] boxes format
        yolo26_ctx->num_predictions = boxes_dim2;
        yolo26_ctx->boxes_transposed = true;
        yolo26_ctx->num_classes = scores_dim1;
        printf("[YOLO26] Format: boxes [1,4,%d], scores [1,%d,%d]\n",
               boxes_dim2, scores_dim1, scores_dim2);
    }
    else if (boxes_dim2 == 4)
    {
        // [1, N, 4] boxes format
        yolo26_ctx->num_predictions = boxes_dim1;
        yolo26_ctx->boxes_transposed = false;
        yolo26_ctx->num_classes = scores_dim2;
        printf("[YOLO26] Format: boxes [1,%d,4], scores [1,%d,%d]\n",
               boxes_dim1, scores_dim1, scores_dim2);
    }
    else
    {
        printf("[YOLO26] ERROR: Invalid boxes dimensions [1,%d,%d], expected [1,4,N] or [1,N,4]\n",
               boxes_dim1, boxes_dim2);
        return -1;
    }

    printf("[YOLO26] Predictions: %d, Classes: %d\n",
           yolo26_ctx->num_predictions, yolo26_ctx->num_classes);

    return 0;
}

void yolo26_deinit_postprocess()
{
    // Nothing to cleanup currently
}

int yolo26_post_process(rknn_app_context_t *app_ctx, yolo26_context_t *yolo26_ctx,
                        void *outputs, letterbox_t *letter_box,
                        float conf_threshold, float nms_threshold,
                        object_detect_result_list *od_results)
{
    if (!app_ctx || !yolo26_ctx || !outputs || !letter_box || !od_results)
    {
        return -1;
    }

    rknn_tensor_mem **output_mems = (rknn_tensor_mem **)outputs;

    int model_width = app_ctx->model_width;
    int model_height = app_ctx->model_height;

    // Parse 2-output format
    std::vector<yolo26_detection_t> raw_detections = parse_yolo26_2output(
        output_mems,
        app_ctx->output_attrs,
        model_width, model_height,
        conf_threshold,
        yolo26_ctx->num_classes > 0 ? yolo26_ctx->num_classes : 1,
        yolo26_ctx->boxes_transposed);

    // Apply NMS
    std::vector<yolo26_detection_t> final_detections = yolo26_nms(raw_detections, nms_threshold);

    // Convert to output format with letterbox coordinate mapping
    memset(od_results, 0, sizeof(object_detect_result_list));
    int count = 0;

    for (const auto &det : final_detections)
    {
        if (count >= OBJ_NUMB_MAX_SIZE)
            break;

        // Map coordinates back to original image space
        float x1 = det.x1 - letter_box->x_pad;
        float y1 = det.y1 - letter_box->y_pad;
        float x2 = det.x2 - letter_box->x_pad;
        float y2 = det.y2 - letter_box->y_pad;

        // Scale back to original coordinates
        od_results->results[count].box.left = (int)(clamp(x1, 0, model_width) / letter_box->scale);
        od_results->results[count].box.top = (int)(clamp(y1, 0, model_height) / letter_box->scale);
        od_results->results[count].box.right = (int)(clamp(x2, 0, model_width) / letter_box->scale);
        od_results->results[count].box.bottom = (int)(clamp(y2, 0, model_height) / letter_box->scale);
        od_results->results[count].prop = det.confidence;
        od_results->results[count].cls_id = det.class_id;

        count++;
    }

    od_results->count = count;

    return 0;
}
And you're good to go! 🚀
- Glenn JocherUltralytics(изменено)
Thanks for sharing this—splitting the head into 2 outputs (boxes + scores) is a sensible RV1106 workaround to keep RKNN-friendly ops and avoid INT8 scale/zero-point coupling issues; just note that monkey-patching
head.Detect.forwardis inherently version-fragile. Current Ultralytics already provides an INT8 flow for RV1106 viaquantize=8withdata=calibration images (see the Rockchip RKNN export guide), so please try that first. If you still need your custom split, open a GitHub issue linking back to this thread and include!yolo checks, yourrknn-toolkit2version, and a minimal calibration set description so we can evaluate it.
dttvn0010
99ms per image is too bad. Using rknn native with 3 npu cores, I can achieve ~11ms per image
NikolayKash
Hi, what did you done to achieve this performance?
- Glenn JocherUltralytics
@Arshapjoy thanks for the detailed info; for YOLO11 detection heads the export output shape is
(1, nc + 4, 8400)(4 box coords plusncclass scores), so with 2 classes(1, 6, 8400)is expected and both classes are present, whereas a postprocessor assuming5 + nc(old YOLO layout with an extra objectness channel) will effectively drop one class. I’d suggest updating your RKNN-side decoder to treat channels[0:4]as[x, y, w, h]and[4:]as class logits for allncclasses; if you still see a true(1, 7, 8400)PyTorch output on the same checkpoint, please share yourultralyticsversion andyolo checksoutput so we can dig deeper. The overall YOLO11 head behaviour is also outlined in the YOLO11 model documentation.@BakhtiariB the high-level
YOLO("./yolo11n_rknn_model")interface is designed to keep preprocessing, NPU inference and postprocessing together, so if you need to run only the core RKNN inference on the NPU while fully controlling pre/post on the CPU you’ll need to load the exported.rknnwith Rockchip’sRKNNAPI directly and implement your own preprocessing and YOLO11 postprocessing around it.@dttvn0010 the ~99 ms figure is a conservative end-to-end pipeline measurement on our RK3588 test setup, so seeing ~11 ms from a highly tuned RKNN deployment using all three NPU cores is quite reasonable; if you are open to sharing your exact model variant, quantization mode, input size and NPU core configuration, we can use that to cross-check and better explain the gap between baseline and fully optimized numbers.
@NikolayKash in practice, large gains like that usually come from combining INT8-quantized RKNN models, all three NPU cores enabled, a suitable input resolution and very lean Python-side pre/postprocessing, so it would be great if @dttvn0010 can share their exact script and RK3588 configuration for others to replicate.
guojieli
he YOLO11 benchmark was run by the Ultralytics team on a Radxa Rock 5B based on the Rockchip RK3588, using the RKNN model format to evaluate speed and accuracy. Could you please clarify whether this was an INT8-quantized model?
- Glenn JocherUltralytics(изменено)
Those RKNN benchmarks were not INT8-quantized; they used the floating-point RKNN build. INT8 RKNN export is now available with
quantize=8anddata=for calibration; see the Rockchip RKNN export guide.
BakhtiariB
I used ultralytics for rk3588 by below code, but i want do inference in NPU and do preprocess and postprocess in CPU, how can separate them. while, in below code, line: "results = rknn_model("https://ultralytics.com/images/bus.jpg")" just all of them!
from ultralytics import YOLO
Load the exported RKNN model
rknn_model = YOLO("./yolo11n_rknn_model")
Run inference
results = rknn_model("https://ultralytics.com/images/bus.jpg")
Arshapjoy
Exported RKNN/ONNX model only has 1 output class instead of 2
Overview
I’m using Ultralytics YOLOv11s with two custom classes and exporting it to ONNX and RKNN formats. After conversion, inference on the RKNN device only detects a single class, and the output tensor shape is
(1, 6, 8400)instead of the expected(1, 7, 8400). I’ve validated that the source.ptmodel correctly reports 2 classes, but both ONNX and RKNN exports drop one class.
Model Details
- Checkpoint path:
path/to/yolo11s_custom.pt - Number of classes: 2
- Input size: 640×640
from ultralytics import YOLO
Load the YOLO11 model
model = YOLO("custom_yolo11s.pt")
Export the model to RKNN format
rknn_path = model.export(format="rknn", name="rk3588") print(f"RKNN model saved to: {rknn_path}")
Actual Behavior
- Received ONNX , RKNN and metadata.yaml after conversion
- Exported ONNX model output shape:
(1, 6, 8400) - Exported RKNN model output shape:
(1, 6, 8400) - Only one class is detected during inference on the RK3588 board.
7. Logs & Metadata
- metadata.yaml generated alongside the RKNN model:
model: name: yolo11s_custom format: rknn input_shape: [1, 3, 640, 640] output_shape: [1, 6, 8400] classes: 2 - ONNX graph info: Attached minimal
onnx.shape_inferencelog shows only 6 channels in the final layer.
8. Additional Notes
- Manual ONNX export yields the same issue, so it’s unlikely to be an Ultralytics export bug alone.
- I’ve confirmed that the PyTorch forward pass on the
.ptcheckpoint produces a shape(1, 7, 8400).
9. Request Could you please:
- Confirm whether there’s an option/flag in the YOLO-Ultralytics or RKNN export pipeline I’m missing to preserve all classes.
- Suggest any workarounds or patches to ensure correct output-channel dimensionality.
- Identify if this might be a known issue in RKNN-Toolkit 1.5.0 or Ultralytics YOLO v11.
Thank you for your assistance!
- Checkpoint path:
WeiIIzz
Hello, when I exported the rknn model, I performed int8 quantization, but I had an error like this: E build: If set do_quantization = True, dataset file need be provided. But it`s value is None! E export_rknn: RKNN model does not exist, please load build model first! My export code is: from ultralytics import YOLO
model = YOLO("/home/ky/dfxw/runs/detect/train3/weights/best.pt") model.export(format="rknn", name="rk3576", int8=True, data="/home/ky/rknn_yolo_test/data.yaml") The path pointed to by data is the same as the training dataset. How to solve it
The content of data.yaml is as follows path: /home/ky/dfxw/split_jiaqian # dataset root dir train: images/train val: images/val
names: 0: 0 1: 1
- Glenn JocherUltralytics(изменено)
@WeiIIzz INT8 export for RKNN is supported with
quantize=8(it replaces the deprecatedint8=True) together withdatapointing to a dataset YAML, which Ultralytics converts into the calibration image list that RKNN needs:from ultralytics import YOLO model = YOLO("/home/ky/dfxw/runs/detect/train3/weights/best.pt") model.export(format="rknn", name="rk3576", quantize=8, data="/home/ky/rknn_yolo_test/data.yaml")The error you saw comes from an older version that did not pass a calibration dataset to RKNN, so run
pip install -U ultralyticsand retry. Make sure the YAML points to existing images. Let us know if this resolves your issue! @glenn-jocher I followed your steps to modify the code as follows. But I still encountered the same problem.
from ultralytics import YOLO

model = YOLO("/home/ky/dfxw/runs/detect/train3/weights/best.pt")
model.export(format="rknn", name="rk3576", int8=True, data="/home/ky/rknn_yolo_test/images")
Is there only images in the data path?
- Glenn JocherUltralytics(изменено)
@WeiIIzz older releases ignored
int8=Truefor RKNN and built the model without quantization. Current Ultralytics supports INT8 RKNN export, so afterpip install -U ultralyticsyou can export with:model.export(format="rknn", name="rk3576", quantize=8, data="data.yaml")Here
datais used for the calibration images. Withoutquantize, the export builds a floating-point (FP16) model.
VictorAboba
Good day,
Is RKNN available for obb tasks? I tried to use it directly, but got an error saying that some operations (cos) are not available in RKNN. As a fix, RKNN suggested adding disable_rules = ['reduce_reshape_op_around_concat'] to my configuration. I actually did this inside the YOLO library. Model was exported first to ONNX and then from ONNX to RKNN works and returns the responses in the format (1,6,21504), which seems what I expected. However, if I use this model through YOLO ("path_to_rknn_model", task = 'obb'), will I still get the results in the standard YOLO format? I just don't want to prescribe pre - and post-processing on my own :)
Thank you!
- Glenn JocherUltralytics(изменено)
@VictorAboba thank you for your question! RKNN export now supports all seven Ultralytics tasks, including OBB, so you can export OBB models directly with
format="rknn"and load the exported_rknn_modeldirectory withYOLO(...)to get standard YOLO results without writing your own pre- and post-processing. See the Rockchip RKNN guide for details. Spidrre
Hey! Did you notice any significant decrease in quality of your model after conversion? I am also trying to find a way to convert from OBB onnx to RKNN without 'reduce_reshape_op_around_concat'.
Hey! Did you notice any significant decrease in quality of your model after conversion? I am also trying to find a way to convert from OBB onnx to RKNN without 'reduce_reshape_op_around_concat'.
Hello, after @glenn-jocher answer, I didn't attempt to convert the OBB model. We have a few other models, and all of them except YOLO were converted to the RKNN format. We will try using this stuff (YOLO without an NPU and others with it) ^_^ After conversion, the OCR model, for example, has almost the same quality, but it doesn't need 'reduce_reshape_op_around_concat' to be used.