YOLOE: обнаружение и сегментация с открытым словарём в реальном времени
Ultralytics YOLOE (Real-Time Seeing Anything — «видеть всё в реальном времени») — модель обнаружения с открытым словарём и сегментации экземпляров: вместо фиксированного при обучении списка классов она принимает нужные тебе категории на этапе инференса — в виде текстового запроса, визуального примера или встроенного словаря из 4 585 названий. YOLOE построена на архитектурах Ultralytics YOLO — YOLOv8, YOLO11 и YOLO26 — и вдохновлена YOLO-World. Она обеспечивает высокую точность zero-shot при скорости, почти не уступающей YOLO с закрытым набором классов.
Смотри: Как использовать Ultralytics YOLOE-26 (новинка) | открытый словарь и обнаружение любых объектов в реальном времени
Быстрый старт#
Укажи нужные классы и запусти модель. YOLOE-26 возвращает рамки и маски сегментации экземпляров для категорий, на которых её никогда не обучали.
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")

# «Двухэтажный автобус» — это не класс COCO; YOLOE определяет его только по словам
model.set_classes(["double-decker bus", "person"])

results = model.predict("https://ultralytics.com/images/bus.jpg")
results[0].show()
При первом вызове set_classes() загружается текстовый энкодер; перед развёртыванием на машине без доступа к сети смотри раздел Установка и требования.
Выбор режима подсказок#
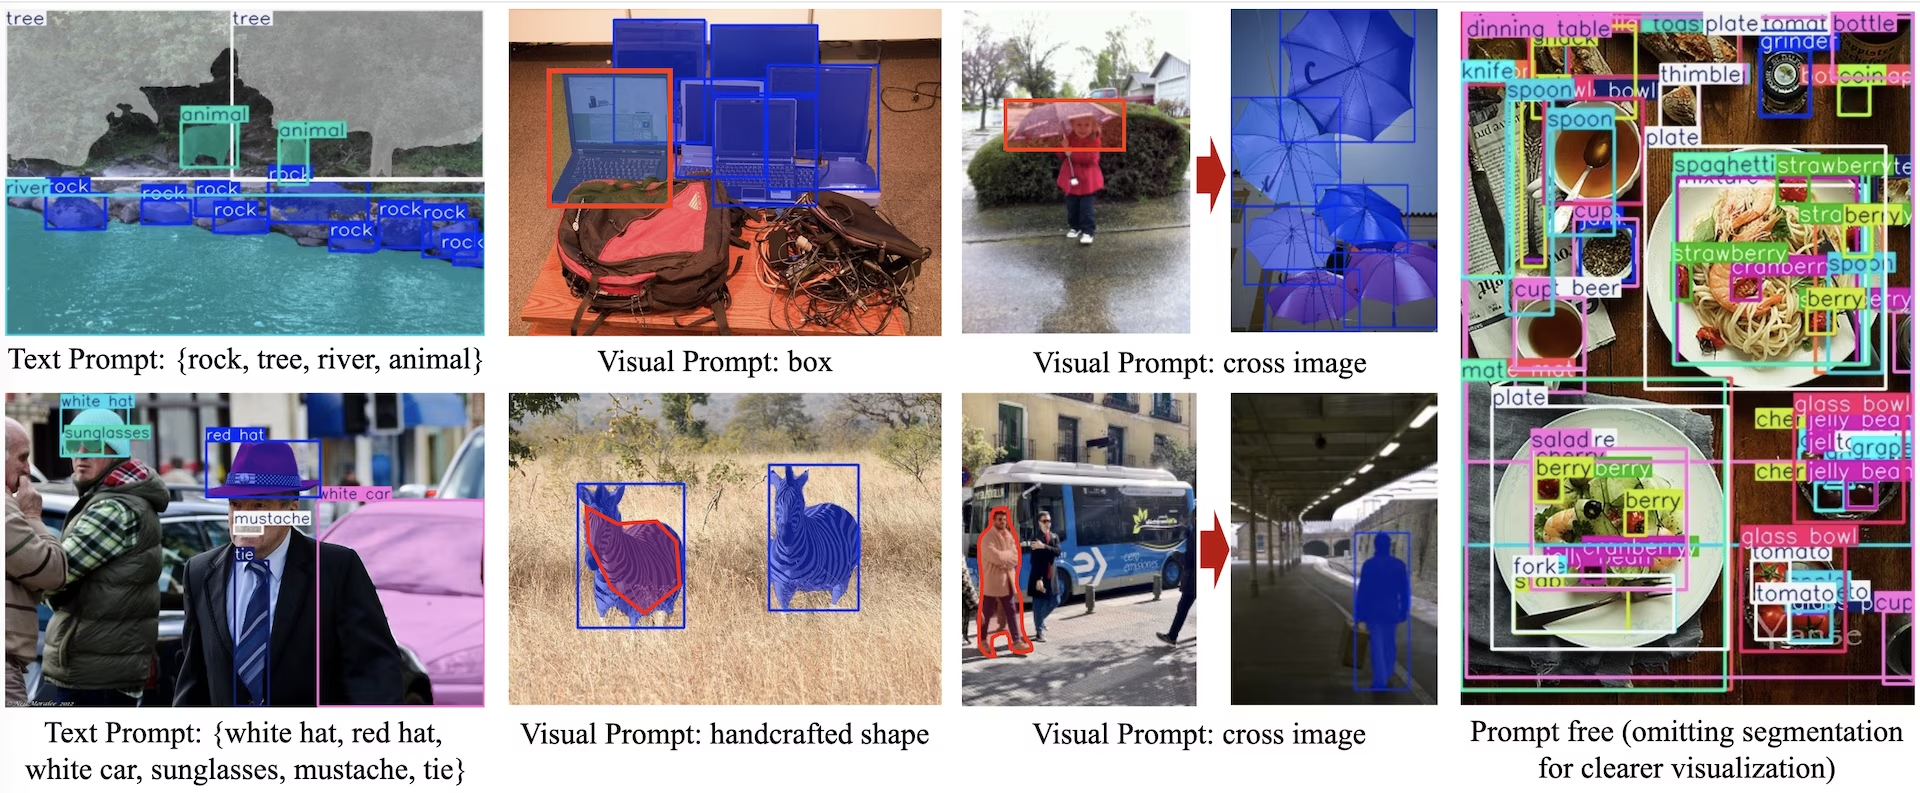
YOLOE поддерживает три режима подсказок. Выбор режима определяет, какую контрольную точку загружать и как будут выглядеть метки классов. Выбери строку, соответствующую тому, что ты можешь предоставить во время инференса.
| Режим | Контрольная точка | Что ты задаёшь | Названия классов в результатах | Когда использовать |
|---|---|---|---|---|
| Текстовая подсказка | *-seg.pt | Названия классов в виде строк | Именно те названия, которые ты передал | Ты можешь описать цель словами — обычно выбирают именно этот режим |
| Визуальная подсказка | *-seg.pt | Примеры рамок на эталонном изображении | Общие object0, object1, … | Ты не можешь описать цель словами: это конкретная деталь, логотип или дефект |
| Без подсказок | *-seg-pf.pt | Ничего | Названия из встроенного словаря из 4 585 категорий | Ты каталогизируешь или исследуешь объекты и заранее не знаешь, что искать |
- Визуальные подсказки не сохраняют твои метки. Идентификаторы классов в
visual_promptsгруппируют примеры; модель возвращает их какobject0,object1и так далее. Самостоятельно сопоставь их со своими названиями. - Контрольные точки без подсказок не принимают
set_classes(). Вызов этого метода для модели*-seg-pf.ptвызываетAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.. Если нужны собственные классы, вместо этого загрузи контрольную точку*-seg.pt.
Установка и требования#
YOLOE входит в основной пакет Ultralytics:
pip install -U ultralyticsДля текстовых подсказок дополнительно нужен текстовый энкодер. Он загружается при первом использовании, а не во время установки:
- При первом вызове
set_classes()с GitHub устанавливается ultralytics/CLIP с помощьюpip(он предоставляет токенизатор), а текстовый энкодер TorchScript загружается в текущую рабочую директорию. YOLOE-26 загружаетmobileclip2_b.tsразмером около 254 МБ; YOLOE-11 и YOLOE-v8 загружаютmobileclip_blt.ts. Запусти загрузку один раз из директории, из которой будешь работать, или скопируй туда файл, иначе он будет загружен повторно. - Для обоих шагов нужен доступ к сети, поэтому выполни один прогноз с подсказкой до развёртывания на компьютере без подключения к сети.
- Для визуальных подсказок и контрольных точек без подсказок текстовый энкодер не нужен.
Для контрольных точек YOLOE-26 требуется ultralytics версии 8.4.0 или новее; семейства YOLOE-11 и YOLOE-v8 доступны в более ранних выпусках. Один прогноз с текстовой подсказкой проверяет весь процесс — загрузку контрольной точки, установку CLIP, текстовый энкодер и инференс:
yolo predict model=yoloe-26s-seg.pt source="https://ultralytics.com/images/bus.jpg" classes="person"Чтобы полностью отказаться от загрузки текстового энкодера во время инференса, один раз встрой подсказки в веса и используй их повторно — смотри раздел Повторное использование эмбеддингов подсказок.
Обзор архитектуры#

YOLOE сохраняет стандартную структуру YOLO — свёрточный бэкбон для извлечения признаков, шейный модуль для многоуровневого объединения и безанкорную разделённую голову, предсказывающую классы и рамки, — и добавляет три модуля, по одному для каждого режима подсказок:
- Перепараметризуемое выравнивание области и текста (RepRTA) уточняет текстовые эмбеддинги из CLIP с помощью небольшой вспомогательной сети. Эта сеть запускается один раз при каждом вызове
set_classes()и удаляется при экспорте, поэтому не создаёт затрат на каждый кадр. На каждом прямом проходе выполняется сравнение сохранённых эмбеддингов запросов с признаками областей; о затратах при большом наборе запросов см. в разделе Ограничения. - Кодировщик визуальных подсказок с семантической активацией (SAVPE) кодирует семантические и активационные признаки из примерной рамки, настраивая модель на объекты, похожие на этот пример. Это режим one-shot для целей, которые сложно назвать, например логотипа или конкретной детали.
- Контрастное сопоставление регионов и подсказок с отложенной обработкой (LRPC) сопоставляет эмбеддинги регионов со встроенным словарём из 4 585 названий, поэтому контрольные точки без подсказок распознают объекты без внешних подсказок и текстового энкодера.
Сегментация экземпляров выполняется ветвью масок в голове обнаружения, как в YOLOv8-Seg, поэтому каждый прогноз содержит маску в results[0].masks. После экспорта модули открытого мира перепараметризуются в стандартную голову YOLO, и экспортированный файл использует обычный путь обнаружения/сегментации.
Доступные модели#
Каждый приведённый ниже чекпойнт предназначен для сегментации экземпляров и поддерживает режимы val, predict, export и track. Загружай файл *-seg.pt для текстовых или визуальных запросов, а файл *-seg-pf.pt — для инференса без запросов; эти файлы не взаимозаменяемы. Подробнее см. в разделе Выбор режима подачи запросов. Только файлы *-seg.pt поддерживают режим train; чекпойнт без запросов создаётся на основе обученной модели с текстовыми запросами. Подробнее см. в разделе Обучение официальных моделей с нуля.
| Модель | Текстовая / визуальная подсказка | Без подсказок |
|---|---|---|
| YOLOE-26n | yoloe-26n-seg.pt | yoloe-26n-seg-pf.pt |
| YOLOE-26s | yoloe-26s-seg.pt | yoloe-26s-seg-pf.pt |
| YOLOE-26m | yoloe-26m-seg.pt | yoloe-26m-seg-pf.pt |
| YOLOE-26l | yoloe-26l-seg.pt | yoloe-26l-seg-pf.pt |
| YOLOE-26x | yoloe-26x-seg.pt | yoloe-26x-seg-pf.pt |
| YOLOE-11s | yoloe-11s-seg.pt | yoloe-11s-seg-pf.pt |
| YOLOE-11m | yoloe-11m-seg.pt | yoloe-11m-seg-pf.pt |
| YOLOE-11l | yoloe-11l-seg.pt | yoloe-11l-seg-pf.pt |
| YOLOE-v8s | yoloe-v8s-seg.pt | yoloe-v8s-seg-pf.pt |
| YOLOE-v8m | yoloe-v8m-seg.pt | yoloe-v8m-seg-pf.pt |
| YOLOE-v8l | yoloe-v8l-seg.pt | yoloe-v8l-seg-pf.pt |
Производительность YOLOE на LVIS#
Результаты zero-shot на LVIS minival при размере 640 пикселей, из статьи Ultralytics YOLO26.
Текстовые и визуальные подсказки#
В каждой ячейке точности и числа параметров указаны значения для текстовой подсказки / визуальной подсказки; FLOPs приведены один раз. Число параметров и FLOPs относятся к конфигурации обнаружения, оцениваемой в статье. Точность — это показатель Non-E2E из статьи, единственный протокол, по которому приведены результаты для всех сравниваемых моделей; голова YOLOE-26 в режиме end-to-end уступает ему не более чем на 1,1 AP при текстовых подсказках и на 2,6 AP при визуальных подсказках.
| Модель | mAP50-95 | mAPr | mAPc | mAPf | параметры (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n | 24.7 / 21.9 | 20.5 / 17.6 | 24.1 / 22.3 | 26.1 / 22.4 | 3.9 / 3.1 | 6.1 |
| YOLOE-26s | 30.8 / 28.6 | 23.9 / 25.1 | 29.6 / 27.8 | 33.0 / 29.9 | 10.7 / 11.0 | 21.9 |
| YOLOE-26m | 35.4 / 33.9 | 31.1 / 33.4 | 34.7 / 34.0 | 36.9 / 33.8 | 21.3 / 25.1 | 70.6 |
| YOLOE-26l | 37.8 / 36.3 | 35.1 / 37.6 | 37.6 / 36.2 | 38.5 / 36.1 | 25.5 / 29.3 | 89.0 |
| YOLOE-26x | 40.6 / 38.5 | 37.4 / 35.3 | 40.9 / 38.8 | 41.0 / 38.8 | 55.2 / 65.2 | 197.7 |
| YOLOE-11s | 27.5 / 26.3 | 21.4 / 22.5 | 26.8 / 27.1 | 29.3 / 26.4 | 10.7 / 10.9 | 22.7 |
| YOLOE-11m | 33.0 / 31.4 | 26.9 / 27.1 | 32.5 / 31.9 | 34.5 / 31.7 | 21.0 / 24.8 | 70.4 |
| YOLOE-11l | 35.2 / 33.7 | 29.1 / 28.1 | 35.0 / 34.6 | 36.5 / 33.8 | 26.0 / 29.8 | 89.5 |
| YOLOE-v8s | 27.9 / 26.2 | 22.3 / 21.3 | 27.8 / 27.7 | 29.0 / 25.7 | 12.3 / 12.6 | 29.8 |
| YOLOE-v8m | 32.6 / 31.0 | 26.9 / 27.0 | 31.9 / 31.7 | 34.4 / 31.1 | 26.4 / 28.4 | 80.7 |
| YOLOE-v8l | 35.9 / 34.2 | 33.2 / 33.2 | 34.8 / 34.6 | 37.3 / 34.1 | 43.5 / 47.3 | 167.6 |
Без подсказок#
Контрольные точки без подсказок выдают результат на основе встроенного словаря, не требуя подсказок. В каждой ячейке точности указаны значения end-to-end / Non-E2E — два протокола, по которым в статье оценивается YOLOE-26; на странице YOLO26 приведён столбец Non-E2E.
| Модель | mAP50-95 | mAPr | mAPc | mAPf | параметры (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n-pf | 16.6 / 17.7 | 15.7 / 15.8 | 15.3 / 16.4 | 17.9 / 19.2 | 2.3 | 5.3 |
| YOLOE-26s-pf | 21.4 / 22.6 | 16.2 / 20.2 | 20.1 / 20.9 | 23.5 / 24.5 | 9.0 | 20.8 |
| YOLOE-26m-pf | 25.7 / 26.4 | 26.7 / 24.5 | 24.0 / 25.0 | 26.9 / 27.9 | 19.4 | 68.4 |
| YOLOE-26l-pf | 27.2 / 28.0 | 26.3 / 25.7 | 25.7 / 26.8 | 28.7 / 29.5 | 23.6 | 86.8 |
| YOLOE-26x-pf | 29.9 / 31.1 | 27.5 / 28.9 | 29.1 / 30.7 | 31.1 / 31.7 | 53.1 | 194.4 |
При текстовых и визуальных запросах модели YOLOE-26 превосходят соответствующие модели YOLOE-11 и YOLOE-v8 на каждом совпадающем масштабе по mAP50-95, при этом у них меньше параметров и FLOPs, чем у линейки v8. На том же сплите в статье приводятся показатели YOLO-Worldv2: 24.4 (S), 32.4 (M) и 35.5 (L), а также детекторов на основе трансформеров GLIP-T (26.0), GDINO-T (27.4) и DetCLIP-T (34.4); у каждого из них от 155 до 232 млн параметров. В оригинальной статье о YOLOE приводятся ещё два результата для представленных в ней моделей масштаба v8. На LVIS YOLOE-v8s превосходит YOLO-Worldv2-S на 3.5 AP, затрачивая на обучение втрое меньше времени и работая на инференсе в 1.4 раза быстрее. При переносе на COCO YOLOE-v8l превосходит YOLOv8-L с закрытым набором классов на 0.6 box AP и 0.4 mask AP, затрачивая на обучение почти в 4 раза меньше времени.
В статье о YOLO26 оценивается конфигурация для детекции. Выпущенные веса — это чекпойнты сегментации с ветвью масок, SAVPE и текстовой проекцией, поэтому загруженная модель yoloe-26l-seg.pt показывает 35.4 млн параметров и 142.0 млрд FLOPs, а не указанные выше 25.5 млн и 89.0 млрд. В обоих случаях значение FLOPs не учитывает сходство регионов с текстом, поэтому реальная стоимость растёт вместе с размером набора запросов, хотя значение в столбце не меняется; см. раздел Ограничения.
Примеры использования#
Все приведенные ниже примеры YOLOE запускаются через Python API. Предсказание по текстовым подсказкам, валидация, экспорт, трекинг и обычное обучение также доступны через CLI; в примерах тонкой настройки передается класс тренера, а в примерах визуального промптинга — массивы подсказок NumPy, которые принимает только Python API.
Использование для обучения#
Дообучи любой выпущенный чекпойнт *-seg.pt на собственном датасете YOLO. В основном процесс соответствует стандартной процедуре обучения YOLO; отличие заключается в том, какой тренер ты передаёшь. YOLOEPESegTrainer встраивает названия твоих классов в голову модели и дообучает её с этой точки — именно это нужно для собственных меток; тренер по умолчанию не обучается на твоих названиях классов. Полученный чекпойнт напрямую предсказывает классы твоего датасета: его голова больше не обрабатывает промпты, поэтому set_classes() выдаёт ошибку, если классы меняются; визуальные промпты также вызывают ошибку. Чтобы работать с другими классами, используй промпты с исходным чекпойнтом.
Смотри: Как обучить YOLOE на наборе данных сегментации автомобильных деталей | модель с открытым словарём, предсказание и экспорт
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPESegTrainer

model = YOLOE("yoloe-26s-seg.pt")

results = model.train(
    data="coco128-seg.yaml",
    epochs=80,
    patience=10,
    trainer=YOLOEPESegTrainer,  # <- Важно: тренер для дообучения, а не тренер по умолчанию
)Все выпущенные чекпойнты — модели сегментации. Чтобы обучить детектор, создай модель по соответствующему YAML, загрузи веса сегментации того же масштаба и замени тренер на тренер для детекции. Остальное не меняется.
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPETrainer

model = YOLOE("yoloe-26s.yaml").load("yoloe-26s-seg.pt")

results = model.train(data="coco128.yaml", epochs=80, patience=10, trainer=YOLOEPETrainer)
Использование для предсказаний#
Вызов с текстовой подсказкой показан в разделе Быстрый старт. Для визуального промптинга добавь аргумент visual_prompts, а для предсказания без подсказок загрузи чекпойнт -pf:
Визуальные запросы показывают модели пример вместо его словесного описания. visual_prompts принимает массив bboxes с примерами ограничивающих рамок и массив cls с идентификаторами классов — по одному на каждую рамку. Эти идентификаторы служат временными группировками, а не метками: они должны идти подряд, начиная с 0, а результаты возвращаются как object0, object1, …, а не под выбранными тобой названиями.
Примеры ограничивающих рамок можно указать на изображении, для которого выполняется предсказание:
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

# По одной примерной рамке на каждую цель, у каждой — собственный идентификатор класса
visual_prompts = {
    "bboxes": np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # человек, очки
    "cls": np.array([0, 1]),
}

results = model.predict(
    "ultralytics/assets/bus.jpg",
    visual_prompts=visual_prompts,
)
results[0].show()
Или на отдельном эталонном изображении, переданном как refer_image. В этом случае bboxes и cls описывают объекты на эталонном изображении, а не на целевом:
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {"bboxes": np.array([[221.52, 405.8, 344.98, 857.54]]), "cls": np.array([0])}  # person

results = model.predict(
    "ultralytics/assets/zidane.jpg",  # Целевое изображение
    refer_image="ultralytics/assets/bus.jpg",  # Где находятся примеры рамок
    visual_prompts=visual_prompts,
)
results[0].show()

# refer_image также задаёт классы на постоянной основе, поэтому в последующих вызовах запросы не нужны
results = model("ultralytics/assets/bus.jpg")
model.export(format="onnx") # И при экспорте они сохраняютсяЕсли source — это видео или поток, первый кадр автоматически становится refer_image, поэтому переданные запросы применяются к этому кадру и сохраняются для всего остального видео. Передай refer_image явно, чтобы выбрать другой кадр.
И source, и refer_image напрямую принимают тензоры torch. Это удобно, когда изображения уже поступают из существующего конвейера. Указывай рамки в пиксельных координатах самого тензора:
import numpy as np
import torch

from ultralytics import YOLOE

model = YOLOE("yoloe-11l-seg.pt")

img_tensor = torch.rand(1, 3, 480, 480)  # (1, 3, H, W) float-тензор в диапазоне [0, 1]
visual_prompts = {"bboxes": np.array([[10, 10, 50, 50]]), "cls": np.array([0])}

results = model.predict(
    img_tensor,
    refer_image=img_tensor,
    visual_prompts=visual_prompts,
    imgsz=640,
)
Чтобы получить предсказания сразу для нескольких изображений, вложи запросы ещё на один уровень глубже: по одному массиву bboxes и одному массиву cls для каждого исходного изображения, в том же порядке, что и изображения.
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {
    "bboxes": [
        np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # bus.jpg: человек, очки
        np.array([[150, 200, 1150, 700]]),  # zidane.jpg: человек
    ],
    "cls": [np.array([0, 1]), np.array([0])],
}

results = model.predict(
    ["ultralytics/assets/bus.jpg", "ultralytics/assets/zidane.jpg"],
    visual_prompts=visual_prompts,
)
results[0].show()
Использование для валидации#
Валидация выполняется так же, как для любой другой модели, на датасете сегментации:
from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")  # или yoloe-26s/m-seg.pt для моделей других размеров

metrics = model.val(data="coco128-seg.yaml")
data также может быть файлом NDJSON или URI набора данных ul:// на Platform; перед созданием текстовых или визуальных запросов данные преобразуются в формат YOLO.
Другие режимы запросов поддерживаются двумя вариантами того же вызова:
- Визуальные запросы —
model.val(data="coco128-seg.yaml", load_vp=True)извлекает визуальное встраивание для каждой категории непосредственно из датасета. Добавьrefer_data="coco.yaml", чтобы взять встраивания из другого датасета, который должен содержать точно те же категории. - Без запросов — загрузи чекпойнт
*-seg-pf.ptи передайsingle_cls=True.
Использование при экспорте#
Встраивания запросов можно сохранить один раз и повторно использовать при создании статических экспортированных моделей, например ONNX, OpenVINO, TensorRT, CoreML, LiteRT и RKNN. Перед экспортом профиль NPZ загружается в исходную модель PyTorch; он не является дополнительным входом во время выполнения, и экспортированной модели файл NPZ не нужен.
Классы, заданные через set_classes() (или через refer_image для визуальных запросов), встраиваются в экспортированные веса. После экспорта модель больше не принимает новые запросы: вызов set_classes() или передача visual_prompts=... в predict() для загруженной экспортированной модели приведёт к ошибке. Чтобы изменить распознаваемые классы, выполни повторный экспорт исходного чекпойнта .pt с новыми заданными запросами. Экспортированный файл работает как стандартная модель YOLO, и его также можно загрузить с помощью YOLO() вместо YOLOE().
from ultralytics import YOLOE

model = YOLOE("yoloe-26n-seg.pt")
model.set_classes(["person", "bus"])
model.save_prompt_embeddings("person-bus.npz")

# Профиль привязан к исходному чекпойнту и подходит для повторного использования при последующих экспортах.
model = YOLOE("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="onnx")
Тот же профиль запросов можно использовать и для настройки модели только для детекции, созданной на основе соответствующей архитектуры YOLOE. Это убирает ветвь масок, сохраняя заданные запросами классы:
from ultralytics import YOLOE

model = YOLOE("yoloe-26n.yaml").load("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="rknn", name="rk3588", quantize=16)
Отслеживание объектов#
Классы, заданные запросами, без изменений переходят в трекинг, поэтому ты можешь отслеживать объекты, на которых трекер не обучался:
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")
model.set_classes(["forklift", "pallet"])

# persist=True сохраняет идентификаторы треков неизменными между кадрами
for result in model.track("path/to/video.mp4", stream=True, persist=True):
    print(result.boxes.id)
Сравнение YOLOE с другими моделями#
YOLOE занимает промежуточное положение между детектором с закрытым набором классов и ресурсоёмкой моделью с открытым словарём. Чтобы понять, подходит ли тебе YOLOE, сравни его по трём пунктам:
- В сравнении с YOLO с закрытым набором классов. После задания запросов YOLOE выполняет предсказания обычным способом для детекции и сегментации, а экспортируется так же, как любая другая модель. Главное преимущество — возможность менять список классов во время инференса без повторного обучения; недостаток — точность в режиме zero-shot значительно ниже, чем у модели, обученной на твоих классах.
- В сравнении с предыдущими семействами YOLOE. YOLOE-26 наследует от YOLO26 сквозную голову без NMS, охватывает пять масштабов (n/s/m/l/x) вместо трёх у предыдущих моделей (s/m/l) и лидирует на каждом совпадающем масштабе в разделе Производительность.
- В сравнении с детекторами с открытым словарём на основе трансформеров. GLIP и OWL-ViT выполняют инференс с помощью визуально-языкового трансформера. YOLOE кодирует запросы один раз, а затем сравнивает их с признаками регионов внутри свёрточной головы.
Ближайшие альтернативы принимают текстовый запрос, но маски возвращают только YOLOE и SAM 3, и каждая из трёх моделей отвечает на свой вопрос:
| YOLOE | SAM 3 | YOLO-World | |
|---|---|---|---|
| Для чего предназначена | Детекция и сегментация названных классов в реальном времени | Сегментация по понятиям и трекинг с запросами | Детекция с открытым словарём в реальном времени |
| Маски | Да, с чекпойнтами *-seg.pt | Да | Нет, только рамки |
| Визуальные запросы | Да (SAVPE) | Да | Нет |
| Режим без запросов | Да, словарь из 4 585 названий | Нет | Нет |
| Выбирай её, если | Тебе важна пропускная способность и ты можешь назвать классы | Тебе нужна максимально точная сегментация по понятиям и доступны необходимые вычислительные ресурсы | Ты уже её используешь — см. примечание о миграции ниже |
Переходишь с YOLO-World? API устроен так же: замени YOLOWorld на YOLOE, загрузи чекпойнт *-seg.pt и оставь вызов set_classes() без изменений. Ты получишь маски и визуальные запросы; примечание об экспорте и фиксированных классах относится к обеим моделям.
Сценарии использования и области применения#
Детекция с открытым словарём позволяет не переобучать модель для каждого класса. Это особенно важно, когда целевой список заранее неизвестен:
- Детекция в открытом мире — робототехника и системы безопасности, которые сталкиваются с объектами, не учтёнными при обучении.
- Однократная детекция по примеру — визуальные запросы позволяют находить конкретную деталь, логотип или дефект по одной эталонной рамке; это полезно для промышленного контроля.
- Каталогизация длинного хвоста — встроенный словарь из 4 585 названий достаточно широк для мониторинга биоразнообразия и инвентаризации розничных товаров.
- Подготовка датасета — предварительно размечай изображения рамками и масками перед проверкой человеком, а затем обучай на полученном датасете быструю модель с закрытым набором классов.
- Сегментация произвольных объектов — выпущенные чекпойнты
*-seg.ptвозвращают маску для каждого предсказания, поэтому медицинская визуализация и анализ спутниковых снимков получают точный попиксельный результат без второй модели.
Распространённый подход сочетает два режима: сначала один раз запусти модель без запросов, чтобы определить присутствующие объекты, а затем переключись на текстовые запросы для нужных категорий.
Ограничения#
YOLOE жертвует точностью ради возможности менять классы во время инференса. Вот что стоит знать, прежде чем использовать эту модель:
- Точность в режиме zero-shot значительно ниже, чем у модели, обученной на твоих классах. Показатели чекпойнтов с запросами на LVIS minival составляют примерно 22–40 mAP; обученная на твоих данных YOLO с закрытым набором классов покажет лучшие результаты для этих классов. Используй YOLOE для классов, на которых ты не можешь обучить модель, а не вместо обучения.
- Редкие категории — слабое место модели. В столбце mAPr раздела Производительность приводится точность именно на редких классах LVIS. При текстовых запросах во всех строках она ниже, чем для распространённых и частых классов. Если твои целевые объекты необычны, ориентируйся на этот показатель, а не на общий mAP.
- Запрос описывает внешний вид, а не отношения между объектами. Детекция сравнивает признаки регионов с встраиванием запроса, поэтому запросы, зависящие от состояния, контекста или сравнения — «повреждённый», «крайний слева», «тот, которого несут», — не дают надёжных признаков для сопоставления. Предпочитай формулировки, близкие к обычным названиям категорий.
- Большие наборы запросов увеличивают задержку. Встраивания запросов вычисляются один раз, но при каждом прямом проходе сравниваются с признаками регионов. При измерениях на CPU с
yoloe-26s-seg.ptдлительность прямого прохода увеличивается примерно на 19% при переходе от 80 к 1 203 классам и примерно на 89% для полного словаря из 4 585 названий. Указанное значение FLOPs совсем не меняется, поскольку сходство регионов с текстом не учитывается, поэтому профиль не предупредит тебя об этом. - До задания запросов названия классов — лишь заполнители. Свежезагруженный чекпойнт
*-seg.ptвозвращаетnc=80с числовыми названиями ("0","1", …), поэтому перед чтением меток вызовиset_classes(). В чекпойнтах без запросов уже заполнен весь словарь.
Примечания по развёртыванию#
- Оборудование. Для инференса нужна GPU NVIDIA с 4–8 ГБ VRAM; модели масштабов
nиsработают на периферийных GPU, например Jetson, или на CPU при уменьшенном разрешении. Для дообучения нужна одна GPU. - По умолчанию NMS не зависит от класса. YOLOE выполняет предсказания с
agnostic_nms=True. По умолчанию нижние по оценке перекрывающиеся рамки подавляются и между разными классами, а не только внутри одного класса. Это предотвращает дублирование, когда одному объекту соответствуют несколько категорий. Приnms=FalseYOLOE-26 не применяет подавление по IoU; в режиме без учёта классов для каждого якоря сохраняется только класс с наилучшей оценкой, вместо того чтобы позволить одному якорю выдавать метки нескольких классов. Передайagnostic_nms=False, чтобы изменить это поведение. - Для визуальных подсказок по умолчанию используется
conf=0.05. Боксы визуальных подсказок оказываются точнее, чем можно предположить по их оценкам: на мини-выборке LVIS, когда в качестве подсказки используется один экземпляр класса,conf=0.25пропускает от 44 до 55% других экземпляров, которые YOLOE-26 находит приconf=0.05. В плотных сценах с почти одинаковыми объектами, например на полках магазинов или среди клеток, могут потребоваться более низкие значения, а приnms=Falseоценки однократной головы YOLOE-26 ещё ниже, и оптимальный порог близок к0.01. Во всех остальных вызовах сохраняетсяconf=0.25, включая последующие вызовы, сохранённые эмбеддинги и экспорты, использующие классы, заданные черезrefer_image. Чтобы задать другое значение, передайconf. - Пакетная обработка. Пакетный инференс работает напрямую, а визуальные запросы для каждого изображения в одном вызове могут различаться.
Обучение официальных моделей с нуля#
Большинству читателей это не понадобится. Здесь воспроизводятся опубликованные чекпойнты с открытым словарём на основе Objects365, GQA и Flickr30k — около 1,4 млн обучающих примеров на 8× RTX 4090. Это не связано с дообучением на собственных данных, которое описано выше в разделе Обучение.
Все тренеры, наследующие YOLOETrainer, отклоняют compile=True, включая стандартный YOLOESegTrainer и все приведённые ниже тренеры для обучения с нуля. Передавай compile=False (значение по умолчанию). На два использованных выше тренера для дообучения — YOLOEPESegTrainer и YOLOEPETrainer — это ограничение не распространяется.
Для обучения нужны сегментные аннотации. Скачай обработанные файлы ниже или создай собственные с помощью скрипта официальной команды, работающего на базе SAM 2.1. Для валидации используется LVIS minival.
| Датасет | Тип | Примеры | Боксы | Обработанные сегментные аннотации |
|---|---|---|---|---|
| Objects365v1 | Обнаружение | 609k | 9621k | objects365_train_segm.json |
| GQA | Привязка к изображениям | 621k | 3681k | final_mixed_train_no_coco_segm.json |
| Flickr30k | Привязка к изображениям | 149k | 641k | final_flickr_separateGT_train_segm.json |
Сначала обучается модель с текстовыми запросами, а два остальных режима запросов получаются её доработкой:
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOESegTrainerFromScratch

data = {
    "train": {
        "yolo_data": ["Objects365.yaml"],
        "grounding_data": [
            {
                "img_path": "flickr/full_images/",
                "json_file": "flickr/annotations/final_flickr_separateGT_train_segm.json",
            },
            {
                "img_path": "mixed_grounding/gqa/images",
                "json_file": "mixed_grounding/annotations/final_mixed_train_no_coco_segm.json",
            },
        ],
    },
    "val": {"yolo_data": ["lvis.yaml"]},
}

model = YOLOE("yoloe-26l-seg.yaml")
model.train(
    data=data,  # или путь к YAML-файлу с той же структурой
    batch=128,
    epochs=30,
    close_mosaic=2,
    optimizer="AdamW",
    lr0=2e-3,
    warmup_bias_lr=0.0,
    weight_decay=0.025,
    momentum=0.9,
    workers=4,
    trainer=YOLOESegTrainerFromScratch,
    device="0,1,2,3,4,5,6,7",
)
Контрольные точки для визуальных подсказок и работы без подсказок создаются на основе обученной модели с текстовыми подсказками, и в каждой обновляется один модуль. YOLOESegVPTrainer — рецепт для визуальных подсказок, а YOLOEPEFreeTrainer — для работы без подсказок, но сами по себе эти классы ничего не замораживают: выборочное обучение обеспечивается списком freeze, который ты передаёшь вместе с классом. В нём перечислены все дочерние модули головы, кроме savpe (соответственно, все классификационные башни), а для запуска без подсказок дополнительно нужен single_cls=True. В исходном репозитории YOLOE приведены полные рецепты для моделей масштаба v8.
После завершения запуска без подсказок модель повторно параметризуется в контрольную точку, которая при инференсе сообщает названия классов без подсказок, с помощью get_vocab и set_vocab:
from ultralytics import YOLOE

# Веса, записанные запуском без подсказок и запуском с текстовыми подсказками, на основе которого он был создан. Каждый
# повторный запуск создаёт новую директорию (train-2, train-3, ...), поэтому используй пути, выведенные запусками.
model = YOLOE("runs/segment/train-2/weights/best.pt")  # в запуске без подсказок голова уже объединена
text_model = YOLOE("runs/segment/train/weights/best.pt")  # в запуске с текстовыми подсказками голова ещё не объединена

names = list(YOLOE("yoloe-26l-seg-pf.pt").model.names.values())  # словарь из 4,585 названий или свой список
vocab = text_model.get_vocab(names)

model.set_vocab(vocab, names)
model.save("yoloe-26l-seg-pf-custom.pt")  # не перезаписывай выпущенную контрольную точку
get_vocab возвращает ветвь, выбранную флагом модели end2end, а set_vocab повторно параметризует эту ветвь. В выпущенных файлах YOLOE-26 для каждой ветви используется отдельный словарь — именно это позволяет nms выбирать между ними. Чтобы воспроизвести такое поведение, возьми второй словарь из другой копии модели с текстовыми подсказками. У YOLOE-11 и YOLOE-v8 одна ветвь, поэтому для них вызов выше остаётся без изменений.
one2one_model = YOLOE("runs/segment/train/weights/best.pt")  # get_vocab объединяет голову, из которой читает данные, поэтому загрузи вторую копию
one2one_model.model.end2end = True  # прочитай ветвь без NMS

model.set_vocab(vocab, names, one2one_vocab=one2one_model.get_vocab(names))
Цитирование и благодарности#
Если YOLOE помогла твоему исследованию или проекту, процитируй оригинальную статью Ao Wang, Lihao Liu, Hui Chen, Zijia Lin, Jungong Han и Guiguang Ding из Университета Цинхуа:
@misc{wang2025yoloerealtimeseeing,
      title={YOLOE: Real-Time Seeing Anything},
      author={Ao Wang and Lihao Liu and Hui Chen and Zijia Lin and Jungong Han and Guiguang Ding},
      year={2025},
      eprint={2503.07465},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2503.07465},
}
Дополнительную информацию можно найти в оригинальной статье о YOLOE на arXiv. Исходный код проекта и другие материалы доступны в репозитории GitHub.
Часто задаваемые вопросы#
Ultralytics YOLOE предлагает две возможности, которых нет у YOLO-World: визуальные подсказки, в которых вместо названия класса используется пример рамки, и контрольные точки без подсказок, которые определяют объекты по встроенному словарю из 4,585 названий без каких-либо подсказок. Каждое предсказание выпущенных контрольных точек
*-seg.ptтакже содержит маску сегментации экземпляров. Что касается точности, в оригинальной статье о YOLOE указано, что YOLOE-v8s превосходит YOLO-Worldv2-S на 3.5 AP на LVIS при втрое меньших затратах на обучение и в 1.4 раза большей скорости инференса. Для перехода достаточно изменить одну строку — см. Сравнение YOLOE.Ultralytics YOLOE поддерживает три режима работы с подсказками. Текстовая подсказка — это названия классов в виде строк, передаваемые контрольной точке
*-seg.pt; обычно используют именно этот вариант. Визуальная подсказка — одна или несколько примерных рамок на эталонном изображении; она подходит для объектов, которые трудно описать словами. При инференсе без подсказок используется отдельная контрольная точка*-seg-pf.pt, которая определяет объекты по встроенному словарю из 4,585 названий без дополнительных данных. Для текстовых и визуальных подсказок используются одни и те же контрольные точки; для режима без подсказок нужны другие файлы, которые не принимаютset_classes(). Полное сравнение см. в разделе Выбор режима работы с подсказками.Начни с
yoloe-26s-seg.pt: семейство YOLOE-26 превосходит YOLOE-11 и YOLOE-v8 при любом совпадающем масштабе, а масштабs— самый маленький из тех, что показывают более 30 mAP на LVIS minival. Выбериm,lилиx, если точность на редких категориях важнее задержки: сравни столбец mAPr в разделе Производительность. Выбирайnтолько для развёртывания на периферийных устройствах. Если нужен встроенный словарь вместо собственных названий классов, загрузи файл*-seg-pf.ptтого же масштаба.Метки вроде
object0иobject1означают, что предсказание получено с помощью визуальной подсказки: примерные рамки группируются во временные пронумерованные классы, вместо того чтобы использовать твои названия. Переданные тобой идентификаторы классовvisual_prompts["cls"]нужны только для группировки. Модель выводит их какobject0,object1и так далее, в порядке назначенных тобой идентификаторов, поэтому сопоставь их со своими метками в результате. Если ты хочешь видеть в выводе свои названия, используй текстовую подсказку.Чекпойнты без промптов (
*-seg-pf.pt) определяют классы с помощью собственного встроенного словаря и отклоняютset_classes()сAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.. Визуальные промпты вызываютAssertionError: Visual prompts need an unfused YOLOE model.. Загрузи чекпойнт*-seg.pt, если тебе нужен собственный список классов. См. раздел Выбор режима промптинга.При первой текстовой подсказке Ultralytics YOLOE устанавливает ultralytics/CLIP с GitHub с помощью
pipи скачивает текстовый энкодер TorchScript в текущую рабочую директорию — около 254 MB для YOLOE-26. Точный файл для каждого семейства моделей см. в разделе Установка и требования. Для визуальных подсказок и контрольных точек без подсказок ничего из этого не требуется. Чтобы не скачивать файл на целевой машине, один раз задай подсказки и сохрани их с помощьюsave_prompt_embeddings()либо экспортируй модель с уже настроенными классами.Нет — при экспорте YOLOE встраивает классы, заданные в подсказках, в веса, поэтому загруженная экспортированная модель отклоняет и
set_classes(), иvisual_prompts=. Повторно экспортируй исходную контрольную точку.pt, предварительно настроив новые подсказки. Экспортированный файл работает как стандартная модель YOLO и загружается как с помощьюYOLO(), так и с помощьюYOLOE().Выбирай YOLOE, если нужна высокая пропускная способность в реальном времени и классы можно назвать, а SAM 3 — если качество сегментации концепта важнее скорости. Обе модели принимают визуальные примеры; режим без подсказок есть только у YOLOE. Полное сравнение см. в разделе Сравнение YOLOE.


Комментарии60
Задай вопрос, поделись результатами или помоги кому-нибудь.
daiyangyang945
I converted YOLOE to ONNX, but it only supports single-image input. How can I implement visual prompts?
1cyt1990cyt1990-dev
你好,请问怎么利用yoloe的视觉提示(结合SAM)功能进行自动标注(auto_annotate)?
 Glenn JocherUltralytics
你好,目前 YOLOE 的视觉提示能力是通过
model.predict(..., visual_prompts=..., refer_image=..., predictor=YOLOEVPSegPredictor)使用的,文档里还没有auto_annotate()直接接入这套流程的现成示例;另外yoloe-26*-seg.pt本身就会输出分割掩码,所以这类自动标注场景通常不需要再额外叠加 SAM,你可以先按 YOLOE 文档 和YOLOE.predict()参考 跑出提示式分割结果再保存为标签;如果你愿意,也欢迎把你的目标流程和样例数据贴在这个讨论里,方便团队一起看。
zhangxiancai
你好,请问yoloe如何使用多张图片里的视觉对象作为参考进行推理。因为一张图片不能全面反映要检测对象的特征,容易漏检。
 User
我也有想过建立一个供yoloe提取多角度多图片特征的小型数据库,但是发现效果并不好。官方通道似乎不支持多特征融合成一个标签。
q9card
Hello, I would like to ask about training YOLOE with a custom grounding dataset.
My current goal is to use YOLOE for open-vocabulary detection on remote-sensing small objects, and I am trying to integrate my own dataset, AI-TOD-v2, into the open-text / grounding training pipeline.
So far, I have completed the following steps:
- Converted AI-TOD-v2 from standard COCO detection annotations into a grounding-style JSON added caption for each image added tokens_positive for each instance
- Successfully ran generate_grounding_cache.py so the custom grounding JSON / cache generation itself seems to work
However, when I try to continue with the official open-text / from-scratch training pipeline, I run into many issues, for example:
(1)hard-coded checks in GroundingDataset.verify_labels() for official dataset names / instance counts (2)mismatch between yolo_data and grounding_data text slot / tensor shapes (3)later shape mismatch again in training loss / bbox decode
So I would like to ask:
Has anyone successfully trained YOLOE open-text / text-prompt models with a custom grounding dataset (not only the official Flickr/GQA/Objects365 data)? If yes, is there any recommended dataset organization or minimal working setup? Does the official pipeline currently support mixing custom grounding data with official grounding datasets such as Flickr/GQA? For a case like mine, would you recommend: continuing to adapt the current from-scratch training pipeline, or switching to another route based on official pretrained weights? If possible, could you share a minimal working example for training with a custom grounding dataset, even a very small toy example?
My current impression is that the main difficulty may not be the grounding JSON / cache generation itself, but rather that the current training code has strong assumptions about the official data pipeline. If there is any official recommendation or similar community experience, I would really appreciate it.
Thank you very much!
- Glenn JocherUltralytics
Thanks for the detailed report — the current public YOLOE from-scratch open-text pipeline is mainly validated around the official
Objects365/Flickr/GQArecipe shown in the YOLOE training docs, so a fully custom grounding dataset is not yet a documented plug-and-play path; for AI-TOD-v2, the safer route is usually to start from pretrainedyoloe-26*-seg.ptweights and the supported fine-tuning flow in the YOLOE usage docs rather than continuing from scratch. Please open a new issue with a minimal reproducible example, full traceback,yolo checks, and a tiny sample of the grounding JSON/cache so the team can check the dataset verification and shape assumptions directly. 我按照你说的用yoloe-s26-seg.pt进行微调,出现AttributeError: Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from '/mnt/workspace/projects/yoloe/ultralytics/nn/modules/head.py'>错误,改用最新版 pip 安装的 Ultralytics 再试仍然存在这个问题。 目前我的yolo check输出如下: OS Linux-5.10.134-18.0.9.lifsea8.x86_64-x86_64-with-glibc2.35 Environment Linux Python 3.10.19 Install pip Path /root/miniconda3/envs/yoloe/lib/python3.10/site-packages/ultralytics RAM 31.34 GB Disk 94.8/97.9 GB CPU Intel Xeon Platinum 8163 CPU @ 2.50GHz CPU count 8 GPU Tesla V100-SXM2-16GB, 16144MiB GPU count 1 CUDA 12.8
numpy ✅ 2.2.6>=1.23.0 matplotlib ✅ 3.10.8>=3.3.0 opencv-python ✅ 4.13.0.92>=4.6.0 pillow ✅ 12.1.1>=7.1.2 pyyaml ✅ 6.0.3>=5.3.1 requests ✅ 2.32.5>=2.23.0 scipy ✅ 1.15.3>=1.4.1 torch ✅ 2.10.0>=1.8.0 torch ✅ 2.10.0!=2.4.0,>=1.8.0; sys_platform == "win32" torchvision ✅ 0.25.0>=0.9.0 psutil ✅ 7.2.2>=5.8.0 polars ✅ 1.39.3>=0.20.0 ultralytics-thop ✅ 2.0.18>=2.0.18
- Glenn JocherUltralytics
这个报错基本就是“权重版本和实际导入的代码版本不一致”:
yolo checks显示你用的是site-packages,但异常却来自/mnt/workspace/projects/yoloe/ultralytics/...,说明本地仓库覆盖了 pip 安装;而YOLOESegment26在当前head.py文档里是存在的,所以请先移除或重命名该本地ultralytics目录并重启 Python/Notebook 会话,确认ultralytics.__file__指向同一环境后再试;如果还报错,请贴完整 traceback 和精确训练命令。
- User
视觉提示只能支持一种类型吗,当我使用视觉提示进行检测之后,再次设置新的类别就会出现shape '[1, 66, -1]' is invalid for input of size 416000
- Glenn JocherUltralytics
视觉提示不只支持一种类别,
visual_prompts里可以给多组bboxes/cls(要求cls从0..N-1连续且与框数量一致),细节见中文 YOLOE 文档;你这个shape '[1, 66, -1]' is invalid...通常是跑过视觉提示(尤其用过refer_image)后又set_classes()切新类别导致旧的 prompt/embedding 状态残留,建议直接重新初始化一个新YOLOE(...)实例(Notebook 里也请重启 kernel)再设置新类别/新视觉提示。若仍复现,请把最小可复现代码、完整 traceback(文本)以及yolo checks输出贴在这里我们才能定位。 - User
好的,问题可以解决。不过衍生出相机模式下,反复创建销毁yoloe()实例,同时相机推理的帧率也很低。我会继续进行优化
- User
感谢,已经将初始化逻辑改成文本/视觉提示发送改变时触发,同时开启GPU加速,问题基本解决,再次感谢答疑
- Glenn JocherUltralytics
很好,感谢你回报进展;相机/视频场景下建议始终复用同一个
YOLOE实例,只在提示词变化时才更新set_classes()或visual_prompts,且注意传了visual_prompts时视频/流会自动用第一帧作为refer_image(详见 中文 YOLOE 文档),这样能避免反复构建带来的卡顿并提升 FPS。from ultralytics import YOLOE model = YOLOE("yoloe-26s-seg.pt") # 可按需求换更小尺度提升速度 # 仅在提示变化时调用:model.set_classes(...) 或传 visual_prompts for r in model.predict(source=0, stream=True, device=0, half=True, imgsz=640): pass # 在这里处理 r(不要每帧重新初始化模型) - User
在使用yoloe-26模型时出现模型加载错误Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from 'd:\YOLO E\yoloe-main\ultralytics\nn\modules\head.py' YOLOE的库有进行开源更新吗
- Glenn JocherUltralytics
这个报错基本就是“权重文件里引用的模块/类名”和你当前导入的本地
ultralytics代码不一致导致的;从路径看你现在加载的是d:\YOLO E\yoloe-main\ultralytics\...这份源码,它不包含权重所需的YOLOESegment26,建议先排除本地目录把包“遮住”了的情况,改用最新版pip安装的 Ultralytics 再试(用法见中文 YOLOE 文档)。pip uninstall -y ultralytics pip install -U ultralytics yolo checks如果仍复现,请把“完整 traceback(文本)”、你是如何加载模型的最小代码(例如
YOLOE("yoloe-26s-seg.pt")/YOLO("yoloe-26s-seg.pt"))、以及上面yolo checks的输出贴出来;如果你刚升级过包且在 Notebook 里运行,也请先重启 kernel 再测。
qbig
Hello,
Can I ask why the exported Core ML model doesn't have labels metadata like normal YOLO or even exported YOLO-World models?
from ultralytics import YOLOE, YOLO from pathlib import Path from ultralytics.utils import YAML model_name = "yoloe-11m-seg.pt" file_name = "lvis.yaml" model = YOLOE(model_name) model.eval() # Please replace names with yours data = YAML.load(file_name) names = [n.split('/')[0] for n in data["names"].values()] model.set_classes(names, model.get_text_pe(names)) coreml_path = model.export(format='coreml', half=True, nms=False)- Glenn JocherUltralytics
That’s expected right now: YOLOE’s classes are prompt-defined (and can be changed via
set_classes()), so the CoreML exporter doesn’t reliably embed a fixed label list in the model metadata—especially when exporting “raw” outputs withnms=False; if you need labels inside the.mlmodel/.mlpackage, either export withnms=Trueor post-edit the CoreML package metadata after export (see the YOLOE export notes and theYOLOEAPI).
gstrat88
Is there any example to use it as a zero-shot logo detection?
tomer196
Hi, Is there a way to get the embeddings of each detection when I use model.predict? Similar to the way I can get the embeddings of the visual and text prompts.
ratom
I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format. @glenn-jocher
Hi @glenn-jocher, I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format.
- Glenn JocherUltralytics(изменено)
@tomer196 Fine-tuning and open-vocabulary prompting are mutually exclusive in the current implementation: after fine-tuning with
YOLOEPESegTrainer, the checkpoint predicts your dataset’s classes directly andset_classes()raises an error, so keep the original checkpoint for prompting. Details are under Train Usage in the YOLOE docs; we can’t share timelines for other changes.@ram-from-tvl For production use you’ll need to choose between AGPL-3.0 compliance (open‑source your entire derivative) or an Enterprise License for proprietary deployment; see options and terms at the Ultralytics License page. For deployment hardening, benchmark and export to your target runtime (ONNX/TensorRT/CoreML/etc.) per the Export section in the YOLOE docs.
@ram-from-tvl To convert a UNet-style binary mask dataset to YOLO segmentation format, create one TXT per image with polygon coordinates per instance (normalized x,y). Format and examples are in the Segmentation task data format. Minimal conversion example for a single-class binary mask:
import cv2, numpy as np, os

def mask_to_yolo_segments(mask):
    h, w = mask.shape[:2]
    contours, _ = cv2.findContours(mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    segs = []
    for c in contours:
        if len(c) < 3:
            continue
        pts = c.squeeze(1).astype(float)
        pts[:, 0] /= w
        pts[:, 1] /= h
        segs.append(pts.reshape(-1))
    return segs

mask = cv2.imread("mask.png", 0) > 0
segs = mask_to_yolo_segments(mask.astype(np.uint8))
os.makedirs("labels", exist_ok=True)
with open("labels/image.txt", "w") as f:
    for seg in segs:
        f.write("0 " + " ".join(f"{v:.6f}" for v in seg.tolist()) + "\n")
@Swetha4545 YOLOE isn’t limited to 80 classes—text prompts are open‑vocab, and the prompt‑free variants use a large vocabulary; for harder concepts like “cotton” try synonyms (e.g., “cotton plant”, “cotton bale”, “fabric”) or switch to visual prompts with a clear reference exemplar; see Text/Visual/Prompt‑free usage in the YOLOE docs and the predictor API for visual prompts: YOLOEVPSegPredictor.
@ratom For per-pixel class maps (semantic segmentation), YOLO26 provides dedicated
-semmodels such asyolo26n-sem.pt(task=semantic); see the Semantic Segmentation docs. YOLOv8/YOLO11/YOLOE are instance segmentation models: if you use them, convert your masks to per‑instance polygons and save in YOLO segmentation TXT format (one line per instance:cls x1 y1 x2 y2 ..., normalized); the expected structure and examples are in the Segmentation task data format.
beichen2012
May I ask how to replace the YOLO11 backbone with DINOV3 distilled? Thanks.
- Glenn JocherUltralytics(изменено)
@daiyangyang945 ONNX runtime doesn’t support passing visual prompts at inference; bake them before export by running one PyTorch pass with
refer_image(which fixes classes), then export the fused model; this preserves the same classes in ONNX and you can still use dynamic batch input: see Visual Prompting and Export sections in the YOLOE docs for details. Example:from ultralytics import YOLOE from ultralytics.models.yolo.yoloe import YOLOEVPSegPredictor m = YOLOE("yoloe-11l-seg.pt") visual_prompts = {"bboxes": ..., "cls": ...} # your examples m.predict("img.jpg", refer_image="ref.jpg", visual_prompts=visual_prompts, predictor=YOLOEVPSegPredictor) m.export(format="onnx", dynamic=True, simplify=True)For guidance see the YOLOE page under Predict and Export usage. Refer: YOLOE: Real‑Time Seeing Anything, YOLOEVPSegPredictor API.
@Chappie123 With bbox-only data, convert to YOLO detection TXT labels and train a detection model. Convert each box from
{minx,miny,maxx,maxy}to normalizedxc,yc,w,h:def to_yolo(minx, miny, maxx, maxy, W, H): xc = (minx + maxx) / 2 / W yc = (miny + maxy) / 2 / H w = (maxx - minx) / W h = (maxy - miny) / H return xc, yc, w, hDataset YAML (minimal):
path: /data/myset
train: images/train
val: images/val
names: {0: class0, 1: class1}
Train:
from ultralytics import YOLOE
model = YOLOE("yoloe-11s.yaml")
model.train(data="data.yaml", epochs=100, imgsz=640)
More in Train mode and Detection task.
@HLHSM The error is from installing the wrong
clippackage. Uninstall the PyPIclipand install the official CLIP (per its README), or use a compatible wheel likeclip-anytorch, then restart Python:pip uninstall -y clip pip install clip-anytorchIf it persists, please run
yolo checksand paste the full text output. Reference for the APIs you’re calling: YOLOE API reference.@Maya7991 Current ONNX exports accept a single
imagesinput; runtime text/visual prompts aren’t exposed as additional ONNX inputs. Use offline prompts: set and fuse classes before export, or use the prompt‑free path.from ultralytics import YOLOE m = YOLOE("yoloe-11s-seg.pt") names = ["person", "bus"] m.set_classes(names, m.get_text_pe(names)) # fuse prompts m.export(format="onnx", dynamic=True, simplify=True)With
dynamic=True, you can pass[N,3,H,W]batches in onnxruntime even though the input name is justimages. See Export mode and YOLOE Export examples on the docs page: YOLOE docs.@beichen2012 Swapping YOLO11’s CNN backbone for a DINOv3‑distilled ViT isn’t supported and would require a custom backbone module plus shape/plumbing changes; we recommend using YOLO26 as‑is or a transformer model like RT‑DETR. If you prototype this, please keep any PR minimal, well‑tested, and scoped to the new backbone only.