Обучение в облаке#
Ultralytics Platform предлагает обучение в облаке одним нажатием на облачных GPU, делая обучение моделей доступным без сложной настройки. Обучай модели YOLO с потоковой передачей метрик в реальном времени и автоматическим сохранением чекпоинтов.
Диалог обучения#
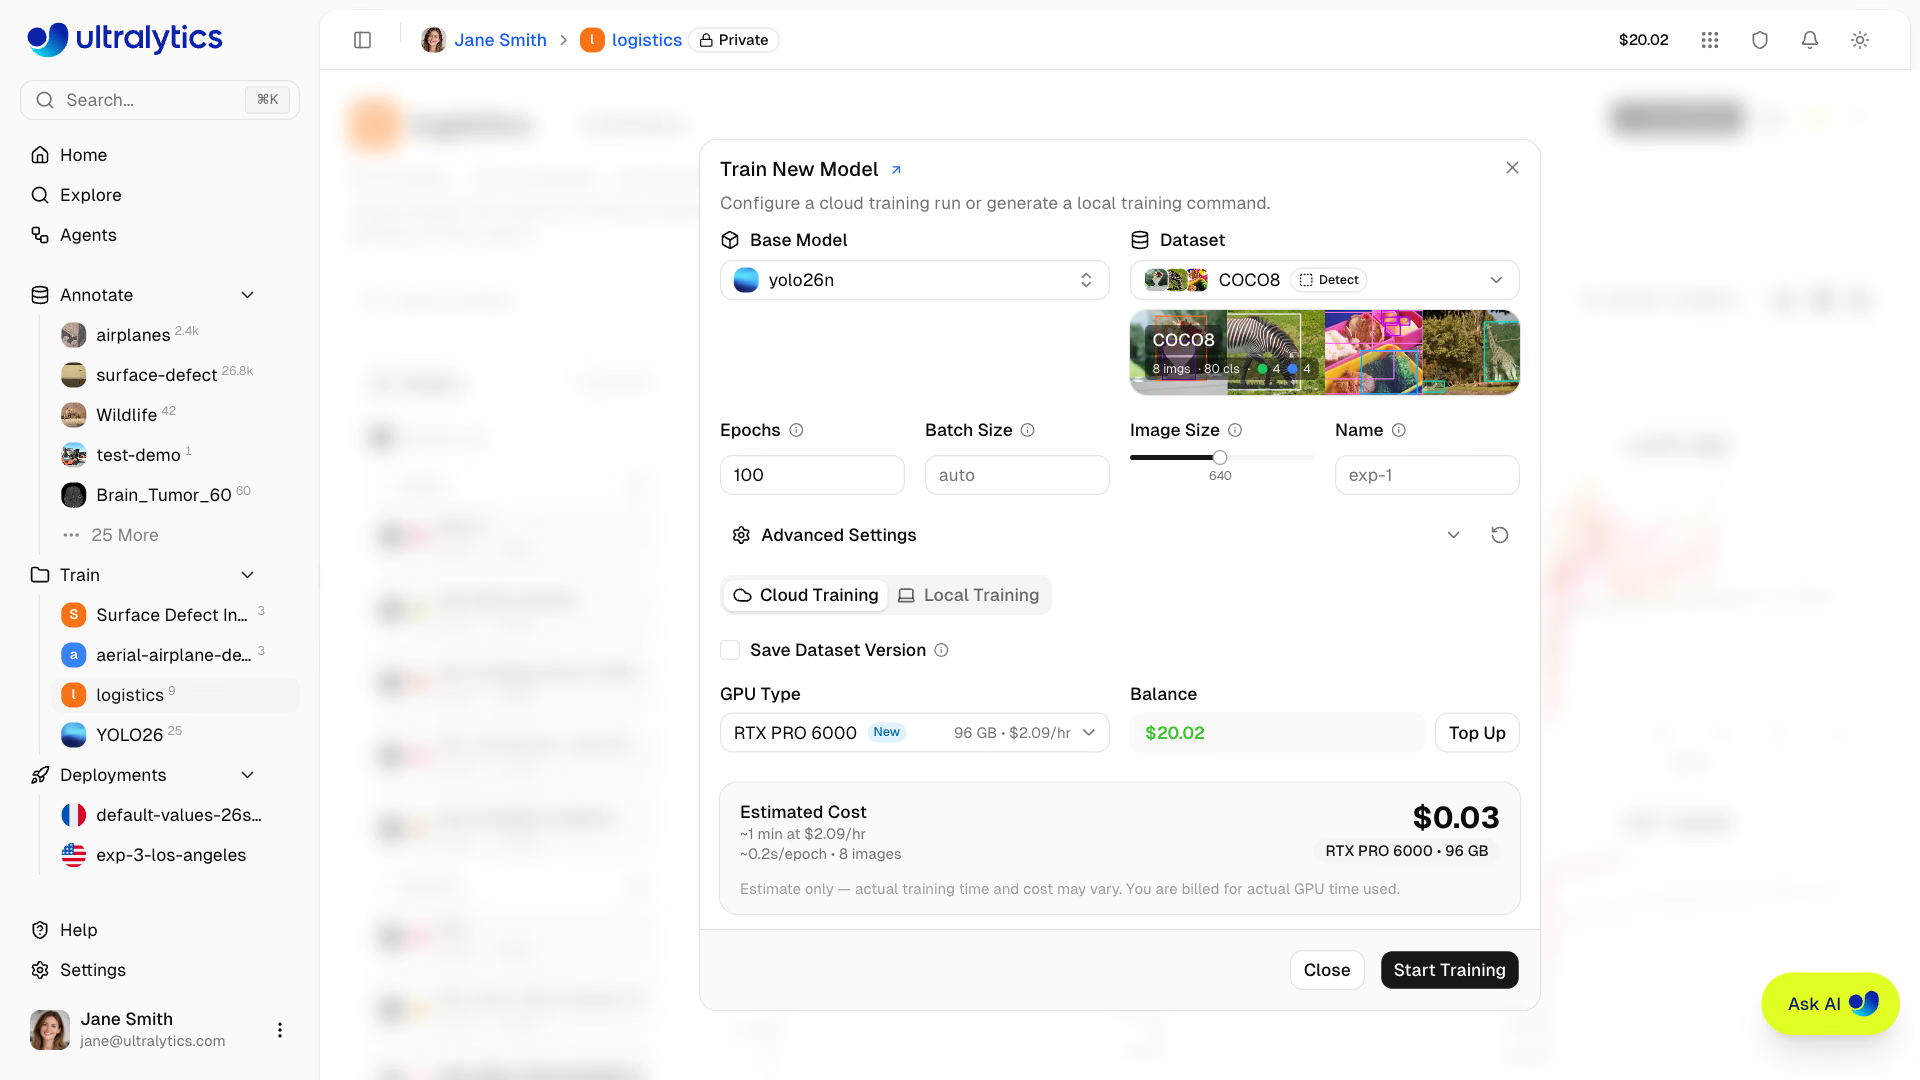
Начни обучение в интерфейсе платформы: нажми Новая модель на странице любого проекта или датасета. В диалоге обучения есть две вкладки: Обучение в облаке и Локальное обучение. Если выбранный датасет находится на хосте локального размещения, первая вкладка называется Локальное размещение, а вкладка «Локальное обучение» скрыта — такой датасет можно обучать только на собственном хосте. Для этого нужны план Enterprise и подключённый активный воркер.
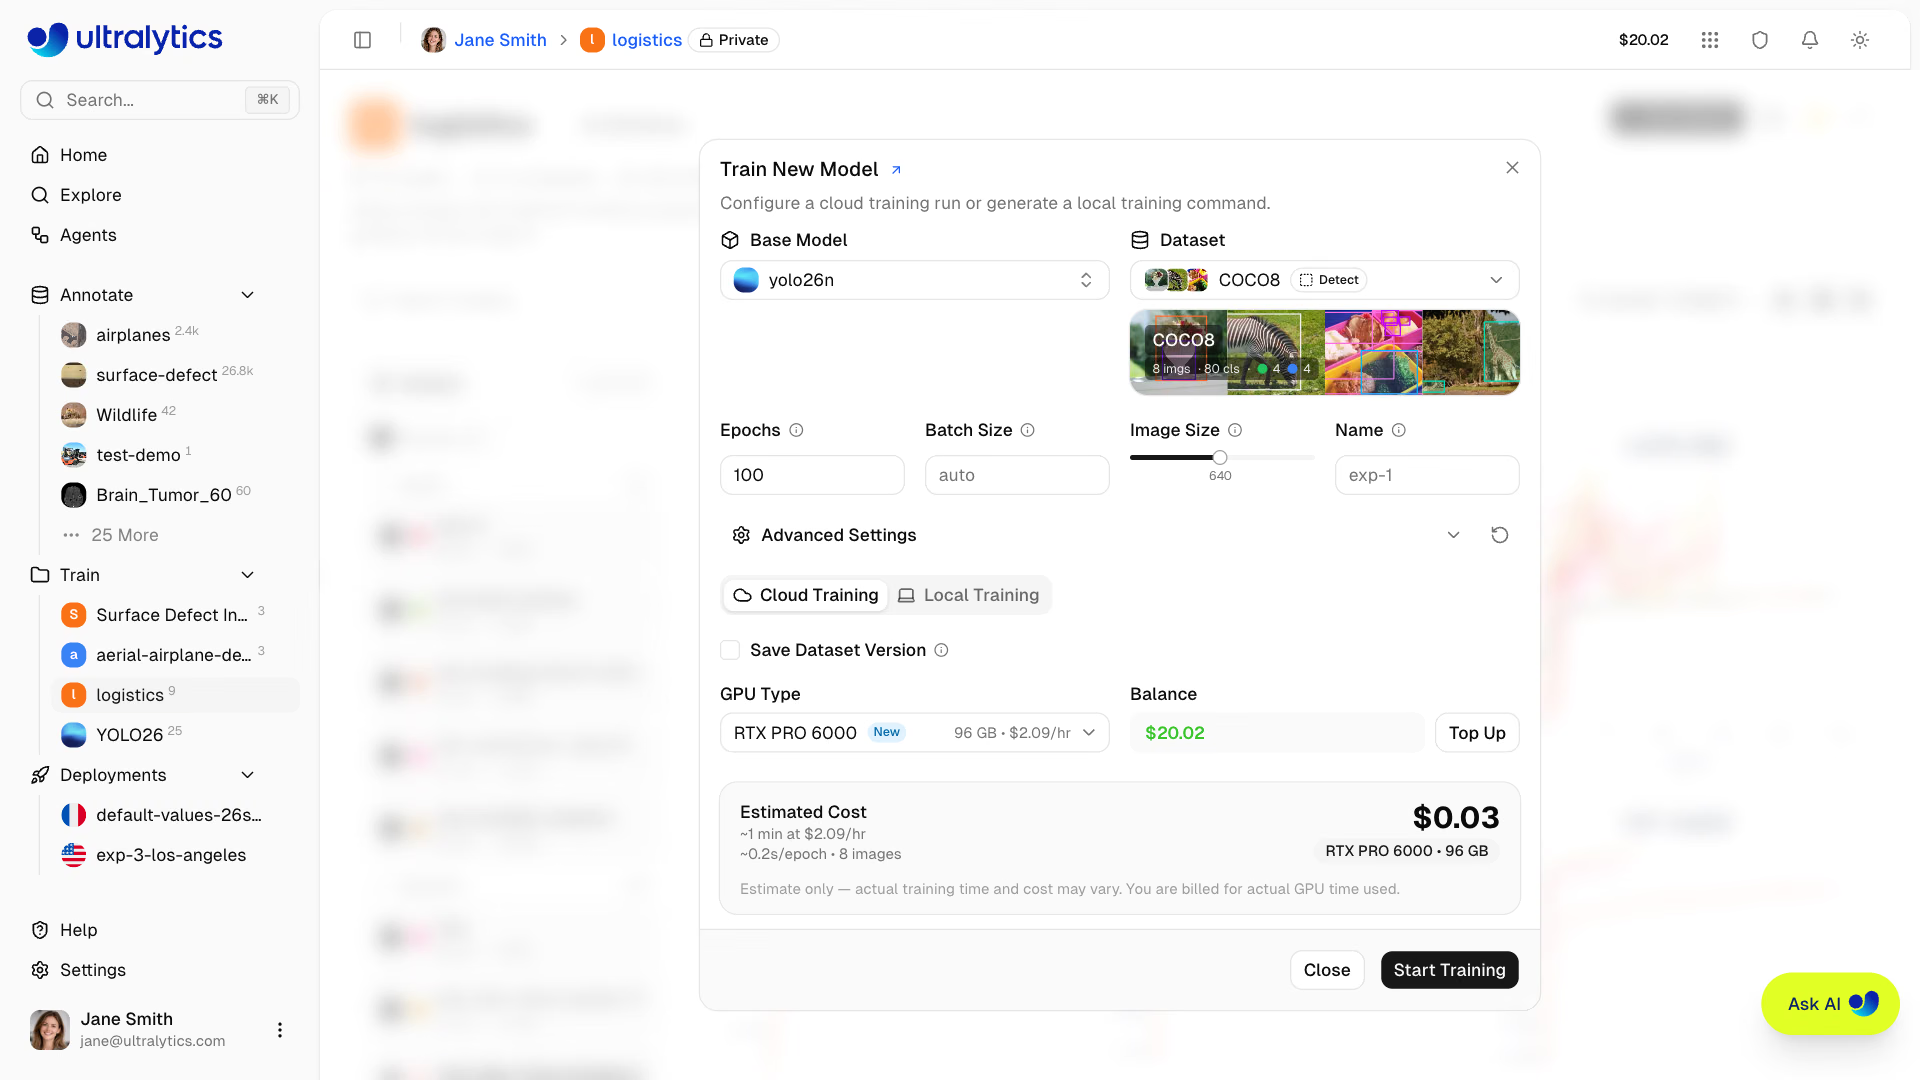
Для каждой задачи датасета и рабочего пространства в текущем браузере диалог запоминает базовую модель и все нестандартные параметры, установленные при последнем закрытии, и восстанавливает их при следующем открытии для этой задачи. Выбор GPU не сохраняется, а команда Повторить обучение для неудачного запуска восстанавливает аргументы именно этого запуска.
Шаг 1. Выбери базовую модель#
Выбери официальную модель Ultralytics или одну из своих завершённых моделей:
| Вкладка | Описание |
|---|---|
| Официальные | Модели из проектов YOLO26 (рекомендуется), YOLO11, YOLOv8 и YOLOv5 |
| Мои модели | Твои завершённые или загруженные модели, сгруппированные по проектам, для дообучения |
В каждой вкладке модели сгруппированы по задачам в каноническом порядке и отсортированы по размеру. В обеих вкладках отображаются только модели, чья задача позволяет обучать выбранный датасет. Для YOLO26 доступны варианты задач обнаружение, сегментация, семантическая сегментация, оценка глубины, классификация, оценка позы и OBB — от nano до xlarge.
Датасеты для оценки глубины можно загружать с целевыми данными NPY типа float в метрах или PNG типа uint16, используя depth_scale датасета. См. формат датасета для оценки глубины. По умолчанию для моделей оценки глубины используется рецепт дообучения (optimizer: AdamW, lr0: 0.0001, warmup_bias_lr: 0.0001), если ты не задашь эти параметры самостоятельно.
Шаг 2. Выбери датасет#
Выбери датасет для обучения (см. раздел Датасеты):
| Параметр | Описание |
|---|---|
| Официальные | Отобранные датасеты от Ultralytics |
| Мои датасеты | Датасеты в твоём рабочем пространстве |
Датасеты должны иметь статус ready, содержать не менее 1 изображения в обучающей выборке, 1 изображения в валидационной или тестовой выборке, не менее 1 размеченного изображения и хотя бы одно название класса. Для датасетов классификации также требуется, чтобы изображение из обучающей выборки было размечено, а в датасетах позы должна быть задана форма ключевых точек. Для датасетов оценки глубины требуется одна пара карт в train и две — в val; изображения без пары исключаются.
Предупреждение о несовпадении задач появляется, если выбранная модель не может обучаться на датасете с такой задачей. Кнопка Начать обучение остаётся неактивной, пока ты не выберешь совместимую модель. Для датасета сегментации подходят модели сегментации или семантической сегментации; для датасетов с другими задачами нужна модель с соответствующей задачей. См. руководства по задачам.
Шаг 3. Настрой параметры#
Задай основные параметры обучения:
| Параметр | Описание | По умолчанию |
|---|---|---|
| Эпохи | Количество итераций обучения (1–10000) | 100 |
| Размер батча | Количество примеров на итерацию (-1 автоматически подбирает значение с учётом доступной VRAM или используй фиксированное количество изображений) | -1 (авто) |
| Размер изображения | Ползунок разрешения входных изображений: от 32 до 1280 с шагом 32 | 640 |
| Название | Необязательное название запуска обучения | авто |
Значения, выходящие за допустимый диапазон параметра, автоматически ограничиваются при потере фокуса полем.
Максимальное значение ползунка — 1280, но редактор YAML принимает размеры до 4096. При значениях выше 1280 появляется предупреждение, поскольку более высокое разрешение значительно увеличивает использование памяти GPU, время обучения и расходы.
Шаг 4. Дополнительные настройки (необязательно)#
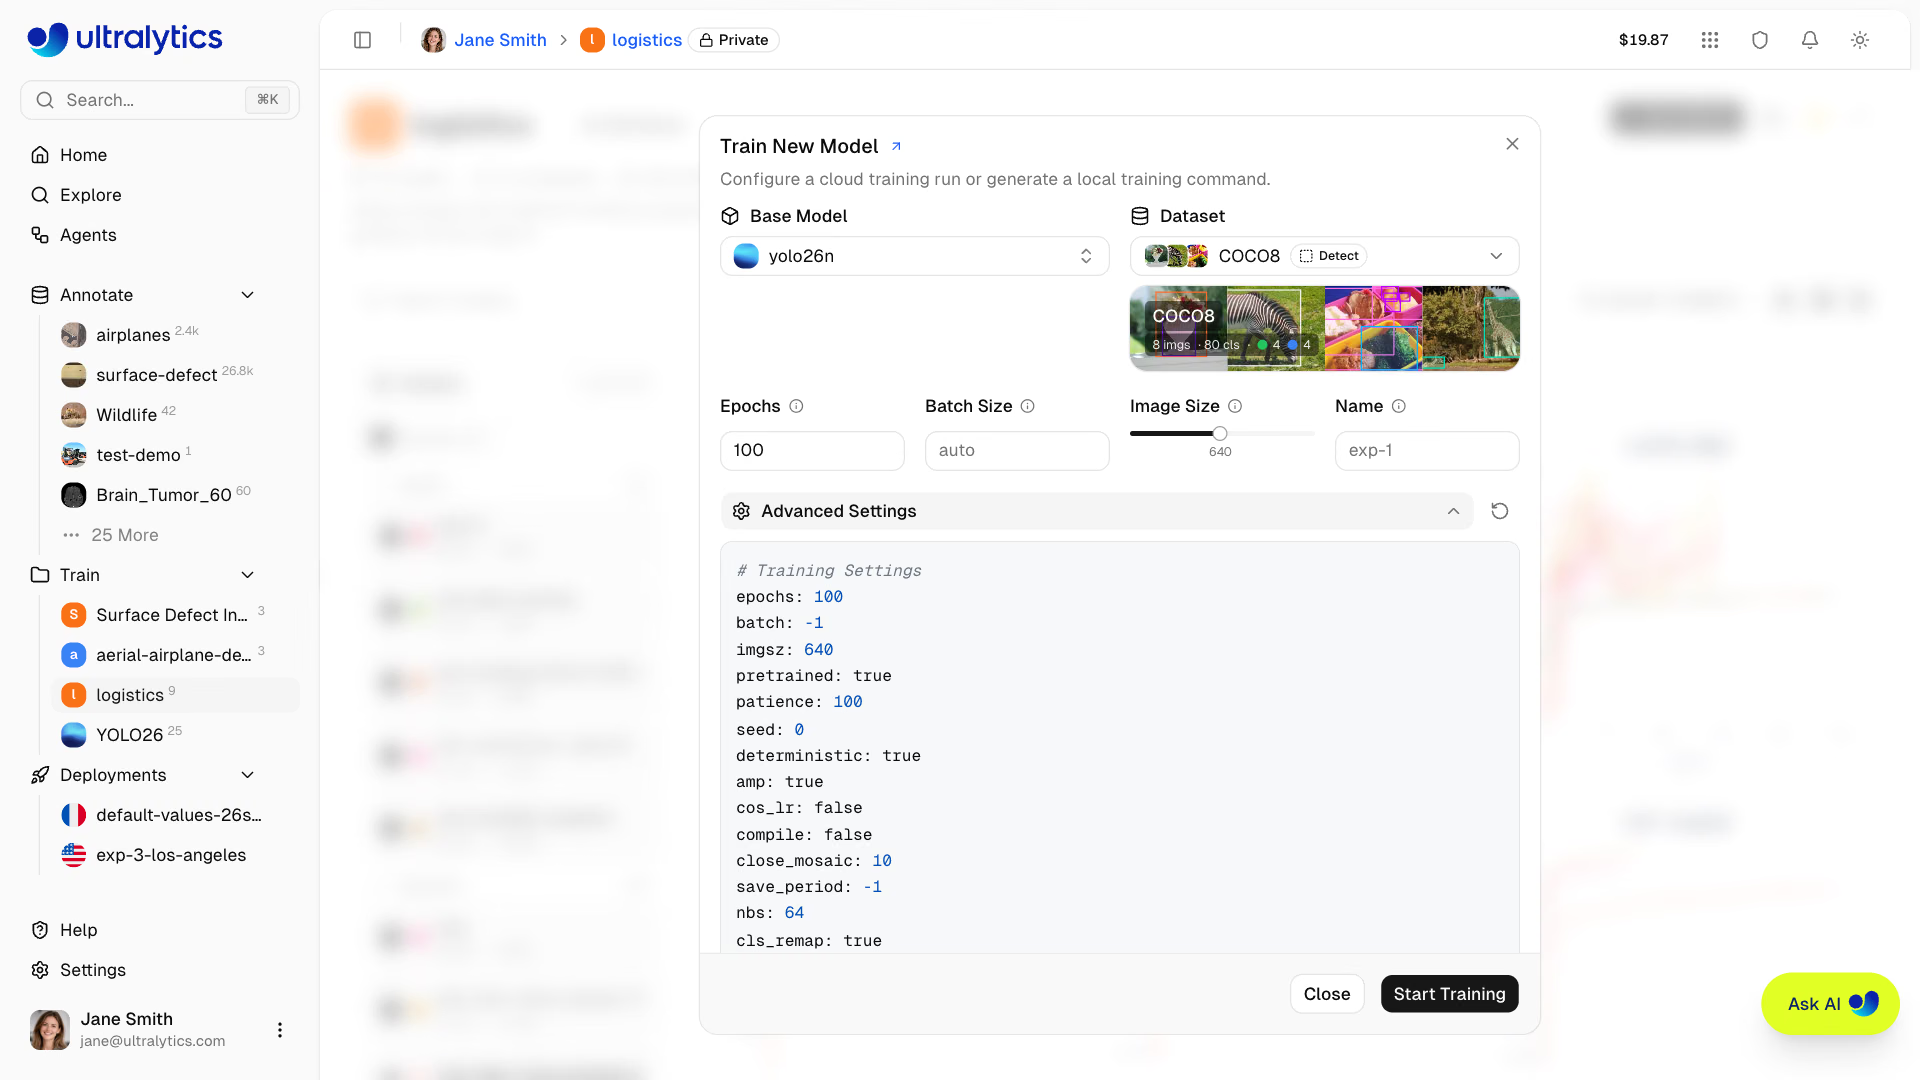
Разверни раздел Дополнительные настройки, чтобы открыть редактор параметров на основе YAML. В разделах Настройки обучения и Аугментации изображений доступны более 50 параметров обучения (см. справочник по конфигурации):
| Группа | Параметры |
|---|---|
| Скорость обучения | lr0, lrf, momentum, weight_decay, warmup_epochs, warmup_momentum, warmup_bias_lr |
| Оптимизатор | auto (по умолчанию), SGD, MuSGD, Adam, AdamW, NAdam, RAdam, RMSProp, Adamax |
| Веса функции потерь | box, cls, cls_pw, dfl, pose, kobj, rle, angle, dlog, dgrad, dlam |
| Цветовая аугментация | hsv_h, hsv_s, hsv_v |
| Геометрическая аугментация | degrees, translate, scale, shear, perspective |
| Аугментация отражением и смешиванием | flipud, fliplr, mosaic, mixup, copy_paste, bgr, cutmix, copy_paste_mode, auto_augment, erasing |
| Управление обучением | epochs, batch, imgsz, pretrained, patience, seed, deterministic, amp, cos_lr, compile, close_mosaic, save_period, nbs, cls_remap, channels_last, profile, overlap_mask, mask_ratio |
| Датасет | fraction, freeze, single_cls, rect, multi_scale, resume |
| Валидация | max_det |
Параметры зависят от задачи (например, copy_paste отображается только для задач сегментации, семантической сегментации и OBB, pose/kobj — только для задач оценки позы, а auto_augment/erasing — только для классификации). Редактор не отображает device, cache, workers, iou, dropout, val и time и игнорирует их в конфигурациях, вставленных или перетащенных в редактор; укажи их в собственной команде yolo train при локальном обучении. Значок Изменено появляется, если значения отличаются от значений по умолчанию; нажми кнопку сброса, чтобы вернуть все значения по умолчанию. В задачу обучения передаются только расширенные параметры, отличающиеся от значений по умолчанию (базовые параметры epochs, batch и размера изображения передаются всегда), поэтому итоговая команда остается удобочитаемой.
Пример: настройка аугментации для небольших датасетов
Для небольших датасетов (<1000 изображений) увеличь аугментацию, чтобы снизить переобучение:
mosaic: 1.0       # Keep mosaic on
mixup: 0.3        # Add mixup blending
copy_paste: 0.3   # Add copy-paste (segment, semantic, OBB)
fliplr: 0.5       # Horizontal flip
degrees: 10.0     # Slight rotation
scale: 0.9        # Aggressive scaling
Сохранить версию датасета (необязательно)#
Включи параметр Сохранить версию датасета, чтобы связать модель с неизменяемой версией датасета, размещенного на Платформе. Платформа проверяет, изменилось ли содержимое датасета, повторно использует совпадающую версию, если изменений нет, и создает новую версию с номером, только если это необходимо. При обучении используется именно этот снимок NDJSON, а номер версии и хеш содержимого записываются в данные модели.
Так сохраняются данные, использованные при запуске, даже если позднее ты добавишь или удалишь изображения, отредактируешь аннотации или изменишь разделение датасета. Связанную версию можно найти на вкладках Модели и Версии датасета.
Параметр Сохранить версию датасета недоступен для подключенного облачного хранилища и локальных датасетов On Premise. Также ты можешь создавать снимки вручную на вкладке «Версии».
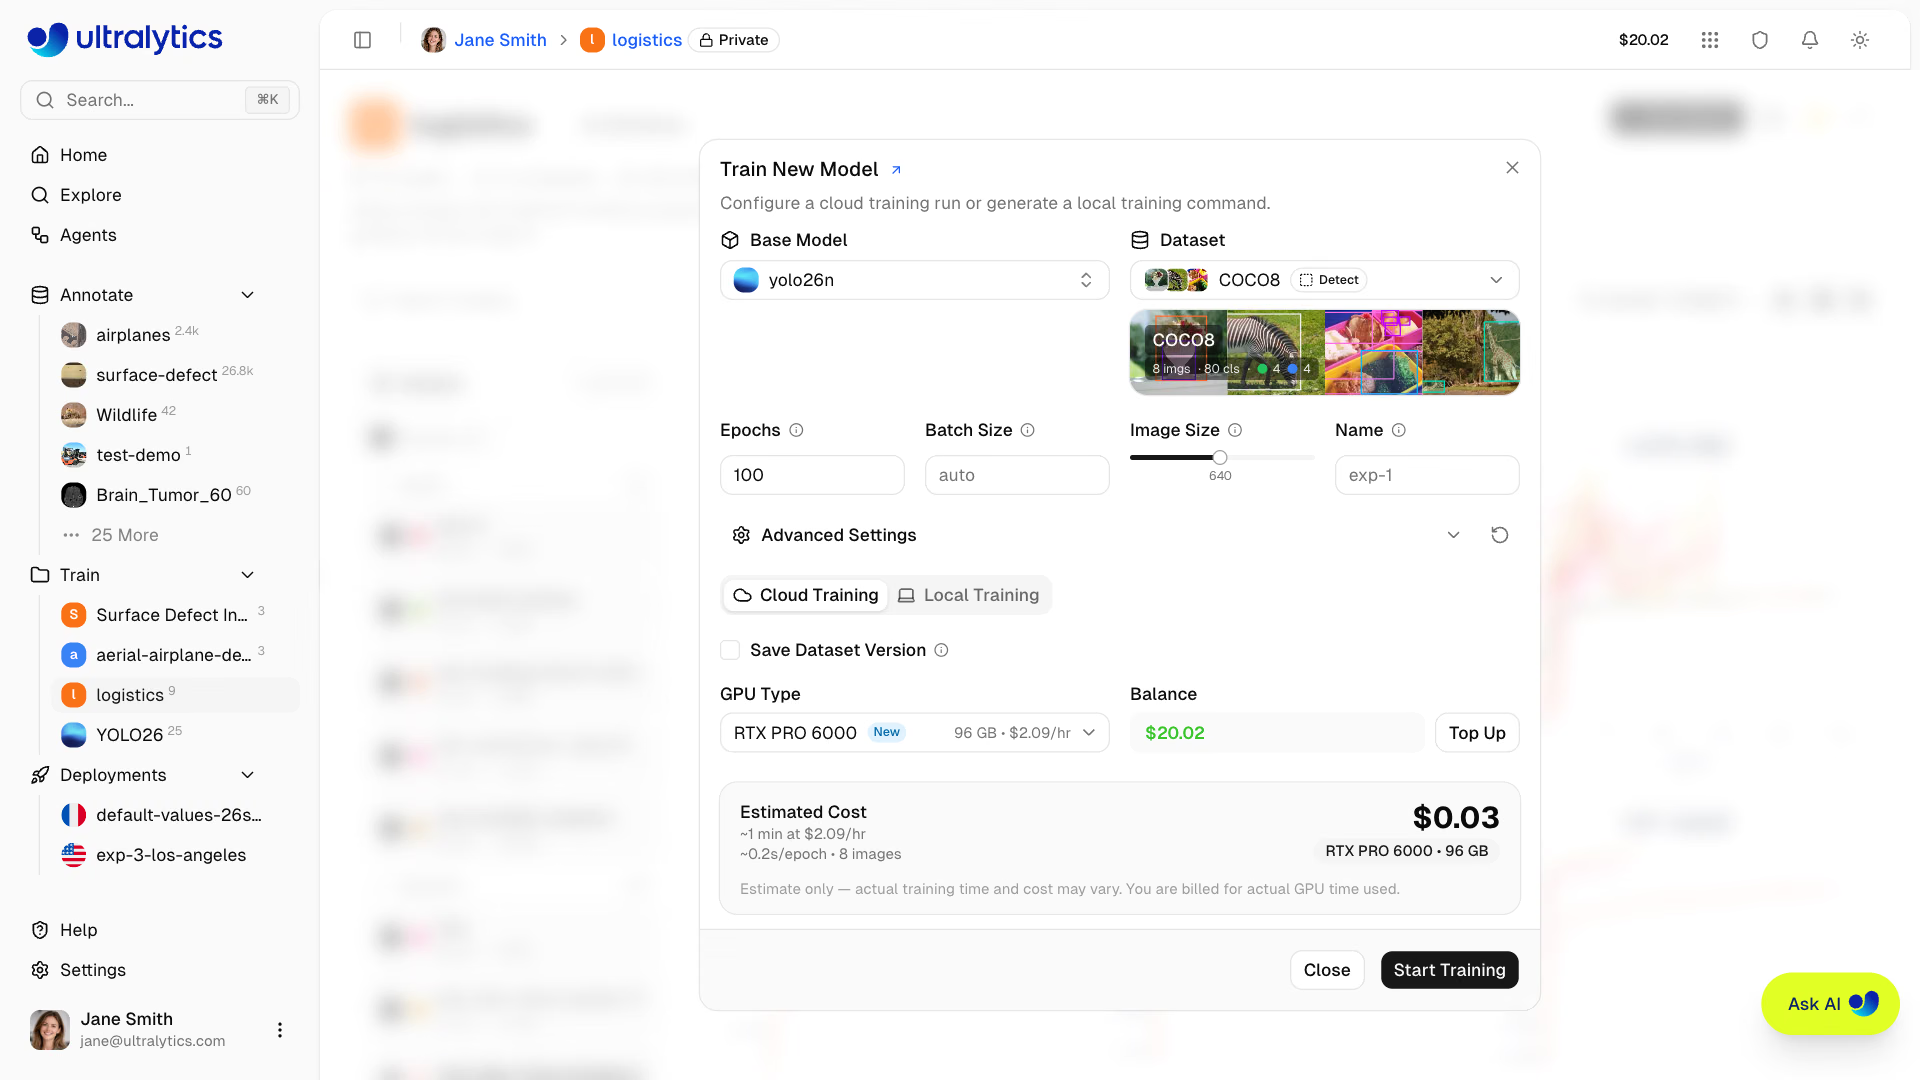
Шаг 5. Выбери GPU (вкладка «Облако»)#
Выбери GPU в Ultralytics Cloud:
| GPU | Поколение | Видеопамять | Стоимость/час | Оптимальный вариант для |
|---|---|---|---|---|
| RTX 2000 Ada | Ada | 16 GB | $0.24 | Небольшие датасеты, тестирование |
| RTX A4500 | Ampere | 20 GB | $0.25 | Небольшие и средние датасеты |
| RTX 4000 Ada | Ada | 20 GB | $0.26 | Средние датасеты |
| RTX A5000 | Ampere | 24 GB | $0.27 | Средние датасеты |
| L4 | Ada | 24 GB | $0.39 | Оптимизирована для инференса |
| A40 | Ampere | 48 GB | $0.44 | Больший размер батча |
| RTX 3090 | Ampere | 24 GB | $0.46 | Обучение общего назначения |
| RTX A6000 | Ampere | 48 GB | $0.49 | Большие модели |
| RTX PRO 4000 | Blackwell | 24 GB | $0.57 | Бюджетный вариант Blackwell |
| RTX PRO 4500 | Blackwell | 32 GB | $0.64 | Отличное соотношение цены и производительности |
| RTX 4090 | Ada | 24 GB | $0.69 | Лучшее соотношение цены и производительности |
| RTX 6000 Ada | Ada | 48 GB | $0.77 | Обучение с большим размером батча |
| L40S | Ada | 48 GB | $0.86 | Обучение с большим размером батча |
| RTX PRO 5000 | Blackwell | 48 GB | $0.96 | Обучение с большим размером батча |
| RTX 5090 | Blackwell | 32 GB | $0.99 | Последнее поколение потребительских GPU |
| L40 | Ada | 48 GB | $0.99 | Большие модели |
| A100 PCIe | Ampere | 80 GB | $1.39 | Обучение для production-среды |
| A100 SXM | Ampere | 80 GB | $1.49 | Обучение для production-среды |
| RTX PRO 6000 | Blackwell | 96 GB | $2.09 | Рекомендуемый вариант по умолчанию |
| H100 PCIe | Hopper | 80 GB | $2.89 | Высокопроизводительное обучение |
| H100 NVL | Hopper | 94 GB | $3.19 | Максимальной производительности |
| H100 SXM | Hopper | 80 GB | $3.29 | Самое быстрое обучение |
| H200 NVL | Hopper | 143 GB | $3.39 | Максимальный объем памяти |
| H200 SXM | Hopper | 141 GB | $4.39 | Максимальной производительности |
| B200 | Blackwell | 180 GB | $5.89 | Крупные модели (Pro+) |
| B300 | Blackwell | 288 GB | $7.39 | Самые крупные модели (Pro+) |
- RTX PRO 6000: 96 ГБ Blackwell — рекомендуемый вариант по умолчанию для большинства задач
- A100 SXM: 80 ГБ HBM2e — отличный выбор для больших размеров батча или крупных моделей
- H100 PCIe / H100 SXM / H100 NVL: 80–94 ГБ Hopper для обучения, когда важна скорость (доступны на всех тарифах)
- H200 NVL / H200 SXM: 141–143 ГБ Hopper для задач с высокими требованиями к памяти (доступны на всех тарифах)
- B200 / B300: 180–288 ГБ NVIDIA Blackwell для самых передовых задач — требуется тариф Pro или Enterprise
В диалоговом окне отображаются текущий баланс и кнопка Пополнить. Карточка стоимости рассчитывает общую продолжительность и цену для твоей конфигурации (размер модели, количество изображений в датасете, эпохи, размер изображения, размер батча, оптимизатор и скорость GPU), а также показывает расчетное время одной эпохи и количество изображений в датасете.
Список GPU отражает текущие запасы облачных ресурсов, поэтому варианты, которых сейчас нет в наличии, помечены соответствующим образом. Если задачу все же не удается разместить на выбранном GPU, Платформа сообщает о нехватке ресурсов и переключает выбор на ближайший доступный GPU — сначала по объему VRAM, затем по скорости и цене — и указывает новый объем VRAM и почасовую ставку, чтобы ты мог сразу запустить задачу или выбрать другой вариант.
Если выбрать GPU дешевле RTX PRO 6000, задача может выполняться на инфраструктуре под управлением Ultralytics. Когда такие ресурсы свободны, задача запускается на RTX PRO 6000, но тарифицируется по ставке выбранного GPU. Поэтому задача может завершиться быстрее и обойтись дешевле, чем при запуске на выбранном тобой GPU; такое повышение никогда не замедляет выполнение и не увеличивает стоимость.
Шаг 6. Запусти обучение#
Нажми Начать обучение, чтобы запустить задачу. Платформа:
- Определяет неизменяемую версию датасета, если включен параметр Сохранить версию датасета
- Выделяет экземпляр GPU
- Скачивает датасет
- Начинает обучение
- Передает метрики в реальном времени
При повторном обучении существующей модели используется та же страница модели, а после создания новой задачи очищаются графики предыдущего запуска, вывод консоли, системные метрики и состояние ошибки. Если запуск завершается с ошибкой до выделения вычислительных ресурсов, предыдущие результаты остаются без изменений.
Жизненный цикл задачи обучения#
Задача обучения проходит следующие этапы:
| Статус | Описание |
|---|---|
| Запуск | Задача отправлена; выделяется GPU, скачиваются датасет и модель |
| Выполняется | Обучение выполняется, метрики передаются в реальном времени |
| Завершено | Обучение успешно завершено |
| Сбой | Ошибка обучения (подробности см. в журналах консоли) |
| Отменено | Пользователь отменил обучение |
Критическая ошибка Python в потоке консоли — трассировка стека, ошибка нехватки памяти CUDA или сбой инициализации CUDA — немедленно завершает запуск, не дожидаясь тайм-аута. Извлеченное сообщение отображается на странице модели в баннере ошибки с действиями Посмотреть полный журнал консоли и Повторить обучение. Запуски, которые не сообщают о действиях в течение 4 часов, автоматически помечаются как завершившиеся с ошибкой, а выделенные для них вычислительные ресурсы освобождаются.
Чтобы получать результаты успешных и неудачных запусков, не оставляя эту страницу открытой, подключи уведомления Slack.
Новые аккаунты получают приветственные кредиты: $5 для личной почты и $25 для корпоративной. Проверь баланс в разделе «Настройки» > «Оплата».
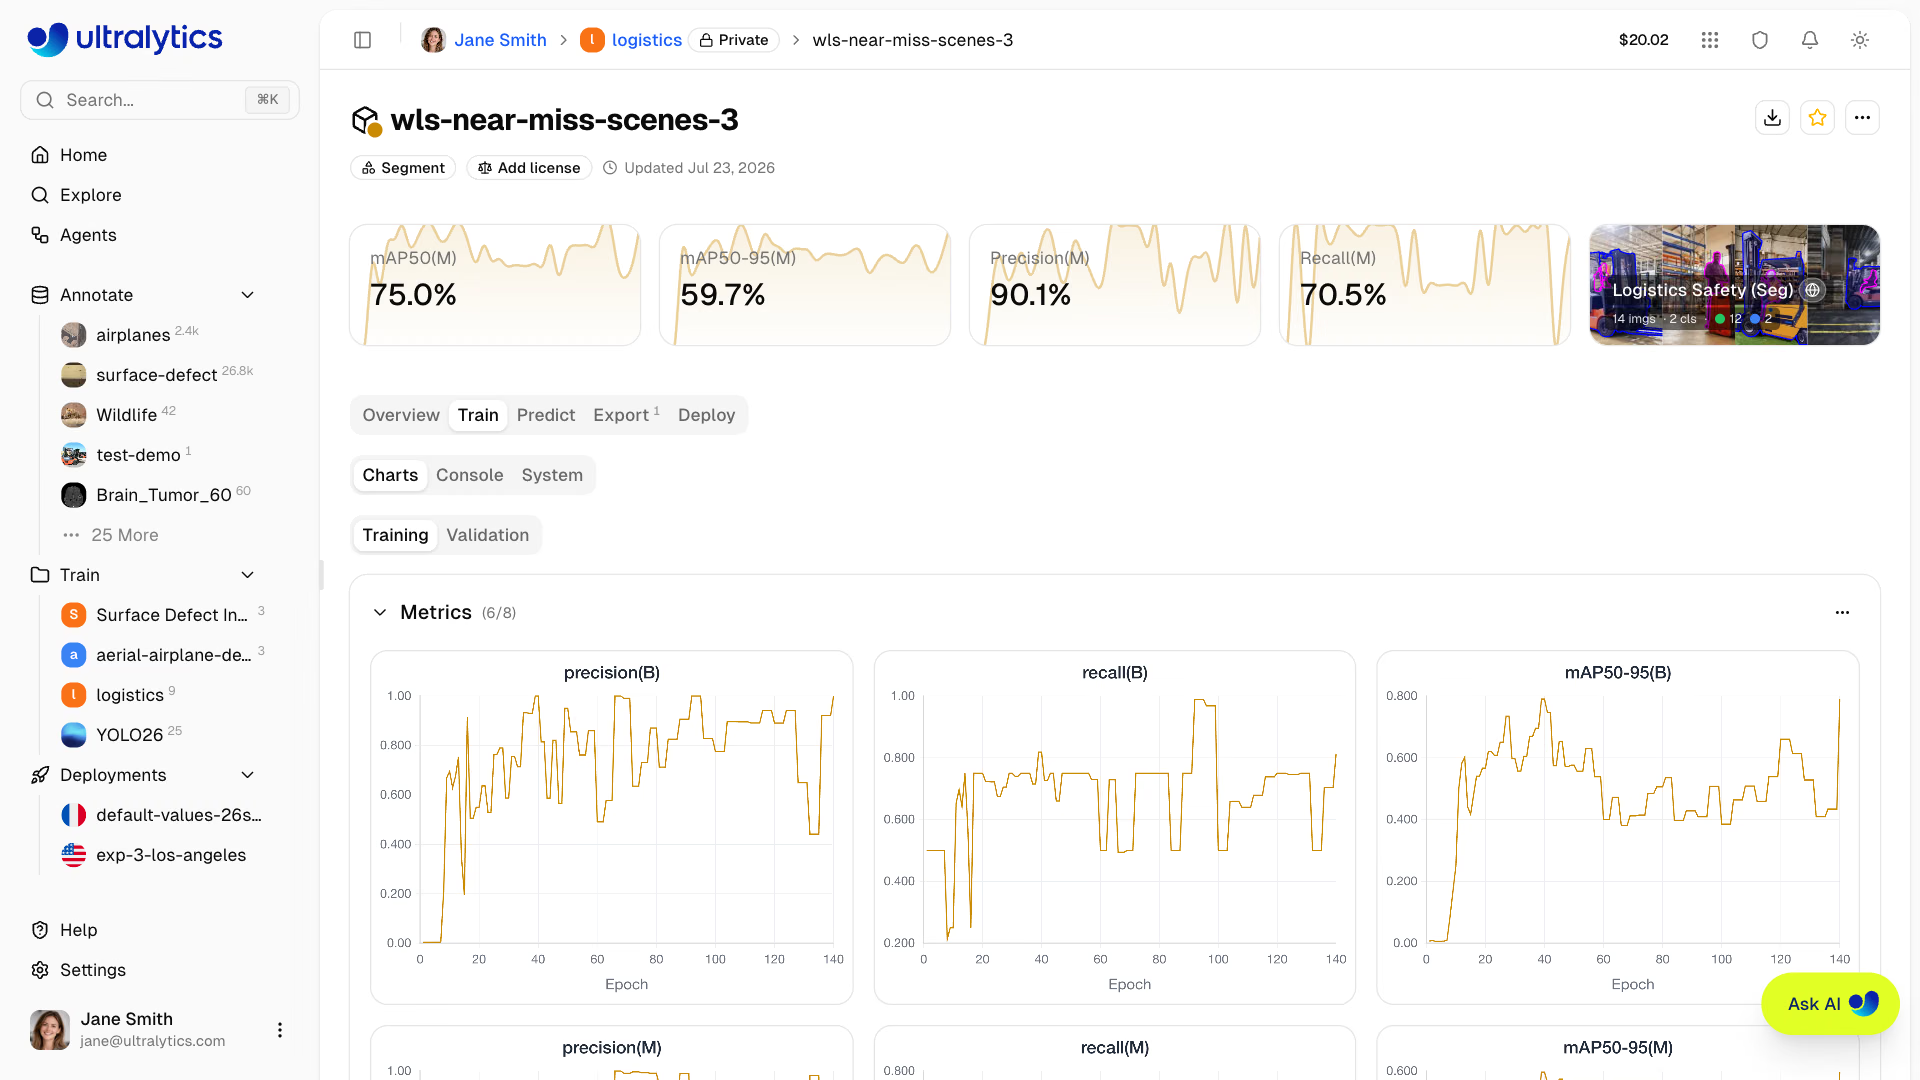
Следи за ходом обучения#
Следи за ходом обучения в реальном времени на вкладке Обучение страницы модели:
Подкладка «Графики»#
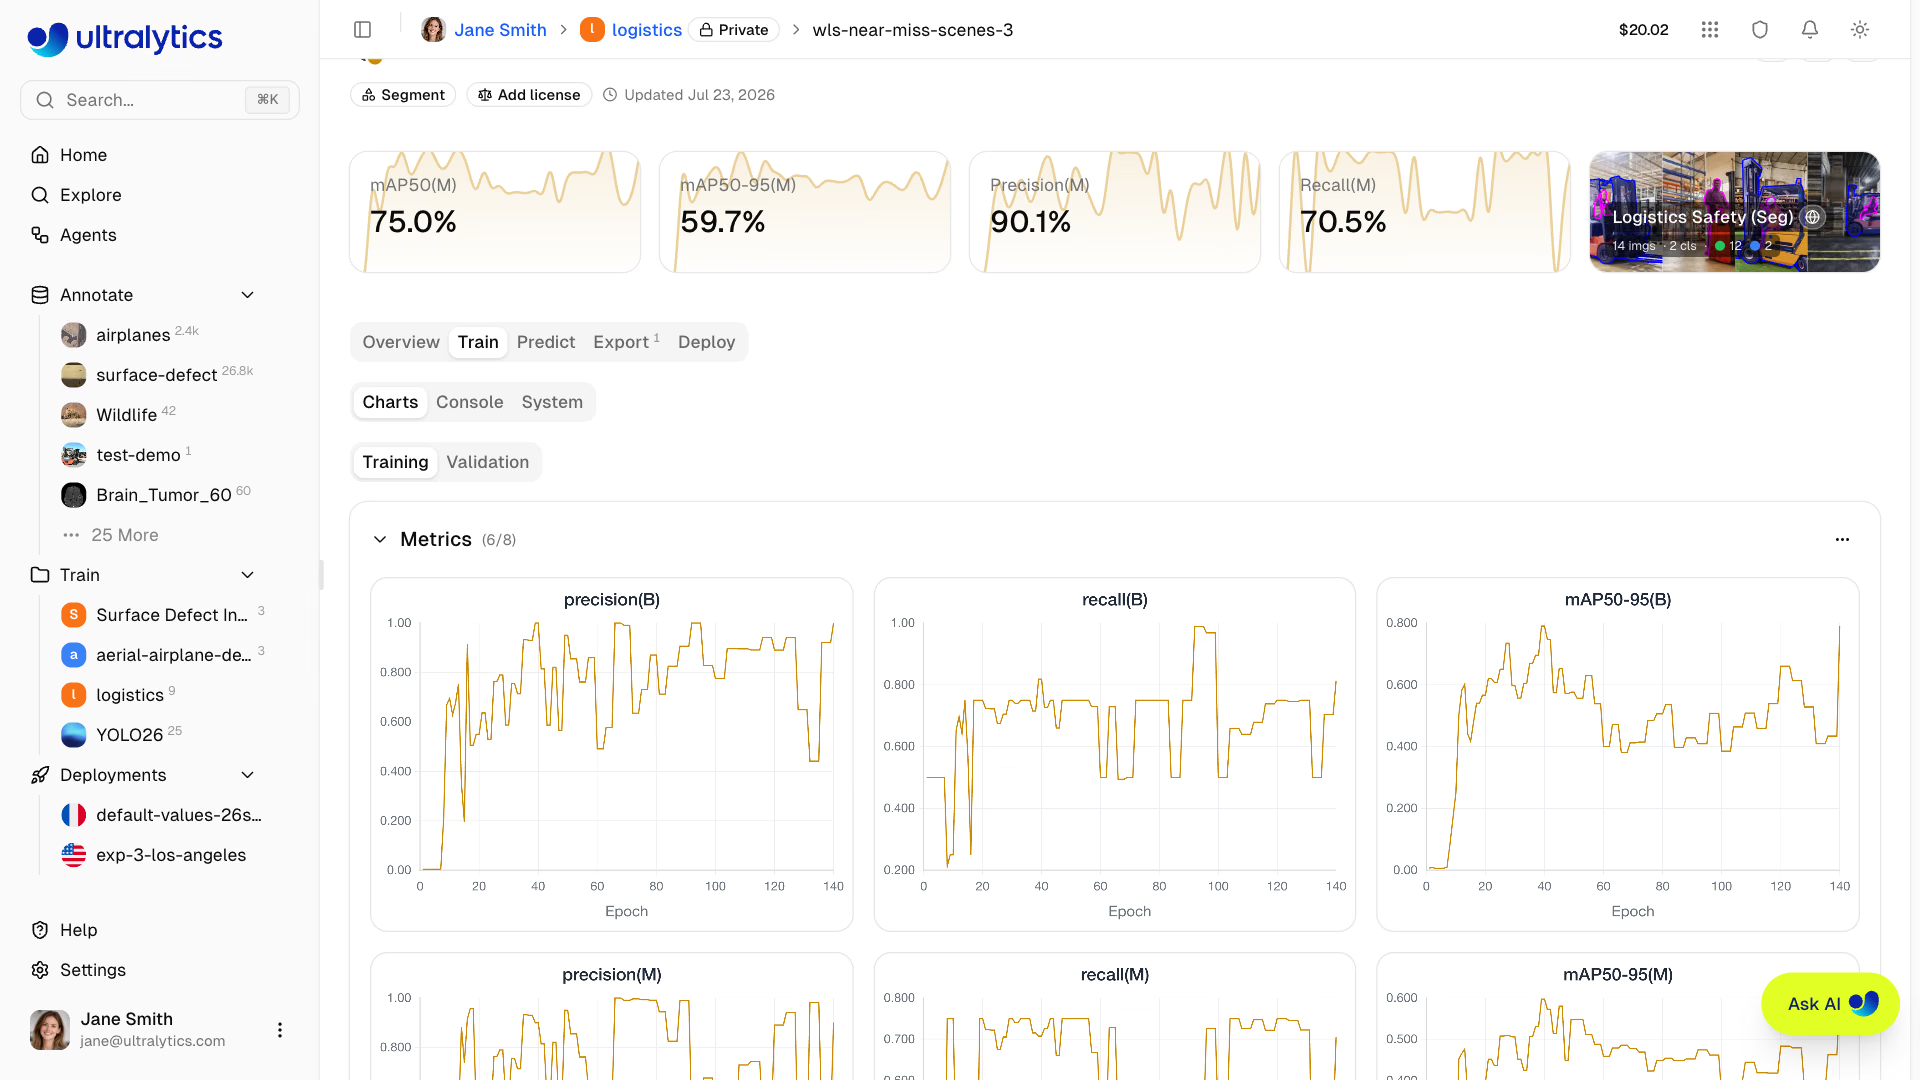
Графики сгруппированы по типам метрик; отображаемые группы зависят от того, какие данные передает запуск:
| Группа | Содержимое |
|---|---|
| Метрики | Метрики задачи — mAP50, mAP50-95, точность и полнота для детекции; метрики для других задач см. в разделе «Модели» |
| Потери | Отдельный график для каждого компонента функции потерь: сплошная линия для обучения и пунктирная — для валидации |
| Скорость обучения | lr/pg0, lr/pg1, lr/pg2 |
Каждую группу можно свернуть, отдельные графики — скрыть или показать через меню группы, а графики можно перетаскивать и изменять их размер. Настройки расположения сохраняются.
Вкладка Console#
Вывод консоли в реальном времени с поддержкой цветов ANSI, индикаторами выполнения и обнаружением критических ошибок. Сохраняются последние 2000 строк; отображение временных меток можно включить, а весь журнал — скопировать как обычный текст.
Вкладка System#
Карточка узла в реальном времени (имя хоста, CPU, GPU, объем RAM и диска), а также графики загрузки CPU и RAM, использования и памяти GPU, температуры GPU, сетевого ввода-вывода и операций чтения-записи диска для каждой эпохи.
Контрольные точки#
Лучшая контрольная точка (best.pt) периодически загружается на Платформу во время обучения и еще раз по завершении запуска, поэтому для скачивания, экспорта и развертывания всегда доступна лучшая из полученных эпох. Если запуск отменен, контрольная точка, загруженная до отмены, сохраняется.
Отмена обучения#
Нажми Отмена в карточке «Информация о запуске» на странице модели и подтверди действие. При обучении в облаке Платформа останавливает задачу, освобождает вычислительные ресурсы и списывает средства за время использования GPU до отмены. При локальном обучении процесс получает сигнал остановиться на границе следующей эпохи, а частичные результаты сохраняются — перед завершением запуск загружает все полученные данные.
Удаленное обучение#
Обучай модель на собственном оборудовании и передавай метрики на платформу.
Для интеграции с Платформой требуются Python>=3.11 и ultralytics>=8.4.120. Более старые версии не будут работать с Платформой.
pip install -U ultralyticsНастройка API-ключа#
- Перейди в
Settings > API Keys - Создай новый ключ (или дождись, пока платформа создаст его автоматически при открытии вкладки «Локальное обучение»)
- Задай переменную окружения:
export ULTRALYTICS_API_KEY="YOUR_API_KEY"Обучение с передачей данных#
Используй параметры project и name, чтобы передавать метрики:
yolo train model=yolo26n.pt data=coco.yaml epochs=100 \
  project=username/my-project name=experiment-1
На вкладке Локальное обучение в диалоговом окне обучения отображается готовая команда с твоим API-ключом, выбранными параметрами и расширенными аргументами.
Использование датасетов на Платформе#
Обучай модель на датасетах, сохраненных на платформе, используя формат URI ul://:
yolo train model=yolo26n.pt data=ul://username/datasets/my-dataset epochs=100 \
  project=username/my-project name=exp1
Формат URI ul:// автоматически скачивает и настраивает датасет. Модель автоматически связывается с датасетом на платформе (см. раздел «Использование датасетов на Платформе»).
Оплата#
Стоимость обучения зависит от использования GPU:
Расчет стоимости#
Перед началом обучения платформа рассчитывает общую продолжительность и стоимость с учетом размера датасета и модели, размера изображения и батча, количества эпох и выбранного GPU. Расчет приблизительный; оплата начисляется за фактическое использование.
Факторы, влияющие на стоимость:
| Фактор | Влияние |
|---|---|
| Размер датасета | Больше изображений = дольше обучение (вычислительная нагрузка растет примерно пропорционально размеру датасета) |
| Размер модели | Крупные модели (m, l, x) обучаются медленнее, чем модели (n, s) |
| Количество эпох | Напрямую увеличивает время обучения |
| Размер изображения | Увеличение imgsz существенно повышает вычислительную нагрузку: для 1280px требуется в несколько раз больше ресурсов, чем для 640px |
| Размер батча | Обучение с большими батчами эффективнее, чем с маленькими |
| Скорость GPU | Более быстрые GPU сокращают время обучения, частично компенсируя более высокую почасовую ставку |
| Оптимизатор | MuSGD работает примерно вдвое медленнее других оптимизаторов |
| Время запуска | До 5 минут на инициализацию экземпляра, скачивание данных и прогрев (время увеличивается вместе с размером датасета) |
Расчеты основаны на реальных запусках обучения в облаке и всегда учитывают выбранный тобой GPU, поэтому задача, перенаправленная на более быструю инфраструктуру Ultralytics, завершается раньше расчетного срока.
Примеры стоимости#
Оценка стоимости приблизительна и зависит от многих факторов. Перед началом обучения в диалоговом окне отображается оценка в реальном времени.
| Сценарий | GPU | Расчетная стоимость |
|---|---|---|
| 500 изображений, YOLO26n, 50 эпох | RTX 4090 | ~$0.03 |
| 1000 изображений, YOLO26n, 100 эпох | RTX PRO 6000 | ~$0.23 |
| 5000 изображений, YOLO26s, 100 эпох | H100 SXM | ~$1.56 |
Процесс оплаты#
Процесс оплаты облачного обучения:
- Оценка: стоимость рассчитывается до начала обучения
- Проверка баланса: перед запуском проверяется доступный баланс кредитов
- Обучение и учет времени: задача выполняется на выбранных вычислительных ресурсах, а накопленное время работы GPU списывается с баланса поэтапно, пока задача выполняется
- Окончательный расчет: при завершении задачи списывается оставшееся время, а за весь запуск создается одна транзакция Training
При оплате учитывается фактическое время работы GPU, включая частичные запуски, которые отменены или завершились с ошибкой после запуска облачного GPU.
Оплата в зависимости от статуса задачи#
| Статус | Оплата? |
|---|---|
| Завершено | Да — за фактическое время работы GPU |
| Отменено | Да — за время работы GPU с момента запуска до отмены |
| Сбой | Да, если запущены облачные вычисления — за прошедшее время работы GPU |
| Зависла | Да — за прошедшее время работы GPU до автоматического завершения |
Если запуск не передает данные об активности в течение 4 часов, он автоматически помечается как завершившийся с ошибкой; экземпляр завершается, а прошедшее время работы GPU учитывается в итоговом расчете. Удаленные запуски на собственном оборудовании просто помечаются как завершившиеся с ошибкой — оплата не взимается.
Если проверка или запуск завершились с ошибкой до старта облачного GPU, оплачивать вычисления не нужно. После запуска GPU завершенные, отмененные, неудачные и автоматически завершенные задачи учитываются в итоговом расчете по фактическому времени работы GPU.
Способы оплаты#
Облачное обучение оплачивается кредитами на балансе платформы.
Для начала обучения нужен положительный доступный баланс и достаточное количество кредитов для оплаты расчетной стоимости задачи; при этом в каждой оценке резервируется не менее 15 минут работы GPU. Если одновременно выполняется несколько запусков, проверка также учитывает еще не оплаченное время этих запусков.
Просмотр стоимости обучения#
Перед запуском облачной задачи в диалоговом окне обучения отображаются текущий баланс кредитов и оценка длительности и стоимости задачи, рассчитанная с учетом выбранной модели, набора данных, количества эпох, размера изображения и GPU. Оценка носит справочный характер; фактическая оплата рассчитывается по использованному времени GPU. После завершения проверь транзакцию по кредитам в разделе Settings > Billing.
Советы по обучению#
Выбери подходящий размер модели#
| Модель | Параметры | Оптимальный вариант для |
|---|---|---|
| YOLO26n | 2.4M | Работа в реальном времени, устройства на периферии |
| YOLO26s | 9.5M | Баланс скорости и точности |
| YOLO26m | 20.4M | Более высокая точность |
| YOLO26l | 24.8M | Точность для промышленной эксплуатации |
| YOLO26x | 55.7M | Максимальная точность |
Оптимизация времени обучения#
- Начни с малого: проверь на недорогом GPU работу набора данных и конфигурации, запустив обучение на 10–20 эпох
- Выбери подходящий GPU: RTX PRO 6000 хорошо справляется с большинством задач
- Проверь набор данных: исправь ошибки разметки до начала затрат на обучение
- Следи за обучением с самого начала: отмени обучение, если функция потерь перестала снижаться — ты платишь только за использованное вычислительное время
Устранение неполадок#
| Проблема | Решение |
|---|---|
| Обучение зависло на 0% | Проверь формат набора данных и повтори попытку |
| Недостаточно памяти | Уменьши размер пакета или используй GPU с большей памятью |
| Низкая точность | Увеличь количество эпох, проверь качество данных |
| Обучение идёт медленно | Попробуй использовать более быстрый GPU |
| Несоответствие типа задачи | Убедись, что типы задач модели и набора данных совпадают |
Справочник по параметрам обучения#
| Параметр | Тип | По умолчанию | Диапазон | Описание |
|---|---|---|---|---|
epochs | int | 100 | 1-10000 | Количество эпох обучения |
batch | int/float | -1 (авто) | -1, 0-1 или >=1 | Размер пакета (-1 = автоматическая подстройка под доступную VRAM, 0-1 = доля памяти GPU) |
imgsz | int | 640 | 32-4096 | Размер входного изображения |
pretrained | bool | True | - | Начинать с предварительно обученных весов, а не со случайной инициализации |
patience | int | 100 | 0-1000 | Терпение при ранней остановке (0 отключает ее) |
time | float | null | 0.1-720 | Ограничение времени обучения в часах; имеет приоритет над количеством эпох |
seed | int | 0 | 0-2147483647 | Случайное начальное значение для воспроизводимости |
deterministic | bool | True | - | Детерминированный режим обучения |
amp | bool/str | True | true/false/fp16/bf16/fp32 | Точность обучения |
compile | bool | False | - | Компиляция с помощью torch.compile (первая эпоха выполняется медленнее) |
close_mosaic | int | 10 | >=0 | Отключать мозаику в последних N эпохах |
save_period | int | -1 | >=-1 | Сохранять контрольную точку каждые N эпох |
device | выбор | авто | auto/0/cpu/mps | Устройство для обучения |
workers | int | 8 | 0-64 | Количество рабочих процессов загрузчика данных |
cache | выбор | false | ram/disk/false | Кэшировать изображения |
dropout | float | 0.0 | 0.0-1.0 | Dropout классификационной головы (только для классификации) |
iou | float | 0.7 | 0.1-0.9 | Порог IoU для NMS при валидации |
max_det | int | 300 | 1-10000 | Максимальное количество обнаружений на изображение |
Некоторые параметры применяются только к определённым задачам:
- Обнаружение, сегментация, поза и OBB:
box,cls,dfl,single_cls,iou,max_det - Все задачи, кроме глубины и классификации (обнаружение, сегментация, семантическая сегментация, поза, obb):
mosaic,mixup,close_mosaic - Все задачи, кроме классификации (обнаружение, сегментация, семантическая сегментация, глубина, поза, obb):
degrees,translate,shear,perspective - Сегментация, семантическая сегментация и OBB:
copy_paste - Только глубина:
dlog,dgrad,dlam - Только классификация:
dropout - Только поза:
pose(вес функции потерь),kobj(объектность ключевых точек),rle - Только OBB:
angle
Часто задаваемые вопросы#
Время обучения зависит от:
- Размер датасета
- Размер модели
- Количества эпох
- Выбранный GPU
Ориентировочное время (1000 изображений, 100 эпох):
Модель RTX PRO 6000 A100 SXM YOLO26n ~6 мин ~5 мин YOLO26m ~15 мин ~12 мин YOLO26x ~30 мин ~25 мин Примерное времяВремя обучения указано приблизительно и зависит от сложности датасета, настроек аугментации и размера батча. Для более точной оценки используй прогноз стоимости в диалоговом окне обучения.
Да. Обучение может идти без присмотра, пока на него хватает средств; Платформа зафиксирует событие завершения или сбоя. Если из-за списания средств баланс станет отрицательным, активные платные облачные запуски остановятся, а стоимость уже использованного времени GPU будет списана.
Стоимость облачных вычислений списывается по мере выполнения обучения. Если списание приведёт к отрицательному балансу, активные платные облачные запуски обучения будут остановлены, а стоимость уже использованного времени GPU будет списана. Пополни баланс или включи автоматическое пополнение, чтобы средств хватило на длительные задания.
Отрицательный балансНулевой или отрицательный баланс не позволяет запускать новые платные облачные задания обучения. Отрицательный баланс при оплате по факту также приводит к остановке активных платных облачных запусков обучения.
Оценка стоимости приблизительная — фактическое время обучения может отличаться из-за таких факторов, как скорость загрузки данных, прогрев GPU и сходимость модели. Если фактические расходы исчерпают доступный баланс, Платформа остановит активные платные облачные запуски, когда баланс станет отрицательным.
Чтобы контролировать расходы:
- Следи за ходом обучения в реальном времени и при необходимости досрочно отмени его
- Включи автоматическое пополнение, чтобы кредиты пополнялись автоматически
- Начни с коротких запусков (с меньшим количеством эпох), чтобы оценить ожидаемые результаты
Да, разверни раздел Дополнительные настройки в диалоговом окне обучения, чтобы открыть редактор YAML с более чем 50 настраиваемыми параметрами. Значения, отличающиеся от стандартных, будут включены в команды как для облачного, так и для локального обучения.
Редактор YAML также позволяет импортировать конфигурации из предыдущих запусков обучения:
- Скопировать из существующей модели: На странице любой завершённой модели в карточке «Конфигурация обучения» есть меню Экспорт данных с пунктом Копировать JSON. Вставь JSON прямо в редактор YAML — он автоматически распознает формат JSON и импортирует все параметры. В этом же меню можно скачать конфигурацию в формате CSV или JSON.
- Вставить YAML или JSON: Вставь в редактор любую корректную конфигурацию обучения в формате YAML или JSON. Параметры проверяются автоматически: значения за пределами диапазона ограничиваются допустимыми, а редактор отображает предупреждения.
- Перетащить файлы: Перетащи файл
.yamlили.jsonпрямо в редактор, чтобы импортировать параметры.
Так можно легко воспроизводить предыдущие конфигурации обучения или вносить в них изменения, не вводя каждый параметр вручную.
При использовании оптимизатора по умолчанию
optimizer: autoсистема обучения сама выбирает оптимизатор и начальную скорость обучения и игнорирует значениеlr0. Чтобы задать собственныеlr0, выбери конкретный оптимизатор, напримерSGDилиAdamW, в разделе Дополнительные настройки. В консоли обучения отображаются выбранные для запуска оптимизатор и скорость обучения; в карточке Конфигурация обучения показаны переданные тобой аргументы, поэтому при использованииautoтам всё ещё может отображатьсяlr0.Да. Для неудачно обученной модели отображается баннер с ошибкой и кнопкой Повторить обучение. Она снова открывает диалоговое окно обучения с той же исходной моделью, датасетом и параметрами, чтобы ты мог изменить одно значение и запустить обучение ещё раз. Повторный запуск использует ту же страницу модели: графики, вывод консоли, системные метрики и ошибка предыдущего запуска очищаются после создания нового задания, а его веса заменяются, когда новый запуск создаёт более качественную контрольную точку.
Да, кнопка Новая модель на странице датасета открывает диалоговое окно обучения с уже выбранным и заблокированным датасетом. Затем выбери проект и модель, чтобы начать обучение.