Bilgisayarlı Görü Modellerini Test Etme#
Giriş#
Model testi, eğitilmiş bir modelin daha önce görülmemiş gerçek dünya verilerindeki (seçilmiş bir kıyaslama veri kümesindeki veriler yerine hareketli, yetersiz aydınlatılmış veya kısmen gizlenmiş nesnelerdeki) performansını kontrol eder. Model değerlendirmesi, etiketli bir veri kümesindeki metrikleri ölçerken test, modelin öğrendiği davranışın dağıtımdan önce uygulamanın hedefleriyle örtüşüp örtüşmediğini doğrular. Bu kılavuzda test verilerini hazırlama, Ultralytics YOLO26 modellerini test etme ve aşırı öğrenme, yetersiz öğrenme ve veri sızıntısını tespit etme konuları ele alınıyor.
İzle: Makine öğrenimi modelleri nasıl test edilir | Bilgisayarlı görüde veri sızıntısını önle 🚀
Model Testi ve Model Değerlendirmesi Karşılaştırması#
Model testi ve model değerlendirmesi, bilgisayarlı görü projesindeki birbirinden farklı iki adımdır. Değerlendirme, etiketli bir veri kümesindeki performansı metriklerle ölçer; test ise modelin öğrendiği davranışın dağıtıma benzer koşullarda da geçerli olup olmadığını kontrol eder.
Kedileri ve köpekleri tanımak üzere bir bilgisayarlı görü modeli eğittiğini ve hayvanları izlemek için bu modeli bir evcil hayvan mağazasında dağıtmak istediğini varsay. Model değerlendirme aşamasında, doğruluk, precision ve recall gibi metrikleri hesaplamak için etiketli bir veri kümesi kullanırsın. Örneğin model, belirli bir veri kümesindeki kedi ve köpekleri ayırt ederken %98 doğruluk gösterebilir.
Değerlendirmeden sonra, kedileri ve köpekleri daha çeşitli ve gerçekçi koşullarda ne kadar iyi tanıdığını görmek için modeli bir evcil hayvan mağazasından alınan görüntülerle test edersin. Hayvanlar hareket hâlindeyken, farklı aydınlatma koşullarındayken veya oyuncak ya da mobilya gibi nesneler tarafından kısmen örtülmüşken modelin kedi ve köpekleri doğru etiketleyip etiketleyemediğini kontrol edersin. Model testi, modelin kontrollü değerlendirme ortamının dışında beklendiği gibi davranıp davranmadığını doğrular.
Model Testine Hazırlanma#
Bilgisayarlı görü veri kümeleri, gerçek dünya koşullarını taklit etmek için genellikle eğitim ve test kümelerine ayrılır: eğitim verileri modeli eğitirken test verileri, modelin daha önce hiç görmediği örneklerdeki davranışını doğrular. Ultralytics Platformu, veri kümesi düzenleme ve etiketlemeyi tek bir yerde tutarak etiketli bir test kümesi oluşturmayı kolaylaştırır.
- Gerçekçi temsil: Daha önce görülmemiş test verileri, dağıtım sırasında modelin işleyeceği verilere benzemelidir. Böylece modelin yetenekleri hakkında gerçekçi bir fikir edinirsin.
- Yeterli boyut: Modelin performansı hakkında güvenilir bilgiler sağlayabilmesi için test veri kümesinin yeterince büyük olması gerekir.
YOLO26 Modelini Test Etme#
Eğitilmiş bir YOLO26 modelini test etmek, birbirini tamamlayan iki iş akışını içerir: nicel metrikler elde etmek için etiketli bir test bölümünde doğrulama yapmak ve davranışını niteliksel olarak incelemek için yeni görüntüler üzerinde tahmin yürütmek.
Etiketli Test Bölümünde Doğrulama Yapma#
Doğrulama modu, model tahminlerini gerçek etiketlerle karşılaştırır ve algılama modelleri için precision, recall, mAP50 ve mAP50-95 değerlerini raporlar. Ayrıca modelin yetersiz performans gösterebileceği belirli alanları fark etmene yardımcı olan karışıklık matrisi ve precision-recall eğrisi gibi görsel yardımcıları da kaydeder.
from ultralytics import YOLO

# Önceden eğitilmiş bir modeli veya kendi eğitilmiş kontrol noktanı yükle; ör. "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Doğrulamayı çalıştır; veri kümesi YAML dosyanda test bölümü tanımlıysa split="test" ekle
metrics = model.val(data="coco8.yaml")
print(metrics.box.map)  # mAP50-95
Doğrulama varsayılan olarak veri kümesinin val bölümünde çalışır. Ayrı tutulan bir test kümesindeki performansı ölçmek için veri kümesi YAML dosyanda bir test: bölümü tanımla ve split="test" değerini ilet.
Yeni Görüntüler Üzerinde Tahmin Yürütme#
Tahmin modu, etiket gerektirmeden yeni ve daha önce görülmemiş veriler üzerinde modeli çalıştırır. Performans metrikleri üretmez; ancak açıklama eklenmiş çıktıları kaydetmek, örneğin bir klasördeki tüm test görüntülerini tek seferde işleyerek modelin gerçek dünya görüntülerindeki davranışını incelemene olanak tanır.
from ultralytics import YOLO

# Önceden eğitilmiş bir modeli veya kendi eğitilmiş kontrol noktanı yükle; ör. "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Bir test görüntüleri klasöründe tahminleri çalıştır ve açıklama eklenmiş sonuçları kaydet
results = model.predict(source="path/to/test_images", save=True)
Özel eğitime zaman ve kaynak ayırmadan önce YOLO26'nın uygulamana uygun olup olmadığını kontrol etmek için kendi görüntülerinde önceden eğitilmiş bir kontrol noktasıyla tahmin modunu çalıştır. Modeller COCO gibi veri kümelerinde önceden eğitildiğinden sonuçlar, modelin kullanım bağlamında ne kadar iyi performans gösterebileceği konusunda hızlı bir fikir verir.
Doğrulama ve Tahmin Modu Karşılaştırması#
| Mod | Amaç | Etiket gerektirir | Çıktı |
|---|---|---|---|
| Doğrulama | Performansı gerçek değerlerle karşılaştırarak ölç | Evet | Precision, recall, mAP50, mAP50-95, karışıklık matrisi, PR eğrileri |
| Tahmin | Modelin yeni ve etiketsiz verilerdeki davranışını incele | Hayır | Açıklama eklenmiş görüntüler ve tahmin sonuçları; metrik yok |
Test Sonuçlarını Analiz Etme#
Tahminler ve metrikler elindeyken modelin nerede ve neden başarısız olduğunu ayrıntılı olarak incele:
- Yanlış sınıflandırılan görüntüler: Modelin nerede hata yaptığını anlamak için yanlış sınıflandırdığı görüntüleri belirle ve incele.
- Hata analizi: Hata türlerini (ör. yanlış pozitifler ve yanlış negatifler) ve olası nedenlerini anlamak için kapsamlı bir hata analizi yap.
- Önyargı ve adalet: Modelin tahminlerinde önyargı olup olmadığını kontrol et. Özellikle veriler ırk, cinsiyet veya yaş gibi hassas özellikler içeriyorsa modelin farklı alt kümelerde eşit derecede iyi performans gösterdiğinden emin ol.
Makine Öğrenmesinde Aşırı ve Yetersiz Öğrenme#
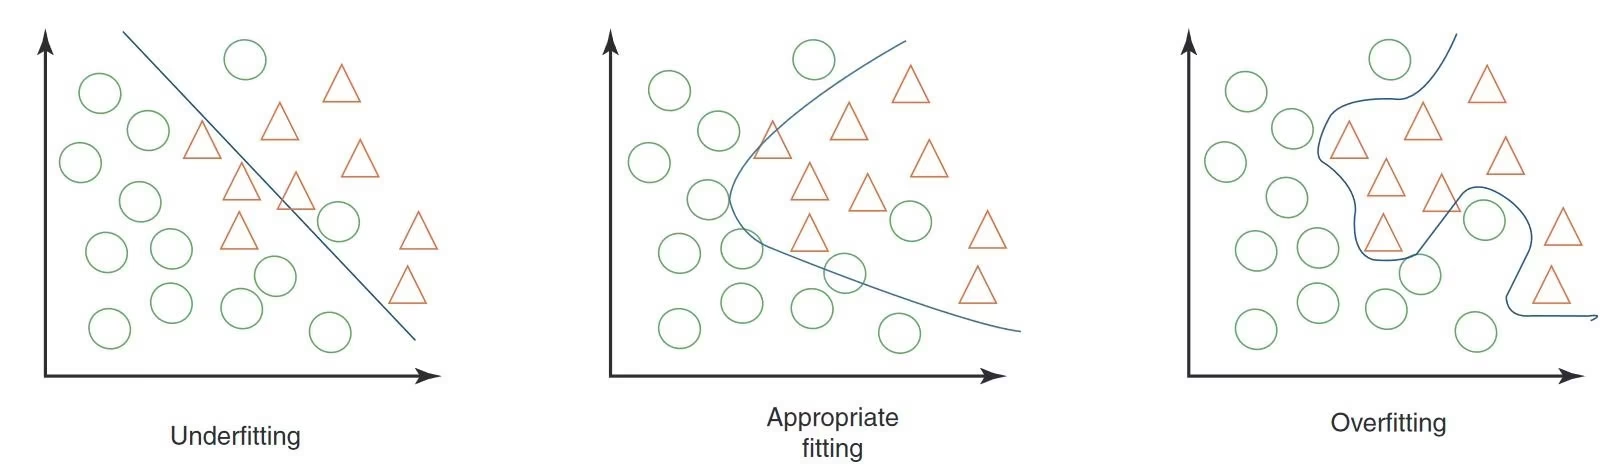
Bir makine öğrenmesi modelini, özellikle bilgisayarlı görü alanında, test ederken aşırı öğrenmeye ve yetersiz öğrenmeye dikkat etmek önemlidir. Bu sorunlar, modelinin yeni verilerdeki performansını önemli ölçüde etkileyebilir.
| Sorun | Yaygın belirtiler | Çözüm yolları |
|---|---|---|
| Aşırı öğrenme | Eğitim doğruluğu yüksek, ancak doğrulama doğruluğu düşük; görüntülerdeki küçük değişikliklere veya ilgisiz ayrıntılara aşırı duyarlılık | Dropout gibi düzenlileştirme yöntemleri uygula, eğitim veri kümesinin boyutunu artır veya model mimarisini basitleştir |
| Yetersiz öğrenme | Eğitim kümesinde bile düşük doğruluk; belirgin özellikleri veya nesneleri tanımada sürekli başarısızlık | Daha karmaşık bir model kullan, daha fazla ilgili özellik sağla veya eğitim epoch sayısını artır |
Önemli olan, modelin hem eğitim hem de doğrulama veri kümelerinde iyi performans göstermesini sağlayacak dengeyi bulmaktır. Metrikleri düzenli olarak izlemek ve test sırasında tahminleri görsel olarak incelemek, modelin iki uçtan birine kaydığını fark etmene yardımcı olur.
Bilgisayarlı Görüde Veri Sızıntısı ve Bunu Önleme Yolları#
Veri sızıntısı, eğitim veri kümesi dışındaki bilgilerin yanlışlıkla modeli eğitmek için kullanılmasıyla ortaya çıkar. Veri sızıntısı olduğunda model eğitim sırasında çok doğru görünebilir, ancak yeni ve daha önce görülmemiş verilerde iyi performans göstermez.
Sızıntıyı tespit etmek zor olabilir ve genellikle eğitim verilerindeki gizli önyargılardan kaynaklanır:
| Önyargı türü | Görünümü |
|---|---|
| Kamera önyargısı | Farklı açılar, aydınlatma, gölgeler ve kamera hareketleri istenmeyen örüntüler oluşturur |
| Yer paylaşımı önyargısı | Görüntülerdeki logolar, zaman damgaları veya diğer yer paylaşımları modeli yanıltır |
| Yazı tipi ve nesne önyargısı | Belirli sınıflarda sıkça görülen yazı tipleri veya nesneler, modelin öğrenmesini çarpıtır |
| Mekânsal önyargı | Ön plan ve arka plan, sınırlayıcı kutu dağılımları ve nesne konumlarındaki dengesizlikler eğitimi etkiler |
| Etiket ve alan önyargısı | Hatalı etiketler veya veri türlerindeki kaymalar sızıntıya yol açar |
Veri Sızıntısı Nasıl Tespit Edilir ve Önlenir#
Veri sızıntısını bulmak için model sonuçlarının şaşırtıcı derecede iyi olup olmadığını kontrol et, bir özelliğin diğerlerinden çok daha önemli görünüp görünmediğine bak, model kararlarının sezgisel olarak anlamlı olduğunu doğrula ve verilerin herhangi bir işleme başlamadan önce doğru şekilde bölündüğünü teyit et.
Bunu önlemek için farklı kameralardan ve ortamlardan alınmış görüntü veya videolar içeren çeşitli bir veri kümesi kullan ve tüm pozitif örneklerin günün belirli bir saatinde alınması gibi gizli yanlılıkları tespit etmek için verilerini dikkatlice incele. Veri sızıntısını önlemek, bilgisayarlı görü modellerini gerçek dünya koşullarında daha güvenilir hâle getirir.
Model Testinden Sonra Ne Yapmalı?#
Modelini test ettikten sonra atacağın sonraki adımlar sonuçlara bağlıdır. Modelin iyi performans gösterirse onu gerçek dünya ortamında kullanıma alabilirsin. Sonuçlar tatmin edici değilse iyileştirmeler yapman gerekir. Hataları analiz etmek, daha fazla veri toplamak, veri kalitesini artırmak, hiperparametreleri ayarlamak ve modeli yeniden eğitmek bu iyileştirmelere dâhil olabilir.
Sonuç#
Ayrılmış bir test kümesinde doğrulama yapmak, gerçek dünya görüntülerinde tahmin yürütmek, aşırı öğrenme ve veri sızıntısı olup olmadığını kontrol etmek gibi titiz model testleri, iyi değerlendirilmiş bir modeli güvenilir bir modele dönüştürür. Testlerin ortaya çıkardığı sorunları kullanıma almadan önce gider; böylece modelinin üretim ortamında beklendiği gibi performans gösterme olasılığı çok daha yüksek olur. Bu süreçte soruların olursa Ultralytics GitHub deposunda veya Ultralytics Discord sunucusunda topluluğa sor.
Sık Sorulan Sorular#
Model değerlendirmesi, etiketli bir veri kümesindeki performansı metriklerle ölçerken model testi, modelin dağıtım koşullarını andıran yeni ve görülmemiş verilerde nasıl davrandığını kontrol eder. Değerlendirme, kontrollü bir veri kümesinden kesinlik ve mAP gibi sayılar üretir; test ise öğrenilen davranışın farklı ışıklandırma, hareket veya örtülme koşullarında geçerliliğini koruyup korumadığını gösterir. Uygulamalı bir örnek için Model Testi ve Model Değerlendirmesi sayfasına göz at.
Tahmin modunu kullan ve klasör yolunu
sourceolarak ver — YOLO26, klasördeki her görüntü üzerinde çalışır ve açıklama eklenmiş sonuçları incelemen için kaydedebilir. Tahmin modu metrik hesaplamaz; etiketli bir kümedeki performansı ölçmek için bunun yerine doğrulama modunu kullan. Her iki iş akışı da YOLO26 Modeli Nasıl Test Edilir sayfasında gösterilmiştir.Algılama modelleri için doğrulama; kesinlik, duyarlılık, mAP50 ve mAP50-95 değerlerini raporlar ve karışıklık matrisi ile kesinlik-duyarlılık eğrisi dâhil grafikleri kaydeder. Varsayılan
valbölmesi yerine özel bir test bölmesinde doğrulama yapmak için veri kümesi YAML dosyandatest:tanımla vesplit="test"parametresini geçir. Her metriğin nasıl yorumlanacağını performans metrikleri kılavuzunda görebilirsin.Aşırı öğrenme için dropout gibi düzenlileştirme teknikleri uygula, eğitim veri kümesinin boyutunu artır veya model mimarisini basitleştir. Yetersiz öğrenme için daha karmaşık bir model kullan, daha alakalı özellikler sağla veya daha fazla epoch boyunca eğitim yap. Her sorunun belirtileri ve ilgili çözümler Makine Öğrenmesinde Aşırı Öğrenme ve Yetersiz Öğrenme sayfasında özetlenmiştir.
Test performansı şaşırtıcı derecede iyi görünüyorsa, tek bir özellik tahminlere hâkimse veya modelin kararları sezgisel olarak anlamlı gelmiyorsa veri sızıntısından şüphelen. Farklı kameralardan ve ortamlardan çeşitli veri kümeleri kullanarak, verileri gizli yanlılıklara karşı inceleyerek ve eğitim/test bölmesinin herhangi bir işleme başlamadan önce yapıldığını doğrulayarak sızıntıyı önle. Yaygın yanlılık türleri için Bilgisayarlı Görüde Veri Sızıntısı sayfasına göz at.
Sonuçlar proje hedeflerini karşılıyorsa modeli kullanıma al; karşılamıyorsa kullanıma almadan önce iyileştir. Bu; hataları analiz etmeyi, daha çeşitli veriler toplamayı, veri kalitesini artırmayı, hiperparametreleri ayarlamayı ve modeli yeniden eğitmeyi içerebilir. Düzeltmelerin işe yaradığını doğrulamak için her değişiklik turundan sonra testi tekrarla.