Çıkarım için Vertex AI'da Ultralytics ile önceden eğitilmiş bir YOLO modeli dağıt#
Bu kılavuzda, Ultralytics ile önceden eğitilmiş bir YOLO26 modelini nasıl kapsayıcıya alacağını, model için bir FastAPI çıkarım sunucusu oluşturacağını ve modeli çıkarım sunucusuyla Google Cloud Vertex AI'da dağıtacağını göstereceğiz. Örnek uygulama, YOLO26 için nesne algılama kullanım senaryosunu ele alacak; ancak aynı ilkeler diğer YOLO görevlerini kullanırken de geçerli olacak.
Başlamadan önce bir Google Bulut Platformu (GCP) projesi oluşturman gerekir. Yeni kullanıcı olarak ücretsiz kullanabileceğin 300 $ tutarında GCP kredisi alırsın. Bu miktar, daha sonra eğitim veya toplu ve akış çıkarımı da dâhil olmak üzere diğer YOLO26 kullanım senaryolarına genişletebileceğin çalışan bir kurulumu test etmek için yeterlidir.
Öğreneceklerin#
- FastAPI kullanarak Ultralytics YOLO26 modeli için bir çıkarım arka ucu oluştur.
- Docker görüntünü depolamak için bir GCP Artifact Registry deposu oluştur.
- Modeli içeren Docker görüntüsünü oluşturup Artifact Registry'ye gönder.
- Modelini Vertex AI'ya aktar.
- Bir Vertex AI uç noktası oluştur ve modeli dağıt.
- Ultralytics ile model üzerinde tam kontrol: Ön işleme, son işleme ve yanıt biçimlendirme üzerinde tam kontrol sağlayarak özel çıkarım mantığı kullanabilirsin.
- Geri kalanını Vertex AI halleder: Otomatik ölçeklendirme yapar; ayrıca işlem kaynaklarını, belleği ve GPU yapılandırmalarını esnek biçimde ayarlamana olanak tanır.
- Yerel GCP entegrasyonları ve güvenlik: Cloud Storage, BigQuery, Cloud Functions, VPC denetimleri, IAM politikaları ve denetim günlükleriyle sorunsuz kurulum.
Ön koşullar#
- Bilgisayarına Docker yükle.
- Google Cloud SDK yükle ve gcloud CLI'yi kullanmak için kimlik doğrulaması yap.
- Bu kılavuzu izlerken resmi Ultralytics Docker görüntülerinden birini genişletmen gerekeceğinden, Ultralytics Docker Hızlı Başlangıç Kılavuzu'nu incelemen önemle tavsiye edilir.
1. FastAPI ile çıkarım arka ucu oluştur#
Öncelikle, YOLO26 modeli çıkarım isteklerine yanıt verecek bir FastAPI uygulaması oluşturman gerekir. Bu uygulama modelin yüklenmesini, görüntü ön işlemesini ve çıkarım (tahmin) mantığını yönetecek.
Vertex AI Uyumluluğunun Temel İlkeleri#
Vertex AI, kapsayıcının iki belirli uç noktayı uygulamasını bekler:
-
Health uç noktası (
/health): Hizmet hazır olduğunda HTTP200 OKdurum kodunu döndürmelidir. -
Predict uç noktası (
/predict): base64 ile kodlanmış görüntüler ve isteğe bağlı parametreler içeren yapılandırılmış tahmin isteklerini kabul eder. Uç nokta türüne göre yük boyutu sınırları geçerlidir./predictuç noktasına gönderilen istek yükleri şu JSON yapısına uymalıdır:{ "instances": [{ "image": "base64_encoded_image" }], "parameters": { "confidence": 0.5 } }
Proje klasör yapısı#
Derleme işlemlerimizin büyük kısmı Docker kapsayıcısında gerçekleşecek ve Ultralytics önceden eğitilmiş bir YOLO26 modelini de yükleyecek. Bu nedenle yerel klasör yapısını basit tutabilirsin:
YOUR_PROJECT/
├── src/
│   ├── __init__.py
│   ├── app.py              # Core YOLO26 inference logic
│   └── main.py             # FastAPI inference server
├── tests/
├── .env                    # Environment variables for local development
├── Dockerfile              # Container configuration
├── LICENSE                 # AGPL-3.0 License
└── pyproject.toml # Python dependencies and project configUltralytics YOLO26 modelleri ve çerçevesi, önemli uyumluluk gereklilikleri bulunan AGPL-3.0 lisansına tabidir. Lisans koşullarına nasıl uyum sağlayacağını anlatan Ultralytics belgelerini okuduğundan emin ol.
Bağımlılıkları içeren pyproject.toml dosyasını oluştur#
Projenin yönetimini kolaylaştırmak için aşağıdaki bağımlılıkları içeren bir pyproject.toml dosyası oluştur:
[project]
name = "YOUR_PROJECT_NAME"
version = "0.0.1"
description = "YOUR_PROJECT_DESCRIPTION"
requires-python = ">=3.10,<3.13"
dependencies = [
   "ultralytics>=8.4.0",
   "fastapi[all]>=0.89.1",
   "uvicorn[standard]>=0.20.0",
   "pillow>=9.0.0",
   "loguru",
]

[build-system]
requires = ["setuptools>=61.0"]
build-backend = "setuptools.build_meta"- FastAPI sunucusunu çalıştırmak için
uvicornkullanılacak. - FastAPI sunucusunda günlük kaydı için
logurukullanılacak. - Görüntü işleme için
pillowkullanılacak; ancak yalnızca PIL görüntüleriyle sınırlı değilsin — Ultralytics başka birçok biçimi destekler.
Ultralytics YOLO26 ile çıkarım mantığını oluştur#
Proje yapısını ve bağımlılıkları ayarladığına göre artık temel YOLO26 çıkarım mantığını uygulayabilirsin. Ultralytics Python API'sini kullanarak model yükleme, görüntü işleme ve tahmin işlemlerini yönetecek bir src/app.py dosyası oluştur.
# src/app.py

from ultralytics import YOLO

# Model initialization and readiness state
model_yolo = None
_model_ready = False

def _initialize_model():
    """Initialize the YOLO model."""
    global model_yolo, _model_ready

    try:
        # Use pretrained YOLO26n model from Ultralytics base image
        model_yolo = YOLO("yolo26n.pt")
        _model_ready = True

    except Exception as e:
        print(f"Error initializing YOLO model: {e}")
        _model_ready = False
        model_yolo = None

# Initialize model on module import
_initialize_model()

def is_model_ready() -> bool:
    """Check if the model is ready for inference."""
    return _model_ready and model_yolo is not None
Bu işlem, kapsayıcı başlatıldığında modeli bir kez yükleyecek ve model tüm istekler arasında paylaşılacak. Modelin yoğun çıkarım yükünü karşılayacaksa, sonraki adımda Vertex AI'ya model aktarırken daha fazla belleğe sahip bir makine türü seçmen önerilir.
Ardından, pillow ile giriş ve çıkış görüntüsü işleme için iki yardımcı işlev oluştur. YOLO26, PIL görüntülerini yerel olarak destekler.
def get_image_from_bytes(binary_image: bytes) -> Image.Image:
    """Convert image from bytes to PIL RGB format."""
    input_image = Image.open(io.BytesIO(binary_image)).convert("RGB")
    return input_image
def get_bytes_from_image(image: Image.Image) -> bytes:
"""Convert PIL image to bytes."""
return_image = io.BytesIO()
image.save(return_image, format="JPEG", quality=85)
return_image.seek(0)
return return_image.getvalue()Son olarak, nesne algılamayı yönetecek run_inference işlevini uygula. Bu örnekte model tahminlerinden sınırlayıcı kutuları, sınıf adlarını ve güven skorlarını çıkaracağız. İşlev, sonraki işleme veya açıklama ekleme işlemleri için algılamaları ve ham sonuçları içeren bir sözlük döndürecek.
def run_inference(input_image: Image.Image, confidence_threshold: float = 0.5) -> Dict[str, Any]:
    """Run inference on an image using YOLO26n model."""
    # Check if model is ready
    if not is_model_ready():
        print("Model not ready for inference")
        return {"detections": [], "results": None}

    try:
        # Make predictions and get raw results
        results = model_yolo.predict(
            imgsz=640, source=input_image, conf=confidence_threshold, save=False, augment=False, verbose=False
        )

        # Extract detections (bounding boxes, class names, and confidences)
        detections = []
        if results and len(results) > 0:
            result = results[0]
            if result.boxes is not None and len(result.boxes.xyxy) > 0:
                boxes = result.boxes

                # Convert tensors to numpy for processing
                xyxy = boxes.xyxy.cpu().numpy()
                conf = boxes.conf.cpu().numpy()
                cls = boxes.cls.cpu().numpy().astype(int)

                # Create detection dictionaries
                for i in range(len(xyxy)):
                    detection = {
                        "xmin": float(xyxy[i][0]),
                        "ymin": float(xyxy[i][1]),
                        "xmax": float(xyxy[i][2]),
                        "ymax": float(xyxy[i][3]),
                        "confidence": float(conf[i]),
                        "class": int(cls[i]),
                        "name": model_yolo.names.get(int(cls[i]), f"class_{int(cls[i])}"),
                    }
                    detections.append(detection)

        return {
            "detections": detections,
            "results": results,  # Keep raw results for annotation
        }
    except Exception as e:
        # If there's an error, return empty structure
        print(f"Error in YOLO detection: {e}")
        return {"detections": [], "results": None}
İsteğe bağlı olarak, Ultralytics'in yerleşik çizim yöntemini kullanarak görüntüye sınırlayıcı kutular ve etiketler ekleyen bir işlev ekleyebilirsin. Tahmin yanıtında açıklama eklenmiş görüntüler döndürmek istiyorsan bu işine yarar.
def get_annotated_image(results: list) -> Image.Image:
    """Get annotated image using Ultralytics built-in plot method."""
    if not results or len(results) == 0:
        raise ValueError("No results provided for annotation")

    result = results[0]
    # PIL çıktısıyla Ultralytics'in yerleşik çizim yöntemini kullan
    return result.plot(pil=True)
FastAPI ile HTTP çıkarım sunucusu oluştur#
Temel YOLO26 çıkarım mantığı hazır olduğuna göre artık bunu sunacak bir FastAPI uygulaması oluşturabilirsin. Bu uygulama, Vertex AI'nın gerektirdiği sağlık denetimi ve tahmin uç noktalarını içerecek.
Önce src/main.py dosyasını oluştur, içe aktarmaları ekle, FastAPI uygulamasını oluştur ve Vertex AI için günlük kaydını yapılandır. Vertex AI stderr'ı hata çıktısı olarak değerlendirdiğinden, günlükleri stdout'a yönlendirmek mantıklıdır.
# src/main.py

import sys

from fastapi import FastAPI
from loguru import logger

app = FastAPI()

# Günlük kaydediciyi yapılandır
logger.remove()
logger.add(
    sys.stdout,
    colorize=True,
    format="<green>{time:HH:mm:ss}</green> | <level>{message}</level>",
    level=10,
)
logger.add("log.log", rotation="1 MB", level="DEBUG", compression="zip")
Vertex AI gerekliliklerine tam uyum sağlamak için gerekli uç noktaları ortam değişkenlerinde tanımla ve istekler için boyut sınırını ayarla. Üretim dağıtımlarında özel Vertex AI uç noktalarını kullanman önerilir. Bu sayede güçlü güvenlik ve erişim denetimine ek olarak daha yüksek bir istek yükü sınırına (genel uç noktalardaki 1,5 MB yerine 10 MB) sahip olursun.
# Vertex AI ortam değişkenleri
AIP_HTTP_PORT = int(os.getenv("AIP_HTTP_PORT", "8080"))
AIP_HEALTH_ROUTE = os.getenv("AIP_HEALTH_ROUTE", "/health")
AIP_PREDICT_ROUTE = os.getenv("AIP_PREDICT_ROUTE", "/predict")

# İstek boyutu sınırı (özel uç noktalar için 10 MB, genel uç noktalar için 1,5 MB)
MAX_REQUEST_SIZE = 10 * 1024 * 1024  # Bayt cinsinden 10 MB
İsteklerini ve yanıtlarını doğrulamak için iki Pydantic modeli ekle:
# İstek/yanıt için Pydantic modelleri
class PredictionRequest(BaseModel):
    instances: list
    parameters: Optional[Dict[str, Any]] = None

class PredictionResponse(BaseModel):
    predictions: list
Modelinin hazır olup olmadığını doğrulamak için sağlık denetimi uç noktasını ekle. Bu, Vertex AI için önemlidir; özel bir sağlık denetimi olmadığında düzenleyici rastgele soketlere ping gönderir ve modelin çıkarıma hazır olup olmadığını belirleyemez. Denetimin başarılı olduğunda 200 OK, başarısız olduğunda ise 503 Service Unavailable döndürmelidir:
# Sağlık denetimi uç noktası
@app.get(AIP_HEALTH_ROUTE, status_code=status.HTTP_200_OK)
def health_check():
    """Health check endpoint for Vertex AI."""
    if not is_model_ready():
        raise HTTPException(status_code=503, detail="Model not ready")
    return {"status": "healthy"}
Artık çıkarım isteklerini yönetecek tahmin uç noktasını uygulamak için gereken her şeye sahipsin. Bu uç nokta bir görüntü dosyasını kabul edecek, çıkarımı çalıştıracak ve sonuçları döndürecek. Görüntünün base64 ile kodlanması gerektiğini ve bunun yük boyutunu ayrıca %33'e kadar artırdığını unutma.
@app.post(AIP_PREDICT_ROUTE, response_model=PredictionResponse)
async def predict(request: PredictionRequest):
    """Prediction endpoint for Vertex AI."""
    try:
        predictions = []

        for instance in request.instances:
            if isinstance(instance, dict):
                if "image" in instance:
                    image_data = base64.b64decode(instance["image"])
                    input_image = get_image_from_bytes(image_data)
                else:
                    raise HTTPException(status_code=400, detail="Instance must contain 'image' field")
            else:
                raise HTTPException(status_code=400, detail="Invalid instance format")

            # Extract YOLO26 parameters if provided
            parameters = request.parameters or {}
            confidence_threshold = parameters.get("confidence", 0.5)
            return_annotated_image = parameters.get("return_annotated_image", False)

            # Run inference with YOLO26n model
            result = run_inference(input_image, confidence_threshold=confidence_threshold)
            detections_list = result["detections"]

            # Format predictions for Vertex AI
            detections = []
            for detection in detections_list:
                formatted_detection = {
                    "class": detection["name"],
                    "confidence": detection["confidence"],
                    "bbox": {
                        "xmin": detection["xmin"],
                        "ymin": detection["ymin"],
                        "xmax": detection["xmax"],
                        "ymax": detection["ymax"],
                    },
                }
                detections.append(formatted_detection)

            # Build prediction response
            prediction = {"detections": detections, "detection_count": len(detections)}

            # Add annotated image if requested and detections exist
            if (
                return_annotated_image
                and result["results"]
                and result["results"][0].boxes is not None
                and len(result["results"][0].boxes) > 0
            ):
                annotated_image = get_annotated_image(result["results"])
                img_bytes = get_bytes_from_image(annotated_image)
                prediction["annotated_image"] = base64.b64encode(img_bytes).decode("utf-8")

            predictions.append(prediction)

        logger.info(
            f"Processed {len(request.instances)} instances, found {sum(len(p['detections']) for p in predictions)} total detections"
        )

        return PredictionResponse(predictions=predictions)

    except HTTPException:
        # Re-raise HTTPException as-is (don't catch and convert to 500)
        raise
    except Exception as e:
        logger.error(f"Prediction error: {e}")
        raise HTTPException(status_code=500, detail=f"Prediction failed: {e}")
Son olarak, FastAPI sunucusunu çalıştırmak için uygulama giriş noktasını ekle.
if __name__ == "__main__":
    import uvicorn

    logger.info(f"Starting server on port {AIP_HTTP_PORT}")
    logger.info(f"Health check route: {AIP_HEALTH_ROUTE}")
    logger.info(f"Predict route: {AIP_PREDICT_ROUTE}")
    uvicorn.run(app, host="0.0.0.0", port=AIP_HTTP_PORT)
Artık YOLO26 çıkarım isteklerine yanıt verebilen eksiksiz bir FastAPI uygulaman var. Bağımlılıkları yükleyip sunucuyu örneğin uv ile çalıştırarak uygulamayı yerel olarak test edebilirsin.
# Install dependencies
uv pip install -e .

# Run the FastAPI server directly
uv run src/main.py
Sunucuyu test etmek için cURL kullanarak hem /health hem de /predict uç noktalarını sorgulayabilirsin. tests klasörüne bir test görüntüsü koy. Ardından Terminal'de aşağıdaki komutları çalıştır:
# Test health endpoint
curl http://localhost:8080/health

# Test predict endpoint with base64 encoded image
curl -X POST -H "Content-Type: application/json" -d "{\"instances\": [{\"image\": \"$(base64 -i tests/test_image.jpg)\"}]}" http://localhost:8080/predict
Algılanan nesneleri içeren bir JSON yanıtı almalısın. İlk isteğinde kısa bir gecikme bekle; Ultralytics'in YOLO26 modelini indirip yüklemesi gerekir.
2. Ultralytics Docker görüntüsünü uygulamanla genişlet#
Ultralytics, uygulama görüntün için temel olarak kullanabileceğin çeşitli Docker görüntüleri sunar. Bunlar Ultralytics'i ve gerekli CUDA kitaplıklarını içerir; böylece üzerine yalnızca uygulamanı eklemen yeterlidir.
Ultralytics YOLO modellerinin tüm özelliklerinden yararlanmak için GPU çıkarımına yönelik CUDA için optimize edilmiş görüntüyü seçmelisin. Ancak görevinde CPU çıkarımı yeterliyse yalnızca CPU kullanan görüntüyü seçerek işlem kaynaklarından tasarruf edebilirsin:
- Dockerfile: YOLO26 tek/çok GPU'lu eğitim ve çıkarım için CUDA için optimize edilmiş görüntü.
- Dockerfile-cpu: YOLO26 çıkarımı için yalnızca CPU kullanan görüntü.
Uygulaman için Docker görüntüsü oluştur#
Projenin kök dizininde aşağıdaki içeriğe sahip bir Dockerfile oluştur:
# Extends official Ultralytics Docker image for YOLO26
FROM ultralytics/ultralytics:latest

ENV PYTHONUNBUFFERED=1

# Install FastAPI and dependencies
RUN uv pip install --system fastapi[all] uvicorn[standard] loguru

WORKDIR /app
COPY src/ ./src/
COPY pyproject.toml ./

# Install the application package
RUN uv pip install --system -e .

RUN mkdir -p /app/logs
ENV PYTHONPATH=/app/src

# Port for Vertex AI
EXPOSE 8080

# Start the inference server
ENTRYPOINT ["python", "src/main.py"]
Örnekte, temel olarak resmi Ultralytics Docker görüntüsü ultralytics:latest kullanılıyor. Bu görüntü YOLO26 modelini ve gerekli tüm bağımlılıkları zaten içeriyor. Sunucunun giriş noktası, FastAPI uygulamasını yerel olarak test etmek için kullandığımızla aynı.
Docker görüntüsünü oluştur ve test et#
Artık aşağıdaki komutla Docker görüntüsünü oluşturabilirsin:
docker build --platform linux/amd64 -t IMAGE_NAME:IMAGE_VERSION .IMAGE_NAME ve IMAGE_VERSION değerlerini istediğin değerlerle, örneğin yolo26-fastapi:0.1 ile değiştir. Vertex AI'da dağıtım yapacaksan görüntüyü linux/amd64 mimarisi için oluşturman gerektiğini unutma. Görüntüyü Apple Silicon Mac'te veya x86 dışındaki herhangi bir mimaride oluşturuyorsan --platform parametresini açıkça ayarlaman gerekir.
Görüntü oluşturma işlemi tamamlandığında Docker görüntüsünü yerel olarak test edebilirsin:
docker run --platform linux/amd64 -p 8080:8080 IMAGE_NAME:IMAGE_VERSIONDocker kapsayıcın artık 8080 bağlantı noktasında bir FastAPI sunucusu çalıştırıyor ve çıkarım isteklerini kabul etmeye hazır. Hem /health hem de /predict uç noktasını öncekiyle aynı cURL komutlarını kullanarak test edebilirsin:
# Test health endpoint
curl http://localhost:8080/health

# Test predict endpoint with base64 encoded image
curl -X POST -H "Content-Type: application/json" -d "{\"instances\": [{\"image\": \"$(base64 -i tests/test_image.jpg)\"}]}" http://localhost:8080/predict
3. Docker görüntüsünü GCP Artifact Registry'ye yükle#
Kapsayıcıya alınmış modelini Vertex AI'ya aktarmak için Docker görüntüsünü Google Cloud Artifact Registry'ye yüklemen gerekir. Henüz bir Artifact Registry depon yoksa önce bir tane oluşturmalısın.
Google Cloud Artifact Registry'de depo oluştur#
Google Cloud Console'da Artifact Registry sayfasını aç. Artifact Registry'yi ilk kez kullanıyorsan önce Artifact Registry API'yi etkinleştirmen istenebilir.

- Depo oluştur'u seç.
- Deponun adını gir. İstediğin bölgeyi seç ve özellikle değiştirmen gerekmiyorsa diğer seçenekler için varsayılan ayarları kullan.
Bölge seçimi, makinelerin kullanılabilirliğini ve Enterprise kullanıcısı olmayanlar için bazı işlem sınırlamalarını etkileyebilir. Daha fazla bilgi için Vertex AI'nın resmi belgelerine bak: Vertex AI kotaları ve sınırları
- Depo oluşturulduğunda PROJECT_ID, Location (Region) ve Repository Name değerlerini gizli bilgi kasana veya
.envdosyasına kaydet. Docker görüntünü Artifact Registry'ye etiketleyip göndermek için bu değerlere daha sonra ihtiyacın olacak.
Docker'ı Artifact Registry'de kimlik doğrulaması yapacak şekilde ayarla#
Docker istemcinde, az önce oluşturduğun Artifact Registry deposu için kimlik doğrulaması yap. Terminalinde aşağıdaki komutu çalıştır:
gcloud auth configure-docker YOUR_REGION-docker.pkg.devGörüntünü Artifact Registry'ye etiketle ve gönder#
Docker görüntüsünü Google Artifact Registry'ye etiketleyip gönder.
Görüntünü her güncellediğinde benzersiz etiketler kullanman önerilir. Vertex AI dâhil çoğu GCP hizmeti otomatik sürüm oluşturma ve ölçeklendirme için görüntü etiketlerine dayanır; bu nedenle anlamsal sürüm oluşturma veya tarihe dayalı etiketler kullanmak iyi bir uygulamadır.
Görüntünü Artifact Registry depo URL'siyle etiketle. Yer tutucuları daha önce kaydettiğin değerlerle değiştir.
docker tag IMAGE_NAME:IMAGE_VERSION YOUR_REGION-docker.pkg.dev/YOUR_PROJECT_ID/YOUR_REPOSITORY_NAME/IMAGE_NAME:IMAGE_VERSIONEtiketlenmiş görüntüyü Artifact Registry deposuna gönder.
docker push YOUR_REGION-docker.pkg.dev/YOUR_PROJECT_ID/YOUR_REPOSITORY_NAME/IMAGE_NAME:IMAGE_VERSIONİşlemin tamamlanmasını bekle. Artık Artifact Registry deponda görüntüyü görmelisin.
Artifact Registry'de görüntülerle çalışma hakkında daha ayrıntılı talimatlar için Artifact Registry belgelerine göz at: Görüntüleri gönderme ve çekme.
4. Modelini Vertex AI'ye aktar#
Az önce gönderdiğin Docker görüntüsünü kullanarak artık modeli Vertex AI'ye aktarabilirsin.
-
Google Cloud gezinme menüsünden Vertex AI > Model Registry'ye git. Alternatif olarak Google Cloud Console'un üst kısmındaki arama çubuğunda "Vertex AI" ifadesini ara.

-
İçe aktar'a tıkla.
-
Yeni bir model olarak içe aktar'ı seç.
-
Bölgeyi seç. Artifact Registry deponla aynı bölgeyi seçebilirsin; ancak seçimin, bölgenizdeki makine türlerinin ve kotaların kullanılabilirliğine göre belirlenmeli.
-
Mevcut bir model kapsayıcısını içe aktar'ı seç.

-
Container image alanında, daha önce oluşturduğun Artifact Registry deposuna göz at ve az önce gönderdiğin görüntüyü seç.
-
Environment variables bölümüne in ve FastAPI uygulamanda tanımladığın predict ve health uç noktalarını ve bağlantı noktasını gir.

-
İçe aktar'a tıkla. Vertex AI'nin modeli kaydetmesi ve dağıtıma hazırlaması birkaç dakika sürer. İçe aktarma tamamlandığında e-posta bildirimi alırsın.
5. Vertex AI Endpoint'i oluştur ve modelini dağıt#
Vertex AI terminolojisinde endpoint'ler, dağıtılmış modelleri ifade eder; çünkü çıkarım isteklerini gönderdiğin HTTP uç noktalarını temsil ederler. Modeller ise Model Registry'de depolanan eğitilmiş ML yapıtlarıdır.
Bir modeli dağıtmak için Vertex AI'de bir Endpoint oluşturman gerekir.
-
Vertex AI gezinme menüsünden Endpoints'e git. Modelini aktarırken kullandığın bölgeyi seç. Create'e tıkla.

-
Uç nokta adını gir.
-
Erişim için Vertex AI, özel Vertex AI uç noktalarını kullanmanı önerir. Güvenlik avantajlarının yanı sıra, özel bir uç nokta seçersen daha yüksek bir yük sınırından yararlanırsın; ancak uç noktaya erişime izin vermek için VPC ağını ve güvenlik duvarı kurallarını yapılandırman gerekir. Daha fazla talimat için Vertex AI belgelerindeki özel uç noktalar bölümüne bak.
-
Devam'a tıkla.
-
Model ayarları iletişim kutusunda, daha önce içe aktardığın modeli seç. Artık modelin için makine türünü, belleği ve GPU ayarlarını yapılandırabilirsin. Uygun YOLO26 performansı için G/Ç darboğazları oluşmamasını sağlamak üzere, çıkarım yükünün yüksek olmasını bekliyorsan yeterli bellek ayır.
-
Accelerator type bölümünde, çıkarım için kullanmak istediğin GPU türünü seç. Hangi GPU'yu seçeceğinden emin değilsen CUDA destekli NVIDIA T4 ile başlayabilirsin.
Bazı bölgelerde işlem kotalarının çok sınırlı olduğunu unutma; bu nedenle bölgen için belirli makine türlerini veya GPU'ları seçemeyebilirsin. Bu durum kritikse dağıtım bölgeni kotası daha yüksek olan bir bölgeyle değiştir. Daha fazla bilgi için Vertex AI'nin resmî belgelerine göz at: Vertex AI kotaları ve sınırları.
- Makine türünü seçtikten sonra Continue'e tıklayabilirsin. Bu aşamada Vertex AI'de model izlemeyi etkinleştirebilirsin. Bu ek hizmet, modelinin performansını izler ve davranışı hakkında öngörüler sunar. Bu seçenek isteğe bağlıdır ve ek maliyet getirir; bu nedenle ihtiyaçlarına göre seçim yap. Create'e tıkla.
Vertex AI'nin modeli dağıtması birkaç dakika sürer (bazı bölgelerde 30 dakikaya kadar). Dağıtım tamamlandığında e-posta bildirimi alırsın.
6. Dağıttığın modeli test et#
Dağıtım tamamlandığında Vertex AI, modelini test etmen için örnek bir API arayüzü sunar.
Uzak çıkarımı test etmek için sağlanan cURL komutunu kullanabilir veya dağıtılan modele istek gönderecek başka bir Python istemci kitaplığı oluşturabilirsin. Görüntünü /predict endpoint'ine göndermeden önce base64 biçiminde kodlaman gerektiğini unutma.
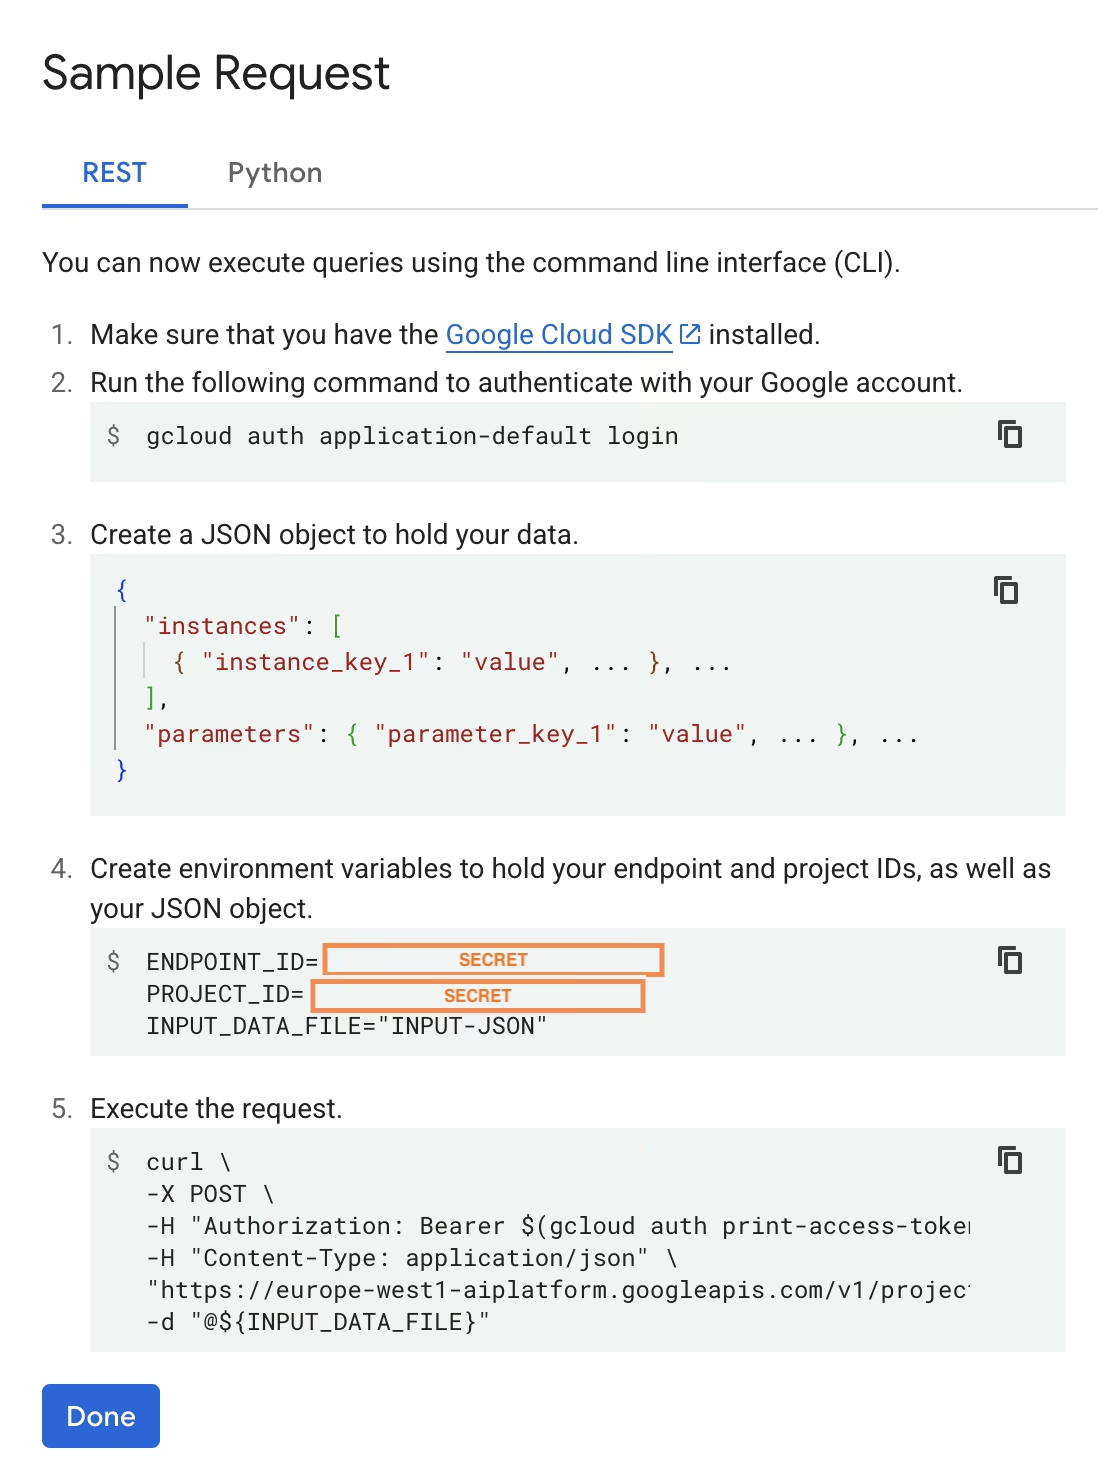
Yerel testte olduğu gibi ilk isteğin kısa süre gecikmesini bekle; Ultralytics'in çalışan kapsayıcıda YOLO26 modelini çekip yüklemesi gerekir.
Ultralytics ile Google Cloud Vertex AI'de önceden eğitilmiş bir YOLO26 modelini başarıyla dağıttın.
Sık Sorulan Sorular#
Evet; ancak önce modeli TensorFlow, Scikit-learn veya XGBoost gibi Vertex AI ile uyumlu bir biçime aktarman gerekir. Google Cloud, dönüştürme sürecine kapsamlı bir genel bakış sunan şu kılavuzu sağlıyor: Vertex üzerinde
.ptmodellerini çalıştırma: PyTorch modellerini Vertex AI'de çalıştırma.Ortaya çıkan kurulumun yalnızca Vertex AI'nin standart sunum katmanına dayanacağını ve gelişmiş Ultralytics çerçevesi özelliklerini desteklemeyeceğini unutma. Vertex AI, kapsayıcı hâline getirilmiş modelleri tam olarak desteklediğinden ve dağıtım yapılandırmana göre bunları otomatik olarak ölçeklendirebildiğinden, modelleri farklı bir biçime dönüştürmene gerek kalmadan Ultralytics YOLO modellerinin tüm özelliklerinden yararlanabilirsin.
FastAPI, çıkarım iş yüklerinde yüksek verim sağlar. Eşzamansız destek, ana iş parçacığını engellemeden aynı anda birden fazla isteği işlemeye olanak tanır; bu, bilgisayarlı görü modelleri sunarken önemlidir.
FastAPI ile otomatik istek/yanıt doğrulaması, üretim ortamındaki çıkarım hizmetlerinde çalışma zamanı hatalarını azaltır. Bu özellik, girdi biçiminin tutarlı olmasının kritik olduğu nesne algılama API'leri için özellikle değerlidir.
FastAPI, çıkarım işlem hattına çok az hesaplama yükü ekleyerek model yürütme ve görüntü işleme görevleri için daha fazla kaynak bırakır.
FastAPI ayrıca akışlı çıkarım senaryolarında kullanışlı olan SSE'yi (Sunucu Tarafından Gönderilen Olaylar) destekler.
Bu, Google Cloud Platform'un bir esneklik özelliğidir; kullandığın her hizmet için bir bölge seçmen gerekir. Vertex AI'de kapsayıcı hâline getirilmiş bir modeli dağıtırken en önemli bölge seçimin Model Registry için yaptığındır. Bu seçim, model dağıtımında kullanılabilecek makine türlerini ve kotaları belirler.
Ayrıca kurulumu genişletip tahmin verilerini veya sonuçlarını Cloud Storage ya da BigQuery'de depolayacaksan gecikmeyi en aza indirmek ve verilere yüksek aktarım hızıyla erişmek için Model Registry ile aynı bölgeyi kullanman gerekir.