Chưng cất tri thức#
Bắt đầu nhanh#
Huấn luyện một model student nhỏ hơn với sự hướng dẫn từ model teacher lớn hơn bằng cách thêm đối số distill_model:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt")
Chưng cất tri thức là gì?#
Chưng cất tri thức truyền tri thức từ model teacher lớn, có độ chính xác cao sang model student nhỏ hơn. Student học cách mô phỏng các biểu diễn đặc trưng bên trong của teacher, thường đạt độ chính xác cao hơn so với huấn luyện từ đầu.
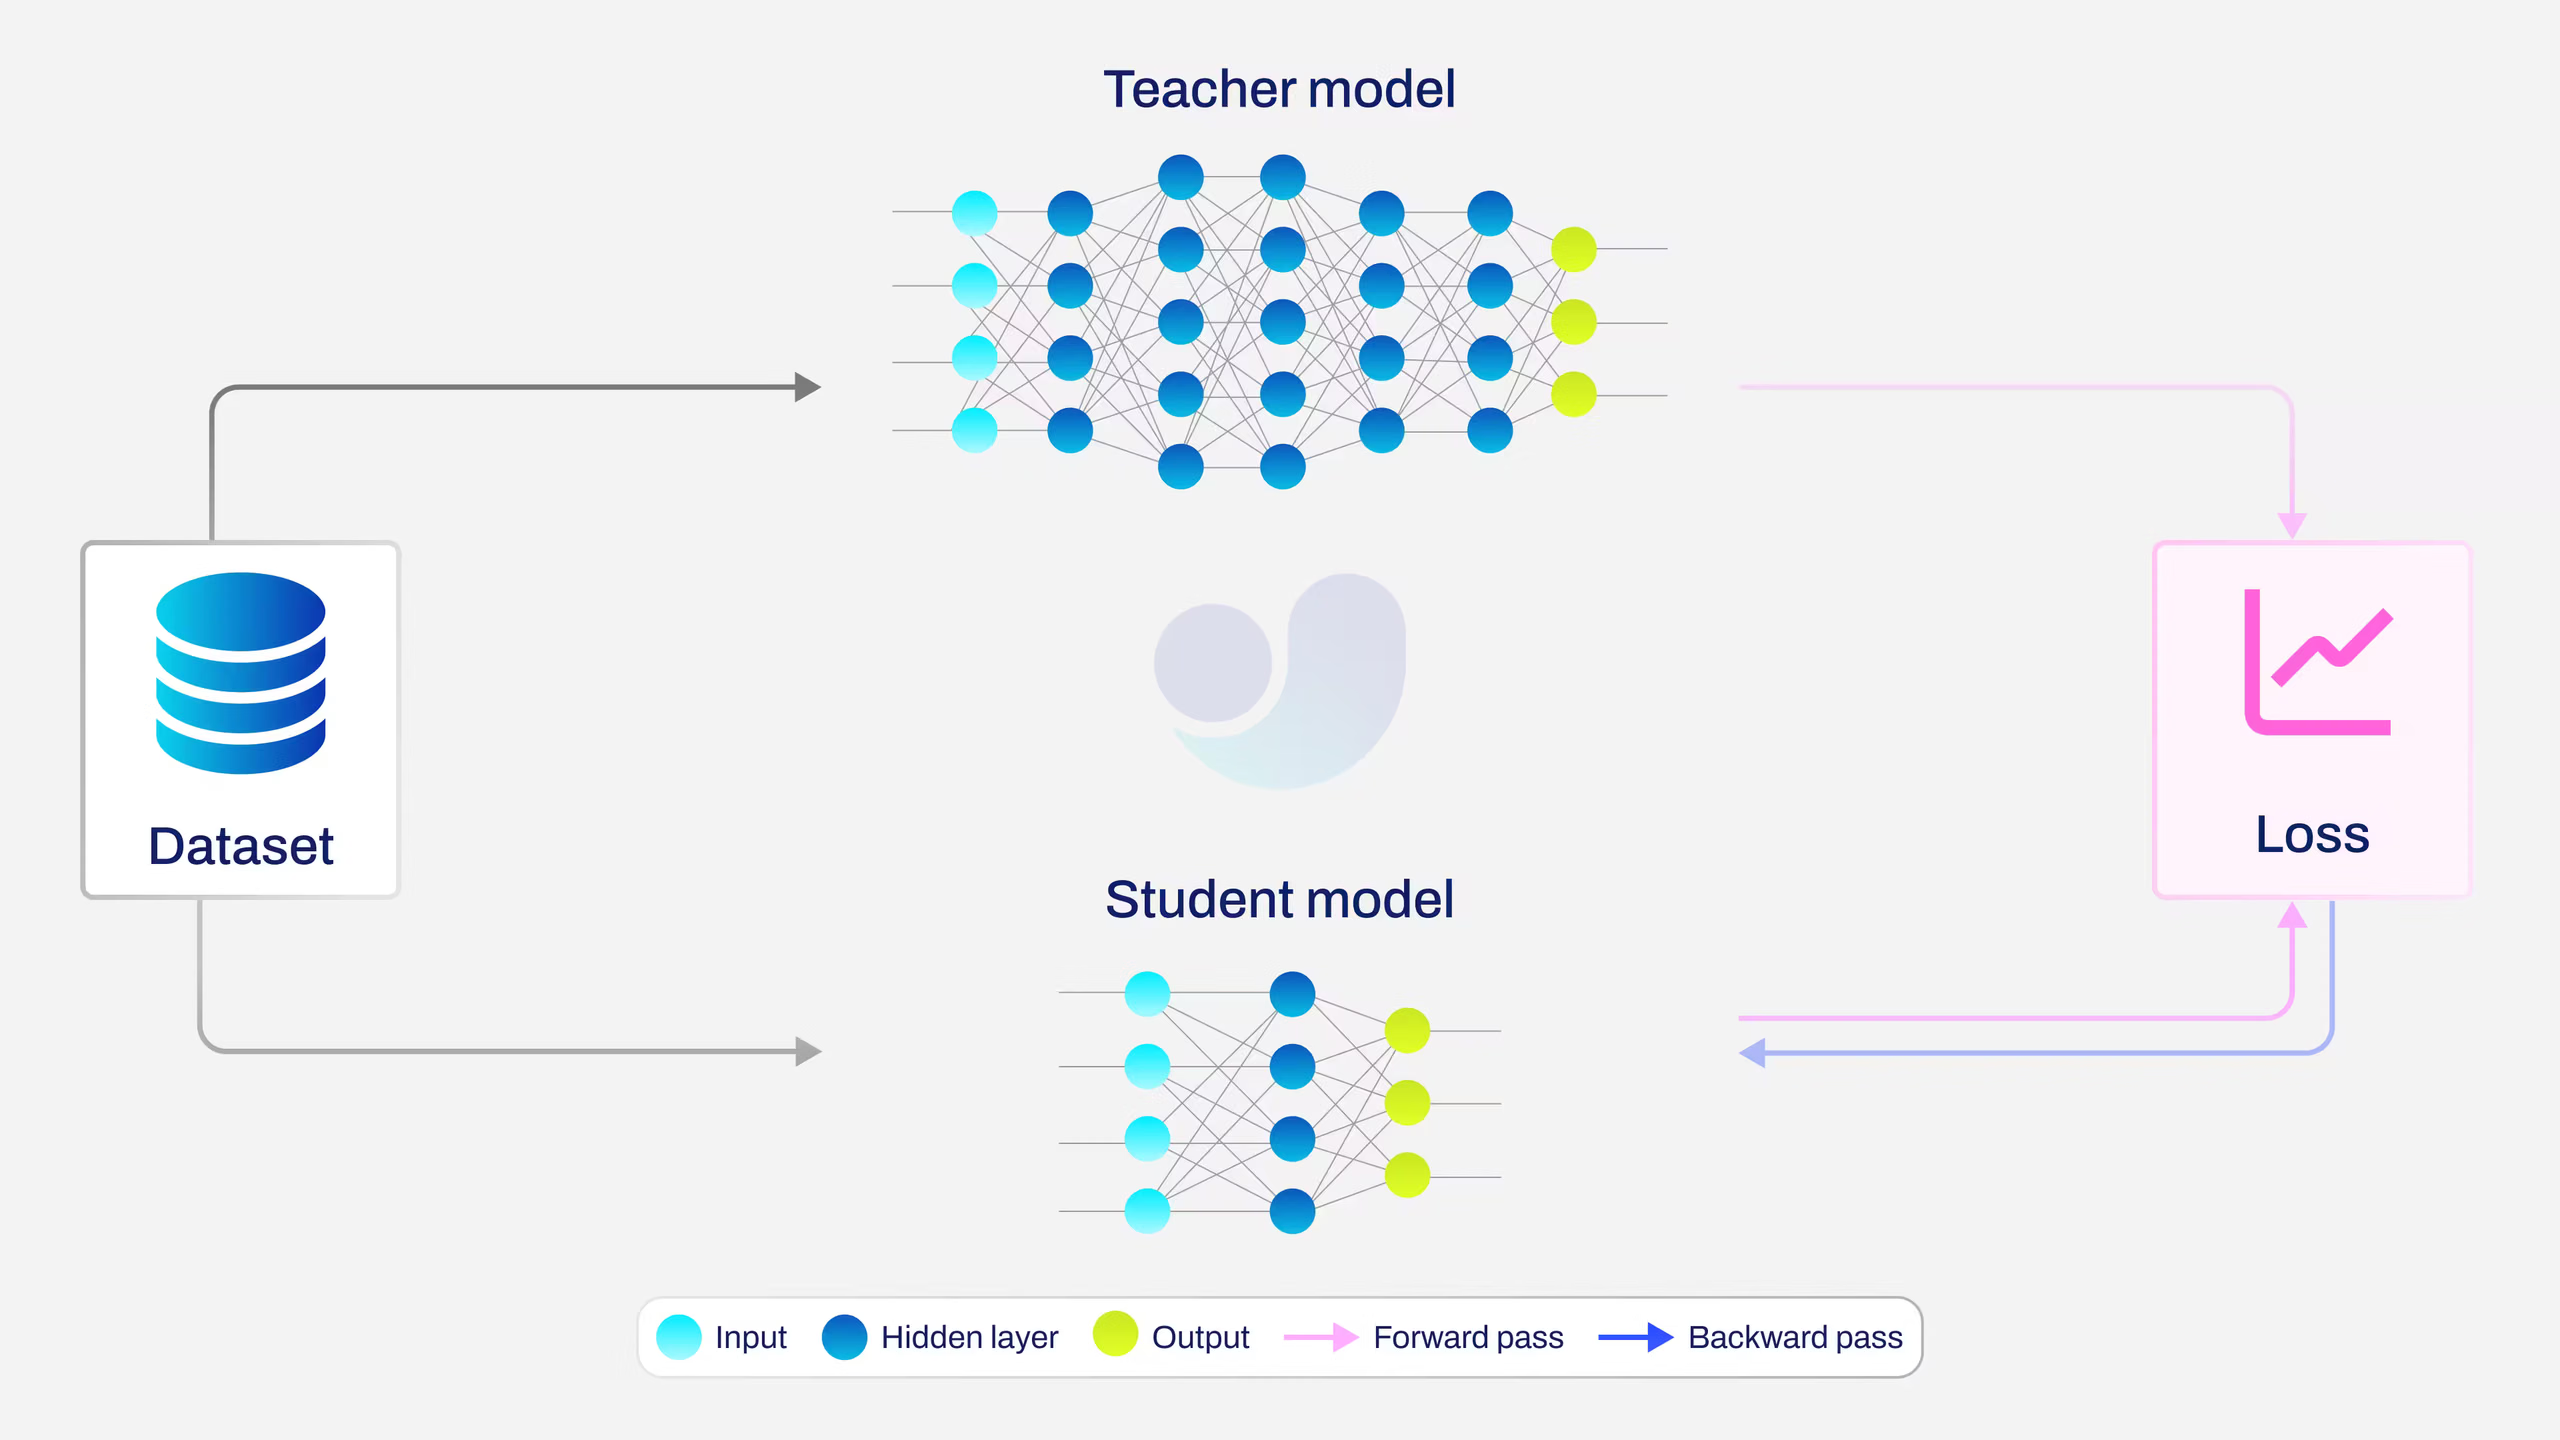
Dùng chưng cất khi:
- Bạn cần một model nhỏ hơn, nhanh hơn để triển khai
- Bạn có model teacher đạt độ chính xác cao, được huấn luyện trên cùng dữ liệu
- Bạn muốn đạt độ chính xác cao hơn so với huấn luyện tiêu chuẩn
Chưng cất tri thức được triển khai cho các tác vụ detect, segment, pose và obb. Hiện tại, chỉ detect đã được xác minh thực nghiệm về mức cải thiện độ chính xác.
Hiệu năng#
Chưng cất tri thức cải thiện mAP của student trên toàn bộ dòng YOLO26 khi dùng COCO, mà không làm tăng chi phí inference. Bảng dưới đây so sánh các model YOLO26 tiêu chuẩn (baseline) với chính các model đó khi được huấn luyện bằng phương pháp chưng cất từ teacher được đề xuất.
| Model | kích thước (pixel) | mAPval 50-95 baseline | mAPval 50-95 đã chưng cất | mAPval 50-95 (e2e) baseline | mAPval 50-95 (e2e) đã chưng cất |
|---|---|---|---|---|---|
| YOLO26n-distill | 640 | 40.9 | 41.5 | 40.1 | 40.9 |
| YOLO26s-distill | 640 | 48.6 | 49.2 | 47.8 | 48.6 |
| YOLO26m-distill | 640 | 53.1 | 53.9 | 52.5 | 53.3 |
| YOLO26l-distill | 640 | 55.0 | 56.0 | 54.4 | 55.5 |
| YOLO26x-distill | 640 | 57.5 | 57.9 | 56.9 | 57.4 |
- Các giá trị mAPval áp dụng cho thiết lập một model, một tỷ lệ trên dataset COCO val2017.
Tái tạo một hàng đã chưng cất bằngyolo val detect model=yolo26n-distill.pt data=coco.yaml device=0; thêmnms=Falsecho cột e2e. - Các giá trị e2e sử dụng luồng inference không cần NMS (
nms=False); các giá trị không phải e2e sử dụng hậu xử lý NMS mặc định (nms=None). Xem Phát hiện đầu cuối để biết chi tiết.
Điều kiện tiên quyết#
Trước khi bắt đầu, hãy đảm bảo bạn đáp ứng các yêu cầu sau:
- Model teacher đã huấn luyện: checkpoint
.ptthuộc cùng dòng YOLO với student. - Tác vụ tương ứng: dùng teacher cho cùng tác vụ với student và huấn luyện teacher trên dữ liệu phù hợp.
- Tài nguyên GPU: đủ bộ nhớ để chứa cả hai model; teacher chỉ chạy forward, không có gradient hoặc trạng thái optimizer.
Các cặp model được đề xuất#
| Student | Teacher được đề xuất |
|---|---|
yolo26n.pt | yolo26s.pt |
yolo26s.pt | yolo26m.pt |
yolo26m.pt | yolo26x.pt |
yolo26l.pt | yolo26x.pt |
Chưng cất giữa các dòng model khác nhau (ví dụ: teacher YOLO11 với student YOLO26) không được hỗ trợ.
Các tham số chính#
| Tham số | Kiểu | Mặc định | Mô tả |
|---|---|---|---|
distill_model | str | None | Đường dẫn đến file model teacher (ví dụ: yolo26x.pt). Thiết lập này sẽ bật chưng cất tri thức. |
dis | float | 6.0 | Trọng số loss chưng cất. Kiểm soát mức độ đóng góp của loss chưng cất vào tổng loss huấn luyện. |
Cách hoạt động#
- Model teacher được giữ cố định ở chế độ
evalvà chạy inference trên từng batch - Model student được huấn luyện bằng các loss tiêu chuẩn của tác vụ cùng với hướng dẫn chưng cất
- Đặc trưng được trích xuất từ cả hai model tại ba layer neck cấp dữ liệu cho head thuộc dòng Detect
- Một projector gồm hai phép tích chập 1×1 với ReLU điều chỉnh từng feature map của student cho khớp với số kênh của teacher
- Loss L2 có trọng số theo điểm số so sánh đặc trưng student đã qua projector với đặc trưng teacher, trong đó trọng số dựa trên độ tin cậy phân loại của teacher
- Loss chưng cất được kết hợp với các loss tiêu chuẩn bằng trọng số
dis
flowchart TD
    A[Input Image Batch]:::start --> T[Teacher Model<br/>frozen, eval mode]:::extern
    A --> S[Student Model<br/>trainable]:::proc

    T --> |Detect head inputs| TF[Teacher Features]:::extern
    S --> |Detect head inputs| SF[Student Features]:::proc

    SF --> P[1×1 Conv Projector<br/>with ReLU]:::decide
    P --> AF[Aligned Student Features]:::proc

    TF --> SW[Score-weighted L2 Loss]:::proc
    AF --> SW

    S --> D[Detection Head]:::proc
    D --> DL[box_loss + cls_loss + l1_loss]:::proc

    SW --> |× dis| DIS[distillation loss]:::proc
    DL --> TOTAL[Total Loss]:::out
    DIS --> TOTAL

    TOTAL --> BP[Backpropagate<br/>Student + Projector only]:::out

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
    classDef decide fill:#FF9800,color:#fff
    classDef out fill:#9C27B0,color:#fff
    classDef extern fill:#607D8B,color:#fff
Hỗ trợ tác vụ#
Phần triển khai chưng cất trích xuất đặc trưng từ ba layer neck cấp dữ liệu cho head thuộc dòng Detect của model. Vì các head segment, pose và obb kế thừa cùng kiến trúc Detect, phương pháp chưng cất cũng tương thích về mặt kỹ thuật với các tác vụ đó.
Phân loại, phân đoạn ngữ nghĩa, ước lượng độ sâu và RT-DETR không dùng head tương thích thuộc dòng Detect nên không được hỗ trợ.
Chỉ detect đã được đánh giá benchmark và xác minh bằng thực nghiệm. Bạn có thể chạy chưng cất cho segment, pose hoặc obb, nhưng mức cải thiện độ chính xác của các tác vụ đó chưa được xác thực.
from ultralytics import YOLO

# Segment
model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=100, distill_model="yolo26s-seg.pt")

# Pose
model = YOLO("yolo26n-pose.pt")
model.train(data="coco8-pose.yaml", epochs=100, distill_model="yolo26s-pose.pt")

# OBB
model = YOLO("yolo26n-obb.pt")
model.train(data="dota8.yaml", epochs=100, distill_model="yolo26s-obb.pt")
Huấn luyện#
Huấn luyện cơ bản#
Huấn luyện bằng phương pháp chưng cất giống hệt huấn luyện tiêu chuẩn. Cung cấp đường dẫn distill_model để bật tính năng này:
from ultralytics import YOLO

# Nạp model student
student = YOLO("yolo26m.pt")

# Huấn luyện bằng chưng cất tri thức từ model teacher lớn hơn
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26x.pt")
Điều chỉnh trọng số loss chưng cất#
Tham số dis (mặc định: 6.0) kiểm soát mức đóng góp của loss chưng cất:
from ultralytics import YOLO

student = YOLO("yolo26n.pt")
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt", dis=10.0)
Tiếp tục huấn luyện chưng cất#
Quá trình huấn luyện chưng cất hỗ trợ tiếp tục từ checkpoint. Model teacher được dựng lại tự động từ đường dẫn distill_model được ghi trong checkpoint:
from ultralytics import YOLO

student = YOLO("runs/detect/train/weights/last.pt")
results = student.train(resume=True)
Đầu ra huấn luyện#
Khi bật chưng cất, một cột dis_loss bổ sung sẽ xuất hiện trong log huấn luyện:
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss   dis_loss  Instances       Size
      1/80      46.2G      1.566      5.404    0.003249      6.658        231        640
Model được export chỉ chứa trọng số student—kích thước file và tốc độ inference tương đương với model student được huấn luyện theo cách thông thường.
Câu hỏi thường gặp#
- Xác minh teacher và student thuộc cùng thế hệ YOLO
- Xác nhận đường dẫn
distill_modelchính xác và file có thể được nạp - Thử tăng
disnếu giá trị loss rất nhỏ - Đảm bảo model teacher được huấn luyện trên cùng dataset
Thêm tham số
distill_model—mọi thứ khác hoạt động giống hệt. Trong quá trình huấn luyện, loss chưng cất bổ sung sẽ được tính, nhưng model đã lưu vẫn là model YOLO tiêu chuẩn và không có thêm chi phí.Có. Teacher bổ sung một lượt forward cho mỗi batch, vì vậy chi phí về thời gian và bộ nhớ phụ thuộc vào cặp teacher/student. Teacher chạy ở chế độ
eval, không có gradient hoặc trạng thái optimizer.Chưng cất tri thức hoạt động với các tác vụ detect, segment, pose và obb vì phương pháp này chưng cất đặc trưng từ ba layer neck cấp dữ liệu cho head thuộc dòng Detect. classify, semantic, depth và RT-DETR không được hỗ trợ.
Chỉ detect đã được xác minh thực nghiệm là cải thiện độ chính xác. Segment, pose và obb tương thích về mặt kỹ thuật nhưng chưa được benchmark.
Teacher và student phải thuộc cùng một họ YOLO (ví dụ: YOLOv8, YOLO11 hoặc YOLO26). Không hỗ trợ distillation giữa các họ khác nhau (ví dụ: teacher YOLO11 với student YOLO26).