SAM 2: Segment Anything Model 2

SAM 2, phiên bản kế nhiệm Segment Anything Model (SAM) của Meta, là model hợp nhất để phân đoạn đối tượng bằng prompt trong cả ảnh lẫn video. Kiến trúc duy nhất có thể nhận prompt hỗ trợ xử lý thời gian thực và khả năng khái quát hóa zero-shot.
Các model SAM 2.1 hỗ trợ tính năng chú giải thông minh trên Ultralytics Platform, cho phép phân đoạn bằng thao tác nhấp để gán nhãn dataset nhanh chóng. Xem hướng dẫn chú giải để biết chi tiết.
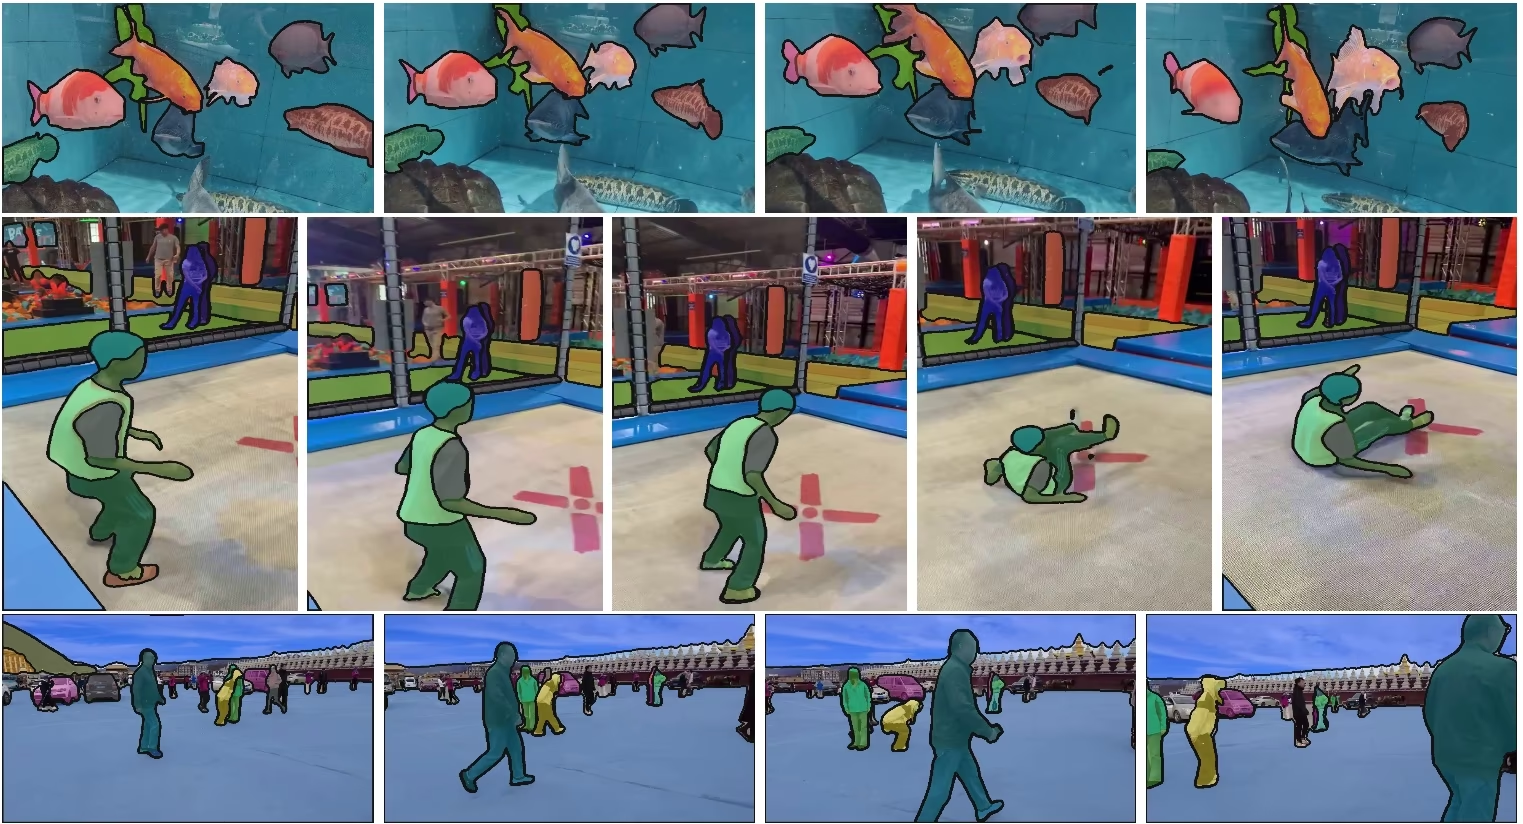
Tính năng chính#
Xem: Cách chạy suy luận với SAM2 của Meta bằng Ultralytics | Hướng dẫn từng bước
Kiến trúc model hợp nhất#
SAM 2 kết hợp khả năng phân đoạn ảnh và video trong một model duy nhất. Sự hợp nhất này đơn giản hóa việc triển khai và đảm bảo hiệu năng nhất quán trên nhiều loại phương tiện khác nhau. Model sử dụng giao diện linh hoạt dựa trên prompt, cho phép người dùng chỉ định các đối tượng quan tâm bằng nhiều loại prompt như điểm, bounding box hoặc mask.
Hiệu suất thời gian thực#
Model đạt tốc độ suy luận thời gian thực, xử lý khoảng 44 khung hình mỗi giây. Nhờ đó, SAM 2 phù hợp với các ứng dụng cần phản hồi tức thì, chẳng hạn như chỉnh sửa video và thực tế tăng cường.
Khả năng khái quát hóa zero-shot#
SAM 2 có thể phân đoạn các đối tượng chưa từng gặp trước đây, cho thấy khả năng khái quát hóa zero-shot mạnh mẽ. Điều này đặc biệt hữu ích trong các miền hình ảnh đa dạng hoặc luôn thay đổi, nơi các danh mục được xác định trước có thể không bao quát hết mọi đối tượng có thể xuất hiện.
Tinh chỉnh tương tác#
Người dùng có thể tinh chỉnh kết quả phân đoạn theo từng bước bằng cách cung cấp thêm prompt, qua đó kiểm soát đầu ra chính xác hơn. Khả năng tương tác này rất cần thiết để tinh chỉnh kết quả trong các ứng dụng như gán nhãn video hoặc chẩn đoán hình ảnh y khoa.
Xử lý các thách thức hình ảnh nâng cao#
SAM 2 có các cơ chế xử lý những thách thức phổ biến trong phân đoạn video, chẳng hạn như đối tượng bị che khuất rồi xuất hiện trở lại. Model sử dụng cơ chế bộ nhớ để theo dõi đối tượng qua các frame, đảm bảo tính liên tục ngay cả khi đối tượng tạm thời bị che hoặc rời khỏi rồi quay lại cảnh.
Để hiểu sâu hơn về kiến trúc và các khả năng của SAM 2, hãy khám phá bài báo nghiên cứu về SAM 2.
Hiệu năng và chi tiết kỹ thuật#
Theo Meta, SAM 2 vượt trội hơn các model trước đây trên một số chỉ số:
| Chỉ số | SAM 2 | SOTA trước đây |
|---|---|---|
| Phân đoạn video tương tác | Tốt nhất | - |
| Số lượt tương tác cần thiết của con người | Ít hơn 3 lần | Cơ sở |
| Độ chính xác phân đoạn ảnh | Được cải thiện | SAM |
| Tốc độ suy luận | Nhanh hơn 6 lần | SAM |
Kiến trúc model#
Các thành phần cốt lõi#
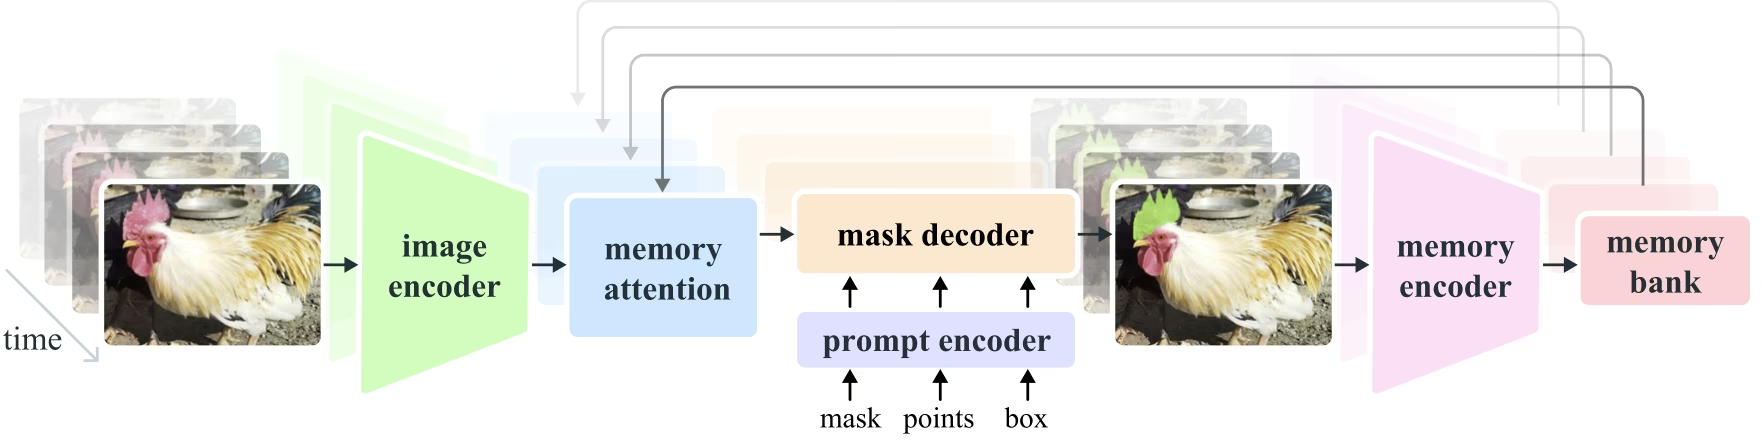
- Encoder ảnh và video: Sử dụng kiến trúc dựa trên transformer để trích xuất các đặc trưng cấp cao từ cả ảnh và frame video. Thành phần này chịu trách nhiệm hiểu nội dung hình ảnh tại mỗi bước thời gian.
- Encoder prompt: Xử lý các prompt do người dùng cung cấp (điểm, hộp, mask) để định hướng tác vụ phân đoạn. Nhờ đó, SAM 2 có thể thích ứng với đầu vào của người dùng và nhắm đến các đối tượng cụ thể trong cảnh.
- Cơ chế bộ nhớ: Bao gồm bộ mã hóa bộ nhớ, ngân hàng bộ nhớ và module chú ý bộ nhớ. Các thành phần này phối hợp lưu trữ và sử dụng thông tin từ những frame trước, giúp model duy trì theo dõi đối tượng nhất quán theo thời gian.
- Decoder mask: Tạo các mask phân đoạn cuối cùng dựa trên đặc trưng ảnh đã mã hóa và các prompt. Trong video, decoder cũng sử dụng ngữ cảnh bộ nhớ để đảm bảo theo dõi chính xác qua các frame.
Cơ chế bộ nhớ và xử lý hiện tượng che khuất#
Cơ chế bộ nhớ cho phép SAM 2 xử lý các phụ thuộc theo thời gian và hiện tượng che khuất trong dữ liệu video. Khi các đối tượng di chuyển và tương tác, SAM 2 ghi lại đặc trưng của chúng vào memory bank. Khi một đối tượng bị che khuất, model có thể dựa vào bộ nhớ này để dự đoán vị trí và diện mạo của đối tượng khi xuất hiện trở lại. Occlusion head xử lý riêng các tình huống đối tượng không hiển thị, bằng cách dự đoán khả năng đối tượng bị che khuất.
Giải quyết sự mơ hồ giữa nhiều mask#
Trong các tình huống mơ hồ (ví dụ: các đối tượng chồng lấp), SAM 2 có thể tạo nhiều dự đoán mask. Điều này giúp biểu diễn các cảnh phức tạp mà một mask duy nhất có thể không thể hiện được đối tượng mong muốn.
Dataset SA-V#
Dataset SA-V, được phát triển để huấn luyện SAM 2, là một trong những dataset phân đoạn video lớn nhất và đa dạng nhất hiện có. Dataset này bao gồm:
- Hơn 51.000 video: Được ghi hình tại 47 quốc gia, cung cấp nhiều tình huống thực tế đa dạng.
- Hơn 600.000 chú giải mask: Các chú giải mask không gian-thời gian chi tiết, được gọi là "masklet", bao phủ toàn bộ đối tượng và các bộ phận của chúng.
- Quy mô dataset: Có số lượng video nhiều gấp 4.5 lần và số lượng annotation nhiều gấp 53 lần so với các dataset phân đoạn video lớn nhất trước đây.
Benchmark#
Phân đoạn đối tượng trong video#
SAM 2 báo cáo các kết quả sau trên những benchmark phân đoạn video lớn:
| Dataset | J&F | J | F |
|---|---|---|---|
| DAVIS 2017 | 82.5 | 79.8 | 85.2 |
| YouTube-VOS | 81.2 | 78.9 | 83.5 |
Phân đoạn tương tác#
Trên các tác vụ phân đoạn tương tác, SAM 2 đạt các kết quả sau:
| Dataset | NoC@90 | AUC |
|---|---|---|
| DAVIS tương tác | 1.54 | 0.872 |
Cài đặt#
SAM 2 có trong package ultralytics. Cài đặt bằng lệnh sau; trọng số SAM 2 sẽ tự động tải xuống khi sử dụng lần đầu.
pip install ultralyticsCách sử dụng SAM 2: Tính linh hoạt trong phân đoạn ảnh và video#
Bảng sau trình bày chi tiết các model SAM 2 hiện có, trọng số được huấn luyện trước, tác vụ được hỗ trợ và khả năng tương thích với các chế độ vận hành khác nhau như Huấn luyện, Xác thực, Suy luận và Xuất.
| Loại model | Weights pretrained | Các tác vụ được hỗ trợ | Huấn luyện | Validation | Suy luận | Export |
|---|---|---|---|---|---|---|
| SAM 2 tiny | sam2_t.pt | Phân đoạn đối tượng | ❌ | ❌ | ✅ | ❌ |
| SAM 2 small | sam2_s.pt | Phân đoạn đối tượng | ❌ | ❌ | ✅ | ❌ |
| SAM 2 base | sam2_b.pt | Phân đoạn đối tượng | ❌ | ❌ | ✅ | ❌ |
| SAM 2 large | sam2_l.pt | Phân đoạn đối tượng | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 tiny | sam2.1_t.pt | Phân đoạn đối tượng | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 small | sam2.1_s.pt | Phân đoạn đối tượng | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 base | sam2.1_b.pt | Phân đoạn đối tượng | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 large | sam2.1_l.pt | Phân đoạn đối tượng | ❌ | ❌ | ✅ | ❌ |
Ví dụ dự đoán với SAM 2#
SAM 2 có thể được sử dụng cho nhiều tác vụ như chỉnh sửa video thời gian thực, chẩn đoán hình ảnh y khoa và hệ thống tự hành. Khả năng phân đoạn dữ liệu thị giác tĩnh lẫn động khiến model trở thành công cụ linh hoạt cho các nhà nghiên cứu và nhà phát triển.
Phân đoạn bằng prompt#
Dùng prompt để phân đoạn các đối tượng cụ thể trong ảnh hoặc video.
from ultralytics import SAM

# Tải model
model = SAM("sam2.1_b.pt")

# Hiển thị thông tin model (không bắt buộc)
model.info()

# Chạy suy luận với prompt bboxes
results = model("path/to/image.jpg", bboxes=[100, 100, 200, 200])

# Chạy suy luận với một điểm đơn
results = model(points=[900, 370], labels=[1])

# Chạy suy luận với nhiều điểm
results = model(points=[[400, 370], [900, 370]], labels=[1, 1])

# Chạy suy luận với prompt gồm nhiều điểm cho mỗi đối tượng
results = model(points=[[[400, 370], [900, 370]]], labels=[[1, 1]])

# Chạy suy luận với prompt gồm các điểm âm
results = model(points=[[[400, 370], [900, 370]]], labels=[[1, 0]])
Phân đoạn mọi thứ#
Phân đoạn toàn bộ nội dung ảnh hoặc video mà không cần prompt cụ thể.
from ultralytics import SAM

# Tải model
model = SAM("sam2.1_b.pt")

# Hiển thị thông tin model (không bắt buộc)
model.info()

# Chạy suy luận
model("path/to/video.mp4")- Ví dụ này minh họa cách sử dụng SAM 2 để phân đoạn toàn bộ nội dung của ảnh hoặc video khi không cung cấp prompt (bboxes/points/masks).
Phân đoạn video và theo dõi đối tượng#
Phân đoạn toàn bộ nội dung video bằng các prompt cụ thể và theo dõi đối tượng.
from ultralytics.models.sam import SAM2VideoPredictor

# Create SAM2VideoPredictor
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "imgsz": 1024, "model": "sam2_b.pt"}
predictor = SAM2VideoPredictor(overrides=overrides)

# Chạy suy luận với một điểm đơn
results = predictor(source="test.mp4", points=[920, 470], labels=[1])

# Chạy suy luận với nhiều điểm
results = predictor(source="test.mp4", points=[[920, 470], [909, 138]], labels=[1, 1])

# Chạy suy luận với prompt gồm nhiều điểm cho mỗi đối tượng
results = predictor(source="test.mp4", points=[[[920, 470], [909, 138]]], labels=[[1, 1]])

# Chạy suy luận với prompt gồm các điểm âm
results = predictor(source="test.mp4", points=[[[920, 470], [909, 138]]], labels=[[1, 0]])
Phân đoạn tương tác động và theo dõi#
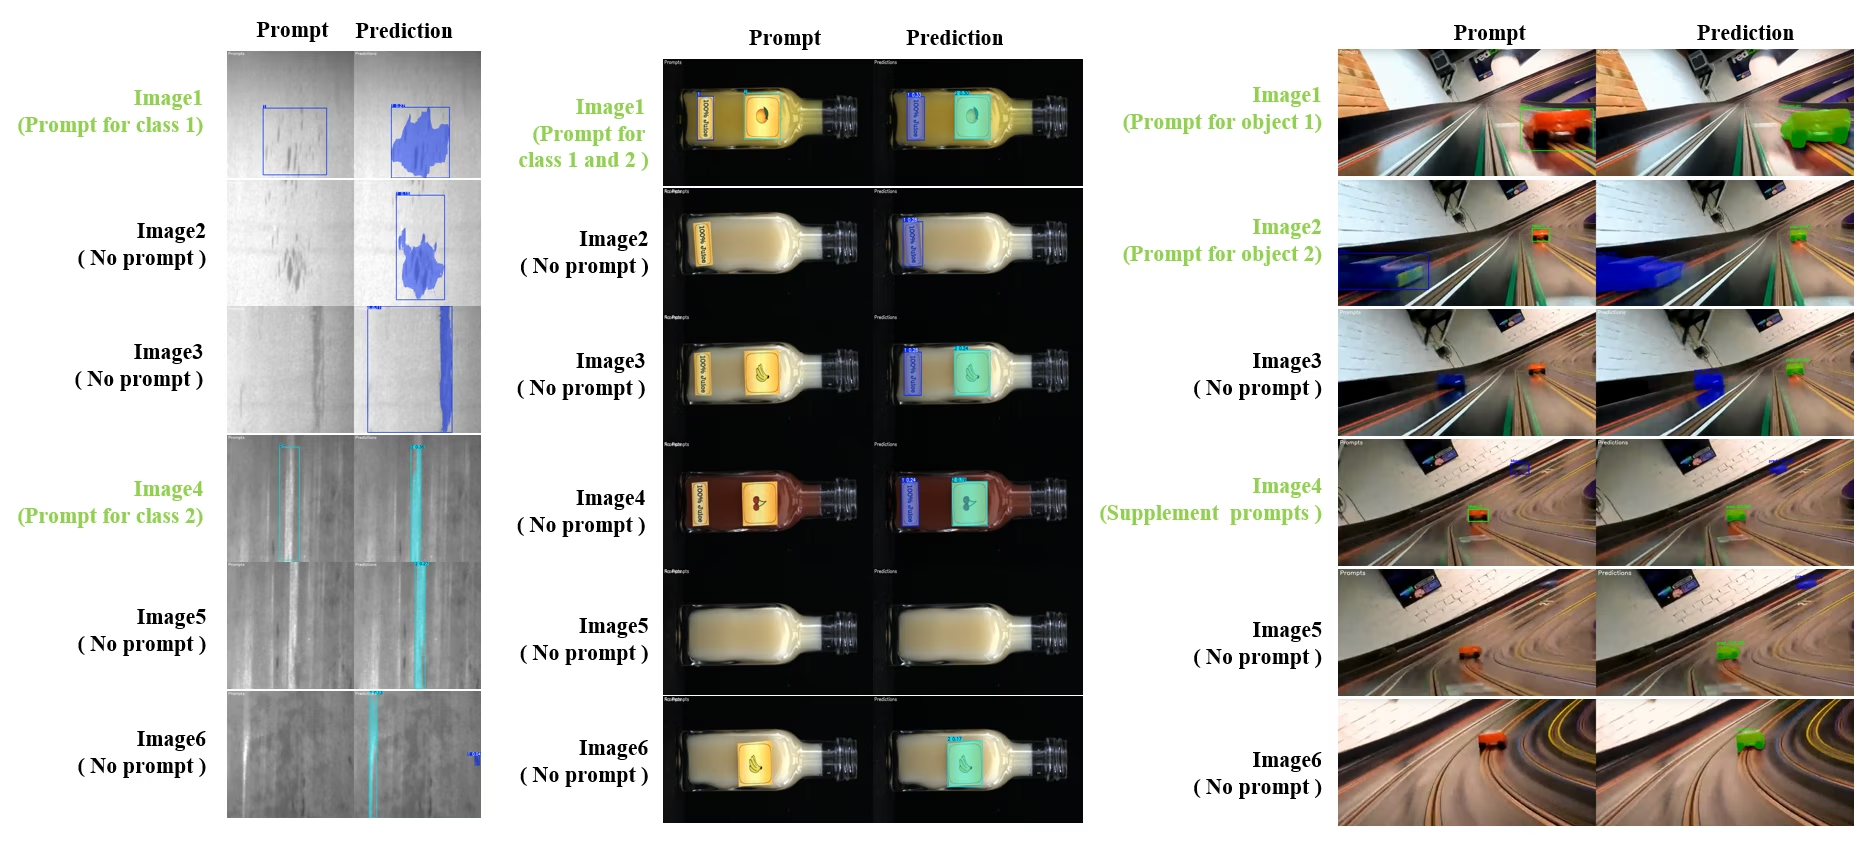
SAM2DynamicInteractivePredictor là phần mở rộng của SAM 2 không cần huấn luyện, cho phép tương tác động với nhiều frame và hỗ trợ học liên tục. Predictor này hỗ trợ cập nhật prompt theo thời gian thực và quản lý bộ nhớ để cải thiện hiệu năng theo dõi xuyên suốt một chuỗi ảnh. So với SAM 2 gốc, SAM2DynamicInteractivePredictor xây dựng lại luồng suy luận để tận dụng tối đa các model SAM 2 được huấn luyện trước mà không cần huấn luyện bổ sung.
Tính năng chính#
Tính năng này có ba cải tiến:
- Tương tác động: Thêm prompt cho các instance mới chưa được theo dõi ở những frame sau, vào bất kỳ thời điểm nào trong quá trình xử lý video
- Học liên tục: Thêm prompt cho các instance hiện có để cải thiện hiệu năng của model theo thời gian
- Hỗ trợ nhiều ảnh độc lập: Xử lý nhiều ảnh độc lập (không nhất thiết thuộc cùng một chuỗi video) với khả năng chia sẻ bộ nhớ và theo dõi đối tượng xuyên ảnh
Các khả năng cốt lõi#
- Tính linh hoạt của prompt: Chấp nhận hộp giới hạn, điểm và mask làm prompt
- Quản lý memory bank: Duy trì memory bank động để lưu trạng thái đối tượng qua các frame
- Theo dõi nhiều đối tượng: Hỗ trợ theo dõi đồng thời nhiều đối tượng với ID riêng cho từng đối tượng
- Cập nhật theo thời gian thực: Cho phép thêm prompt trong quá trình suy luận mà không cần xử lý lại các frame trước đó
- Xử lý ảnh độc lập: Xử lý các ảnh riêng lẻ với ngữ cảnh bộ nhớ dùng chung để đảm bảo tính nhất quán của đối tượng xuyên ảnh
from ultralytics.models.sam import SAM2DynamicInteractivePredictor

# Create SAM2DynamicInteractivePredictor
overrides = {"conf": 0.01, "task": "segment", "mode": "predict", "imgsz": 1024, "model": "sam2_t.pt", "save": False}
predictor = SAM2DynamicInteractivePredictor(overrides=overrides, max_obj_num=10)

# Xác định một danh mục bằng prompt dạng hộp
predictor(source="image1.jpg", bboxes=[[100, 100, 200, 200]], obj_ids=[0], update_memory=True)

# Phát hiện đối tượng cụ thể này trong ảnh mới
results = predictor(source="image2.jpg")

# Thêm danh mục mới với ID đối tượng mới
results = predictor(
    source="image4.jpg",
    bboxes=[[300, 300, 400, 400]],  # Đối tượng mới
    obj_ids=[1],  # ID đối tượng mới
    update_memory=True,  # Thêm vào bộ nhớ
)
# Thực hiện suy luận
results = predictor(source="image5.jpg")

# Thêm các prompt tinh chỉnh vào cùng danh mục để cải thiện hiệu suất
# Điều này hữu ích khi diện mạo đối tượng thay đổi đáng kể
results = predictor(
    source="image6.jpg",
    points=[[150, 150]],  # Điểm tinh chỉnh
    labels=[1],  # Điểm dương
    obj_ids=[1],  # Cùng ID đối tượng
    update_memory=True,  # Cập nhật bộ nhớ bằng thông tin mới
)
# Thực hiện suy luận trên ảnh mới
results = predictor(source="image7.jpg")SAM2DynamicInteractivePredictor được thiết kế để hoạt động với các model SAM 2 và hỗ trợ thêm cũng như tinh chỉnh danh mục bằng tất cả prompt hộp, điểm và mask mà SAM 2 hỗ trợ nguyên bản. Tính năng này đặc biệt hữu ích trong các tình huống đối tượng xuất hiện hoặc thay đổi theo thời gian, chẳng hạn như chú thích video hoặc các tác vụ chỉnh sửa tương tác.
Đối số#
| Tên | Giá trị mặc định | Kiểu dữ liệu | Mô tả |
|---|---|---|---|
max_obj_num | 3 | int | Số lượng danh mục tối đa được thiết lập sẵn |
update_memory | False | bool | Có cập nhật bộ nhớ bằng prompt mới hay không |
obj_ids | None | List[int] | Danh sách ID đối tượng tương ứng với các prompt |
Trường hợp sử dụng#
SAM2DynamicInteractivePredictor phù hợp với:
- Quy trình chú thích video khi đối tượng mới xuất hiện trong chuỗi
- Chỉnh sửa video tương tác cần thêm và tinh chỉnh đối tượng theo thời gian thực
- Ứng dụng giám sát cần theo dõi đối tượng động
- Chẩn đoán hình ảnh y tế để theo dõi cấu trúc giải phẫu qua chuỗi thời gian
- Hệ thống tự hành cần phát hiện và theo dõi đối tượng thích ứng
- Tập dữ liệu nhiều ảnh để phân đoạn đối tượng nhất quán trên các ảnh độc lập
- Phân tích bộ sưu tập ảnh khi cần theo dõi đối tượng qua các cảnh khác nhau
- Phân đoạn xuyên miền tận dụng bộ nhớ từ nhiều ngữ cảnh ảnh đa dạng
- Chú thích bán tự động để tạo tập dữ liệu hiệu quả với ít can thiệp thủ công
So sánh SAM với YOLO#
Sau đây là so sánh các model SAM 2 của Meta, bao gồm biến thể SAM2-t nhỏ nhất, với các model phân đoạn của Ultralytics, bao gồm YOLO26:
| Model | Kích thước (MB) | Tham số (M) | Tốc độ (CPU) (ms/ảnh) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 41703 |
| Meta SAM2-b | 162 | 80.8 | 28867 |
| Meta SAM2-t | 78.1 | 38.9 | 23430 |
| MobileSAM | 40.7 | 10.1 | 23802 |
| FastSAM-s với backbone YOLOv8 | 23.9 | 11.8 | 58.0 |
| Ultralytics YOLOv8n-seg | 7.1 (nhỏ hơn 11.0 lần) | 3.4 (ít hơn 11.4 lần) | 24.8 (nhanh hơn 945 lần) |
| Ultralytics YOLO11n-seg | 6.2 (nhỏ hơn 12.6 lần) | 2.9 (ít hơn 13.4 lần) | 24.3 (nhanh hơn 964 lần) |
| Ultralytics YOLO26n-seg | 6.7 (nhỏ hơn 11.7 lần) | 2.7 (ít hơn 14.4 lần) | 25.2 (nhanh hơn 930 lần) |
So sánh này cho thấy sự khác biệt đáng kể về kích thước và tốc độ giữa các biến thể SAM và model phân đoạn YOLO. SAM có khả năng phân đoạn tự động độc đáo, nhưng các model YOLO, đặc biệt là YOLOv8n-seg, YOLO11n-seg và YOLO26n-seg, nhỏ hơn, nhanh hơn và hiệu quả tính toán hơn đáng kể.
Tốc độ SAM được đo bằng PyTorch, tốc độ YOLO được đo bằng ONNX Runtime. Các thử nghiệm được chạy trên Apple M4 Air 2025 với RAM 16GB, sử dụng torch==2.10.0, ultralytics==8.4.31 và onnxruntime==1.24.4. Để tái tạo thử nghiệm này:
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# Đo hiệu năng SAM2-t, SAM2-b, SAM-b, MobileSAM
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# Lập hồ sơ FastSAM-s
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# Đo hiệu năng các model YOLO (ONNX)
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    onnx_path = model.export(format="onnx", dynamic=True, nms=False)  # Đầu NMS-free của YOLO26; không có tác dụng với YOLOv8/YOLO11
    model = YOLO(onnx_path)
    model(ASSETS)
Tự động chú thích: Tạo tập dữ liệu hiệu quả#
Tính năng tự động gán nhãn kết hợp SAM 2 với một model phát hiện được huấn luyện trước để nhanh chóng tạo dataset phân đoạn mà không cần gán nhãn thủ công nhiều. Ultralytics Platform cũng cung cấp tính năng tự động gán nhãn trên trình duyệt bằng các model thị giác được lưu trữ; hãy so sánh độ chính xác phát hiện, chi phí và tốc độ của các model này trên bảng xếp hạng VLM.
Cách tự động chú thích bằng SAM 2#
Xem: Tự động gán nhãn bằng model Segment Anything 2 của Meta với Ultralytics | Gán nhãn dữ liệu
Để tự động gán nhãn dataset bằng detector YOLO26x và SAM 2, hãy làm theo ví dụ này:
from ultralytics.data.annotator import auto_annotate

auto_annotate(data="path/to/images", det_model="yolo26x.pt", sam_model="sam2_b.pt")| Đối số | Kiểu | Mặc định | Mô tả |
|---|---|---|---|
data | str | bắt buộc | Đường dẫn đến thư mục chứa ảnh mục tiêu cần chú thích hoặc phân đoạn. |
det_model | str | 'yolo26x.pt' | Đường dẫn đến model phát hiện YOLO để phát hiện đối tượng ban đầu. |
sam_model | str | 'sam_b.pt' | Đường dẫn đến model SAM để phân đoạn (hỗ trợ các weight của SAM, SAM 2, MobileSAM và SAM 3). |
device | str | '' | Thiết bị tính toán (ví dụ: 'cuda:0', 'cpu' hoặc '' để tự động phát hiện thiết bị). |
conf | float | 0.25 | Ngưỡng confidence của model phát hiện YOLO để lọc các kết quả phát hiện yếu. |
iou | float | 0.5 | Ngưỡng IoU cho Non-Maximum Suppression để lọc các hộp chồng lấn. |
imgsz | int | 640 | Kích thước đầu vào để thay đổi kích thước ảnh (nếu cần, làm tròn lên bội số của 32). |
max_det | int | 300 | Số lượng kết quả phát hiện tối đa trên mỗi ảnh để tiết kiệm bộ nhớ. |
classes | list[int] | None | Danh sách chỉ số class cần phát hiện (ví dụ: [0, 1] cho người và xe đạp). |
output_dir | str | None | Thư mục lưu chú thích (mặc định: thư mục cùng cấp với <data>_auto_annotate_labels). |
Hàm này chuyển một thư mục ảnh chưa được gán nhãn thành dataset phân đoạn với nỗ lực thủ công tối thiểu.
Hạn chế#
Dù có nhiều ưu điểm, SAM 2 vẫn có một số hạn chế:
- Độ ổn định khi theo dõi: SAM 2 có thể mất dấu đối tượng trong các chuỗi kéo dài hoặc khi góc nhìn thay đổi đáng kể.
- Nhầm lẫn đối tượng: Đôi khi model có thể nhầm lẫn các đối tượng trông giống nhau, đặc biệt trong những cảnh đông đúc.
- Hiệu quả khi xử lý nhiều đối tượng: Hiệu quả phân đoạn giảm khi xử lý đồng thời nhiều đối tượng do thiếu cơ chế giao tiếp giữa các đối tượng.
- Độ chính xác chi tiết Accuracy: Có thể bỏ sót chi tiết nhỏ, nhất là với các đối tượng chuyển động nhanh. Prompt bổ sung có thể khắc phục phần nào vấn đề này, nhưng không đảm bảo độ mượt theo thời gian.
Trích dẫn và lời cảm ơn#
Nếu sử dụng SAM 2 trong nghiên cứu hoặc công việc phát triển, vui lòng trích dẫn theo tài liệu tham khảo sau:
@article{ravi2024sam2,
  title={SAM 2: Segment Anything in Images and Videos},
  author={Ravi, Nikhila and Gabeur, Valentin and Hu, Yuan-Ting and Hu, Ronghang and Ryali, Chaitanya and Ma, Tengyu and Khedr, Haitham and R{\"a}dle, Roman and Rolland, Chloe and Gustafson, Laura and Mintun, Eric and Pan, Junting and Alwala, Kalyan Vasudev and Carion, Nicolas and Wu, Chao-Yuan and Girshick, Ross and Doll{\'a}r, Piotr and Feichtenhofer, Christoph},
  journal={arXiv preprint},
  year={2024}
}
Chúng tôi cảm ơn Meta AI đã phát hành model và dataset này cho cộng đồng AI.
Câu hỏi thường gặp#
SAM 2, phiên bản kế nhiệm Mô hình Segment Anything (SAM) của Meta, là một model thống nhất có thể điều khiển bằng prompt để phân đoạn đối tượng trong cả ảnh và video. SAM 2 có một số cải tiến so với SAM ban đầu, bao gồm:
- Kiến trúc model thống nhất: Kết hợp khả năng phân đoạn ảnh và video trong một model duy nhất.
- Hiệu năng thời gian thực: Xử lý khoảng 44 khung hình mỗi giây, phù hợp với các ứng dụng cần phản hồi tức thì.
- Khả năng khái quát hóa zero-shot: Phân đoạn các đối tượng model chưa từng gặp, hữu ích trong nhiều miền hình ảnh khác nhau.
- Tinh chỉnh tương tác: Cho phép người dùng tinh chỉnh kết quả phân đoạn theo từng bước bằng cách cung cấp prompt bổ sung.
- Xử lý nâng cao các thách thức hình ảnh: Xử lý các thách thức thường gặp trong phân đoạn video như đối tượng bị che khuất và xuất hiện trở lại.
Để biết thêm chi tiết về kiến trúc và khả năng của SAM 2, hãy xem bài báo nghiên cứu về SAM 2.
SAM 2 hỗ trợ phân đoạn video theo thời gian thực thông qua giao diện điều khiển bằng prompt và tốc độ suy luận nhanh. Sau đây là ví dụ cơ bản:
Phân đoạn bằng promptDùng prompt để phân đoạn các đối tượng cụ thể trong ảnh hoặc video.
from ultralytics import SAM

# Tải model
model = SAM("sam2_b.pt")

# Hiển thị thông tin model (không bắt buộc)
model.info()

# Phân đoạn bằng prompt hộp giới hạn
results = model("path/to/image.jpg", bboxes=[100, 100, 200, 200])

# Phân đoạn bằng prompt điểm
results = model("path/to/image.jpg", points=[150, 150], labels=[1])
Để tìm hiểu cách sử dụng đầy đủ hơn, hãy tham khảo mục Cách sử dụng SAM 2.
SAM 2 được huấn luyện trên dataset SA-V, một trong những dataset phân đoạn video lớn nhất và đa dạng nhất hiện có. Dataset SA-V bao gồm:
- Hơn 51.000 video: Được ghi hình tại 47 quốc gia, cung cấp nhiều tình huống thực tế đa dạng.
- Hơn 600.000 chú giải mask: Các chú giải mask không gian-thời gian chi tiết, được gọi là "masklet", bao phủ toàn bộ đối tượng và các bộ phận của chúng.
- Quy mô tập dữ liệu: Có số video nhiều gấp 4,5 lần và số chú thích nhiều gấp 53 lần so với các tập dữ liệu lớn nhất trước đó, mang lại mức độ đa dạng và phức tạp chưa từng có.
Dataset này giúp SAM 2 đạt kết quả cao trên các benchmark phân đoạn video lớn và cải thiện khả năng khái quát hóa zero-shot.
SAM 2 bao gồm cơ chế bộ nhớ để quản lý các phụ thuộc thời gian và hiện tượng che khuất trong dữ liệu video. Cơ chế bộ nhớ gồm:
- Bộ mã hóa bộ nhớ và ngân hàng bộ nhớ: Lưu trữ đặc trưng từ các khung hình trước.
- Module attention bộ nhớ: Sử dụng thông tin đã lưu trữ để duy trì việc theo dõi đối tượng nhất quán theo thời gian.
- Đầu dự đoán che khuất: Xử lý riêng các tình huống đối tượng không hiển thị, dự đoán khả năng đối tượng bị che khuất.
Cơ chế này đảm bảo tính liên tục ngay cả khi đối tượng tạm thời bị che khuất hoặc rời khỏi rồi quay lại cảnh. Để biết thêm chi tiết, hãy tham khảo mục Cơ chế bộ nhớ và xử lý che khuất.
Các model SAM 2 như SAM2-t và SAM2-b của Meta có khả năng phân đoạn zero-shot mạnh mẽ, nhưng lớn hơn và chậm hơn đáng kể so với các model YOLO. Chẳng hạn, YOLO26n-seg nhỏ hơn khoảng 24 lần và nhanh hơn hơn 1145 lần so với SAM2-b trên CPU. SAM 2 nổi trội trong các tình huống phân đoạn đa dụng, dựa trên prompt và zero-shot, trong khi YOLO26 được tối ưu về tốc độ, hiệu quả và ứng dụng thời gian thực với suy luận end-to-end không cần NMS, nhờ đó phù hợp hơn để triển khai trong môi trường hạn chế tài nguyên.


Bình luận150
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.
 Glenn JocherUltralytics
Hey everyone! We wanted to give you a quick update: our team is currently busy integrating SAM 2 (Segment Anything Model 2) into the Ultralytics package. This new model is super exciting, with features like real-time performance and the ability to segment objects it’s never seen before.
We're really pumped about what SAM2 can do, but it's still in the works. Thanks for your patience as we get everything set up! We'll keep you posted as we make progress. Stay tuned!
10- Glenn JocherUltralytics
Update: SAM 2 is now fully integrated! Update your package to
ultralytics>=8.2.70withpip install -U ultralyticsand then for example:from ultralytics import ASSETS, SAM # Load a model model = SAM("sam2_s.pt") # Segment with point prompt results = model(ASSETS / "bus.jpg", points=[150, 150], labels=[1], device="cpu")1
avasanjesh
Hello,
Can i use sam2.1 for real time segmentation? i want to specify the object on the first frame of live video webcam then sam2.1 shows the segmentation and continue to track and show the result of segmentation of that object. Is it possible to do this?
1thedatamask
Breaking News: 🚨 SAM 1.0 outperforms SAM 2.0 on low-contrast images like CT Scan and MRI images! Check out this insightful video from Data Mask YouTube channel where they dive deep into the architecture, demos, and limitations of both Meta's segmentation models. Discover when to use SAM 1.0 for superior results on challenging images.
Use case with ultralytics
https://www.youtube.com/watch?v=vMI-TnyNLYU
Please do like and subscribe for exciting video like above .
#SAM #SAM2.0 #MetaAI #ImageSegmentation #AI #MachineLearning #DeepLearning #DataMask #BreakingNews
1- Glenn JocherUltralytics
@thedatamask thank you for sharing the video. For insights on SAM 2's capabilities and its comparison with other models, you can explore our documentation. If you have specific questions about using SAM 2 with Ultralytics, feel free to ask!
ram-from-tvl
Hi Team,
the below is the code I have been using to annotate some items in a folder of several images. I am planning to segment everything first and then try to cherry pick the ones that are to be annotated for a downstream segmentation task. Could you please tailor the code for the same. I am not getting any help from the docs regarding the same. i have tried auto annotate but its not working for my use case. So please help me in this approach
` from ultralytics import SAM
Load a model
model = SAM("sam2.1_b.pt")
Display model information (optional)
model.info()
Run inference
model("/kaggle/working/10_random_frames") `
Thankyou
Regards Ram
 Onuralp SezerUltralytics
Hi Team,
the below is the code I have been using to annotate some items in a folder of several images. I am planning to segment everything first and then try to cherry pick the ones that are to be annotated for a downstream segmentation task. Could you please tailor the code for the same. I am not getting any help from the docs regarding the same. i have tried auto annotate but its not working for my use case. So please help me in this approach
` from ultralytics import SAM
Load a model
model = SAM("sam2.1_b.pt")
Display model information (optional)
model.info()
Run inference
model("/kaggle/working/10_random_frames") `
Thankyou
Regards Ram
You may want check out here https://docs.ultralytics.com/reference/data/annotator/#ultralytics.data.annotator.auto_annotate
zhaowangalready
Hello, dear doctor, I encountered some problems in the automatic annotation segmentation. I used the successfully annotated data for verification and found that the data of each species has a serial number border. How can I remove the serial number border? I hope to hear from you.
- Glenn JocherUltralytics
auto_annotate()生成的是标准 YOLO-seg 标签:每一行开头的“数字”是类别class_id(必需字段,不能删),如果你看到的是验证/预测保存出来的图片上带编号的边框/轮廓,那只是可视化绘图,不会写进数据本身;你可以按 SAM 2 文档 继续用同一套数据训练/验证,同时关掉这些 plot:yolo val model=yolo26n-seg.pt data=path/to/data.yaml plots=False yolo predict model=sam2.1_b.pt source=path/to/images show_labels=False show_boxes=False方便的话把“带序号边框”的截图 + 对应的一行标签
.txt内容贴在这个 discussion 里,我帮你确认你看到的到底是class_id还是绘图叠加效果。
cyberpunk-edgerunner
I have to question related to SAM2 :
- How to use text-prompt for segmentation using SAM ?
- Along with the bounding box coordinates, is there a way to tell SAM what not to segment ?
I have two questions regarding segmentation with SAM2 and YOLOv11:
1. Visualization and Editing with SAM2 I've used the
auto_annotatefeature and I'm wondering:- How can I visualize the segmentations produced by the SAM2 model?
- Is there a way to manually inspect or edit these segmentations?
I'm aiming to verify the outputs before proceeding further.
2. Saving and Cropping Segmentations I'm using the following code to detect and segment images with YOLOv11 and SAM2:
from ultralytics import YOLO
from ultralytics import SAM

model = YOLO(r"runs\detect\train2\weights\best.pt")
sam_model = SAM("sam2_b.pt")

results = model("more_test_images", save=True)

for result in results:
    class_ids = result.boxes.cls.int().tolist()

    if len(class_ids):
        boxes = result.boxes.xyxy
        sam_results = sam_model(result.orig_img, bboxes=boxes, verbose=False, save=True)
The detection results from YOLOv11 are saved correctly, but only one segmented result is saved by SAM2.
Questions:
- How can I ensure all SAM2 segmentations are saved for each image?
- How can I crop and save only the segmented parts (i.e., masked regions) from each image? I need these as separate images, containing only the segmented pixels.
Any help or pointers would be greatly appreciated!
fangyuZ1025
Hello, dear doctor, I encountered some problems in the automatic annotation segmentation. The automatic annotation automatically marked various marks on my output, but in fact, this is not the correct mark of my picture, and even some pictures cannot recognise the objects in it. How can I make it change the label uniform? For example, all of them are labelled as "fruit", "vehicle" and so on? I hope to get your reply.
from ultralytics.data.annotator import auto_annotate
auto_annotate(data=r"D:\graduation.thesis\mydata\mt_label\images", det_model="yolov8n.pt", sam_model="sam2_b.pt")
image 19/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112848.jpg: 640x640 (no detections), 33.4ms image 20/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112858.jpg: 640x640 1 orange, 31.9ms image 21/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112907.jpg: 640x640 1 apple, 35.3ms image 22/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112916.jpg: 640x640 (no detections), 34.0ms image 23/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112938.jpg: 640x640 (no detections), 35.3ms image 24/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112947.jpg: 640x640 1 donut, 32.1ms image 25/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113004.jpg: 640x640 (no detections), 28.6ms image 26/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113014.jpg: 640x640 1 donut, 33.9ms image 27/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113028.jpg: 640x640 1 apple, 1 donut, 35.8ms
- Glenn JocherUltralytics(đã chỉnh sửa)
@fangyuZ1025 to improve label consistency in auto-annotation, you'll need to train a custom detection model with your specific classes ("fruit", "vehicle") first. The auto_annotate function relies on your detection model's class definitions - it doesn't rename labels but uses whatever classes your det_model was trained on. For immediate improvement, try a newer detection model such as YOLO26 (for example
det_model="yolo26n.pt"), which is more accurate than YOLOv8.
Fatima-khanjar
Hello, I am using SAM2 with my fine-tuned YOLOv11 on my custom dataset to perform auto-annotation for an object detection task. However, the annotations in the .txt file are not in the YOLO format (class_label x_center y_center width height).
Could you clarify the format of the labels generated when using both SAM2 and YOLOv11 for auto-annotation?
- Glenn JocherUltralytics
@Fatima-khanjar the auto-annotation function generates segmentation masks in YOLO segmentation format (polygon points normalized 0-1), not bounding boxes. For object detection tasks, you'll need to convert these masks to bounding boxes using
masks.xyfrom Results objects. We recommend reviewing the Auto-Annotation with SAM2 documentation for implementation details and conversion examples.1
danieltudosiu(đã chỉnh sửa)
How does one use SAM2 with a numpy input? I saw how to do it with SAM but SAM2 does not have a preprocess method like SAM.
- Glenn JocherUltralytics(đã chỉnh sửa)
@danieltudosiu you can pass numpy arrays directly as the source to
SAM. Here's a minimal example:import numpy as np from ultralytics import SAM model = SAM("sam2.1_b.pt") img = np.random.randint(0, 255, (640, 640, 3), dtype=np.uint8) # Your numpy array results = model(img, points=[100, 100], labels=[1])For more details, see the SAM 2 documentation.
But what about the Image one? Or just use the Video one for Images as well?
- Glenn JocherUltralytics(đã chỉnh sửa)
You can pass numpy arrays or file paths directly to
SAM("sam2.1_b.pt"), for examplemodel(img_array, points=[100, 100], labels=[1]).SAM2VideoPredictoris only needed for video. For image-specific examples, see the SAM 2 documentation.