YOLOE: Phát hiện và phân đoạn theo từ vựng mở theo thời gian thực
Ultralytics YOLOE (Nhìn thấy mọi thứ theo thời gian thực) là model phát hiện open-vocabulary và phân đoạn instance: thay vì dùng danh sách lớp cố định tại thời điểm huấn luyện, model nhận các danh mục bạn muốn tại thời điểm suy luận dưới dạng prompt văn bản, ví dụ trực quan hoặc từ vựng tích hợp gồm 4.585 tên. Được xây dựng trên các kiến trúc Ultralytics YOLO — YOLOv8, YOLO11 và YOLO26 — đồng thời lấy cảm hứng từ YOLO-World, YOLOE đạt độ chính xác zero-shot cao với tốc độ gần bằng YOLO closed-set.
Xem: Cách sử dụng Ultralytics YOLOE-26 (Mới) | Open Vocabulary và Nhìn thấy mọi thứ theo thời gian thực
Bắt đầu nhanh#
Chỉ cần nêu tên các lớp bạn muốn rồi chạy model. YOLOE-26 trả về các bounding box và mask phân đoạn instance cho những danh mục mà model chưa từng được huấn luyện.
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")

# "double-decker bus" không phải là lớp COCO; YOLOE nhận diện lớp này chỉ dựa vào từ ngữ
model.set_classes(["double-decker bus", "person"])

results = model.predict("https://ultralytics.com/images/bus.jpg")
results[0].show()
Lần gọi set_classes() đầu tiên sẽ tải xuống text encoder; hãy xem Cài đặt và yêu cầu trước khi triển khai lên máy không có quyền truy cập mạng.
Chọn chế độ prompting#
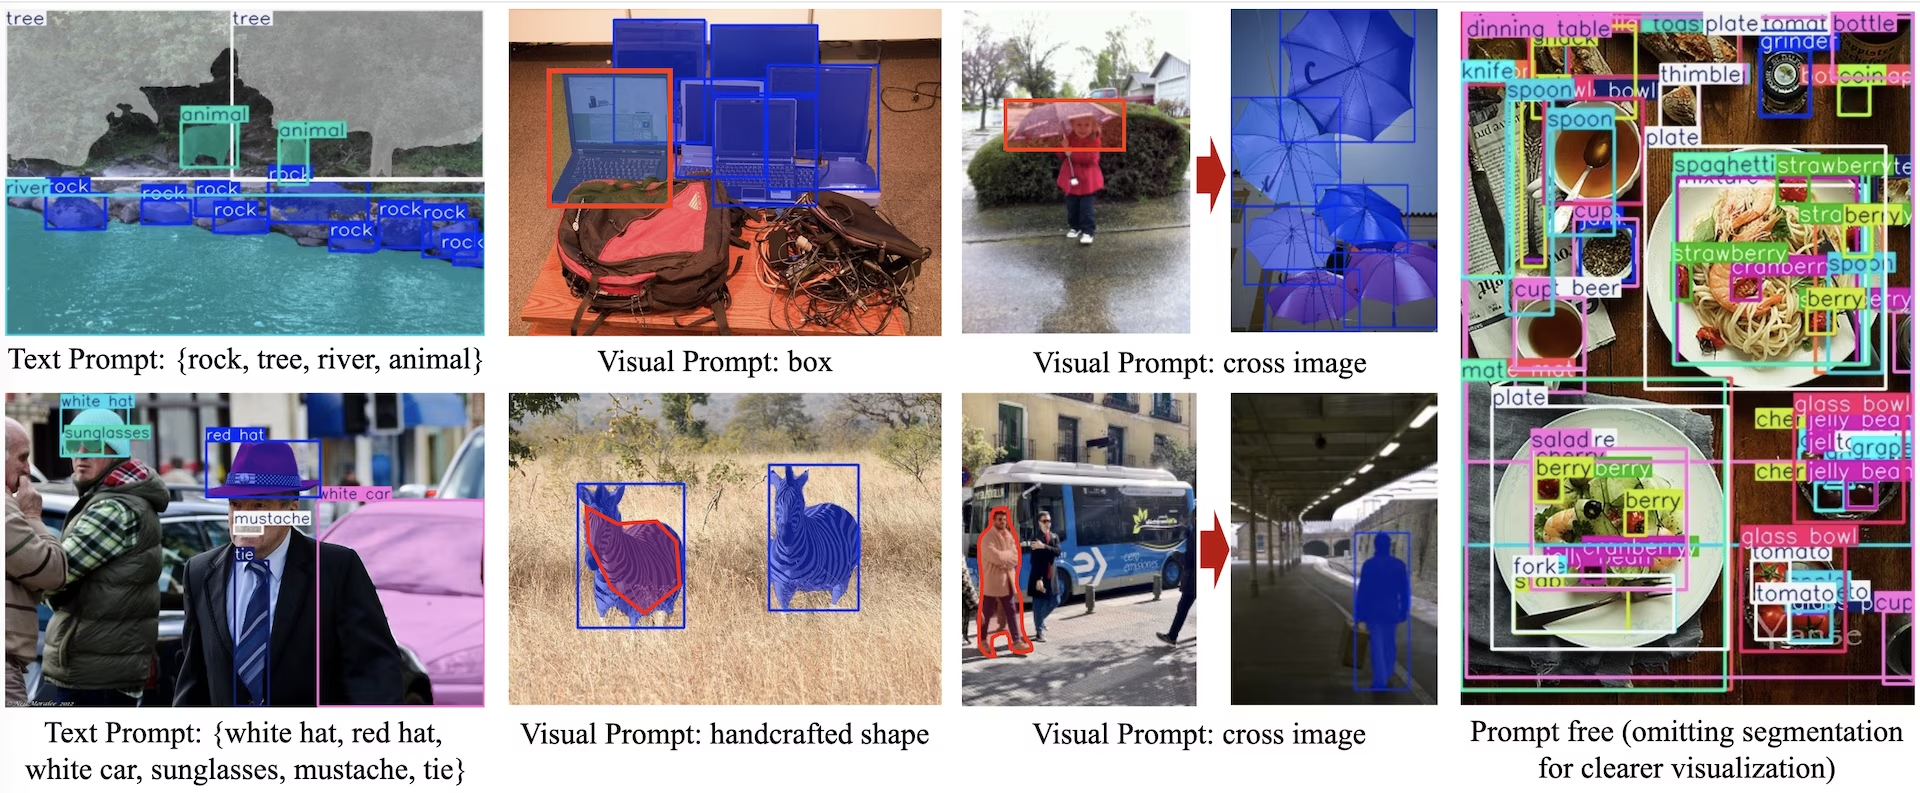
YOLOE hỗ trợ ba chế độ prompting; lựa chọn của bạn quyết định checkpoint cần tải và định dạng nhãn lớp. Hãy chọn hàng tương ứng với dữ liệu bạn có thể cung cấp tại thời điểm suy luận.
| Chế độ | Checkpoint | Bạn cung cấp | Tên lớp trong kết quả | Sử dụng khi |
|---|---|---|---|---|
| Prompt văn bản | *-seg.pt | Tên lớp dưới dạng chuỗi | Chính xác các tên bạn đã nhập | Bạn có thể mô tả mục tiêu bằng từ ngữ — lựa chọn thông thường |
| Prompt hình ảnh | *-seg.pt | BBox ví dụ trên ảnh tham chiếu | object0, object1, … chung chung | Bạn không thể diễn đạt mục tiêu bằng từ ngữ: một bộ phận cụ thể, logo hoặc lỗi |
| Không cần prompt | *-seg-pf.pt | Không có gì | Tên từ bộ từ vựng tích hợp gồm 4.585 tên | Bạn đang lập danh mục hoặc khám phá và chưa biết trước cần tìm gì |
- Prompt hình ảnh không mang theo nhãn của bạn. Các class ID trong
visual_promptsdùng để nhóm các ví dụ; model trả về chúng dưới dạngobject0,object1và tiếp tục như vậy. Bạn cần tự ánh xạ chúng về tên riêng của mình. - Checkpoint không cần prompt từ chối
set_classes(). Gọi mục này trên model*-seg-pf.ptsẽ gây ra lỗiAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.. Thay vào đó, hãy tải checkpoint*-seg.ptkhi cần dùng các lớp của riêng bạn.
Cài đặt và yêu cầu#
YOLOE được tích hợp trong package Ultralytics chính:
pip install -U ultralyticsNgoài ra, prompting bằng văn bản cần có text encoder; text encoder được tải về khi sử dụng lần đầu chứ không phải lúc cài đặt:
- Lần gọi
set_classes()đầu tiên sẽ cài đặt ultralytics/CLIP từ GitHub bằngpip(package này cung cấp tokenizer) và tải text encoder TorchScript vào thư mục làm việc hiện tại. YOLOE-26 tảimobileclip2_b.ts, dung lượng khoảng 254 MB; YOLOE-11 và YOLOE-v8 tảimobileclip_blt.ts. Hãy chạy tải xuống một lần từ thư mục bạn sẽ chạy chương trình hoặc sao chép file vào đó; nếu không, file sẽ được tải lại. - Cả hai bước đều cần truy cập mạng, vì vậy hãy chạy một lượt dự đoán có prompt trước khi triển khai lên máy ngoại tuyến hoặc cách ly mạng.
- Prompt hình ảnh và checkpoint không cần prompt hoàn toàn không cần text encoder.
Các checkpoint YOLOE-26 yêu cầu ultralytics phiên bản 8.4.0 trở lên; các dòng YOLOE-11 và YOLOE-v8 có trong những bản phát hành cũ hơn. Một lượt dự đoán bằng prompt văn bản sẽ kiểm tra toàn bộ quy trình — tải checkpoint, cài đặt CLIP, text encoder và suy luận:
yolo predict model=yoloe-26s-seg.pt source="https://ultralytics.com/images/bus.jpg" classes="person"Để bỏ hoàn toàn việc tải text encoder tại thời điểm suy luận, hãy tích hợp prompt vào weights một lần rồi tái sử dụng — xem Tái sử dụng embedding của prompt.
Tổng quan kiến trúc#

YOLOE giữ cấu trúc YOLO tiêu chuẩn — backbone tích chập để trích xuất đặc trưng, neck để hợp nhất đa tỷ lệ và head không anchor, tách biệt để dự đoán lớp và bbox — đồng thời bổ sung ba module, mỗi module ứng với một chế độ prompting:
- Căn chỉnh vùng-văn bản có thể tái tham số hóa (RepRTA) tinh chỉnh embedding văn bản từ CLIP thông qua một mạng phụ trợ nhỏ. Mạng này chỉ chạy một lần cho mỗi lần gọi
set_classes()và được gộp đi khi xuất model, nên không tốn chi phí trên mỗi frame. Phép so sánh embedding prompt đã lưu với đặc trưng vùng vẫn chạy ở mỗi lượt forward; xem Giới hạn để biết chi phí khi dùng tập prompt lớn. - Bộ mã hóa prompt hình ảnh kích hoạt ngữ nghĩa (SAVPE) mã hóa đặc trưng ngữ nghĩa và kích hoạt từ một bbox ví dụ, điều kiện hóa model theo các đối tượng có hình dạng tương tự. Đây là quy trình one-shot dành cho các mục tiêu khó gọi tên, chẳng hạn như logo hoặc một bộ phận cụ thể.
- Đối sánh tương phản prompt vùng lười (LRPC) đối sánh embedding vùng với bộ từ vựng tích hợp gồm 4.585 tên, nhờ đó checkpoint không cần prompt có thể nhận diện đối tượng mà không cần prompt bên ngoài hay text encoder.
Phân đoạn instance được thực hiện bằng một nhánh mask trên detection head, tương tự YOLOv8-Seg, và mỗi dự đoán đều có mask trên results[0].masks. Sau khi model được xuất, các module open-world được tái tham số hóa thành YOLO head tiêu chuẩn, vì vậy tệp đã xuất chạy theo quy trình detect/segment thông thường.
Các model hiện có#
Mỗi checkpoint bên dưới đều là model phân đoạn instance và hỗ trợ val, predict, export và track. Tải tệp *-seg.pt để dùng prompt văn bản hoặc trực quan, và tệp *-seg-pf.pt để suy luận không cần prompt; hai loại tệp này không thể thay thế cho nhau, xem Chọn chế độ Prompt. Chỉ các tệp *-seg.pt hỗ trợ train; checkpoint không cần prompt được tạo từ model đã huấn luyện bằng prompt văn bản, xem Huấn luyện các model chính thức từ đầu.
| Model | Prompt văn bản / hình ảnh | Không cần prompt |
|---|---|---|
| YOLOE-26n | yoloe-26n-seg.pt | yoloe-26n-seg-pf.pt |
| YOLOE-26s | yoloe-26s-seg.pt | yoloe-26s-seg-pf.pt |
| YOLOE-26m | yoloe-26m-seg.pt | yoloe-26m-seg-pf.pt |
| YOLOE-26l | yoloe-26l-seg.pt | yoloe-26l-seg-pf.pt |
| YOLOE-26x | yoloe-26x-seg.pt | yoloe-26x-seg-pf.pt |
| YOLOE-11s | yoloe-11s-seg.pt | yoloe-11s-seg-pf.pt |
| YOLOE-11m | yoloe-11m-seg.pt | yoloe-11m-seg-pf.pt |
| YOLOE-11l | yoloe-11l-seg.pt | yoloe-11l-seg-pf.pt |
| YOLOE-v8s | yoloe-v8s-seg.pt | yoloe-v8s-seg-pf.pt |
| YOLOE-v8m | yoloe-v8m-seg.pt | yoloe-v8m-seg-pf.pt |
| YOLOE-v8l | yoloe-v8l-seg.pt | yoloe-v8l-seg-pf.pt |
Hiệu năng YOLOE trên LVIS#
Kết quả zero-shot trên tập minival của LVIS ở độ phân giải 640 pixel, trích từ bài báo Ultralytics YOLO26.
Prompt văn bản và hình ảnh#
Mỗi ô độ chính xác và số tham số hiển thị theo thứ tự prompt văn bản / prompt hình ảnh; FLOPs chỉ được ghi một lần. Số tham số và FLOPs áp dụng cho cấu hình phát hiện được đánh giá trong bài báo. Độ chính xác là số liệu Non-E2E của bài báo, giao thức duy nhất được báo cáo cho mọi model trong phép so sánh; head end-to-end của YOLOE-26 có AP thấp hơn tối đa 1,1 AP với prompt văn bản và 2,6 AP với prompt hình ảnh.
| Model | mAP50-95 | mAPr | mAPc | mAPf | params (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n | 24.7 / 21.9 | 20.5 / 17.6 | 24.1 / 22.3 | 26.1 / 22.4 | 3.9 / 3.1 | 6.1 |
| YOLOE-26s | 30.8 / 28.6 | 23.9 / 25.1 | 29.6 / 27.8 | 33.0 / 29.9 | 10.7 / 11.0 | 21.9 |
| YOLOE-26m | 35.4 / 33.9 | 31.1 / 33.4 | 34.7 / 34.0 | 36.9 / 33.8 | 21.3 / 25.1 | 70.6 |
| YOLOE-26l | 37.8 / 36.3 | 35.1 / 37.6 | 37.6 / 36.2 | 38.5 / 36.1 | 25.5 / 29.3 | 89.0 |
| YOLOE-26x | 40.6 / 38.5 | 37.4 / 35.3 | 40.9 / 38.8 | 41.0 / 38.8 | 55.2 / 65.2 | 197.7 |
| YOLOE-11s | 27.5 / 26.3 | 21.4 / 22.5 | 26.8 / 27.1 | 29.3 / 26.4 | 10.7 / 10.9 | 22.7 |
| YOLOE-11m | 33.0 / 31.4 | 26.9 / 27.1 | 32.5 / 31.9 | 34.5 / 31.7 | 21.0 / 24.8 | 70.4 |
| YOLOE-11l | 35.2 / 33.7 | 29.1 / 28.1 | 35.0 / 34.6 | 36.5 / 33.8 | 26.0 / 29.8 | 89.5 |
| YOLOE-v8s | 27.9 / 26.2 | 22.3 / 21.3 | 27.8 / 27.7 | 29.0 / 25.7 | 12.3 / 12.6 | 29.8 |
| YOLOE-v8m | 32.6 / 31.0 | 26.9 / 27.0 | 31.9 / 31.7 | 34.4 / 31.1 | 26.4 / 28.4 | 80.7 |
| YOLOE-v8l | 35.9 / 34.2 | 33.2 / 33.2 | 34.8 / 34.6 | 37.3 / 34.1 | 43.5 / 47.3 | 167.6 |
Không cần prompt#
Checkpoint không cần prompt đưa ra kết quả dựa trên từ vựng tích hợp mà không cần cung cấp prompt. Mỗi ô độ chính xác hiển thị theo thứ tự end-to-end / Non-E2E, hai giao thức mà bài báo dùng để đánh giá YOLOE-26; trang YOLO26 trích dẫn cột Non-E2E.
| Model | mAP50-95 | mAPr | mAPc | mAPf | params (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n-pf | 16.6 / 17.7 | 15.7 / 15.8 | 15.3 / 16.4 | 17.9 / 19.2 | 2.3 | 5.3 |
| YOLOE-26s-pf | 21.4 / 22.6 | 16.2 / 20.2 | 20.1 / 20.9 | 23.5 / 24.5 | 9.0 | 20.8 |
| YOLOE-26m-pf | 25.7 / 26.4 | 26.7 / 24.5 | 24.0 / 25.0 | 26.9 / 27.9 | 19.4 | 68.4 |
| YOLOE-26l-pf | 27.2 / 28.0 | 26.3 / 25.7 | 25.7 / 26.8 | 28.7 / 29.5 | 23.6 | 86.8 |
| YOLOE-26x-pf | 29.9 / 31.1 | 27.5 / 28.9 | 29.1 / 30.7 | 31.1 / 31.7 | 53.1 | 194.4 |
Với prompt văn bản và hình ảnh, các model YOLOE-26 dẫn đầu các phiên bản YOLOE-11 và YOLOE-v8 tương ứng ở mọi kích thước tương ứng về mAP50-95, đồng thời có số tham số và FLOPs thấp hơn dòng v8. Trên cùng tập dữ liệu, bài báo báo cáo YOLO-Worldv2 đạt 24.4 (S), 32.4 (M) và 35.5 (L), còn các detector dựa trên Transformer là GLIP-T đạt 26.0, GDINO-T đạt 27.4 và DetCLIP-T đạt 34.4; mỗi model có từ 155 đến 232 M tham số. Bài báo YOLOE gốc bổ sung hai kết quả cho các model ở quy mô v8 được giới thiệu trong bài. Trên LVIS, YOLOE-v8s vượt YOLO-Worldv2-S 3.5 AP với chi phí huấn luyện bằng một phần ba và tốc độ suy luận nhanh hơn 1.4×. Khi chuyển sang COCO, YOLOE-v8l tăng 0.6 box AP và 0.4 mask AP so với YOLOv8-L closed-set, trong khi thời gian huấn luyện giảm gần 4×.
Bài báo YOLO26 đánh giá một cấu hình detection. Các weight được phát hành là checkpoint segmentation và có thêm nhánh mask, SAVPE cùng phép chiếu văn bản, vì vậy model yoloe-26l-seg.pt được tải báo cáo 35.4 M và 142.0 B thay vì 25.5 M và 89.0 B ở trên. Trong cả hai trường hợp, con số FLOPs không tính độ tương đồng giữa vùng và văn bản, do đó chi phí thực tế tăng theo kích thước của tập prompt dù giá trị trong cột không đổi; xem Các hạn chế.
Ví dụ sử dụng#
Mọi ví dụ YOLOE bên dưới đều chạy qua Python API. Dự đoán bằng prompt văn bản, validation, export, tracking và huấn luyện thông thường cũng hoạt động qua CLI; các công thức fine-tuning truyền vào một lớp trainer, còn prompting trực quan truyền các mảng prompt NumPy — những cách này chỉ được Python API hỗ trợ.
Cách sử dụng để huấn luyện#
Tinh chỉnh bất kỳ checkpoint *-seg.pt nào đã phát hành trên dataset YOLO của riêng bạn. Quy trình này phần lớn tuân theo quy trình huấn luyện YOLO tiêu chuẩn; điểm khác biệt nằm ở trainer bạn truyền vào. YOLOEPESegTrainer hợp nhất tên lớp của bạn vào head rồi tinh chỉnh từ đó; đây là cách phù hợp khi dùng nhãn của riêng bạn, vì trainer mặc định không huấn luyện theo tên lớp của bạn. Checkpoint thu được sẽ dự đoán trực tiếp các lớp trong dataset của bạn: head không còn đọc prompt, vì vậy set_classes() sẽ báo lỗi nếu các lớp thay đổi, và prompt trực quan cũng vậy. Hãy dùng prompt với checkpoint gốc để dự đoán các lớp khác.
Xem: Cách huấn luyện YOLOE trên bộ dữ liệu phân đoạn phụ tùng ô tô | Model Open-Vocabulary, dự đoán và xuất
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPESegTrainer

model = YOLOE("yoloe-26s-seg.pt")

results = model.train(
    data="coco128-seg.yaml",
    epochs=80,
    patience=10,
    trainer=YOLOEPESegTrainer,  # <- Quan trọng: trainer fine-tuning, không phải trainer mặc định
)Mọi checkpoint được phát hành đều là model segmentation. Để huấn luyện detector, hãy tạo model từ YAML tương ứng, tải weight segmentation cùng kích thước rồi chuyển sang trainer detection. Mọi thứ khác giữ nguyên.
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPETrainer

model = YOLOE("yoloe-26s.yaml").load("yoloe-26s-seg.pt")

results = model.train(data="coco128.yaml", epochs=80, patience=10, trainer=YOLOEPETrainer)
Cách sử dụng Predict#
Lệnh gọi prompt văn bản là lệnh trong Quick Start. Prompting trực quan thêm đối số visual_prompts, còn dự đoán không dùng prompt tải checkpoint -pf thay thế:
Visual prompt cung cấp cho model một ví dụ thay vì mô tả đối tượng. visual_prompts nhận một mảng bboxes chứa các box ví dụ và một mảng cls chứa ID class, mỗi box ứng với một ID. Các ID này chỉ là nhóm tạm thời, không phải nhãn — chúng phải là các số liên tiếp bắt đầu từ 0, và kết quả được trả về dưới dạng object0, object1, … chứ không theo tên do bạn chọn.
Các box ví dụ có thể nằm ngay trên hình ảnh bạn đang dự đoán:
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

# Mỗi đối tượng cần phát hiện có một box ví dụ riêng, kèm ID class riêng
visual_prompts = {
    "bboxes": np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # người, kính
    "cls": np.array([0, 1]),
}

results = model.predict(
    "ultralytics/assets/bus.jpg",
    visual_prompts=visual_prompts,
)
results[0].show()
Hoặc nằm trên một hình ảnh tham chiếu riêng được truyền vào dưới dạng refer_image; khi đó, bboxes và cls mô tả các đối tượng trong hình ảnh tham chiếu, không phải trong hình ảnh đích:
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {"bboxes": np.array([[221.52, 405.8, 344.98, 857.54]]), "cls": np.array([0])}  # person

results = model.predict(
    "ultralytics/assets/zidane.jpg",  # Hình ảnh đích
    refer_image="ultralytics/assets/bus.jpg",  # Vị trí đặt các box ví dụ
    visual_prompts=visual_prompts,
)
results[0].show()

# refer_image cũng thiết lập class cố định, vì vậy các lệnh gọi sau không cần prompt
results = model("ultralytics/assets/bus.jpg")
model.export(format="onnx") # Và export cũng giữ lại chúngKhi source là video hoặc luồng dữ liệu, frame đầu tiên sẽ tự động trở thành refer_image, nên các prompt bạn truyền vào được áp dụng cho frame đó và duy trì xuyên suốt phần còn lại của video. Truyền refer_image một cách tường minh để chọn frame khác.
Cả source và refer_image đều nhận trực tiếp tensor torch, rất hữu ích khi hình ảnh đã có sẵn từ một pipeline hiện có. Cung cấp tọa độ box theo hệ tọa độ pixel của chính tensor:
import numpy as np
import torch

from ultralytics import YOLOE

model = YOLOE("yoloe-11l-seg.pt")

img_tensor = torch.rand(1, 3, 480, 480)  # tensor float (1, 3, H, W) trong khoảng [0, 1]
visual_prompts = {"bboxes": np.array([[10, 10, 50, 50]]), "cls": np.array([0])}

results = model.predict(
    img_tensor,
    refer_image=img_tensor,
    visual_prompts=visual_prompts,
    imgsz=640,
)
Để dự đoán đồng thời trên nhiều hình ảnh, hãy lồng prompt sâu thêm một cấp: một mảng bboxes và một mảng cls cho mỗi hình ảnh nguồn, theo đúng thứ tự của các nguồn.
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {
    "bboxes": [
        np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # bus.jpg: người, kính
        np.array([[150, 200, 1150, 700]]),  # zidane.jpg: người
    ],
    "cls": [np.array([0, 1]), np.array([0])],
}

results = model.predict(
    ["ultralytics/assets/bus.jpg", "ultralytics/assets/zidane.jpg"],
    visual_prompts=visual_prompts,
)
results[0].show()
Cách sử dụng Val#
Validation được thực hiện như với mọi model khác trên dataset segmentation:
from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")  # hoặc yoloe-26s/m-seg.pt cho các kích thước khác

metrics = model.val(data="coco128-seg.yaml")
data cũng có thể là một tệp NDJSON hoặc một URI tập dữ liệu của nền tảng ul://; giá trị này được chuyển đổi sang định dạng YOLO trước khi tạo prompt văn bản hoặc prompt thị giác.
Hai biến thể của cùng lệnh gọi hỗ trợ các chế độ prompting còn lại:
- Visual prompt —
model.val(data="coco128-seg.yaml", load_vp=True)trích xuất embedding hình ảnh cho mỗi danh mục trực tiếp từ dataset. Thêmrefer_data="coco.yaml"để lấy embedding từ dataset khác; dataset đó phải có chính xác cùng các danh mục. - Không cần prompt — tải checkpoint
*-seg-pf.ptvà truyềnsingle_cls=True.
Cách sử dụng export#
Có thể lưu embedding prompt một lần rồi tái sử dụng khi tạo các bản export tĩnh như ONNX, OpenVINO, TensorRT, CoreML, LiteRT và RKNN. Profile NPZ được model PyTorch gốc nạp trước khi export; đây không phải đầu vào runtime bổ sung, và model đã export không cần tệp NPZ.
Các class được cấu hình bằng set_classes() (hoặc qua refer_image đối với visual prompt) được tích hợp cố định vào weight đã export. Sau khi export, model không thể nhận prompt mới: gọi set_classes() hoặc truyền visual_prompts=... vào predict() trên bản export đã tải sẽ gây lỗi. Để thay đổi class cần phát hiện, hãy export lại từ checkpoint .pt gốc với prompt mới được cấu hình. Tệp đã export hoạt động như một model YOLO tiêu chuẩn và cũng có thể được tải bằng YOLO() thay vì YOLOE().
from ultralytics import YOLOE

model = YOLOE("yoloe-26n-seg.pt")
model.set_classes(["person", "bus"])
model.save_prompt_embeddings("person-bus.npz")

# Profile này gắn với checkpoint nguồn và có thể được tái sử dụng cho các lần export sau.
model = YOLOE("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="onnx")
Cùng một profile prompt cũng có thể cấu hình model chỉ có detection được tạo từ kiến trúc YOLOE tương ứng. Cách này loại bỏ nhánh mask nhưng vẫn giữ các class được chỉ định bằng prompt:
from ultralytics import YOLOE

model = YOLOE("yoloe-26n.yaml").load("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="rknn", name="rk3588", quantize=16)
Theo dõi sử dụng#
Các class được chỉ định bằng prompt được đưa thẳng vào tracking, nhờ đó bạn có thể theo dõi những đối tượng mà tracker chưa từng được huấn luyện:
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")
model.set_classes(["forklift", "pallet"])

# persist=True giữ ID track ổn định giữa các frame
for result in model.track("path/to/video.mp4", stream=True, persist=True):
    print(result.boxes.id)
So sánh YOLOE#
YOLOE nằm giữa detector closed-set và model open-vocabulary cỡ lớn. Ba phép so sánh giúp xác định liệu đây có phải lựa chọn phù hợp:
- So với YOLO closed-set. Sau khi thiết lập prompt, YOLOE dự đoán bằng quy trình detect/segment thông thường và export như mọi model khác. Điểm khác biệt là khả năng thay đổi danh sách class tại thời điểm suy luận thay vì huấn luyện lại; đổi lại, độ chính xác zero-shot thấp hơn nhiều so với model được huấn luyện trên các class của chính bạn.
- So với các dòng YOLOE đời trước. YOLOE-26 kế thừa head end-to-end không dùng NMS của YOLO26, hỗ trợ năm kích thước (n/s/m/l/x) so với ba kích thước trước đây (s/m/l), đồng thời dẫn đầu ở mọi kích thước tương ứng trong Hiệu năng.
- So với detector open-vocabulary dựa trên Transformer. GLIP và OWL-ViT chạy Transformer thị giác-ngôn ngữ tại thời điểm suy luận. YOLOE mã hóa prompt một lần rồi so sánh chúng với đặc trưng vùng bên trong head tích chập.
Các lựa chọn thay thế gần nhất đều nhận prompt văn bản, nhưng chỉ YOLOE và SAM 3 trả về mask; cả ba giải quyết các nhu cầu khác nhau:
| YOLOE | SAM 3 | YOLO-World | |
|---|---|---|---|
| Được thiết kế cho | Detection và segmentation thời gian thực cho các class được gọi tên | Segmentation khái niệm và tracking có thể điều khiển bằng prompt | Detection open-vocabulary thời gian thực |
| Masks | Có, với các checkpoint *-seg.pt | Có | Không, chỉ có box |
| Visual prompt | Có (SAVPE) | Có | Không |
| Chế độ không cần prompt | Có, từ vựng gồm 4,585 tên | Không | Không |
| Chọn model này khi | Bạn cần thông lượng cao và có thể nêu tên các class | Bạn cần segmentation khái niệm mạnh nhất và có thể dành thêm tài nguyên tính toán | Bạn đang sử dụng model này — xem ghi chú di chuyển bên dưới |
Đang dùng YOLO-World? API có cấu trúc tương tự: thay YOLOWorld bằng YOLOE, tải checkpoint *-seg.pt và giữ nguyên lệnh gọi set_classes(). Bạn sẽ có thêm mask và visual prompt; ghi chú về export liên quan đến class bị cố định áp dụng cho cả hai.
Các trường hợp sử dụng và ứng dụng#
Detection open-vocabulary loại bỏ bước huấn luyện lại cho từng class, đặc biệt hữu ích khi chưa xác định trước danh sách đối tượng cần phát hiện:
- Detection trong thế giới mở — robotics và hệ thống an ninh phải xử lý những đối tượng chưa được liệt kê khi huấn luyện.
- Detection một lần từ ví dụ — visual prompt nhận diện một linh kiện, logo hoặc lỗi cụ thể từ một box tham chiếu duy nhất, hữu ích trong kiểm tra công nghiệp.
- Lập danh mục đối tượng dài đuôi — từ vựng tích hợp gồm 4,585 tên đủ rộng cho các đợt giám sát đa dạng sinh học hoặc kiểm kê bán lẻ.
- Khởi tạo dataset — gán nhãn trước hình ảnh bằng box và mask để con người xem xét, sau đó huấn luyện một model closed-set nhanh trên dữ liệu thu được.
- Segmentation các đối tượng tùy ý — các checkpoint
*-seg.ptđược phát hành trả về mask cùng mỗi dự đoán, nhờ đó chẩn đoán hình ảnh y khoa và phân tích ảnh vệ tinh có được đầu ra chính xác đến từng pixel mà không cần model thứ hai.
Một quy trình phổ biến kết hợp hai chế độ: chạy chế độ không cần prompt một lần để phát hiện những gì có trong ảnh, sau đó chuyển sang prompt văn bản cho các danh mục cần quan tâm.
Hạn chế#
YOLOE đánh đổi độ chính xác để có khả năng thay đổi class tại thời điểm suy luận. Dưới đây là những hệ quả cần biết trước khi lựa chọn:
- Độ chính xác zero-shot thấp hơn nhiều so với model được huấn luyện trên các class của bạn. Các checkpoint dùng prompt đạt khoảng 22-40 mAP trên LVIS minival; YOLO closed-set được huấn luyện trên dữ liệu của bạn sẽ có kết quả tốt hơn ở những class đó. Hãy chọn YOLOE để xử lý các class bạn không thể huấn luyện, chứ không phải để thay thế việc huấn luyện.
- Các danh mục hiếm là điểm yếu. Cột mAPr trong Hiệu năng báo cáo riêng độ chính xác trên các class hiếm của LVIS; khi dùng prompt văn bản, chỉ số này thấp hơn các cột class phổ biến và thường gặp trong mọi hàng. Nếu đối tượng cần phát hiện ít gặp, hãy kiểm tra chỉ số này thay vì chỉ nhìn mAP tổng quát.
- Prompt mô tả hình dáng, không mô tả mối quan hệ. Detection hoạt động bằng cách so sánh đặc trưng vùng với embedding prompt, vì vậy các prompt phụ thuộc vào trạng thái, ngữ cảnh hoặc sự so sánh — như "bị hỏng", "ngoài cùng bên trái", "đối tượng đang được mang" — không có đặc điểm phù hợp đáng tin cậy để đối chiếu. Nên dùng cách diễn đạt gần với tên danh mục thông thường.
- Tập prompt lớn làm tăng độ trễ. Embedding prompt chỉ được tính một lần, nhưng được so sánh với đặc trưng vùng trong mỗi lượt forward. Đo trên CPU với
yoloe-26s-seg.pt, thời gian của một lượt forward tăng khoảng 19% khi chuyển từ 80 lên 1,203 class và tăng khoảng 89% với toàn bộ từ vựng gồm 4,585 tên. FLOPs được báo cáo không thay đổi vì phép tính độ tương đồng giữa vùng và văn bản không được tính, do đó profile sẽ không cảnh báo bạn. - Tên class chỉ là tên giữ chỗ cho đến khi bạn đặt prompt. Checkpoint
*-seg.ptvừa được tải sẽ trả vềnc=80với tên dạng số ("0","1", …), vì vậy hãy gọiset_classes()trước khi đọc nhãn. Các checkpoint không cần prompt đã có sẵn toàn bộ từ vựng.
Ghi chú triển khai#
- Phần cứng. Suy luận cần GPU NVIDIA với 4-8 GB VRAM; các kích thước
nvàschạy được trên GPU edge như Jetson hoặc trên CPU ở độ phân giải thấp hơn. Fine-tuning cần một GPU. - Mặc định, NMS không phụ thuộc class. YOLOE dự đoán bằng
agnostic_nms=True. Theo mặc định, cách này loại bỏ các box chồng lấp có điểm thấp hơn giữa các class khác nhau thay vì chỉ trong cùng một class, giúp tránh phát hiện trùng khi một đối tượng khớp với nhiều danh mục. Vớinms=False, YOLOE-26 không áp dụng suppression theo IoU; chế độ không phụ thuộc class chỉ giữ class tốt nhất cho mỗi anchor thay vì để một anchor xuất ra nhiều nhãn class. Truyềnagnostic_nms=Falseđể ghi đè. - Mặc định, prompt trực quan sử dụng
conf=0.05. Các hộp trong prompt trực quan thường xác định đúng nhiều hơn so với mức điểm thể hiện: trên LVIS minival, khi dùng một instance của một lớp làm prompt,conf=0.25bỏ sót 44 đến 55% các instance khác mà YOLOE-26 tìm thấy ởconf=0.05. Các cảnh dày đặc có nhiều đối tượng gần như giống hệt nhau, chẳng hạn như kệ hàng bán lẻ hoặc tế bào, có thể cần giá trị thấp hơn; vớinms=False, đầu ra một-một của YOLOE-26 còn cho điểm thấp hơn nữa, với ngưỡng tối ưu gần0.01. Mọi lần gọi khác đều giữ nguyênconf=0.25, bao gồm cả các lần gọi sau, embedding đã lưu và các bản xuất sử dụng lại những lớp được thiết lập bởirefer_image. Truyềnconfđể ghi đè. - Batching. Batch inference hoạt động trực tiếp, và visual prompt có thể khác nhau giữa các hình ảnh trong cùng một lệnh gọi.
Huấn luyện các model chính thức từ đầu#
Phần lớn người đọc không cần đến mục này. Quy trình này tái tạo các checkpoint open-vocabulary đã công bố từ Objects365, GQA và Flickr30k — khoảng 1.4 M mẫu huấn luyện trên 8× RTX 4090 — và không liên quan đến fine-tuning trên dữ liệu của bạn, nội dung được trình bày trong Cách sử dụng khi huấn luyện ở trên.
Mọi trainer kế thừa YOLOETrainer đều từ chối compile=True, bao gồm YOLOESegTrainer mặc định và tất cả trainer huấn luyện từ đầu bên dưới. Hãy truyền compile=False (giá trị mặc định). Hai trainer fine-tuning được dùng ở trên, YOLOEPESegTrainer và YOLOEPETrainer, không bị hạn chế này.
Huấn luyện cần có annotation phân đoạn. Bạn có thể tải các tệp đã xử lý bên dưới hoặc tự tạo bằng script do nhóm chính thức cung cấp, sử dụng SAM 2.1. Validation dùng LVIS minival.
| Dataset | Kiểu | Mẫu | Boxes | Annotation phân đoạn đã xử lý |
|---|---|---|---|---|
| Objects365v1 | Phát hiện | 609k | 9621k | objects365_train_segm.json |
| GQA | Grounding | 621k | 3681k | final_mixed_train_no_coco_segm.json |
| Flickr30k | Grounding | 149k | 641k | final_flickr_separateGT_train_segm.json |
Model dùng prompt văn bản được huấn luyện trước; hai chế độ prompting còn lại được tinh chỉnh từ model này:
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOESegTrainerFromScratch

data = {
    "train": {
        "yolo_data": ["Objects365.yaml"],
        "grounding_data": [
            {
                "img_path": "flickr/full_images/",
                "json_file": "flickr/annotations/final_flickr_separateGT_train_segm.json",
            },
            {
                "img_path": "mixed_grounding/gqa/images",
                "json_file": "mixed_grounding/annotations/final_mixed_train_no_coco_segm.json",
            },
        ],
    },
    "val": {"yolo_data": ["lvis.yaml"]},
}

model = YOLOE("yoloe-26l-seg.yaml")
model.train(
    data=data,  # hoặc đường dẫn đến tệp YAML chứa cùng cấu trúc
    batch=128,
    epochs=30,
    close_mosaic=2,
    optimizer="AdamW",
    lr0=2e-3,
    warmup_bias_lr=0.0,
    weight_decay=0.025,
    momentum=0.9,
    workers=4,
    trainer=YOLOESegTrainerFromScratch,
    device="0,1,2,3,4,5,6,7",
)
Các checkpoint visual-prompt và prompt-free bắt đầu từ model text-prompt đã được huấn luyện đó và mỗi checkpoint cập nhật một module. YOLOESegVPTrainer là recipe visual-prompt, còn YOLOEPEFreeTrainer là recipe prompt-free, nhưng bản thân không lớp nào đóng băng bất cứ thứ gì: việc huấn luyện có chọn lọc đến từ danh sách freeze bạn truyền kèm, danh sách này nêu tên mọi phần tử con của head ngoại trừ savpe (tương ứng, mọi classification tower), và lần chạy prompt-free còn cần single_cls=True. Repository YOLOE chính thức lưu trữ đầy đủ các recipe cho model quy mô v8.
Sau khi hoàn tất, lần chạy prompt-free được tái tham số hóa thành checkpoint hiển thị tên mà không cần prompt khi inference, bằng cách dùng get_vocab và set_vocab:
from ultralytics import YOLOE

# Trọng số được ghi bởi lần chạy prompt-free và lần chạy text-prompt mà nó bắt đầu từ đó. Mỗi
# lần chạy lại tạo một thư mục mới (train-2, train-3, ...), vì vậy hãy dùng các đường dẫn mà các lần chạy đã in ra.
model = YOLOE("runs/segment/train-2/weights/best.pt")  # lần chạy prompt-free, head của nó đã được hợp nhất
text_model = YOLOE("runs/segment/train/weights/best.pt")  # lần chạy text-prompt, head của nó vẫn chưa được hợp nhất

names = list(YOLOE("yoloe-26l-seg-pf.pt").model.names.values())  # từ vựng gồm 4,585 tên, hoặc danh sách của riêng bạn
vocab = text_model.get_vocab(names)

model.set_vocab(vocab, names)
model.save("yoloe-26l-seg-pf-custom.pt")  # không bao giờ ghi đè checkpoint đã phát hành
get_vocab trả về nhánh được chọn bởi flag end2end của model, còn set_vocab tái tham số hóa nhánh đó. Các tệp YOLOE-26 đã phát hành thay vào đó mang một bộ từ vựng cho mỗi nhánh, nhờ vậy nms có thể chọn giữa các nhánh; để tái tạo điều này, hãy lấy bộ từ vựng thứ hai từ một bản sao khác của model text-prompt. YOLOE-11 và YOLOE-v8 chỉ có một nhánh, vì vậy dùng nguyên lời gọi ở trên.
one2one_model = YOLOE("runs/segment/train/weights/best.pt")  # get_vocab hợp nhất head mà nó đọc, vì vậy hãy tải một bản sao thứ hai
one2one_model.model.end2end = True  # đọc nhánh không dùng NMS

model.set_vocab(vocab, names, one2one_vocab=one2one_model.get_vocab(names))
Trích dẫn và lời cảm ơn#
Nếu YOLOE đã đóng góp cho nghiên cứu hoặc dự án của bạn, vui lòng trích dẫn bài báo gốc của Ao Wang, Lihao Liu, Hui Chen, Zijia Lin, Jungong Han, và Guiguang Ding thuộc Đại học Thanh Hoa:
@misc{wang2025yoloerealtimeseeing,
      title={YOLOE: Real-Time Seeing Anything},
      author={Ao Wang and Lihao Liu and Hui Chen and Zijia Lin and Jungong Han and Guiguang Ding},
      year={2025},
      eprint={2503.07465},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2503.07465},
}
Để tìm hiểu thêm, bài báo YOLOE gốc có trên arXiv. Bạn có thể truy cập mã nguồn và các tài nguyên bổ sung của dự án qua repository GitHub.
Câu hỏi thường gặp#
Ultralytics YOLOE bổ sung hai khả năng mà YOLO-World không có: visual prompt, trong đó một box mẫu thay cho tên class, và checkpoint prompt-free có thể trả lời dựa trên từ vựng tích hợp gồm 4,585 tên mà không cần prompt. Mỗi dự đoán từ các checkpoint
*-seg.ptđã phát hành cũng đi kèm mask instance segmentation. Về độ chính xác, bài báo YOLOE gốc cho thấy YOLOE-v8s vượt YOLO-Worldv2-S 3.5 AP trên LVIS, với chi phí huấn luyện chỉ bằng một phần ba và tốc độ inference nhanh hơn 1.4×. Việc chuyển đổi chỉ cần thay đổi một dòng — xem So sánh YOLOE.Ultralytics YOLOE hỗ trợ ba chế độ prompting. Text prompt là tên class dưới dạng chuỗi trên checkpoint
*-seg.pt, và là lựa chọn thông thường. Visual prompt gồm một hoặc nhiều box mẫu trên ảnh tham chiếu, dành cho các đối tượng khó mô tả bằng lời. Inference prompt-free dùng checkpoint*-seg-pf.ptriêng, có thể trả lời dựa trên từ vựng tích hợp gồm 4,585 tên mà không cần đầu vào. Text prompt và visual prompt dùng chung checkpoint; prompt-free dùng các tệp khác và từ chốiset_classes(). Xem Chọn chế độ prompting để biết so sánh đầy đủ.Hãy bắt đầu với
yoloe-26s-seg.pt: dòng YOLOE-26 dẫn trước YOLOE-11 và YOLOE-v8 ở mọi quy mô tương ứng, và quy môslà nhỏ nhất đạt trên 30 mAP trên LVIS minival. Chuyển lênm,lhoặcxkhi độ chính xác trên các category hiếm quan trọng hơn độ trễ — cột mAPr trong Hiệu năng là cột cần so sánh. Chỉ giảm xuốngnkhi triển khai trên edge. Thay vào đó, hãy tải tệp*-seg-pf.ptcùng quy mô nếu bạn muốn dùng từ vựng tích hợp thay vì tên class của riêng mình.Các nhãn như
object0vàobject1có nghĩa là dự đoán đến từ visual prompt, nhóm các box mẫu thành những class tạm thời được đánh số thay vì giữ tên của bạn. Các class ID bạn truyền vàovisual_prompts["cls"]chỉ dùng để nhóm như vậy. Model báo cáo chúng dưới dạngobject0,object1, v.v., theo thứ tự ID bạn đã gán, vì vậy hãy ánh xạ chúng về nhãn riêng trong kết quả. Nếu muốn đầu ra có tên của bạn, hãy dùng text prompt.Các checkpoint không cần prompt (
*-seg-pf.pt) xác định lớp bằng từ vựng tích hợp sẵn và từ chốiset_classes()khi dùng vớiAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.. Prompt trực quan gây raAssertionError: Visual prompts need an unfused YOLOE model.. Hãy tải checkpoint*-seg.ptkhi bạn cần danh sách lớp của riêng mình. Xem Chọn chế độ prompt.Text prompt đầu tiên khiến Ultralytics YOLOE cài đặt ultralytics/CLIP từ GitHub bằng
pipvà tải text encoder TorchScript vào thư mục làm việc hiện tại — khoảng 254 MB với YOLOE-26; xem Cài đặt và yêu cầu để biết chính xác asset cho từng dòng model. Visual prompt và checkpoint prompt-free không cần những thành phần này. Để tránh tải xuống trên máy đích, hãy thiết lập prompt một lần rồi lưu bằngsave_prompt_embeddings(), hoặc export model khi các class đã được cấu hình.Không — YOLOE tích hợp các class được prompt vào trọng số tại thời điểm export, vì vậy export đã tải sẽ từ chối cả
set_classes()lẫnvisual_prompts=. Hãy export lại từ checkpoint.ptgốc sau khi cấu hình prompt mới. Tệp đã export hoạt động như một model YOLO tiêu chuẩn và có thể được tải bằngYOLO()cũng nhưYOLOE().Dùng YOLOE khi bạn cần thông lượng thời gian thực và có thể nêu tên class; dùng SAM 3 khi chất lượng segmentation trên một khái niệm quan trọng hơn tốc độ. Cả hai đều chấp nhận ví dụ trực quan; chỉ YOLOE có chế độ prompt-free. Xem so sánh đầy đủ tại So sánh YOLOE.


Bình luận60
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.
daiyangyang945
I converted YOLOE to ONNX, but it only supports single-image input. How can I implement visual prompts?
1cyt1990cyt1990-dev
你好,请问怎么利用yoloe的视觉提示(结合SAM)功能进行自动标注(auto_annotate)?
 Glenn JocherUltralytics
你好,目前 YOLOE 的视觉提示能力是通过
model.predict(..., visual_prompts=..., refer_image=..., predictor=YOLOEVPSegPredictor)使用的,文档里还没有auto_annotate()直接接入这套流程的现成示例;另外yoloe-26*-seg.pt本身就会输出分割掩码,所以这类自动标注场景通常不需要再额外叠加 SAM,你可以先按 YOLOE 文档 和YOLOE.predict()参考 跑出提示式分割结果再保存为标签;如果你愿意,也欢迎把你的目标流程和样例数据贴在这个讨论里,方便团队一起看。
zhangxiancai
你好,请问yoloe如何使用多张图片里的视觉对象作为参考进行推理。因为一张图片不能全面反映要检测对象的特征,容易漏检。
 User
我也有想过建立一个供yoloe提取多角度多图片特征的小型数据库,但是发现效果并不好。官方通道似乎不支持多特征融合成一个标签。
q9card
Hello, I would like to ask about training YOLOE with a custom grounding dataset.
My current goal is to use YOLOE for open-vocabulary detection on remote-sensing small objects, and I am trying to integrate my own dataset, AI-TOD-v2, into the open-text / grounding training pipeline.
So far, I have completed the following steps:
- Converted AI-TOD-v2 from standard COCO detection annotations into a grounding-style JSON added caption for each image added tokens_positive for each instance
- Successfully ran generate_grounding_cache.py so the custom grounding JSON / cache generation itself seems to work
However, when I try to continue with the official open-text / from-scratch training pipeline, I run into many issues, for example:
(1)hard-coded checks in GroundingDataset.verify_labels() for official dataset names / instance counts (2)mismatch between yolo_data and grounding_data text slot / tensor shapes (3)later shape mismatch again in training loss / bbox decode
So I would like to ask:
Has anyone successfully trained YOLOE open-text / text-prompt models with a custom grounding dataset (not only the official Flickr/GQA/Objects365 data)? If yes, is there any recommended dataset organization or minimal working setup? Does the official pipeline currently support mixing custom grounding data with official grounding datasets such as Flickr/GQA? For a case like mine, would you recommend: continuing to adapt the current from-scratch training pipeline, or switching to another route based on official pretrained weights? If possible, could you share a minimal working example for training with a custom grounding dataset, even a very small toy example?
My current impression is that the main difficulty may not be the grounding JSON / cache generation itself, but rather that the current training code has strong assumptions about the official data pipeline. If there is any official recommendation or similar community experience, I would really appreciate it.
Thank you very much!
- Glenn JocherUltralytics
Thanks for the detailed report — the current public YOLOE from-scratch open-text pipeline is mainly validated around the official
Objects365/Flickr/GQArecipe shown in the YOLOE training docs, so a fully custom grounding dataset is not yet a documented plug-and-play path; for AI-TOD-v2, the safer route is usually to start from pretrainedyoloe-26*-seg.ptweights and the supported fine-tuning flow in the YOLOE usage docs rather than continuing from scratch. Please open a new issue with a minimal reproducible example, full traceback,yolo checks, and a tiny sample of the grounding JSON/cache so the team can check the dataset verification and shape assumptions directly. 我按照你说的用yoloe-s26-seg.pt进行微调,出现AttributeError: Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from '/mnt/workspace/projects/yoloe/ultralytics/nn/modules/head.py'>错误,改用最新版 pip 安装的 Ultralytics 再试仍然存在这个问题。 目前我的yolo check输出如下: OS Linux-5.10.134-18.0.9.lifsea8.x86_64-x86_64-with-glibc2.35 Environment Linux Python 3.10.19 Install pip Path /root/miniconda3/envs/yoloe/lib/python3.10/site-packages/ultralytics RAM 31.34 GB Disk 94.8/97.9 GB CPU Intel Xeon Platinum 8163 CPU @ 2.50GHz CPU count 8 GPU Tesla V100-SXM2-16GB, 16144MiB GPU count 1 CUDA 12.8
numpy ✅ 2.2.6>=1.23.0 matplotlib ✅ 3.10.8>=3.3.0 opencv-python ✅ 4.13.0.92>=4.6.0 pillow ✅ 12.1.1>=7.1.2 pyyaml ✅ 6.0.3>=5.3.1 requests ✅ 2.32.5>=2.23.0 scipy ✅ 1.15.3>=1.4.1 torch ✅ 2.10.0>=1.8.0 torch ✅ 2.10.0!=2.4.0,>=1.8.0; sys_platform == "win32" torchvision ✅ 0.25.0>=0.9.0 psutil ✅ 7.2.2>=5.8.0 polars ✅ 1.39.3>=0.20.0 ultralytics-thop ✅ 2.0.18>=2.0.18
- Glenn JocherUltralytics
这个报错基本就是“权重版本和实际导入的代码版本不一致”:
yolo checks显示你用的是site-packages,但异常却来自/mnt/workspace/projects/yoloe/ultralytics/...,说明本地仓库覆盖了 pip 安装;而YOLOESegment26在当前head.py文档里是存在的,所以请先移除或重命名该本地ultralytics目录并重启 Python/Notebook 会话,确认ultralytics.__file__指向同一环境后再试;如果还报错,请贴完整 traceback 和精确训练命令。
- User
视觉提示只能支持一种类型吗,当我使用视觉提示进行检测之后,再次设置新的类别就会出现shape '[1, 66, -1]' is invalid for input of size 416000
- Glenn JocherUltralytics
视觉提示不只支持一种类别,
visual_prompts里可以给多组bboxes/cls(要求cls从0..N-1连续且与框数量一致),细节见中文 YOLOE 文档;你这个shape '[1, 66, -1]' is invalid...通常是跑过视觉提示(尤其用过refer_image)后又set_classes()切新类别导致旧的 prompt/embedding 状态残留,建议直接重新初始化一个新YOLOE(...)实例(Notebook 里也请重启 kernel)再设置新类别/新视觉提示。若仍复现,请把最小可复现代码、完整 traceback(文本)以及yolo checks输出贴在这里我们才能定位。 - User
好的,问题可以解决。不过衍生出相机模式下,反复创建销毁yoloe()实例,同时相机推理的帧率也很低。我会继续进行优化
- User
感谢,已经将初始化逻辑改成文本/视觉提示发送改变时触发,同时开启GPU加速,问题基本解决,再次感谢答疑
- Glenn JocherUltralytics
很好,感谢你回报进展;相机/视频场景下建议始终复用同一个
YOLOE实例,只在提示词变化时才更新set_classes()或visual_prompts,且注意传了visual_prompts时视频/流会自动用第一帧作为refer_image(详见 中文 YOLOE 文档),这样能避免反复构建带来的卡顿并提升 FPS。from ultralytics import YOLOE model = YOLOE("yoloe-26s-seg.pt") # 可按需求换更小尺度提升速度 # 仅在提示变化时调用:model.set_classes(...) 或传 visual_prompts for r in model.predict(source=0, stream=True, device=0, half=True, imgsz=640): pass # 在这里处理 r(不要每帧重新初始化模型) - User
在使用yoloe-26模型时出现模型加载错误Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from 'd:\YOLO E\yoloe-main\ultralytics\nn\modules\head.py' YOLOE的库有进行开源更新吗
- Glenn JocherUltralytics
这个报错基本就是“权重文件里引用的模块/类名”和你当前导入的本地
ultralytics代码不一致导致的;从路径看你现在加载的是d:\YOLO E\yoloe-main\ultralytics\...这份源码,它不包含权重所需的YOLOESegment26,建议先排除本地目录把包“遮住”了的情况,改用最新版pip安装的 Ultralytics 再试(用法见中文 YOLOE 文档)。pip uninstall -y ultralytics pip install -U ultralytics yolo checks如果仍复现,请把“完整 traceback(文本)”、你是如何加载模型的最小代码(例如
YOLOE("yoloe-26s-seg.pt")/YOLO("yoloe-26s-seg.pt"))、以及上面yolo checks的输出贴出来;如果你刚升级过包且在 Notebook 里运行,也请先重启 kernel 再测。
qbig
Hello,
Can I ask why the exported Core ML model doesn't have labels metadata like normal YOLO or even exported YOLO-World models?
from ultralytics import YOLOE, YOLO from pathlib import Path from ultralytics.utils import YAML model_name = "yoloe-11m-seg.pt" file_name = "lvis.yaml" model = YOLOE(model_name) model.eval() # Please replace names with yours data = YAML.load(file_name) names = [n.split('/')[0] for n in data["names"].values()] model.set_classes(names, model.get_text_pe(names)) coreml_path = model.export(format='coreml', half=True, nms=False)- Glenn JocherUltralytics
That’s expected right now: YOLOE’s classes are prompt-defined (and can be changed via
set_classes()), so the CoreML exporter doesn’t reliably embed a fixed label list in the model metadata—especially when exporting “raw” outputs withnms=False; if you need labels inside the.mlmodel/.mlpackage, either export withnms=Trueor post-edit the CoreML package metadata after export (see the YOLOE export notes and theYOLOEAPI).
gstrat88
Is there any example to use it as a zero-shot logo detection?
tomer196
Hi, Is there a way to get the embeddings of each detection when I use model.predict? Similar to the way I can get the embeddings of the visual and text prompts.
ratom
I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format. @glenn-jocher
Hi @glenn-jocher, I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format.
- Glenn JocherUltralytics(đã chỉnh sửa)
@tomer196 Fine-tuning and open-vocabulary prompting are mutually exclusive in the current implementation: after fine-tuning with
YOLOEPESegTrainer, the checkpoint predicts your dataset’s classes directly andset_classes()raises an error, so keep the original checkpoint for prompting. Details are under Train Usage in the YOLOE docs; we can’t share timelines for other changes.@ram-from-tvl For production use you’ll need to choose between AGPL-3.0 compliance (open‑source your entire derivative) or an Enterprise License for proprietary deployment; see options and terms at the Ultralytics License page. For deployment hardening, benchmark and export to your target runtime (ONNX/TensorRT/CoreML/etc.) per the Export section in the YOLOE docs.
@ram-from-tvl To convert a UNet-style binary mask dataset to YOLO segmentation format, create one TXT per image with polygon coordinates per instance (normalized x,y). Format and examples are in the Segmentation task data format. Minimal conversion example for a single-class binary mask:
import cv2, numpy as np, os

def mask_to_yolo_segments(mask):
    h, w = mask.shape[:2]
    contours, _ = cv2.findContours(mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    segs = []
    for c in contours:
        if len(c) < 3:
            continue
        pts = c.squeeze(1).astype(float)
        pts[:, 0] /= w
        pts[:, 1] /= h
        segs.append(pts.reshape(-1))
    return segs

mask = cv2.imread("mask.png", 0) > 0
segs = mask_to_yolo_segments(mask.astype(np.uint8))
os.makedirs("labels", exist_ok=True)
with open("labels/image.txt", "w") as f:
    for seg in segs:
        f.write("0 " + " ".join(f"{v:.6f}" for v in seg.tolist()) + "\n")
@Swetha4545 YOLOE isn’t limited to 80 classes—text prompts are open‑vocab, and the prompt‑free variants use a large vocabulary; for harder concepts like “cotton” try synonyms (e.g., “cotton plant”, “cotton bale”, “fabric”) or switch to visual prompts with a clear reference exemplar; see Text/Visual/Prompt‑free usage in the YOLOE docs and the predictor API for visual prompts: YOLOEVPSegPredictor.
@ratom For per-pixel class maps (semantic segmentation), YOLO26 provides dedicated
-semmodels such asyolo26n-sem.pt(task=semantic); see the Semantic Segmentation docs. YOLOv8/YOLO11/YOLOE are instance segmentation models: if you use them, convert your masks to per‑instance polygons and save in YOLO segmentation TXT format (one line per instance:cls x1 y1 x2 y2 ..., normalized); the expected structure and examples are in the Segmentation task data format.
beichen2012
May I ask how to replace the YOLO11 backbone with DINOV3 distilled? Thanks.
- Glenn JocherUltralytics(đã chỉnh sửa)
@daiyangyang945 ONNX runtime doesn’t support passing visual prompts at inference; bake them before export by running one PyTorch pass with
refer_image(which fixes classes), then export the fused model; this preserves the same classes in ONNX and you can still use dynamic batch input: see Visual Prompting and Export sections in the YOLOE docs for details. Example:from ultralytics import YOLOE from ultralytics.models.yolo.yoloe import YOLOEVPSegPredictor m = YOLOE("yoloe-11l-seg.pt") visual_prompts = {"bboxes": ..., "cls": ...} # your examples m.predict("img.jpg", refer_image="ref.jpg", visual_prompts=visual_prompts, predictor=YOLOEVPSegPredictor) m.export(format="onnx", dynamic=True, simplify=True)For guidance see the YOLOE page under Predict and Export usage. Refer: YOLOE: Real‑Time Seeing Anything, YOLOEVPSegPredictor API.
@Chappie123 With bbox-only data, convert to YOLO detection TXT labels and train a detection model. Convert each box from
{minx,miny,maxx,maxy}to normalizedxc,yc,w,h:def to_yolo(minx, miny, maxx, maxy, W, H): xc = (minx + maxx) / 2 / W yc = (miny + maxy) / 2 / H w = (maxx - minx) / W h = (maxy - miny) / H return xc, yc, w, hDataset YAML (minimal):
path: /data/myset
train: images/train
val: images/val
names: {0: class0, 1: class1}
Train:
from ultralytics import YOLOE
model = YOLOE("yoloe-11s.yaml")
model.train(data="data.yaml", epochs=100, imgsz=640)
More in Train mode and Detection task.
@HLHSM The error is from installing the wrong
clippackage. Uninstall the PyPIclipand install the official CLIP (per its README), or use a compatible wheel likeclip-anytorch, then restart Python:pip uninstall -y clip pip install clip-anytorchIf it persists, please run
yolo checksand paste the full text output. Reference for the APIs you’re calling: YOLOE API reference.@Maya7991 Current ONNX exports accept a single
imagesinput; runtime text/visual prompts aren’t exposed as additional ONNX inputs. Use offline prompts: set and fuse classes before export, or use the prompt‑free path.from ultralytics import YOLOE m = YOLOE("yoloe-11s-seg.pt") names = ["person", "bus"] m.set_classes(names, m.get_text_pe(names)) # fuse prompts m.export(format="onnx", dynamic=True, simplify=True)With
dynamic=True, you can pass[N,3,H,W]batches in onnxruntime even though the input name is justimages. See Export mode and YOLOE Export examples on the docs page: YOLOE docs.@beichen2012 Swapping YOLO11’s CNN backbone for a DINOv3‑distilled ViT isn’t supported and would require a custom backbone module plus shape/plumbing changes; we recommend using YOLO26 as‑is or a transformer model like RT‑DETR. If you prototype this, please keep any PR minimal, well‑tested, and scoped to the new backbone only.