Triển khai YOLOv5 với DeepSparse của Neural Magic#
Neural Magic đã được Red Hat mua lại vào tháng 1 năm 2025 và ngừng hỗ trợ các phiên bản cộng đồng của DeepSparse, SparseML, SparseZoo và Sparsify vào ngày 2 tháng 6 năm 2025. Các công cụ vẫn hoạt động nhưng không còn được cập nhật hoặc hỗ trợ. Để tăng tốc CPU được duy trì, hãy xem các tích hợp OpenVINO và ONNX.
Chào mừng bạn đến với AI được cung cấp thông qua phần mềm.
Hướng dẫn này giải thích cách triển khai YOLOv5 với DeepSparse của Neural Magic.
DeepSparse là runtime suy luận có hiệu suất vượt trội trên CPU. Chẳng hạn, so với baseline ONNX Runtime, DeepSparse tăng tốc YOLOv5s lên 5,8 lần khi chạy trên cùng một máy!
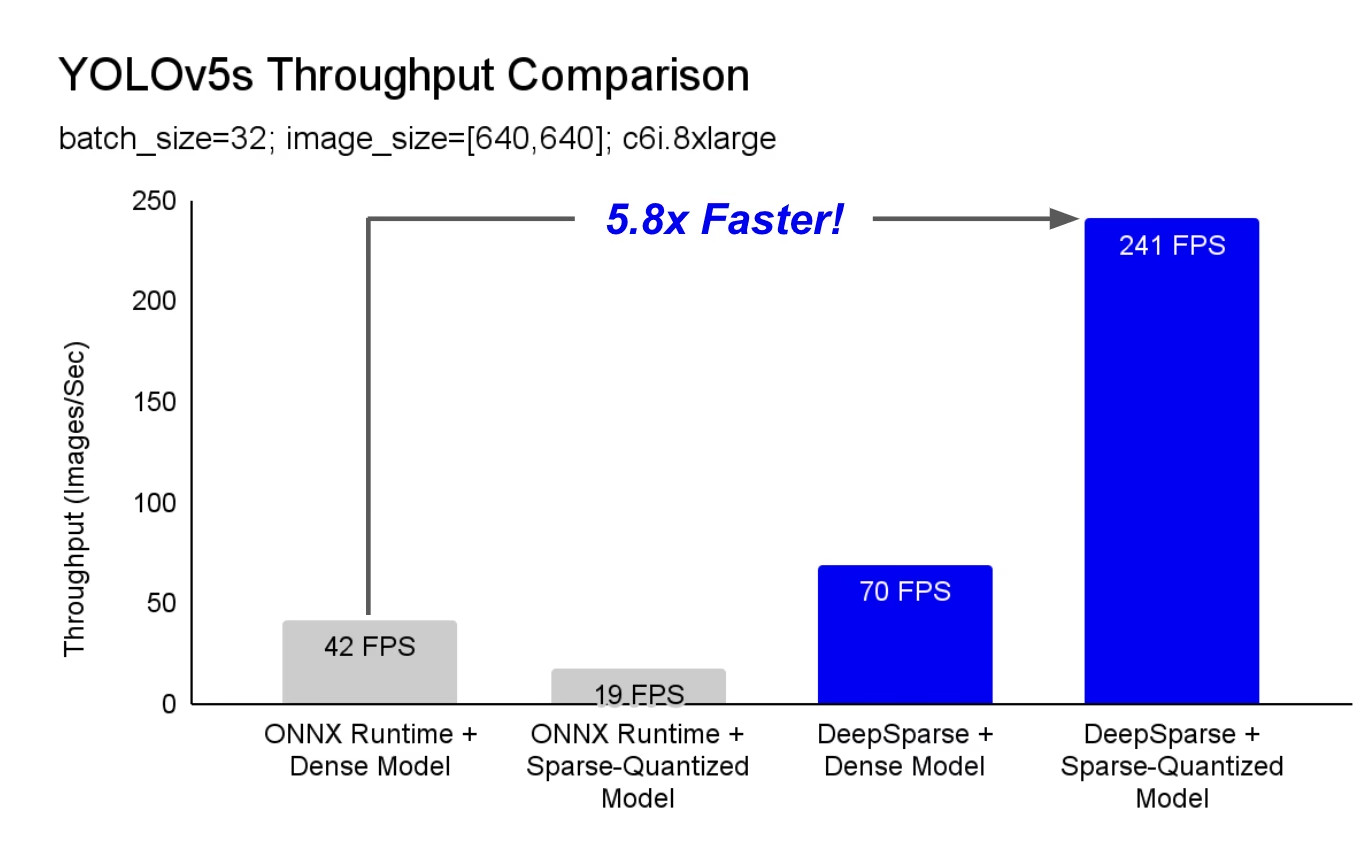
Lần đầu tiên, các workload deep learning của bạn có thể đáp ứng yêu cầu hiệu suất trong môi trường production mà không cần đến độ phức tạp và chi phí của bộ tăng tốc phần cứng. Nói đơn giản, DeepSparse mang lại hiệu suất của GPU cùng sự đơn giản của phần mềm:
- Triển khai linh hoạt: Chạy nhất quán trên cloud, trung tâm dữ liệu và thiết bị edge với mọi nhà cung cấp phần cứng, từ Intel đến AMD và ARM
- Khả năng mở rộng không giới hạn: Mở rộng theo chiều dọc lên hàng trăm core, mở rộng ra ngoài bằng Kubernetes tiêu chuẩn hoặc sử dụng Serverless được trừu tượng hóa hoàn toàn
- Tích hợp dễ dàng: API rõ ràng để tích hợp model vào ứng dụng và giám sát model trong môi trường production
DeepSparse đạt hiệu suất ngang GPU bằng cách nào?#
DeepSparse tận dụng tính thưa của model để tăng tốc hiệu suất.
Kỹ thuật tạo tính thưa thông qua pruning và lượng tử hóa đã được nghiên cứu rộng rãi, cho phép giảm bậc độ lớn kích thước và lượng tính toán cần thiết để chạy một mạng, đồng thời duy trì độ chính xác cao. DeepSparse nhận biết tính thưa, nghĩa là bỏ qua các tham số đã được đặt về 0, qua đó giảm lượng tính toán trong một lượt forward. Vì phép tính thưa lúc này bị giới hạn bởi bộ nhớ, DeepSparse thực thi mạng theo chiều sâu, chia bài toán thành các Tensor Column — những dải tính toán dọc vừa với cache.
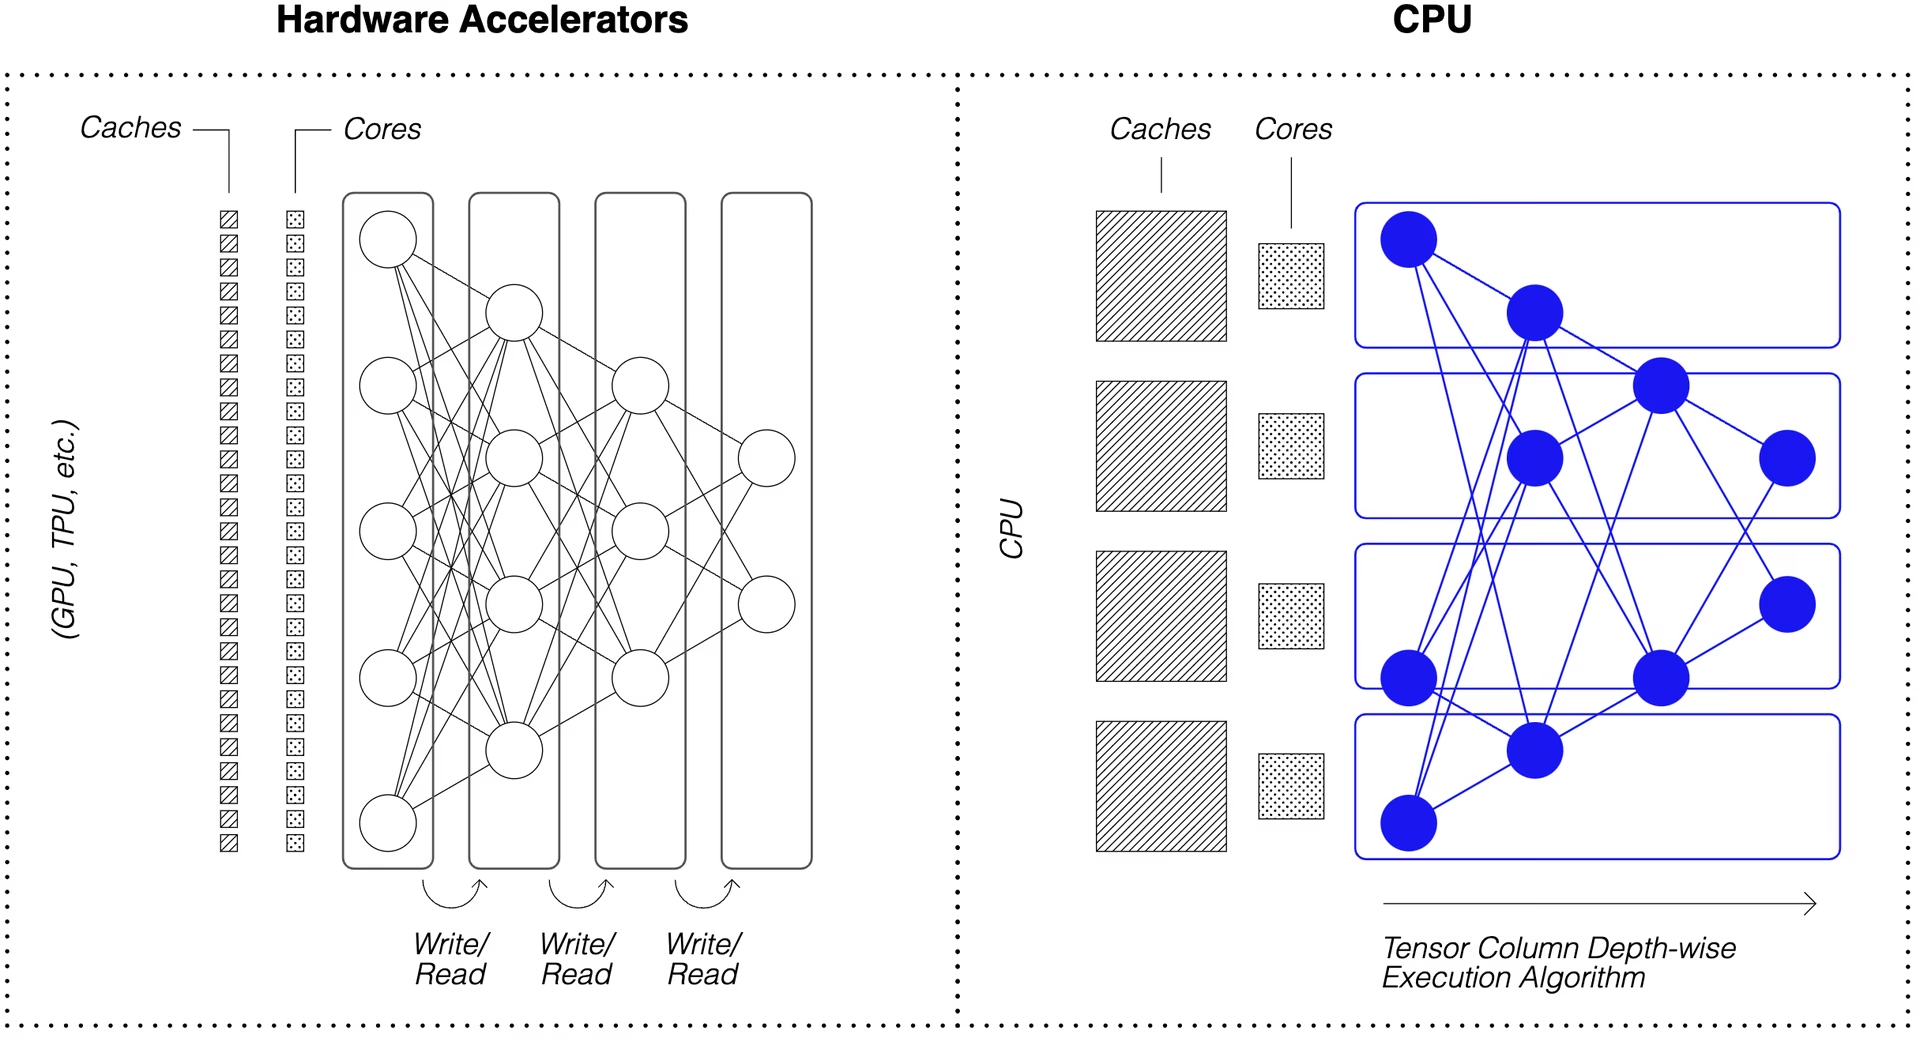
Các mạng thưa với phép tính được nén, thực thi theo chiều sâu trong cache, cho phép DeepSparse đạt hiệu suất ngang GPU trên CPU!
Làm thế nào để tạo phiên bản thưa của YOLOv5 được huấn luyện trên dữ liệu của tôi?#
Kho model mã nguồn mở của Neural Magic, SparseZoo, chứa các checkpoint đã được tạo tính thưa trước cho từng model YOLOv5. Với SparseML, được tích hợp với Ultralytics, bạn có thể fine-tune một checkpoint thưa trên dữ liệu của mình chỉ bằng một lệnh CLI.
Xem tích hợp SparseML với YOLOv5 để biết thêm chi tiết.
Cách sử dụng DeepSparse#
Chúng ta sẽ xem qua ví dụ benchmark và triển khai phiên bản thưa của YOLOv5s bằng DeepSparse.
Cài đặt DeepSparse#
Chạy lệnh sau để cài đặt DeepSparse. Chúng tôi khuyến nghị bạn sử dụng môi trường ảo với Python.
pip install "deepsparse[server,yolo,onnxruntime]"Thu thập file ONNX#
DeepSparse nhận model ở định dạng ONNX, được cung cấp theo một trong các cách sau:
- Stub SparseZoo trỏ đến một file ONNX trong SparseZoo
- Đường dẫn cục bộ đến một model ONNX trong hệ thống tệp
Các ví dụ dưới đây sử dụng checkpoint YOLOv5s dense và đã pruning-lượng tử hóa tiêu chuẩn, được xác định bằng các stub SparseZoo sau:
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
Triển khai model#
DeepSparse cung cấp API thuận tiện để tích hợp model vào ứng dụng.
Để thử các ví dụ triển khai bên dưới, hãy tải một ảnh mẫu và lưu thành basilica.jpg bằng lệnh sau:
wget -O basilica.jpg https://raw.githubusercontent.com/neuralmagic/deepsparse/main/src/deepsparse/yolo/sample_images/basilica.jpgPython API#
Pipelines bao bọc tiền xử lý và hậu xử lý đầu ra quanh runtime, cung cấp giao diện rõ ràng để thêm DeepSparse vào ứng dụng. Tích hợp DeepSparse-Ultralytics có sẵn Pipeline, chấp nhận ảnh thô và xuất bounding box.
Tạo Pipeline và chạy suy luận:
from deepsparse import Pipeline

# danh sách ảnh trong hệ thống tệp cục bộ
images = ["basilica.jpg"]

# tạo Pipeline
model_stub = "zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none"
yolo_pipeline = Pipeline.create(
    task="yolo",
    model_path=model_stub,
)

# chạy suy luận trên ảnh, nhận bounding box + lớp
pipeline_outputs = yolo_pipeline(images=images, iou_thres=0.6, conf_thres=0.001)
print(pipeline_outputs)
Nếu chạy trên cloud, bạn có thể gặp lỗi OpenCV không tìm thấy libGL.so.1. Bạn có thể cài đặt thư viện còn thiếu:
apt-get install libgl1Hoặc sử dụng bản OpenCV headless, hoàn toàn không phụ thuộc GUI:
pip install opencv-python-headlessHTTP Server#
DeepSparse Server chạy trên framework web FastAPI phổ biến và web server Uvicorn. Chỉ với một lệnh CLI, bạn có thể dễ dàng thiết lập endpoint dịch vụ model bằng DeepSparse. Server hỗ trợ mọi Pipeline của DeepSparse, bao gồm phát hiện đối tượng bằng YOLOv5, cho phép bạn gửi ảnh thô đến endpoint và nhận bounding box.
Khởi chạy Server với YOLOv5s đã pruning-lượng tử hóa:
deepsparse.server \
  --task yolo \
  --model_path zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
Ví dụ về một request sử dụng package requests của Python:
import json
from contextlib import ExitStack

import requests

# danh sách ảnh để suy luận (file cục bộ phía máy khách)
path = ["basilica.jpg"]

# gửi request qua HTTP đến endpoint /predict/from_files
url = "http://0.0.0.0:5543/predict/from_files"
with ExitStack() as stack:
    files = [("request", stack.enter_context(open(img, "rb"))) for img in path]
    resp = requests.post(url=url, files=files)

# response được trả về ở định dạng JSON
annotations = json.loads(resp.text)  # dictionary chứa kết quả chú giải
bounding_boxes = annotations["boxes"]
labels = annotations["labels"]
Annotate CLI#
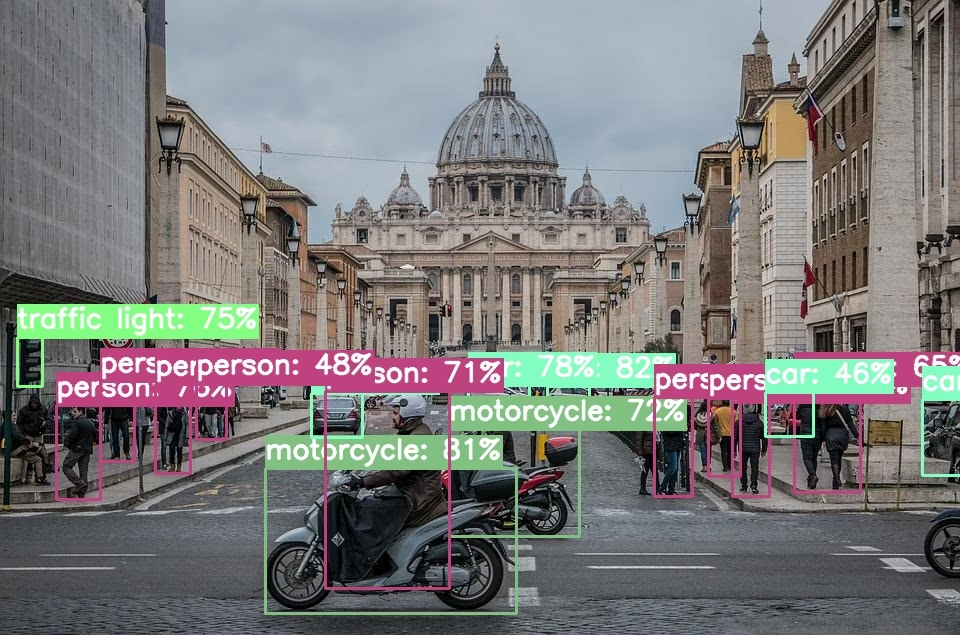
Bạn cũng có thể dùng lệnh annotate để engine lưu ảnh đã chú giải vào đĩa. Hãy thử --source 0 để chú giải luồng webcam trực tiếp của bạn!
deepsparse.object_detection.annotate --model_filepath zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none --source basilica.jpgChạy lệnh trên sẽ tạo thư mục annotation-results và lưu ảnh đã chú thích vào bên trong.
Đánh giá hiệu năng#
Chúng ta sẽ so sánh thông lượng của DeepSparse với thông lượng của ONNX Runtime trên YOLOv5s bằng script benchmark của DeepSparse.
Các benchmark được chạy trên một instance AWS c6i.8xlarge (16 lõi).
So sánh hiệu năng ở batch 32#
Mức cơ sở của ONNX Runtime#
Ở batch 32, ONNX Runtime đạt 42 ảnh/giây với YOLOv5s dense tiêu chuẩn:
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 41.9025
Hiệu năng Dense của DeepSparse#
DeepSparse đạt hiệu năng tốt nhất với các model sparse đã được tối ưu, nhưng cũng hoạt động tốt với YOLOv5s dense tiêu chuẩn.
Ở batch 32, DeepSparse đạt 70 ảnh/giây với YOLOv5s dense tiêu chuẩn, hiệu năng cải thiện 1.7x so với ORT!
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 69.5546
Hiệu năng Sparse của DeepSparse#
Khi áp dụng sparsity cho model, mức tăng hiệu năng của DeepSparse so với ONNX Runtime còn lớn hơn.
Ở batch 32, DeepSparse đạt 241 ảnh/giây với YOLOv5s đã pruning và quantize, hiệu năng cải thiện 5.8x so với ORT!
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 241.2452
So sánh hiệu năng ở batch 1#
DeepSparse cũng có thể tăng tốc so với ONNX Runtime trong tình huống batch 1 nhạy cảm với độ trễ.
Mức cơ sở của ONNX Runtime#
Ở batch 1, ONNX Runtime đạt 48 ảnh/giây với YOLOv5s dense tiêu chuẩn.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 1 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 48.0921
Hiệu năng Sparse của DeepSparse#
Ở batch 1, DeepSparse đạt 135 mục/giây với YOLOv5s đã pruning và quantize, tăng hiệu năng 2.8x so với ONNX Runtime!
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 134.9468
Vì các instance c6i.8xlarge có tập lệnh VNNI, có thể tăng thêm thông lượng của DeepSparse nếu pruning trọng số theo các khối 4.
Ở batch 1, DeepSparse đạt 180 mục/giây với YOLOv5s đã pruning theo khối 4 và quantize, tăng hiệu năng 3.7x so với ONNX Runtime!
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 179.7375
Bắt đầu với DeepSparse#
Nghiên cứu hay thử nghiệm? DeepSparse Community miễn phí cho mục đích nghiên cứu và thử nghiệm. Bắt đầu với README của DeepSparse.
Để biết thêm thông tin về cách triển khai YOLOv5 với DeepSparse, hãy xem các ví dụ YOLOv5 của DeepSparse và bài viết trên blog Ultralytics về tích hợp DeepSparse.
Câu hỏi thường gặp#
Không. DeepSparse là runtime CPU; các benchmark ở trên được đo trên một instance AWS
c6i.8xlarge16 lõi mà không có bất kỳ bộ tăng tốc nào.Xuất model sang ONNX bằng
python export.py --weights best.pt --include onnxvà truyền đường dẫn tệp làmmodel_paththay vì dùng SparseZoo stub. Các model dense vẫn hưởng lợi từ runtime, còn model đã pruning và quantize đạt mức cải thiện lớn nhất.Dùng SparseML để fine-tune một trong các checkpoint SparseZoo đã được tạo sparsity trước trên dữ liệu của bạn; SparseML giữ nguyên cấu trúc sparsity trong quá trình training. Sau đó, xuất model sang ONNX.
Không. Các phiên bản cộng đồng đã ngừng hỗ trợ vào ngày 2 tháng 6 năm 2025 và các package trên PyPI đã bị đóng băng. Các pipeline hiện có vẫn hoạt động, nhưng các lần triển khai mới nên cân nhắc các hướng OpenVINO hoặc ONNX Runtime, hiện vẫn được duy trì tích cực.