Kiến trúc Ultralytics YOLOv5#
YOLOv5 (v6.0/6.1) là thuật toán phát hiện đối tượng do Ultralytics phát triển. Bài viết này giải thích kiến trúc YOLOv5, các chiến lược data augmentation, phương pháp huấn luyện và kỹ thuật tính loss. Hiểu rõ những nội dung này sẽ giúp bạn ứng dụng phát hiện đối tượng trong các lĩnh vực như giám sát, xe tự hành và nhận dạng hình ảnh.
1. Cấu trúc model#
Kiến trúc YOLOv5 gồm ba phần chính:
- Backbone: Đây là phần chính của mạng. Với YOLOv5, backbone được thiết kế theo cấu trúc
CSPDarknet53, một phiên bản chỉnh sửa của kiến trúc Darknet được sử dụng trong các phiên bản trước. - Neck: Phần này kết nối backbone với head. YOLOv5 sử dụng các cấu trúc
SPPF(Spatial Pyramid Pooling - Fast) vàPANet(Path Aggregation Network). - Head: Phần này chịu trách nhiệm tạo đầu ra cuối cùng. YOLOv5 sử dụng
YOLOv3 Headcho mục đích này.
Cấu trúc model được minh họa trong hình bên dưới. Bạn có thể xem chi tiết cấu trúc model trong models/yolov5l.yaml.
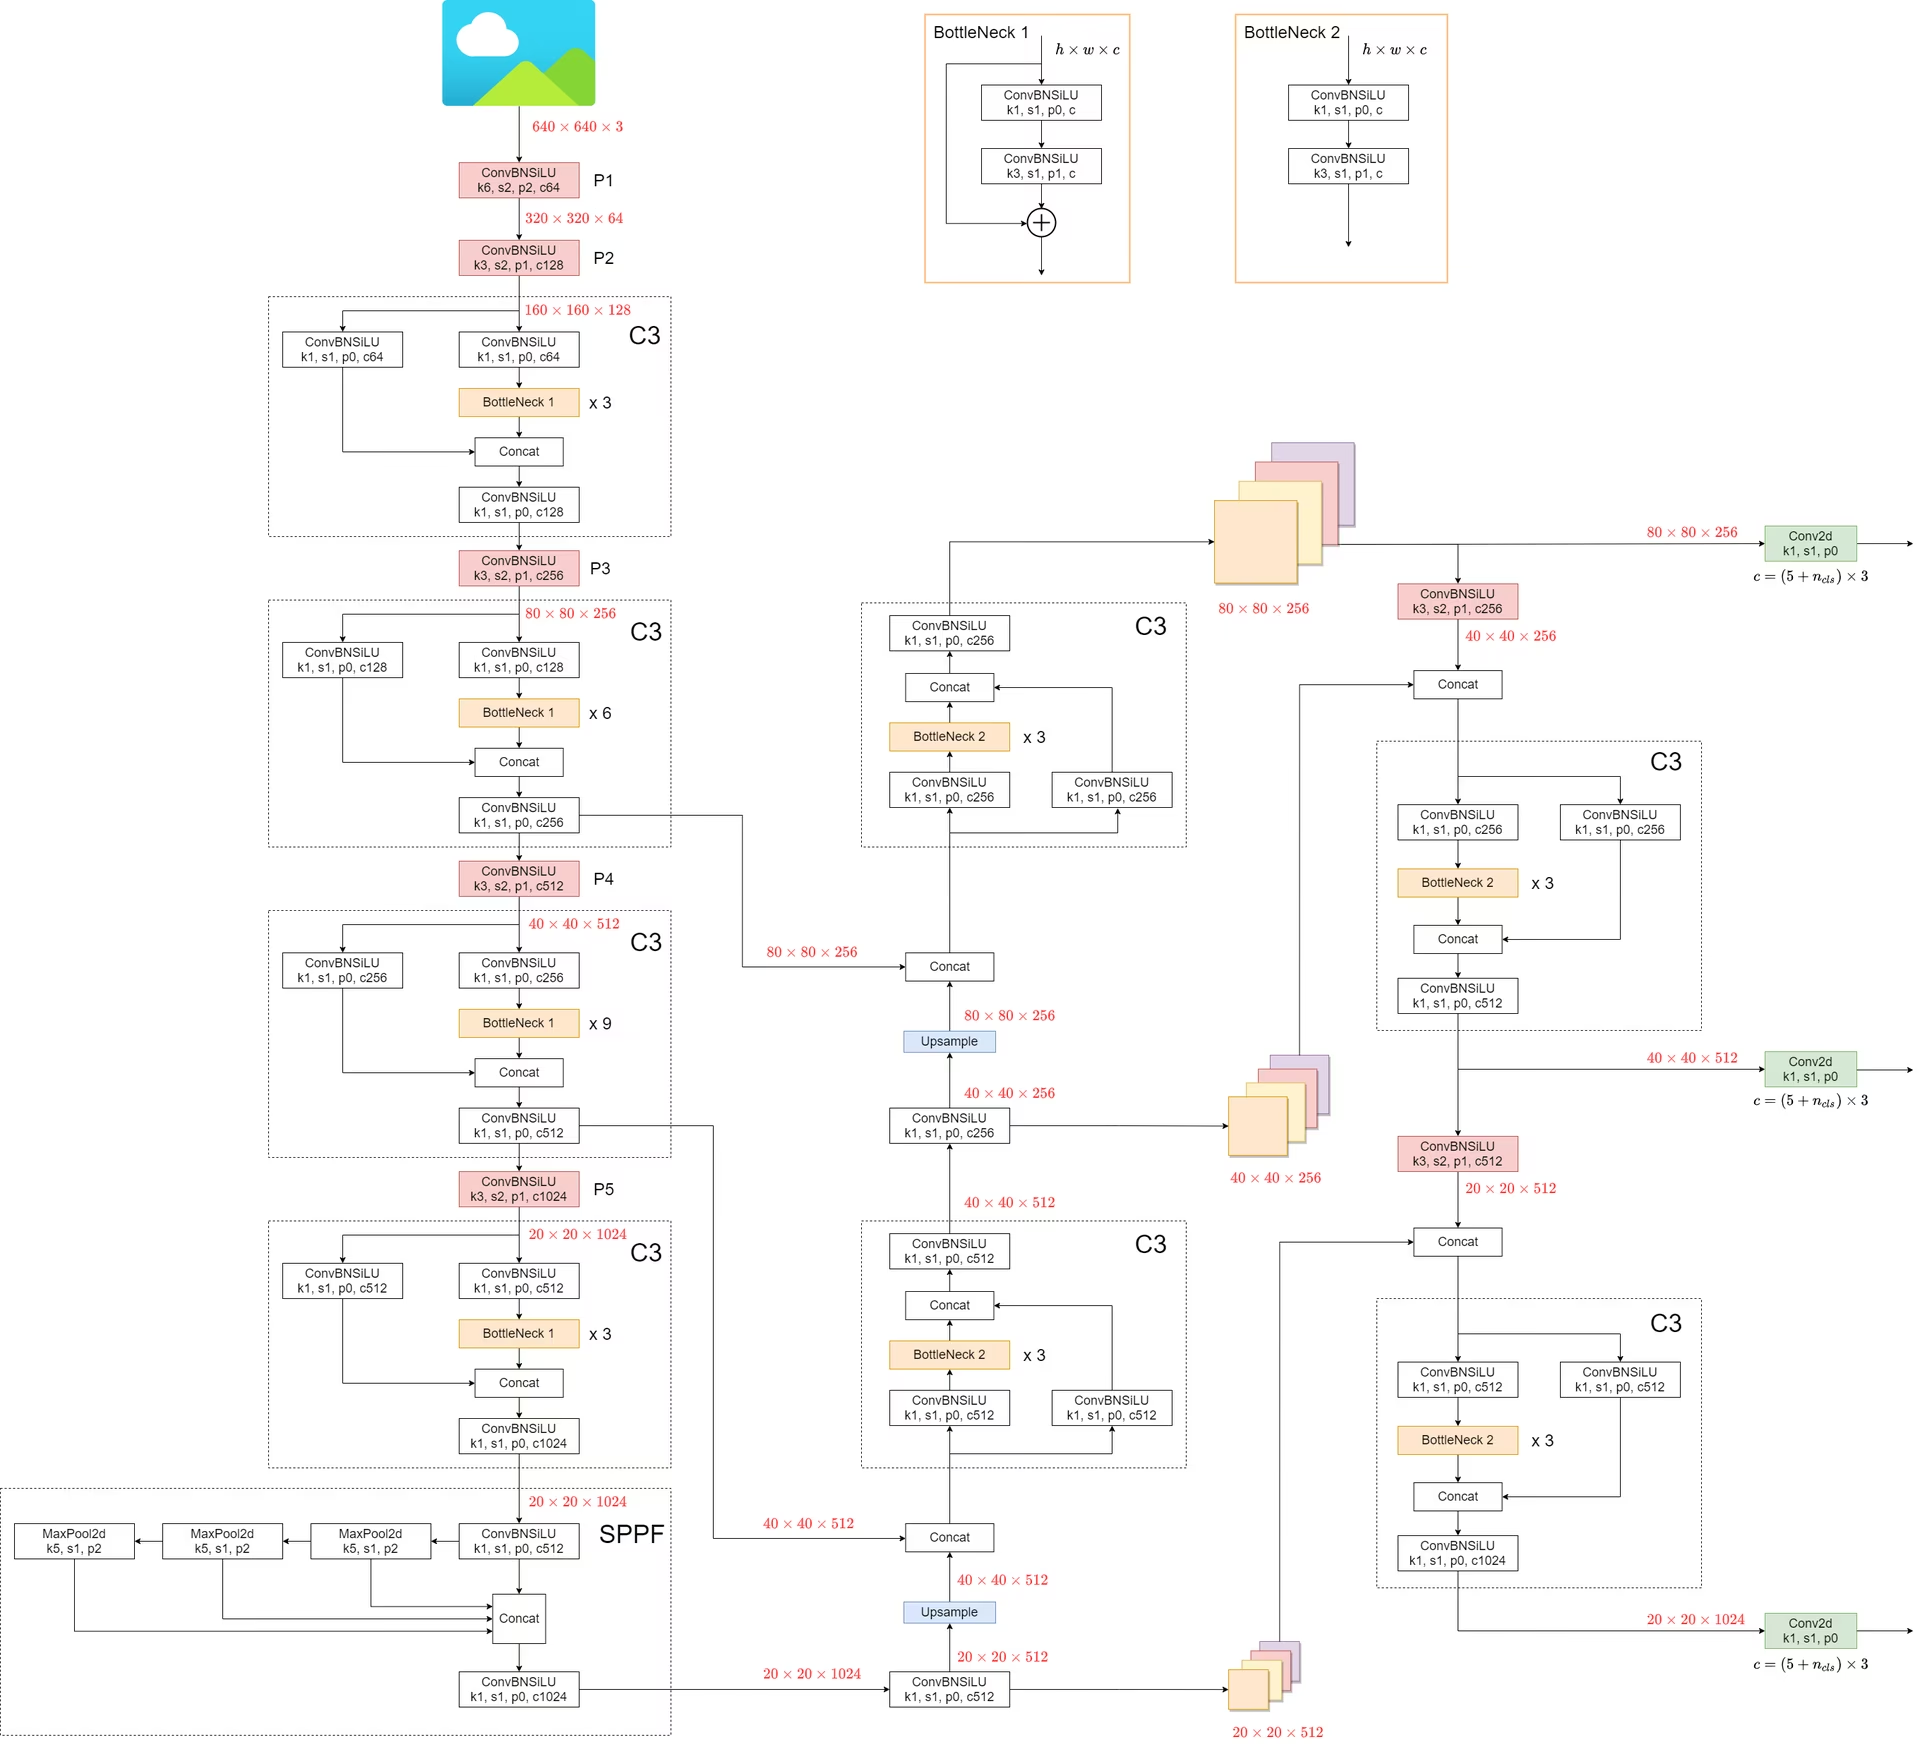
YOLOv5 có một số cải tiến đáng chú ý so với các phiên bản tiền nhiệm:
- Cấu trúc
Focustrong các phiên bản trước được thay thế bằng cấu trúc6x6 Conv2d. Thay đổi này giúp tăng hiệu quả #4825. - Cấu trúc
SPPđược thay thế bằngSPPF. Thay đổi này giúp tốc độ xử lý tăng hơn gấp đôi trong khi vẫn giữ nguyên đầu ra.
Có thể dùng đoạn mã sau để kiểm tra tốc độ của SPP và SPPF:
Ví dụ profiling tốc độ SPP so với SPPF (nhấp để mở)
import time

import torch
from torch import nn

class SPP(nn.Module):
    def __init__(self):
        """Initializes an SPP module with three different sizes of max pooling layers."""
        super().__init__()
        self.maxpool1 = nn.MaxPool2d(5, 1, padding=2)
        self.maxpool2 = nn.MaxPool2d(9, 1, padding=4)
        self.maxpool3 = nn.MaxPool2d(13, 1, padding=6)

    def forward(self, x):
        """Applies three max pooling layers on input `x` and concatenates results along channel dimension."""
        o1 = self.maxpool1(x)
        o2 = self.maxpool2(x)
        o3 = self.maxpool3(x)
        return torch.cat([x, o1, o2, o3], dim=1)

class SPPF(nn.Module):
    def __init__(self):
        """Initializes an SPPF module with a specific configuration of MaxPool2d layer."""
        super().__init__()
        self.maxpool = nn.MaxPool2d(5, 1, padding=2)

    def forward(self, x):
        """Applies sequential max pooling and concatenates results with input tensor."""
        o1 = self.maxpool(x)
        o2 = self.maxpool(o1)
        o3 = self.maxpool(o2)
        return torch.cat([x, o1, o2, o3], dim=1)

def main():
    """Compares outputs and performance of SPP and SPPF on a random tensor (8, 32, 16, 16)."""
    input_tensor = torch.rand(8, 32, 16, 16)
    spp = SPP()
    sppf = SPPF()
    output1 = spp(input_tensor)
    output2 = sppf(input_tensor)

    print(torch.equal(output1, output2))

    t_start = time.time()
    for _ in range(100):
        spp(input_tensor)
    print(f"SPP time: {time.time() - t_start}")

    t_start = time.time()
    for _ in range(100):
        sppf(input_tensor)
    print(f"SPPF time: {time.time() - t_start}")

if __name__ == "__main__":
    main()
Kết quả:
True
SPP time: 0.5373051166534424
SPPF time: 0.20780706405639648
2. Kỹ thuật tăng cường dữ liệu#
YOLOv5 sử dụng nhiều kỹ thuật tăng cường dữ liệu để cải thiện khả năng tổng quát hóa của model và giảm overfitting. Các kỹ thuật này gồm:
-
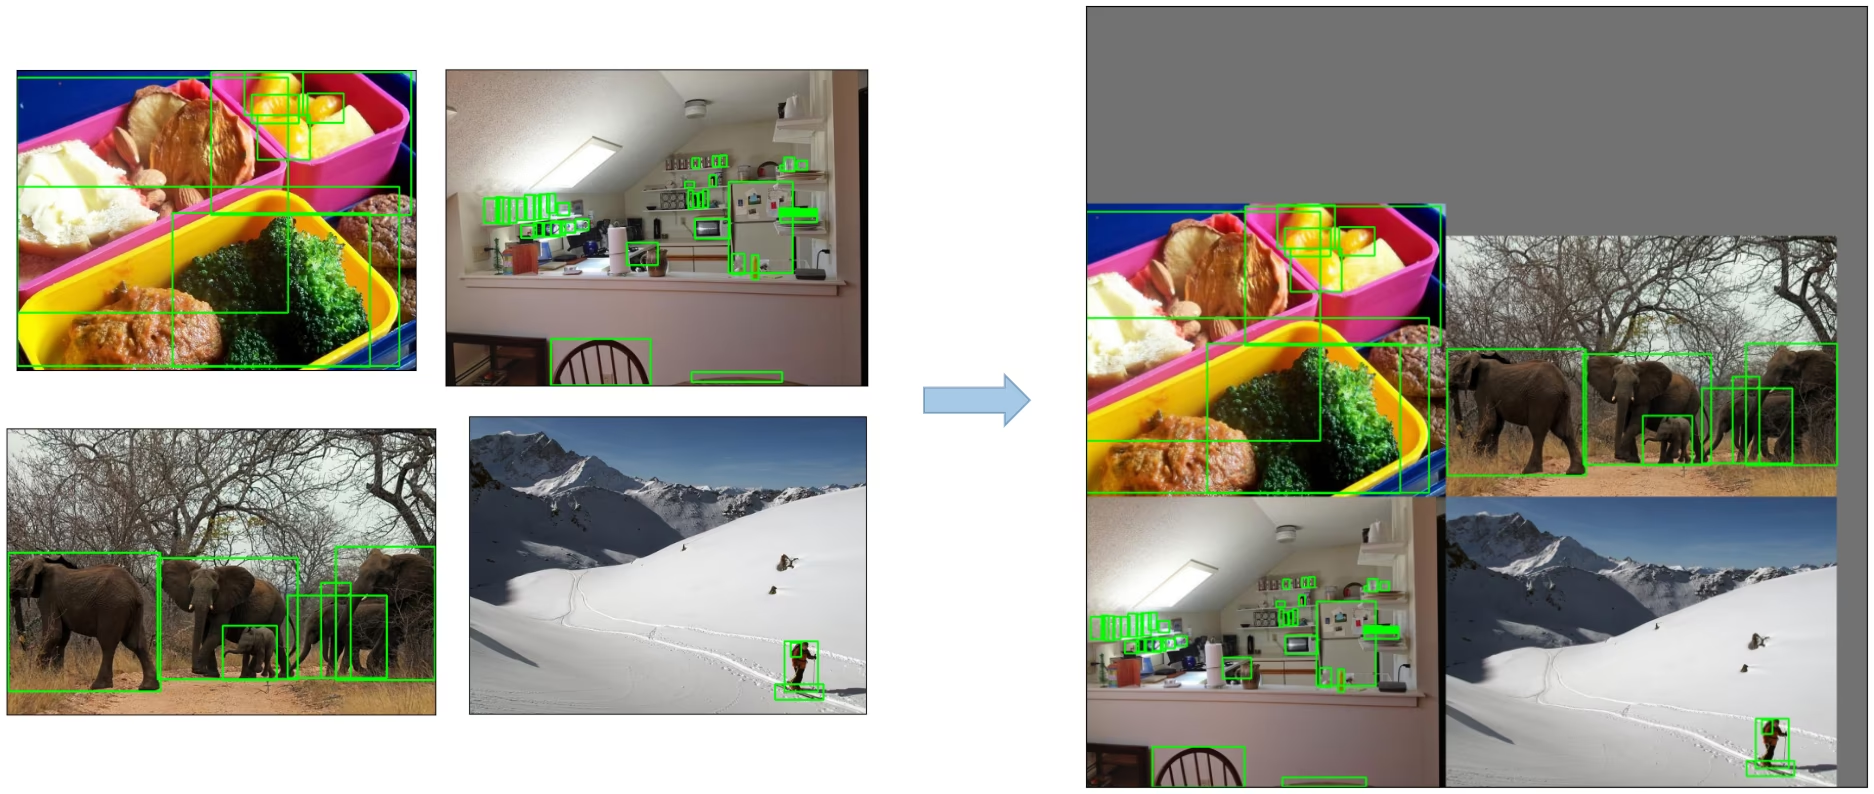
Mosaic Augmentation: Kỹ thuật xử lý ảnh kết hợp bốn ảnh huấn luyện thành một theo cách giúp model phát hiện đối tượng xử lý tốt hơn các đối tượng ở nhiều tỷ lệ và vị trí khác nhau.
-
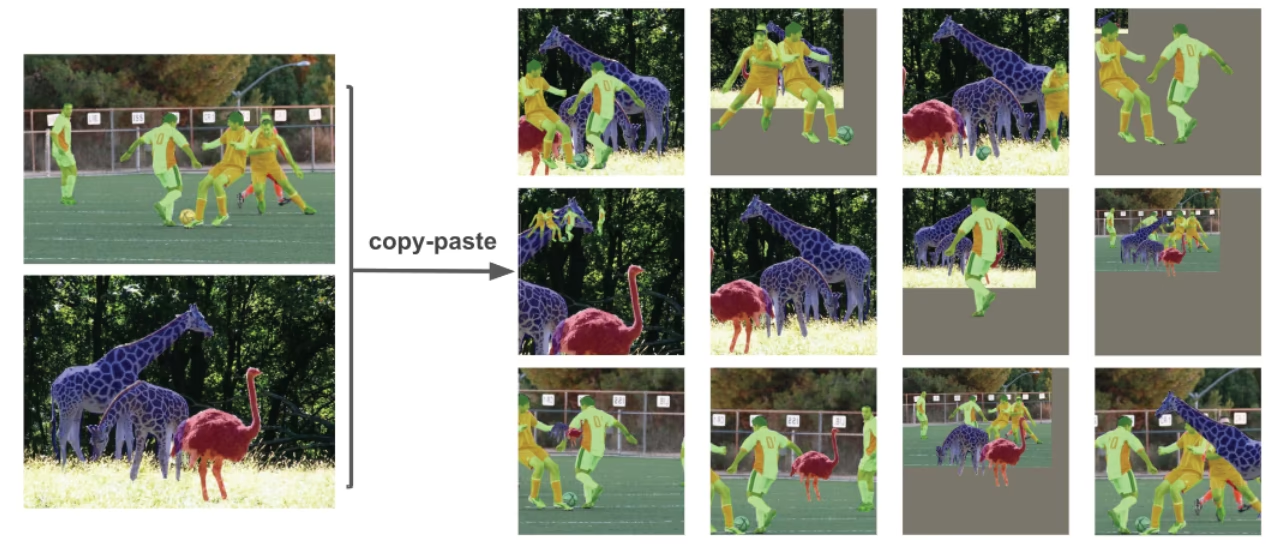
Copy-Paste Augmentation: Phương pháp data augmentation sao chép các đối tượng bằng mask segmentation của chúng rồi dán lên ảnh huấn luyện để tạo mẫu huấn luyện mới.
-
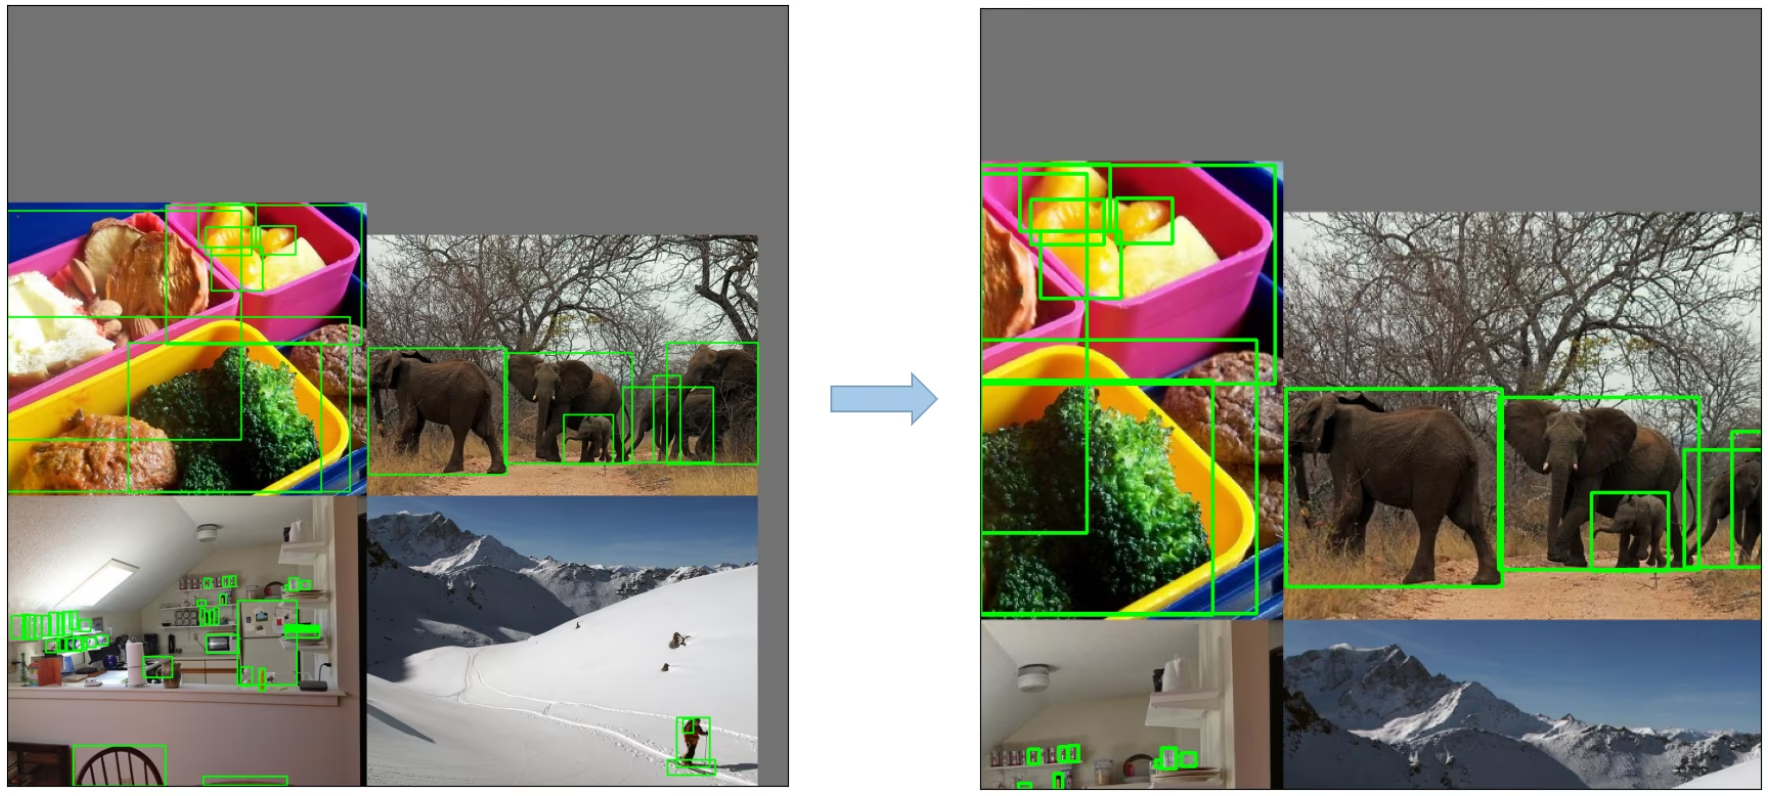
Biến đổi affine ngẫu nhiên: Bao gồm xoay, thay đổi tỷ lệ, dịch chuyển và cắt xiên ảnh ngẫu nhiên.
-
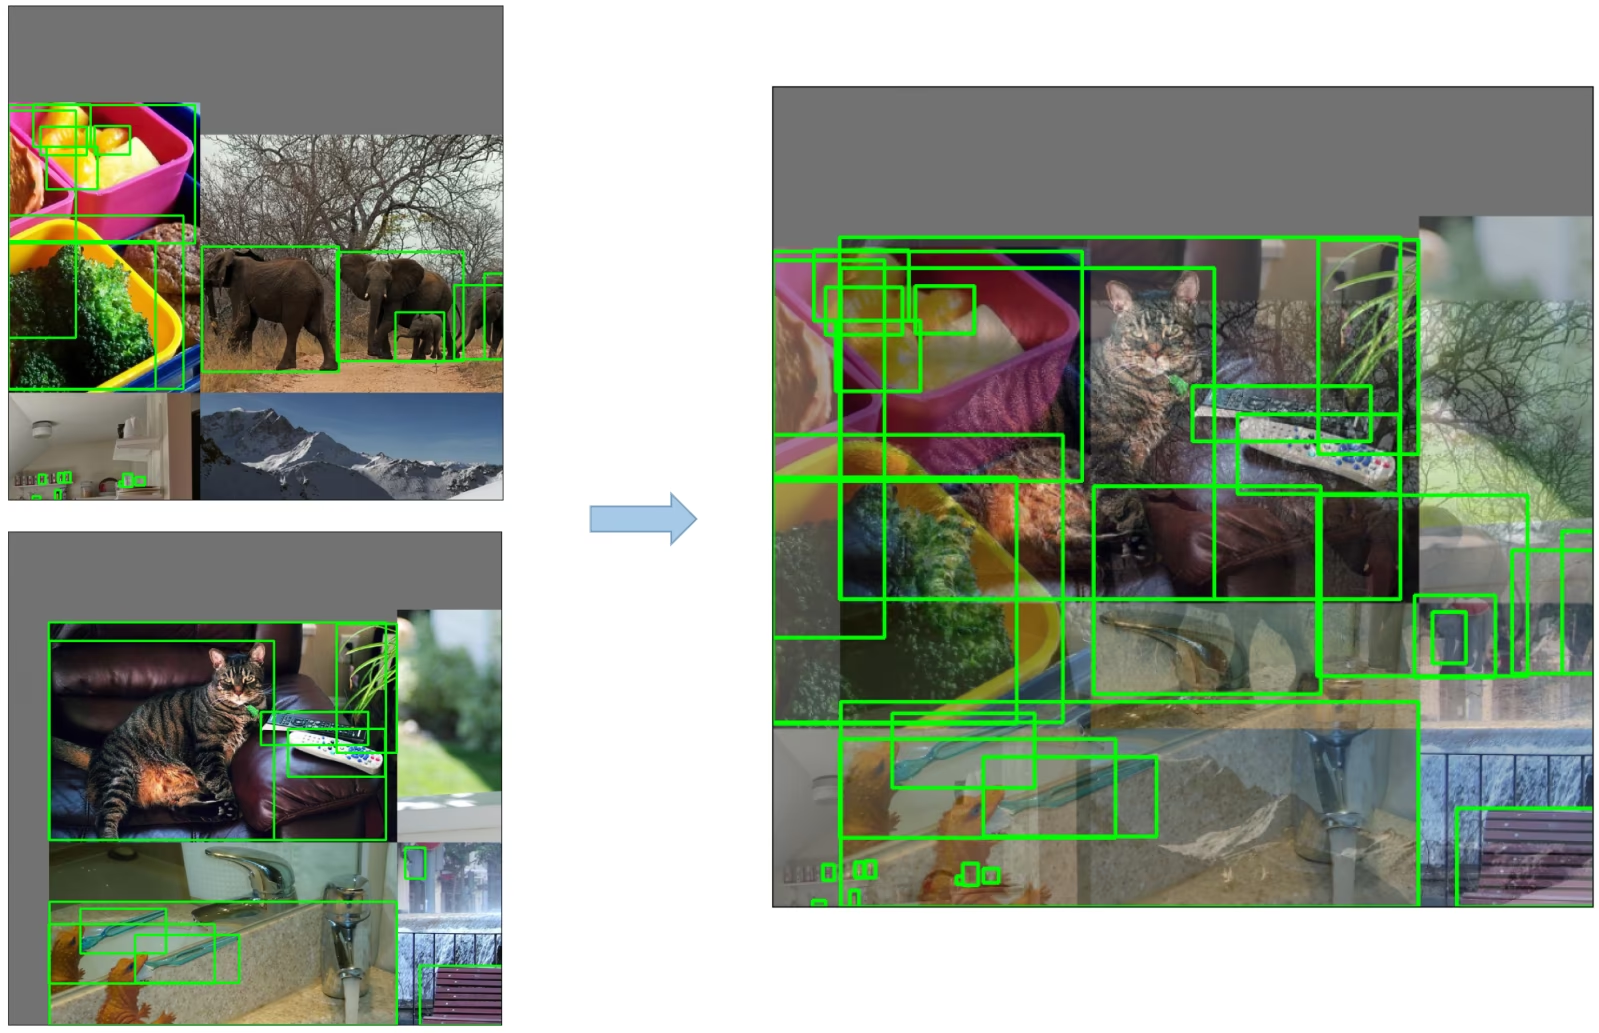
Tăng cường MixUp: Phương pháp tạo ảnh tổng hợp bằng cách lấy tổ hợp tuyến tính của hai ảnh cùng nhãn tương ứng.
-
Albumentations: Thư viện augmentation hình ảnh hỗ trợ nhiều kỹ thuật augmentation.
-
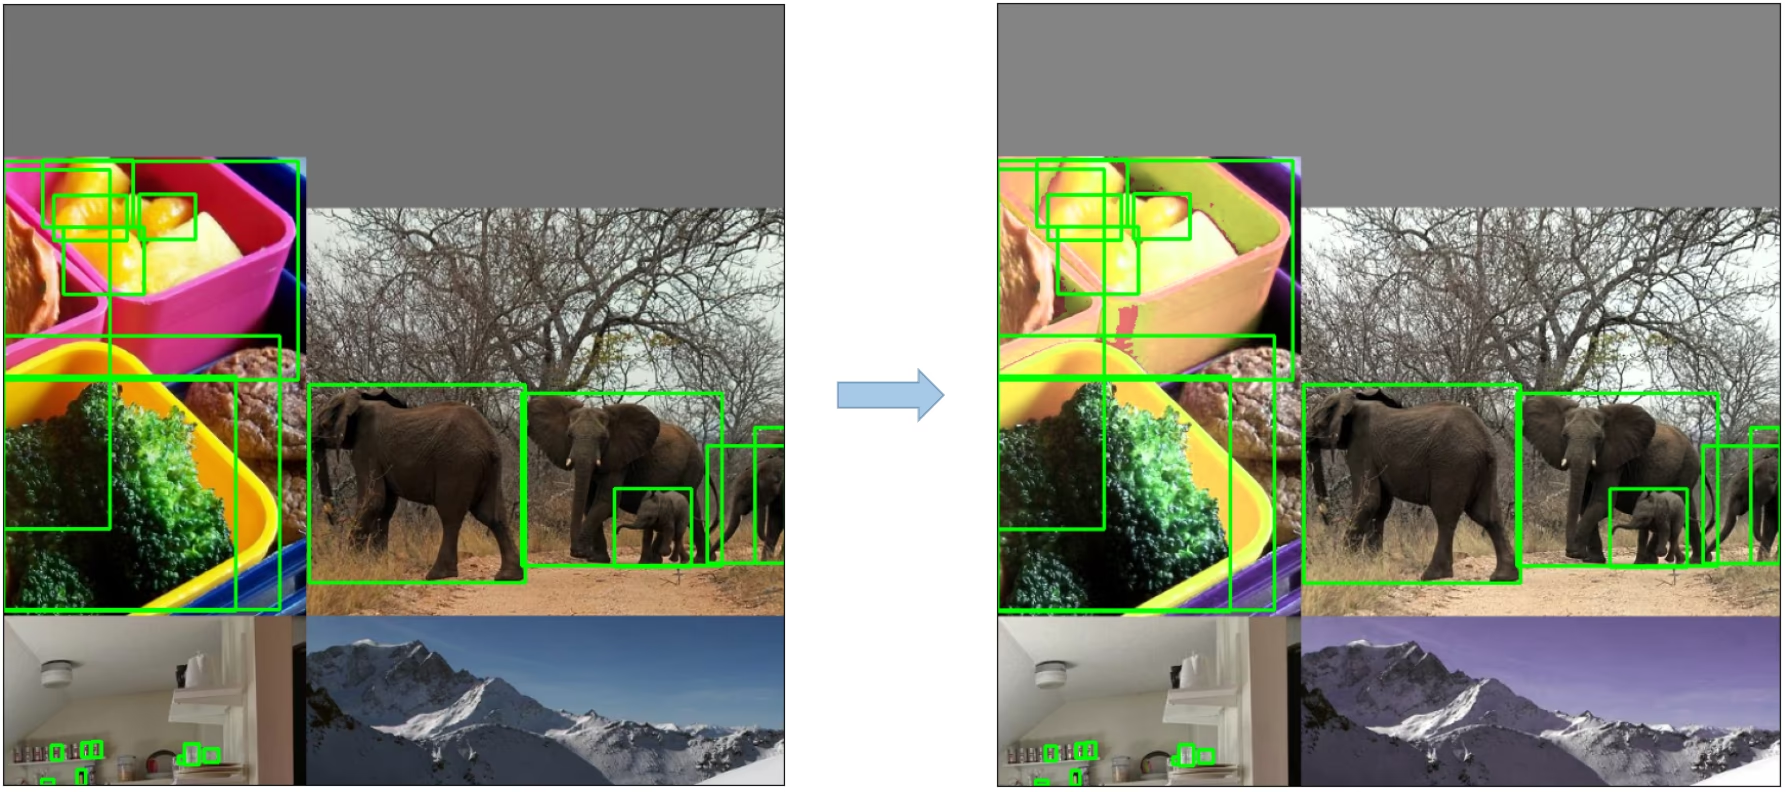
Tăng cường HSV: Thay đổi ngẫu nhiên Hue, Saturation và Value của ảnh.
-
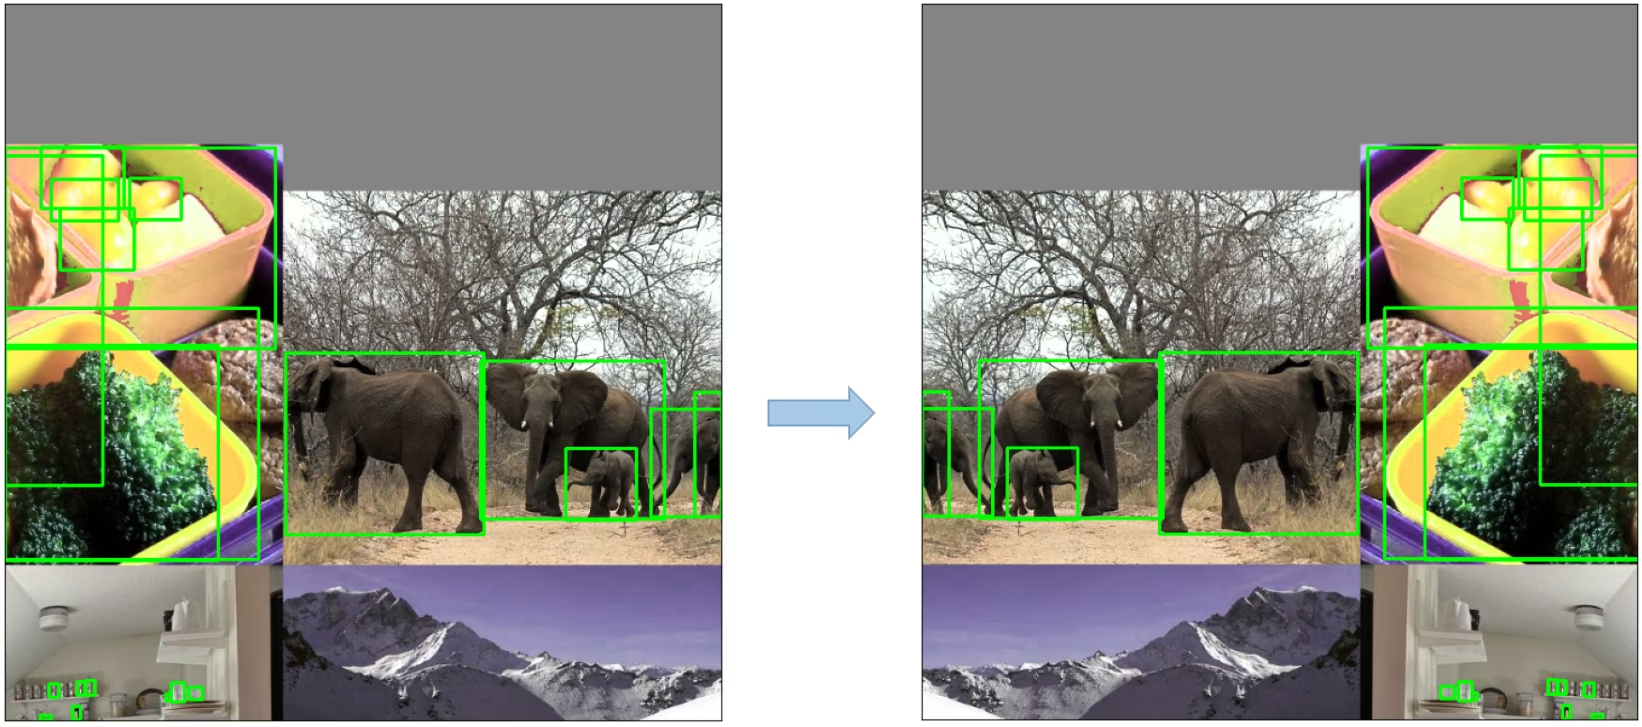
Lật ngang ngẫu nhiên: Phương pháp tăng cường ngẫu nhiên lật ảnh theo chiều ngang.
3. Chiến lược huấn luyện#
YOLOv5 áp dụng một số chiến lược huấn luyện để nâng cao hiệu năng của model. Các chiến lược này bao gồm:
- Huấn luyện đa tỷ lệ: Trong quá trình huấn luyện, ảnh đầu vào được thay đổi tỷ lệ ngẫu nhiên trong phạm vi từ 0,5 đến 1,5 lần kích thước ban đầu.
- AutoAnchor: Chiến lược này tối ưu các anchor box ban đầu để khớp với đặc tính thống kê của các box ground truth trong dữ liệu tùy chỉnh của bạn.
- Bộ lập lịch Warmup và Cosine LR: Phương pháp điều chỉnh learning rate để cải thiện hiệu suất model.
- Trung bình trượt hàm mũ (EMA): Chiến lược sử dụng giá trị trung bình của các tham số qua những bước trước đó để ổn định quá trình huấn luyện và giảm lỗi khái quát hóa.
- Huấn luyện mixed precision: Phương pháp thực hiện các phép toán ở định dạng độ chính xác bán phần, giúp giảm mức sử dụng bộ nhớ và tăng tốc độ tính toán.
- Tiến hóa siêu tham số: Chiến lược tự động tinh chỉnh siêu tham số để đạt hiệu suất tối ưu. Xem hướng dẫn Tiến hóa siêu tham số.
4. Tính năng bổ sung#
4.1 Tính loss#
Loss trong YOLOv5 được tính bằng cách kết hợp ba thành phần loss riêng biệt:
- Loss lớp (loss BCE): Loss Entropy chéo nhị phân, đo lỗi của tác vụ phân loại.
- Loss độ hiện diện của đối tượng (loss BCE): Một loss Entropy chéo nhị phân khác, tính lỗi khi phát hiện có hay không có đối tượng trong một ô lưới cụ thể.
- Hàm mất mát định vị (hàm mất mát CIoU): Hàm mất mát IoU hoàn chỉnh đo lường sai số khi định vị đối tượng trong ô lưới.
Hàm loss tổng thể được biểu diễn như sau:
4.2 Cân bằng loss#
Các loss độ hiện diện của đối tượng ở ba lớp dự đoán (P3, P4, P5) được gán trọng số khác nhau. Các trọng số cân bằng lần lượt là [4.0, 1.0, 0.4]. Cách tiếp cận này đảm bảo dự đoán ở các tỷ lệ khác nhau đóng góp phù hợp vào loss tổng.
4.3 Loại bỏ độ nhạy với lưới#
Kiến trúc YOLOv5 có một số thay đổi quan trọng trong chiến lược dự đoán box so với các phiên bản YOLO trước đó. Trong YOLOv2 và YOLOv3, tọa độ box được dự đoán trực tiếp bằng hàm kích hoạt của lớp cuối cùng.

Tuy nhiên, trong YOLOv5, công thức dự đoán tọa độ box đã được cập nhật để giảm độ nhạy với lưới và ngăn model dự đoán các kích thước box không bị giới hạn.
Các công thức sửa đổi để tính bounding box dự đoán như sau:
So sánh độ lệch tâm trước và sau khi scale. Phạm vi độ lệch tâm được điều chỉnh từ (0, 1) thành (-0.5, 1.5). Nhờ đó, độ lệch có thể đạt giá trị 0 hoặc 1 dễ dàng hơn.

So sánh tỷ lệ scale chiều cao và chiều rộng (so với anchor) trước và sau khi điều chỉnh. Các phương trình box YOLO/Darknet ban đầu có lỗi nghiêm trọng. Chiều rộng và chiều cao hoàn toàn không bị giới hạn vì đơn giản là out=exp(in); điều này nguy hiểm vì có thể dẫn đến gradient tăng mất kiểm soát, mất ổn định, loss NaN và cuối cùng khiến quá trình huấn luyện thất bại hoàn toàn.

4.4 Xây dựng target#
Quy trình xây dựng target trong YOLOv5 đóng vai trò thiết yếu đối với hiệu quả huấn luyện và độ chính xác của model. Quy trình này bao gồm việc gán các box ground truth cho những ô lưới phù hợp trong bản đồ đầu ra và ghép chúng với các anchor box tương ứng.
Quy trình này gồm các bước sau:
- Tính tỷ lệ giữa kích thước box ground truth và kích thước của từng anchor template.

- Nếu tỷ lệ đã tính nằm trong ngưỡng, hãy ghép box ground truth với anchor tương ứng.

- Gán anchor đã ghép cho các ô phù hợp. Lưu ý rằng do độ lệch tâm đã được điều chỉnh, một box ground truth có thể được gán cho nhiều anchor vì phạm vi độ lệch tâm đổi từ (0, 1) thành (-0.5, 1.5), cho phép tạo thêm các phép ghép.

Nhờ đó, quy trình xây dựng target đảm bảo mỗi đối tượng ground truth được gán và ghép chính xác trong quá trình huấn luyện, giúp YOLOv5 học tác vụ phát hiện đối tượng hiệu quả hơn.
Kết luận#
YOLOv5 đánh dấu một bước tiến đáng kể trong quá trình phát triển của công nghệ phát hiện đối tượng thời gian thực. Các lựa chọn kiến trúc, chiến lược huấn luyện và cải tiến kỹ thuật của model mang lại hiệu suất và hiệu quả cao so với các phiên bản YOLO trước đó.
Các cải tiến chính trong YOLOv5 bao gồm tinh chỉnh kiến trúc như stem 6x6 Conv2d và SPPF, một loạt kỹ thuật data augmentation, các chiến lược huấn luyện như AutoAnchor và EMA, cùng những điều chỉnh trong cách tính loss và xây dựng target. Kết hợp lại, những cải tiến này nâng cao độ chính xác và hiệu quả phát hiện đối tượng, đồng thời duy trì tốc độ vốn là thế mạnh của các model YOLO.
Câu hỏi thường gặp#
Backbone CSPDarknet53 trích xuất đặc trưng, neck SPPF và PANet hợp nhất đặc trưng ở nhiều tỷ lệ, còn head kiểu YOLOv3 dự đoán box, độ hiện diện của đối tượng và lớp tại các stride 8, 16 và 32. Danh sách đầy đủ các layer có trong
models/yolov5l.yaml.SPPF nối tiếp ba phép pooling cực đại 5x5 thay vì chạy song song các phép pooling 5x5, 9x9 và 13x13. Kết quả đầu ra giống hệt về mặt toán học nhưng tốc độ nhanh hơn gấp đôi, như đoạn mã profiling ở trên cho thấy.
Độ lệch ban đầu của YOLO không thể đạt chính xác 0 hoặc 1, khiến các đối tượng nằm giữa ranh giới lưới khó dự đoán. Mở rộng sigmoid sang phạm vi (-0.5, 1.5) loại bỏ độ nhạy với lưới, còn việc bình phương
2σcho chiều rộng và chiều cao giới hạn dự đoán ở mức gấp 4 lần kích thước anchor, ngăn gradient tăng không kiểm soát như khi dùng hàm mũ không giới hạn.Mọi anchor có tỷ lệ chiều rộng và chiều cao so với box nằm trong
anchor_t(mặc định là 4.0) đều được ghép. Phạm vi độ lệch mở rộng cũng cho phép gán box vào hai ô lưới lân cận. Do đó, một đối tượng có thể tạo ra nhiều target dương, giúp tăng tốc độ hội tụ.
Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.