Học chuyển giao với các lớp bị đóng băng trong YOLOv5#
📚 Hướng dẫn này giải thích cách đóng băng các lớp YOLOv5 🚀 khi triển khai học chuyển giao. Học chuyển giao là một kỹ thuật học máy (ML) mạnh mẽ, cho phép bạn nhanh chóng huấn luyện lại model trên dữ liệu mới mà không cần huấn luyện lại toàn bộ mạng từ đầu. Bằng cách đóng băng trọng số của các lớp ban đầu và chỉ cập nhật tham số của các lớp phía sau, bạn có thể giảm đáng kể nhu cầu về tài nguyên tính toán và thời gian huấn luyện. Tuy nhiên, cách tiếp cận này có thể ảnh hưởng nhẹ đến độ chính xác cuối cùng của model.
Trước khi bắt đầu#
Trước tiên, hãy clone repository YOLOv5 và cài đặt các dependency cần thiết được liệt kê trong requirements.txt. Đảm bảo bạn có môi trường Python>=3.8.0 đã cài đặt PyTorch>=1.8. Các model pretrained và dataset cần thiết sẽ được tải tự động từ bản phát hành YOLOv5 mới nhất.
git clone https://github.com/ultralytics/yolov5 # clone repository
cd yolov5
pip install -r requirements.txt # install dependencies
Cách đóng băng lớp hoạt động#
Khi đóng băng các lớp trong mạng nơ-ron, bạn ngăn không cho các tham số của chúng (trọng số và bias) được cập nhật trong quá trình huấn luyện. Trong PyTorch, thao tác này được thực hiện bằng cách đặt thuộc tính requires_grad của tensor thuộc lớp thành False. Do đó, gradient không được tính cho các lớp này trong quá trình lan truyền ngược, giúp tiết kiệm năng lực tính toán và bộ nhớ.
Sau đây là cách YOLOv5 triển khai việc đóng băng lớp trong script huấn luyện:
# Freeze specified layers
freeze = [f"model.{x}." for x in (freeze if len(freeze) > 1 else range(freeze[0]))]  # layers to freeze
for k, v in model.named_parameters():
    v.requires_grad = True  # Ensure all parameters are initially trainable
    if any(x in k for x in freeze):
        print(f"Freezing layer: {k}")
        v.requires_grad = False  # Disable gradient calculation for frozen layers
Tìm hiểu kiến trúc model#
Hiểu cấu trúc của model YOLOv5 là yếu tố quan trọng để quyết định nên đóng băng những lớp nào. Bạn có thể kiểm tra tên của tất cả module và tham số bằng đoạn mã Python sau:
# Giả sử 'model' là instance model YOLOv5 bạn đã tải
for name, param in model.named_parameters():
    print(name)

"""
Example Output:
model.0.conv.weight
model.0.bn.weight
model.0.bn.bias
model.1.conv.weight
model.1.bn.weight
model.1.bn.bias
model.2.cv1.conv.weight
model.2.cv1.bn.weight
...
"""
Kiến trúc YOLOv5 thường gồm một backbone (các lớp 0-9 trong những cấu hình tiêu chuẩn như YOLOv5s/m/l/x) chịu trách nhiệm trích xuất đặc trưng, và một head (các lớp còn lại) thực hiện phát hiện đối tượng.
# Example YOLOv5 v6.0 backbone structure
backbone:
    # [from, number, module, args]
    - [-1, 1, Conv, [64, 6, 2, 2]]  # Layer 0: Initial convolution (P1/2 stride)
    - [-1, 1, Conv, [128, 3, 2]] # Layer 1: Downsampling convolution (P2/4 stride)
    - [-1, 3, C3, [128]]          # Layer 2: C3 module
    - [-1, 1, Conv, [256, 3, 2]] # Layer 3: Downsampling convolution (P3/8 stride)
    - [-1, 6, C3, [256]]          # Layer 4: C3 module
    - [-1, 1, Conv, [512, 3, 2]] # Layer 5: Downsampling convolution (P4/16 stride)
    - [-1, 9, C3, [512]]          # Layer 6: C3 module
    - [-1, 1, Conv, [1024, 3, 2]]# Layer 7: Downsampling convolution (P5/32 stride)
    - [-1, 3, C3, [1024]]         # Layer 8: C3 module
    - [-1, 1, SPPF, [1024, 5]]    # Layer 9: Spatial Pyramid Pooling Fast

# Example YOLOv5 v6.0 head structure
head:
    - [-1, 1, Conv, [512, 1, 1]] # Layer 10
    - [-1, 1, nn.Upsample, [None, 2, "nearest"]] # Layer 11
    - [[-1, 6], 1, Concat, [1]] # Layer 12: Concatenate with backbone P4 (from layer 6)
    - [-1, 3, C3, [512, False]] # Layer 13: C3 module
    # ... subsequent head layers for feature fusion and detection
Các tùy chọn đóng băng#
Bạn có thể kiểm soát các lớp bị đóng băng bằng đối số --freeze trong lệnh huấn luyện. Đối số này chỉ định chỉ số của module đầu tiên không bị đóng băng; trọng số của tất cả module trước chỉ số này sẽ bị đóng băng. Thay vào đó, nếu truyền nhiều chỉ số (ví dụ: --freeze 0 1 2), chỉ những module đó sẽ bị đóng băng. Dùng model.model (một nn.Sequential) để kiểm tra thứ tự module nếu bạn cần xác nhận chỉ số nào tương ứng với một block cụ thể.
Chỉ đóng băng backbone#
Để đóng băng toàn bộ backbone (các lớp từ 0 đến 9), đây là cách thường dùng khi điều chỉnh model cho các lớp đối tượng mới nhưng vẫn giữ lại khả năng trích xuất đặc trưng tổng quát đã học từ một dataset lớn như COCO:
python train.py --weights yolov5m.pt --data your_dataset.yaml --freeze 10Chiến lược này hiệu quả khi dataset mục tiêu có các đặc trưng hình ảnh cấp thấp (cạnh, kết cấu) tương tự dữ liệu huấn luyện ban đầu (ví dụ: COCO) nhưng chứa các danh mục đối tượng khác.
Đóng băng tất cả trừ các lớp phát hiện cuối#
Để đóng băng gần như toàn bộ mạng, chỉ để các lớp convolution đầu ra cuối cùng (thuộc module Detect, thường là module cuối cùng, ví dụ module 24 trong YOLOv5s) có thể huấn luyện:
python train.py --weights yolov5m.pt --data your_dataset.yaml --freeze 24Cách tiếp cận này hữu ích khi bạn chủ yếu cần điều chỉnh model cho số lượng lớp đầu ra khác trong khi vẫn giữ nguyên phần lớn đặc trưng đã học. Cách này cần ít tài nguyên tính toán nhất để tinh chỉnh.
So sánh hiệu năng#
Để minh họa tác động của việc đóng băng lớp, chúng tôi huấn luyện YOLOv5m trên dataset Pascal VOC trong 50 epoch, bắt đầu từ trọng số pretrained COCO chính thức (yolov5m.pt). Chúng tôi so sánh ba kịch bản: huấn luyện tất cả các lớp (--freeze 0), đóng băng backbone (--freeze 10) và đóng băng tất cả trừ các lớp phát hiện cuối (--freeze 24).
# Example command for training with backbone frozen
python train.py --batch 48 --weights yolov5m.pt --data voc.yaml --epochs 50 --cache --img 512 --hyp data/hyps/hyp.VOC.yaml --freeze 10
Kết quả độ chính xác#
Kết quả cho thấy việc đóng băng lớp có thể tăng tốc đáng kể quá trình huấn luyện nhưng có thể khiến mAP (độ chính xác trung bình) cuối cùng giảm nhẹ. Huấn luyện tất cả các lớp thường cho độ chính xác tốt nhất, còn đóng băng nhiều lớp hơn giúp huấn luyện nhanh hơn nhưng có thể làm giảm hiệu suất.
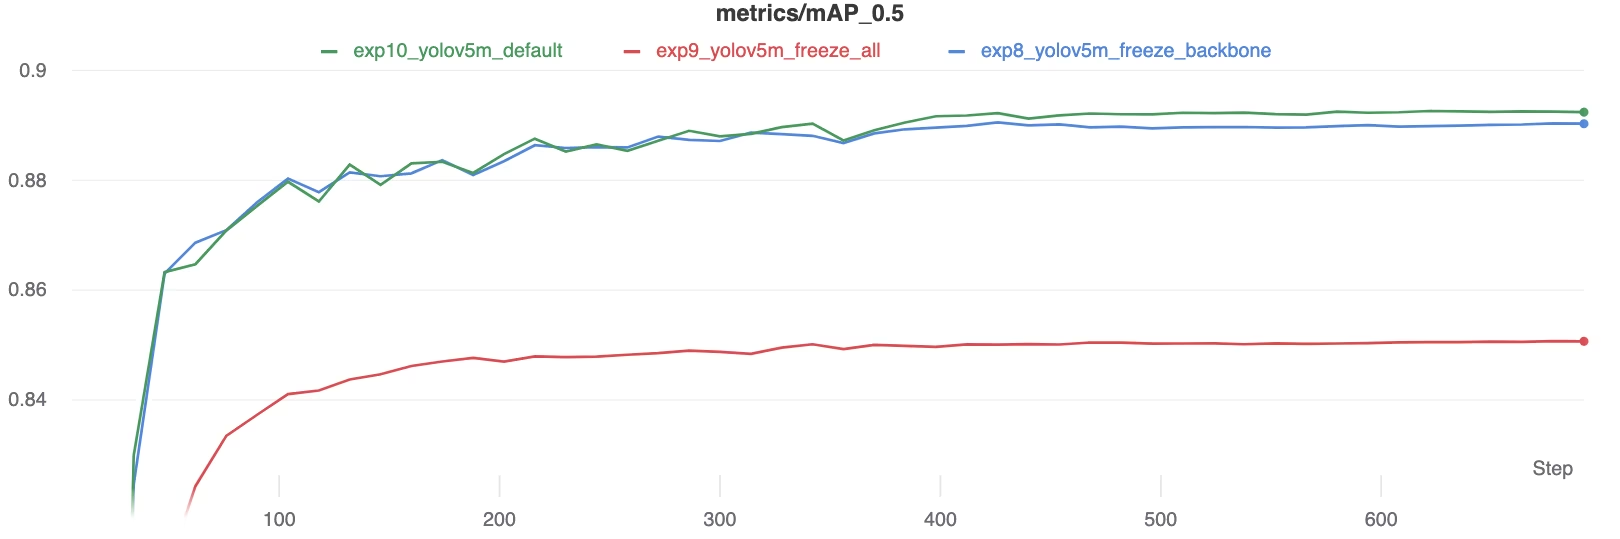 So sánh mAP50 trong quá trình huấn luyện
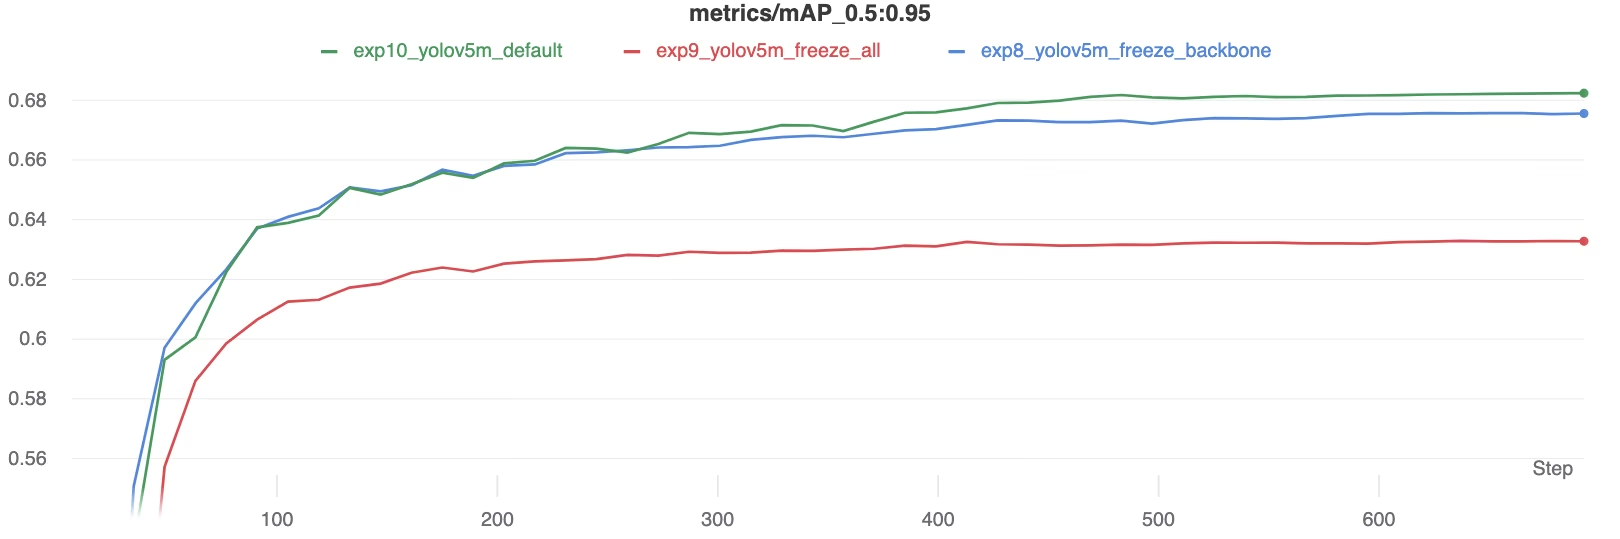 So sánh mAP50-95 trong quá trình huấn luyện
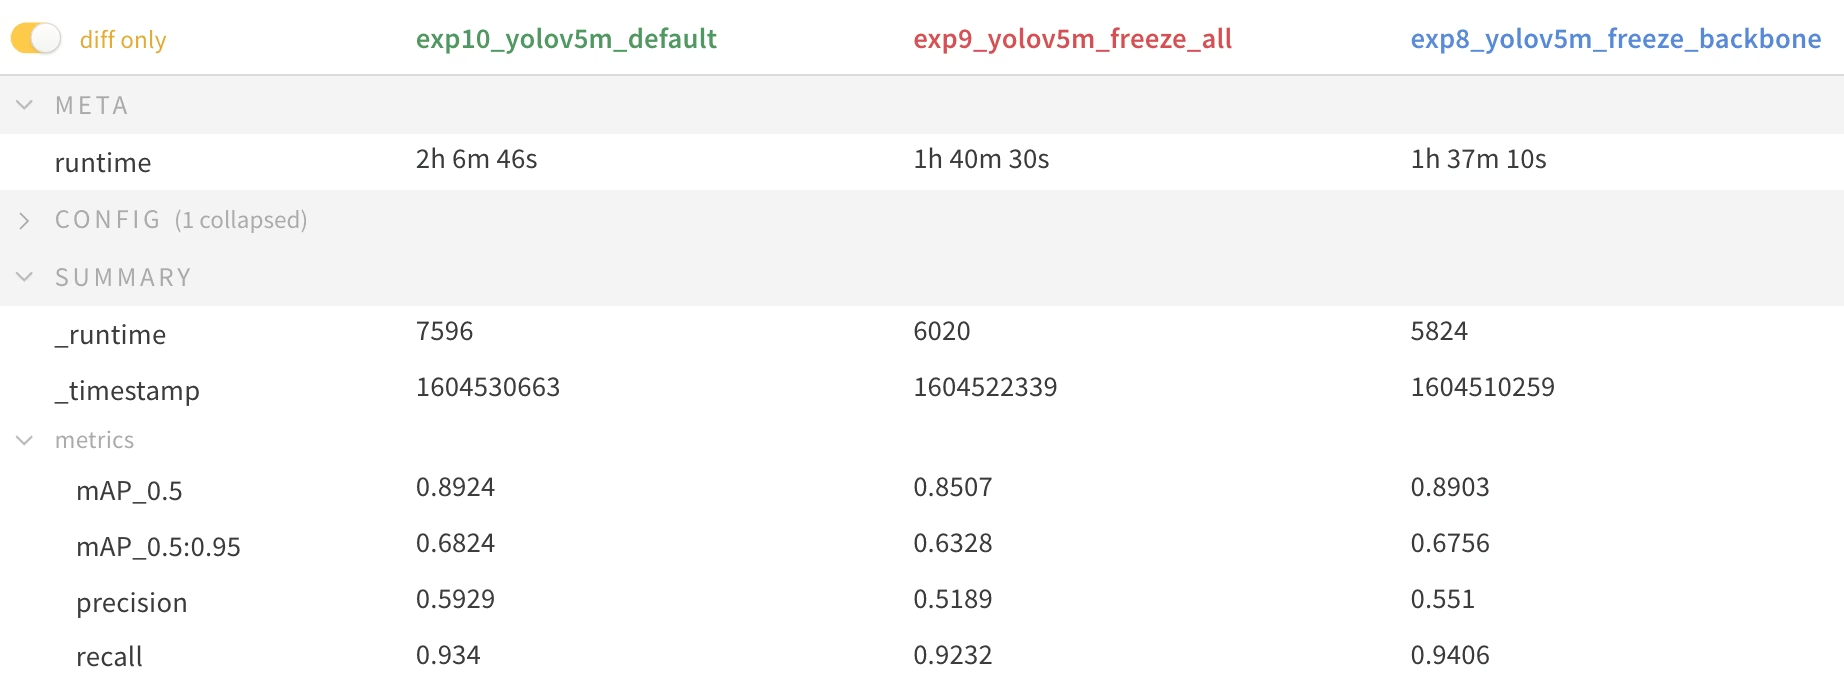 *Bảng tóm tắt các chỉ số hiệu suất*
Mức sử dụng tài nguyên#
Đóng băng nhiều lớp hơn giúp giảm đáng kể yêu cầu bộ nhớ GPU và mức sử dụng tổng thể. Nhờ đó, học chuyển giao với các lớp bị đóng băng trở thành lựa chọn hấp dẫn khi tài nguyên phần cứng hạn chế, cho phép huấn luyện model lớn hơn hoặc sử dụng kích thước ảnh lớn hơn so với những gì có thể thực hiện trong điều kiện thông thường.
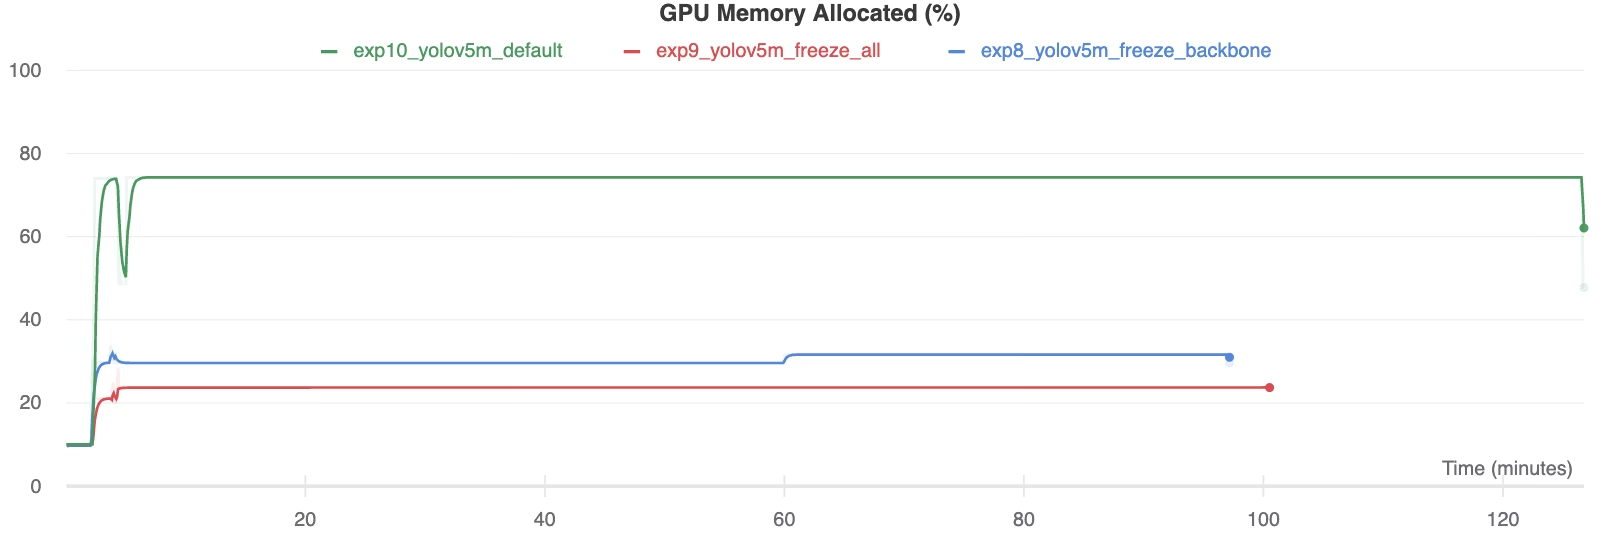 Bộ nhớ GPU đã cấp phát (%)
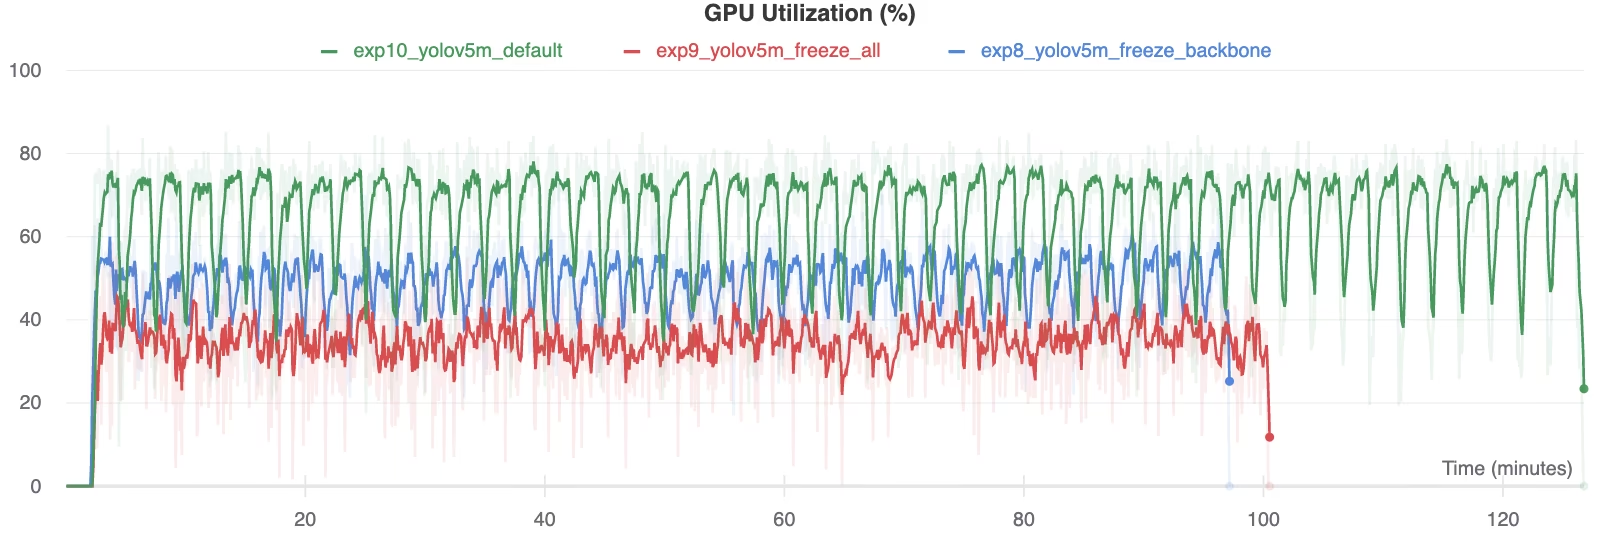 Mức sử dụng GPU (%)
Khi nào nên đóng băng lớp#
Đóng băng lớp trong quá trình học chuyển giao đặc biệt hữu ích trong một số trường hợp:
- Tài nguyên tính toán hạn chế: Khi bạn bị giới hạn về bộ nhớ GPU hoặc năng lực xử lý.
- Dataset nhỏ: Khi dataset mục tiêu nhỏ hơn đáng kể so với dataset dùng để pretrain ban đầu, việc đóng băng giúp ngăn overfitting.
- Tạo nguyên mẫu nhanh: Khi bạn cần nhanh chóng điều chỉnh một model hiện có cho tác vụ hoặc lĩnh vực mới để đánh giá ban đầu.
- Các miền đặc trưng tương tự: Khi các đặc trưng cấp thấp trong dataset mới rất giống với những đặc trưng trong dataset mà model đã được pretrain.
Tìm hiểu thêm về các khía cạnh tinh tế của học chuyển giao trong mục từ điển thuật ngữ của chúng tôi và cân nhắc tiến hóa siêu tham số để tối ưu hiệu suất.
Môi trường được hỗ trợ#
Ultralytics cung cấp nhiều môi trường sẵn dùng với các dependency thiết yếu như CUDA, CuDNN, Python và PyTorch được cài đặt sẵn.
- Notebook GPU miễn phí:


- Google Cloud: Hướng dẫn bắt đầu nhanh với GCP
- Amazon: Hướng dẫn bắt đầu nhanh với AWS
- Azure: Hướng dẫn bắt đầu nhanh với AzureML
- Docker: Hướng dẫn bắt đầu nhanh với Docker

Trạng thái dự án#

Huy hiệu này xác nhận rằng tất cả bài kiểm tra Continuous Integration (CI) của GitHub Actions YOLOv5 đều vượt qua thành công. Các bài kiểm tra CI này đánh giá nghiêm ngặt chức năng và hiệu suất của YOLOv5 trong những thao tác chính: huấn luyện, validation, suy luận, xuất model và benchmark. Các bài kiểm tra đảm bảo hệ thống hoạt động nhất quán và đáng tin cậy trên macOS, Windows và Ubuntu, tự động chạy mỗi 24 giờ và sau mỗi lần commit mã mới.
Câu hỏi thường gặp#
Tham số này đóng băng
Nmodule đầu tiên củamodel.model, giữ nguyên trọng số và không nhận gradient.--freeze 10đóng băng backbone, còn--freeze 24đóng băng mọi thứ ngoại trừ moduleDetectcuối cùng.Trong thử nghiệm VOC ở trên, huấn luyện tất cả các lớp cho mAP tốt nhất; đóng băng backbone làm giảm độ chính xác một chút, còn đóng băng tất cả trừ detection head gây giảm nhiều nhất. Đổi lại, các lượt huấn luyện với lớp bị đóng băng chạy nhanh hơn và sử dụng ít bộ nhớ GPU hơn đáng kể.
Khi hình ảnh của bạn có các đặc trưng cấp thấp tương đồng với dữ liệu pretraining, dataset nhỏ hoặc bạn cần nhanh chóng tạo baseline trên phần cứng hạn chế. Hãy huấn luyện tất cả các lớp khi dataset lớn hơn hoặc khi bạn cần thêm vài điểm mAP cuối cùng.
Có. Bắt đầu một lượt chạy mới từ
best.ptcủa model đã đóng băng, không dùng--freeze, để tinh chỉnh toàn bộ mạng; thông thường nên dùng learning rate thấp hơn.