Dataset COCO#
Dataset COCO (Các đối tượng phổ biến trong ngữ cảnh) là một dataset quy mô lớn dành cho phát hiện đối tượng, phân đoạn và tạo chú thích. Dataset này được thiết kế để khuyến khích nghiên cứu trên nhiều danh mục đối tượng khác nhau và thường được sử dụng để benchmark các model thị giác máy tính. Đây là dataset thiết yếu для các nhà nghiên cứu và developer làm việc với các tác vụ phát hiện đối tượng, phân đoạn và ước tính pose.
Watch: Ultralytics COCO Dataset Overview
Các model COCO được pretrained#
| Model | kích thước (pixel) | mAPval 50-95 | mAPval 50-95(e2e) | Tốc độ CPU ONNX (ms) | Tốc độ T4 TensorRT10 (ms) | tham số (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|
| YOLO26n | 640 | 40.9 | 40.1 | 38.9 ± 0.7 | 1.7 ± 0.0 | 2.4 | 5.5 |
| YOLO26s | 640 | 48.6 | 47.8 | 87.2 ± 0.9 | 2.5 ± 0.0 | 9.5 | 20.9 |
| YOLO26m | 640 | 53.1 | 52.5 | 220.0 ± 1.4 | 4.7 ± 0.1 | 20.4 | 68.4 |
| YOLO26l | 640 | 55.0 | 54.4 | 286.2 ± 2.0 | 6.2 ± 0.2 | 24.8 | 86.8 |
| YOLO26x | 640 | 57.5 | 56.9 | 525.8 ± 4.0 | 11.8 ± 0.2 | 55.7 | 194.4 |
Tính năng chính#
- COCO chứa 330K hình ảnh, trong đó 200K hình ảnh có annotation cho các tác vụ phát hiện đối tượng, phân đoạn và tạo chú thích.
- Dataset bao gồm 80 danh mục đối tượng, trong đó có các đối tượng phổ biến như ô tô, xe đạp và động vật, cùng các danh mục cụ thể hơn như ô, túi xách và thiết bị thể thao.
- Annotation bao gồm BBox của đối tượng, mask phân đoạn và chú thích cho mỗi hình ảnh.
- COCO cung cấp các metric đánh giá được chuẩn hóa như Độ chính xác trung bình (mAP) cho phát hiện đối tượng và Độ bao phủ trung bình (mAR) cho các tác vụ phân đoạn, giúp phù hợp để so sánh hiệu năng của các model.
Cấu trúc bộ dữ liệu#
Dataset COCO được chia thành ba tập con:
- Train2017: 118,287 hình ảnh dùng để train các model phát hiện đối tượng, phân đoạn và tạo chú thích.
- Val2017: 5,000 hình ảnh được sử dụng để validation trong quá trình train model.
- Test2017: 20,288 hình ảnh test-dev được sử dụng để benchmark các model đã train. Annotation ground truth cho tập con này không được công khai và kết quả được gửi đến server đánh giá COCO để đánh giá hiệu năng.
Ứng dụng#
Dataset COCO được sử dụng rộng rãi để train và đánh giá các model deep learning trong phát hiện đối tượng (chẳng hạn như Ultralytics YOLO, Faster R-CNN và SSD), phân đoạn instance (chẳng hạn như Mask R-CNN) và phát hiện keypoint (chẳng hạn như OpenPose). Tập hợp đa dạng các danh mục đối tượng, số lượng lớn hình ảnh có annotation và các metric đánh giá được chuẩn hóa khiến dataset này trở thành tài nguyên thiết yếu cho các nhà nghiên cứu và kỹ sư thực hành trong lĩnh vực thị giác máy tính.
Annotation được export từ các công cụ labeling theo COCO JSON tuân theo cùng cấu trúc này. Để train trên dữ liệu định dạng COCO của riêng bạn, hãy xem Chuyển đổi COCO Annotations sang YOLO.
YAML của bộ dữ liệu#
Một file YAML được sử dụng để định nghĩa cấu hình dataset. File này chứa thông tin về các path, class và thông tin liên quan khác của dataset. Đối với dataset COCO, file coco.yaml được duy trì tại https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO 2017 dataset https://cocodataset.org by Microsoft
# Documentation: https://docs.ultralytics.com/datasets/detect/coco
# Example usage: yolo train data=coco.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco ← downloads here (20.3 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco # dataset root dir
train: train2017.txt # train images (relative to 'path') 118287 images
val: val2017.txt # val images (relative to 'path') 5000 images
test: test-dev2017.txt # 20288 of 40670 images, submit via https://cocodataset.org/#detection-eval

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: |
  from pathlib import Path

  from ultralytics.utils import ASSETS_URL
  from ultralytics.utils.downloads import download

  # Download labels
  segments = True  # segment or box labels
  dir = Path(yaml["path"])  # dataset root dir
  urls = [ASSETS_URL + ("/coco2017labels-segments.zip" if segments else "/coco2017labels.zip")]  # labels
  download(urls, dir=dir.parent)

  # Download data (test2017.zip excluded: ground truth is withheld, only used for the eval-server test-dev split)
  urls = [
      "http://images.cocodataset.org/zips/train2017.zip",  # 19G, 118k images
      "http://images.cocodataset.org/zips/val2017.zip",  # 1G, 5k images
  ]
  download(urls, dir=dir / "images", threads=3)
Cách sử dụng#
Dữ liệu train và validation COCO2017 (20.3 GB) sẽ tự động được tải xuống vào lần đầu tiên bạn bắt đầu train. Để train một model YOLO26n trên COCO trong 100 epoch với kích thước hình ảnh là 640, bạn có thể sử dụng các đoạn code sau. Để xem danh sách đầy đủ các argument khả dụng, hãy tham khảo trang Training của model. Bạn cũng có thể chạy quá trình train COCO trên cloud với Ultralytics Platform.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="coco.yaml", epochs=100, imgsz=640)
Hình ảnh mẫu và annotation#
Dataset COCO chứa một tập hợp đa dạng các hình ảnh với nhiều danh mục đối tượng và các cảnh phức tạp. Dưới đây là một số ví dụ về hình ảnh trong dataset cùng với annotation tương ứng:
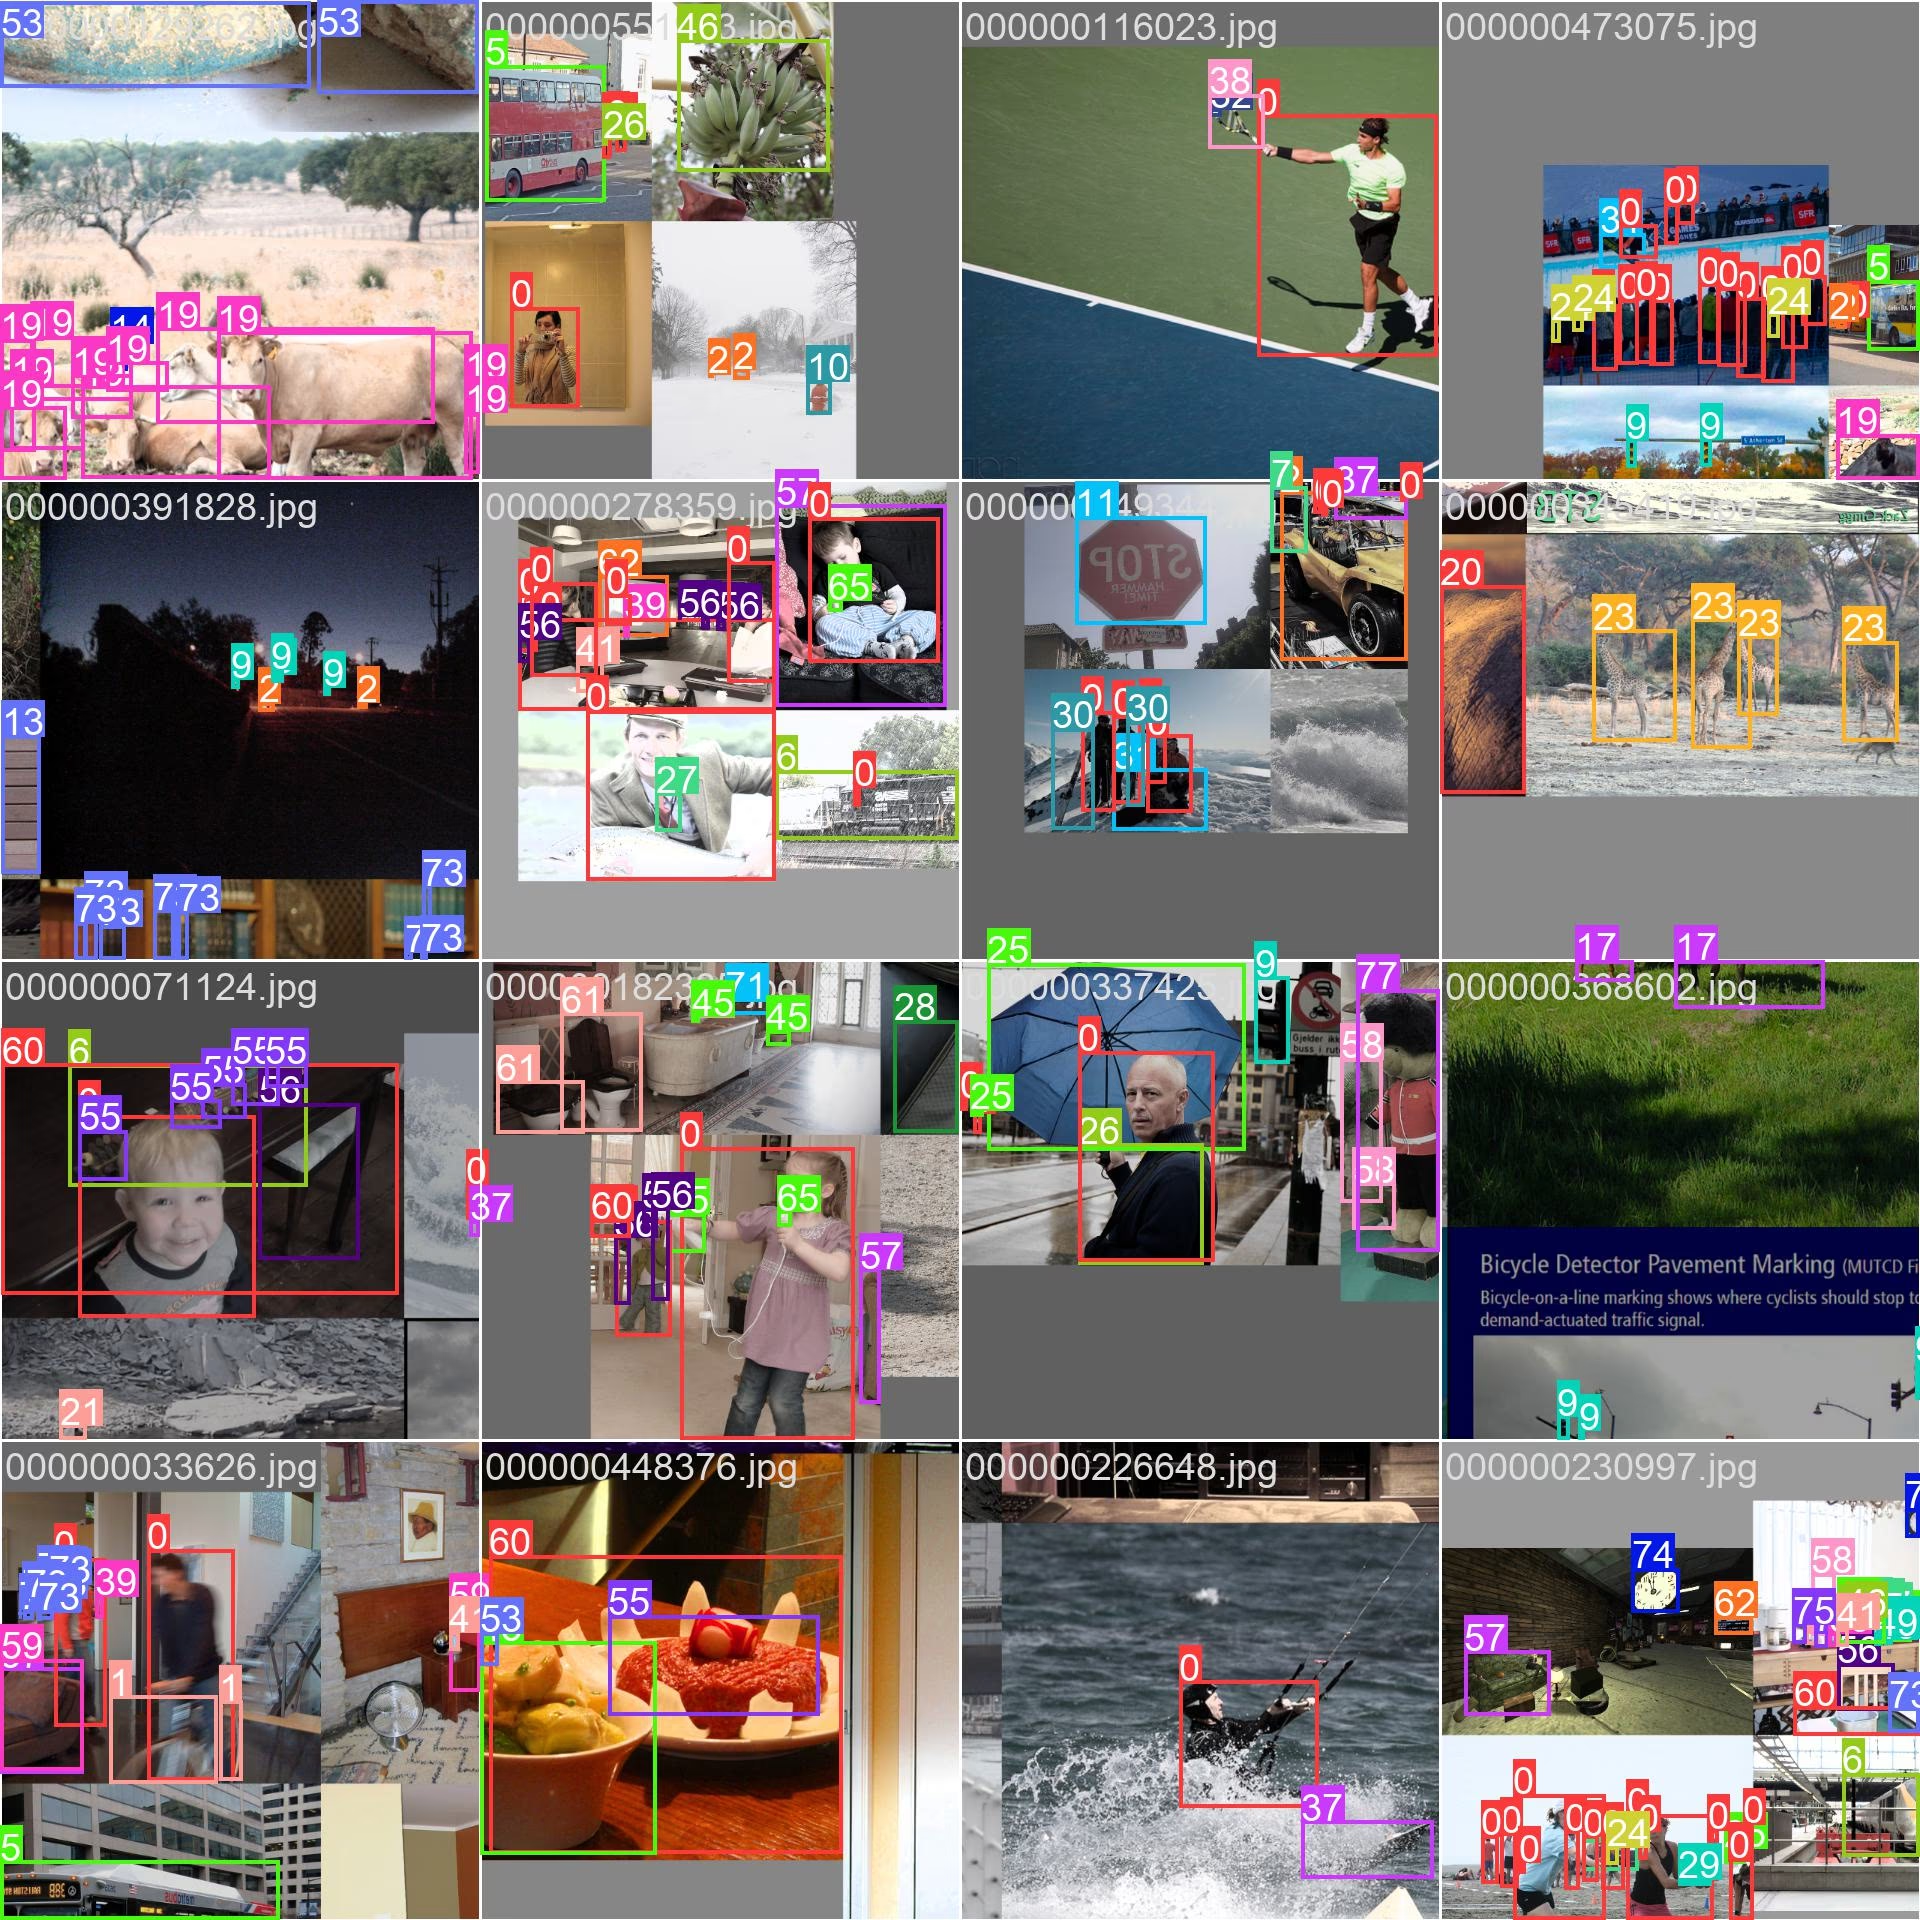
- Hình ảnh dạng mosaic: Hình ảnh này minh họa một batch train được tạo từ các hình ảnh dataset dạng mosaic. Mosaicing là một kỹ thuật được sử dụng trong quá trình train, kết hợp nhiều hình ảnh thành một hình ảnh duy nhất để tăng tính đa dạng của đối tượng và cảnh trong mỗi batch train. Điều này giúp cải thiện khả năng tổng quát hóa của model đối với các kích thước đối tượng, tỷ lệ khung hình và ngữ cảnh khác nhau.
Ví dụ này cho thấy tính đa dạng và độ phức tạp của các hình ảnh trong dataset COCO, cũng như lợi ích của việc sử dụng mosaicing trong quá trình train.
Trích dẫn và ghi nhận đóng góp#
Nếu bạn sử dụng dataset COCO trong công trình nghiên cứu hoặc phát triển của mình, vui lòng trích dẫn paper sau:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Chúng tôi xin ghi nhận COCO Consortium đã tạo và duy trì tài nguyên quý giá này cho cộng đồng thị giác máy tính. Để biết thêm thông tin về dataset COCO và các tác giả, hãy truy cập website dataset COCO.
FAQ#
Dataset COCO (Các đối tượng phổ biến trong ngữ cảnh) là một dataset quy mô lớn được sử dụng cho phát hiện đối tượng, phân đoạn và tạo chú thích. Dataset này chứa 330K hình ảnh với annotation chi tiết cho 80 danh mục đối tượng, khiến nó trở nên thiết yếu để benchmark và train các model thị giác máy tính. Các nhà nghiên cứu sử dụng COCO nhờ các danh mục đa dạng và các metric đánh giá được chuẩn hóa như Độ chính xác trung bình (mAP).
Để train một model YOLO26 bằng dataset COCO, bạn có thể sử dụng các đoạn code sau:
Ví dụ huấn luyệnfrom ultralytics import YOLO # Load a model model = YOLO("yolo26n.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="coco.yaml", epochs=100, imgsz=640)Tham khảo trang Training để biết thêm chi tiết về các argument khả dụng.
Dataset COCO bao gồm:
- 330K hình ảnh, trong đó 200K hình ảnh có annotation cho phát hiện đối tượng, phân đoạn và tạo chú thích.
- 80 danh mục đối tượng, từ các vật phổ biến như ô tô và động vật đến các vật cụ thể như túi xách và thiết bị thể thao.
- Các metric đánh giá được chuẩn hóa cho phát hiện đối tượng (mAP) và phân đoạn (Độ bao phủ trung bình, mAR).
- Kỹ thuật Mosaicing trong các batch train để tăng cường khả năng tổng quát hóa của model đối với nhiều kích thước và ngữ cảnh đối tượng khác nhau.
Các model YOLO26 được pretrained trên dataset COCO có thể được tải xuống từ các liên kết được cung cấp trong tài liệu. Ví dụ bao gồm:
Các model này khác nhau về kích thước, mAP và tốc độ inference, cung cấp các lựa chọn cho những yêu cầu khác nhau về hiệu năng và tài nguyên.
Dataset COCO được chia thành ba tập con:
- Train2017: 118,287 hình ảnh dùng để train.
- Val2017: 5,000 hình ảnh dùng để validation trong quá trình train.
- Test2017: 20,288 hình ảnh test-dev dùng để benchmark các model đã train. Kết quả cần được gửi đến server đánh giá COCO để đánh giá hiệu năng.
File cấu hình YAML của dataset có tại coco.yaml, trong đó định nghĩa các path, class và thông tin chi tiết về dataset.