Cắt tỉa model và độ thưa trong YOLOv5
Hướng dẫn này giải thích cách áp dụng pruning cho model YOLOv5 để tạo ra các mạng hiệu quả hơn mà vẫn duy trì hiệu năng.
Cắt tỉa model là gì?#
Pruning model là kỹ thuật giảm kích thước và độ phức tạp của mạng neural bằng cách loại bỏ các tham số ít quan trọng hơn (trọng số và kết nối). Quá trình này tạo ra model hiệu quả hơn với một số lợi ích:
- Giảm kích thước model để dễ triển khai hơn trên các thiết bị có tài nguyên hạn chế
- Tăng tốc độ suy luận với ảnh hưởng tối thiểu đến độ chính xác
- Giảm mức sử dụng bộ nhớ và năng lượng
- Cải thiện hiệu quả tổng thể cho các ứng dụng thời gian thực
Pruning hoạt động bằng cách xác định và loại bỏ các tham số đóng góp rất ít vào hiệu năng của model, nhờ đó tạo ra model gọn nhẹ hơn với độ chính xác tương đương.
Trước khi bắt đầu#
Clone repo và cài đặt requirements.txt trong môi trường Python>=3.8.0, bao gồm PyTorch>=1.8. Model và dataset sẽ tự động được tải xuống từ bản phát hành YOLOv5 mới nhất.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Kiểm thử hiệu suất cơ sở#
Trước khi pruning, hãy thiết lập hiệu năng cơ sở để so sánh. Lệnh này kiểm thử YOLOv5x trên COCO val2017 với kích thước ảnh 640 pixel. yolov5x.pt là model P5 lớn nhất và chính xác nhất. Các lựa chọn khác là checkpoint pretrained nhỏ hơn yolov5n.pt, yolov5s.pt, yolov5m.pt và yolov5l.pt, hoặc checkpoint của riêng bạn từ quá trình huấn luyện trên dataset tùy chỉnh, ví dụ runs/train/exp/weights/best.pt.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfĐầu ra:
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images  Instances          P          R      mAP50   mAP50-95: 100% 157/157 [01:12<00:00,  2.16it/s]
                 all       5000      36335      0.732      0.628      0.683      0.496
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- base speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.507  # <--- base mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.689
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.552
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.345
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.559
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.652
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.381
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.630
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.682
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.526
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.731
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.829
Results saved to runs/val/exp2
Áp dụng cắt tỉa cho YOLOv5x (độ thưa 30%)#
Có thể áp dụng cắt tỉa cho model bằng hàm prune() được định nghĩa trong utils/torch_utils.py. Để kiểm thử model đã cắt tỉa, chúng ta cập nhật val.py nhằm cắt tỉa YOLOv5x xuống độ thưa 0.3 (30% trọng số được đặt bằng 0):
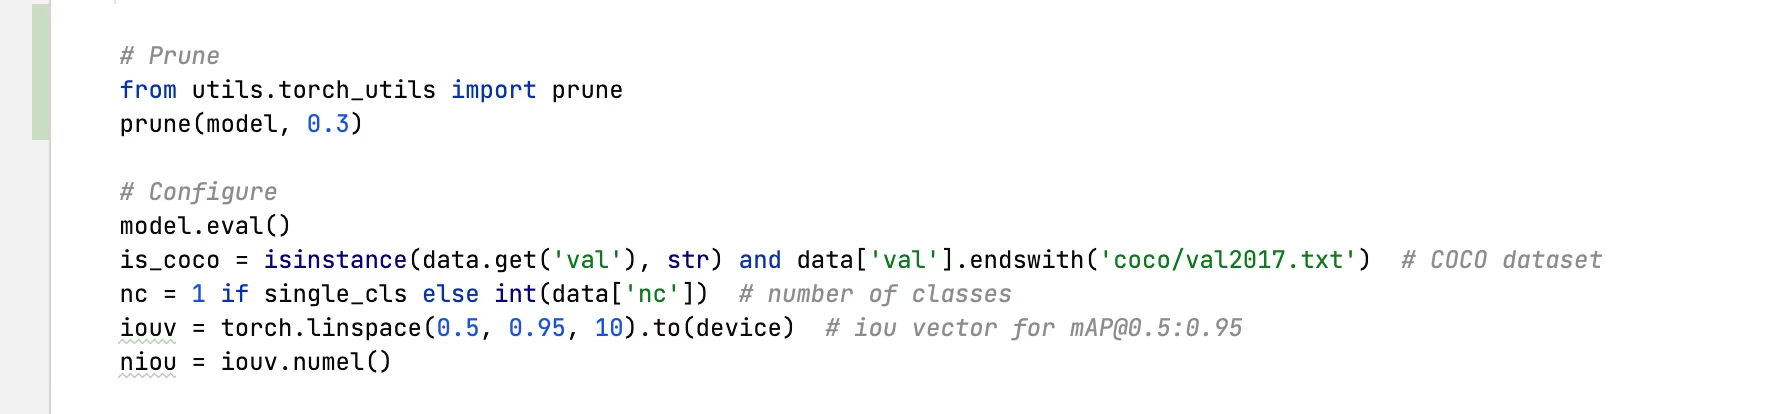
Đầu ra sau khi cắt tỉa 30%:
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
Pruning model...  0.3 global sparsity
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images  Instances          P          R      mAP50   mAP50-95: 100% 157/157 [01:11<00:00,  2.19it/s]
                 all       5000      36335      0.724      0.614      0.671      0.478
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- prune speed

Evaluating pycocotools mAP... saving runs/val/exp3/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.489  # <--- prune mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.677
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.537
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.334
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.542
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.635
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.370
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.612
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.664
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.496
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.722
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.803
Results saved to runs/val/exp3
Phân tích kết quả#
Từ kết quả, có thể nhận thấy:
- Đạt độ thưa 30%: 30% tham số trọng số của model trong các lớp
nn.Conv2dhiện được đặt bằng 0 - Thời gian suy luận không đổi: Dù đã cắt tỉa, tốc độ xử lý về cơ bản vẫn giữ nguyên
- Ảnh hưởng tối thiểu đến hiệu suất: mAP giảm nhẹ từ 0.507 xuống 0.489 (chỉ giảm 3.6%)
- Kích thước model không đổi: Trọng số được đặt bằng 0 vẫn được lưu ở dạng dense, vì vậy kích thước file chỉ giảm khi dùng định dạng hỗ trợ tensor thưa hoặc nén
Điều này cho thấy có thể loại bỏ 30% trọng số convolution mà chỉ ảnh hưởng nhỏ đến độ chính xác. Để biến độ thưa đó thành inference nhanh hơn hoặc file nhỏ hơn, cần runtime nhận biết độ thưa, pruning có cấu trúc hoặc nén.
Fine-tune model đã cắt tỉa#
Để đạt kết quả tốt nhất, nên fine-tune model sau khi cắt tỉa để khôi phục độ chính xác. Có thể thực hiện bằng cách:
- Áp dụng cắt tỉa với mức độ thưa mong muốn
- Huấn luyện model đã pruning trong vài epoch với learning rate thấp hơn
- Đánh giá model đã cắt tỉa và fine-tune so với model cơ sở
Quy trình này giúp các tham số còn lại thích nghi để bù đắp cho những kết nối đã bị loại bỏ, thường khôi phục được phần lớn hoặc toàn bộ độ chính xác ban đầu.
Môi trường được hỗ trợ#
Ultralytics cung cấp nhiều môi trường sẵn sàng sử dụng, mỗi môi trường đã cài đặt trước các dependency thiết yếu như CUDA, cuDNN, Python và PyTorch, giúp bạn nhanh chóng bắt đầu dự án.
- Notebook GPU miễn phí:


- Google Cloud: Hướng dẫn bắt đầu nhanh với GCP
- Amazon: Hướng dẫn bắt đầu nhanh với AWS
- Azure: Hướng dẫn bắt đầu nhanh với AzureML
- Docker: Hướng dẫn bắt đầu nhanh với Docker

Trạng thái dự án#

Huy hiệu này cho biết tất cả bài kiểm thử Continuous Integration (CI) của GitHub Actions cho YOLOv5 đều đã chạy thành công. Các bài kiểm thử CI này kiểm tra nghiêm ngặt chức năng và hiệu năng của YOLOv5 trên nhiều khía cạnh chính: huấn luyện, validation, inference, export và benchmark. Các bài kiểm thử đảm bảo hoạt động nhất quán và đáng tin cậy trên macOS, Windows và Ubuntu; chúng được thực hiện mỗi 24 giờ và sau mỗi commit mới.
Câu hỏi thường gặp#
Cắt tỉa không cấu trúc đặt trọng số về 0 nhưng giữ nguyên hình dạng tensor, vì vậy các kernel PyTorch dense vẫn thực hiện cùng lượng phép tính. Muốn tăng tốc cần runtime nhận biết độ thưa như DeepSparse hoặc cắt tỉa có cấu trúc để loại bỏ toàn bộ channel.
Gọi helper từ
utils/torch_utils.pytrước khi validation hoặc export:from utils.torch_utils import prune prune(model, amount=0.3) # Độ thưa toàn cục 30% trên trọng số nn.Conv2dBắt đầu ở mức 0.3 và đo mAP. YOLOv5x giảm khoảng 3.6% mAP ở độ thưa 30% khi chưa fine-tune; mức độ thưa cao hơn thường cần huấn luyện lại trong vài epoch với learning rate thấp để khôi phục độ chính xác.
Có. Trọng số được đặt bằng 0 vẫn được lưu như các trọng số khác, vì vậy
export.pyhoạt động không đổi. Kích thước file chỉ giảm nếu định dạng đích hoặc runtime nén tensor thưa.


Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.