Huấn luyện YOLOv5 trên dữ liệu tùy chỉnh#
📚 Hướng dẫn này giải thích cách huấn luyện dataset tùy chỉnh của riêng bạn bằng model YOLOv5 🚀. Huấn luyện model tùy chỉnh là bước cơ bản để điều chỉnh các giải pháp thị giác máy tính cho những ứng dụng thực tế cụ thể, vượt ra ngoài phạm vi phát hiện đối tượng tổng quát.
Trước khi bắt đầu#
Trước tiên, hãy đảm bảo bạn đã thiết lập môi trường cần thiết. Sao chép repository YOLOv5 và cài đặt các dependency cần thiết từ requirements.txt. Cần có môi trường Python>=3.8.0 cùng PyTorch>=1.8. Model và dataset sẽ tự động được tải xuống từ bản phát hành YOLOv5 mới nhất nếu chưa có trên máy.
git clone https://github.com/ultralytics/yolov5 # Clone the repository
cd yolov5
pip install -r requirements.txt # Install dependencies
Huấn luyện trên dữ liệu tùy chỉnh#
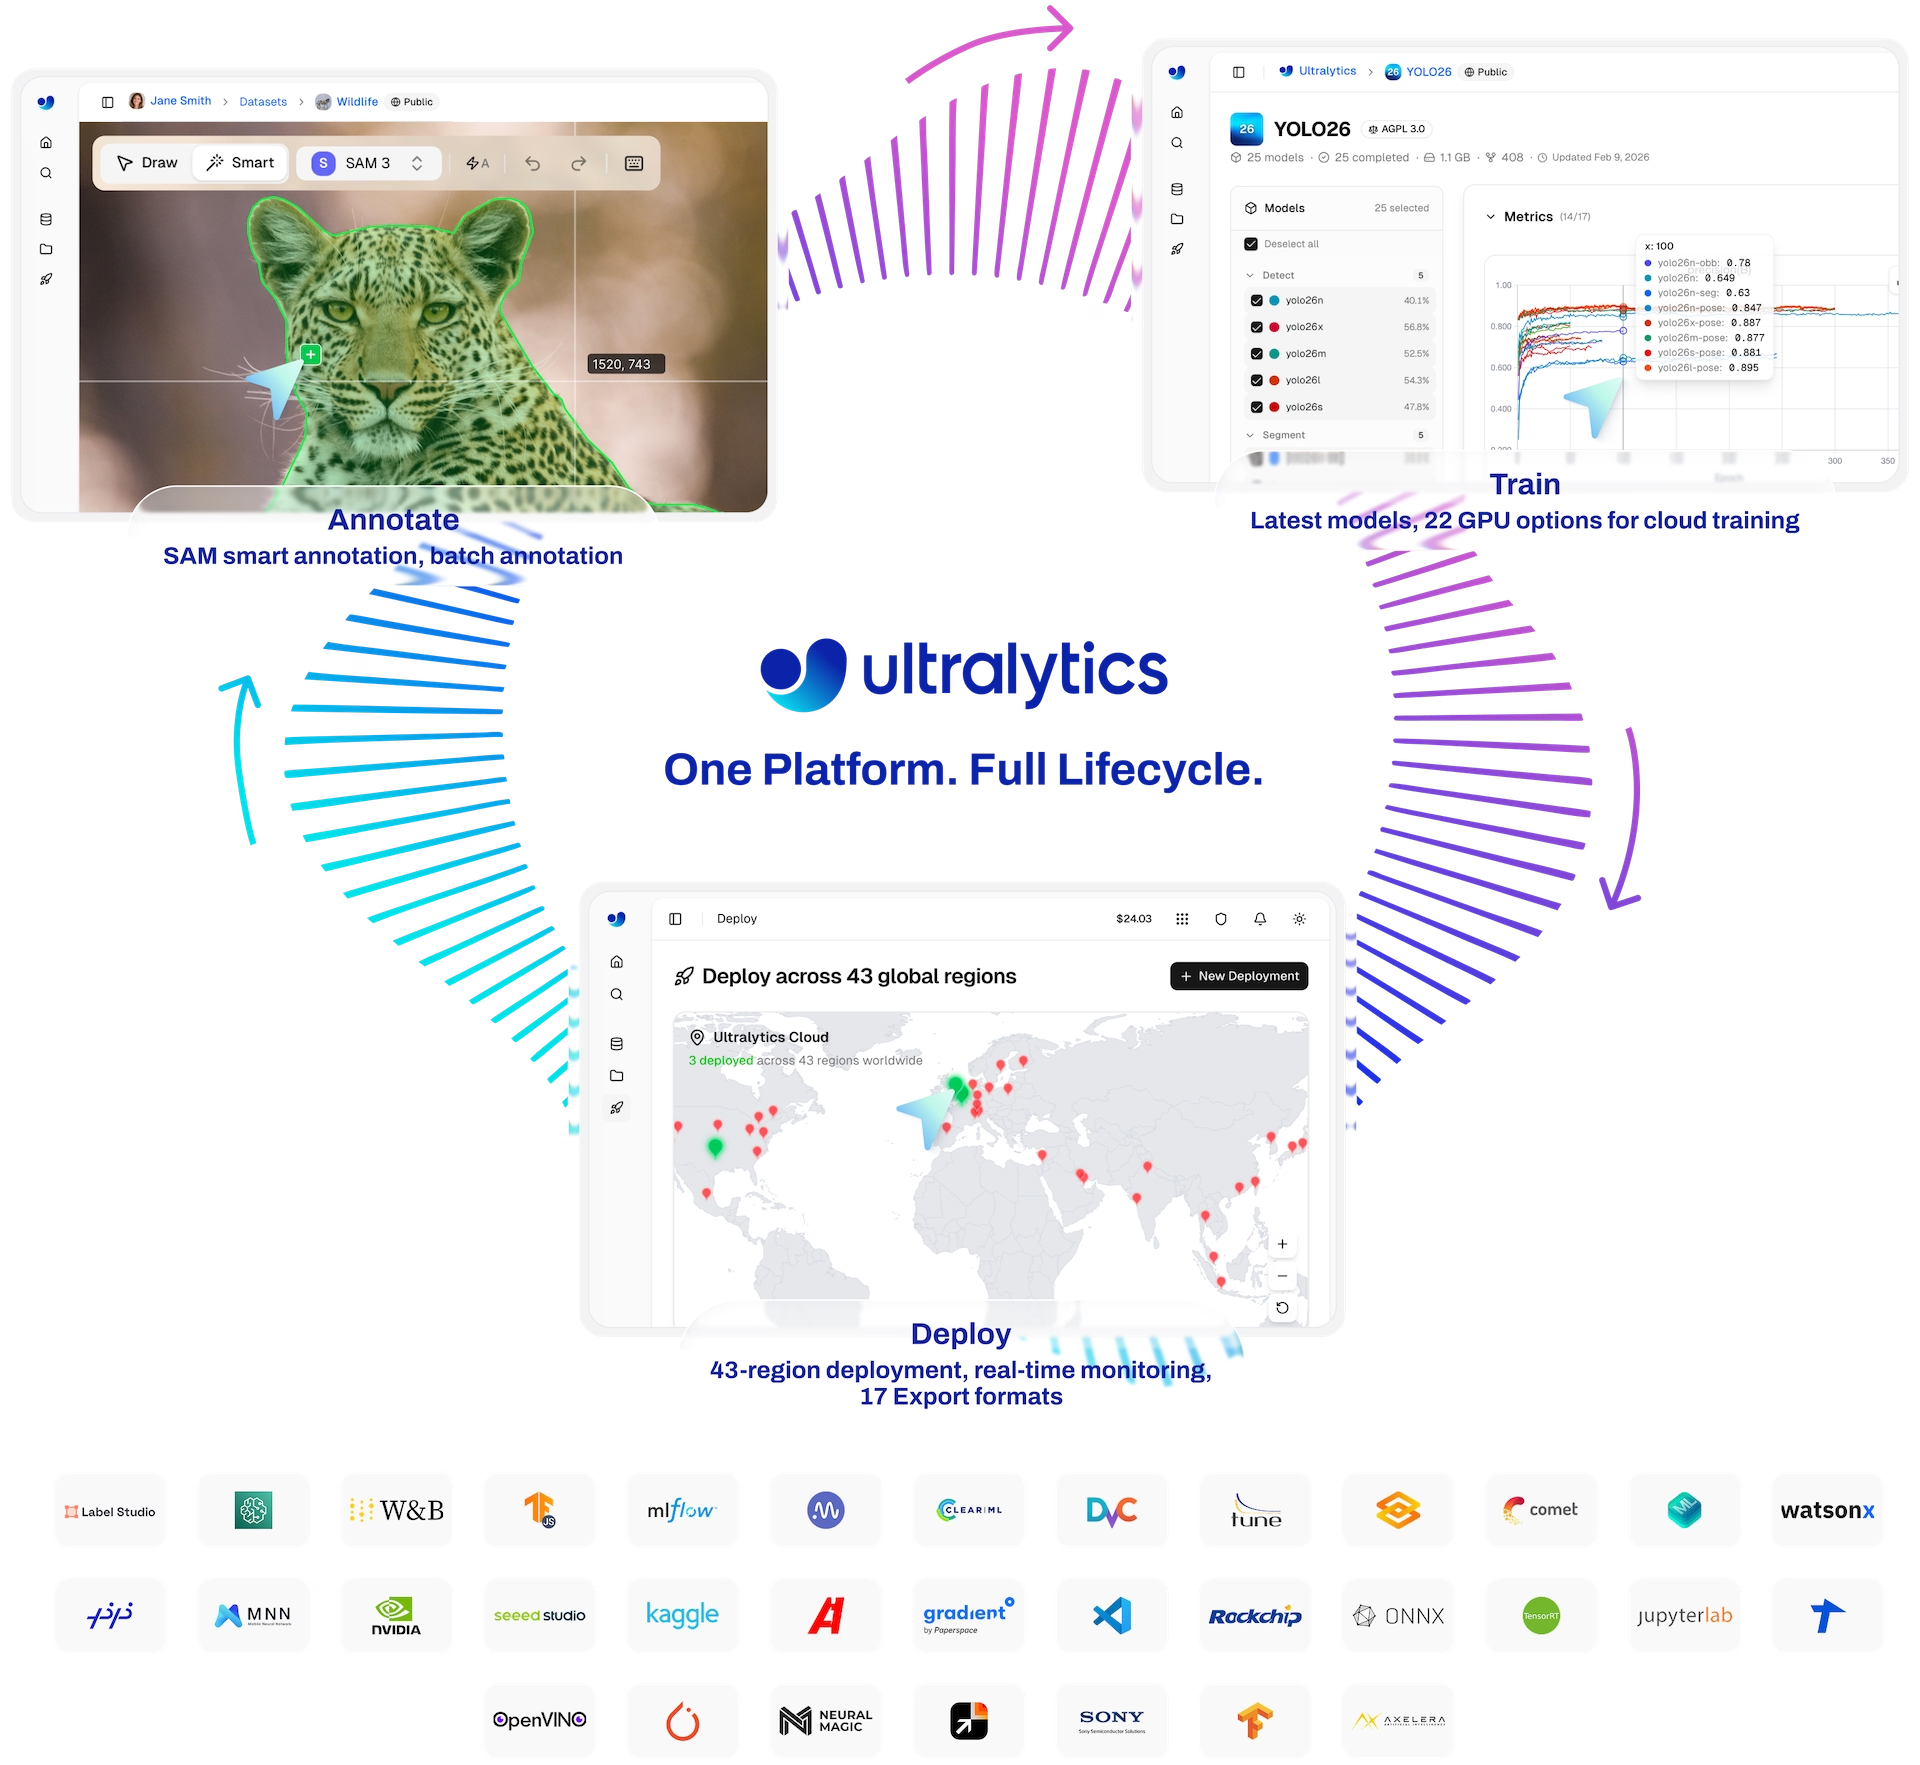
Phát triển model phát hiện đối tượng tùy chỉnh là một quy trình lặp:
- Thu thập và sắp xếp hình ảnh: Thu thập hình ảnh phù hợp với tác vụ cụ thể của bạn. Dữ liệu đa dạng, chất lượng cao là yếu tố then chốt. Xem hướng dẫn Thu thập và gán nhãn dữ liệu của chúng tôi.
- Gán nhãn đối tượng: Gán nhãn chính xác các đối tượng cần quan tâm trong hình ảnh.
- Huấn luyện model: Dùng dữ liệu đã gán nhãn để huấn luyện model YOLOv5. Tận dụng transfer learning bằng cách bắt đầu từ trọng số pretrained.
- Triển khai và dự đoán: Sử dụng model đã huấn luyện để inference trên dữ liệu mới chưa từng thấy.
- Thu thập trường hợp biên: Xác định các tình huống model hoạt động kém (trường hợp biên) và bổ sung dữ liệu tương tự vào dataset để cải thiện độ vững chắc. Lặp lại chu trình.
Nền tảng Ultralytics cung cấp giải pháp không cần viết mã, tinh gọn cho toàn bộ chu trình vận hành học máy (MLOps), bao gồm quản lý dataset, huấn luyện model và triển khai.
Ultralytics cung cấp hai tùy chọn cấp phép để đáp ứng nhiều tình huống sử dụng khác nhau:
- Giấy phép AGPL-3.0: Giấy phép mã nguồn mở được OSI phê duyệt này phù hợp với sinh viên, nhà nghiên cứu và những người đam mê cộng tác mở, chia sẻ kiến thức. Giấy phép yêu cầu các sản phẩm phái sinh phải được chia sẻ theo cùng giấy phép. Xem tệp LICENSE để biết đầy đủ chi tiết.
- Giấy phép Enterprise: Dành cho mục đích phát triển và production, giấy phép này cho phép tích hợp liền mạch phần mềm và model AI của Ultralytics vào sản phẩm, dịch vụ doanh nghiệp, bao gồm công cụ nội bộ, workflow tự động và triển khai production, đồng thời không phải tuân theo các yêu cầu nguồn mở của AGPL-3.0. Để bắt đầu, vui lòng liên hệ với chúng tôi qua Cấp phép Ultralytics.
Tìm hiểu thêm về các tùy chọn cấp phép của chúng tôi trên trang Cấp phép Ultralytics.
Cần chuẩn bị dataset trước khi bắt đầu huấn luyện.
1. Tạo dataset#
Model YOLOv5 cần dữ liệu đã gán nhãn để học các đặc điểm hình ảnh của từng lớp đối tượng. Sắp xếp dataset chính xác là điều then chốt.
1.1 Tạo dataset.yaml#
Tệp cấu hình dataset (ví dụ: coco128.yaml) mô tả cấu trúc dataset, tên lớp và đường dẫn đến các thư mục hình ảnh. COCO128 là một dataset mẫu nhỏ, gồm 128 hình ảnh đầu tiên từ dataset COCO quy mô lớn. Dataset này hữu ích để kiểm tra nhanh pipeline huấn luyện và chẩn đoán các vấn đề tiềm ẩn như overfitting.
Cấu trúc tệp dataset.yaml bao gồm:
path: Thư mục gốc chứa dataset.train,val,test: Đường dẫn tương đối từpathđến các thư mục chứa hình ảnh hoặc tệp văn bản liệt kê đường dẫn hình ảnh cho tập huấn luyện, xác thực và kiểm thử.names: Từ điển ánh xạ chỉ số lớp (bắt đầu từ 0) với tên lớp tương ứng.
Khi chạy huấn luyện từ thư mục gốc repository YOLOv5, bạn có thể đặt path thành đường dẫn thư mục tuyệt đối (ví dụ: /home/user/datasets/coco128) hoặc đường dẫn tương đối như ../datasets/coco128.
Dưới đây là cấu trúc của coco128.yaml (xem trên GitHub):
# Dataset root directory relative to the yolov5 directory
path: ../datasets/coco128

# Train/val/test sets: specify directories, *.txt files, or lists
train: images/train2017 # 128 images for training
val: images/train2017 # 128 images for validation
test: # Optional path to test images

# Classes (example using 80 COCO classes)
names:
    0: person
    1: bicycle
    2: car
    # ... (remaining COCO classes)
    77: teddy bear
    78: hair drier
    79: toothbrush
1.2 Tận dụng model để tự động gán nhãn#
Gán nhãn thủ công là cách làm phổ biến nhưng tốn thời gian. Foundation model có thể tự động hóa hoặc bán tự động hóa việc chú giải, giúp tăng tốc quá trình tạo dataset. Một số model có thể hỗ trợ tạo nhãn:
- Google Gemini: Các model đa phương thức lớn như Gemini có khả năng hiểu hình ảnh mạnh mẽ. Có thể đưa prompt để model xác định và định vị đối tượng trong hình ảnh, tạo bounding box hoặc mô tả có thể chuyển thành nhãn định dạng YOLO. Hãy khám phá tiềm năng của model này trong notebook hướng dẫn được cung cấp.
- SAM2 (Mô hình phân đoạn mọi thứ 2): Các foundation model tập trung vào phân đoạn như SAM2 có thể xác định và phân định đối tượng với độ chính xác cao. Dù chủ yếu phục vụ phân đoạn, các mask tạo ra thường có thể chuyển thành chú thích bounding box phù hợp cho tác vụ phát hiện đối tượng.
- YOLOWorld: Model này cung cấp khả năng phát hiện với từ vựng mở. Bạn có thể nhập mô tả văn bản về đối tượng cần tìm, và YOLOWorld có thể định vị chúng trong hình ảnh mà không cần huấn luyện trước trên các lớp cụ thể đó. Có thể dùng model này làm điểm khởi đầu để tạo nhãn ban đầu, sau đó tinh chỉnh các nhãn này.
Sử dụng các model này có thể tạo bước “gán nhãn sơ bộ”, giảm công sức cần thiết cho việc gán nhãn thủ công. Tuy nhiên, điều quan trọng là phải xem xét và tinh chỉnh nhãn được tạo tự động để đảm bảo độ chính xác và nhất quán, vì chất lượng nhãn ảnh hưởng trực tiếp đến hiệu suất của model YOLOv5 đã huấn luyện. Sau khi tạo (và có thể tinh chỉnh) nhãn, hãy đảm bảo nhãn tuân thủ định dạng YOLO: mỗi hình ảnh có một tệp *.txt, trong đó mỗi dòng biểu diễn một đối tượng theo dạng class_index x_center y_center width height (tọa độ chuẩn hóa, chỉ số lớp bắt đầu từ 0). Nếu hình ảnh không có đối tượng cần quan tâm thì không cần tệp *.txt tương ứng.
Quy cách tệp *.txt theo định dạng YOLO rất cụ thể:
- Mỗi đối tượng có một dòng bounding box.
- Mỗi dòng phải chứa:
class_index x_center y_center width height. - Tọa độ phải được chuẩn hóa về khoảng từ 0 đến 1. Để làm vậy, chia giá trị pixel của
x_centervàwidthcho tổng chiều rộng của hình ảnh, đồng thời chiay_centervàheightcho tổng chiều cao của hình ảnh. - Chỉ số lớp bắt đầu từ 0 (tức là lớp đầu tiên được biểu diễn bằng
0, lớp thứ hai bằng1, v.v.).
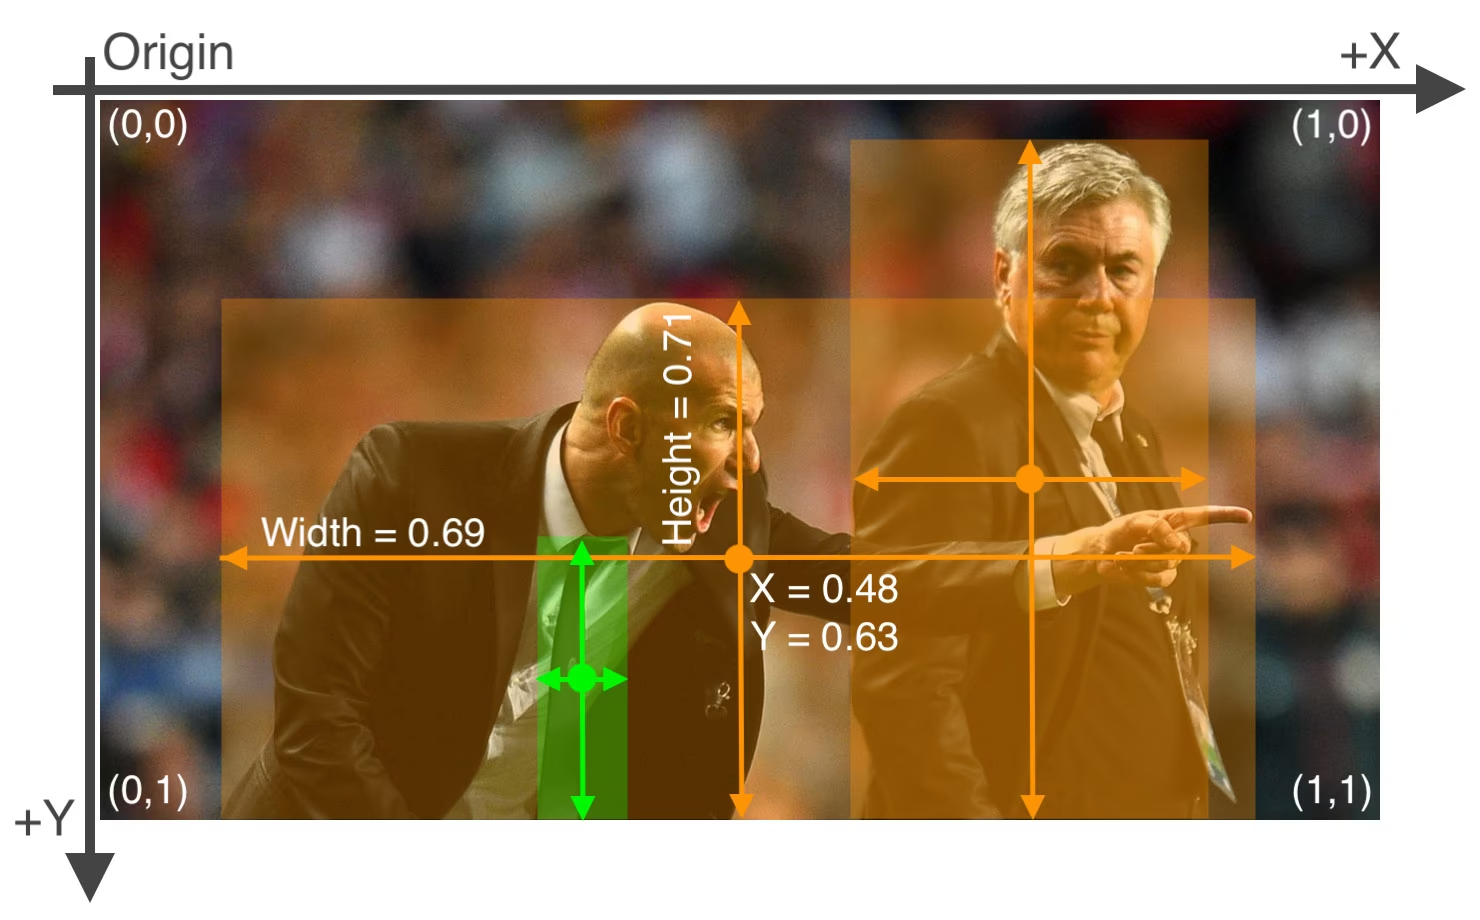
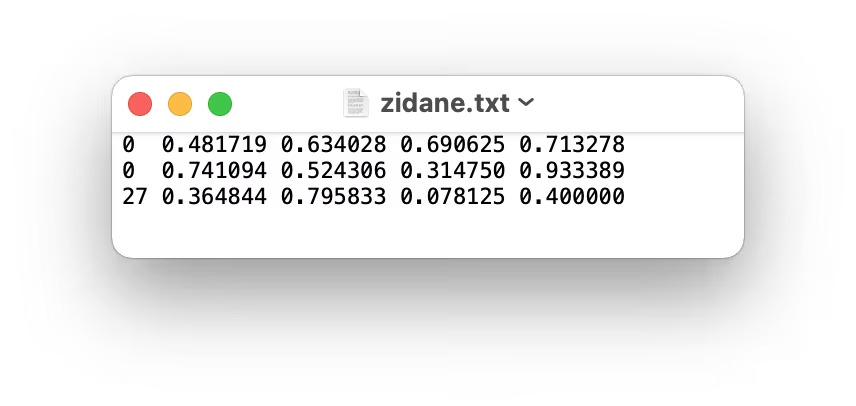
Tệp nhãn tương ứng với hình ảnh ở trên sẽ có dạng như sau, chứa hai đối tượng 'person' (chỉ số lớp 0) và một đối tượng 'tie' (chỉ số lớp 27):
1.3 Sắp xếp thư mục#
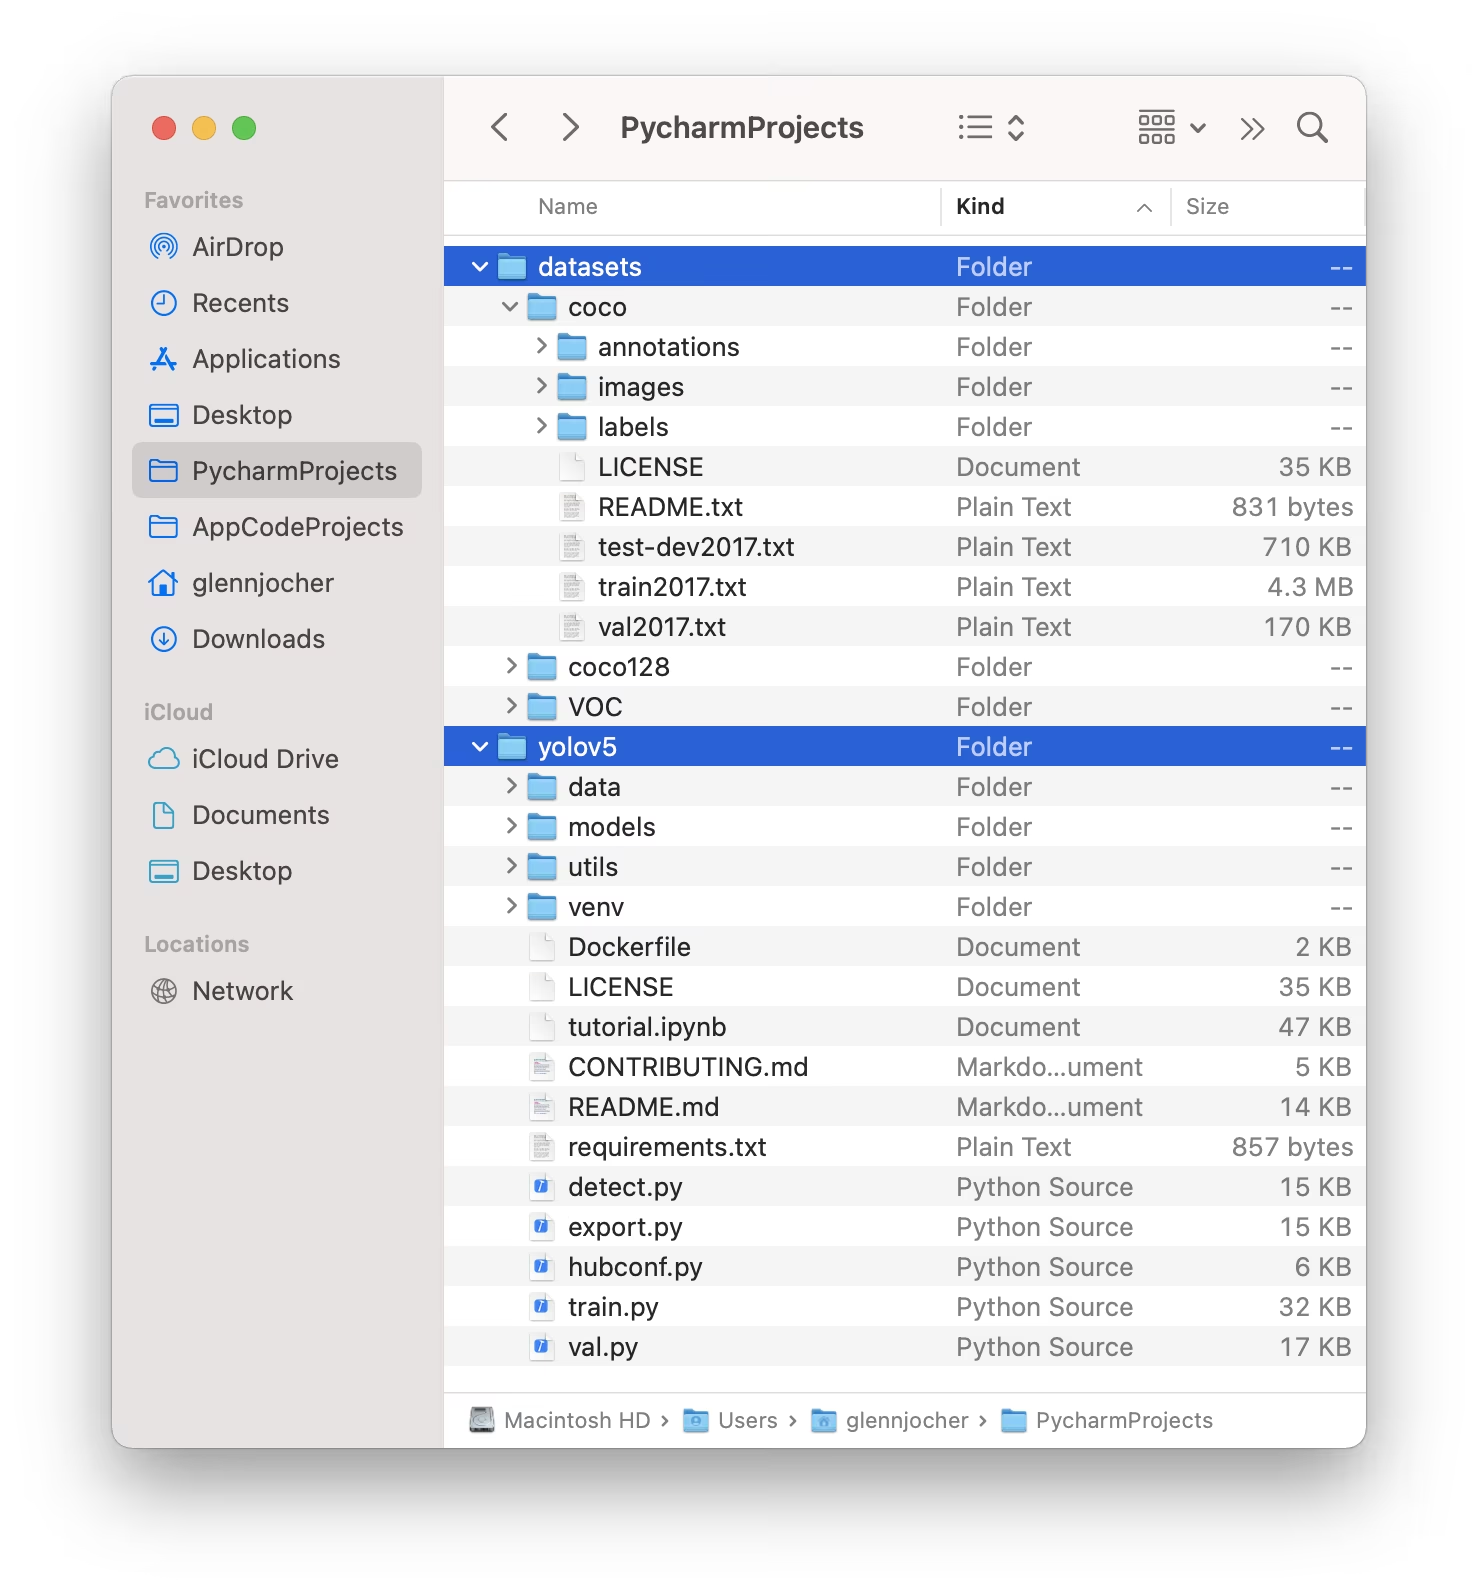
Sắp xếp thư mục dataset như minh họa bên dưới. Theo mặc định, YOLOv5 dự kiến thư mục dataset (ví dụ: /coco128) nằm trong thư mục /datasets, cùng cấp với thư mục repository /yolov5.
YOLOv5 tự động tìm nhãn cho từng hình ảnh bằng cách thay thế lần xuất hiện cuối cùng của /images/ trong đường dẫn hình ảnh bằng /labels/. Ví dụ:
../datasets/coco128/images/im0.jpg # Path to the image file
../datasets/coco128/labels/im0.txt # Path to the corresponding label file
Cấu trúc thư mục được đề xuất như sau:
/datasets/
└── coco128/  # Dataset root
    ├── images/
    │   ├── train2017/  # Training images
    │   │   ├── 000000000009.jpg
    │   │   └── ...
    │   └── val2017/    # Validation images (optional if using same set for train/val)
    │       └── ...
    └── labels/
        ├── train2017/  # Training labels
        │   ├── 000000000009.txt
        │   └── ...
        └── val2017/    # Validation labels (optional if using same set for train/val)
            └── ...
2. Chọn model#
Chọn model pretrained để bắt đầu quá trình huấn luyện. Bắt đầu với trọng số pretrained giúp tăng tốc đáng kể quá trình học và cải thiện hiệu suất so với huấn luyện từ đầu. YOLOv5 cung cấp nhiều kích thước model khác nhau, mỗi kích thước có sự cân bằng riêng giữa tốc độ và độ chính xác. Ví dụ, YOLOv5s là model nhỏ thứ hai và nhanh thứ hai, phù hợp với môi trường hạn chế tài nguyên. Tham khảo bảng README để xem so sánh chi tiết tất cả model hiện có.

3. Huấn luyện#
Bắt đầu huấn luyện model bằng script train.py. Các tham số thiết yếu gồm:
--img: Xác định kích thước hình ảnh đầu vào (ví dụ:--img 640). Kích thước lớn hơn thường cho độ chính xác cao hơn nhưng cần nhiều bộ nhớ GPU hơn.--batch: Xác định batch size (ví dụ:--batch 16). Hãy chọn kích thước lớn nhất mà GPU của bạn có thể xử lý.--epochs: Chỉ định tổng số epoch huấn luyện (ví dụ:--epochs 100). Một epoch là một lượt chạy đầy đủ qua toàn bộ dataset huấn luyện.--data: Đường dẫn đến tệpdataset.yamlcủa bạn (ví dụ:--data coco128.yaml).--weights: Đường dẫn đến tệp trọng số ban đầu. Nên dùng trọng số pretrained (ví dụ:--weights yolov5s.pt) để hội tụ nhanh hơn và đạt kết quả tốt hơn. Để huấn luyện từ đầu (không khuyến nghị trừ khi bạn có dataset rất lớn và nhu cầu cụ thể), hãy dùng--weights '' --cfg yolov5s.yaml.
Trọng số pretrained sẽ tự động được tải xuống từ bản phát hành YOLOv5 mới nhất nếu chưa có trên máy.
# Example: Train YOLOv5s on the COCO128 dataset for 3 epochs
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt💡 Dùng --cache ram hoặc --cache disk để lưu ảnh dataset vào RAM hoặc ổ đĩa cục bộ. Cách này giúp tăng tốc đáng kể quá trình huấn luyện, đặc biệt khi I/O (đầu vào/đầu ra) của dataset là nút thắt cổ chai. Lưu ý rằng cần có dung lượng RAM hoặc ổ đĩa đáng kể.
💡 Luôn huấn luyện bằng dataset được lưu trữ cục bộ. Truy cập dữ liệu từ ổ đĩa mạng (như Google Drive) hoặc bộ nhớ từ xa có thể chậm hơn đáng kể và làm giảm hiệu suất huấn luyện. Sao chép dataset vào SSD cục bộ thường là cách làm tốt nhất.
Tất cả đầu ra huấn luyện, bao gồm trọng số và log, được lưu trong thư mục runs/train/. Mỗi phiên huấn luyện tạo một thư mục con mới (ví dụ: runs/train/exp, runs/train/exp2, v.v.). Để có trải nghiệm tương tác, thực hành trực tiếp, hãy xem phần huấn luyện trong các notebook hướng dẫn chính thức của chúng tôi: 

4. Trực quan hóa#
YOLOv5 tích hợp liền mạch với nhiều công cụ để trực quan hóa tiến trình huấn luyện, đánh giá kết quả và theo dõi hiệu suất theo thời gian thực.
Ghi log và trực quan hóa với Comet#
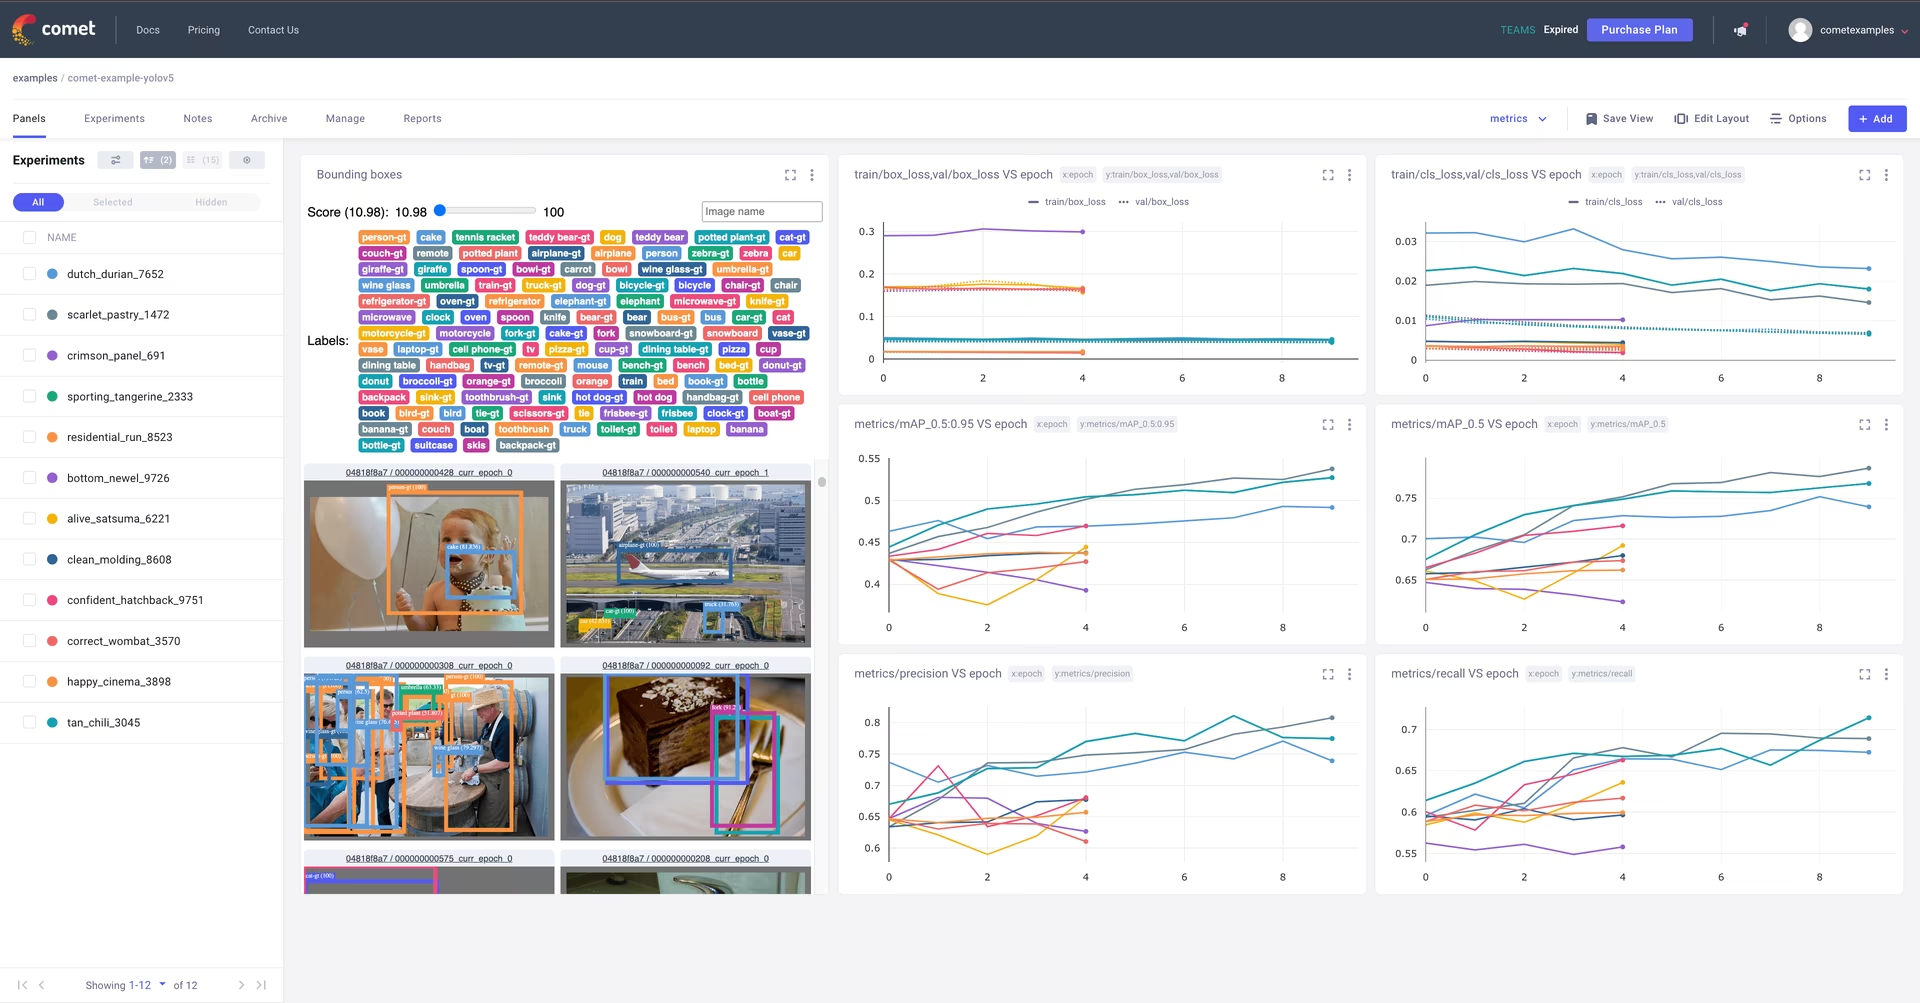
Comet được tích hợp đầy đủ để theo dõi thí nghiệm toàn diện. Trực quan hóa metric trực tiếp, lưu siêu tham số, quản lý dataset và checkpoint model, đồng thời phân tích dự đoán của model bằng Comet Custom Panels tương tác.
Bắt đầu rất đơn giản:
pip install comet_ml                                                          # 1. Install Comet library
export COMET_API_KEY=YOUR_API_KEY_HERE                                        # 2. Set your Comet API key (create a free account at Comet.ml)
python train.py --img 640 --epochs 3 --data coco128.yaml --weights yolov5s.pt # 3. Train your model - Comet automatically logs everything!
Tìm hiểu sâu hơn về các tính năng được hỗ trợ trong Hướng dẫn tích hợp Comet của chúng tôi. Tìm hiểu thêm về khả năng của Comet trong tài liệu chính thức. Dùng Comet Colab Notebook để xem bản demo trực tiếp:
Ghi log và tự động hóa với ClearML#
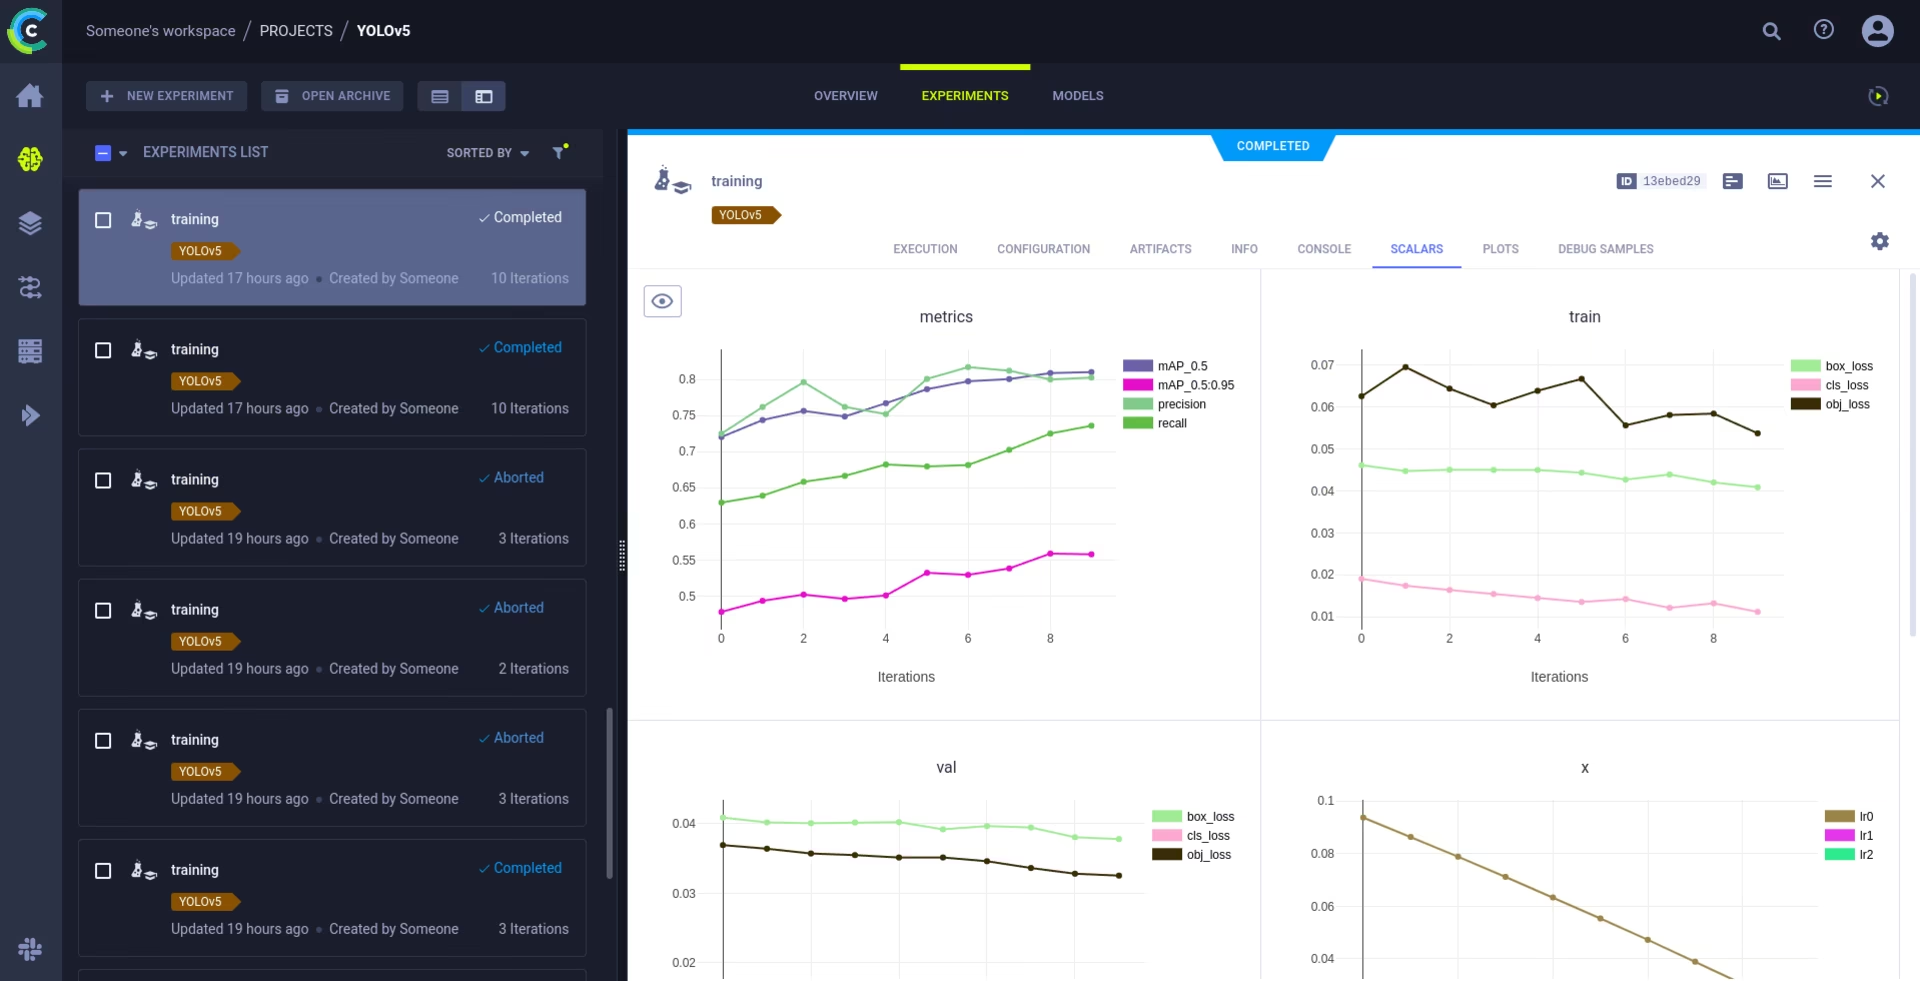
Tích hợp ClearML cho phép theo dõi thí nghiệm chi tiết, quản lý phiên bản dataset và thậm chí thực thi các lượt huấn luyện từ xa. Kích hoạt ClearML qua các bước đơn giản sau:
- Cài đặt package:
pip install clearml - Khởi tạo ClearML: Chạy
clearml-initmột lần để kết nối với máy chủ ClearML (tự lưu trữ hoặc gói miễn phí).
ClearML tự động ghi nhận chi tiết thí nghiệm, lượt tải model lên, các phép so sánh, thay đổi mã chưa commit và package đã cài đặt, đảm bảo khả năng tái lập đầy đủ. Bạn có thể dễ dàng lên lịch các tác vụ huấn luyện trên agent từ xa và quản lý phiên bản dataset bằng ClearML Data. Xem Hướng dẫn tích hợp ClearML để biết thông tin chi tiết.
Ghi log cục bộ#
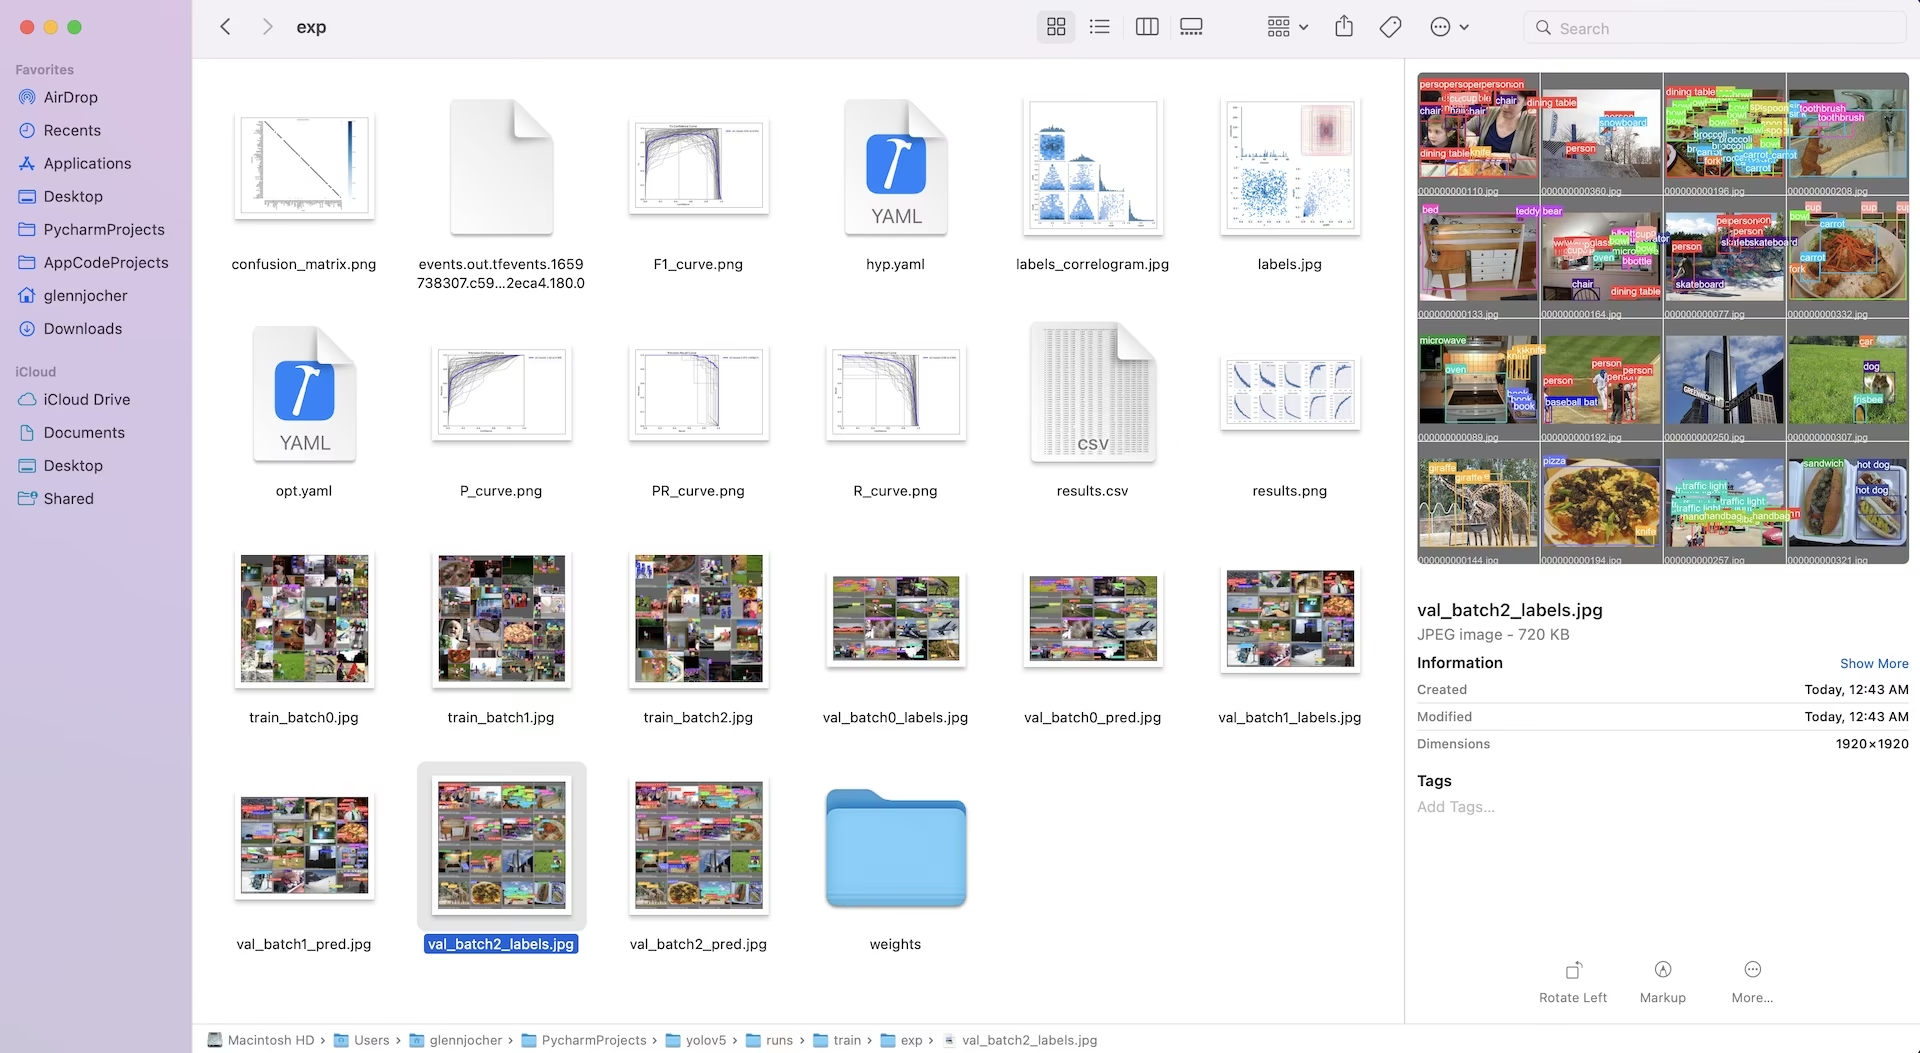
Kết quả huấn luyện được tự động ghi log bằng TensorBoard và lưu thành tệp CSV trong thư mục thí nghiệm tương ứng (ví dụ: runs/train/exp). Dữ liệu được ghi log bao gồm:
- Loss và metric hiệu suất trong quá trình huấn luyện và xác thực.
- Ảnh mẫu thể hiện các phép tăng cường dữ liệu đã áp dụng (như mosaic).
- Nhãn ground truth cùng với dự đoán của model để kiểm tra trực quan.
- Các metric đánh giá chính như đường cong Precision-Recall (PR).
- Ma trận nhầm lẫn để phân tích chi tiết hiệu suất theo từng lớp.
Tệp results.csv được cập nhật sau mỗi epoch và được vẽ thành results.png khi kết thúc huấn luyện. Bạn cũng có thể vẽ thủ công bất kỳ tệp results.csv nào bằng hàm tiện ích được cung cấp:
from utils.plots import plot_results

# Vẽ kết quả từ thư mục của một lượt huấn luyện cụ thể
plot_results("runs/train/exp/results.csv")  # Lệnh này sẽ tạo 'results.png' trong cùng thư mục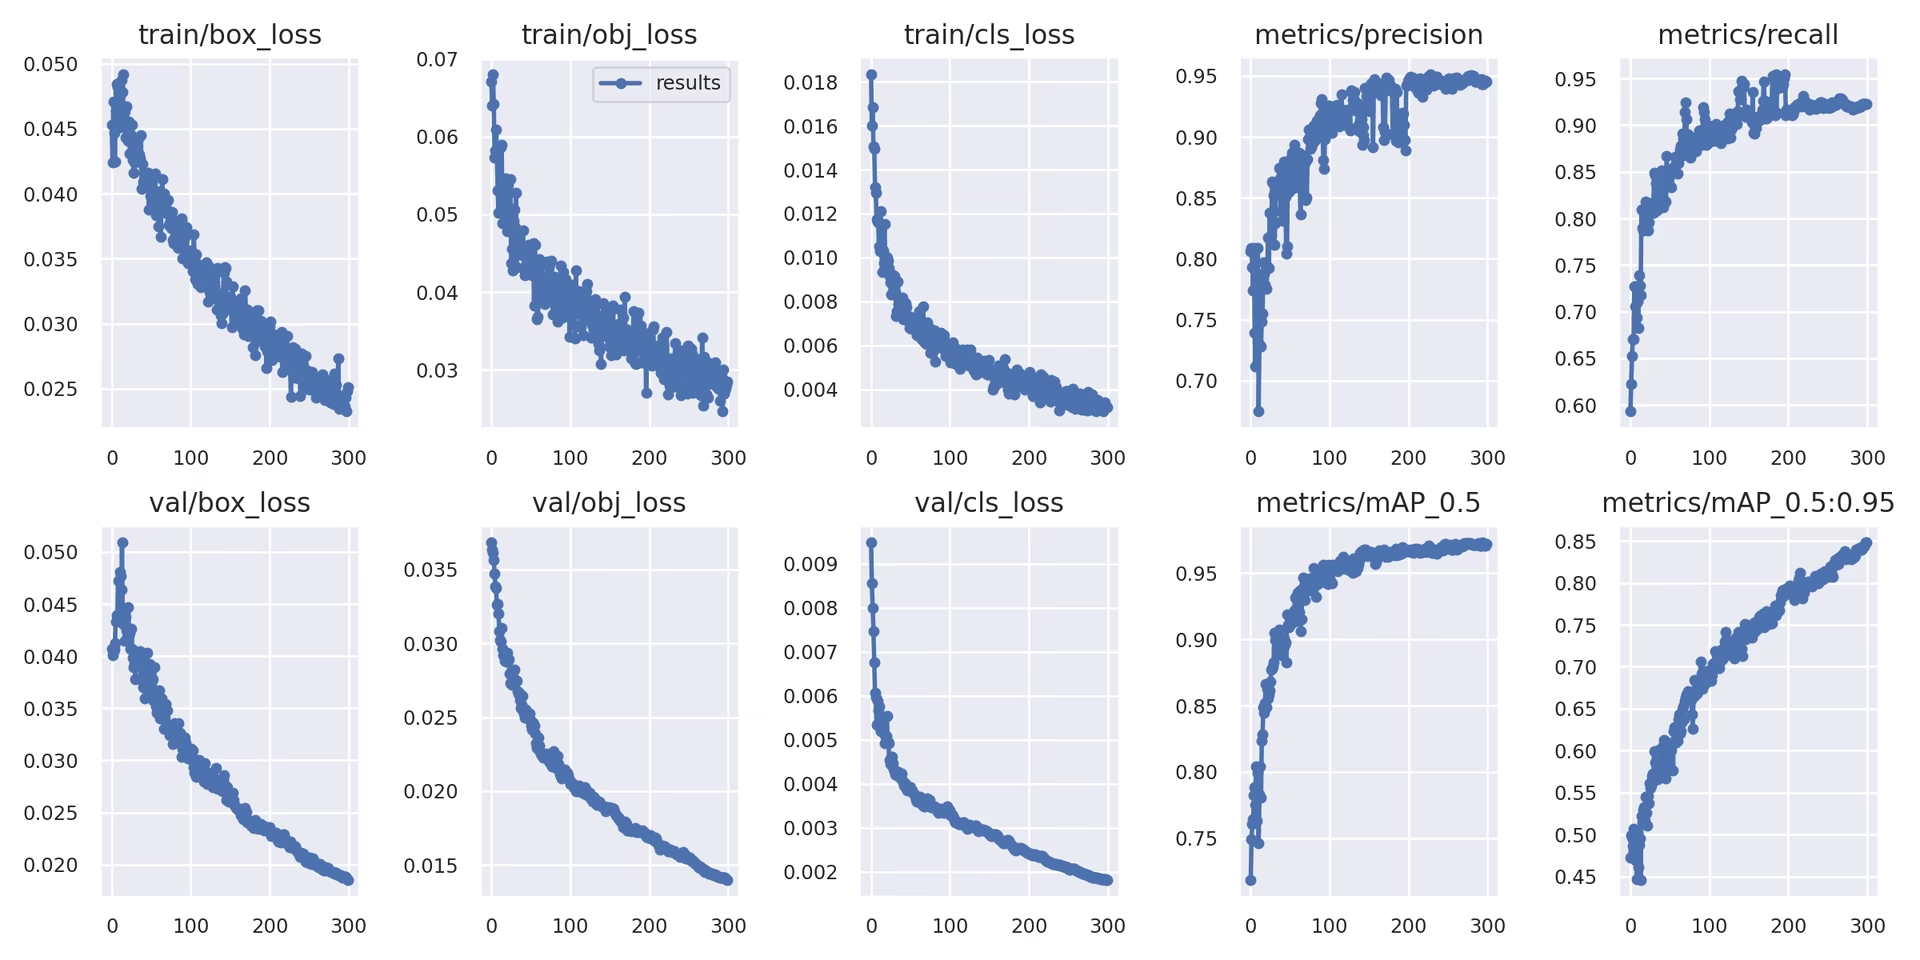
5. Các bước tiếp theo#
Sau khi huấn luyện hoàn tất thành công, checkpoint model có hiệu suất tốt nhất (best.pt) sẽ được lưu và sẵn sàng để triển khai hoặc tinh chỉnh thêm. Các bước tiếp theo có thể gồm:
- Chạy inference trên hình ảnh hoặc video mới bằng model đã huấn luyện thông qua CLI hoặc Python.
- Chạy
val.pyđể đánh giá độ chính xác và khả năng tổng quát hóa của model trên các phần dữ liệu khác nhau (ví dụ: tập kiểm thử được giữ lại). - Export model sang nhiều định dạng triển khai như ONNX, TensorFlow SavedModel hoặc TensorRT để tối ưu inference trên nhiều nền tảng.
- Dùng tiến hóa siêu tham số để tìm cách cải thiện thêm hiệu suất.
- Tiếp tục cải thiện model bằng cách làm theo Mẹo để đạt kết quả huấn luyện tốt nhất của chúng tôi và lặp lại quá trình bổ sung dữ liệu đa dạng, có độ khó cao hơn dựa trên phân tích hiệu suất.
Môi trường được hỗ trợ#
Ultralytics cung cấp các môi trường sẵn sàng sử dụng, được trang bị những dependency thiết yếu như CUDA, cuDNN, Python và PyTorch, giúp bạn bắt đầu thuận lợi.
- Notebook GPU miễn phí:
- Nền tảng đám mây:
- Google Cloud: Hướng dẫn bắt đầu nhanh với GCP
- Amazon AWS: Hướng dẫn bắt đầu nhanh AWS
- Microsoft Azure: Hướng dẫn bắt đầu nhanh AzureML
- Thiết lập cục bộ:


Trạng thái dự án#

Huy hiệu này cho biết tất cả kiểm thử GitHub Actions Tích hợp liên tục (CI) của YOLOv5 đều chạy thành công. Các kiểm thử CI nghiêm ngặt này bao phủ những chức năng cốt lõi, bao gồm huấn luyện, xác thực, inference, export và đánh giá hiệu năng trên hệ điều hành macOS, Windows và Ubuntu. Kiểm thử được tự động chạy mỗi 24 giờ và sau mỗi lần commit mã, đảm bảo độ ổn định nhất quán và hiệu suất tối ưu.
Câu hỏi thường gặp#
Việc huấn luyện YOLOv5 trên dataset tùy chỉnh gồm một số bước chính:
- Chuẩn bị dataset: Thu thập hình ảnh và gán nhãn. Đảm bảo các chú thích tuân theo định dạng YOLO bắt buộc. Sắp xếp hình ảnh và nhãn vào các thư mục
train/vàval/(và tùy chọntest/). Cân nhắc sử dụng các model như Google Gemini, SAM2 hoặc YOLOWorld để hỗ trợ hoặc tự động hóa quy trình gán nhãn (xem Mục 1.2). - Thiết lập môi trường: Clone repository YOLOv5 và cài đặt các dependency bằng
pip install -r requirements.txt.git clone https://github.com/ultralytics/yolov5 cd yolov5 pip install -r requirements.txt - Tạo cấu hình dataset: Xác định đường dẫn dataset, số lượng class và tên class trong file
dataset.yaml. - Bắt đầu huấn luyện: Chạy script
train.py, cung cấp đường dẫn đếndataset.yaml, trọng số pretrained mong muốn (ví dụ:yolov5s.pt), kích thước ảnh, batch size và số epoch.python train.py --img 640 --batch 16 --epochs 100 --data path/to/your/dataset.yaml --weights yolov5s.pt
- Chuẩn bị dataset: Thu thập hình ảnh và gán nhãn. Đảm bảo các chú thích tuân theo định dạng YOLO bắt buộc. Sắp xếp hình ảnh và nhãn vào các thư mục
Ultralytics Platform là một nền tảng toàn diện được thiết kế để đơn giản hóa toàn bộ vòng đời phát triển model YOLO, thường không cần viết mã. Các lợi ích chính gồm:
- Đơn giản hóa việc huấn luyện: Dễ dàng huấn luyện model bằng các môi trường được cấu hình sẵn và giao diện người dùng trực quan.
- Quản lý dữ liệu tích hợp: Tải lên, quản lý phiên bản và quản lý dataset hiệu quả ngay trên nền tảng.
- Giám sát theo thời gian thực: Theo dõi tiến độ huấn luyện và trực quan hóa các metric hiệu năng khi chúng được cập nhật.
- Tính năng cộng tác: Hỗ trợ làm việc nhóm thông qua tài nguyên dùng chung, công cụ quản lý dự án và khả năng chia sẻ model dễ dàng.
- Triển khai không cần code: Triển khai trực tiếp các model đã huấn luyện lên nhiều mục tiêu khác nhau.
Để xem hướng dẫn thực hành, hãy đọc bài blog của chúng tôi: Cách huấn luyện model tùy chỉnh bằng Ultralytics Platform.
Dù bạn gán nhãn thủ công hay dùng công cụ tự động (như các công cụ được đề cập trong Mục 1.2), nhãn cuối cùng phải ở định dạng YOLO cụ thể mà YOLOv5 yêu cầu:
- Tạo một file
.txtcho mỗi hình ảnh. Tên file phải trùng với tên hình ảnh (ví dụ:image1.jpgtương ứng vớiimage1.txt). Đặt các file này trong thư mụclabels/, nằm ngang cấp với thư mụcimages/(ví dụ:../datasets/mydataset/labels/train/). - Mỗi dòng trong file
.txtbiểu thị một chú thích đối tượng và tuân theo định dạng:class_index center_x center_y width height. - Tọa độ (
center_x,center_y,width,height) phải được chuẩn hóa (giá trị từ 0.0 đến 1.0) theo kích thước hình ảnh. - Chỉ số class bắt đầu từ 0 (class đầu tiên là
0, class thứ hai là1, v.v.).
Nhiều công cụ gán nhãn thủ công hỗ trợ xuất trực tiếp sang định dạng YOLO. Nếu sử dụng model tự động, bạn cần script hoặc quy trình để chuyển đổi đầu ra của chúng (ví dụ: tọa độ bounding box, mask phân đoạn) sang định dạng văn bản chuẩn hóa cụ thể này. Đảm bảo cấu trúc dataset cuối cùng tuân theo ví dụ trong hướng dẫn. Để biết thêm chi tiết, xem Hướng dẫn thu thập và gán nhãn dữ liệu của chúng tôi.
- Tạo một file
Ultralytics cung cấp các tùy chọn cấp phép linh hoạt phù hợp với nhiều nhu cầu khác nhau:
- Giấy phép AGPL-3.0: Giấy phép nguồn mở này phù hợp với nghiên cứu học thuật, dự án cá nhân và các trường hợp có thể tuân thủ yêu cầu nguồn mở. Giấy phép yêu cầu các sửa đổi và sản phẩm phái sinh cũng phải được phát hành dưới AGPL-3.0. Xem chi tiết giấy phép AGPL-3.0.
- Giấy phép Enterprise: Giấy phép thương mại dành cho doanh nghiệp tích hợp YOLOv5 vào sản phẩm hoặc dịch vụ độc quyền. Giấy phép này loại bỏ các nghĩa vụ nguồn mở của AGPL-3.0, cho phép phân phối dưới dạng mã nguồn đóng. Truy cập trang Cấp phép để biết thêm chi tiết hoặc yêu cầu Giấy phép Enterprise.
Hãy chọn giấy phép phù hợp nhất với yêu cầu và mô hình phân phối của dự án.