Dataset COCO128#
Giới thiệu#
Ultralytics COCO128 là một dataset phát hiện đối tượng nhỏ nhưng linh hoạt, gồm 128 hình ảnh đầu tiên của tập COCO train 2017. Dataset này lý tưởng để kiểm thử và debug các model phát hiện đối tượng hoặc thử nghiệm những phương pháp phát hiện mới. Với 128 hình ảnh, dataset đủ nhỏ để dễ dàng quản lý nhưng vẫn đủ đa dạng để kiểm tra pipeline training nhằm phát hiện lỗi và thực hiện kiểm tra hợp lệ trước khi training các dataset lớn hơn.
Watch: Ultralytics COCO Dataset Overview
Dataset này được thiết kế để sử dụng với Ultralytics Platform và YOLO26.
Cấu trúc bộ dữ liệu#
COCO128 chứa 128 hình ảnh đầu tiên từ tập COCO train 2017, bao phủ toàn bộ 80 lớp đối tượng COCO trong định dạng nhãn YOLO. 128 hình ảnh này được sử dụng đồng thời cho split training và validation, giúp dataset nhẹ để nhanh chóng kiểm tra tính hợp lệ:
coco128/
├── images/
│   └── train2017/   # 128 images (used for both train and val)
└── labels/
    └── train2017/
YAML của bộ dữ liệu#
Một file YAML được sử dụng để định nghĩa cấu hình dataset. File này chứa thông tin về các path, class và những thông tin liên quan khác của dataset. Đối với dataset COCO128, file coco128.yaml được duy trì tại https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco128.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO128 dataset https://www.kaggle.com/datasets/ultralytics/coco128 (first 128 images from COCO train2017) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/coco128
# Example usage: yolo train data=coco128.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco128 ← downloads here (7 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco128 # dataset root dir
train: images/train2017 # train images (relative to 'path') 128 images
val: images/train2017 # val images (relative to 'path') 128 images
test: # test images (optional)

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco128.zip
Cách sử dụng#
Dataset COCO128 (7 MB) sẽ tự động được download khi bạn bắt đầu training lần đầu tiên. Để training model YOLO26n trên COCO128 trong 100 epoch với kích thước hình ảnh là 640, bạn có thể sử dụng các đoạn code sau. Để xem danh sách đầy đủ các argument hiện có, hãy tham khảo trang Training của model.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="coco128.yaml", epochs=100, imgsz=640)
Hình ảnh mẫu và annotation#
Dưới đây là một số ví dụ về hình ảnh trong dataset COCO128 cùng với các annotation tương ứng:
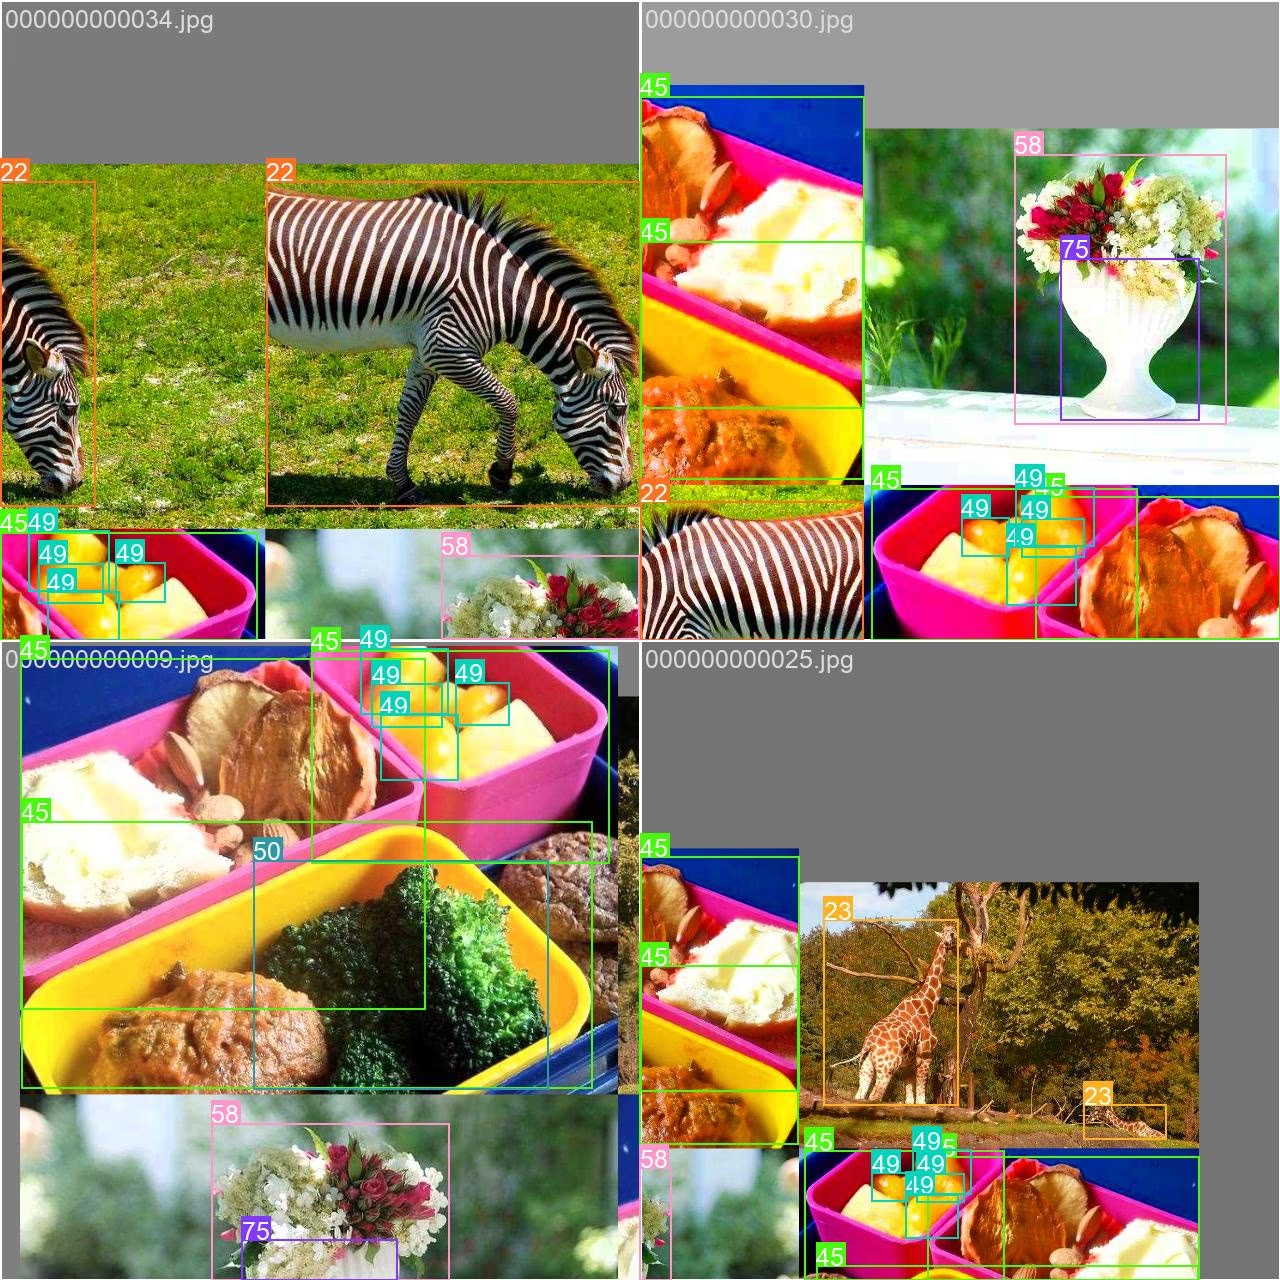
- Hình ảnh dạng mosaic: Hình ảnh này minh họa một batch train được tạo từ các hình ảnh dataset dạng mosaic. Mosaicing là một kỹ thuật được sử dụng trong quá trình train, kết hợp nhiều hình ảnh thành một hình ảnh duy nhất để tăng tính đa dạng của đối tượng và cảnh trong mỗi batch train. Điều này giúp cải thiện khả năng tổng quát hóa của model đối với các kích thước đối tượng, tỷ lệ khung hình và ngữ cảnh khác nhau.
Ví dụ này thể hiện sự đa dạng và phức tạp của các hình ảnh trong dataset COCO128, cũng như những lợi ích của việc sử dụng mosaic trong quá trình training.
Trích dẫn và ghi nhận đóng góp#
Nếu bạn sử dụng dataset COCO trong công trình nghiên cứu hoặc phát triển của mình, vui lòng trích dẫn paper sau:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Chúng tôi xin ghi nhận đóng góp của COCO Consortium trong việc tạo và duy trì resource có giá trị này cho cộng đồng thị giác máy tính. Để biết thêm thông tin về dataset COCO và những người tạo ra dataset, hãy truy cập website dataset COCO.
FAQ#
Dataset COCO128 của Ultralytics là một subset nhỏ gọn gồm 128 hình ảnh đầu tiên từ dataset COCO train 2017. Dataset này chủ yếu được sử dụng để kiểm thử và debug các model phát hiện đối tượng, thử nghiệm những phương pháp phát hiện mới và xác thực pipeline training trước khi mở rộng lên các dataset lớn hơn. Kích thước dễ quản lý giúp dataset này phù hợp cho các vòng lặp nhanh, đồng thời vẫn cung cấp đủ độ đa dạng để trở thành một trường hợp kiểm thử có ý nghĩa.
Để training model YOLO26 trên dataset COCO128, bạn có thể sử dụng lệnh Python hoặc CLI. Cách thực hiện như sau:
Ví dụ huấn luyệnfrom ultralytics import YOLO # Load a pretrained model model = YOLO("yolo26n.pt") # Train the model results = model.train(data="coco128.yaml", epochs=100, imgsz=640)Để biết thêm các tùy chọn và tham số training, hãy tham khảo tài liệu Training.
Mosaic augmentation, như minh họa trong các hình ảnh mẫu, kết hợp nhiều hình ảnh training thành một hình ảnh tổng hợp duy nhất. Kỹ thuật này mang lại một số lợi ích khi training với COCO128:
- Tăng sự đa dạng của các đối tượng và ngữ cảnh trong mỗi training batch
- Cải thiện khả năng tổng quát hóa của model trên các kích thước và tỷ lệ khung hình đối tượng khác nhau
- Nâng cao hiệu năng phát hiện đối tượng ở nhiều scale khác nhau
- Tối đa hóa giá trị sử dụng của một dataset nhỏ bằng cách tạo ra các sample training đa dạng hơn
Kỹ thuật này đặc biệt có giá trị đối với các dataset nhỏ hơn như COCO128, giúp model học được các feature mạnh mẽ hơn từ lượng dữ liệu hạn chế.
Xét về kích thước, COCO128 (128 hình ảnh) nằm giữa COCO8 (8 hình ảnh) và dataset COCO đầy đủ (hơn 118K hình ảnh):
- COCO8: Chỉ chứa 8 hình ảnh (4 train, 4 val) - lý tưởng cho việc kiểm thử và debug nhanh
- COCO128: Chứa 128 hình ảnh - cân bằng giữa kích thước và độ đa dạng
- COCO đầy đủ: Chứa hơn 118K hình ảnh training - toàn diện nhưng đòi hỏi nhiều resource
COCO128 mang lại sự cân bằng tốt, cung cấp độ đa dạng cao hơn COCO8 nhưng vẫn dễ quản lý hơn nhiều so với dataset COCO đầy đủ cho việc thử nghiệm và phát triển model ban đầu.
Mặc dù COCO128 chủ yếu được thiết kế cho việc phát hiện đối tượng, các annotation của dataset có thể được điều chỉnh cho những task thị giác máy tính khác:
- Instance segmentation: Sử dụng các segmentation mask được cung cấp trong annotation
- Keypoint detection: Dành cho các hình ảnh chứa người có annotation keypoint
- Transfer learning: Làm điểm khởi đầu để fine-tune model cho các task tùy chỉnh
Đối với các task chuyên biệt như segmentation, hãy cân nhắc sử dụng các biến thể được xây dựng riêng như COCO8-seg, vốn bao gồm các annotation phù hợp.