Xuất model YOLO26 sang TensorRT#
Việc triển khai model thị giác máy tính trong các môi trường hiệu suất cao có thể đòi hỏi định dạng tối đa hóa tốc độ và hiệu quả. Điều này đặc biệt đúng khi triển khai model trên GPU NVIDIA.
Sử dụng định dạng xuất TensorRT giúp bạn tối ưu hóa model Ultralytics YOLO26 để suy luận nhanh và hiệu quả trên phần cứng NVIDIA. Hướng dẫn này cung cấp các bước chuyển đổi dễ thực hiện và giúp bạn tận dụng tối đa công nghệ tiên tiến của NVIDIA trong các dự án deep learning.
TensorRT#
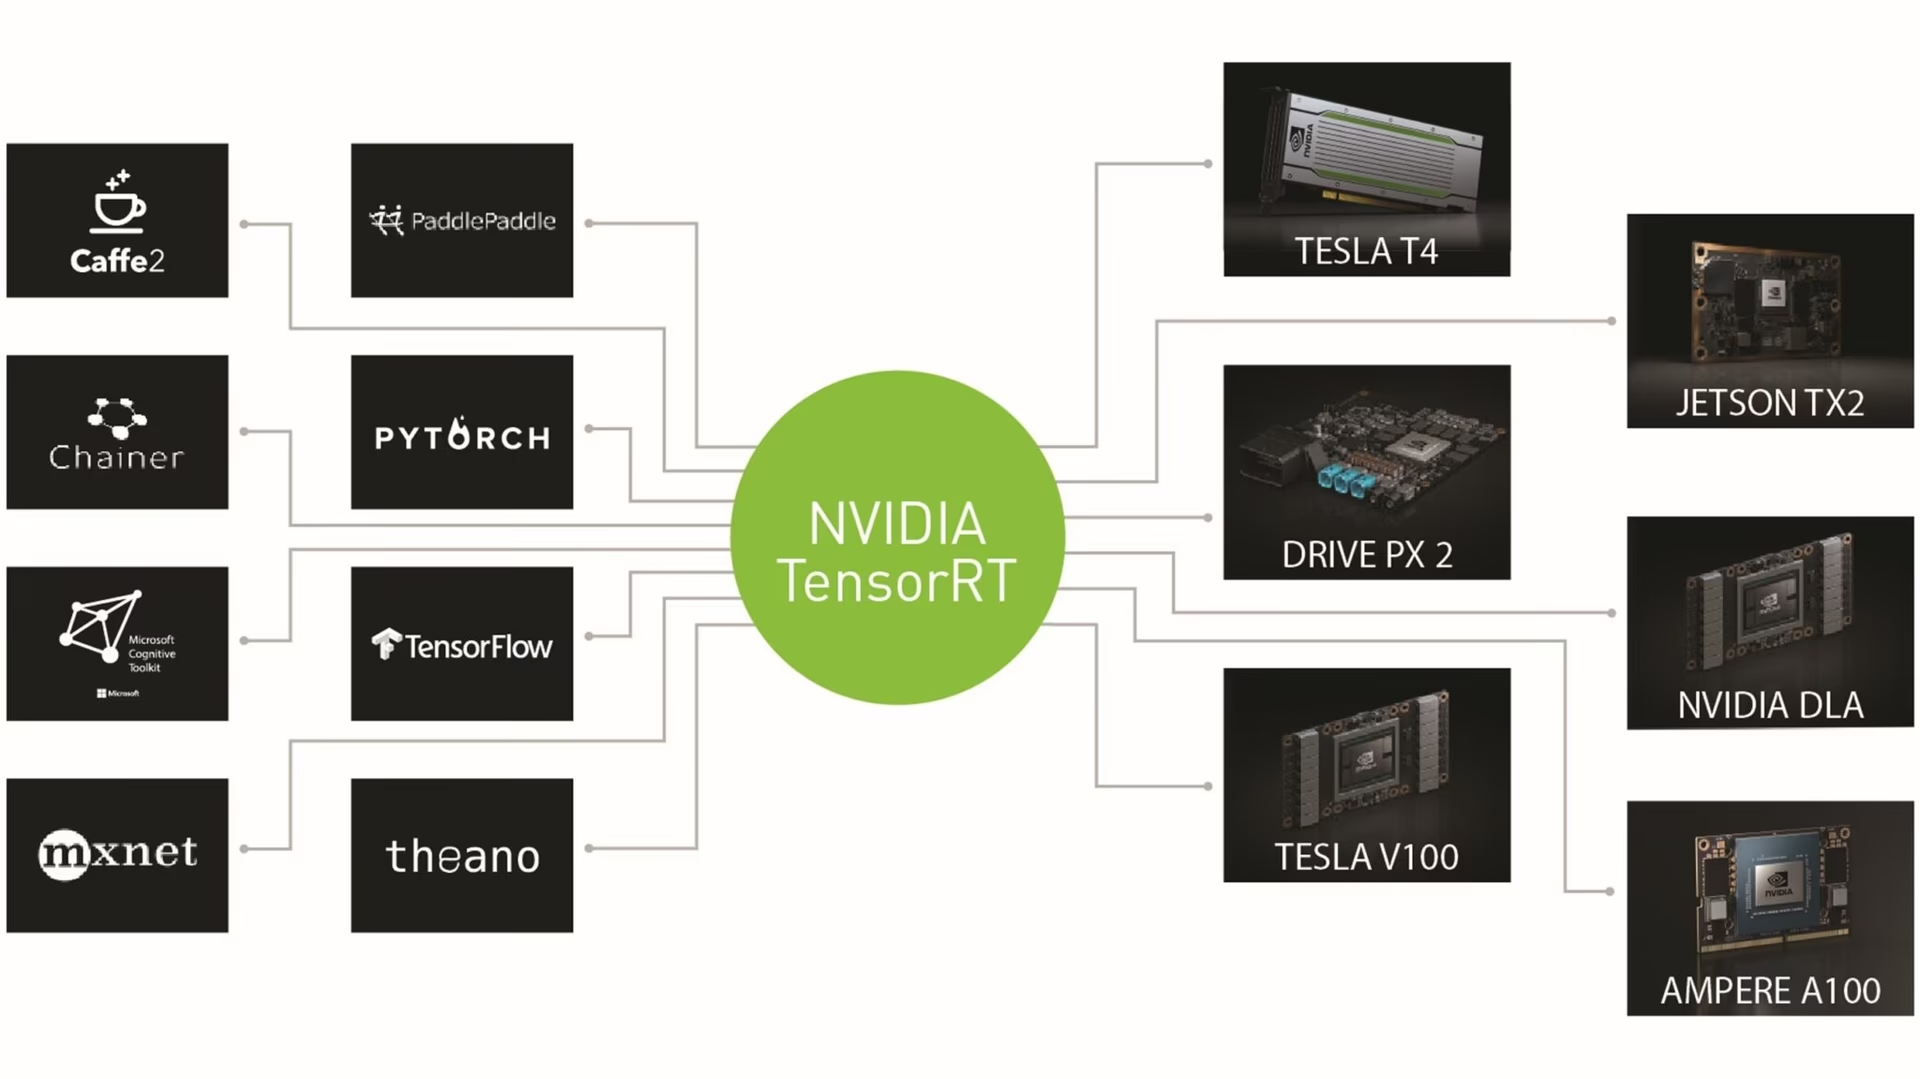
TensorRT, do NVIDIA phát triển, là bộ công cụ phát triển phần mềm (SDK) tiên tiến được thiết kế để suy luận deep learning tốc độ cao. TensorRT rất phù hợp với các ứng dụng thời gian thực như phát hiện đối tượng.
Bộ công cụ này tối ưu hóa model deep learning cho GPU NVIDIA, giúp hoạt động nhanh và hiệu quả hơn. Model TensorRT trải qua quá trình tối ưu hóa TensorRT, bao gồm các kỹ thuật như hợp nhất layer, hiệu chỉnh độ chính xác (INT8 và FP16), quản lý bộ nhớ tensor động và tự động tinh chỉnh kernel. Chuyển đổi model deep learning sang định dạng TensorRT giúp nhà phát triển khai thác tối đa tiềm năng của GPU NVIDIA.
TensorRT nổi tiếng với khả năng tương thích nhiều định dạng model, bao gồm TensorFlow, PyTorch và ONNX, cung cấp cho nhà phát triển giải pháp linh hoạt để tích hợp và tối ưu hóa model từ các framework khác nhau. Tính linh hoạt này cho phép triển khai model hiệu quả trên nhiều môi trường phần cứng và phần mềm.
TensorRT lập profile và tinh chỉnh engine trên GPU dùng để build engine đó. Hãy build cho kiến trúc GPU triển khai và sử dụng runtime TensorRT/CUDA tương thích; không nên coi tệp .engine là định dạng model có thể di chuyển giữa các nền tảng. Để triển khai trên edge, Ultralytics Platform cung cấp tám lựa chọn thiết bị Jetson, kèm trạng thái build và validation thực tế được ghi nhận cho từng thiết bị; hoặc bạn có thể xuất model cục bộ trên thiết bị đích.
Các tính năng chính của model TensorRT#
Model TensorRT cung cấp nhiều tính năng chính góp phần nâng cao hiệu quả và hiệu suất suy luận deep learning tốc độ cao:
-
Hiệu chỉnh độ chính xác: TensorRT hỗ trợ hiệu chỉnh độ chính xác, cho phép tinh chỉnh model theo các yêu cầu độ chính xác cụ thể. Tính năng này hỗ trợ các định dạng độ chính xác thấp hơn như INT8 và FP16, có thể tăng thêm tốc độ suy luận mà vẫn duy trì mức độ chính xác chấp nhận được.
-
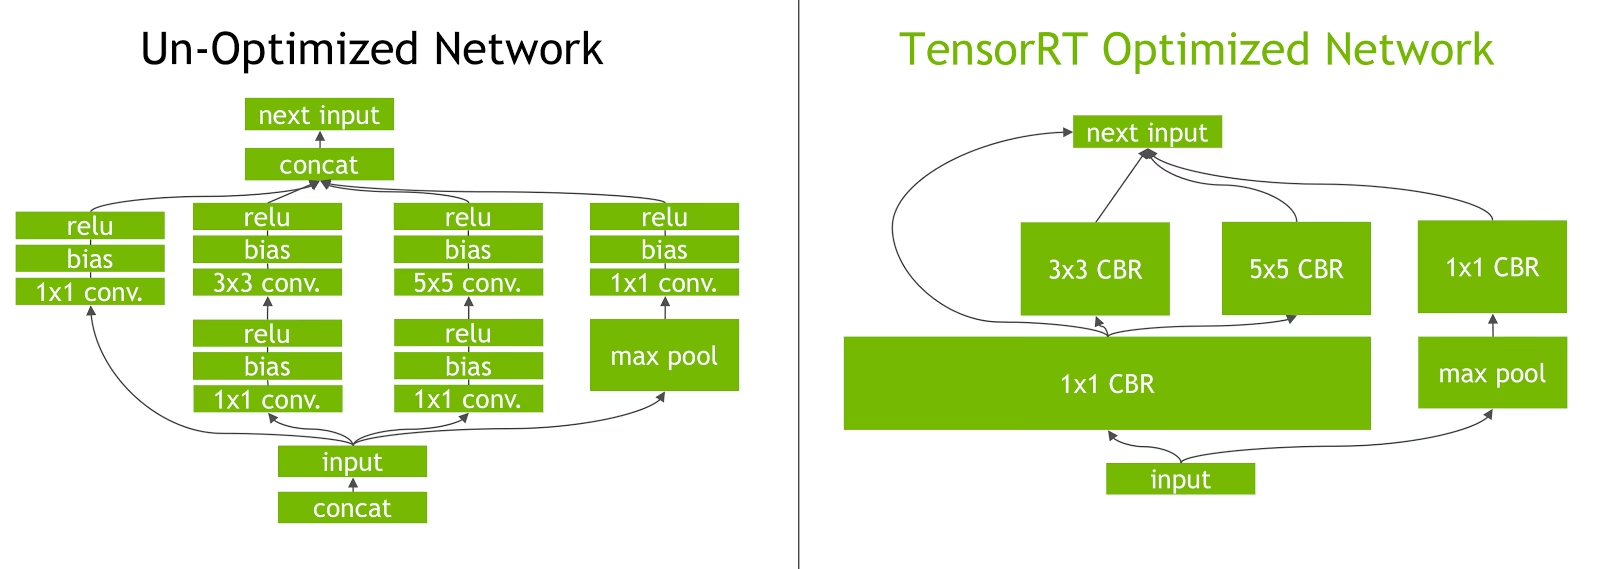
Hợp nhất layer: Quy trình tối ưu hóa TensorRT bao gồm hợp nhất layer, trong đó nhiều layer của mạng neural được kết hợp thành một phép toán duy nhất. Cách này giảm chi phí tính toán và cải thiện tốc độ suy luận bằng cách giảm thiểu truy cập bộ nhớ và phép tính.
-
Quản lý bộ nhớ tensor động: TensorRT quản lý hiệu quả việc sử dụng bộ nhớ tensor trong quá trình suy luận, giảm chi phí bộ nhớ và tối ưu hóa việc cấp phát bộ nhớ. Nhờ đó, bộ nhớ GPU được sử dụng hiệu quả hơn.
-
Tự động tinh chỉnh kernel: TensorRT tự động tinh chỉnh kernel để chọn kernel GPU được tối ưu nhất cho từng layer của model. Phương pháp thích ứng này đảm bảo model tận dụng tối đa năng lực tính toán của GPU.
Các tùy chọn triển khai trong TensorRT#
Trước khi xem mã xuất model YOLO26 sang định dạng TensorRT, hãy tìm hiểu các trường hợp sử dụng phổ biến của model TensorRT.
TensorRT cung cấp nhiều tùy chọn triển khai; mỗi tùy chọn có sự cân bằng khác nhau giữa mức độ dễ tích hợp, tối ưu hóa hiệu suất và tính linh hoạt:
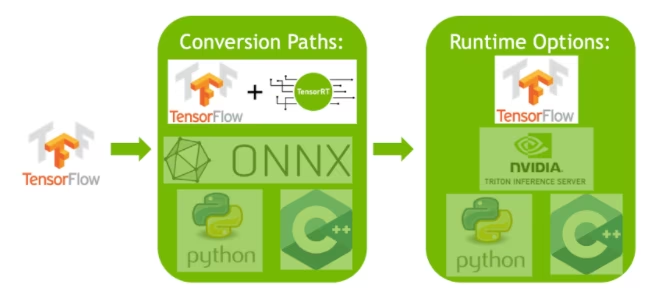
- Triển khai bên trong TensorFlow: Phương pháp này tích hợp TensorRT vào TensorFlow, cho phép chạy model đã tối ưu trong môi trường TensorFlow quen thuộc. Cách này hữu ích với model kết hợp các layer được hỗ trợ và không được hỗ trợ, vì TF-TRT có thể xử lý chúng hiệu quả.
-
TensorRT Runtime API độc lập: Cung cấp khả năng kiểm soát chi tiết, lý tưởng cho các ứng dụng nhạy cảm với hiệu suất. Cách này phức tạp hơn nhưng cho phép triển khai tùy chỉnh các toán tử không được hỗ trợ.
-
NVIDIA Triton Inference Server: Lựa chọn hỗ trợ model từ nhiều framework khác nhau. Đặc biệt phù hợp với suy luận trên cloud hoặc edge, cung cấp các tính năng như thực thi đồng thời nhiều model và phân tích model.
Các tác vụ được hỗ trợ#
Xuất TensorRT hỗ trợ cả bảy tác vụ của Ultralytics. Phân đoạn ngữ nghĩa và ước tính độ sâu chỉ khả dụng với YOLO26, dòng model duy nhất có các head này.
Xuất model YOLO26 sang TensorRT#
Bạn có thể cải thiện hiệu quả thực thi và tối ưu hóa hiệu suất bằng cách chuyển đổi model YOLO26 sang định dạng TensorRT.
Cài đặt#
Để cài đặt package cần thiết, hãy chạy:
# Install the required package for YOLO26
pip install ultralytics
Để xem hướng dẫn chi tiết và các phương pháp thực hành tốt nhất liên quan đến quy trình cài đặt, hãy tham khảo hướng dẫn cài đặt YOLO26. Nếu gặp khó khăn khi cài đặt các package cần thiết cho YOLO26, hãy xem hướng dẫn về các sự cố thường gặp để tìm giải pháp và mẹo xử lý.
Cách sử dụng#
Trước khi tìm hiểu hướng dẫn sử dụng, hãy xem qua các model YOLO26 do Ultralytics cung cấp. Điều này sẽ giúp bạn chọn model phù hợp nhất với yêu cầu dự án.
Định dạng TensorRT hỗ trợ các chế độ Export, Predict và Validate. Suy luận và validation yêu cầu GPU NVIDIA. Hãy xuất model, sau đó tải model đã xuất để chạy suy luận hoặc validation độ chính xác.
from ultralytics import YOLO

# Nạp model YOLO26
model = YOLO("yolo26n.pt")

# Export model sang định dạng TensorRT
model.export(format="engine") # # tạo 'yolo26n.engine'from ultralytics import YOLO
# Tải model TensorRT đã export
model = YOLO("yolo26n.engine")
# Chạy suy luận
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Tải model TensorRT đã export
model = YOLO("yolo26n.engine")
# # Đánh giá độ chính xác trên bộ dữ liệu COCO8
metrics = model.val(data="coco8.yaml")Các tham số xuất model#
| Đối số | Kiểu | Mặc định | Mô tả |
|---|---|---|---|
format | str | 'engine' | Định dạng đích của model đã xuất, xác định khả năng tương thích với nhiều môi trường triển khai. |
imgsz | int hoặc tuple | 640 | Kích thước ảnh mong muốn cho đầu vào model. Có thể là số nguyên cho ảnh vuông hoặc tuple (height, width) để chỉ định kích thước cụ thể. |
quantize | int hoặc str | None | Độ chính xác lượng tử hóa: 16 (FP16) hoặc 8 (INT8/PTQ; cần calibration data/fraction); 32/không đặt là FP32. Checkpoint được huấn luyện với quantize=8 luôn được xuất ở dạng INT8 từ các dải giá trị đi kèm, không cần calibration. Thay thế các cờ half/int8 đã lỗi thời. |
dynamic | bool | False | Cho phép kích thước đầu vào động, tăng tính linh hoạt khi xử lý ảnh có kích thước khác nhau. |
simplify | bool | True | Đơn giản hóa đồ thị model bằng onnxslim, có khả năng cải thiện hiệu năng và khả năng tương thích. |
opset | int | None | Chỉ định phiên bản opset ONNX cho đồ thị ONNX trung gian. Nếu không đặt, phiên bản được hỗ trợ mới nhất sẽ được sử dụng. |
workspace | float hoặc None | None | Đặt kích thước workspace tối đa, tính bằng GiB, cho các bước tối ưu hóa TensorRT, giúp cân bằng mức sử dụng bộ nhớ và hiệu suất; dùng None để TensorRT tự động cấp phát tối đa theo giới hạn thiết bị. |
nms | bool, không bắt buộc | None | Chọn đầu ra thô (None, mặc định), NMS nhúng (True) hoặc head không có NMS (False). |
batch | int | 1 | Chỉ định kích thước batch suy luận của model khi xuất hoặc số lượng ảnh tối đa mà model đã xuất xử lý đồng thời ở chế độ predict. |
data | str | None | Đường dẫn đến tệp YAML của dataset, cần thiết cho lượng tử hóa; riêng bài toán phân loại sử dụng thư mục dataset hoặc tên dataset tích hợp sẵn. Nếu bỏ qua khi dùng quantize=8, Ultralytics sẽ chọn dataset calibration mặc định cho tác vụ của model; checkpoint được huấn luyện với quantize=8 không cần dataset này. |
fraction | float, int hoặc list | 1.0 | Tập con hiệu chuẩn dưới dạng tỷ lệ, số lượng ảnh hoặc tỷ lệ/số lượng [train, val, test]. Danh sách gồm hai mục giữ test ở dạng đầy đủ, còn 0 sẽ bỏ qua mục này. |
device | str | None | Chỉ định thiết bị dùng để xuất: GPU (device=0), DLA cho NVIDIA Jetson (device=dla:0 hoặc device=dla:1). |
Hãy đảm bảo sử dụng GPU hỗ trợ CUDA khi xuất sang TensorRT.
TensorRT 11.2.1 không hỗ trợ JetPack, bao gồm cả Thor; hãy sử dụng runtime TensorRT 10.x được phiên bản JetPack của bạn hỗ trợ. Với device=dla:0 hoặc device=dla:1, NVIDIA xác định TensorRT 10.7 là phiên bản cuối cùng có hỗ trợ DLA. TensorRT 11.0, 11.1 và 11.2 không hỗ trợ DLA.
Để biết thêm chi tiết về quy trình xuất, hãy truy cập trang tài liệu Ultralytics về xuất model.
Xuất TensorRT với lượng tử hóa INT8#
Xuất model Ultralytics YOLO bằng TensorRT với độ chính xác INT8 sẽ thực hiện lượng tử hóa sau huấn luyện (PTQ). TensorRT dùng calibration cho PTQ để đo phân phối activation trong từng tensor activation khi model YOLO thực hiện suy luận trên dữ liệu đầu vào đại diện, sau đó dùng phân phối đó để ước tính giá trị scale cho từng tensor. Mỗi tensor activation đủ điều kiện lượng tử hóa đều có một giá trị scale được xác định qua quá trình calibration. Checkpoint được tinh chỉnh bằng quantize=8 thông qua huấn luyện có nhận biết lượng tử hóa đã có sẵn các dải INT8, vì vậy quá trình xuất sử dụng các dải này và bỏ qua calibration.
TensorRT 11 đã loại bỏ lượng tử hóa ngầm và giao diện IInt8Calibrator. Trên TensorRT 11 trở lên, Ultralytics thực hiện lượng tử hóa INT8 bằng lượng tử hóa tường minh với NVIDIA ModelOpt, chèn các node Q/DQ vào đồ thị ONNX trước khi build engine có kiểu dữ liệu cố định; FP16 được áp dụng bằng phương pháp chuyển đổi độ chính xác hỗn hợp AutoCast của ModelOpt. Các tham số quantize=8, quantize=16 và data hoạt động như trước; ModelOpt được tự động cài đặt trong lần sử dụng đầu tiên. Trên TensorRT 7-10, thay vào đó sẽ dùng bộ hiệu chỉnh cũ được mô tả bên dưới.
Khi xử lý các mạng được lượng tử hóa ngầm, TensorRT sử dụng INT8 khi thích hợp để tối ưu hóa thời gian thực thi layer. Nếu một layer chạy nhanh hơn ở INT8 và được gán scale lượng tử hóa cho dữ liệu đầu vào và đầu ra, kernel có độ chính xác INT8 sẽ được gán cho layer đó; nếu không, TensorRT chọn độ chính xác FP32 hoặc FP16 cho kernel, tùy theo lựa chọn nào giúp layer thực thi nhanh hơn.
Điều cực kỳ quan trọng là phải dùng chính thiết bị sẽ sử dụng trọng số model TensorRT khi triển khai để xuất model với độ chính xác INT8, vì kết quả calibration có thể khác nhau giữa các thiết bị.
Cấu hình xuất INT8#
Các tham số được cung cấp khi dùng export cho model Ultralytics YOLO sẽ ảnh hưởng rất lớn đến hiệu suất của model đã xuất. Cần chọn tham số dựa trên tài nguyên thiết bị hiện có; tuy nhiên, các tham số mặc định nên hoạt động tốt với hầu hết GPU NVIDIA rời Ampere trở lên. Thuật toán calibration được dùng là "MINMAX_CALIBRATION" khi xuất trên GPU, còn khi xuất DLA trên NVIDIA Jetson thì dùng "ENTROPY_CALIBRATION_2". Bạn có thể đọc thêm chi tiết về các tùy chọn khả dụng trong TensorRT Developer Guide. Thử nghiệm của Ultralytics cho thấy "MINMAX_CALIBRATION" là lựa chọn tốt nhất khi xuất trên GPU; thuật toán được tự động chọn dựa trên thiết bị xuất.
-
workspace: Kiểm soát kích thước (tính bằng GiB) bộ nhớ thiết bị được cấp phát trong quá trình chuyển đổi trọng số model.-
Điều chỉnh giá trị
workspacetheo nhu cầu calibration và tài nguyên hiện có. Mặc dùworkspacelớn hơn có thể kéo dài thời gian calibration, giá trị này cho phép TensorRT thử nghiệm nhiều chiến thuật tối ưu hóa hơn, qua đó có khả năng cải thiện hiệu suất và độ chính xác của model. Ngược lại,workspacenhỏ hơn có thể rút ngắn thời gian calibration nhưng giới hạn các chiến lược tối ưu hóa, ảnh hưởng đến chất lượng model đã lượng tử hóa. -
Mặc định là
workspace=None, cho phép TensorRT tự động cấp phát bộ nhớ. Khi cấu hình thủ công, có thể cần tăng giá trị này nếu calibration gặp sự cố (thoát mà không cảnh báo). -
Trong quá trình xuất, TensorRT sẽ báo
UNSUPPORTED_STATEnếu giá trịworkspacelớn hơn dung lượng bộ nhớ khả dụng của thiết bị; khi đó cần giảm giá trịworkspacehoặc đặt thànhNone. -
Nếu
workspaceđược đặt ở giá trị tối đa nhưng calibration không thành công/gặp sự cố, hãy cân nhắc dùngNoneđể tự động cấp phát hoặc giảm các giá trịimgszvàbatchnhằm giảm yêu cầu bộ nhớ. -
Lưu ý việc calibration INT8 phụ thuộc vào từng thiết bị, vì vậy mượn GPU "cao cấp" để calibration có thể dẫn đến hiệu suất kém khi chạy suy luận trên thiết bị khác.
-
-
batch: Kích thước batch tối đa được dùng khi suy luận. Vớidynamic=True, có thể dùng batch nhỏ hơn khi suy luận, nhưng không thể xử lý batch lớn hơn giá trị đã chỉ định.
Dùng batch nhỏ có thể dẫn đến việc scale không chính xác trong quá trình calibration INT8. Nguyên nhân là quá trình này điều chỉnh dựa trên dữ liệu quan sát được. Batch nhỏ có thể không bao quát đủ dải giá trị, gây ra vấn đề với kết quả calibration cuối cùng. Dùng batch size lớn hơn giúp đảm bảo kết quả calibration mang tính đại diện hơn.
Các thử nghiệm của NVIDIA khiến họ khuyến nghị sử dụng ít nhất 500 ảnh calibration đại diện cho dữ liệu của model khi calibration lượng tử hóa INT8. Đây là hướng dẫn chứ không phải yêu cầu bắt buộc, và bạn cần thử nghiệm để xác định cấu hình phù hợp với dataset của mình. Vì dữ liệu calibration là cần thiết để calibration INT8 bằng TensorRT, hãy nhớ dùng tham số data khi xuất checkpoint không được huấn luyện với quantize=8 (lượng tử hóa sau huấn luyện) tại quantize=8 sang TensorRT, đồng thời dùng data="my_dataset.yaml" để calibration bằng ảnh từ validation. Checkpoint được huấn luyện với quantize=8 sẽ bỏ qua calibration, vì vậy không cần dùng data. Nếu không truyền giá trị cho data khi xuất sang TensorRT với lượng tử hóa INT8, hệ thống sẽ mặc định dùng một trong các dataset ví dụ "nhỏ" dựa trên tác vụ của model thay vì báo lỗi.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(
    format="engine",
    dynamic=True,  # (1)!
    batch=8,  # (2)!
    workspace=4,  # (3)!
    quantize=8,
    data="coco.yaml",  # (4)!
)

# Tải model TensorRT INT8 đã xuất
model = YOLO("yolo26n.engine", task="detect")

# Chạy suy luận
result = model.predict("https://ultralytics.com/images/bus.jpg")- Xuất model với các trục động, chấp nhận kích thước đầu vào từ 32 pixel đến gấp đôi giá trị
imgszdùng khi xuất;dynamicvẫn giữ nguyênFalsetrừ khi được đặt rõ ràng. Xem các tham số export để biết thêm thông tin. - Đặt batch size tối đa là 8 cho model đã xuất và quá trình calibration INT8.
- Cấp phát 4 GiB bộ nhớ thay vì dùng toàn bộ thiết bị cho quá trình chuyển đổi.
- Sử dụng dataset COCO để calibration, cụ thể là các ảnh dùng cho validation (tổng cộng 5.000 ảnh).
Ưu điểm khi sử dụng YOLO với TensorRT INT8#
-
Giảm kích thước model: Lượng tử hóa từ FP32 sang INT8 có thể giảm kích thước model xuống 4 lần (trên đĩa hoặc trong bộ nhớ), giúp tải xuống nhanh hơn, giảm nhu cầu lưu trữ và giảm dung lượng bộ nhớ cần dùng khi triển khai model.
-
Tiêu thụ ít điện năng hơn: Các phép toán giảm độ chính xác trên model YOLO được xuất ở định dạng INT8 có thể tiêu thụ ít điện năng hơn so với model FP32, đặc biệt trên các thiết bị dùng pin.
-
Tăng tốc độ suy luận: TensorRT tối ưu hóa model cho phần cứng đích, nhờ đó có thể tăng tốc độ suy luận trên GPU, thiết bị nhúng và bộ tăng tốc.
Lưu ý về tốc độ suy luận
Có thể dự kiến rằng một vài lần gọi suy luận đầu tiên với model được xuất sang TensorRT INT8 sẽ có thời gian tiền xử lý, suy luận và/hoặc hậu xử lý lâu hơn bình thường. Hiện tượng này cũng có thể xảy ra khi thay đổi imgsz trong quá trình suy luận, đặc biệt khi imgsz không giống với giá trị đã chỉ định khi xuất model (export imgsz được đặt làm profile TensorRT "optimal").
Nhược điểm khi sử dụng YOLO với TensorRT INT8#
-
Chỉ số đánh giá giảm: Sử dụng độ chính xác thấp hơn đồng nghĩa với việc
mAP,Precision,Recallhoặc bất kỳ metric nào khác dùng để đánh giá hiệu suất model có khả năng sẽ kém hơn đôi chút. Các lớp Sigmoid vẫn được giữ ở độ chính xác cao hơn để duy trì hiệu chuẩn điểm số, nhưng INT8 vẫn có thể làm thay đổi giá trị confidence, vì vậy hãy chọn ngưỡng vận hành từ đường cong F1 của chính model INT8. Xem phần kết quả hiệu suất để so sánh khác biệt vềmAP50vàmAP50-95khi xuất với INT8 trên một mẫu nhỏ gồm nhiều thiết bị. -
Tăng thời gian phát triển: Việc tìm các cài đặt "optimal" để hiệu chuẩn INT8 cho dataset và thiết bị có thể đòi hỏi nhiều thời gian thử nghiệm.
-
Phụ thuộc phần cứng: Quá trình hiệu chuẩn và mức tăng hiệu suất có thể phụ thuộc nhiều vào phần cứng, đồng thời trọng số model cũng khó chuyển đổi giữa các thiết bị hơn.
Hiệu suất xuất Ultralytics YOLO sang TensorRT#
NVIDIA A100#
Được kiểm thử trên Ubuntu 22.04.3 LTS, python 3.10.12, ultralytics==8.2.4, tensorrt==8.6.1.post1
Xem Tài liệu về Detection để biết ví dụ sử dụng các model này được huấn luyện trên COCO, bao gồm 80 class được huấn luyện trước.
Thời gian suy luận hiển thị cho mean, min (nhanh nhất) và max (chậm nhất) trong mỗi bài kiểm thử, sử dụng trọng số được huấn luyện trước yolov8n.engine
| Precision | Bài kiểm thử đánh giá | trung bình (ms) | nhỏ nhất | lớn nhất (ms) | mAPval 50(B) | mAPval 50-95(B) | batch | kích thước (pixel) |
|---|---|---|---|---|---|---|---|
| FP32 | Dự đoán | 0.52 | 0.51 | 0.56 | 8 | 640 | ||
| FP32 | COCOval | 0.52 | 0.52 | 0.37 | 1 | 640 | |
| FP16 | Dự đoán | 0.34 | 0.34 | 0.41 | 8 | 640 | ||
| FP16 | COCOval | 0.33 | 0.52 | 0.37 | 1 | 640 | |
| INT8 | Dự đoán | 0.28 | 0.27 | 0.31 | 8 | 640 | ||
| INT8 | COCOval | 0.29 | 0.47 | 0.33 | 1 | 640 |
GPU phổ thông#
Được kiểm thử trên Windows 10.0.19045, python 3.10.9, ultralytics==8.2.4, tensorrt==10.0.0b6
Thời gian suy luận hiển thị cho mean, min (nhanh nhất) và max (chậm nhất) trong mỗi bài kiểm thử, sử dụng trọng số được huấn luyện trước yolov8n.engine
| Precision | Bài kiểm thử đánh giá | trung bình (ms) | nhỏ nhất | lớn nhất (ms) | mAPval 50(B) | mAPval 50-95(B) | batch | kích thước (pixel) |
|---|---|---|---|---|---|---|---|
| FP32 | Dự đoán | 1.06 | 0.75 | 1.88 | 8 | 640 | ||
| FP32 | COCOval | 1.37 | 0.52 | 0.37 | 1 | 640 | |
| FP16 | Dự đoán | 0.62 | 0.75 | 1.13 | 8 | 640 | ||
| FP16 | COCOval | 0.85 | 0.52 | 0.37 | 1 | 640 | |
| INT8 | Dự đoán | 0.52 | 0.38 | 1.00 | 8 | 640 | ||
| INT8 | COCOval | 0.74 | 0.47 | 0.33 | 1 | 640 |
Thiết bị nhúng#
Được kiểm thử trên JetPack 6.0 (L4T 36.3) Ubuntu 22.04.4 LTS, python 3.10.12, ultralytics==8.2.16, tensorrt==10.0.1
Thời gian suy luận hiển thị cho mean, min (nhanh nhất) và max (chậm nhất) trong mỗi bài kiểm thử, sử dụng trọng số được huấn luyện trước yolov8n.engine
| Precision | Bài kiểm thử đánh giá | trung bình (ms) | nhỏ nhất | lớn nhất (ms) | mAPval 50(B) | mAPval 50-95(B) | batch | kích thước (pixel) |
|---|---|---|---|---|---|---|---|
| FP32 | Dự đoán | 6.11 | 6.10 | 6.29 | 8 | 640 | ||
| FP32 | COCOval | 6.17 | 0.52 | 0.37 | 1 | 640 | |
| FP16 | Dự đoán | 3.18 | 3.18 | 3.20 | 8 | 640 | ||
| FP16 | COCOval | 3.19 | 0.52 | 0.37 | 1 | 640 | |
| INT8 | Dự đoán | 2.30 | 2.29 | 2.35 | 8 | 640 | ||
| INT8 | COCOval | 2.32 | 0.46 | 0.32 | 1 | 640 |
Xem hướng dẫn bắt đầu nhanh về NVIDIA Jetson với Ultralytics YOLO để tìm hiểu thêm về cách thiết lập và cấu hình.
Xem hướng dẫn bắt đầu nhanh về NVIDIA DGX Spark với Ultralytics YOLO để tìm hiểu thêm về cách thiết lập và cấu hình.
Phương pháp đánh giá#
Mở rộng các mục bên dưới để xem thông tin về cách xuất và kiểm thử các model này.
Cấu hình xuất model
Xem chế độ export để biết chi tiết về các tham số cấu hình export.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# TensorRT FP32
out = model.export(format="engine", imgsz=640, dynamic=True, verbose=False, batch=8, workspace=2)

# TensorRT FP16
out = model.export(format="engine", imgsz=640, dynamic=True, verbose=False, batch=8, workspace=2, quantize=16)

# TensorRT INT8 với `data` hiệu chuẩn (tức là COCO, ImageNet hoặc DOTAv1 cho tác vụ model phù hợp)
out = model.export(
    format="engine", imgsz=640, dynamic=True, verbose=False, batch=8, workspace=2, quantize=8, data="coco8.yaml"
)
Vòng lặp dự đoán
Xem chế độ predict để biết thêm thông tin.
import cv2

from ultralytics import YOLO

model = YOLO("yolo26n.engine")
img = cv2.imread("path/to/image.jpg")

for _ in range(100):
    result = model.predict(
        [img] * 8,  # batch=8 của cùng một ảnh
        verbose=False,
        device="cuda",
    )
Cấu hình validation
Xem chế độ val để tìm hiểu thêm về các tham số cấu hình validation.
from ultralytics import YOLO

model = YOLO("yolo26n.engine")
results = model.val(
    data="data.yaml",  # COCO, ImageNet hoặc DOTAv1 cho tác vụ model phù hợp
    batch=1,
    imgsz=640,
    verbose=False,
    device="cuda",
)
Triển khai model YOLO26 TensorRT đã xuất#
Sau khi xuất thành công model Ultralytics YOLO26 sang định dạng TensorRT, bạn đã sẵn sàng triển khai. Để xem hướng dẫn chuyên sâu về cách triển khai model TensorRT trong nhiều môi trường khác nhau, hãy tham khảo các tài nguyên sau:
-
Triển khai Ultralytics với Triton Server: Hướng dẫn sử dụng NVIDIA Triton Inference Server (trước đây là TensorRT Inference Server) dành riêng cho model Ultralytics YOLO.
-
Triển khai mạng nơ-ron sâu với NVIDIA TensorRT: Bài viết này giải thích cách sử dụng NVIDIA TensorRT để triển khai hiệu quả mạng nơ-ron sâu trên các nền tảng triển khai dựa trên GPU.
-
AI đầu cuối cho PC dùng NVIDIA: Triển khai NVIDIA TensorRT: Bài đăng blog này giải thích cách sử dụng NVIDIA TensorRT để tối ưu hóa và triển khai model AI trên PC dùng NVIDIA.
-
Kho GitHub của NVIDIA TensorRT: Đây là kho GitHub chính thức chứa mã nguồn và tài liệu về NVIDIA TensorRT.
Tóm tắt#
Trong hướng dẫn này, chúng tôi tập trung vào việc chuyển đổi model Ultralytics YOLO26 sang định dạng model TensorRT của NVIDIA. Bước chuyển đổi này đóng vai trò then chốt trong việc cải thiện hiệu quả và tốc độ của model YOLO26, giúp model hoạt động hiệu quả hơn và phù hợp với nhiều môi trường triển khai.
Để biết thêm chi tiết về cách sử dụng, hãy xem tài liệu chính thức về TensorRT.
Nếu muốn tìm hiểu thêm về các tích hợp Ultralytics YOLO26, trang hướng dẫn tích hợp của chúng tôi cung cấp nhiều tài nguyên hữu ích và thông tin chuyên sâu.
Câu hỏi thường gặp#
Để chuyển đổi model Ultralytics YOLO26 sang định dạng TensorRT nhằm tối ưu hóa suy luận trên GPU NVIDIA, hãy làm theo các bước sau:
-
Cài đặt package cần thiết:
pip install ultralytics -
Xuất model YOLO26:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(format="engine")  # # tạo 'yolo26n.engine'

# Chạy suy luận
model = YOLO("yolo26n.engine")
results = model("https://ultralytics.com/images/bus.jpg")
Để biết thêm chi tiết, hãy xem hướng dẫn cài đặt YOLO26 và tài liệu export.
-
Sử dụng TensorRT để tối ưu hóa model YOLO26 mang lại một số lợi ích:
- Tốc độ suy luận nhanh hơn: TensorRT tối ưu hóa các layer của model và sử dụng hiệu chuẩn độ chính xác (INT8 và FP16) để tăng tốc suy luận mà không làm giảm đáng kể độ chính xác.
- Sử dụng bộ nhớ hiệu quả: TensorRT quản lý bộ nhớ tensor một cách linh hoạt, giảm overhead và cải thiện mức sử dụng bộ nhớ GPU.
- Hợp nhất layer: Kết hợp nhiều layer thành các phép toán đơn, giảm độ phức tạp tính toán.
- Tự động tinh chỉnh kernel: Tự động chọn kernel GPU được tối ưu hóa cho từng layer của model, đảm bảo hiệu suất tối đa.
Để tìm hiểu thêm, hãy xem tài liệu TensorRT chính thức của NVIDIA và tổng quan chuyên sâu về TensorRT của chúng tôi.
Có, bạn có thể xuất model YOLO26 bằng TensorRT với lượng tử hóa INT8. Quy trình này bao gồm lượng tử hóa sau huấn luyện (PTQ) và hiệu chuẩn, trừ khi checkpoint được huấn luyện với
quantize=8(huấn luyện nhận biết lượng tử hóa); trong trường hợp đó, các khoảng giá trị có sẵn trong checkpoint sẽ được xuất mà không cần hiệu chuẩn:-
Xuất với INT8:
from ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="engine", batch=8, workspace=4, quantize=8, data="coco.yaml") -
Chạy suy luận:
from ultralytics import YOLO

model = YOLO("yolo26n.engine", task="detect")
result = model.predict("https://ultralytics.com/images/bus.jpg")
Để biết thêm chi tiết, hãy tham khảo phần xuất TensorRT với lượng tử hóa INT8.
-
Có thể triển khai model YOLO26 TensorRT trên NVIDIA Triton Inference Server bằng các tài nguyên sau:
- Triển khai Ultralytics YOLO26 với Triton Server: Hướng dẫn từng bước về cách thiết lập và sử dụng Triton Inference Server.
- Triển khai mạng nơ-ron sâu với NVIDIA TensorRT: Hướng dẫn của NVIDIA về triển khai model deep learning với TensorRT, cung cấp thông tin chi tiết về các tùy chọn và cấu hình triển khai.
Các hướng dẫn này sẽ giúp bạn tích hợp hiệu quả model YOLO26 trong nhiều môi trường triển khai.
Mức cải thiện hiệu suất với TensorRT có thể khác nhau tùy theo model và phần cứng được sử dụng. Sau đây là các benchmark điển hình được đo bằng YOLOv8n, minh họa mức tăng tương đối ứng với từng độ chính xác:
-
NVIDIA A100:
- Suy luận FP32: ~0.52 ms / ảnh
- Suy luận FP16: ~0.34 ms / ảnh
- Suy luận INT8: ~0.28 ms / ảnh
- Độ chính xác mAP giảm nhẹ với INT8, nhưng tốc độ được cải thiện đáng kể.
-
GPU phổ thông (ví dụ: RTX 3080):
- Suy luận FP32: ~1.06 ms / ảnh
- Suy luận FP16: ~0.62 ms / ảnh
- Suy luận INT8: ~0.52 ms / ảnh
Có thể xem benchmark hiệu suất chi tiết cho các cấu hình phần cứng khác nhau trong phần hiệu suất.
Để có thông tin toàn diện hơn về hiệu suất TensorRT, hãy tham khảo tài liệu Ultralytics và các báo cáo phân tích hiệu suất của chúng tôi.
-