Chiến lược thu thập và gán nhãn dữ liệu cho thị giác máy tính
Thu thập dữ liệu và gán nhãn là hai bước nền tảng của mọi dự án thị giác máy tính: bạn thu thập ảnh hoặc video đại diện, sau đó gán nhãn để model có thể học từ chúng. Chất lượng dữ liệu này quyết định trực tiếp hiệu suất model; vì vậy, cần xác định class, thu thập dữ liệu không thiên lệch và gán nhãn nhất quán trước khi bắt đầu huấn luyện.
Xem: Cách xây dựng chiến lược thu thập và gán nhãn dữ liệu hiệu quả cho thị giác máy tính 🚀
Hướng dẫn này trình bày cách thiết lập lớp và thu thập dữ liệu, gán nhãn dữ liệu là gì cùng các loại và định dạng gán nhãn để lựa chọn, cũng như chiến lược gán nhãn hiệu quả — mọi quyết định đều gắn với mục tiêu dự án của bạn.
Thiết lập lớp và thu thập dữ liệu#
Việc thu thập hình ảnh và video cho dự án thị giác máy tính gồm ba quyết định: xác định bao nhiêu lớp, lấy dữ liệu từ đâu và làm thế nào để tránh thiên lệch trong dataset.
Chọn lớp phù hợp cho dự án#
Một trong những câu hỏi đầu tiên khi bắt đầu dự án thị giác máy tính là nên có bao nhiêu lớp. Bạn cần xác định các đối tượng thuộc lớp nào, tức là những danh mục hoặc nhãn mà bạn muốn model nhận diện và phân biệt. Số lượng lớp nên được xác định dựa trên mục tiêu cụ thể của dự án.
Ví dụ, nếu muốn giám sát giao thông, các lớp có thể gồm "ô tô", "xe tải", "xe buýt", "xe máy" và "xe đạp". Ngược lại, nếu muốn theo dõi mặt hàng trong cửa hàng, các lớp có thể là "trái cây", "rau củ", "đồ uống" và "đồ ăn nhẹ". Xác định lớp dựa trên mục tiêu dự án giúp dataset luôn phù hợp và tập trung.
Khi xác định lớp, một điểm khác biệt quan trọng cần cân nhắc là chọn số lượng lớp ở mức khái quát hay chi tiết. 'Số lượng lớp' là số lớp riêng biệt mà bạn quan tâm. Quyết định này ảnh hưởng đến mức độ chi tiết của dữ liệu và độ phức tạp của model. Dưới đây là những điểm cần cân nhắc cho từng cách tiếp cận:
- Số lượng lớp khái quát: Đây là các danh mục rộng và bao quát hơn, chẳng hạn như "phương tiện" và "không phải phương tiện". Cách này đơn giản hóa việc gán nhãn và cần ít tài nguyên tính toán hơn, nhưng cung cấp ít thông tin chi tiết hơn, có thể hạn chế hiệu quả của model trong các tình huống phức tạp.
- Số lượng lớp chi tiết: Có nhiều danh mục hơn với sự phân biệt cụ thể hơn, chẳng hạn như "sedan", "SUV", "xe bán tải" và "xe máy". Cách này ghi nhận thông tin chi tiết hơn, cải thiện độ chính xác và hiệu suất của model. Tuy nhiên, việc gán nhãn tốn nhiều thời gian và công sức hơn, đồng thời đòi hỏi thêm tài nguyên tính toán.
Bắt đầu với các lớp cụ thể hơn có thể rất hữu ích, đặc biệt trong các dự án phức tạp cần chú ý đến chi tiết. Các lớp cụ thể hơn giúp bạn thu thập dữ liệu chi tiết hơn, có được insight sâu hơn và phân biệt rõ ràng hơn giữa các danh mục. Cách này không chỉ cải thiện độ chính xác của model mà còn giúp điều chỉnh model dễ dàng hơn về sau nếu cần, tiết kiệm cả thời gian lẫn tài nguyên.
Nguồn dữ liệu#
Bạn có thể sử dụng dataset công khai hoặc tự thu thập dữ liệu tùy chỉnh. Các dataset công khai như trên Kaggle và Google Dataset Search Engine cung cấp dữ liệu được gán nhãn tốt và chuẩn hóa, là điểm khởi đầu phù hợp để huấn luyện và đánh giá model.
Ngược lại, việc thu thập dữ liệu tùy chỉnh cho phép bạn thiết kế dataset theo nhu cầu cụ thể. Bạn có thể chụp ảnh và quay video bằng camera hoặc drone, thu thập hình ảnh từ web hoặc sử dụng dữ liệu nội bộ sẵn có của tổ chức. Dữ liệu tùy chỉnh giúp bạn kiểm soát tốt hơn chất lượng và mức độ phù hợp của dữ liệu. Kết hợp cả nguồn dữ liệu công khai và tùy chỉnh sẽ giúp tạo dataset đa dạng và toàn diện.
Tránh thiên lệch trong thu thập dữ liệu#
Thiên lệch xảy ra khi một số nhóm hoặc tình huống không được đại diện đầy đủ hoặc bị đại diện quá mức trong dataset. Điều này khiến model hoạt động tốt trên một số dữ liệu nhưng kém trên những dữ liệu khác. Điều quan trọng là tránh thiên lệch trong AI để model thị giác máy tính có thể hoạt động tốt trong nhiều tình huống.
Sau đây là cách tránh thiên lệch khi thu thập dữ liệu:
- Nguồn đa dạng: Thu thập dữ liệu từ nhiều nguồn để ghi nhận các góc nhìn và tình huống khác nhau.
- Đại diện cân bằng: Đảm bảo đại diện cân bằng cho mọi nhóm liên quan. Ví dụ, hãy cân nhắc các độ tuổi, giới tính và sắc tộc khác nhau.
- Giám sát liên tục: Thường xuyên rà soát và cập nhật dataset để nhận diện và xử lý các thiên lệch mới phát sinh.
- Kỹ thuật giảm thiểu thiên lệch: Sử dụng các phương pháp như tăng mẫu cho lớp chưa được đại diện đầy đủ, tăng cường dữ liệu và thuật toán có xét đến tính công bằng.
Thực hiện các phương pháp này giúp tạo ra model mạnh mẽ và công bằng hơn, có khả năng tổng quát hóa tốt trong các ứng dụng thực tế.
Gán nhãn dữ liệu là gì?#
Gán nhãn dữ liệu là quá trình dán nhãn cho dữ liệu để có thể dùng dữ liệu đó huấn luyện model machine learning. Trong thị giác máy tính, điều này có nghĩa là gán nhãn cho hình ảnh hoặc video bằng thông tin mà model cần học. Nếu dữ liệu không được gán nhãn đúng cách, model không thể học chính xác mối quan hệ giữa đầu vào và đầu ra.
Các loại gán nhãn dữ liệu#
Tùy theo yêu cầu cụ thể của tác vụ thị giác máy tính, có nhiều loại gán nhãn dữ liệu khác nhau. Sau đây là một số ví dụ:
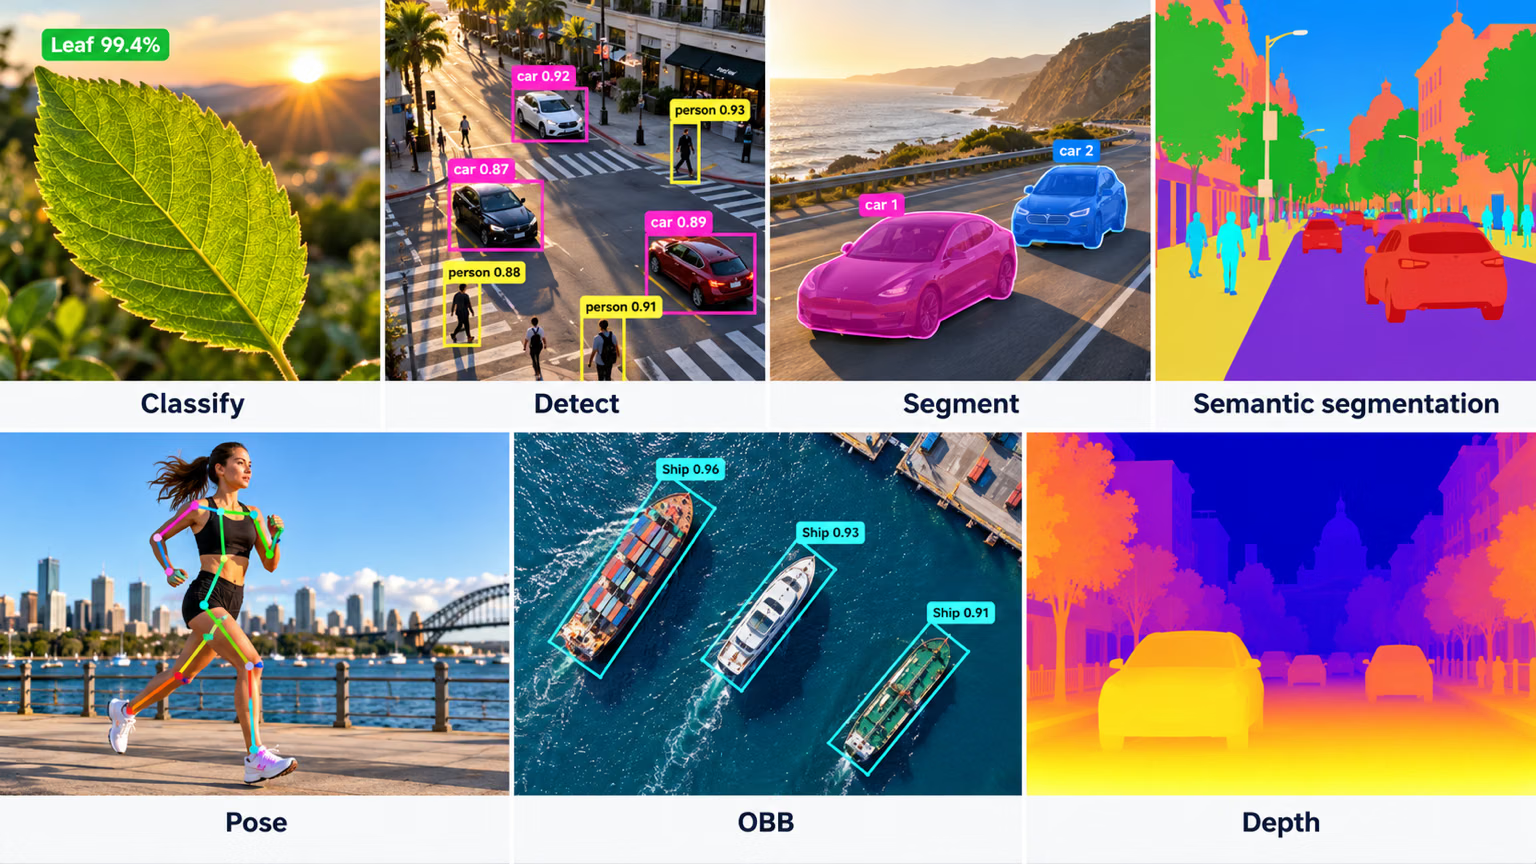
- Bounding box: Các khung chữ nhật được vẽ quanh đối tượng trong ảnh, chủ yếu dùng cho tác vụ phát hiện đối tượng. Các khung này được xác định bằng tọa độ góc trên bên trái và góc dưới bên phải.
- Đa giác: Đường viền chi tiết của đối tượng, cho phép gán nhãn chính xác hơn bounding box. Đa giác được dùng trong các tác vụ như phân đoạn instance, khi hình dạng đối tượng rất quan trọng.
- Mask: Mask nhị phân trong đó mỗi pixel thuộc về đối tượng hoặc nền. Mask được dùng trong các tác vụ phân đoạn ngữ nghĩa để cung cấp thông tin chi tiết ở cấp pixel.
- Keypoint: Các điểm cụ thể được đánh dấu trong ảnh để xác định vị trí cần quan tâm. Keypoint được dùng trong các tác vụ như ước tính pose và phát hiện landmark khuôn mặt.
- Bounding box định hướng: Các hình chữ nhật có góc xoay, được dùng trong tác vụ OBB khi đối tượng xuất hiện ở nhiều hướng tùy ý, chẳng hạn như trong ảnh chụp từ trên không.
Các định dạng gán nhãn phổ biến#
Sau khi chọn loại gán nhãn, điều quan trọng là chọn định dạng phù hợp để lưu trữ và chia sẻ nhãn. Các định dạng phổ biến nhất gồm:
| Định dạng | Cấu trúc file | Thường dùng cho |
|---|---|---|
| COCO | Một file JSON | Phát hiện đối tượng, phân đoạn instance, phát hiện keypoint, phân đoạn stuff và phân đoạn toàn cảnh, tạo chú thích ảnh |
| Pascal VOC | Một file XML cho mỗi ảnh | Phát hiện đối tượng |
| YOLO | Một file .txt cho mỗi ảnh | Phát hiện đối tượng, phân đoạn, pose và bounding box định hướng |
Định dạng YOLO lưu một hàng cho mỗi đối tượng, với chỉ số class bắt đầu từ 0. Với tác vụ phát hiện đối tượng, hàng có dạng class x_center y_center width height cùng tọa độ chuẩn hóa trong khoảng 0–1. Hàng phân đoạn thay box bằng các điểm polygon chuẩn hóa của đối tượng, còn hàng pose giữ nguyên box và thêm tọa độ keypoint phía sau, cùng một cờ hiển thị cho mỗi keypoint khi dataset khai báo kpt_shape: [n, 3]. Hàng OBB lưu class x1 y1 x2 y2 x3 y3 x4 y4 bằng tọa độ góc đã chuẩn hóa.
Nếu công cụ gán nhãn của bạn export COCO JSON, bạn có thể chuyển đổi sang nhãn YOLO .txt hoặc huấn luyện trực tiếp trên JSON bằng lớp dataset tùy chỉnh.
Thiết lập hướng dẫn gán nhãn#
Sau khi chọn loại và định dạng gán nhãn, bước tiếp theo là thiết lập các quy tắc gán nhãn rõ ràng, khách quan. Những quy tắc này đóng vai trò định hướng để đảm bảo tính nhất quán và độ chính xác trong suốt quá trình gán nhãn. Các khía cạnh chính của những quy tắc này gồm:
- Rõ ràng và chi tiết: Đảm bảo hướng dẫn dễ hiểu. Dùng ví dụ và hình minh họa để cho thấy kết quả mong đợi.
- Nhất quán: Duy trì sự đồng nhất giữa các nhãn. Đặt tiêu chí chuẩn cho việc gán nhãn các loại dữ liệu khác nhau để mọi nhãn đều tuân theo cùng một quy tắc.
- Giảm thiên lệch: Giữ thái độ trung lập. Rèn luyện tính khách quan và giảm thiểu thiên kiến cá nhân để đảm bảo nhãn công bằng.
- Hiệu quả: Sử dụng các công cụ và quy trình tự động hóa những tác vụ lặp lại, giúp quá trình gán nhãn nhanh hơn và hiệu quả hơn.
Thường xuyên rà soát và cập nhật quy tắc gán nhãn sẽ giúp nhãn luôn chính xác, nhất quán và phù hợp với mục tiêu dự án.
Công cụ gán nhãn#
Một công cụ gán nhãn tốt cho phép bạn gán nhãn mọi loại dữ liệu mà tác vụ yêu cầu, đảm bảo tuân thủ hướng dẫn nhất quán và export nhãn ở định dạng sẵn sàng cho huấn luyện. Ultralytics Platform cung cấp trình chỉnh sửa gán nhãn tích hợp, hỗ trợ phát hiện, phân đoạn instance, phân đoạn ngữ nghĩa, phân loại, pose và OBB; cùng với gán nhãn thông minh dựa trên SAM, biến một lần nhấp thành mask cho các tác vụ phát hiện, phân đoạn instance, phân đoạn ngữ nghĩa và OBB. Vì nhãn được lưu theo cấu trúc mà mỗi tác vụ yêu cầu — các hàng YOLO .txt cho các tác vụ không gian và thư mục lớp cho phân loại — dataset đã gán nhãn có thể được đưa thẳng vào quy trình huấn luyện mà không cần bước chuyển đổi.
Chất lượng gán nhãn: độ chính xác, precision và outlier#
Trước khi gán nhãn trên quy mô lớn, bạn nên hiểu về độ chính xác, precision, các ngoại lệ và kiểm soát chất lượng để tránh gán nhãn dữ liệu theo cách phản tác dụng.
Tìm hiểu về độ chính xác và precision#
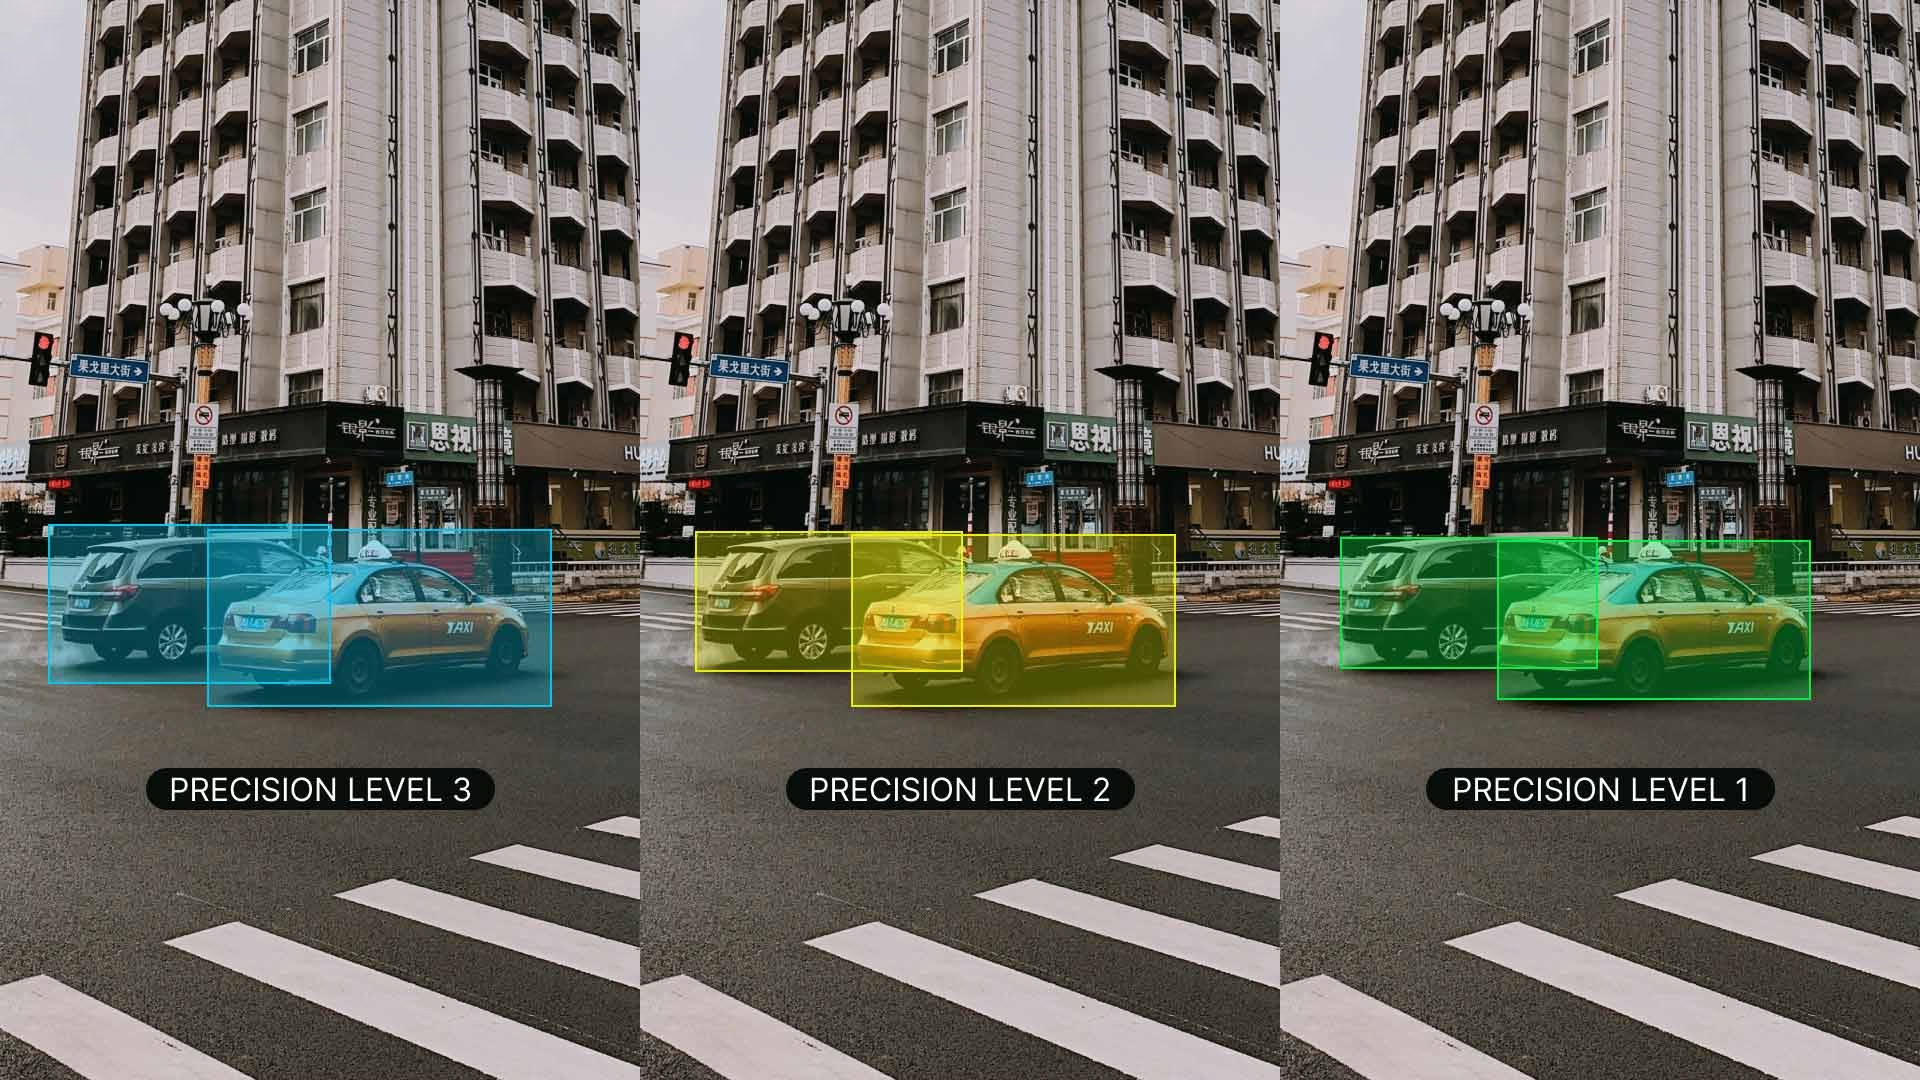
Điều quan trọng là hiểu sự khác biệt giữa độ chính xác và precision, cũng như mối liên hệ của chúng với việc gán nhãn. Độ chính xác cho biết dữ liệu được gán nhãn gần với giá trị thực đến mức nào. Chỉ số này giúp đánh giá mức độ nhãn phản ánh các tình huống thực tế. Precision cho biết tính nhất quán của nhãn, tức là liệu bạn có gán cùng một nhãn cho cùng một đối tượng hoặc đặc trưng trong toàn bộ dataset hay không. Độ chính xác và precision cao giúp huấn luyện model tốt hơn bằng cách giảm nhiễu và cải thiện khả năng tổng quát hóa từ dữ liệu huấn luyện.
Nhận diện outlier#
Outlier là các điểm dữ liệu khác biệt đáng kể so với những quan sát khác trong dataset. Trong ngữ cảnh gán nhãn, outlier có thể là ảnh được gán nhãn sai hoặc nhãn không phù hợp với phần còn lại của dataset. Outlier cần được lưu ý vì có thể làm sai lệch quá trình học của model, dẫn đến dự đoán không chính xác và khả năng tổng quát hóa kém.
Bạn có thể dùng nhiều phương pháp để phát hiện và xử lý outlier:
- Kỹ thuật thống kê: Để phát hiện outlier trong các đặc trưng số như giá trị pixel, tọa độ bounding box hoặc kích thước đối tượng, bạn có thể dùng các phương pháp như biểu đồ hộp, histogram hoặc z-score.
- Kỹ thuật trực quan: Để phát hiện bất thường trong các đặc trưng phân loại như lớp đối tượng, màu sắc hoặc hình dạng, hãy dùng các phương pháp trực quan như biểu diễn hình ảnh, nhãn hoặc heatmap.
- Phương pháp thuật toán: Sử dụng các công cụ như phân cụm (ví dụ: phân cụm K-means, DBSCAN) và các thuật toán phát hiện bất thường để xác định các ngoại lệ dựa trên những mẫu phân phối dữ liệu.
Kiểm soát chất lượng dữ liệu đã gán nhãn#
Cũng như các dự án kỹ thuật khác, kiểm soát chất lượng là yêu cầu bắt buộc đối với dữ liệu đã gán nhãn. Nên thường xuyên kiểm tra nhãn để đảm bảo tính chính xác và nhất quán. Có thể thực hiện việc này theo một số cách:
- Rà soát mẫu dữ liệu đã gán nhãn
- Sử dụng công cụ tự động để phát hiện lỗi thường gặp
- Nhờ người khác kiểm tra lại nhãn
Khi làm việc với nhiều người, tính nhất quán giữa các annotator là rất quan trọng. Mức độ đồng thuận giữa các annotator tốt cho thấy hướng dẫn rõ ràng và mọi người đều làm theo cùng một cách. Điều này giúp mọi người thống nhất cách làm và đảm bảo các annotation nhất quán.
Trong quá trình rà soát, nếu phát hiện lỗi, hãy sửa lỗi và cập nhật hướng dẫn để tránh lặp lại về sau. Cung cấp phản hồi cho annotator và tổ chức đào tạo thường xuyên để giúp giảm lỗi. Quy trình xử lý lỗi chặt chẽ giúp dataset luôn chính xác và đáng tin cậy.
Chiến lược gán nhãn dữ liệu hiệu quả#
Để quy trình gán nhãn dữ liệu diễn ra thuận lợi và hiệu quả hơn, hãy cân nhắc triển khai các chiến lược sau:
- Hướng dẫn gán nhãn rõ ràng: Cung cấp chỉ dẫn chi tiết kèm ví dụ để đảm bảo tất cả người gán nhãn diễn giải nhiệm vụ nhất quán. Chẳng hạn, khi gán nhãn chim, hãy nêu rõ cần bao gồm toàn bộ con chim hay chỉ một số bộ phận cụ thể.
- Kiểm tra chất lượng định kỳ: Thiết lập các tiêu chuẩn và sử dụng những metric cụ thể để rà soát công việc, duy trì tiêu chuẩn cao thông qua phản hồi liên tục.
- Sử dụng công cụ tiền gán nhãn: Nhiều nền tảng gán nhãn hiện đại cung cấp tính năng tiền gán nhãn có AI hỗ trợ, giúp tăng tốc đáng kể quy trình bằng cách tự động tạo nhãn ban đầu để con người tinh chỉnh.
- Triển khai Active Learning: Phương pháp này ưu tiên gán nhãn các mẫu giàu thông tin nhất trước, nhờ đó giảm tổng số annotation cần thiết mà vẫn duy trì hiệu suất của model.
- Xử lý theo lô: Nhóm các ảnh tương tự lại với nhau để gán nhãn, duy trì tính nhất quán và nâng cao hiệu quả.
Các chiến lược này có thể giúp duy trì chất lượng nhãn cao, đồng thời giảm thời gian và tài nguyên cần thiết cho quy trình gán nhãn.
Kết luận#
Thu thập dữ liệu đa dạng, không thiên lệch và gán nhãn nhất quán bằng các công cụ phù hợp là nền tảng cho một model thị giác máy tính đáng tin cậy. Sau khi thu thập và gán nhãn dataset, hãy tiếp tục với hướng dẫn các bước thực hiện một dự án thị giác máy tính để chuyển sang huấn luyện và đánh giá. Nếu có thắc mắc trong quá trình thực hiện, hãy hỏi cộng đồng tại kho lưu trữ Ultralytics trên GitHub hoặc máy chủ Ultralytics trên Discord.
Câu hỏi thường gặp#
Để giảm thiểu thiên lệch, hãy thu thập dữ liệu từ nhiều nguồn đa dạng, đảm bảo đại diện cân bằng cho tất cả các nhóm liên quan (chẳng hạn như các độ tuổi, giới tính và sắc tộc khác nhau), thường xuyên rà soát và cập nhật dataset để phát hiện thiên lệch mới xuất hiện, đồng thời áp dụng các kỹ thuật giảm thiểu như tăng mẫu cho các lớp ít được đại diện, tăng cường dữ liệu và thuật toán chú trọng tính công bằng. Tránh thiên lệch theo cách này giúp model thị giác máy tính hoạt động tốt trong nhiều tình huống thực tế khác nhau và cải thiện khả năng khái quát hóa.
Thiết lập hướng dẫn gán nhãn rõ ràng, khách quan với chỉ dẫn, ví dụ và hình minh họa chi tiết, sau đó áp dụng đồng nhất cho mọi loại dữ liệu để mỗi nhãn tuân theo cùng một quy tắc. Đào tạo người gán nhãn giữ thái độ trung lập để giảm thiên lệch cá nhân, thường xuyên rà soát và cập nhật hướng dẫn, đồng thời sử dụng các bước kiểm tra tính nhất quán tự động cùng phản hồi giữa những người gán nhãn để duy trì độ chính xác cao và phù hợp với mục tiêu dự án.
Vài trăm đối tượng được gán nhãn cho mỗi lớp là đủ để bắt đầu thử nghiệm transfer learning, nhưng để đạt hiệu suất đáng tin cậy trong thực tế, Ultralytics khuyến nghị ít nhất 1.500 ảnh và 10.000 instance được gán nhãn cho mỗi lớp. Kết hợp dataset đủ lớn với lịch huấn luyện hợp lý — khoảng 300 epoch là điểm khởi đầu phổ biến, giảm số epoch nếu model overfit sớm — và đảm bảo nhãn được tạo nghiêm ngặt, phù hợp với mục tiêu cụ thể của dự án. Tìm hiểu các chiến lược huấn luyện chi tiết trong hướng dẫn huấn luyện YOLO26.
Có. Ultralytics Platform tích hợp sẵn trình chỉnh sửa nhãn, hỗ trợ bounding box, polygon, keypoint, box định hướng và nhãn phân loại trong cùng một workspace. Tính năng gán nhãn thông minh bằng SAM giúp tăng tốc gán nhãn cho các tác vụ detection, phân đoạn instance, phân đoạn ngữ nghĩa và OBB bằng cách tạo mask chỉ với một lần nhấp; dataset pose có thể dùng model pose YOLO để gán nhãn thông minh, còn phân loại được gán nhãn thủ công. Nhãn được lưu theo cấu trúc mà từng tác vụ yêu cầu — các dòng YOLO
.txtcho các tác vụ không gian, thư mục lớp cho phân loại — sẵn sàng để huấn luyện.Chọn loại nhãn phù hợp với tác vụ bạn định huấn luyện. Bounding box là loại nhanh nhất để vẽ và đáp ứng mọi nhu cầu của object detection. Polygon và mask tốn nhiều thời gian hơn đáng kể cho mỗi đối tượng, nhưng cần thiết cho phân đoạn instance khi cần xác định chính xác hình dạng của đối tượng. Keypoint phù hợp với ước lượng pose và phát hiện landmark, còn box định hướng phù hợp với tác vụ OBB, chẳng hạn như ảnh chụp từ trên không, nơi hình chữ nhật song song với trục sẽ bao gồm quá nhiều nền. Gán nhãn theo đúng tác vụ cụ thể cần thiết giúp công sức gán nhãn tương xứng với kết quả.


Bình luận16
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.
 Letícia Rama
Hello,
Has anyone worked with oriented object detection using a multisource dataset that combines satellite and UAV imagery?
I am currently developing a scientific project focused on oriented detection of fishing vessels. As part of this work, I conducted two systematic reviews: one covering existing oriented detection models and another covering publicly available datasets. So far, I have identified multisource datasets that combine imagery from multiple satellite platforms; however, I have not found datasets that explicitly integrate both satellite and UAV images.
I understand the importance of source diversity to mitigate dataset bias and improve model generalization. That said, I would appreciate insights from the community on whether combining UAV and satellite imagery might introduce excessive domain variability (e.g., differences in spatial resolution, viewing angles, and sensor characteristics), potentially hindering model training and convergence.
Any experiences, references, or best practices related to this type of multisource setup would be highly appreciated.
 Glenn JocherUltralytics
Great question—mixing UAV + satellite can increase domain shift (GSD/resolution, look-angle, sensor PSF), but it’s usually manageable if you control the dataset and evaluation: keep one unified, very explicit labeling policy (same object extent/rotation rules) and balanced sampling as described in our Data Collection and Annotation guide, then train with per-source “slice” validation (sat-only/UAV-only) and consider staged training (pretrain on the larger domain, then fine-tune on the smaller) rather than a single fully-mixed run; if you’re using Ultralytics YOLO for oriented detection, the OBB task docs cover the expected label format and training flow—feel free to share your planned split strategy and a couple example tiles (UAV + satellite) here and the team/community can sanity-check the setup.
1- Letícia Rama
Hi Glenn,
To be more specific,
I am using a pretrained yolo26 m obb to perform detection of a single class: ships of a particular type (fishing boats).
I have a dataset with satellite optical images collected from google earth pro counting 331 pairs of images/labels. The total number of instances is 5974. Images size are fixed at 4823 height x 8192 width. The bounding boxes have 0.075 height x 0.04 width (according to yolo train results). Resolution varies from very-low to very-high. The images were captured with an altitude between 200-400 meters.
I also have 21 very-high resolution images collected from UAV. Images size are fixed at 3072 height x 4096 width. The images were captured with an altitude of 120 meters.
I would like to test if incorporating UAV images in training data would improved the models hability to detect the objects.
From what you proposed, please confirm if I understood correctly:
- Should the train set be mixed (sat+UAV) and the validation set be separate (sat-only/UAV-only)?
- If so, is this separation configured the staged training you are refering? That is, pretrain with sat+UAV as the train set and sat-only as validation subset, and further fine-tune with the same train subset (sat+UAV) but now using the uav-only as the validation set?
Thanks
- Letícia Rama
OBS.: sorry, sometimes I wrote 'train subset', and 'validation subset' but all of them was supposed to be written as 'train set', and 'validation set'.
- Glenn JocherUltralytics
Your first interpretation is correct: compare a satellite-only baseline against mixed satellite+UAV training while keeping fixed, disjoint satellite-only and UAV-only evaluation sets. This is not staged training—changing only the validation set does not fine-tune the model. Staged training would first train on satellite data, then continue from that checkpoint using only the UAV training split with a lower learning rate, evaluating both domains afterward. With only 21 UAV images, split by original scene before tiling to prevent leakage, and consider grouped k-fold validation because a single UAV split will be unstable.
1 - Letícia Rama
Understood, thanks.
Sudharsanam-1
hello ! For detecting 31 Chinese symbols (16 true and 15 fake), how many classes should be used in the model? Is it more efficient to detect the true symbols using only true class , or should we also include the fake symbols as separate classes?
Team-Q-Botix
I’m working on Robocon 2026 (Kung Fu Quest) and using YOLO-seg for detecting KFS symbols — ancient Chinese oracle bone characters. There are 15 true symbols, 15 fake ones (random patterns mimicking the real ones), plus 1 “other” class → total 31 classes.
Do you think instance segmentation (YOLOv8-seg / YOLOv11-seg) is the right approach for these detailed 2D symbols, or would box detection + contour refinement be better? Also, any advice on which model to start with and how large a dataset (per class) you’d recommend for good mask performance on Jetson Orin?
robert-hardman
Hello In object recognition with YOLO11 If we label images by drawing polygons: When training, does YOLO11 convert polygon coordinates to boxes? How does Inference handle polygon coordinates?
- Glenn JocherUltralytics
@robert-hardman yOLO11 does not inherently convert polygon annotations to bounding boxes during training. Polygons are used directly for tasks like instance segmentation, while bounding boxes are utilized for object detection. During inference, polygon annotations are retained for segmentation tasks, ensuring accurate object shape representation. For more on annotation types, refer to Data Annotation Guide.
1
ghost
Hello, thanks for the info ! I would like to know how to perform active learning, specifically what are the metrics to choose the most informative images when the task is multi-instance multi-class object detection ?
 Paula DerrengerUltralytics(đã chỉnh sửa)
@cawilchesp hello! Great question on active learning for multi-instance multi-class object detection. Active learning can significantly enhance your model by iteratively selecting the most informative samples for annotation. Here are some key metrics and strategies to consider:
Metrics for Selecting Informative Images:
-
Uncertainty Sampling: Choose images where the model is least confident. This can be measured using:
- Entropy: High entropy indicates uncertainty in predictions.
- Margin Sampling: Select samples where the difference between the top two class probabilities is smallest.
- Least Confidence: Select samples with the lowest maximum class probability.
-
Diversity Sampling: Ensure a diverse set of samples to avoid redundancy.
- Core-Set Selection: Use clustering techniques to select a diverse subset of data points.
- Representative Sampling: Choose samples that represent the overall data distribution.
-
Error-Based Sampling: Focus on samples where the model previously made errors.
- Misclassified Samples: Select images where the model's predictions were incorrect.
- High Loss Samples: Choose samples with high loss values during training.
Implementing Active Learning:
Here's a basic example using least-confidence uncertainty sampling for detection, based on each image's mean box confidence (
result.probsis only available for classification models):import numpy as np from ultralytics import YOLO # Load your model model = YOLO('yolo26n.pt') # Predict on a batch of images results = model(['image1.jpg', 'image2.jpg', 'image3.jpg']) # Mean box confidence per image (0 if nothing was detected) scores = [r.boxes.conf.mean().item() if len(r.boxes) else 0.0 for r in results] # Select the image with the lowest confidence most_informative_image = results[int(np.argmin(scores))]Additional Resources:
For more detailed strategies and examples, you can refer to our Data Collection and Annotation Strategies.
Feel free to experiment with these methods and see which works best for your specific use case. If you have any further questions or need more examples, don't hesitate to ask! 😊
-
MoAbbasid
Hello, Im looking for an open source annotation tool similar to labelme that exports directly to YOLOv8 format, something other than labelme?
- Glenn JocherUltralytics
@MoAbbasid hello! For an open-source annotation tool that exports directly to YOLOv8 format, you might want to try CVAT. It's quite versatile and supports exporting annotations directly into YOLO format among others. Another good option could be Label Studio, which offers flexibility in configuring export formats, including YOLO. Both tools provide robust features for efficient data labeling and are well-suited for various annotation tasks. Happy annotating! 😊
1 @glenn-jocher do they offer polygon annotations for instance segmentation?
- Glenn JocherUltralytics(đã chỉnh sửa)
Hello @MoAbbasid,
Yes, Ultralytics YOLO does support polygon annotations for instance segmentation. This allows for more precise labeling of objects compared to traditional bounding boxes, which can be particularly useful for complex shapes and detailed segmentation tasks.
To create polygon annotations, you can use tools like Roboflow Annotate or CVAT. Both of these tools support polygon annotations and can export the data in a format compatible with Ultralytics YOLO.
Here's a brief overview of how you can use Roboflow for this purpose:
- Create a Project: Start by creating a new project in Roboflow.
- Upload Images: Upload your images to the project.
- Annotate Images: Use the polygon tool to draw detailed outlines around objects. Roboflow also offers a SAM-based label assistant to speed up the annotation process.
- Export Annotations: Once your annotations are complete, you can export the dataset in YOLO format.
For more detailed steps on using Roboflow for data annotation and management, you can refer to the Roboflow documentation.
Here's a quick example of how to load and use a dataset with polygon annotations:
from ultralytics import YOLO

# Load a YOLO26 segmentation model
model = YOLO('yolo26n-seg.pt')

# Train the model on your custom dataset
model.train(data='path/to/your/dataset.yaml', epochs=100, imgsz=640)

# Validate the model
metrics = model.val()

# Make predictions
results = model.predict(source='path/to/your/images')

# Visualize results
results[0].show()
Feel free to reach out if you have any more questions or need further assistance. Happy annotating! 😊
1