Mẹo để đạt kết quả huấn luyện YOLOv5 tốt nhất
Hướng dẫn này giải thích cách đạt mAP và kết quả huấn luyện tốt nhất với YOLOv5.
Trong hầu hết trường hợp, có thể đạt kết quả tốt mà không cần thay đổi model hoặc thiết lập huấn luyện, miễn là dataset đủ lớn và được gắn nhãn tốt. Nếu ban đầu chưa đạt kết quả tốt, bạn có thể thực hiện một số bước để cải thiện; tuy nhiên, chúng tôi luôn khuyến nghị người dùng huấn luyện trước bằng toàn bộ thiết lập mặc định rồi mới cân nhắc thay đổi. Việc này giúp thiết lập mức hiệu năng cơ sở và xác định các điểm cần cải thiện.
Nếu bạn có câu hỏi về kết quả huấn luyện, hãy cung cấp càng nhiều thông tin càng tốt để nhận được câu trả lời hữu ích, bao gồm biểu đồ kết quả (loss train, loss val, P, R, mAP), đường cong PR, ma trận nhầm lẫn, mosaic huấn luyện, kết quả kiểm thử và ảnh thống kê dataset như labels.png. Tất cả đều nằm trong thư mục project/name, thường là yolov5/runs/train/exp.
Các phần dưới đây trình bày những yếu tố chính ảnh hưởng đến kết quả huấn luyện YOLOv5.
Dataset#
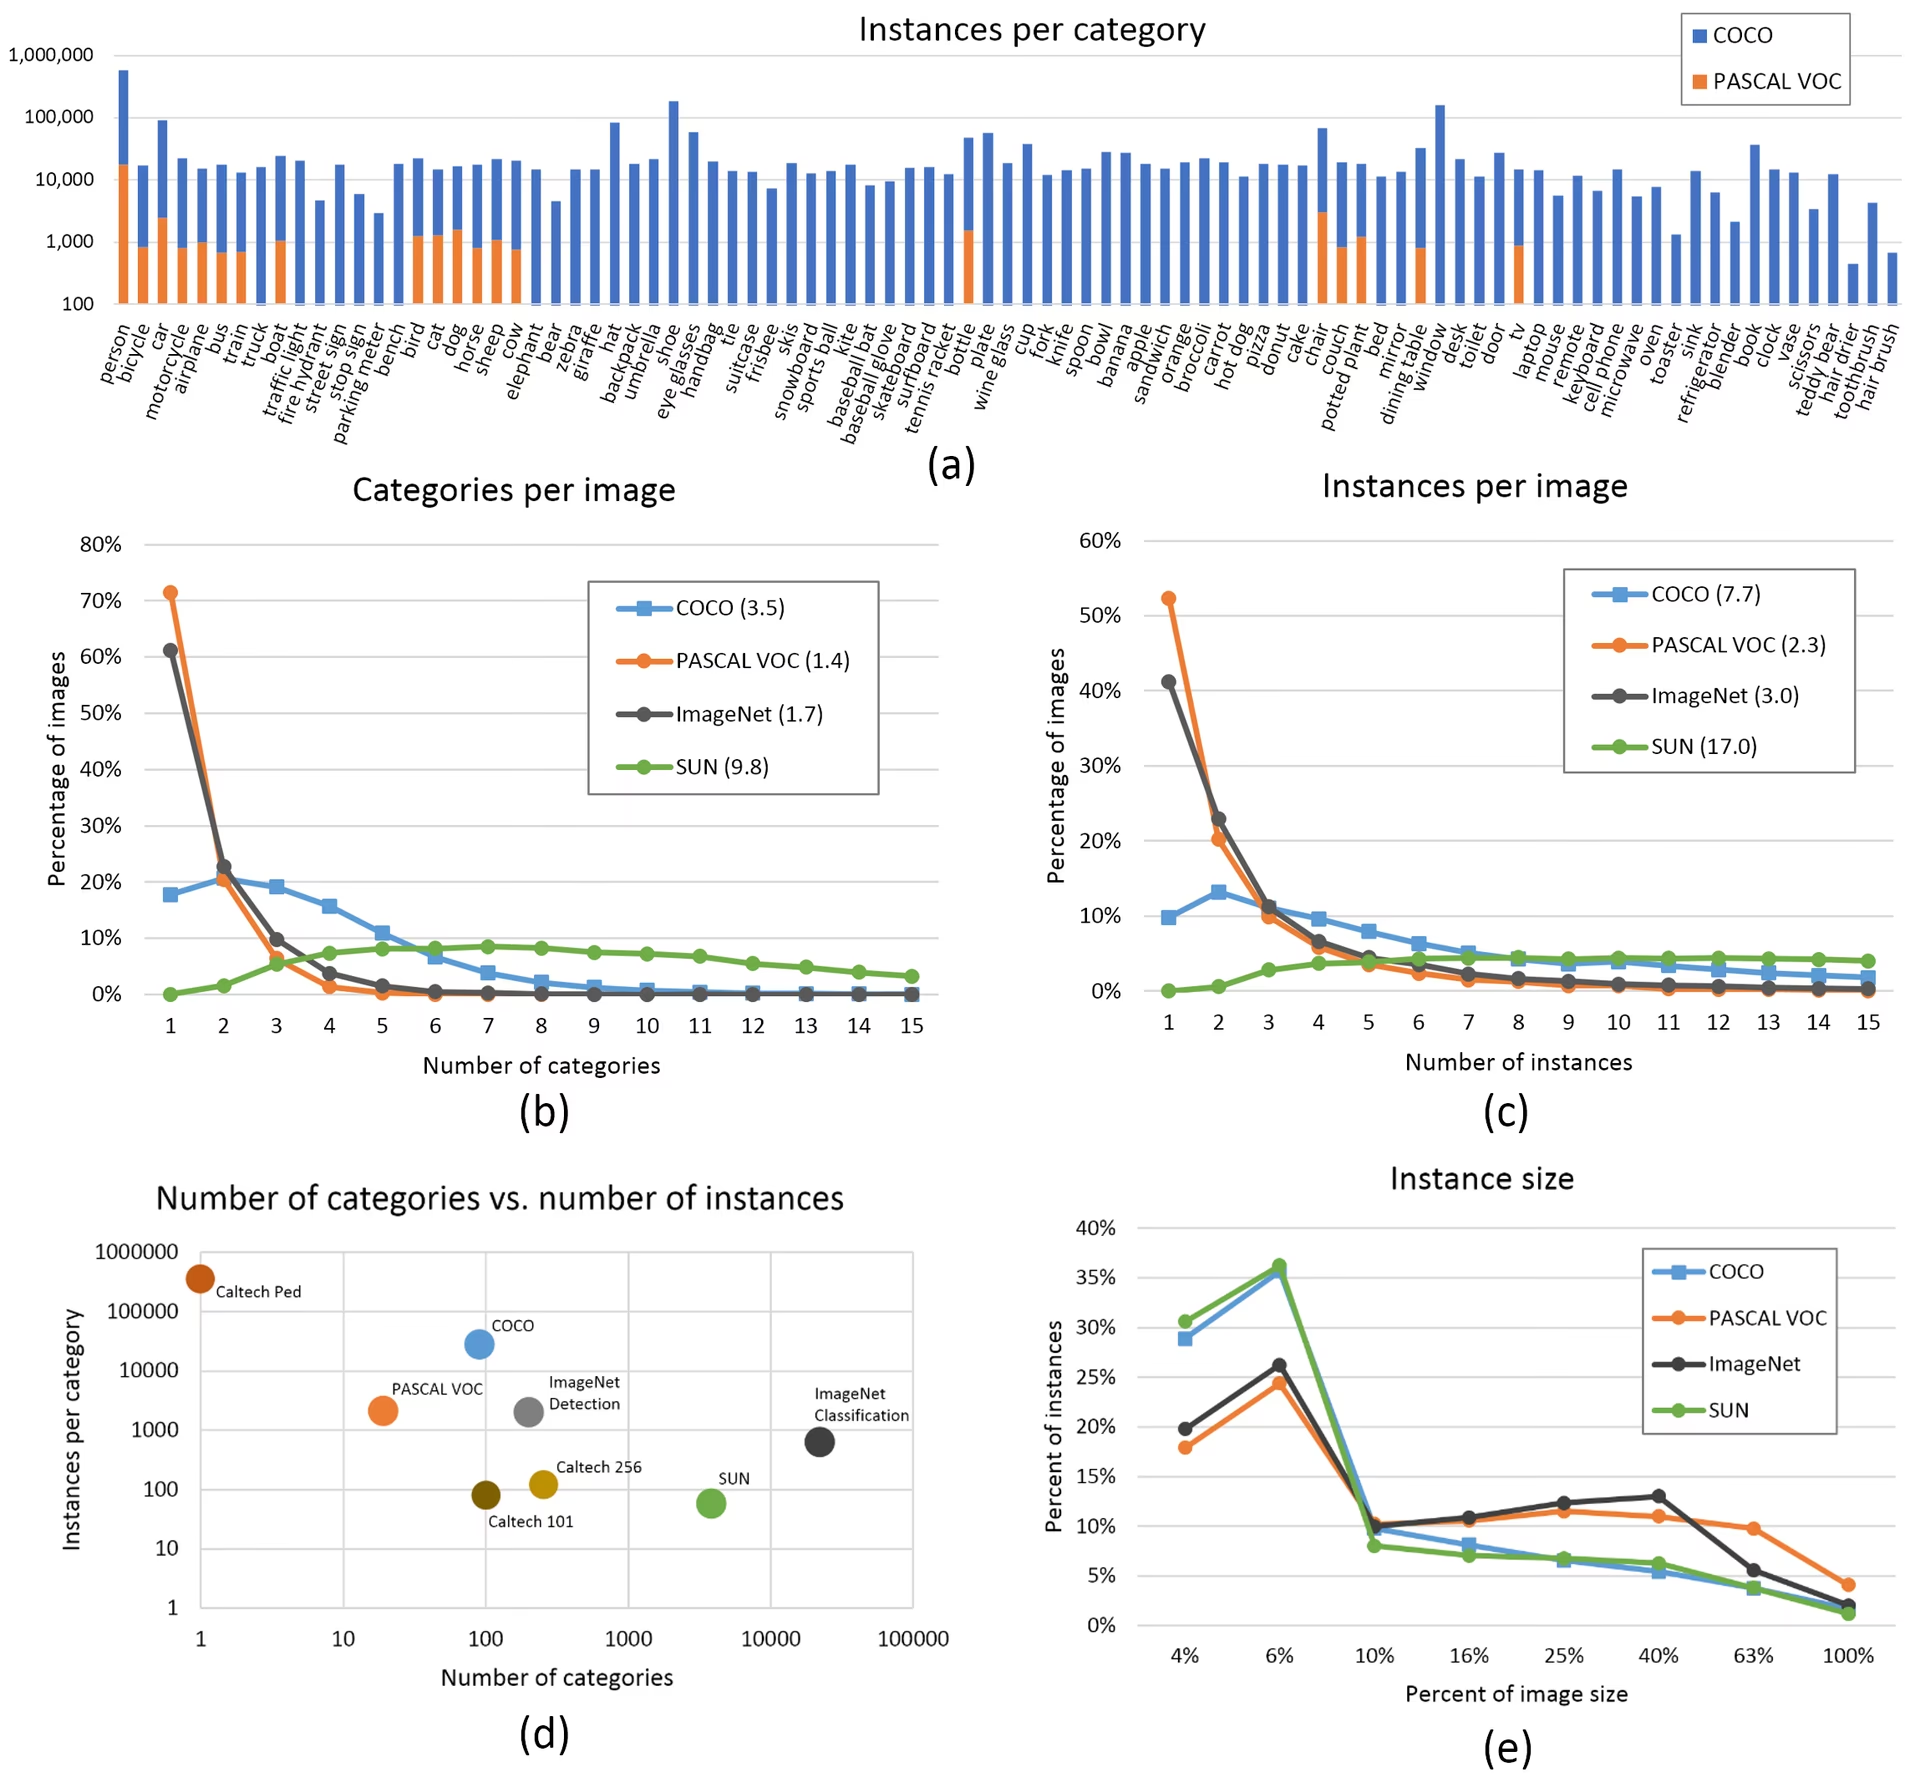
- Số hình ảnh mỗi class. Khuyến nghị ≥ 1500 hình ảnh mỗi class
- Số instance mỗi class. Khuyến nghị ≥ 10000 instance (đối tượng được gán nhãn) mỗi class
- Độ đa dạng hình ảnh. Hình ảnh phải đại diện cho môi trường triển khai. Với các trường hợp sử dụng thực tế, chúng tôi khuyến nghị dùng hình ảnh chụp vào các thời điểm khác nhau trong ngày, ở các mùa khác nhau, trong điều kiện thời tiết, ánh sáng, góc chụp và nguồn khác nhau (thu thập trên mạng, thu thập tại chỗ, từ các camera khác nhau), v.v.
- Tính nhất quán của nhãn. Phải gán nhãn tất cả instance của mọi class trong tất cả hình ảnh. Gán nhãn không đầy đủ sẽ không hiệu quả.
- Độ chính xác của nhãn. Nhãn phải bao sát từng đối tượng. Không được có khoảng trống giữa đối tượng và bounding box của đối tượng. Không được bỏ sót nhãn của bất kỳ đối tượng nào.
- Tuân thủ phân chia train/val. Đảm bảo hình ảnh validation và test không bao giờ xuất hiện trong tập train để tránh metric quá lạc quan. Duy trì phân bố class tương tự giữa các tập.
- Xác minh nhãn. Xem các ảnh mosaic
train_batch*.jpgkhi bắt đầu huấn luyện để xác minh nhãn hiển thị chính xác. - Hình ảnh nền. Hình ảnh nền là hình ảnh không có đối tượng, được thêm vào dataset để giảm số dương tính giả (FP). Chúng tôi khuyến nghị khoảng 0-10% hình ảnh nền để giúp giảm FP (COCO có 1000 hình ảnh nền làm mốc tham khảo, chiếm 1% tổng số). Hình ảnh nền không cần nhãn.
Lựa chọn model#
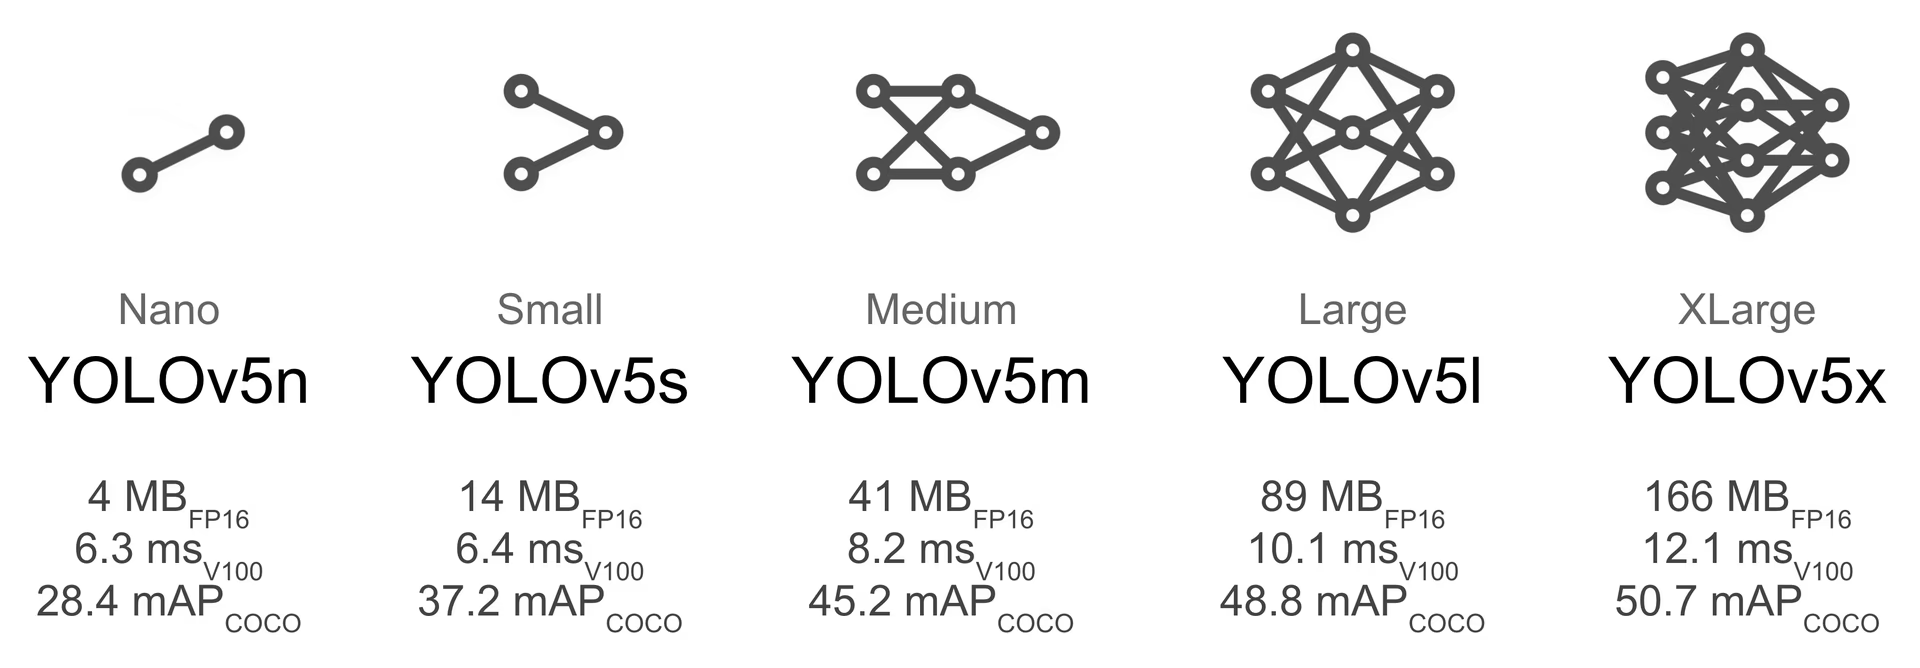
Các model lớn hơn như YOLOv5x và YOLOv5x6 sẽ cho kết quả tốt hơn trong hầu hết trường hợp, nhưng có nhiều parameter hơn, cần nhiều bộ nhớ CUDA hơn để huấn luyện và chạy chậm hơn. Với triển khai di động, chúng tôi khuyến nghị YOLOv5s/m; với triển khai cloud, chúng tôi khuyến nghị YOLOv5l/x.
-
Bắt đầu từ trọng số pretrained. Khuyến nghị cho dataset cỡ nhỏ đến trung bình (ví dụ: VOC, VisDrone, GlobalWheat). Truyền tên model vào tham số
--weights. Model sẽ tự động được tải từ bản phát hành YOLOv5 mới nhất.python train.py --data custom.yaml --weights yolov5s.pt python train.py --data custom.yaml --weights yolov5m.pt python train.py --data custom.yaml --weights yolov5l.pt python train.py --data custom.yaml --weights yolov5x.pt python train.py --data custom.yaml --weights custom_pretrained.pt -
Bắt đầu từ đầu. Khuyến nghị cho dataset lớn (ví dụ: COCO, Objects365, OIv6). Truyền YAML kiến trúc model bạn cần cùng tham số
--weights ''rỗng:python train.py --data custom.yaml --weights '' --cfg yolov5s.yaml python train.py --data custom.yaml --weights '' --cfg yolov5m.yaml python train.py --data custom.yaml --weights '' --cfg yolov5l.yaml python train.py --data custom.yaml --weights '' --cfg yolov5x.yaml
Thiết lập huấn luyện#
Trước khi sửa đổi bất kỳ điều gì, hãy huấn luyện trước bằng thiết lập mặc định để thiết lập mốc hiệu năng. Có thể tìm thấy danh sách đầy đủ các thiết lập của train.py trong bộ phân tích tham số train.py.
- Epoch. Bắt đầu với 300 epoch. Nếu xảy ra overfit sớm, bạn có thể giảm số epoch. Nếu không xảy ra overfit sau 300 epoch, hãy huấn luyện lâu hơn, chẳng hạn 600 hoặc 1200 epoch.
- Kích thước ảnh. COCO được huấn luyện ở độ phân giải gốc
--img 640, nhưng do dataset có nhiều đối tượng nhỏ nên có thể cải thiện khi huấn luyện ở độ phân giải cao hơn như--img 1280. Nếu có nhiều đối tượng nhỏ, dataset tùy chỉnh sẽ có lợi khi huấn luyện ở độ phân giải gốc hoặc cao hơn. Kết quả suy luận tốt nhất đạt được ở cùng--imgnhư khi huấn luyện; ví dụ, nếu huấn luyện ở--img 1280, bạn cũng nên kiểm thử và phát hiện ở--img 1280. - Batch size. Dùng
--batch-sizelớn nhất mà phần cứng của bạn hỗ trợ. Batch size nhỏ tạo ra thống kê batch normalization kém và nên tránh. Bạn có thể dùng--batch-size -1để tự động chọn batch size tối ưu cho GPU. - Learning rate. Lịch learning rate mặc định hoạt động tốt trong hầu hết trường hợp. Để hội tụ nhanh hơn, bạn có thể thử dùng flag
--cos-lrnhằm bật lịch learning rate cosine, giảm dần learning rate theo đường cong cosine qua các epoch. - Tăng cường dữ liệu. YOLOv5 tích hợp nhiều kỹ thuật augmentation như mosaic, kết hợp nhiều hình ảnh huấn luyện. Điều chỉnh mức độ augmentation thông qua hyperparameter
mosaictrong file--hypđể giúp ổn định quá trình huấn luyện. - Hyperparameter. Hyperparameter mặc định nằm trong hyp.scratch-low.yaml. Chúng tôi khuyến nghị trước tiên huấn luyện với hyperparameter mặc định rồi mới cân nhắc sửa đổi. Nhìn chung, tăng hyperparameter augmentation sẽ giảm và trì hoãn overfitting, cho phép huấn luyện lâu hơn và đạt mAP cuối cùng cao hơn. Giảm hyperparameter gain của thành phần loss như
hyp['obj']sẽ giúp giảm overfitting ở chính các thành phần loss đó. Để tối ưu các hyperparameter này tự động, xem Hướng dẫn tiến hóa hyperparameter của chúng tôi. - Huấn luyện độ chính xác hỗn hợp. YOLOv5 tự động bật Độ chính xác hỗn hợp tự động (AMP) khi phát hiện GPU được hỗ trợ, giúp tăng tốc huấn luyện và giảm mức sử dụng bộ nhớ mà không làm giảm độ chính xác của model.
- Huấn luyện đa GPU. Nếu có nhiều GPU, hãy khởi chạy huấn luyện DistributedDataParallel bằng
python -m torch.distributed.run --nproc_per_node 4 train.py ... --device 0,1,2,3để giảm đáng kể thời gian huấn luyện. - Dừng sớm. Dùng
--patience 50để dừng huấn luyện nếu metric validation không cải thiện trong 50 epoch, giúp tiết kiệm thời gian và ngăn overfitting.
Kỹ thuật tối ưu hóa nâng cao#
- Học chuyển giao. Với dataset chuyên biệt, hãy bắt đầu bằng trọng số pretrained và tùy chọn đóng băng các layer bằng
--freezeđể điều chỉnh model cho tác vụ cụ thể. - Cắt tỉa model. Sau khi huấn luyện, hãy cân nhắc cắt tỉa model để đưa các trọng số dư thừa về 0 mà ít làm giảm độ chính xác, sau đó triển khai model bằng runtime nhận biết độ thưa để tăng tốc.
- Kết hợp model. Với các ứng dụng quan trọng, hãy huấn luyện nhiều model với cấu hình khác nhau rồi kết hợp các dự đoán để cải thiện độ chính xác.
- Tăng cường dữ liệu lúc kiểm thử. Bật TTA khi suy luận bằng
--augmentđể cải thiện độ chính xác dự đoán bằng cách gộp dự đoán từ các phiên bản ảnh đầu vào được lật và thay đổi tỷ lệ.
Đọc thêm#
Nếu muốn tìm hiểu thêm, một điểm khởi đầu hữu ích là A Recipe for Training Neural Networks của Karpathy, tài liệu trình bày các ý tưởng huấn luyện có thể áp dụng rộng rãi trong mọi lĩnh vực ML.
Chúc bạn may mắn, và hãy cho chúng tôi biết nếu bạn còn câu hỏi nào khác.
Câu hỏi thường gặp#
Model của bạn có thể bị overfitting nếu loss huấn luyện tiếp tục giảm trong khi loss validation bắt đầu tăng. Hãy theo dõi mAP validation — nếu chỉ số này chững lại hoặc giảm trong khi loss huấn luyện tiếp tục cải thiện, đó là dấu hiệu overfitting. Các giải pháp bao gồm bổ sung dữ liệu huấn luyện, tăng cường data augmentation hoặc áp dụng các kỹ thuật regularization.
Batch size tối ưu phụ thuộc vào bộ nhớ GPU. Batch size lớn hơn thường cung cấp thống kê batch normalization tốt hơn và giúp huấn luyện ổn định hơn. Hãy dùng batch size lớn nhất mà phần cứng có thể xử lý mà không hết bộ nhớ. Bạn có thể dùng
--batch-size -1để tự động xác định batch size tối ưu cho cấu hình của mình.Để tăng tốc quá trình huấn luyện, hãy thử: sử dụng nhiều GPU với DDP, cache dataset bằng
--cachevà tối ưu batch size (mixed precision được tự động bật trên các GPU được hỗ trợ). Bạn cũng có thể cân nhắc dùng biến thể model nhỏ hơn như YOLOv5s nếu độ chính xác tuyệt đối không phải yêu cầu thiết yếu.
Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.