Tiến hóa siêu tham số cho YOLOv5#
📚 Hướng dẫn này giải thích về tiến hóa siêu tham số cho YOLOv5 🚀. Tiến hóa siêu tham số là phương pháp Tối ưu hóa siêu tham số sử dụng Thuật toán di truyền (GA) để tối ưu hóa.
Các siêu tham số trong machine learning kiểm soát nhiều khía cạnh của quá trình huấn luyện, và việc tìm ra các giá trị tối ưu có thể là một thách thức. Các phương pháp truyền thống như tìm kiếm lưới có thể nhanh chóng trở nên không khả thi do:
- Không gian tìm kiếm có số chiều lớn
- Các mối tương quan chưa biết giữa các chiều
- Chi phí đánh giá độ thích nghi tại mỗi điểm cao
Điều này khiến thuật toán di truyền trở thành lựa chọn phù hợp để tìm kiếm siêu tham số.
Trước khi bắt đầu#
Clone repository và cài đặt requirements.txt trong môi trường Python>=3.8.0, bao gồm PyTorch>=1.8. Model và dataset được tự động tải xuống từ bản phát hành YOLOv5 mới nhất.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
1. Khởi tạo siêu tham số#
YOLOv5 có khoảng 30 siêu tham số được sử dụng cho nhiều thiết lập huấn luyện. Các siêu tham số này được định nghĩa trong các file *.yaml thuộc thư mục /data/hyps. Giá trị khởi tạo tốt hơn sẽ tạo ra kết quả cuối cùng tốt hơn, vì vậy cần khởi tạo các giá trị này đúng cách trước khi tiến hóa. Nếu chưa chắc chắn, chỉ cần dùng các giá trị mặc định, vốn được tối ưu cho việc huấn luyện YOLOv5 trên COCO từ đầu.
# YOLOv5 🚀 by Ultralytics, AGPL-3.0 license
# Hyperparameters for low-augmentation COCO training from scratch
# python train.py --batch 64 --cfg yolov5n6.yaml --weights '' --data coco.yaml --img 640 --epochs 300 --linear
# See tutorials for hyperparameter evolution https://github.com/ultralytics/yolov5#tutorials

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.01 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
2. Xác định độ thích nghi#
Độ thích nghi là giá trị mà chúng ta muốn tối đa hóa. Trong YOLOv5, hàm độ thích nghi mặc định được định nghĩa là tổ hợp có trọng số của các metric: mAP@0.5 chiếm 10% trọng số và mAP@0.5:0.95 chiếm 90% còn lại, không bao gồm precision (P) và recall (R). Bạn có thể điều chỉnh các trọng số này theo nhu cầu hoặc dùng định nghĩa độ thích nghi mặc định trong utils/metrics.py (được khuyến nghị). Giá trị độ thích nghi này quyết định kết quả nào được lưu vào hyp_evolve.yaml; riêng thuật toán di truyền xếp hạng các cá thể bố mẹ và cá thể ưu tú chỉ dựa trên mAP@0.5, vì vậy thay đổi các trọng số này không làm thay đổi việc chọn cá thể bố mẹ.
def fitness(x):
    """Return model fitness as the sum of weighted metrics [P, R, mAP@0.5, mAP@0.5:0.95]."""
    w = [0.0, 0.0, 0.1, 0.9]  # trọng số cho [P, R, mAP@0.5, mAP@0.5:0.95]
    return (x[:, :4] * w).sum(1)
3. Tiến hóa#
Quá trình tiến hóa được thực hiện dựa trên một kịch bản cơ sở mà chúng ta muốn cải thiện. Trong ví dụ này, kịch bản cơ sở là tinh chỉnh COCO128 trong 10 epoch bằng YOLOv5s đã pretrained. Lệnh huấn luyện kịch bản cơ sở là:
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cacheĐể tiến hóa các siêu tham số riêng cho kịch bản này, bắt đầu từ các giá trị ban đầu được xác định trong Phần 1. và tối đa hóa hàm fitness được xác định trong Phần 2., hãy thêm --evolve:
# Single-GPU
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --evolve

# Multi-GPU with delay
for i in {0..7}; do
  sleep $((30 * i)) # 30-second delay (optional)
  echo "Starting GPU $i..."
  nohup python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log" &
done

# Continuous training (use with caution)
# for i in {0..7}; do
#   sleep $((30 * i))  # 30-second delay (optional)
#   echo "Starting continuous training on GPU $i..."
#   (
#     while true; do
#       python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log"
#     done
#   ) &
# done
Cấu hình tiến hóa mặc định chạy trong 300 thế hệ; mỗi thế hệ huấn luyện kịch bản cơ sở một lần cho từng cá thể trong quần thể gồm 50 cá thể. Bạn có thể sửa số thế hệ bằng đối số --evolve, ví dụ: python train.py --evolve 1000.
Các toán tử di truyền chính là lai ghép và đột biến. Mỗi thế hệ huấn luyện từng cá thể và chấm điểm cá thể đó bằng mAP@0.5, chọn bố mẹ bằng phương pháp chọn lọc giải đấu, đồng thời đưa các cá thể ưu tú có fitness cao nhất vào nhóm bố mẹ; sau đó tạo quần thể tiếp theo thông qua lai ghép và đột biến với các tỷ lệ thích ứng theo tiến trình tiến hóa. Kết quả được ghi vào runs/evolve/exp/evolve.csv, và cá thể con có fitness cao nhất được lưu ở mỗi thế hệ dưới dạng runs/evolve/exp/hyp_evolve.yaml:
# YOLOv5 Hyperparameter Evolution Results
# Best generation: 287
# Last generation: 300
#    metrics/precision,       metrics/recall,      metrics/mAP_0.5, metrics/mAP_0.5:0.95,         val/box_loss,         val/obj_loss,         val/cls_loss
#              0.54634,              0.55625,              0.58201,              0.33665,             0.056451,             0.042892,             0.013441

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.2 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
Để đạt kết quả tốt nhất, chúng tôi khuyến nghị tiến hóa ít nhất 300 thế hệ. Lưu ý rằng tiến hóa thường tốn kém và mất nhiều thời gian, vì kịch bản cơ sở được huấn luyện hàng nghìn lần, có thể cần hàng trăm hoặc hàng nghìn giờ GPU.
Khi quá trình tiến hóa kết thúc, hãy sử dụng lại các thiết lập đã tìm được bằng cách trỏ quá trình huấn luyện đến tệp đã lưu, chẳng hạn python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.
4. Trực quan hóa#
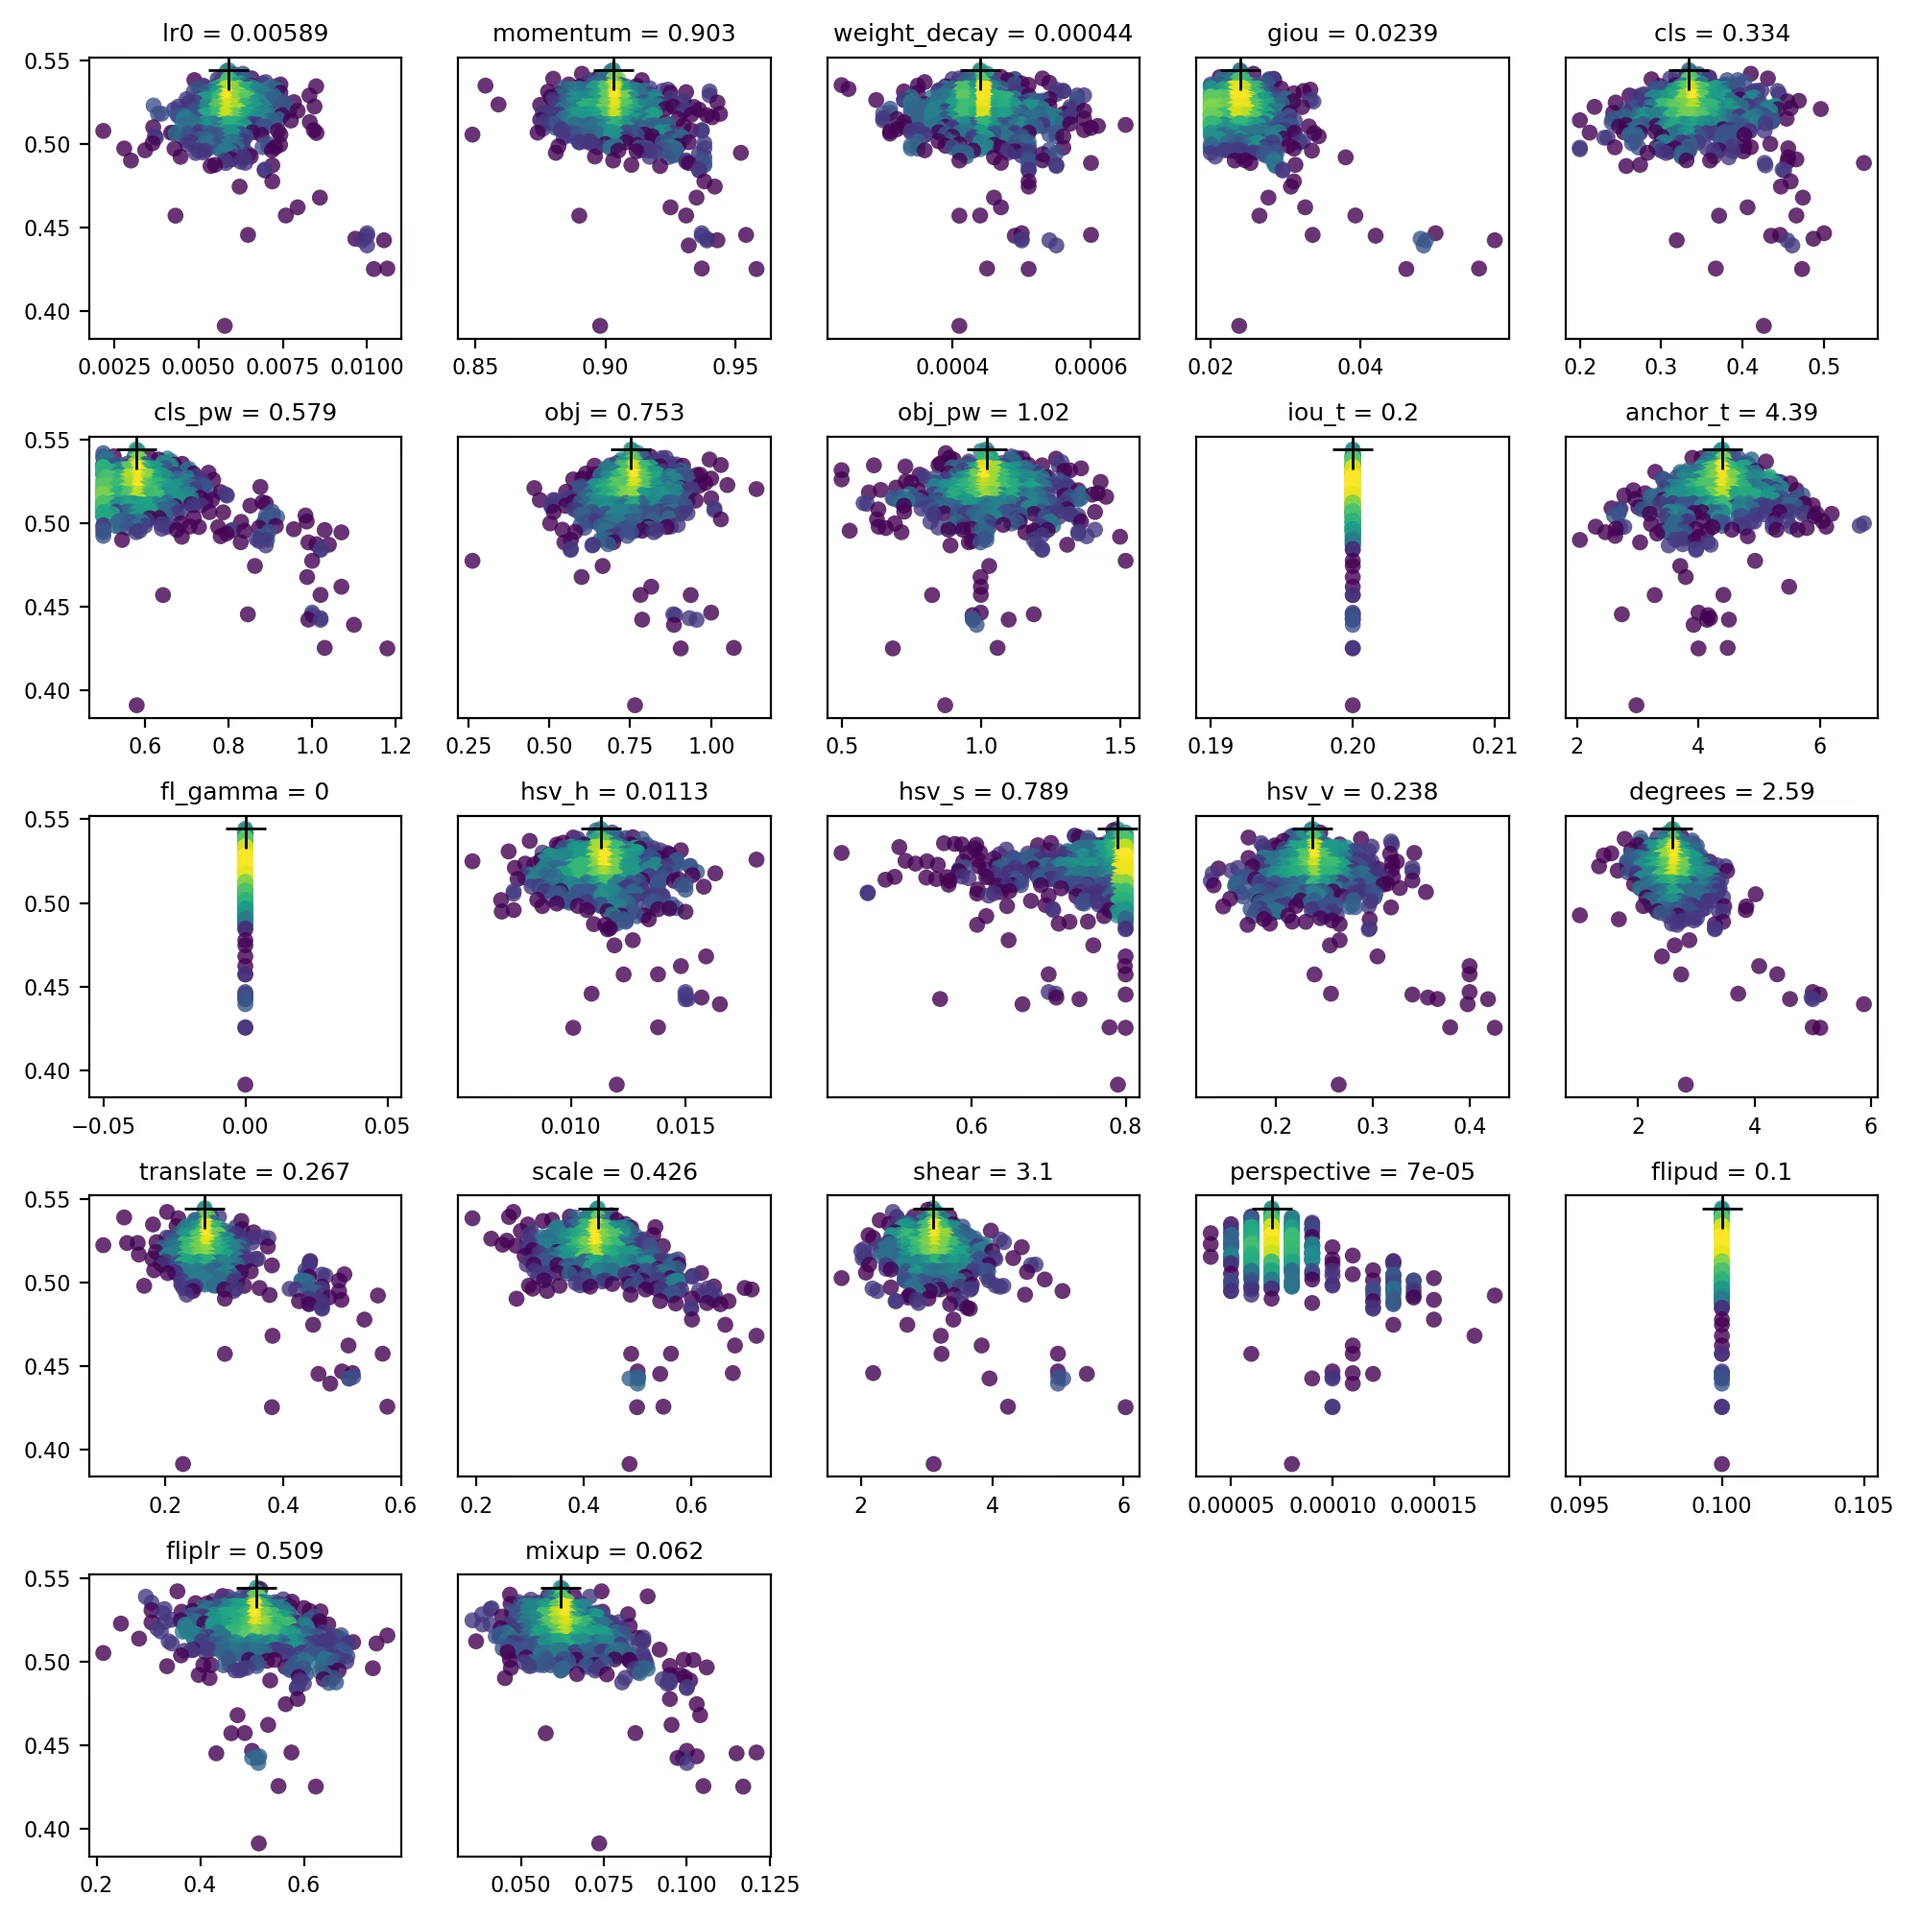
evolve.csv được biểu diễn dưới dạng evolve.png bằng utils.plots.plot_evolve() sau khi quá trình tiến hóa kết thúc. Biểu đồ có một ô con cho mỗi siêu tham số, thể hiện fitness (trục y) theo các giá trị siêu tham số (trục x). Màu vàng biểu thị mật độ cao hơn. Phân bố theo chiều dọc cho biết một tham số đã bị tắt và không đột biến. Người dùng có thể chọn thiết lập này trong dictionary meta của train.py; thiết lập này hữu ích để cố định tham số và ngăn tham số tiến hóa.
Môi trường được hỗ trợ#
Ultralytics cung cấp nhiều môi trường sẵn sàng sử dụng, mỗi môi trường được cài đặt sẵn các dependency thiết yếu như CUDA, CUDNN, Python và PyTorch, giúp bạn bắt đầu dự án nhanh chóng.
- Notebook GPU miễn phí:


- Google Cloud: Hướng dẫn bắt đầu nhanh với GCP
- Amazon: Hướng dẫn bắt đầu nhanh với AWS
- Azure: Hướng dẫn bắt đầu nhanh với AzureML
- Docker: Hướng dẫn bắt đầu nhanh với Docker

Trạng thái dự án#

Huy hiệu này cho biết tất cả bài kiểm thử Continuous Integration (CI) của GitHub Actions cho YOLOv5 đều đã chạy thành công. Các bài kiểm thử CI này kiểm tra nghiêm ngặt chức năng và hiệu năng của YOLOv5 trên nhiều khía cạnh chính: huấn luyện, validation, inference, export và benchmark. Các bài kiểm thử đảm bảo hoạt động nhất quán và đáng tin cậy trên macOS, Windows và Ubuntu; chúng được thực hiện mỗi 24 giờ và sau mỗi commit mới.
Câu hỏi thường gặp#
Mỗi thế hệ huấn luyện kịch bản cơ sở một lần cho từng cá thể trong quần thể 50 cá thể, vì vậy 300 thế hệ của một lượt chạy COCO128 10 epoch sẽ tốn khoảng gấp 15.000 lần một lượt chạy như vậy. Hãy giữ kịch bản cơ sở ngắn gọn và có tính đại diện. Vòng lặp đa GPU ở trên khởi chạy một lượt tìm kiếm độc lập trên mỗi GPU thay vì chia sẻ một lượt tìm kiếm, vì vậy hãy giảm
--evolvecho mỗi tiến trình nếu bạn cần giới hạn ngân sách cố định.Có.
--evolvemặc định là 300 thế hệ; hãy truyền một số như--evolve 1000để chạy nhiều thế hệ hơn.Đặt giá trị đầu tiên trong mục tương ứng của dictionary
metatrongtrain.pythànhFalse. Các tham số bị loại trừ sẽ giữ nguyên giá trị ban đầu và xuất hiện dưới dạng đường thẳng đứng trongevolve.png.Truyền tệp đã lưu vào một lượt huấn luyện thông thường:
python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.