Tích hợp ClearML#

Giới thiệu về ClearML#
ClearML là nền tảng MLOps mã nguồn mở, được xây dựng để tinh giản quy trình machine learning và tiết kiệm thời gian kỹ thuật.
- 🔨 Theo dõi mọi lượt huấn luyện YOLOv5 trong trình quản lý experiment.
- 🔧 Quản lý phiên bản và truy cập dữ liệu huấn luyện tùy chỉnh bằng công cụ quản lý phiên bản dữ liệu tích hợp của ClearML.
- 🔦 Huấn luyện và giám sát từ xa các lượt chạy YOLOv5 bằng ClearML Agent.
- 🔬 Tìm mAP tốt nhất bằng tối ưu hóa hyperparameter của ClearML.
- 🔭 Chuyển model YOLOv5 đã huấn luyện thành API chỉ bằng vài lệnh với ClearML Serving.
Sử dụng bao nhiêu công cụ tùy nhu cầu — bắt đầu chỉ với trình quản lý experiment hoặc kết hợp tất cả thành một pipeline hoàn chỉnh.
🦾 Thiết lập#
ClearML cần giao tiếp với máy chủ để theo dõi experiment và dữ liệu. Bạn có hai lựa chọn:
- Đăng ký dịch vụ lưu trữ ClearML miễn phí, hoặc
- Triển khai máy chủ ClearML của riêng bạn — vì là mã nguồn mở, đây vẫn là lựa chọn khả thi ngay cả với dữ liệu nhạy cảm.
Sau đó cài đặt package Python clearml và kết nối SDK với máy chủ:
pip install clearmlTạo thông tin xác thực tại Settings → Workspace → Create new credentials (góc trên bên phải giao diện ClearML), rồi chạy:
clearml-initLàm theo hướng dẫn. Vậy là xong — thiết lập đã hoàn tất.
🚀 Huấn luyện YOLOv5 với ClearML#
Để bật tính năng theo dõi experiment, hãy cài package ClearML pip nếu bạn chưa cài:
pip install clearmlThao tác này sẽ bật tích hợp với script huấn luyện YOLOv5. Từ giờ, mọi lượt huấn luyện sẽ được ghi nhận và lưu trữ bởi trình quản lý experiment ClearML.
Để tùy chỉnh tên project và task, hãy truyền --project và --name vào train.py. Giá trị mặc định là YOLOv5 và Training. ClearML dùng / làm dấu phân cách subproject, vì vậy hãy tránh dùng / trong tên project tùy chỉnh.
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheHoặc dùng tên tùy chỉnh:
python train.py --project my_project --name my_training --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheMỗi lượt chạy ghi nhận:
- Mã nguồn và các thay đổi chưa commit
- Các package đã cài đặt
- Hyperparameter
- Checkpoint của model (dùng
--save-period nđể lưu sau mỗinepoch) - Đầu ra console
- Các giá trị vô hướng (mAP_0.5, mAP_0.5:0.95, precision, recall, loss, learning rate)
- Thông tin máy, thời gian chạy và ngày tạo
- Các biểu đồ được tạo, chẳng hạn như biểu đồ tương quan nhãn và ma trận nhầm lẫn
- Hình ảnh có bounding box theo từng epoch
- Hình ảnh trực quan hóa Mosaic theo từng epoch
- Hình ảnh validation theo từng epoch
Mọi thông tin đều xuất hiện trong giao diện ClearML để bạn có thể theo dõi quá trình huấn luyện tại một nơi. Thêm các cột tùy chỉnh (ví dụ: mAP_0.5) để sắp xếp theo model có hiệu năng tốt nhất, hoặc chọn nhiều experiment để so sánh song song.
Đọc tiếp về tối ưu hóa hyperparameter và thực thi từ xa.
🔗 Quản lý phiên bản dataset#
Quản lý phiên bản dữ liệu riêng biệt với mã nguồn giúp dễ dàng lấy phiên bản mới nhất và đảm bảo khả năng tái lập đầy đủ. Repository này chấp nhận ID phiên bản dataset, tự động tải dữ liệu nếu dữ liệu chưa có và ghi ID làm tham số task để bạn luôn biết dữ liệu nào được dùng trong experiment nào.
Chuẩn bị dataset#
Repository YOLOv5 hỗ trợ nhiều dataset thông qua các file cấu hình YAML. Theo mặc định, dataset được tải xuống thư mục ../datasets tính từ thư mục gốc của repository. Sau khi tải xuống coco128, cấu trúc thư mục sẽ như sau:
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ LICENSE
        |_ README.txt
Bạn có thể dùng bất kỳ dataset nào, miễn là giữ nguyên cấu trúc này.
Tiếp theo, sao chép file YAML của dataset vào thư mục gốc của dataset — ClearML đọc file này để sử dụng dataset chính xác. Bạn có thể tự tạo YAML theo bố cục mẫu, đảm bảo file định nghĩa path, train, test, val, nc và names.
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ coco128.yaml  # <---- HERE
        |_ LICENSE
        |_ README.txt
Tải dataset lên#
Để đăng ký dataset dưới dạng dataset ClearML có quản lý phiên bản, hãy chuyển đến thư mục gốc của dataset rồi chạy:
cd ../datasets/coco128
clearml-data sync --project YOLOv5 --name coco128 --folder .
clearml-data sync là cách viết tắt của chuỗi lệnh sau; bạn cũng có thể chạy rõ từng lệnh:
# Add --parent <parent_dataset_id> to base this version on a previous one.
# Duplicate files are not re-uploaded.
clearml-data create --name coco128 --project YOLOv5
clearml-data add --files .
clearml-data close
Huấn luyện trên dataset ClearML#
Sau khi đăng ký dataset, hãy chỉ định ID dataset cho quá trình huấn luyện:
python train.py --img 640 --batch 16 --epochs 3 --data clearml://YOUR_DATASET_ID --weights yolov5s.pt --cache👀 Tối ưu hóa hyperparameter#
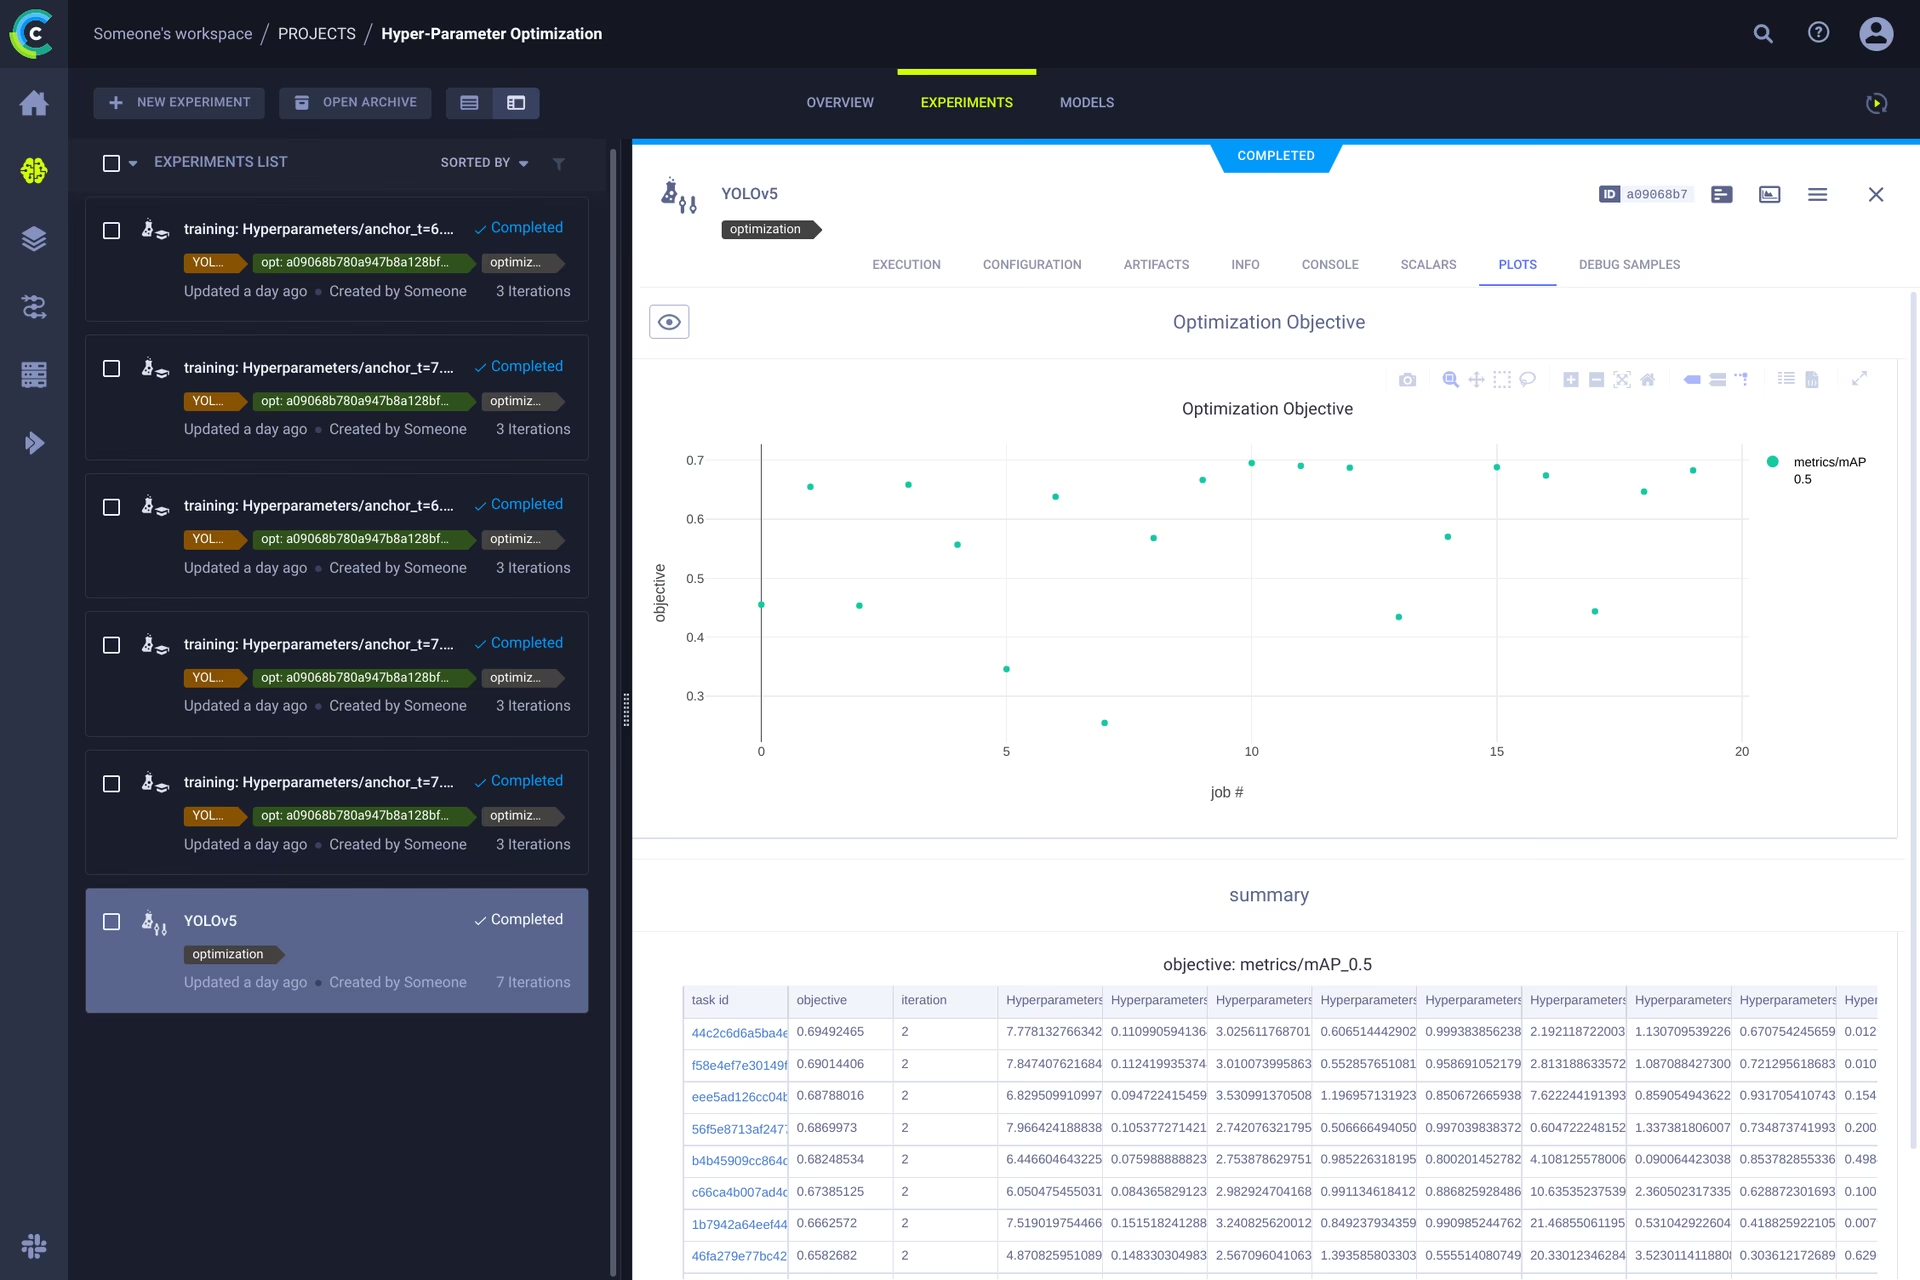
Khi experiment và dữ liệu đã được quản lý phiên bản, bạn có thể xây dựng dựa trên chúng. Vì mỗi experiment được theo dõi đều ghi nhận đầy đủ môi trường — mã nguồn, package đã cài đặt và cấu hình — nên các lượt chạy có thể tái lập hoàn toàn. ClearML cho phép bạn nhân bản một experiment, thay đổi tham số và tự động chạy lại; đây là nền tảng của tối ưu hóa hyperparameter (HPO).
Để chạy HPO cục bộ, hãy dùng script đi kèm. Trước tiên, hãy đảm bảo có task huấn luyện trong trình quản lý experiment — script sẽ nhân bản task đó và thay đổi các hyperparameter.
Điền ID task mẫu vào utils/loggers/clearml/hpo.py, sau đó chạy:
# Install Optuna or change the optimizer to RandomSearch.
pip install optuna
python utils/loggers/clearml/hpo.py
Để chạy các lượt thử nghiệm trên agent từ xa, hãy thay optimizer.start_locally() bằng optimizer.start() và đặt execution_queue trong lời gọi HyperParameterOptimizer thành queue mà các agent đang theo dõi.
🤯 Thực thi từ xa (nâng cao)#
Chạy HPO cục bộ rất tiện, nhưng bạn thường sẽ muốn chạy experiment trên phần cứng mạnh hơn — máy GPU tại chỗ hoặc một instance đám mây. Đây là vai trò của ClearML Agent:
Mỗi experiment được theo dõi đều chứa mọi thứ cần thiết để tái lập trên máy khác (package đã cài đặt, thay đổi chưa commit và cấu hình). ClearML Agent theo dõi một queue, nhận các task mới, tái tạo môi trường, chạy job và truyền các giá trị vô hướng cùng biểu đồ trở lại trình quản lý experiment.
Biến bất kỳ máy nào — VM trên đám mây, máy GPU cục bộ hoặc laptop — thành ClearML Agent bằng cách chạy:
clearml-agent daemon --queue QUEUES_TO_LISTEN_TO [--docker]Nhân bản, chỉnh sửa và đưa vào queue#
Khi agent đã chạy, bạn có thể giao việc trực tiếp từ giao diện:
- 🪄 Nhấp chuột phải vào một experiment và nhân bản experiment đó.
- 🎯 Chỉnh sửa hyperparameter của experiment.
- ⏳ Nhấp chuột phải vào task đã nhân bản và đưa task vào queue đích.
Thực thi task từ xa#
Bạn cũng có thể đánh dấu một script đang chạy để thực thi từ xa theo cách lập trình bằng cách thêm task.execute_remotely() sau khi khởi tạo ClearML logger. Thêm dòng được tô sáng vào train.py:
# ...
# Loggers
data_dict = None
if RANK in {-1, 0}:
    loggers = Loggers(save_dir=save_dir, weights=weights, opt=opt, hyp=hyp, logger=LOGGER)
    if loggers.clearml:
        loggers.clearml.task.execute_remotely(queue="my_queue")  # <------ THÊM DÒNG NÀY
    # ...
    # Xử lý liên kết artifact của dataset tùy chỉnh
    data_dict = loggers.remote_dataset
# ...
Sau thay đổi này, khi chạy script huấn luyện, quá trình sẽ thực thi đến dòng đó, đóng gói mã nguồn và gửi mã nguồn vào queue.
Tự động mở rộng worker#
ClearML đi kèm autoscaler, có thể khởi chạy máy từ xa trên AWS, GCP hoặc Azure khi queue có experiment đang chờ, chuyển các máy đó thành ClearML Agent và tắt máy khi hoàn tất công việc — nhờ vậy bạn chỉ trả phí cho tài nguyên tính toán đang thực sự chạy.
Xem video hướng dẫn bắt đầu bên dưới:
Tìm hiểu thêm#
Để biết thêm thông tin về cách tích hợp ClearML với các model Ultralytics, hãy xem hướng dẫn tích hợp ClearML và tìm hiểu cách cải thiện quy trình MLOps bằng các công cụ theo dõi experiment khác.
Câu hỏi thường gặp#
Không. Dịch vụ hosted miễn phí tại app.clear.ml hoạt động ngay sau khi
clearml-init. Tự host là tùy chọn và thường được chọn khi dữ liệu không thể rời khỏi mạng của bạn.YOLOv5 kích hoạt tích hợp bất cứ khi nào có thể import package
clearml, vì vậy hãy gỡ cài đặt package này bằngpip uninstall clearmlđể tắt tracking cho một lần chạy.Đăng ký dataset bằng
clearml-data sync, sau đó truyền ID của dataset làm đối số data:python train.py --data clearml://YOUR_DATASET_ID --weights yolov5s.pt. ID được ghi lại trong task để mỗi thử nghiệm biết chính xác dữ liệu đã sử dụng.Có. Khởi chạy
clearml-agent daemontrên mỗi máy, sau đó thêm các thử nghiệm đã clone vào hàng đợi từ giao diện người dùng hoặc chỉnh sửautils/loggers/clearml/hpo.pyđể gọioptimizer.start()vớiexecution_queueđược thiết lập, để bộ tối ưu hóa đẩy các lượt thử nghiệm vào hàng đợi.