Các phương pháp và mẹo hay nhất về Machine Learning để huấn luyện model
Giới thiệu#
Một trong những bước quan trọng nhất khi thực hiện dự án thị giác máy tính là huấn luyện model. Trước khi đến bước này, bạn cần xác định mục tiêu và thu thập, gán nhãn dữ liệu. Sau khi tiền xử lý dữ liệu để đảm bảo dữ liệu sạch và nhất quán, bạn có thể bắt đầu huấn luyện model.
Huấn luyện model là quá trình giúp model nhận diện các mẫu hình ảnh và đưa ra dự đoán từ dữ liệu; quá trình này tác động trực tiếp đến độ chính xác của ứng dụng. Hướng dẫn này trình bày các phương pháp hay nhất, kỹ thuật tối ưu hóa và mẹo khắc phục sự cố để giúp bạn huấn luyện hiệu quả các model thị giác máy tính.
Xem: Mẹo huấn luyện model | Cách xử lý dataset lớn | Batch size, mức sử dụng GPU và mixed precision
Cách huấn luyện model Machine Learning#
Model thị giác máy tính được huấn luyện bằng cách điều chỉnh các tham số bên trong để giảm thiểu lỗi. Ban đầu, model được cung cấp một tập lớn ảnh đã gán nhãn. Model dự đoán nội dung của các ảnh này, sau đó các dự đoán được so sánh với nhãn hoặc nội dung thực tế để tính lỗi. Các lỗi cho biết dự đoán của model sai lệch bao nhiêu so với giá trị thực.
Trong quá trình huấn luyện, model liên tục đưa ra dự đoán, tính lỗi và cập nhật tham số thông qua quy trình gọi là lan truyền ngược. Trong quy trình này, model điều chỉnh các tham số bên trong (weights và bias) để giảm lỗi. Lặp lại chu kỳ này nhiều lần giúp độ chính xác của model dần được cải thiện. Theo thời gian, model học cách nhận diện các mẫu phức tạp như hình dạng, màu sắc và kết cấu.
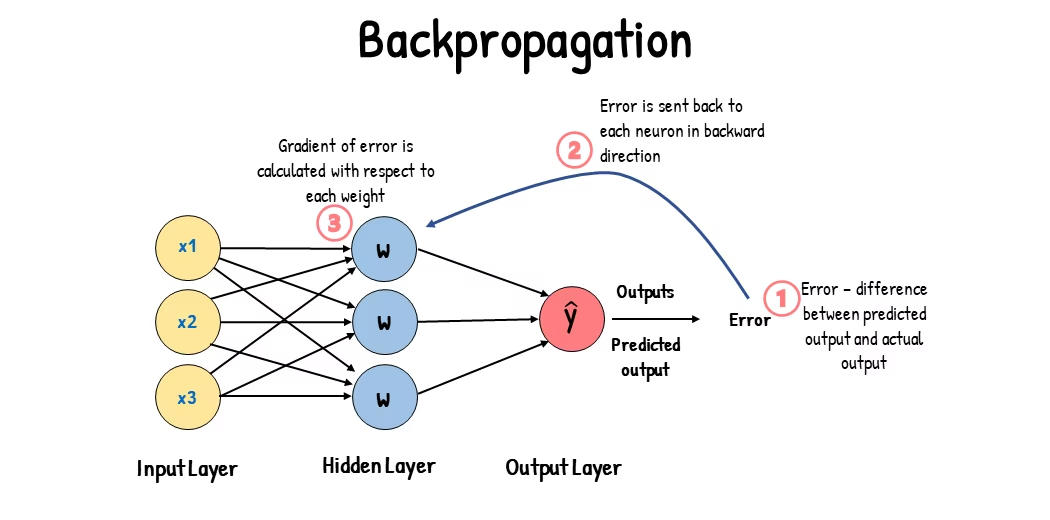
Quá trình học này cho phép model thị giác máy tính thực hiện nhiều tác vụ, bao gồm phát hiện đối tượng, phân đoạn instance, phân đoạn ngữ nghĩa và phân loại ảnh. Mục tiêu cuối cùng là tạo ra model có thể khái quát hóa những gì đã học sang các ảnh mới chưa từng thấy, từ đó hiểu chính xác dữ liệu hình ảnh trong các ứng dụng thực tế.
Giờ đã biết những gì diễn ra bên trong khi huấn luyện model, hãy cùng xem xét các điểm cần lưu ý khi huấn luyện model.
Huấn luyện trên dataset lớn#
Có một số khía cạnh cần cân nhắc khi dự định sử dụng dataset lớn để huấn luyện model. Ví dụ: bạn có thể điều chỉnh batch size, kiểm soát mức sử dụng GPU, chọn huấn luyện đa tỷ lệ, v.v. Hãy cùng tìm hiểu chi tiết từng tùy chọn.
Batch size và mức sử dụng GPU#
Khi huấn luyện model trên dataset lớn, việc sử dụng GPU hiệu quả là yếu tố then chốt. Batch size là một yếu tố quan trọng, biểu thị số lượng mẫu dữ liệu mà model Machine Learning xử lý trong một iteration huấn luyện. Sử dụng batch size lớn nhất mà GPU hỗ trợ giúp khai thác tối đa khả năng của GPU và giảm thời gian huấn luyện model. Tuy nhiên, cần tránh để GPU hết bộ nhớ. Nếu gặp lỗi bộ nhớ, hãy giảm dần batch size cho đến khi model huấn luyện ổn định.
Xem: Cách tăng tốc độ suy luận Ultralytics YOLO26 lên 2× bằng xử lý theo batch | Python & GPU | MLOps 🚀
Đối với YOLO26, bạn có thể đặt tham số batch trong các tham số chế độ Train để phù hợp với khả năng của GPU. Trên một bộ tăng tốc, batch=-1 phân tích model và chọn kích thước batch nhằm đạt mức sử dụng bộ nhớ khoảng 60%; một tỷ lệ như batch=0.70 sẽ nhắm đến mức sử dụng khác. Các lần chạy đa GPU yêu cầu đặt rõ ràng kích thước batch toàn cục ít nhất bằng số lượng thiết bị. Trên CPU và Apple silicon, AutoBatch đưa ra cảnh báo và chuyển về batch=16.
Huấn luyện trên tập con#
Huấn luyện trên tập con là một chiến lược thực tiễn, trong đó bạn huấn luyện model trên một tập dữ liệu nhỏ hơn nhưng đại diện cho dataset lớn. Cách này giúp tiết kiệm thời gian và tài nguyên, đặc biệt trong giai đoạn phát triển và kiểm thử model ban đầu. Nếu không có nhiều thời gian hoặc đang thử nghiệm các cấu hình model khác nhau, huấn luyện trên tập con là một lựa chọn phù hợp.
Đối với YOLO26, bạn có thể triển khai huấn luyện trên tập con bằng tham số fraction. Hãy dùng tỷ lệ như fraction=0.1 để chọn 10% dữ liệu huấn luyện, số nguyên như fraction=300 để chọn chính xác 300 ảnh huấn luyện, hoặc danh sách [train, val, test] như fraction=[300, 100, 0] để giới hạn từng tập và bỏ qua ảnh kiểm thử. Danh sách gồm hai phần tử như [300, 100] sẽ giữ nguyên toàn bộ tập kiểm thử. Dataset NDJSON chọn các bản ghi cách đều nhau trước khi tải xuống, vì vậy các lần chạy lặp lại sẽ dùng lại chính xác tập con đó. Dataset phân loại dạng thư mục ảnh cũng chọn các mẫu cách đều nhau. Với các dataset dạng thư mục ảnh khác, fraction chọn N ảnh đầu tiên theo thứ tự đường dẫn ảnh đã sắp xếp, chứ không chọn mẫu ngẫu nhiên; vì vậy, hãy tự chọn lọc các tập con khi thứ tự có thể khiến một số nguồn hoặc lớp bị loại trừ. Khi chuẩn bị các tập train/val, hãy giữ toàn bộ nhóm ảnh gần trùng lặp trong cùng một tập.
Huấn luyện đa tỷ lệ#
Huấn luyện đa tỷ lệ là kỹ thuật cải thiện khả năng khái quát hóa của model bằng cách huấn luyện trên ảnh có kích thước khác nhau. Model có thể học cách phát hiện đối tượng ở các tỷ lệ và khoảng cách khác nhau, nhờ đó trở nên mạnh mẽ hơn.
Khi huấn luyện YOLO26, bạn có thể bật scale augmentation bằng cách đặt tham số scale. Tham số này điều chỉnh kích thước ảnh huấn luyện theo hệ số chỉ định, mô phỏng đối tượng ở các khoảng cách khác nhau. Ví dụ, đặt scale=0.5 sẽ phóng to hoặc thu nhỏ ngẫu nhiên ảnh huấn luyện với hệ số từ 0.5 đến 1.5 trong quá trình huấn luyện. Cấu hình tham số này giúp model tiếp xúc với nhiều tỷ lệ ảnh khác nhau và cải thiện khả năng phát hiện đối tượng ở các kích thước cũng như tình huống khác nhau.
Ultralytics cũng hỗ trợ huấn luyện đa tỷ lệ theo kích thước ảnh thông qua tham số multi_scale. Khác với scale, vốn phóng to ảnh rồi padding/crop về imgsz, multi_scale thay đổi chính imgsz ở mỗi batch (được làm tròn theo stride của model). Ví dụ, với imgsz=640 và multi_scale=0.25, kích thước huấn luyện được lấy mẫu từ 480 đến 800 theo các bước stride (ví dụ: 480, 512, 544, ..., 800), trong khi multi_scale=0.0 giữ kích thước cố định.
Caching#
Caching là kỹ thuật quan trọng giúp tăng hiệu quả huấn luyện model Machine Learning. Lưu ảnh đã tiền xử lý trong bộ nhớ giúp giảm thời gian GPU chờ dữ liệu được tải từ đĩa. Model có thể liên tục nhận dữ liệu mà không bị chậm trễ do các thao tác I/O trên đĩa.
Có thể kiểm soát caching khi huấn luyện YOLO26 bằng tham số cache:
cache=True: Lưu ảnh dataset trong RAM, cho tốc độ truy cập nhanh nhất nhưng làm tăng mức sử dụng bộ nhớ.cache='disk': Lưu ảnh trên đĩa, chậm hơn RAM nhưng nhanh hơn tải dữ liệu mới mỗi lần.cache=False: Tắt caching, hoàn toàn dựa vào I/O trên đĩa; đây là tùy chọn chậm nhất.
Huấn luyện với độ chính xác hỗn hợp#
Huấn luyện mixed precision sử dụng cả kiểu số dấu phẩy động 16-bit (FP16) và 32-bit (FP32): FP16 để tính toán nhanh hơn và FP32 để duy trì độ chính xác khi cần. Hầu hết các phép toán của neural network được thực hiện bằng FP16 nhằm tận dụng tốc độ tính toán cao hơn và mức sử dụng bộ nhớ thấp hơn. Tuy nhiên, một bản sao chính của trọng số model được giữ ở FP32 để đảm bảo độ chính xác trong các bước cập nhật trọng số. Bạn có thể xử lý model lớn hơn hoặc batch size lớn hơn trong cùng giới hạn phần cứng.
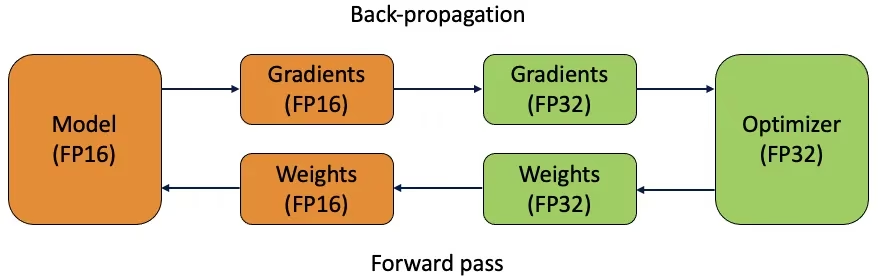
Để triển khai huấn luyện với độ chính xác hỗn hợp, bạn cần sửa đổi script huấn luyện và đảm bảo phần cứng (chẳng hạn GPU) hỗ trợ tính năng này. Nhiều framework deep learning hiện đại như PyTorch và TensorFlow có hỗ trợ sẵn độ chính xác hỗn hợp.
Huấn luyện mixed precision rất đơn giản khi dùng YOLO26: AMP đã được bật mặc định (amp=True). Trên GPU CUDA, YOLO kiểm tra khả năng một lần khi bắt đầu huấn luyện và chuyển về FP32 đầy đủ nếu kiểm tra thất bại; trên CPU và Apple silicon, AMP hoàn toàn không được sử dụng. Đặt amp=False để buộc dùng FP32 hoặc amp="bf16" để huấn luyện bằng bfloat16 trên GPU được hỗ trợ.
Weights pretrained#
Sử dụng trọng số pretrained là cách hiệu quả để tăng tốc quá trình huấn luyện model. Trọng số pretrained lấy từ các model đã được huấn luyện trên dataset lớn, giúp model của bạn có điểm khởi đầu thuận lợi. Transfer learning điều chỉnh model pretrained cho các tác vụ mới có liên quan. Fine-tune model pretrained nghĩa là bắt đầu từ các trọng số này rồi tiếp tục huấn luyện trên dataset cụ thể của bạn. Phương pháp này giúp rút ngắn thời gian huấn luyện và thường cải thiện hiệu suất vì model đã có nền tảng vững chắc về các đặc trưng cơ bản.
Weights pretrained được chỉ định bằng đối số model, vì vậy model=yolo26n.pt đã bắt đầu từ weights COCO. Tham số pretrained kiểm soát việc giữ nguyên các weights đó (True, mặc định), loại bỏ chúng (False) hay thay bằng checkpoint khác (pretrained=path/to/best.pt). Đặt pretrained=True trên model *.yaml không tự tải weights. Xem Cách fine-tune YOLO trên dataset tùy chỉnh để biết toàn bộ quy trình transfer learning.
Các kỹ thuật khác cần cân nhắc khi xử lý dataset lớn#
Có một vài kỹ thuật khác cần cân nhắc khi xử lý dataset lớn:
- Bộ lập lịch learning rate: Triển khai bộ lập lịch learning rate để điều chỉnh learning rate linh hoạt trong quá trình huấn luyện. Learning rate được tinh chỉnh tốt có thể ngăn model vượt quá các điểm cực tiểu và cải thiện độ ổn định. Khi huấn luyện YOLO26, tham số
lrfgiúp quản lý lịch learning rate bằng cách đặt learning rate cuối cùng theo tỷ lệ của learning rate ban đầu. Với các hành vi không có đối số tương ứng, chẳng hạn learning rate theo từng layer hoặc gradient clipping, hãy tạo subclass của trainer. - Huấn luyện phân tán: Với dataset lớn, huấn luyện phân tán giúp rút ngắn thời gian bằng cách phân bổ khối lượng công việc trên nhiều GPU hoặc máy. Phương pháp này đặc biệt hữu ích cho các dự án quy mô doanh nghiệp có tài nguyên tính toán đáng kể.
- Định dạng bộ nhớ channels-last: Khi huấn luyện trên NVIDIA CUDA, bố cục bộ nhớ NHWC nhanh hơn sẽ được tự động sử dụng với PyTorch 1.11 trở lên, ngoại trừ Windows, nơi bố cục này được đo là chậm hơn. Khi huấn luyện trên AMD ROCm, định dạng vẫn là NCHW, vốn được đo là nhanh hơn trên nền tảng này. Đặt
channels_last=Trueđể buộc sử dụng định dạng này hoặcchannels_last=Falseđể giữ NCHW; PyTorch 1.10 trở xuống, CPU và MPS mặc định vẫn dùng NCHW.
Số epoch cần huấn luyện#
Khi huấn luyện model, epoch là một lượt duyệt hoàn chỉnh qua toàn bộ dataset huấn luyện. Trong một epoch, model xử lý mỗi mẫu trong tập huấn luyện một lần và cập nhật tham số dựa trên thuật toán học. Thường cần nhiều epoch để model học và tinh chỉnh tham số theo thời gian.
Một câu hỏi thường gặp là nên huấn luyện model trong bao nhiêu epoch. Điểm khởi đầu hợp lý là 300 epoch. Nếu model overfit sớm, bạn có thể giảm số epoch. Nếu sau 300 epoch vẫn chưa xảy ra overfitting, bạn có thể kéo dài quá trình huấn luyện lên 600, 1200 hoặc nhiều epoch hơn.
Tuy nhiên, số epoch lý tưởng có thể thay đổi tùy theo kích thước dataset và mục tiêu dự án. Dataset lớn hơn có thể cần nhiều epoch hơn để model học hiệu quả, trong khi dataset nhỏ hơn có thể cần ít epoch hơn để tránh overfitting. Với YOLO26, bạn có thể đặt tham số epochs trong script huấn luyện.
Dừng sớm#
Dừng sớm là kỹ thuật hữu ích để tối ưu hóa quá trình huấn luyện model. Bằng cách theo dõi hiệu năng validation, bạn có thể dừng huấn luyện khi model không còn cải thiện. Cách này giúp tiết kiệm tài nguyên tính toán và ngăn overfitting.
Quy trình này sử dụng tham số patience để xác định số epoch cần chờ cải thiện metric validation trước khi dừng huấn luyện. Nếu hiệu năng model không cải thiện trong số epoch này, quá trình huấn luyện sẽ dừng để tránh lãng phí thời gian và tài nguyên.
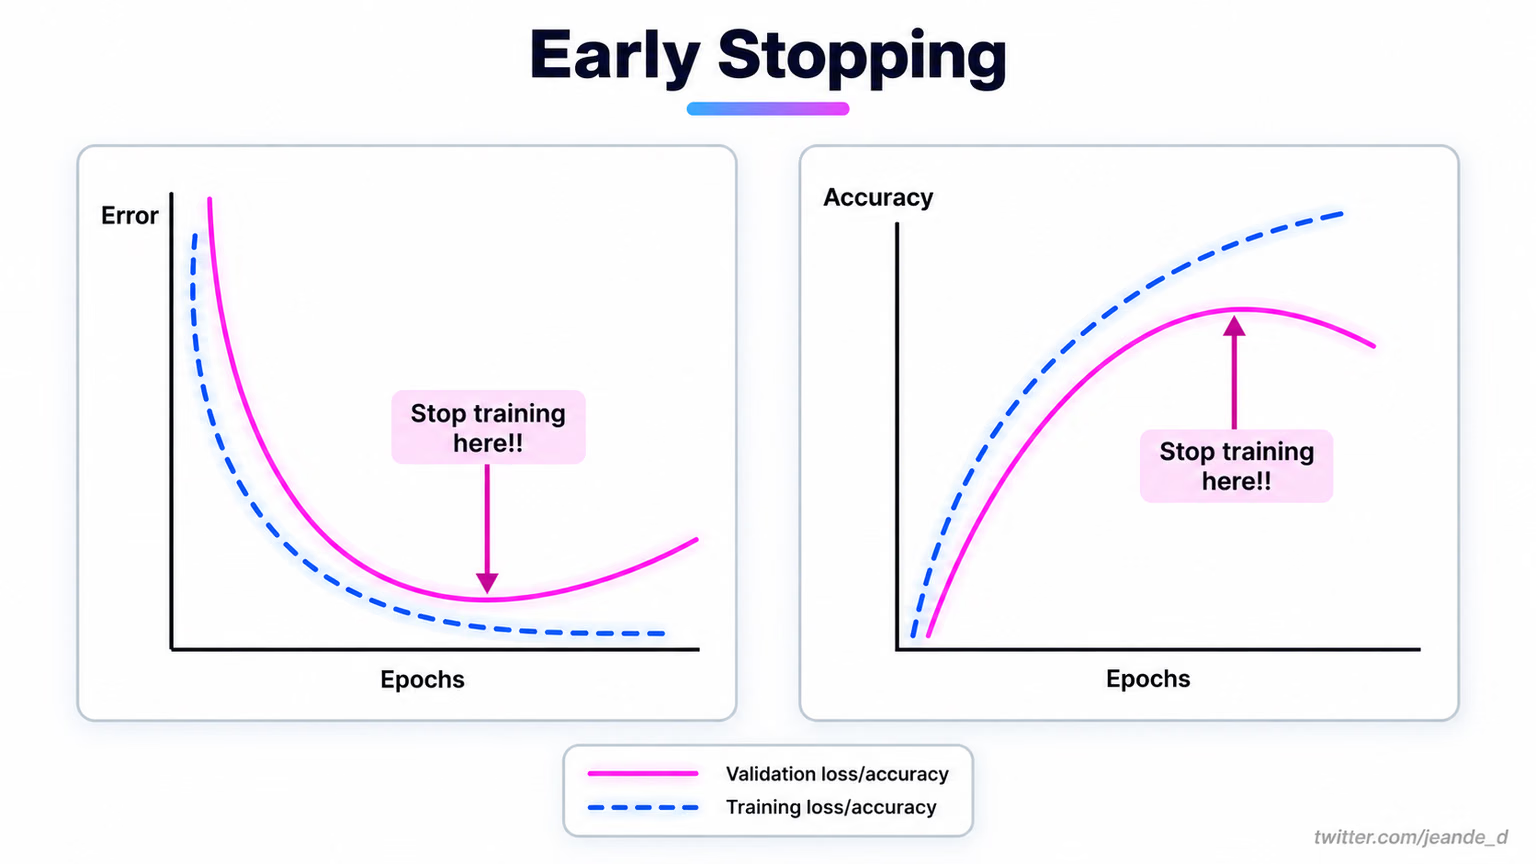
Với YOLO26, bạn có thể bật early stopping bằng cách đặt tham số patience trong cấu hình huấn luyện. Ví dụ, patience=5 nghĩa là quá trình huấn luyện sẽ dừng nếu các metric validation không cải thiện trong 5 epoch liên tiếp. Cách này giúp huấn luyện hiệu quả và tránh tính toán không cần thiết.
Chọn huấn luyện trên cloud hay máy cục bộ#
Có hai lựa chọn để huấn luyện model: huấn luyện trên cloud và huấn luyện cục bộ.
Huấn luyện trên cloud có khả năng mở rộng linh hoạt và phần cứng mạnh mẽ, rất phù hợp để xử lý dataset lớn và model phức tạp. Các nền tảng như Google Cloud, AWS và Azure cung cấp quyền truy cập theo nhu cầu vào GPU và TPU hiệu năng cao, giúp rút ngắn thời gian huấn luyện và cho phép thử nghiệm với model lớn hơn. Ultralytics Platform cũng cung cấp dịch vụ huấn luyện YOLO trên cloud được quản lý. Tuy nhiên, huấn luyện trên cloud có thể tốn kém, đặc biệt khi chạy trong thời gian dài; việc truyền dữ liệu cũng có thể làm tăng chi phí và độ trễ.
Huấn luyện cục bộ mang lại khả năng kiểm soát và tùy chỉnh cao hơn, cho phép bạn điều chỉnh môi trường theo nhu cầu cụ thể và tránh chi phí cloud định kỳ. Phương pháp này có thể tiết kiệm hơn đối với các dự án dài hạn; đồng thời, vì dữ liệu luôn nằm tại chỗ nên cũng an toàn hơn. Tuy nhiên, phần cứng cục bộ có thể bị giới hạn tài nguyên và cần bảo trì, dẫn đến thời gian huấn luyện lâu hơn với các model lớn.
Chọn optimizer#
Optimizer là một thuật toán điều chỉnh trọng số của neural network để giảm thiểu hàm loss, vốn đo lường mức độ hoạt động của model. Nói đơn giản, optimizer giúp model học bằng cách tinh chỉnh các tham số để giảm lỗi. Việc chọn optimizer phù hợp ảnh hưởng trực tiếp đến tốc độ và độ chính xác khi model học.
Bạn cũng có thể tinh chỉnh các tham số của optimizer để cải thiện hiệu năng model. Điều chỉnh learning rate sẽ xác định kích thước các bước khi cập nhật tham số. Để đảm bảo độ ổn định, bạn có thể bắt đầu với learning rate vừa phải rồi giảm dần theo thời gian nhằm cải thiện khả năng học lâu dài. Ngoài ra, thiết lập momentum sẽ xác định mức độ ảnh hưởng của các lần cập nhật trước đến lần cập nhật hiện tại. Giá trị momentum phổ biến là khoảng 0.9, thường mang lại sự cân bằng tốt.
Các optimizer phổ biến#
Mỗi optimizer đều có ưu điểm và nhược điểm riêng. Dưới đây là một số optimizer phổ biến.
-
SGD (Gradient Descent ngẫu nhiên):
- Cập nhật các tham số của model bằng gradient của hàm loss theo các tham số đó.
- Đơn giản và hiệu quả, nhưng có thể hội tụ chậm và mắc kẹt tại các cực tiểu cục bộ.
-
Adam (Ước lượng moment thích nghi):
- Kết hợp ưu điểm của cả SGD có momentum và RMSProp.
- Điều chỉnh learning rate cho từng tham số dựa trên ước lượng moment bậc nhất và bậc hai của gradient.
- Phù hợp với dữ liệu nhiễu và gradient thưa.
- Hiệu quả và thường cần ít tinh chỉnh hơn. Với các lần huấn luyện ngắn,
optimizer=autocủa YOLO26 chọn AdamW có liên quan chặt chẽ thay vì chính Adam.
-
RMSProp (Lan truyền căn trung bình bình phương):
- Điều chỉnh learning rate cho từng tham số bằng cách chia gradient cho trung bình trượt độ lớn của các gradient gần đây.
- Giúp xử lý vấn đề gradient biến mất và có hiệu quả với recurrent neural network.
-
MuSGD (optimizer lai Muon + SGD):
- Kết hợp các bước cập nhật kiểu SGD với cơ chế lấy cảm hứng từ Muon để cải thiện độ ổn định khi huấn luyện quy mô lớn.
- Là lựa chọn phù hợp khi bạn muốn khả năng tổng quát hóa như SGD nhưng cần hội tụ mượt hơn SGD thuần.
- Đặc biệt phù hợp với các cấu hình huấn luyện YOLO26; nếu chưa chắc, hãy bắt đầu với
optimizer=autorồi so sánh với MuSGD trên tập dữ liệu của bạn.
Với YOLO26, tham số optimizer cho phép bạn chọn trong số nhiều optimizer, bao gồm SGD, MuSGD, Adam, Adamax, AdamW, NAdam, RAdam và RMSProp; hoặc đặt thành auto để tự động chọn dựa trên số vòng lặp huấn luyện (AdamW cho các lượt chạy ngắn hơn, MuSGD khi vượt quá 10,000 vòng lặp).
yolo train model=yolo26n.pt data=coco8.yaml optimizer=MuSGDKết nối với cộng đồng#
Tham gia cộng đồng những người đam mê computer vision có thể giúp bạn giải quyết vấn đề và học nhanh hơn. Sau đây là một số cách để kết nối, nhận trợ giúp và chia sẻ ý tưởng.
Tài nguyên cộng đồng#
- GitHub Issues: Truy cập repository YOLO26 trên GitHub và dùng tab Issues để đặt câu hỏi, báo lỗi và đề xuất tính năng mới. Cộng đồng và đội ngũ duy trì dự án rất tích cực, luôn sẵn sàng trợ giúp.
- Máy chủ Discord của Ultralytics: Tham gia máy chủ Discord của Ultralytics để trò chuyện với người dùng và developer khác, nhận hỗ trợ và chia sẻ trải nghiệm.
Sử dụng các tài nguyên này sẽ giúp bạn giải quyết thách thức và cập nhật những xu hướng, phương pháp mới nhất trong cộng đồng thị giác máy tính.
Điểm chính cần lưu ý#
Huấn luyện model thị giác máy tính đòi hỏi áp dụng các phương pháp tốt, tối ưu chiến lược và giải quyết vấn đề khi chúng phát sinh. Những kỹ thuật như điều chỉnh batch size, huấn luyện mixed precision và bắt đầu với trọng số pretrained có thể giúp model hoạt động tốt hơn và huấn luyện nhanh hơn. Các phương pháp như huấn luyện trên tập con và early stopping giúp tiết kiệm thời gian và tài nguyên. Kết nối với cộng đồng và cập nhật xu hướng mới sẽ giúp bạn liên tục nâng cao kỹ năng huấn luyện model.
Câu hỏi thường gặp#
Để cải thiện mức sử dụng GPU, hãy đặt tham số
batchở kích thước tối đa mà GPU hỗ trợ. Trên một bộ tăng tốc,batch=-1phân tích model và nhắm đến mức sử dụng bộ nhớ khoảng 60%. Trên CPU và Apple silicon, tham số này chuyển vềbatch=16, trong khi các lần chạy đa GPU yêu cầu đặt rõ ràng kích thước batch toàn cục ít nhất bằng số lượng thiết bị. Để biết thêm thông tin, hãy tham khảo các tham số chế độ Train.Huấn luyện mixed precision sử dụng cả kiểu số thực 16-bit (FP16) và 32-bit (FP32) để cân bằng tốc độ tính toán với độ chính xác. Trong YOLO26, tính năng này được bật mặc định thông qua
amp=True; đặtamp=Falseđể buộc sử dụng FP32. AMP được bỏ qua trên CPU và Apple silicon.Huấn luyện đa tỷ lệ cải thiện hiệu năng model bằng cách huấn luyện trên ảnh có nhiều kích thước khác nhau, giúp model tổng quát hóa tốt hơn với các tỷ lệ và khoảng cách khác nhau. YOLO26 cung cấp hai tham số riêng cho tính năng này.
scale=0.5lấy mẫu hệ số zoom trong khoảng 0.5 đến 1.5, sau đó đệm hoặc cắt ảnh vềimgszcố định; cònmulti_scale=0.25thay đổi chínhimgsztheo từng batch, với bước bằng stride. Để xem các thiết lập và biết thêm chi tiết, hãy tham khảo tài liệu chế độ Train.Sử dụng trọng số pretrained có thể tăng tốc đáng kể quá trình huấn luyện và cải thiện độ chính xác của model bằng cách tận dụng một model đã nhận diện được các đặc trưng hình ảnh nền tảng. Nạp trọng số qua đối số
model, chẳng hạn nhưmodel=yolo26n.pt; sau đó,pretrainedsẽ quyết định giữ lại các trọng số đó (True, mặc định), loại bỏ chúng (False) hay thay bằng checkpoint khác (pretrained=path/to/best.pt, cách chuyển trọng số sang bản dựngmodel=*.yaml). Tìm hiểu thêm trong tài liệu chế độ Train.Số epoch là số lượt hoàn chỉnh đi qua tập dữ liệu huấn luyện trong quá trình huấn luyện model. Mức khởi điểm phổ biến là 300 epoch. Nếu model overfit sớm, bạn có thể giảm số epoch. Ngược lại, nếu không thấy hiện tượng overfit, bạn có thể kéo dài quá trình huấn luyện lên 600, 1200 epoch hoặc hơn. Để thiết lập số này trong YOLO26, hãy dùng tham số
epochstrong script huấn luyện. Để biết thêm lời khuyên về cách xác định số epoch phù hợp, hãy tham khảo phần số epoch.


Bình luận12
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.
puzzlemindgames
Hello
I'm working on a browser-based puzzle solver that uses a custom YOLO model to detect visible objects from game screenshots.
Some examples include: Transparent ice/frost overlays on the lower part of objects Semi-transparent cloth or curtain overlays Small decorative objects inside larger objects (for example, keys inside containers) The visible objects are usually detected correctly, but these overlays often cause false negatives or incorrect class predictions.
At the moment I'm considering a few approaches: Training with many more occlusion-heavy examples Splitting the detection into multiple stages instead of one larger model
python results = model.predict( source="level_512.png", conf=0.25, iou=0.45, imgsz=1280 ) for box in results[0].boxes: print(box.cls, box.conf)
For anyone who has trained YOLO models on UI or game screenshots which approach gave you the biggest improvement? Or is there another strategy that tends to work better for partially occluded objects?
I'd really appreciate hearing about real-world experiences before I spend time retraining the dataset.
 Glenn JocherUltralytics
Start with targeted data: add representative occluded examples, keep annotations consistent for partially visible objects, and synthetically composite the actual frost/cloth overlays at realistic opacity and placement. Measure recall per class on a dedicated occlusion-heavy validation split, then tune
mosaic,mixup, orcutmixconservatively; higherimgszor tiled inference can help nested small objects. A multi-stage pipeline is usually worthwhile only if the first stage can reliably isolate containers or overlay regions. Please continue sharing results and questions here so the Ultralytics team and community can see them.1Thanks! I followed your suggestions and added more occluded samples. The main objects/tubes are much more stable as well as the colors now but I'm still struggling with very small objects.
i cant able to attach model training screenshots here for you to review.
For example, tiny keys or tags inside transparent containers are often missed or detected as the wrong class. For context the screenshots come from a puzzle game with objects similar to these shown in sample pictures embedded at product homepage: https://aimagicsortsolver.com/
results = model.predict( source="level.png", imgsz=1280, conf=0.35, iou=0.45 ) Would you recommend keep improving a single model or train a second YOLO model just for these small objects?
- Glenn JocherUltralytics(đã chỉnh sửa)
Keep the single model first: audit tiny-object annotations, add more balanced close-up examples, and test cropped or SAHI tiled inference so keys and tags occupy more pixels; also compare
conf=0.15–0.25, since higher thresholds may suppress weak detections. Train a second specialized model only if the first model reliably detects each container, allowing its crop to be passed to the small-object model at higher effective resolution.1 Thank you for your suggestions. I'll tweak it as per the recommendations.
TSHSLU
What is the minimum Dataset Size required if i use a pretrained model for custom projects. i barely find any sources online which recommend a minimum dataset size.
- Glenn JocherUltralytics
There isn’t a fixed “minimum” dataset size when fine-tuning a pretrained model; if your domain is close to the pretrained data and labels are clean, you can often start getting useful signal with ~50–200 images per class (or a few hundred labeled object instances), but for reliably robust results across different lighting/viewpoints/backgrounds you’ll usually want 500–2000+ images per class with good diversity—one practical way to find your true minimum is to train on a small pilot subset, check validation failures, then add data specifically where the model breaks (the
fractionworkflow in the Model training tips guide helps iterate quickly).from ultralytics import YOLO model = YOLO("yolo26n.pt") model.train(data="data.yaml", epochs=100, fraction=0.1)1
VeeranjaneyuluToka
Hi, I just noticed a thing, looks like the optimizer is getting chosen based on no.of iterations, would you mind telling me the reason for the same? I mean how does iterations matter when we choose optimizer?
Imran-ml
First of all its great to have another powerful model and congratulations. I have fine tuned and trained yolo11x.pt for my custom objects but I'm facing some issues. My images data resolution is around 6000 x 2000 but while trained the model I set the imgsz=(1280, 640). It work well when I adjust the video stream by zoom in-out and detect all my 60 objects well (objects are small) but when there is some zoom or squeezed then it completely dont detect any object or few only.
Please let me know if I'm missing something or I have to do something else? I have labelled the data on my original images so resizing making any issues? any ratio issues? Please guide me properly so I can use this power yolo11 model effectively.
- Glenn JocherUltralytics
@Imran-ml it sounds like the issue might be related to image resizing affecting object detection. Consider enabling multiscale training by adjusting the
scaleparameter to help the model generalize better across different image sizes. This can improve detection performance when objects appear at varying scales. For more detailed guidance, you can refer to our model training tips at https://docs.ultralytics.com/guides/model-training-tips/.
Taufiq-Ahmed
Hi I have a question. I am using Yolov8s for trained a dataset that has four class. fire, smoke, person, animal. all the images has areal view to detect forest fire . In my dataset I have forest fire images from drone so after training it detect fire smoke quite accurately. however, I do not have any dataset that has person or animal in forest fire. so I have to collect some other dataset from roboflow that has person and animal and the n I have merged them with my own dataset ( have changed the label of animal and person accordingly so 0 means smoke, 1 means fire, 2 means person and 3 means animal and also updated the data.yaml file) . this time the problem is it could not detect the animal and person properly some times it can detect them. The main reasons seems to me is that the drone is flying in a high altitude so it does not detect person and animal properly because in the dataset of person and animal the view of the drone is not that much high. is there any technique to solve this problem and detect all the objects as many as possible?
- Glenn JocherUltralytics
@Taufiq-Ahmed it sounds like the altitude difference between your training and test datasets is causing the detection issues. To address this, consider using data augmentation techniques to simulate higher altitude views in your training data. You can also try multiscale training to help the model generalize better across different scales. Additionally, fine-tuning the model with a mix of high-altitude and low-altitude images might improve its performance. For more detailed strategies, you can refer to our model training tips.