Bộ dữ liệu PASCAL VOC là benchmark phát hiện vật thể kinh điển với 20 lớp đối tượng thường gặp. Cấu hình VOC.yaml của Ultralytics kết hợp các tập trainval của VOC2007 và VOC2012 thành tập huấn luyện gồm 16,551 ảnh, đánh giá trên 4,952 ảnh kiểm thử VOC2007 có annotation công khai và tự động tải toàn bộ dữ liệu (2.8 GB) trong lần sử dụng đầu tiên.
Xem: Cách huấn luyện Ultralytics YOLO trên dataset Pascal VOC | Phát hiện đối tượng | Thị giác máy tính 🚀
Các cuộc thi PASCAL VOC diễn ra từ năm 2005 đến 2012 và định hình cách đánh giá model phát hiện vật thể: benchmark bao gồm các tác vụ phân loại ảnh, phát hiện và phân đoạn, đồng thời phổ biến độ chính xác trung bình (mAP) như metric tiêu chuẩn cho phát hiện. Cấu hình VOC.yaml của Ultralytics sử dụng annotation phát hiện, chuyển đổi bounding box XML gốc sang định dạng YOLO trong quá trình tải xuống.
20 lớp đối tượng thường gặp: người; sáu loài động vật (chim, mèo, bò, chó, ngựa, cừu); bảy phương tiện (máy bay, xe đạp, thuyền, xe buýt, ô tô, xe máy, tàu hỏa); và sáu đồ vật trong nhà (chai, ghế, bàn ăn, cây trồng trong chậu, sofa, màn hình TV).
Kết hợp hai thế hệ cuộc thi: tập huấn luyện gộp VOC2007 trainval (5,011 ảnh) với VOC2012 trainval (11,540 ảnh).
Đánh giá tiêu chuẩn hóa: Các baseline VOC được công bố qua nhiều thập kỷ khiến bộ dữ liệu này trở thành mốc tham chiếu thuận tiện để so sánh các model phát hiện.
Sẵn sàng cho YOLO: script tải xuống lấy các archive và tự động chuyển đổi annotation — không cần chuẩn bị thủ công.
VOC2007 test, dùng để đánh giá trong quá trình huấn luyện
Kiểm thử
4,952
Chính các ảnh kiểm thử VOC2007 đó — cấu hình không định nghĩa tập riêng biệt nào được giữ lại
Annotation của VOC2007 test được công bố sau cuộc thi năm đó, nhờ vậy tập này có thể được dùng làm tập validation có nhãn. Annotation của VOC2012 test vẫn được giữ kín — chỉ có thể chấm điểm kết quả thông qua máy chủ đánh giá PASCAL chính thức — nên không thuộc cấu hình này.
Đã loại trừ các vật thể khó
Bộ chuyển đổi tự động bỏ qua các vật thể được đánh dấu difficult trong annotation XML VOC gốc, vì vậy số lượng instance theo từng lớp hơi khác so với thống kê VOC chính thức.
Khám phá VOC trên Ultralytics Platform để xem ảnh cùng lớp phủ annotation, xem phân bố lớp và heatmap bounding box trong tab Charts, rồi sao chép bộ dữ liệu để huấn luyện model của riêng bạn trên cloud.
PASCAL VOC là benchmark chính cho nghiên cứu phát hiện vật thể trong những năm trước khi bộ dữ liệu COCO ra đời với quy mô lớn hơn: các bộ phát hiện như Faster R-CNN và SSD công bố kết quả ban đầu trên bộ dữ liệu này, và model Ultralytics YOLO có thể huấn luyện trên bộ dữ liệu này ngay mà không cần cấu hình thêm. Hiện nay, bộ dữ liệu vẫn phổ biến cho:
Đánh giá benchmark các kiến trúc phát hiện mới so với lịch sử lâu dài của các baseline đã công bố
Thử nghiệm nhanh và bài tập thực hành — với 16,551 ảnh huấn luyện, thời gian huấn luyện nhanh hơn COCO nhiều
Nghiên cứu học chuyển giao trên một tập lớp đối tượng thường gặp nhỏ gọn, được hiểu rõ
VOC được tải xuống tự động trong lần đầu tiên bạn huấn luyện — gồm ba tệp lưu trữ với tổng dung lượng 2.8 GB — và cần khoảng 6 GB dung lượng đĩa trống trong quá trình giải nén và chuyển đổi.
Để huấn luyện model YOLO26n trên dataset VOC trong 100 epoch với kích thước ảnh 640, bạn có thể dùng các đoạn code sau.
Ví dụ huấn luyện
from ultralytics import YOLO

# Tải model
model = YOLO("yolo26n.pt")  # tải model đã huấn luyện trước (được khuyến nghị khi huấn luyện)

# Huấn luyện model - tập dữ liệu sẽ tự động tải xuống trong lần chạy đầu tiên
results = model.train(data="VOC.yaml", epochs=100, imgsz=640)
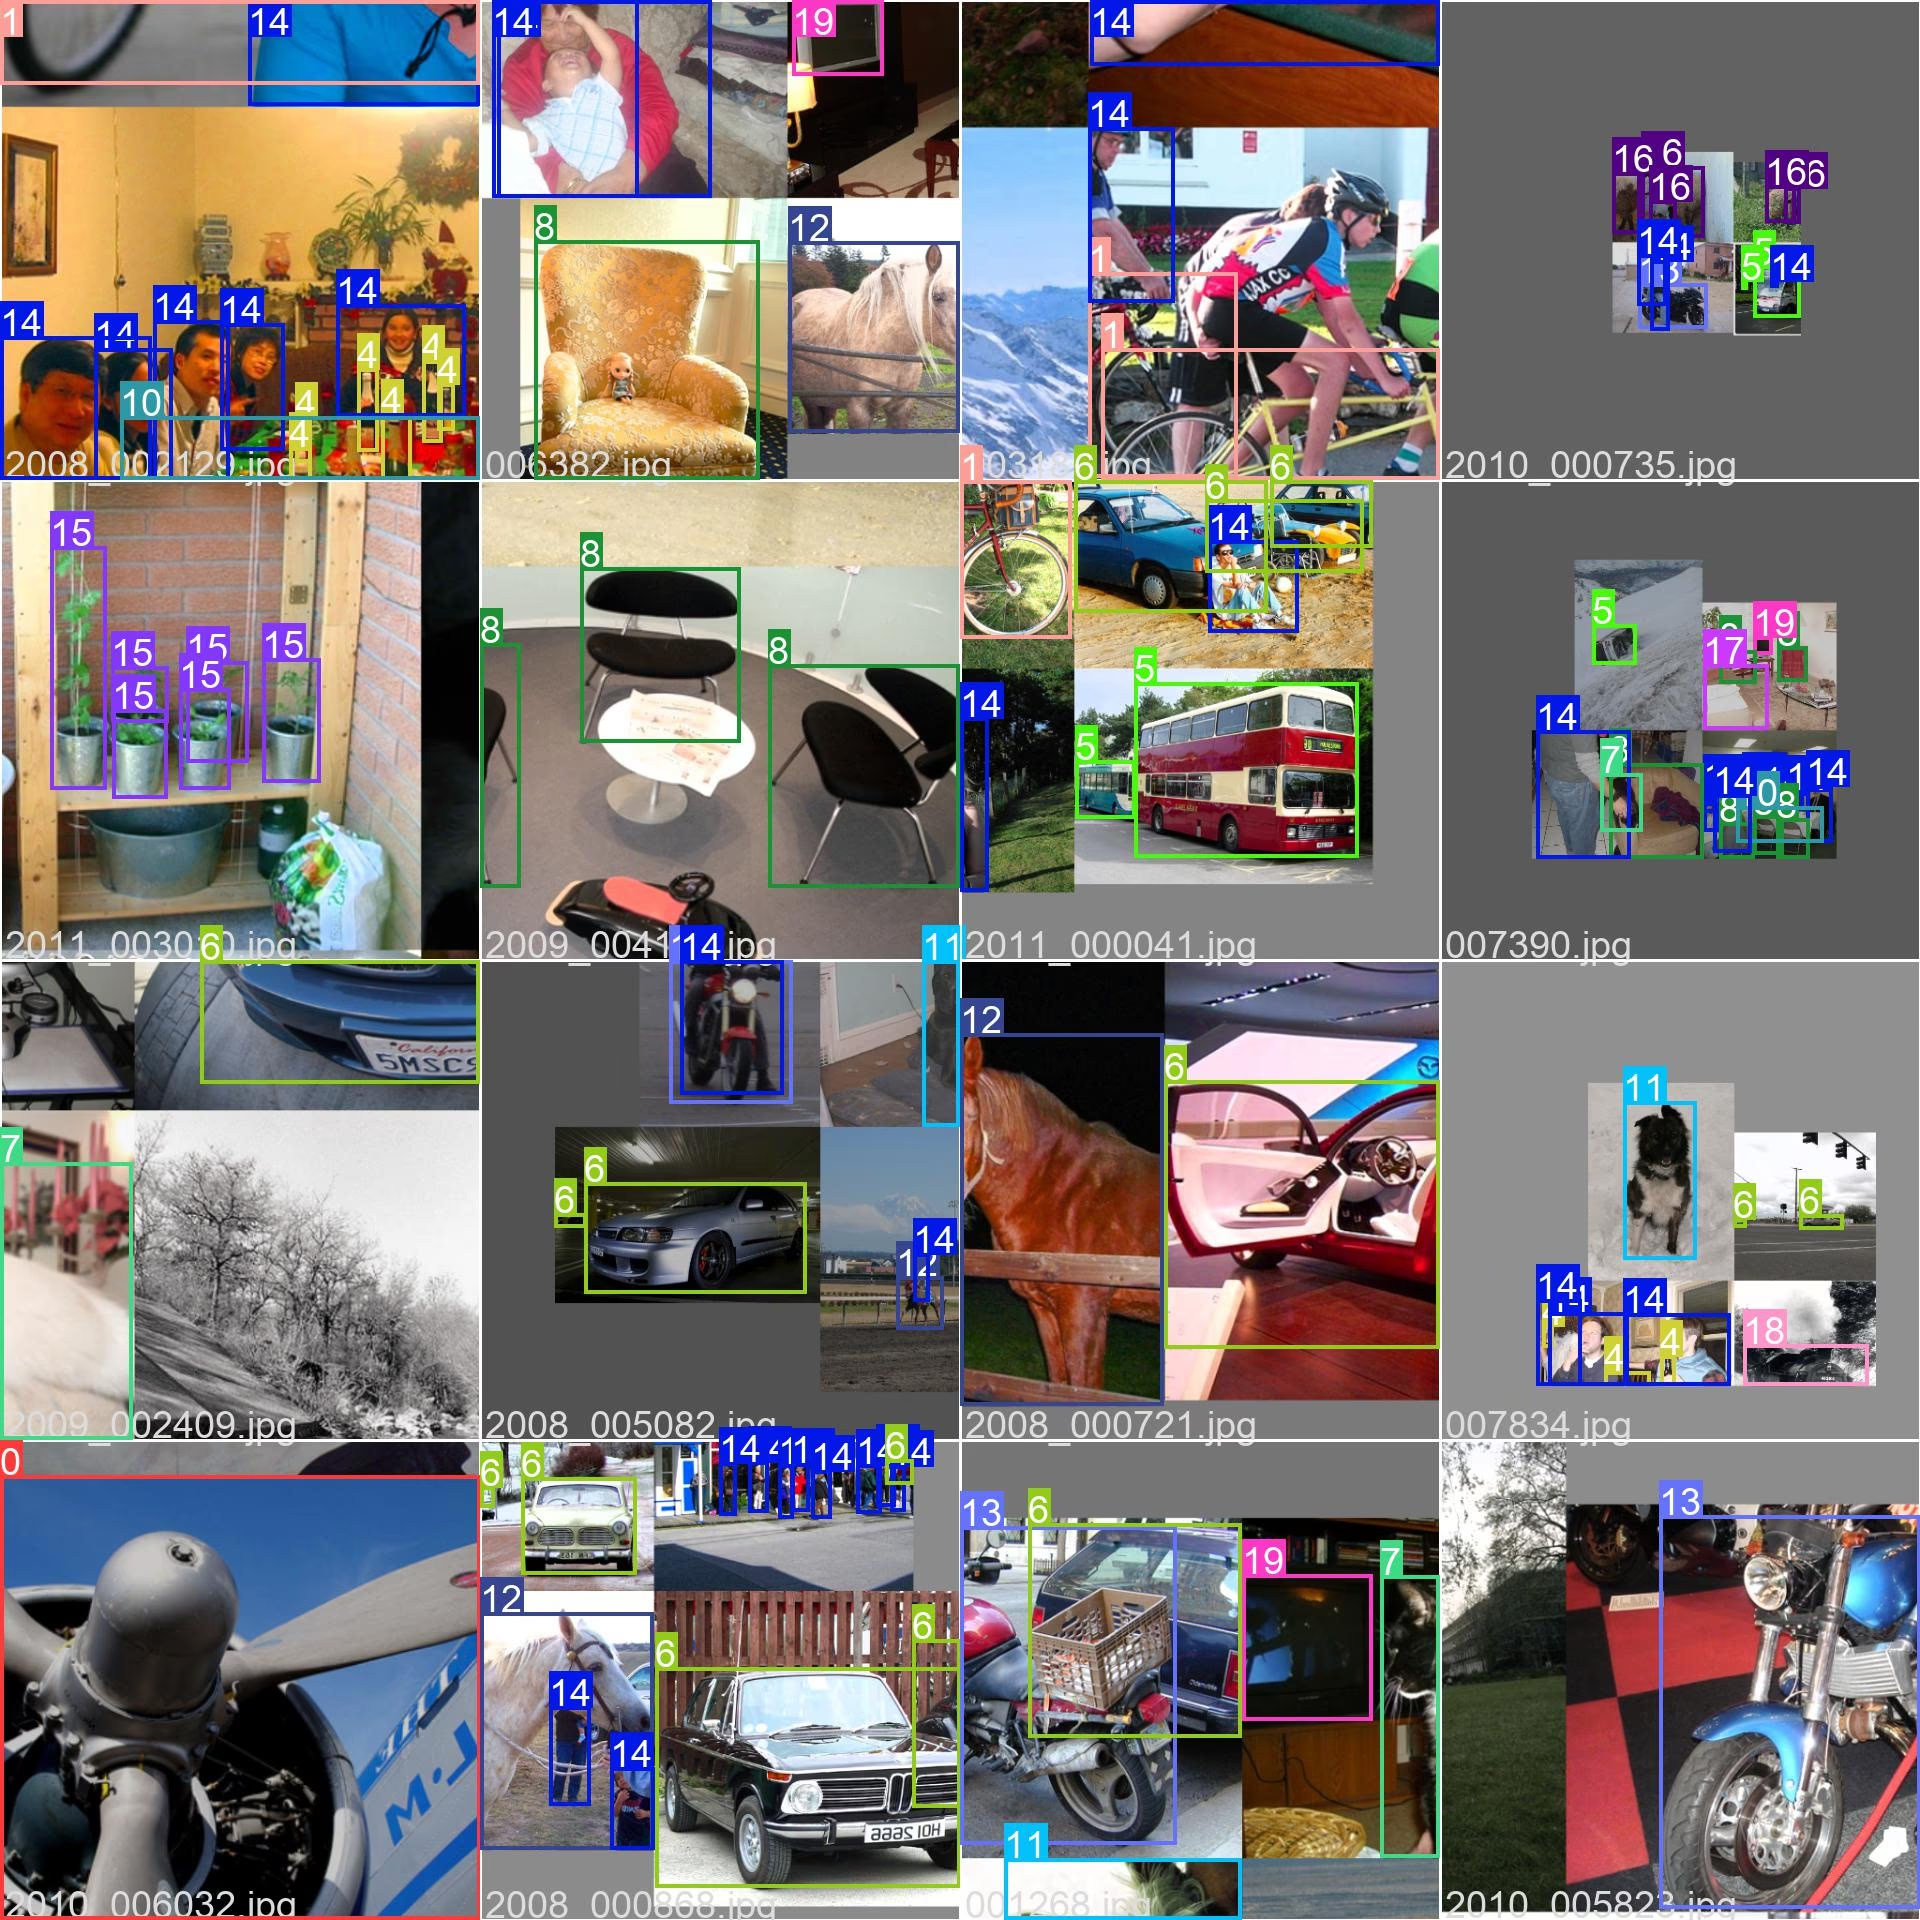
Hình ảnh bên dưới cho thấy một batch huấn luyện được tạo mosaic từ dataset VOC. Kỹ thuật mosaic kết hợp nhiều hình ảnh thành một mẫu huấn luyện duy nhất, làm tăng sự đa dạng về đối tượng, tỷ lệ và bối cảnh cảnh vật mà model nhìn thấy trong mỗi batch — xem hướng dẫn tăng cường dữ liệu YOLO để biết chi tiết.
Nếu sử dụng dataset VOC trong nghiên cứu hoặc công việc phát triển, vui lòng trích dẫn bài báo sau:
Trích dẫn
@article{everingham2010pascal,
  author={Everingham, Mark and Van Gool, Luc and Williams, Christopher K. I. and Winn, John and Zisserman, Andrew},
  journal={International Journal of Computer Vision},
  title={The Pascal Visual Object Classes (VOC) Challenge},
  year={2010},
  volume={88},
  number={2},
  pages={303-338},
  doi={10.1007/s11263-009-0275-4}}
Chúng tôi xin ghi nhận đóng góp của PASCAL VOC Consortium trong việc tạo và duy trì tài nguyên quý giá này cho cộng đồng thị giác máy tính. Để biết thêm thông tin về dataset VOC và những người tạo ra dataset, hãy truy cập trang web dataset PASCAL VOC.
PASCAL VOC được sử dụng để huấn luyện và benchmark các model phát hiện đối tượng trên 20 lớp đối tượng thường ngày như người, ô tô, chó và ghế. Vì dataset nhỏ gọn, có nhãn đầy đủ và được hỗ trợ bởi nhiều kết quả chuẩn đã công bố trong nhiều năm, dataset này thường được chọn để xác thực kiến trúc mới, thực hiện thử nghiệm trong khóa học và nghiên cứu transfer learning nhanh.
Cấu hình VOC của Ultralytics có 21,503 hình ảnh: 16,551 hình ảnh dùng để huấn luyện (VOC2007 trainval + VOC2012 trainval) và 4,952 hình ảnh dùng để validation (tập test VOC2007). Tất cả các tập con đều có chung 20 lớp. Xem Cấu trúc dataset để biết phân tích đầy đủ.
VOC được tải xuống tự động trong lần đầu tiên bạn huấn luyện bằng data="VOC.yaml" — không cần thực hiện thủ công. Script tải về ba tệp lưu trữ (2.8 GB) từ tài sản bản phát hành trên GitHub của Ultralytics và chuyển đổi chú thích XML sang định dạng YOLO.
Huấn luyện model YOLO26n trên VOC trong 100 epoch với kích thước ảnh 640:
Ví dụ huấn luyện
from ultralytics import YOLO

# Tải model
model = YOLO("yolo26n.pt")  # tải model đã huấn luyện trước (được khuyến nghị khi huấn luyện)

# Huấn luyện model
results = model.train(data="VOC.yaml", epochs=100, imgsz=640)
Cả hai thử thách đều có chung 20 lớp nhưng cung cấp các hình ảnh khác nhau. VOC2007 có 5,011 hình ảnh trainval cùng một tập test gồm 4,952 hình ảnh với chú thích được công khai; VOC2012 có 11,540 hình ảnh trainval, trong khi chú thích của tập test không được công khai và chỉ được chấm điểm qua máy chủ đánh giá chính thức. VOC.yaml của Ultralytics gộp cả hai tập trainval để huấn luyện và dùng tập test VOC2007 để validation.
VOC nhỏ hơn và đơn giản hơn: 20 lớp và 21.503 hình ảnh so với 80 lớp và 330K hình ảnh của COCO. Kết quả VOC theo truyền thống được báo cáo dưới dạng mAP tại IoU 0.5, trong khi COCO tính trung bình mAP trên các ngưỡng IoU từ 0.5 đến 0.95. VOC huấn luyện nhanh hơn nhiều và phù hợp với các thử nghiệm nhanh; dataset COCO là tiêu chuẩn để benchmark ở quy mô sản xuất.
Không — VOC.yaml là cấu hình chỉ dành cho phát hiện: bộ chuyển đổi trích xuất bounding box từ annotation XML của VOC và không chuyển đổi các mask phân đoạn có trong benchmark gốc. Để huấn luyện model phân đoạn instance, hãy sử dụng dataset có nhãn polygon như COCO-Seg cùng model YOLO26n-seg.
raise RuntimeError(emojis(f"Dataset '{clean_url(self.args.data)}' error ❌ {e}")) from e
RuntimeError: Dataset 'VOC.yaml' error ❌ [Errno 2] No such file or directory: '/home/diana/Code/test/datasets/VOC/images/VOCdevkit/VOC2007/ImageSets/Main/train.txt'
Nice find on the root cause. To clean things up, delete the incomplete datasets/VOC folder and run your yolo ... data=VOC.yaml command again so the download/conversion script can fully re-download and unpack everything; if you still hit a path error after that, please share the full command and complete traceback so we can take a closer look.
Respectively, "xmin/ymin" and "xmax/ymax" are the coordinates of the upper-left and lower-right corners of the object.
How can I use this dataset to train the YoloV11 neural network?
@YustasDev to train YOLO26 on your Pascal VOC dataset, you need to convert the XML annotations to YOLO format (class, x_center, y_center, width, height in normalized coordinates). Use the conversion script provided in the VOC.yaml file under the "Download script/URL" section. Once converted, define a custom YAML file for your dataset paths and run the training using:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="your_dataset.yaml", epochs=100, imgsz=640)
Respectively, "xmin/ymin" and "xmax/ymax" are the coordinates of the upper-left and lower-right corners of the object.
How can I use this dataset to train the YoloV11 neural network?
@YustasDev to use your Pascal VOC dataset for YOLO26 training, you need to convert the XML annotations to YOLO format (class, x_center, y_center, width, height with normalized coordinates). You can adapt the XML-to-YOLO conversion script from the VOC dataset documentation here: https://docs.ultralytics.com/datasets/detect/voc/. Once converted, create a dataset YAML file similar to VOC.yaml, specifying your paths and classes, and then start training using yolo detect train data=your_dataset.yaml model=yolo26n.pt. Let me know if you encounter any issues!
Cookie giúp chúng tôi biết tài liệu, model và tính năng nào hữu ích với bạn để chúng tôi không ngừng cải thiện. Chọn nội dung bạn chia sẻ trong , hoặc đọc Chính sách quyền riêng tư của chúng tôi.


mengdxiran
 Glenn JocherUltralytics
YustasDev