Caltech-256 数据集#
Caltech-256 数据集是经典的图像分类基准,包含 30,607 张图像,涵盖 256 个对象类别和一个背景类别。每个类别至少包含 80 张真实世界物体图像,包括动物、车辆、家居用品和人物。与 Caltech-101 相比,它是规模更大、挑战性更高的后续数据集,适用于对象识别模型。
在 Ultralytics Platform 上探索 Caltech-256,即可预览样例、查看数据集统计信息,并克隆数据集用于训练。
Caltech-256 未提供预定义的训练集/验证集划分。下面的训练命令会自动按 80% 训练集和 20% 验证集进行划分,因此无需手动准备。
主要功能#
- Caltech-256 包含 30,607 张彩色图像,涵盖 256 个对象类别和一个
257.clutter背景类别(共 257 个类别文件夹)。 - 这些类别涵盖了各种真实世界物体,包括动物、车辆、家居用品和人物。
- 每个类别至少包含 80 张图像,最多的类别约有 800 张,因此类别规模不均衡。
- 图像的尺寸和分辨率各不相同。
- Caltech-256 广泛用于评测图像分类和对象识别算法。
数据集结构#
Caltech-256 以 257 个文件夹的形式分发,每个文件夹对应一个类别,涵盖 256 个对象类别和一个 257.clutter 背景类别,且没有预定义的训练集/验证集划分。启动训练后,Ultralytics 会自动划分图像,让模型无需任何手动设置即可训练全部 257 个类别:
- 类别数:257(256 个对象类别 + 1 个背景类别)
- 图像总数:30,607
- 训练集/验证集划分:自动按 80% / 20% 划分(约 24,385 张训练图像,约 6,222 张验证图像)
- 每类图像数:至少 80 张(类别不平衡,最多约 800 张)
应用场景#
Caltech-256 数据集广泛用于训练和评估图像分类和对象识别模型,包括卷积神经网络 (CNNs) 和支持向量机 (SVMs)。其类别数量多、图像质量高,因此成为机器学习和计算机视觉研究与原型开发中常用的基准数据集。
用法#
在 Caltech-256 上训练 YOLO 模型 100 个轮次,图像尺寸设为 416。有关可用参数的完整列表,请参阅训练页面和图像分类任务指南。
from ultralytics import YOLO

# 加载模型
model = YOLO("yolo26n-cls.pt")  # 加载预训练模型(推荐用于训练)

# 训练模型
results = model.train(data="caltech256", epochs=100, imgsz=416)示例图像和标注#
Caltech-256 数据集包含各种物体的高质量彩色图像,为图像分类任务提供了结构良好的数据集。以下是该数据集中的一些图像示例(来源):
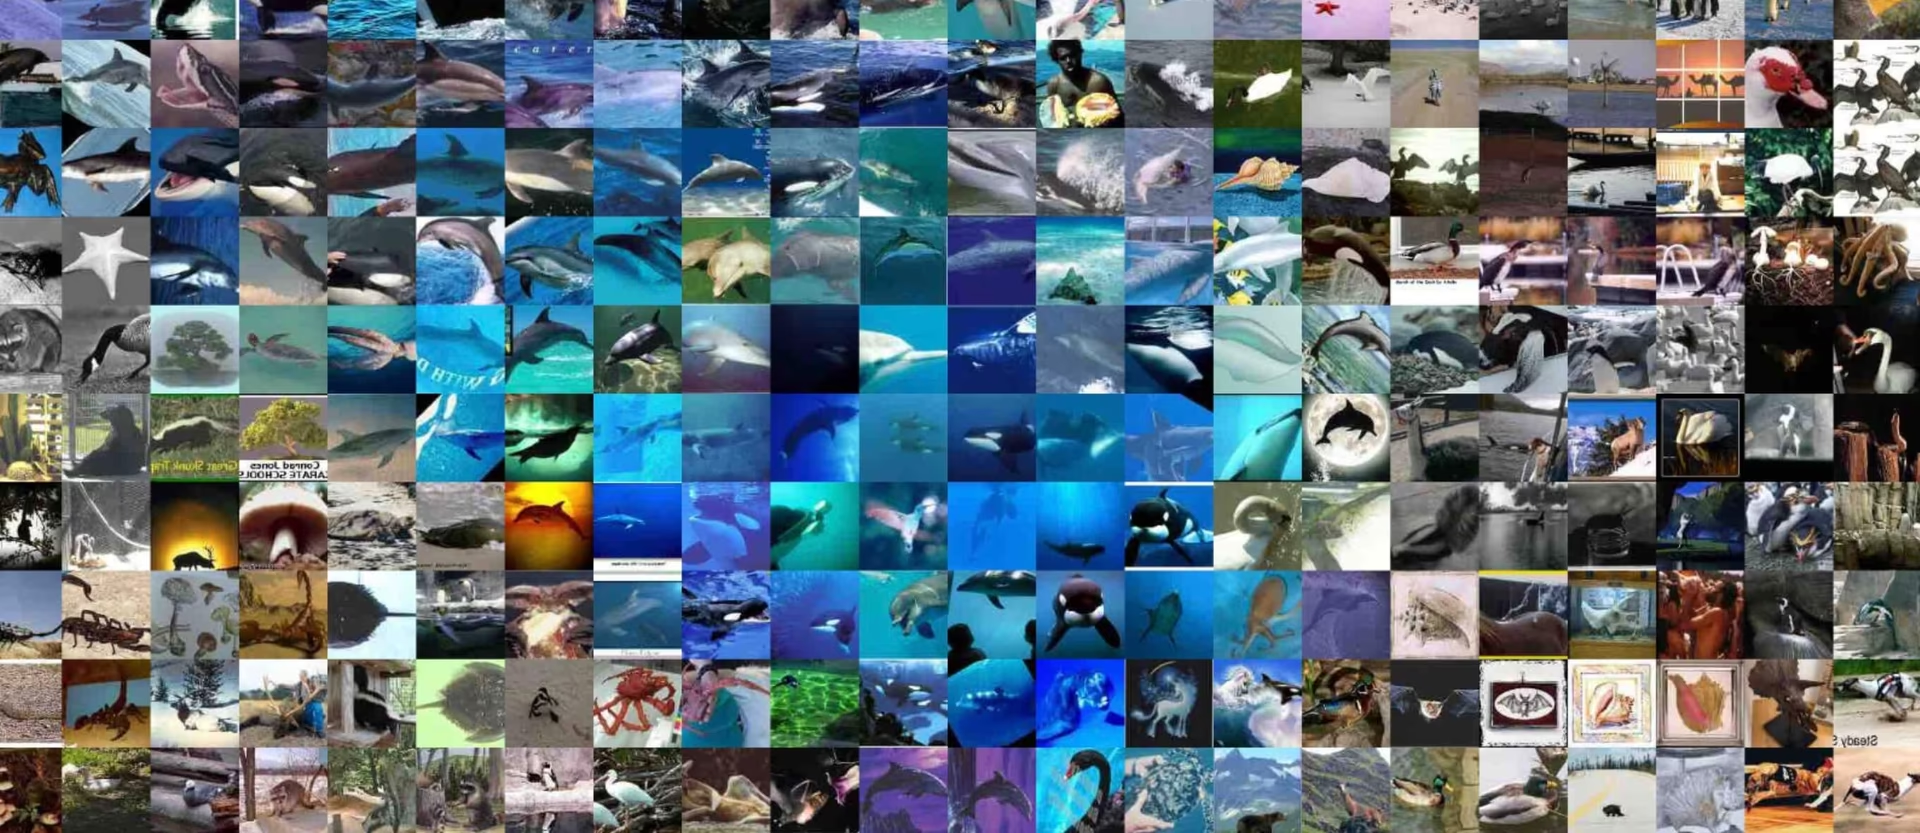
这些样例展现了 Caltech-256 数据集中物体的多样性和复杂性,凸显了多样化数据集对于训练稳健对象识别模型的价值。
引用与致谢#
如果你在研究或开发工作中使用 Caltech-256 数据集,请引用以下论文:
@article{griffin2007caltech,
         title={Caltech-256 object category dataset},
         author={Griffin, Gregory and Holub, Alex and Perona, Pietro},
         year={2007}
}
我们感谢 Gregory Griffin、Alex Holub 和 Pietro Perona 创建并维护 Caltech-256 数据集,为机器学习和计算机视觉研究社区提供了宝贵资源。有关 Caltech-256 数据集及其创建者的更多信息,请访问 Caltech-256 数据集网站。
常见问题#
Caltech-256 数据集广泛用于训练和评测图像分类及对象识别模型。它包含 30,607 张图像,涵盖 256 个对象类别和一个背景类别。与 Caltech-101 相比,它为评估卷积神经网络 (CNNs) 和支持向量机 (SVMs) 等算法提供了规模更大、挑战性更高的基准。
要使用 Caltech-256 训练 Ultralytics YOLO 模型,请使用下面的代码片段。首次使用时,数据集会自动下载。参数完整列表请参阅模型的训练页面。
训练示例from ultralytics import YOLO # 加载模型 model = YOLO("yolo26n-cls.pt") # 加载预训练模型(推荐用于训练) # 训练模型 results = model.train(data="caltech256", epochs=100, imgsz=416)Caltech-256 包含 256 个对象类别和一个
257.clutter背景类别,共有 257 个类别文件夹和 30,607 张图像。使用 Ultralytics 训练时,模型会学习全部 257 个类别。每个类别至少包含 80 张图像,但类别规模不均衡,最多的类别约有 800 张图像。Caltech-256 没有预定义的数据集划分。首次训练时,Ultralytics 会自动将数据集划分为 80% 训练集和 20% 验证集,即约 24,385 张训练图像和 6,222 张验证图像,因此你无需手动创建划分。若要自行控制划分,请在训练前将图像整理到
train/和val/文件夹中。可以。Ultralytics Platform 可让你管理数据集、训练图像分类模型并部署模型,而无需编写大量代码。它是在云端运行 Caltech-256 实验的便捷方式,你还可以在我们的分类数据集概览中了解更多选项。