CIFAR-10 数据集
CIFAR-10(加拿大高级研究所)数据集是经典的图像分类基准,包含 60,000 张 32x32 彩色图像,均匀分为 10 个类别:飞机、汽车、鸟、猫、鹿、狗、青蛙、马、船和卡车。该数据集提供预定义划分,包含 50,000 张训练图像和 10,000 张测试图像(每类 6,000 张),是训练和评测分类模型的轻量、均衡起点。如需更细粒度的挑战,请参阅相关的 CIFAR-100 数据集。
在 Ultralytics Platform 上探索 CIFAR-10,即可预览样例、查看数据集统计信息,并克隆数据集用于训练。
观看: 如何使用 CIFAR-10 数据集和 Ultralytics YOLO 训练图像分类模型
主要功能#
- CIFAR-10 包含 60,000 张 32x32 像素的彩色图像,均匀分为 10 个类别。
- 每个类别恰好包含 6,000 张图像,其中 5,000 张用于训练,1,000 张用于测试,因此该数据集完全均衡。
- 10 个类别分别为飞机、汽车、鸟、猫、鹿、狗、青蛙、马、船和卡车。
- 该数据集提供预定义的训练集/测试集划分,因此无需手动或自动划分。
- CIFAR-10 是图像分类和目标识别研究中的标准基准数据集。
数据集结构#
CIFAR-10 提供官方预定义划分,因此无需自动或手动划分:
- 类别:10(飞机、汽车、鸟、猫、鹿、狗、青蛙、马、船、卡车)
- 图像总数:60,000(32x32 彩色图像)
- 训练集:50,000 张图像(每类 5,000 张)
- 测试集:10,000 张图像(每类 1,000 张)
CIFAR-10 没有单独的验证文件夹,因此默认情况下,Ultralytics 会在训练期间将包含 10,000 张图像的测试集用作验证集。
应用场景#
CIFAR-10 常用于训练和评估图像分类模型,涵盖经典的卷积神经网络 (CNNs) 和支持向量机 (SVMs),以及现代深度架构。其图像尺寸较小、类别均衡,非常适合快速实验、新算法基准测试,以及学习计算机视觉基础知识。
用法#
在 CIFAR-10 上以 32 的图像尺寸训练YOLO26n-cls模型 100 个周期。
from ultralytics import YOLO

# 加载模型
model = YOLO("yolo26n-cls.pt")  # 加载预训练模型(推荐用于训练)

# 训练模型
results = model.train(data="cifar10", epochs=100, imgsz=32)示例图像和标注#
CIFAR-10 数据集包含各种对象的彩色图像,为图像分类任务提供了结构良好的数据集。以下是该数据集中的一些图像示例:
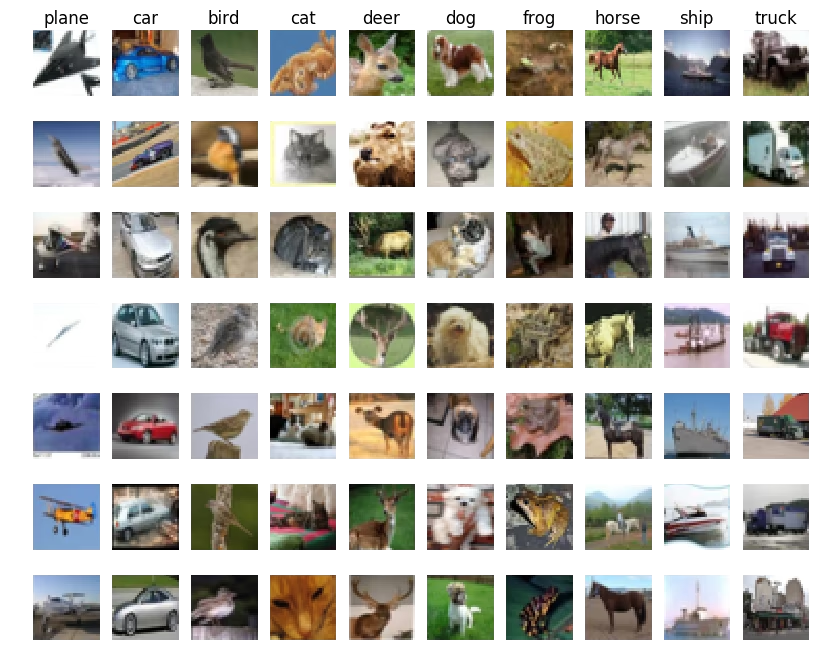
这些样例展现了 CIFAR-10 数据集中物体的多样性,凸显了多样化数据集对于训练稳健图像分类模型的价值。
引用与致谢#
如果你在研究或开发工作中使用 CIFAR-10 数据集,请引用以下论文:
@TECHREPORT{Krizhevsky09learningmultiple,
            author={Alex Krizhevsky},
            title={Learning multiple layers of features from tiny images},
            institution={},
            year={2009}
}
我们谨向 Alex Krizhevsky 致谢,感谢他创建并维护 CIFAR-10 数据集,为机器学习和计算机视觉研究社区提供了宝贵资源。
常见问题#
要使用 CIFAR-10 训练 Ultralytics YOLO 模型,请使用下面的代码片段。首次使用时,数据集会自动下载。参数完整列表请参阅模型的训练页面。
训练示例from ultralytics import YOLO # 加载模型 model = YOLO("yolo26n-cls.pt") # 加载预训练模型(推荐用于训练) # 训练模型 results = model.train(data="cifar10", epochs=100, imgsz=32)CIFAR-10 有 10 个类别:飞机、汽车、鸟、猫、鹿、狗、青蛙、马、船和卡车;每类恰好有 6,000 张图像,总计 60,000 张。各类别互斥且完全均衡,彼此之间没有重叠。
CIFAR-10 提供预定义划分,包含 50,000 张训练图像和 10,000 张测试图像,每类恰好有 5,000 张训练图像和 1,000 张测试图像。与由 Ultralytics 自动划分的基于文件夹的分类数据集不同,CIFAR-10 使用官方划分,不作更改;默认情况下,训练期间测试集会用作验证集。
可以。Ultralytics Platform 可让你管理数据集、训练图像分类模型并部署模型,而无需编写大量代码。它是在云端运行 CIFAR-10 实验的便捷方式,你还可以在我们的分类数据集概览中了解更多选项。


评论
提出问题、分享结果,或帮助其他人。