数据准备#
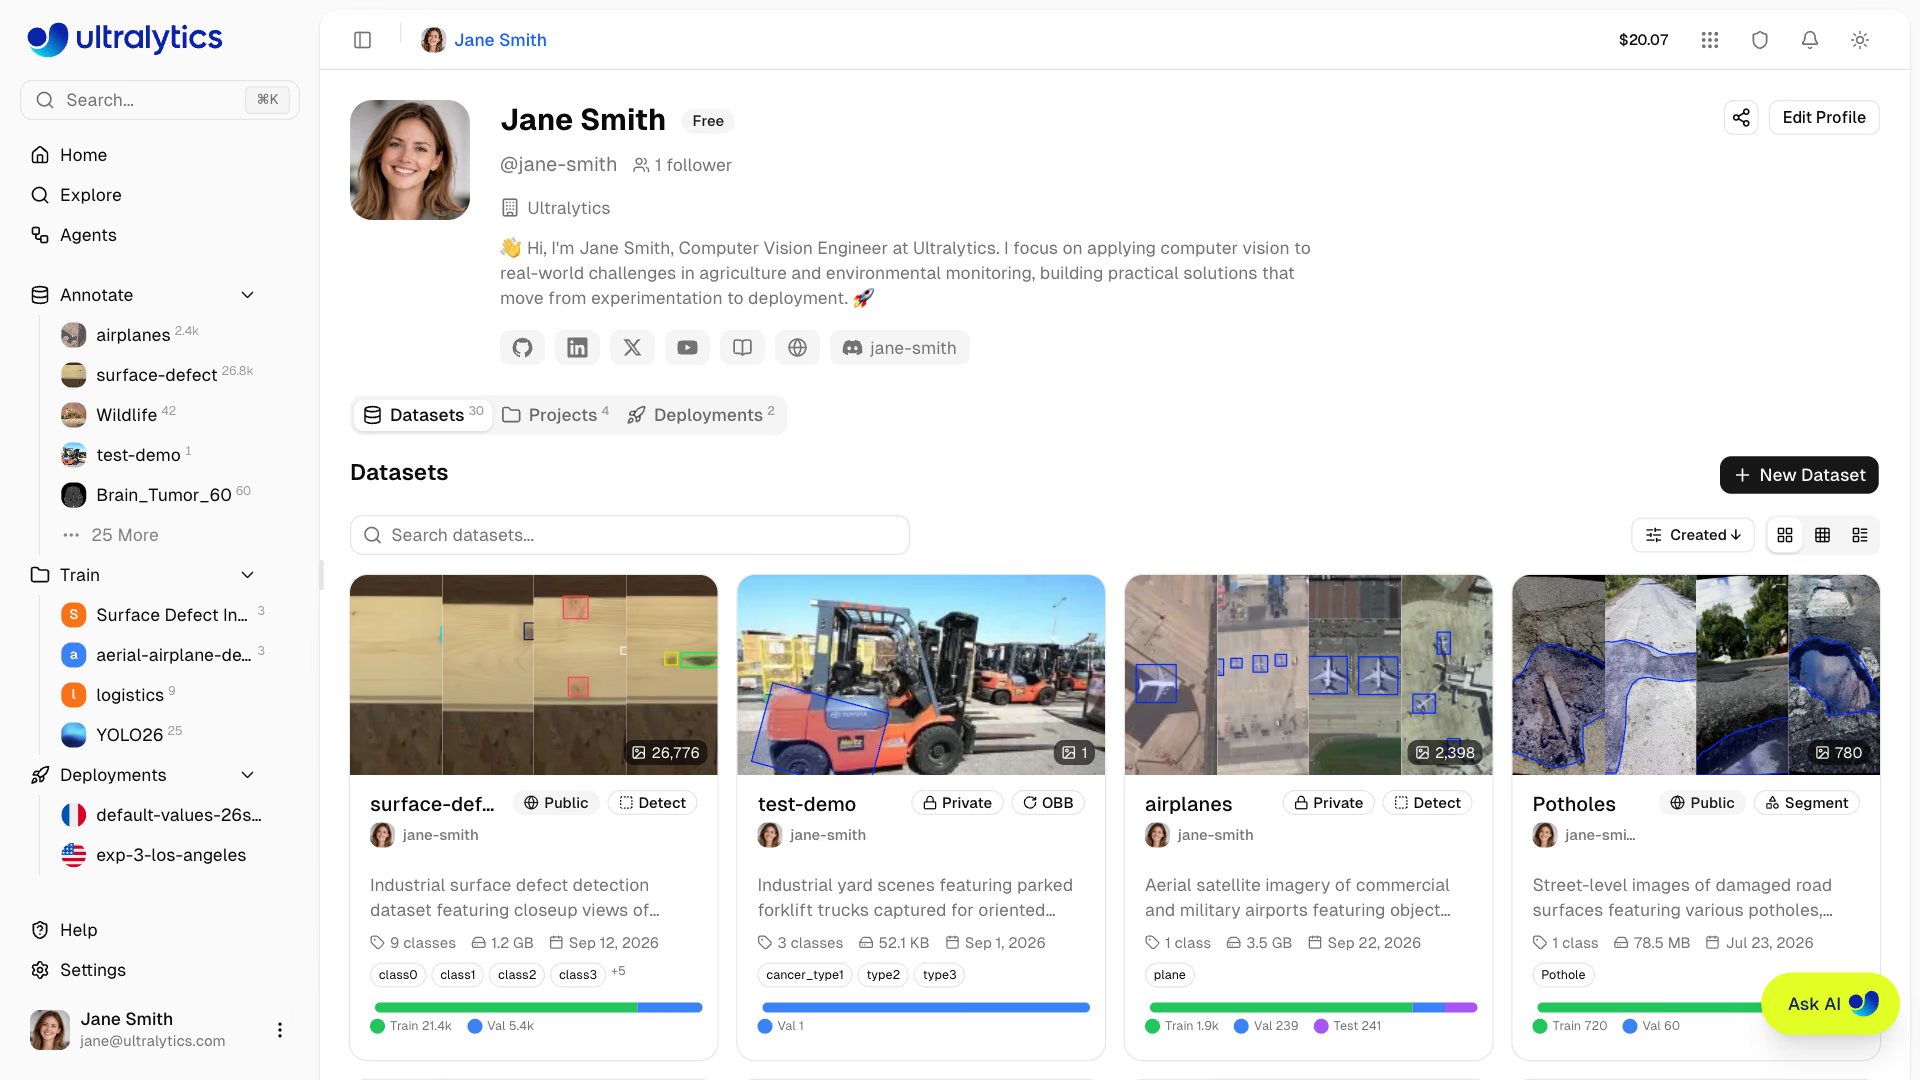
数据准备是成功的计算机视觉模型的基础。Ultralytics Platform提供全面的数据管理工具,涵盖从上传、标注到分析的各个环节。
观看: 开始使用 Ultralytics Platform - 数据
概述#
Ultralytics Platform 的数据部分可帮助你:
- 上传图像、视频和数据集文件(ZIP、TAR,包括
.tar.gz/.tgz、NDJSON) - 从 URL 导入:粘贴存档文件或 NDJSON 导出的直接链接,或从 Roboflow 导入
- 连接Google Cloud Storage、Amazon S3或 Azure Blob Storage,无需上传副本,即可直接使用其中的数据
- 通过企业版本地部署 CPU/GPU 工作器,让像素数据保留在本地
- 在包含 1–200 个类别的检测数据集上,使用手动绘图工具和 SAM 智能标注(SAM 2.1、SAM 3或默认的 SAM 3.1)、YOLO 模型或按类别提示的模型进行标注;模型可以是托管的开源模型或付费提供商模型
- 通过重命名、重新着色、合并和删除类别,在整个数据集中管理类别
- 通过查找相似图像或生成相似图像扩充数据集,然后标注保留的图像
- 对现有图像或之后上传的图像进行人脸模糊处理
- 通过统计数据、可视化和基于嵌入的聚类分析数据
- 以 NDJSON 格式导出,用于本地训练
工作流#
| 阶段 | 说明 |
|---|---|
| 上传 | 导入图像、视频或存档文件并自动处理 |
| 标注 | 使用手动工具标注数据,或在包含 1–200 个类别的检测数据集上使用 SAM 智能标注(检测、分割、语义和 OBB)、YOLO 或按类别提示的模型;模型可以是托管的开源模型或付费提供商模型 |
| 分析 | 查看类别分布、空间热力图、尺寸统计数据和嵌入聚类 |
| 导出 | 下载NDJSON 格式的数据以供离线使用 |
支持的任务#
Ultralytics Platform 数据集支持全部 7 种 YOLO 任务类型:
| 任务 | 说明 | 标注工具 |
|---|---|---|
| 检测 | 使用边界框进行目标检测 | 矩形工具 |
| 实例分割 | 使用像素掩码进行实例分割 | 多边形工具 |
| 语义分割 | 按类别划分像素区域的语义分割 | 多边形工具 |
| 深度 | 逐像素度量深度图 | 导入的目标 |
| 分类 | 图像级分类 | 类别选择器 |
| 姿态 | 使用内置和自定义骨架模板进行关键点估计 | 关键点工具 |
| OBB | 用于旋转目标的有向边界框 | 有向框工具 |
创建数据集时会设置任务类型,并据此确定可用的标注工具。之后,你可以通过数据集标题栏中的任务选择器更改任务类型,但切换后将不会显示不兼容的标注。只有数据集为空时,才允许切换到深度任务或从深度任务切换到其他任务——详见编辑数据集。
主要功能#
智能存储#
Ultralytics Platform 会高效管理存储:
- 重复数据删除:同一数据区域中的相同图像只存储一次
- 完整性:验证上传内容以确保数据完整性
- 效率:优化存储并加快处理速度
数据集 URI#
使用 ul:// URI 格式引用数据集(参见使用 Platform 数据集):
yolo train model=yolo26n.pt data=ul://username/datasets/my-dataset配置好API 密钥后,你就可以从任何计算机上使用 Platform 数据集进行训练。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="ul://username/datasets/my-dataset", epochs=100)数据集版本控制#
创建不可变的 NDJSON 快照,以便进行可复现训练。每个版本都会记录创建时的图像数量、类别数量和标注数量。详情请参阅版本选项卡。
数据集选项卡#
根据数据集状态和你的权限,数据集页面最多可显示六个选项卡:
| 选项卡 | 说明 |
|---|---|
| 图像 | 以网格、紧凑或表格视图浏览图像,并叠加显示标注 |
| 类别 | 查看、重命名、重新着色、合并和删除类别,并查看每个类别的标签数量 |
| 图表 | 自动统计数据:数据划分分布、类别数量、热力图 |
| 模型 | 在此数据集上训练的模型,包含指标和状态 |
| 版本 | 创建、比较、下载和还原不可变的 NDJSON 快照 |
| 错误 | 处理失败的图像,以及错误详情和修复指南 |
当数据集包含图像且其任务设有类别时,会显示 Classes;只要数据集包含图像,就会显示 Charts。只有存在处理失败时,才会显示 Errors。当你拥有编辑权限时会显示 Versions;如果已有版本,则只读模式下也会显示。
聚类#
将数据集作为交互式二维散点图进行探索:视觉上相似的图像会彼此靠近,有助于发现聚类、重复图像和离群值,并检查数据划分或类别在数据中的分布情况。套索选取一个区域或点击某个点,即可筛选图库,只显示对应图像。分析要求图像数量在 20 到 200,000 张之间,且这些图像不能有处理错误。借助相同的嵌入,你可以在公开数据集、自己的数据集和团队数据集中查找相似图像,并将图像添加到自己的数据集中。详情请参阅聚类。
统计与可视化#
Charts 选项卡会提供自动分析,包括:
- 数据划分分布:以环形图显示训练/验证/测试图像数量
- 热门类别:以环形图显示标注数量最多的 10 个类别
- 图像尺寸:图像宽度和高度分布直方图(单位:像素)
- 图像尺寸 2D:宽度与高度的二维热力图,带有宽高比参考线
- 标注位置:边界框中心位置的二维热力图
- 每个实例的点数:多边形顶点或关键点数量分布(分割/姿态数据集)
查看 Charts 选项卡 获取完整列表。
快速链接#
常见问题#
Ultralytics Platform 支持:
图像: JPEG、PNG、WebP、BMP、TIFF、HEIC、AVIF、JP2、DNG、MPO(每个文件最大 50MB)
视频: MP4、WebM、MOV、MKV、M4V(最大 1GB,按 1 FPS 抽取帧,最多 100 帧)
数据集文件: ZIP 或 TAR 压缩包,包含
.tar.gz和.tgz(Free 版最大 10GB、Pro 版 20GB、Enterprise 版 50GB),其中可包含图像以及可选的 YOLO 格式、COCO JSON 或 LabelMe JSON 标签、语义 PNG 掩码或深度图,以及 Ultralytics NDJSON 或 Labelbox NDJSON 导出文件也可以在
New Dataset对话框的URL选项卡中粘贴直接 HTTP(S) 链接,导入上述任意压缩包或 NDJSON 格式。系统会检测 Pascal VOC XML 标签,但不会导入。存储限制取决于你的套餐:
套餐 存储上限 Free 100 GB Pro 500 GB Enterprise 无限 单个文件限制:图像 50MB,视频 1GB,数据集 Free 版 10GB / Pro 版 20GB / Enterprise 版 50GB
可以!使用数据集 URI 格式进行本地训练:
export ULTRALYTICS_API_KEY="YOUR_API_KEY"
yolo train model=yolo26n.pt data=ul://username/datasets/my-dataset epochs=100
或者,将数据集导出为 NDJSON 格式,以便传输元数据、数据划分、标注和签名图像 URL。