تقنيات المعالجة المسبقة لبيانات الرؤية الحاسوبية المعلّق عليها#
تُحوِّل المعالجة المسبقة للبيانات الصور الخام المُعلَّمة إلى مدخلات نظيفة ومتسقة يحتاج إليها نموذج الرؤية الحاسوبية للتدريب بكفاءة. مع Ultralytics YOLO26، تُنفَّذ عمليات معالجة البكسل الأساسية — التحويل إلى RGB، والتحجيم إلى [0, 1]، وتغيير الحجم — تلقائيًا ضمن مسار التدريب، لذا يقتصر العمل المتبقي على تقسيم مجموعة البيانات على نحو صحيح، وموازنة الفئات، واختيار أساليب زيادة البيانات. يغطي هذا الدليل التقنيات الأساسية: تغيير الحجم، والتطبيع، وتقسيم مجموعة البيانات، وزيادة البيانات، والتحليل الاستكشافي للبيانات (EDA).
شاهد: كيفية استخدام المعالجة المسبقة للبيانات وزيادتها لتحسين دقة النماذج في سيناريوهات العالم الحقيقي 🚀
تأتي هذه الخطوة بعد أن حدّدت أهداف مشروعك وجمعت بياناتك وعلّقت عليها، وتقع في مرحلة مبكرة من سير عمل مشروع الرؤية الحاسوبية.
أهمية المعالجة المسبقة#
تجهّز المعالجة المسبقة بياناتك بتنسيق يقلل العبء الحسابي ويحسّن أداء النموذج. وتعالج ثلاث مشكلات شائعة في البيانات الخام:
- الضوضاء: اختلافات غير ذات صلة أو عشوائية في البيانات.
- عدم الاتساق: اختلافات في أحجام الصور وتنسيقاتها وجودتها.
- اختلال التوازن: توزيع غير متكافئ للفئات أو التصنيفات في مجموعة البيانات.
تقنيات المعالجة المسبقة#
التقنيات الرئيسية هي تغيير الحجم، والتطبيع، وتقسيم مجموعة البيانات، وزيادة البيانات. ينفّذ YOLO26 أول عمليتين تلقائيًا، بينما يكون لاختياراتك الأثر الأكبر في التقسيم وزيادة البيانات.
تغيير حجم الصور#
تتطلب نماذج كثيرة حجم إدخال موحّدًا، لذا يجعل تغيير الحجم الصور متجانسة ويقلل التعقيد الحسابي. ومن طريقتَي الاستيفاء الشائعتين:
- الاستيفاء ثنائي الخطية: ينعّم قيم البكسل من خلال حساب متوسط مرجّح لأقرب أربعة بكسلات.
- أقرب جار: ينسخ قيمة أقرب بكسل من دون حساب المتوسط — وهو أسرع، لكنه ينتج صورة أكثر تكتلًا.
توفر مكتبات مثل OpenCV وPIL (Pillow) هذه الوظائف، لكنك عادة لا تحتاج إلى تغيير الحجم يدويًا عند استخدام YOLO26. تتولى الوسيطة imgsz ذلك. في مسار الصور المربعة ثابتة الحجم، تنشئ عملية التحقق والاستدلال حوافًا حول الصور لتقترب من إدخال imgsz × imgsz، مثل 640 × 640، مع الحفاظ على نسبة العرض إلى الارتفاع وإضافة حشوة رمادية (القيمة 114). تُصغّر الصور الأكبر لتناسب الحجم، بينما لا تُكبّر الصور الأصغر عند تعطيل التكبير. في مسار التدريب الافتراضي، تضع mosaic=1.0 أربع صور على لوحة أكبر ثم تقصها إلى imgsz؛ وعندما تعطل close_mosaic عملية mosaic في الحقب الأخيرة، تُضاف حواف حول الصور ثم تظل خاضعة لتحويلات عشوائية بدلًا من تمريرها من دون تغيير. تستخدم الدُفعات المستطيلة (rect=True) وmulti_scale أشكال إدخال مختلفة.
تطبيع قيم البكسل#
يحوّل التطبيع قيم البكسل إلى نطاق معياري، ما يساعد النموذج على التقارب بسرعة أكبر أثناء التدريب. ومن الطريقتين الشائعتين:
- تحجيم الحد الأدنى والأقصى: يحوّل قيم البكسل إلى نطاق من 0 إلى 1.
- تطبيع Z-score: يحوّل قيم البكسل استنادًا إلى المتوسط والانحراف المعياري.
يتولى YOLO26 التطبيع تلقائيًا ضمن مسار المعالجة المسبقة: فهو يحوّل الصور إلى RGB ويحوّل قيم البكسل إلى النطاق [0, 1] بقسمتها على 255 (تحجيم الحد الأدنى والأقصى). لا يطبّق YOLO افتراضيًا التطبيع باستخدام المتوسط والانحراف المعياري على غرار ImageNet (تطبيع Z-score)، لذا لا حاجة إلى خطوة تطبيع يدوية.
تقسيم مجموعة البيانات#
يتيح لك تقسيم البيانات إلى مجموعات التدريب والتحقق والاختبار تقييم النموذج على بيانات لم يسبق له رؤيتها وقياس قدرته على التعميم. ومن التقسيمات الشائعة تخصيص 70% للتدريب و20% للتحقق و10% للاختبار. وتسهّل أدوات مثل scikit-learn أو TensorFlow هذه العملية.
ضع النقاط التالية في الحسبان عند تقسيم البيانات:
- الحفاظ على توزيع الفئات: احرص على تمثيل كل فئة بنسبة متناسبة في مجموعات التدريب والتحقق والاختبار.
- موازنة الفئات: في مجموعات البيانات غير المتوازنة، فكّر في الإفراط في أخذ العينات للفئة الأقلية أو تقليل أخذ العينات من الفئة الأكثرية — ضمن مجموعة التدريب فقط.
قسّم مجموعة البيانات قبل تطبيق أي زيادة للبيانات أو غيرها من عمليات المعالجة المسبقة، وطبّق هذه التحويلات على مجموعة التدريب فقط. تؤدي زيادة البيانات قبل التقسيم إلى تسرب معلومات من صور التحقق أو الاختبار إلى التدريب، ما ينتج عنه درجات مرتفعة بصورة مضللة تنهار عند استخدام بيانات العالم الحقيقي.
زيادة مجموعة البيانات#
تزيد زيادة البيانات حجم مجموعة البيانات اصطناعيًا من خلال إنشاء نسخ معدّلة من الصور الموجودة. وتساعد على الحد من فرط التكيّف وتحسين التعميم، فضلًا عن عدة فوائد:
- نماذج أكثر متانة: تجعل الاختلافات في الإضاءة والاتجاه والمقياس النموذج أكثر مقاومة للتشوهات الواقعية.
- فعّالة من حيث التكلفة: توسّع مجموعة التدريب دون جمع بيانات جديدة ووسمها.
- استفادة أفضل من البيانات: تنتج كل صورة معلّق عليها أشكالًا متعددة للتدريب.
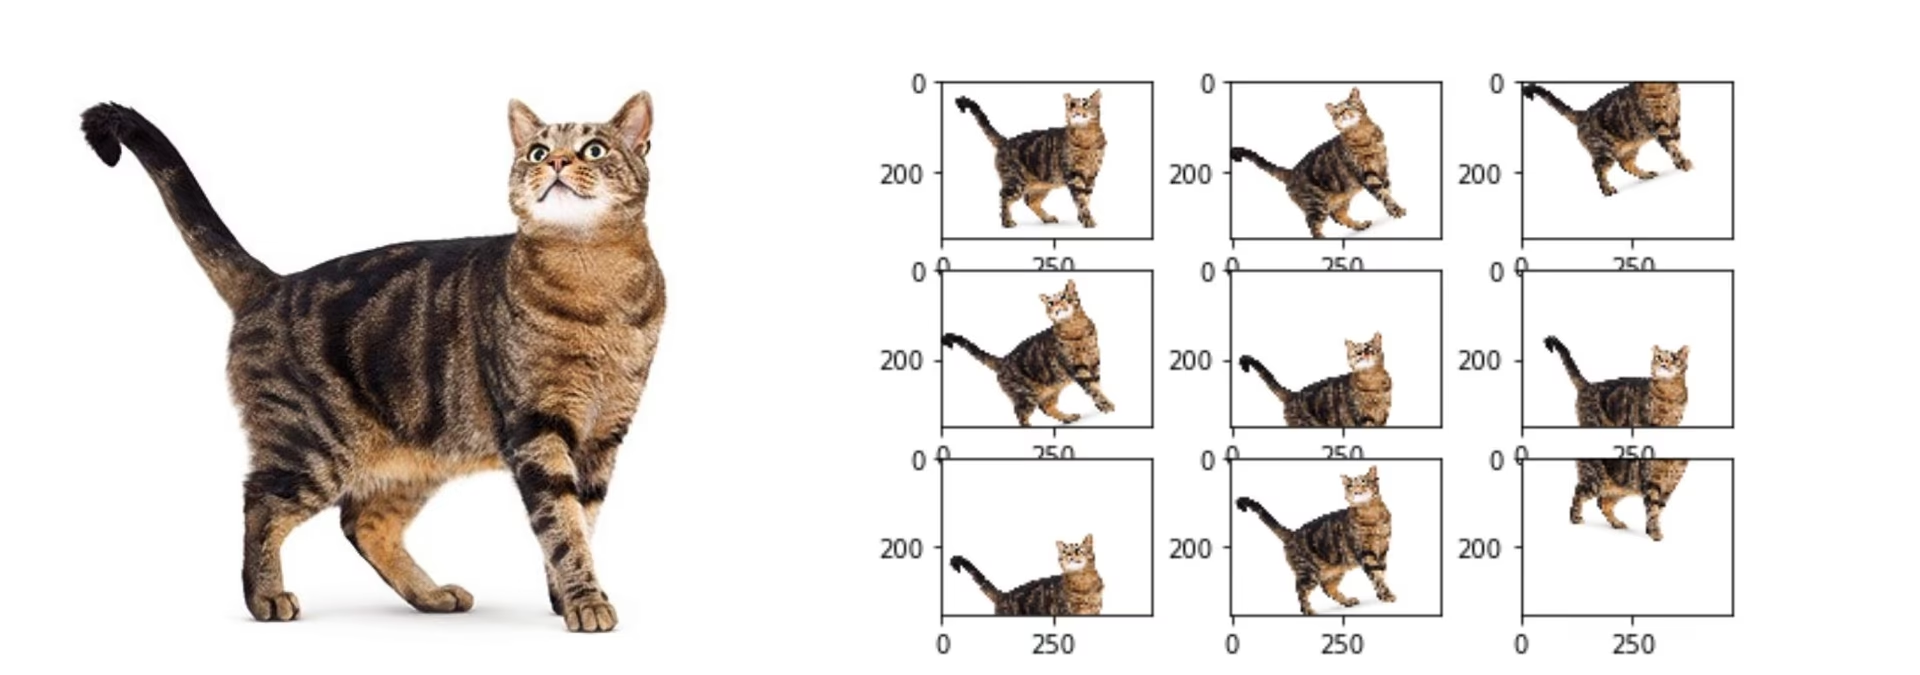
في YOLO26، يُضبط مستوى زيادة البيانات عبر وسيطات التدريب التي تُمرّر إلى model.train() أو إلى رايات CLI المكافئة، لا عبر تحرير YAML مجموعة البيانات، الذي يعرّف بيانات وصفية للمجموعة مثل المسارات وأسماء الفئات والتقسيمات. والاستثناء الوحيد هو flip_idx: إذ تعرّفه مجموعات بيانات الوضعية في YAML مجموعة البيانات لربط أزواج النقاط المفتاحية اليسرى واليمنى، ويعطّل YOLO تمامًا fliplr وflipud عند غيابه. وتشمل عمليات زيادة البيانات المدمجة ما يلي:
- Mosaic وMixUp وCutMix (
mosaic،mixup،cutmix): دمج عدة صور في عينة تدريب واحدة. - القلب (
fliplr،flipud): عكس الصور أفقيًا أو عموديًا. - التحويلات الهندسية (
degrees،translate،scale،shear،perspective): تدوير الصور وإزاحتها وتكبيرها وتشويهها. - تغيير ألوان HSV (
hsv_h،hsv_s،hsv_v): تغيير درجة اللون والتشبّع والسطوع. - النسخ واللصق (
copy_paste): لصق نسخ إضافية من الكائنات المقسّمة، مع عكسها داخل الصورة نفسها افتراضيًا أو أخذها من صورة أخرى باستخدامcopy_paste_mode=mixup. - تبديل القنوات (
bgr): تبديل ترتيب قنوات RGB إلى BGR. - تحويلات التصنيف (
auto_augment،erasing): تطبيق سياسة آلية لزيادة البيانات والمحو العشوائي عند تدريب مصنّف.
from ultralytics import YOLO
model = YOLO("yolo26n.pt")
# يُضبط مستوى زيادة البيانات باستخدام وسيطات التدريب، وليس YAML مجموعة البيانات
model.train(data="coco8.yaml", epochs=10, hsv_h=0.015, fliplr=0.5, mosaic=1.0, degrees=10.0)للاطلاع على القائمة الكاملة لوسيطات زيادة البيانات وقيمها الافتراضية، راجع مرجع إعدادات زيادة البيانات ودليل زيادة بيانات YOLO المخصّص. وإذا كانت حزمة albumentations مثبتة، يفعّل YOLO أيضًا تلقائيًا عمليات زيادة البيانات المدمجة المعتمدة على Albumentations.
دراسة حالة: المعالجة المسبقة لكشف المركبات#
لنفترض وجود مشروع لكشف المركبات وتصنيفها في صور حركة المرور باستخدام YOLO26، بدءًا من صور موسومة ومزوّدة بـمربعات إحاطة. إليك كيفية تطبيق كل قرار من قرارات المعالجة المسبقة:
- تغيير الحجم: لا حاجة إلى عمل يدوي — يغيّر YOLO26 الحجم إلى
imgszأثناء التدريب. - التطبيع: لا حاجة إلى عمل يدوي — يحوّل YOLO26 قيم البكسل تلقائيًا إلى
[0, 1]. - التقسيم: قسّم مجموعة البيانات إلى 70% للتدريب و20% للتحقق و10% للاختبار، مع الحفاظ على اتساق توزيع الفئات بين التقسيمات.
- زيادة البيانات: اضبط وسيطات التدريب بما يتناسب مع مشاهد حركة المرور — مثل
fliplrلاستقلالية الاتجاه، وhsv_vلإضاءة النهار والليل، وmosaicلتفاوت كثافة الكائنات.
بعد اتخاذ هذه القرارات، تصبح مجموعة البيانات جاهزة لتحليل البيانات الاستكشافي (EDA).
تحليل البيانات الاستكشافي (EDA)#
يستخدم تحليل البيانات الاستكشافي الإحصاءات والتصورات المرئية للكشف عن الأنماط والتوزيعات في بياناتك، ما يساعدك على اكتشاف مشكلات مثل اختلال توازن الفئات أو القيم الشاذة قبل التدريب.
أساليب تحليل البيانات الاستكشافي الإحصائي#
يبدأ تحليل البيانات الاستكشافي الإحصائي بمقاييس أساسية — المتوسط والوسيط والانحراف المعياري والمدى — تُحسب لخصائص مثل توزيعات شدة البكسل. وتوفر هذه المقاييس لمحة سريعة عن جودة مجموعة البيانات، وتكشف مبكرًا عن حالات عدم الانتظام.
أساليب تحليل البيانات الاستكشافي المرئي#
تكشف التصورات المرئية عن أنماط لا تظهر في الإحصاءات الملخّصة، مثل اختلال توازن الفئات والقيم الشاذة. وتشمل الأدوات الشائعة:
- المخططات الهيستوغرامية والصندوقية: تعرض توزيع قيم البكسل وتكشف القيم الشاذة في توزيعات الشدة أو الخصائص.
- المخططات الشريطية: تكشف اختلال توازن الفئات من خلال مقارنة عدد الأمثلة في كل فئة.
- المخططات المبعثرة: تستكشف العلاقات بين خصائص الصور أو التعليقات التوضيحية.
- الخرائط الحرارية: تصوّر توزيعات شدة البكسل أو التوزيع المكاني للتعليقات التوضيحية عبر الصور.
منصة Ultralytics لتحليل البيانات الاستكشافي#
لإجراء تحليل البيانات الاستكشافي من دون كتابة أي تعليمات برمجية، ارفع مجموعة بياناتك إلى منصة Ultralytics. تنشئ علامة التبويب Charts الخاصة بمجموعة البيانات تلقائيًا تصورات أساسية لتحليل البيانات الاستكشافي: توزيع التقسيمات، وأعداد الفئات الأكثر شيوعًا، ومخططات هيستوغرامية لعرض الصور وارتفاعها، وخرائط حرارية ثنائية الأبعاد لمواضع التعليقات التوضيحية وأبعاد الصور. وتتيح لك علامة التبويب Images استعراض بياناتك في عروض الشبكة أو العرض المدمج أو الجدول، مع تراكبات للتعليقات التوضيحية، ما يسهّل اكتشاف الأمثلة ذات الوسوم الخاطئة أو الفئات غير المتوازنة دون كتابة أي تعليمات برمجية.
الخلاصة#
يساعد تقسيم البيانات وتطبيعها وزيادتها على نحو سليم في تقليل الضوضاء وتحسين التعميم، وتحويل مجموعة خام من الصور إلى مجموعة تدريب موثوقة. بعد المعالجة المسبقة لمجموعة بياناتك، تتمثل الخطوة التالية في تدريب نموذجك. وإذا ظهرت أسئلة في أثناء ذلك، فاطرحها على المجتمع في مستودع Ultralytics على GitHub أو خادم Ultralytics على Discord.
الأسئلة الشائعة#
تضمن المعالجة المسبقة أن تكون بياناتك نظيفة ومتسقة وبتنسيق ملائم للتدريب. ومن خلال معالجة الضوضاء وعدم الاتساق واختلال توازن الفئات في البيانات الخام، تقلل خطوات مثل تغيير الحجم والتطبيع وزيادة البيانات وتقسيم مجموعة البيانات العبء الحسابي وتحسّن أداء النموذج. اطّلع على خطوات مشروع الرؤية الحاسوبية لمعرفة موقع هذه العملية ضمن سير العمل الأوسع.
اضبط زيادة البيانات عبر وسيطات التدريب بدلًا من YAML مجموعة البيانات. مرّر وسيطات مثل
fliplrوmosaicوhsv_hوdegreesإلىmodel.train()(أو رايات CLI المكافئة) لتحديد احتمال كل تحويل ومستوى شدته. توضّح إعدادات زيادة البيانات هذه الخيارات، ويشرحها دليل زيادة بيانات YOLO. وتُستثنى مجموعات بيانات الوضعية: إذ يوجد تعيين النقاط المفتاحيةflip_idxالخاص بها في YAML مجموعة البيانات، وتُعطّل عمليات القلب عند غيابه.أكثر التقنيات شيوعًا هما تحجيم الحد الأدنى والأقصى (إعادة تحجيم البكسلات إلى نطاق من 0 إلى 1) وتطبيع Z-score (إعادة التحجيم استنادًا إلى المتوسط والانحراف المعياري). يطبّق YOLO26 تحجيم الحد الأدنى والأقصى تلقائيًا — إذ يحوّل الصور إلى RGB ويقسم قيم البكسل على 255 — لذا لا تحتاج إلى خطوة تطبيع يدوية. ولا يطبّق تطبيع Z-score افتراضيًا.
من الممارسات الشائعة تخصيص 70% للتدريب و20% للتحقق و10% للاختبار. حافظ على توزيع الفئات في التقسيمات الثلاثة، وتجنّب تسرّب البيانات بتطبيق زيادة البيانات على مجموعة التدريب فقط بعد التقسيم. وتعالج أدوات مثل scikit-learn أو TensorFlow التقسيم بكفاءة. راجع دليل جمع البيانات والتعليق التوضيحي عليها للاطلاع على إعداد مجموعة البيانات في المراحل السابقة.
نعم. تتحكم الوسيطة
imgszفي حجم الإدخال المستهدف، دون الحاجة إلى عمل يدوي. في مسار الصور المربعة ثابتة الحجم، تضيف عمليتا التحقق والاستدلال حوافًا حول الصور لتقريبها من الشكل المحدد مع الحفاظ على نسبة العرض إلى الارتفاع؛ وتُصغّر الصور الأكبر لتناسب الحجم، بينما لا تُكبّر الصور الأصغر عند تعطيل التكبير. أثناء التدريب، تصل زيادة البيانات الافتراضية من نوع mosaic إلى الحجم المستهدف عبر ترتيب أربع صور وقصّها بدلًا من ذلك. تستخدم الدُفعات المستطيلة (rect=True) وmulti_scaleأشكال إدخال مختلفة. راجع وثائق تدريب النموذج للاطلاع على التفاصيل.