استراتيجيات جمع البيانات ووسمها للرؤية الحاسوبية#
جمع البيانات ووسمها هما الخطوتان الأساسيتان في كل مشروع للرؤية الحاسوبية: إذ تجمع صورًا أو مقاطع فيديو تمثيلية، ثم تضع لها تسميات حتى يتمكن النموذج من التعلم منها. وتحدد جودة هذه البيانات أداء النموذج مباشرةً، ولذلك يُعد تعريف الفئات، ومصادر البيانات غير المتحيزة، والوسم المتسق أمورًا مهمة قبل بدء أي تدريب.
Watch: How to Build Effective Data Collection and Annotation Strategies for Computer Vision 🚀
يغطي هذا الدليل إعداد الفئات وجمع البيانات، وماهية وسم البيانات إلى جانب أنواع الوسم والتنسيقات التي يمكن اختيارها، واستراتيجيات الوسم الفعّالة — بحيث يتوافق كل قرار مع أهداف مشروعك.
إعداد الفئات وجمع البيانات#
ينحصر جمع الصور ومقاطع الفيديو لمشروع رؤية حاسوبية في ثلاثة قرارات: عدد الفئات التي ينبغي تعريفها، ومصدر البيانات، وكيفية إبقاء مجموعة البيانات خالية من التحيز.
اختيار الفئات المناسبة لمشروعك#
من أولى الأسئلة عند بدء مشروع للرؤية الحاسوبية: كم عدد الفئات التي ينبغي تضمينها؟ عليك تحديد عضوية الفئات، أي الفئات أو التسميات المختلفة التي تريد أن يتعرف النموذج عليها ويميز بينها. وينبغي تحديد عدد الفئات وفقًا للأهداف المحددة لمشروعك.
على سبيل المثال، إذا أردت مراقبة حركة المرور، فقد تشمل فئاتك "سيارة" و"شاحنة" و"حافلة" و"دراجة نارية" و"دراجة هوائية". أما إذا كنت تتتبع العناصر في متجر، فقد تكون فئاتك "فواكه" و"خضروات" و"مشروبات" و"وجبات خفيفة". ويساعد تعريف الفئات استنادًا إلى أهداف مشروعك في إبقاء مجموعة البيانات ملائمة ومركزة.
عند تعريف فئاتك، هناك تمييز مهم آخر يتمثل في اختيار عدد فئات إجمالي أو تفصيلي. يشير «العدد» إلى عدد الفئات المميزة التي تهمك. ويؤثر هذا القرار في دقة بياناتك وتعقيد نموذجك. فيما يلي اعتبارات كل نهج:
- عدد الفئات الإجمالي: فئات أوسع وأكثر شمولًا، مثل "مركبة" و"غير مركبة". وهي تبسط عملية الوسم وتتطلب موارد حوسبة أقل، لكنها توفر معلومات أقل تفصيلًا، ما قد يحد من فعالية النموذج في السيناريوهات المعقدة.
- عدد الفئات التفصيلي: فئات أكثر مع تمييزات أدق، مثل "سيارة سيدان" و"SUV" و"شاحنة صغيرة" و"دراجة نارية". وهي تلتقط معلومات أكثر تفصيلًا، مما يحسن دقة النموذج وأداءه. لكنها تستغرق وقتًا أطول وتتطلب جهدًا أكبر في الوسم، كما تحتاج إلى موارد حوسبة إضافية.
قد يكون البدء بفئات أكثر تحديدًا مفيدًا جدًا، لا سيما في المشاريع المعقدة التي تكون فيها التفاصيل مهمة. تتيح لك الفئات الأكثر تحديدًا جمع بيانات أكثر تفصيلًا، واكتساب رؤى أعمق، وإرساء تمييزات أوضح بين الفئات. ولا يؤدي ذلك إلى تحسين دقة النموذج فحسب، بل يسهل أيضًا تعديل النموذج لاحقًا عند الحاجة، مما يوفر الوقت والموارد.
مصادر البيانات#
يمكنك استخدام مجموعات بيانات عامة أو جمع بيانات مخصصة بنفسك. توفر مجموعات البيانات العامة، مثل تلك الموجودة على Kaggle ومحرك البحث عن مجموعات بيانات Google، بيانات موحدة وموَسومة جيدًا، مما يجعلها نقاط انطلاق رائعة لتدريب النماذج والتحقق منها.
أما جمع البيانات المخصصة فيتيح لك تخصيص مجموعة البيانات وفق احتياجاتك المحددة. فقد تلتقط الصور ومقاطع الفيديو باستخدام الكاميرات أو الطائرات المسيّرة، أو تجمع الصور من الويب، أو تستخدم بيانات داخلية موجودة لدى مؤسستك. وتمنحك البيانات المخصصة تحكمًا أكبر في جودتها وملاءمتها. ويساعد الجمع بين مصادر البيانات العامة والمخصصة في إنشاء مجموعة بيانات متنوعة وشاملة.
تجنب التحيز في جمع البيانات#
يحدث التحيز عندما تكون مجموعات أو سيناريوهات معينة ممثلة بأقل من اللازم أو بأكثر منه في مجموعة بياناتك. ويؤدي ذلك إلى نموذج يحقق أداءً جيدًا على بعض البيانات وأداءً ضعيفًا على بيانات أخرى. ومن الضروري تجنب التحيز في الذكاء الاصطناعي حتى يتمكن نموذج الرؤية الحاسوبية لديك من الأداء جيدًا في مجموعة متنوعة من السيناريوهات.
إليك كيفية تجنب التحيز أثناء جمع البيانات:
- مصادر متنوعة: اجمع البيانات من مصادر عديدة لالتقاط وجهات نظر وسيناريوهات مختلفة.
- تمثيل متوازن: احرص على تمثيل متوازن لجميع المجموعات ذات الصلة. فعلى سبيل المثال، ضع في الاعتبار الأعمار والأجناس والأعراق المختلفة.
- المراقبة المستمرة: راجع مجموعة بياناتك وحدّثها بانتظام لاكتشاف أي تحيزات ناشئة ومعالجتها.
- تقنيات الحد من التحيز: استخدم أساليب مثل الإفراط في أخذ العينات من الفئات ناقصة التمثيل، وزيادة البيانات، والخوارزميات المراعية للإنصاف.
يساعد اتباع هذه الممارسات في إنشاء نموذج أكثر متانة وإنصافًا، ويمكنه التعميم جيدًا في التطبيقات الواقعية.
ما هو وسم البيانات؟#
وسم البيانات هو عملية وضع تسميات على البيانات لجعلها قابلة للاستخدام في تدريب نماذج التعلم الآلي. وفي الرؤية الحاسوبية، يعني ذلك وسم الصور أو مقاطع الفيديو بالمعلومات التي يحتاج النموذج إلى التعلم منها. ومن دون بيانات موَسومة بطريقة صحيحة، لا تستطيع النماذج تعلم العلاقات بين المدخلات والمخرجات بدقة.
أنواع وسم البيانات#
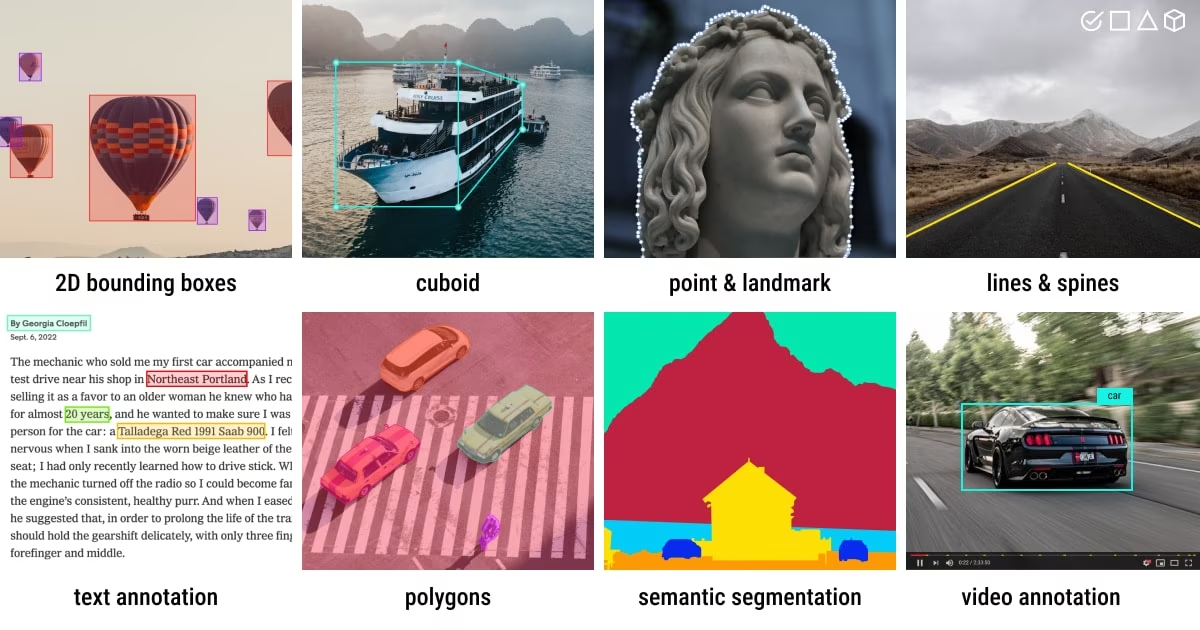
اعتمادًا على المتطلبات المحددة لـمهمة الرؤية الحاسوبية، توجد أنواع مختلفة من وسم البيانات. إليك بعض الأمثلة:
- المربعات المحيطة: مربعات مستطيلة تُرسم حول العناصر في الصورة، وتُستخدم أساسًا لمهام اكتشاف العناصر. وتُحدَّد هذه المربعات بإحداثيات الزاويتين العلوية اليسرى والسفلية اليمنى.
- المضلعات: مخططات تفصيلية للعناصر، تتيح وسمًا أدق من المربعات المحيطة. وتُستخدم المضلعات في مهام مثل تجزئة المثيلات، حيث يكون شكل العنصر مهمًا.
- الأقنعة: أقنعة ثنائية يكون كل بكسل فيها إما جزءًا من عنصر أو جزءًا من الخلفية. وتُستخدم الأقنعة في مهام التجزئة الدلالية لتوفير تفاصيل على مستوى البكسل.
- النقاط الرئيسية: نقاط محددة تُعلَّم داخل الصورة لتحديد المواضع المهمة. وتُستخدم النقاط الرئيسية في مهام مثل تقدير الوضعية واكتشاف معالم الوجه.
- المربعات المحيطة الموجَّهة: مستطيلات تحمل زاوية دوران، وتُستخدم في مهام OBB حيث تظهر العناصر في اتجاهات عشوائية، مثل الصور الجوية.
تنسيقات الوسم الشائعة#
بعد اختيار نوع الوسم، من المهم اختيار التنسيق المناسب لتخزين التسميات ومشاركتها. وأكثر التنسيقات شيوعًا هي:
| التنسيق | بنية الملف | الاستخدامات الشائعة |
|---|---|---|
| COCO | ملف JSON واحد | اكتشاف العناصر، وتجزئة المثيلات، واكتشاف النقاط الرئيسية، وتجزئة الأشياء والتجزئة البانوبتيكية، ووصف الصور |
| Pascal VOC | ملف XML واحد لكل صورة | اكتشاف العناصر |
| YOLO | ملف .txt واحد لكل صورة | اكتشاف العناصر، والتجزئة، والوضعية، والمربعات الموجَّهة |
يخزن تنسيق YOLO صفًا واحدًا لكل عنصر، مع بدء فهارس الفئات من 0. في اكتشاف العناصر، يكون الصف هو class x_center y_center width height مع إحداثيات مُطبَّعة بين 0 و1. ويستبدل صف التجزئة المربعَ بنقاط مضلع العنصر المُطبَّعة، بينما يحتفظ صف الوضعية بالمربع ويُلحق به إحداثيات النقاط الرئيسية، مع علامة رؤية لكل نقطة رئيسية عندما تعلن مجموعة البيانات عن kpt_shape: [n, 3]. ويخزن صف OBB القيمة class x1 y1 x2 y2 x3 y3 x4 y4 باستخدام إحداثيات الزوايا المُطبَّعة.
إذا كانت أداة الوسم لديك تُصدّر COCO JSON، فيمكنك إما تحويله إلى تسميات YOLO .txt أو التدريب على JSON مباشرةً باستخدام فئة مخصصة لمجموعة البيانات.
إعداد إرشادات الوسم#
بعد اختيار نوع الوسم والتنسيق، تتمثل الخطوة التالية في وضع قواعد واضحة وموضوعية لوضع التسميات. وتعمل هذه القواعد كخارطة طريق للاتساق والدقة طوال عملية الوسم. وتشمل الجوانب الرئيسية لهذه القواعد ما يلي:
- الوضوح والتفصيل: احرص على وضوح تعليماتك. استخدم أمثلة ورسومًا توضيحية لبيان المطلوب.
- الاتساق: حافظ على تجانس تسمياتك. ضع معايير موحدة لوسم أنواع البيانات المختلفة، بحيث تتبع جميع التسميات القواعد نفسها.
- الحد من التحيز: التزم بالحياد. درّب نفسك على الموضوعية وقلّل التحيزات الشخصية لضمان عدالة التسميات.
- الكفاءة: اعمل بذكاء لا بجهد أكبر. استخدم الأدوات وسير العمل التي تؤتمت المهام المتكررة، مما يجعل عملية الوسم أسرع وأكثر كفاءة.
تساعد مراجعة قواعد وضع التسميات وتحديثها بانتظام في الحفاظ على دقة تسمياتك واتساقها ومواءمتها مع أهداف مشروعك.
أدوات الوسم#
تتيح لك أداة الوسم الجيدة وسم كل نوع تحتاجه مهمتك، وتفرض إرشادات متسقة، وتصدّر التسميات بتنسيق جاهز للتدريب. توفر Ultralytics Platform محرر وسم مدمجًا يغطي الاكتشاف، وتجزئة المثيلات، والتجزئة الدلالية، والتصنيف، والوضعية، وOBB، مع وسم ذكي مدعوم بـ SAM يحوّل نقرة واحدة إلى قناع لمهام الاكتشاف، وتجزئة المثيلات، والتجزئة الدلالية، وOBB. وبما أن التسميات تُحفظ بالتخطيط الذي تتوقعه كل مهمة — صفوف YOLO .txt للمهام المكانية ومجلدات الفئات للتصنيف — تنتقل مجموعة بياناتك المَوسومة مباشرةً إلى التدريب من دون خطوة تحويل.
جودة الوسم: الدقة، والإحكام، والقيم الشاذة#
قبل تنفيذ الوسم على نطاق واسع، من المفيد فهم الدقة والإحكام والقيم الشاذة وضبط الجودة، حتى لا تضع تسميات لبياناتك بطريقة تؤدي إلى نتائج عكسية.
فهم الدقة والإحكام#
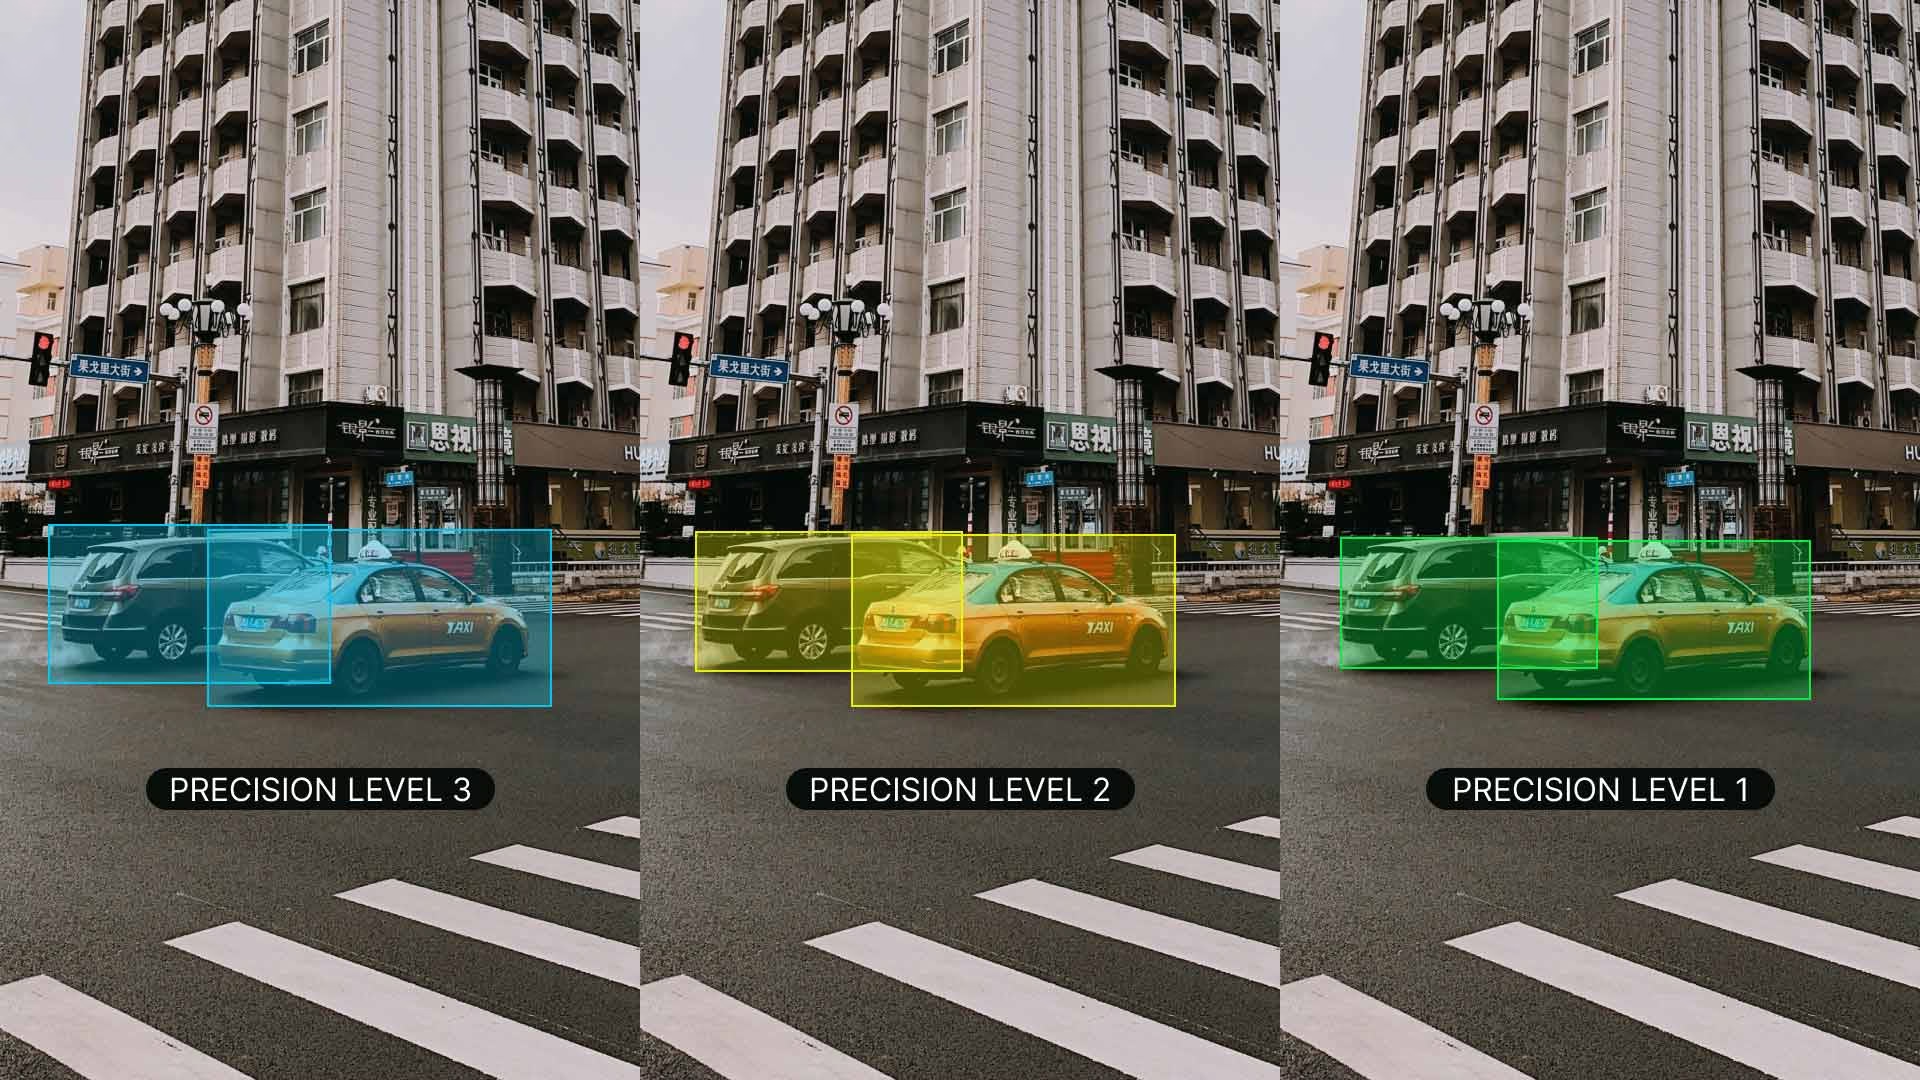
من المهم فهم الفرق بين الدقة والإحكام وعلاقته بالوسم. تشير الدقة إلى مدى قرب البيانات المَوسومة من القيم الحقيقية. وهي تساعدنا في قياس مدى عكس التسميات للسيناريوهات الواقعية. ويشير الإحكام إلى اتساق التسميات، إذ يتحقق من منح العنصر أو السمة نفسها التسمية نفسها طوال مجموعة البيانات. وتؤدي الدقة والإحكام المرتفعان إلى نماذج أفضل تدريبًا، من خلال تقليل الضوضاء وتحسين قدرة النموذج على التعميم انطلاقًا من بيانات التدريب.
تحديد القيم الشاذة#
القيم الشاذة هي نقاط بيانات تنحرف بدرجة كبيرة عن الملاحظات الأخرى في مجموعة البيانات. وفيما يتعلق بالتسميات، قد تكون القيمة الشاذة صورة موسومة بطريقة غير صحيحة أو تسمية لا تنسجم مع بقية مجموعة البيانات. وتثير القيم الشاذة القلق لأنها قد تشوه عملية تعلم النموذج، مما يؤدي إلى تنبؤات غير دقيقة وضعف في التعميم.
يمكنك استخدام أساليب متنوعة لاكتشاف القيم الشاذة وتصحيحها:
- التقنيات الإحصائية: لاكتشاف القيم الشاذة في السمات العددية مثل قيم البكسلات أو إحداثيات المربع المحيط أو أحجام العناصر، يمكنك استخدام أساليب مثل المخططات الصندوقية أو المدرجات التكرارية أو درجات z.
- التقنيات المرئية: لاكتشاف الحالات الشاذة في السمات الفئوية مثل فئات العناصر أو الألوان أو الأشكال، استخدم أساليب مرئية مثل رسم الصور أو التسميات أو خرائط الحرارة.
- الأساليب الخوارزمية: استخدم أدوات مثل التجميع، مثل تجميع K-means وDBSCAN، وخوارزميات اكتشاف الحالات الشاذة لتحديد القيم الشاذة استنادًا إلى أنماط توزيع البيانات.
ضبط جودة البيانات المَوسومة#
مثلما هو الحال في المشاريع التقنية الأخرى، يُعد ضبط الجودة أمرًا ضروريًا للبيانات المَوسومة. ومن الممارسات الجيدة فحص التسميات بانتظام للتأكد من دقتها واتساقها. ويمكن إجراء ذلك بعدة طرق مختلفة:
- مراجعة عينات من البيانات المَوسومة
- استخدام أدوات مؤتمتة لاكتشاف الأخطاء الشائعة
- تكليف شخص آخر بإعادة التحقق من التسميات
إذا كنت تعمل مع عدة أشخاص، فإن الاتساق بين واضعي التسميات المختلفين مهم. ويعني الاتفاق الجيد بين واضعي التسميات أن الإرشادات واضحة وأن الجميع يتبعها بالطريقة نفسها. وهذا يُبقي الجميع على فهم مشترك ويحافظ على اتساق التسميات.
أثناء المراجعة، إذا وجدت أخطاء، فصححها وحدّث الإرشادات لتجنب الأخطاء المستقبلية. وقدّم ملاحظات إلى واضعي التسميات ووفّر تدريبًا منتظمًا للمساعدة في تقليل الأخطاء. ويساعد وجود عملية قوية للتعامل مع الأخطاء في الحفاظ على دقة مجموعة بياناتك وموثوقيتها.
استراتيجيات وسم البيانات بكفاءة#
لجعل عملية وسم البيانات أكثر سلاسة وفعالية، فكّر في تطبيق الاستراتيجيات التالية:
- إرشادات وسم واضحة: قدّم تعليمات تفصيلية مع أمثلة لضمان تفسير جميع واضعي التسميات للمهام بصورة متسقة. فعلى سبيل المثال، عند وسم الطيور، حدّد ما إذا كان ينبغي تضمين الطائر كاملًا أم أجزاءً محددة منه فقط.
- فحوصات جودة منتظمة: حدّد معايير مرجعية واستخدم مقاييس محددة لمراجعة العمل، مع الحفاظ على معايير عالية من خلال الملاحظات المستمرة.
- استخدام أدوات ما قبل الوسم: توفر العديد من منصات الوسم الحديثة ميزات ما قبل الوسم بمساعدة الذكاء الاصطناعي، ويمكنها تسريع العملية بدرجة كبيرة من خلال إنشاء تسميات أولية تلقائيًا يستطيع البشر تحسينها لاحقًا.
- تطبيق التعلم النشط: يعطي هذا النهج الأولوية لوسم العينات الأكثر إفادة أولًا، مما قد يقلل العدد الإجمالي للتسميات المطلوبة مع الحفاظ على أداء النموذج.
- المعالجة الدفعية: جمّع الصور المتشابهة معًا للوسم للحفاظ على الاتساق وتحسين الكفاءة.
يمكن أن تساعد هذه الاستراتيجيات في الحفاظ على تسميات عالية الجودة مع تقليل الوقت والموارد اللازمة لعملية الوسم.
الخلاصة#
يُعد جمع بيانات متنوعة وغير متحيزة ووسمها باستمرار باستخدام الأدوات المناسبة أساس نموذج موثوق للرؤية الحاسوبية. بعد جمع مجموعة بياناتك ووسمها، تابع إلى دليل خطوات مشروع الرؤية الحاسوبية للانتقال إلى التدريب والتقييم. وإذا ظهرت أسئلة أثناء ذلك، فاطرحها على المجتمع في مستودع Ultralytics على GitHub أو خادم Ultralytics على Discord.
الأسئلة الشائعة#
لتقليل التحيز، اجمع البيانات من مصادر متنوعة، واحرص على تمثيل متوازن لجميع المجموعات ذات الصلة، مثل الأعمار والأجناس والأعراق المختلفة، وراجع مجموعة بياناتك وحدّثها بانتظام لاكتشاف التحيزات الناشئة، وطبّق تقنيات الحد من التحيز مثل الإفراط في أخذ العينات من الفئات ناقصة التمثيل، وزيادة البيانات، والخوارزميات المراعية للإنصاف. ويساعد تجنب التحيز بهذه الطريقة نموذج الرؤية الحاسوبية على الأداء الجيد في سيناريوهات العالم الحقيقي المتنوعة، كما يحسن قدرته على التعميم.
ضع إرشادات واضحة وموضوعية لوضع التسميات، تتضمن تعليمات وأمثلة ورسومًا توضيحية تفصيلية، ثم طبّقها بانتظام على جميع أنواع البيانات بحيث تتبع كل تسمية القواعد نفسها. درّب واضعي التسميات على الالتزام بالحياد لتقليل التحيز الشخصي، وراجع الإرشادات وحدّثها بانتظام، واستخدم فحوصات الاتساق المؤتمتة وملاحظات واضعي التسميات المتبادلة للحفاظ على دقة عالية ومواءمة النتائج مع أهداف مشروعك.
يكفي بضع مئات من العناصر المَوسومة لكل فئة لبدء التجربة باستخدام التعلم بالنقل، لكن للحصول على أداء موثوق في العالم الحقيقي، توصي Ultralytics باستخدام ما لا يقل عن 1,500 صورة و10,000 مثيل مَوسوم لكل فئة. اجمع بين مجموعة بيانات كبيرة بما يكفي وجدول تدريب مناسب — إذ يُعد نحو 300 حقبة نقطة بداية شائعة، مع تقليل العدد إذا أفرط النموذج في التكيّف مبكرًا — وحافظ على صرامة تسمياتك ومواءمتها مع أهداف مشروعك المحددة. واستكشف استراتيجيات التدريب التفصيلية في دليل تدريب YOLO26.
نعم. تتضمن Ultralytics Platform محرر وسم مدمجًا يدعم المربعات المحيطة والمضلعات والنقاط الرئيسية والمربعات الموجَّهة وتسميات التصنيف في مساحة عمل واحدة. ويسرّع الوسم الذكي المدعوم بـ SAM عملية وسم مهام الاكتشاف وتجزئة المثيلات والتجزئة الدلالية وOBB من خلال إنشاء أقنعة بنقرة واحدة، بينما تُوسم الوضعية والتصنيف يدويًا. وتُخزَّن التسميات بالتخطيط الذي تتوقعه كل مهمة — صفوف YOLO
.txtللمهام المكانية ومجلدات الفئات للتصنيف — وتكون جاهزةً لـالتدريب.طابق نوع الوسم مع المهمة التي تنوي تدريب النموذج عليها. فالمربعات المحيطة هي الأسرع في الرسم، وهي كل ما يحتاجه اكتشاف العناصر. أما المضلعات والأقنعة فتتطلب وقتًا أطول بوضوح لكل عنصر، لكنها ضرورية لـتجزئة المثيلات عندما يكون الشكل الدقيق للعنصر مهمًا. وتناسب النقاط الرئيسية تقدير الوضعية واكتشاف المعالم، بينما تناسب المربعات الموجَّهة مهام OBB مثل الصور الجوية، حيث سيحيط المستطيل المحاذي للمحاور بقدر كبير من الخلفية. ويضمن اختيار الوسم لأدق مهمة تحتاج إليها فعلًا تناسب جهد الوسم مع النتيجة.