RT-DETR من Baidu: كاشف كائنات آني قائم على Vision Transformer
نظرة عامة#
محوّل الكشف في الوقت الفعلي (RT-DETR)، الذي طوّرته Baidu، هو كاشف للكائنات يعمل من البداية إلى النهاية ويوفّر أداءً آنيًا مع الحفاظ على دقة عالية. يستند RT-DETR إلى DETR، وهو إطار عمل للكشف خالٍ من NMS وقائم على المحوّل، ويضيف RT-DETR عمودًا فقريًا التفافيًا ومشفّرًا هجينًا فعّالًا للوصول إلى سرعة آنية. يعالج RT-DETR السمات متعددة المقاييس بكفاءة عبر فصل التفاعل داخل المقياس عن الدمج بين المقاييس. يتمتع النموذج بقدرة عالية على التكيّف، إذ يتيح ضبط سرعة الاستدلال بمرونة باستخدام طبقات مختلفة من مفكك الترميز دون إعادة التدريب. يحقق RT-DETR أفضل أداء على الواجهات الخلفية المسرّعة مثل CUDA مع TensorRT.
شاهد: كيفية استخدام RT-DETR من Baidu لكشف الكائنات | الاستدلال وقياس الأداء باستخدام Ultralytics
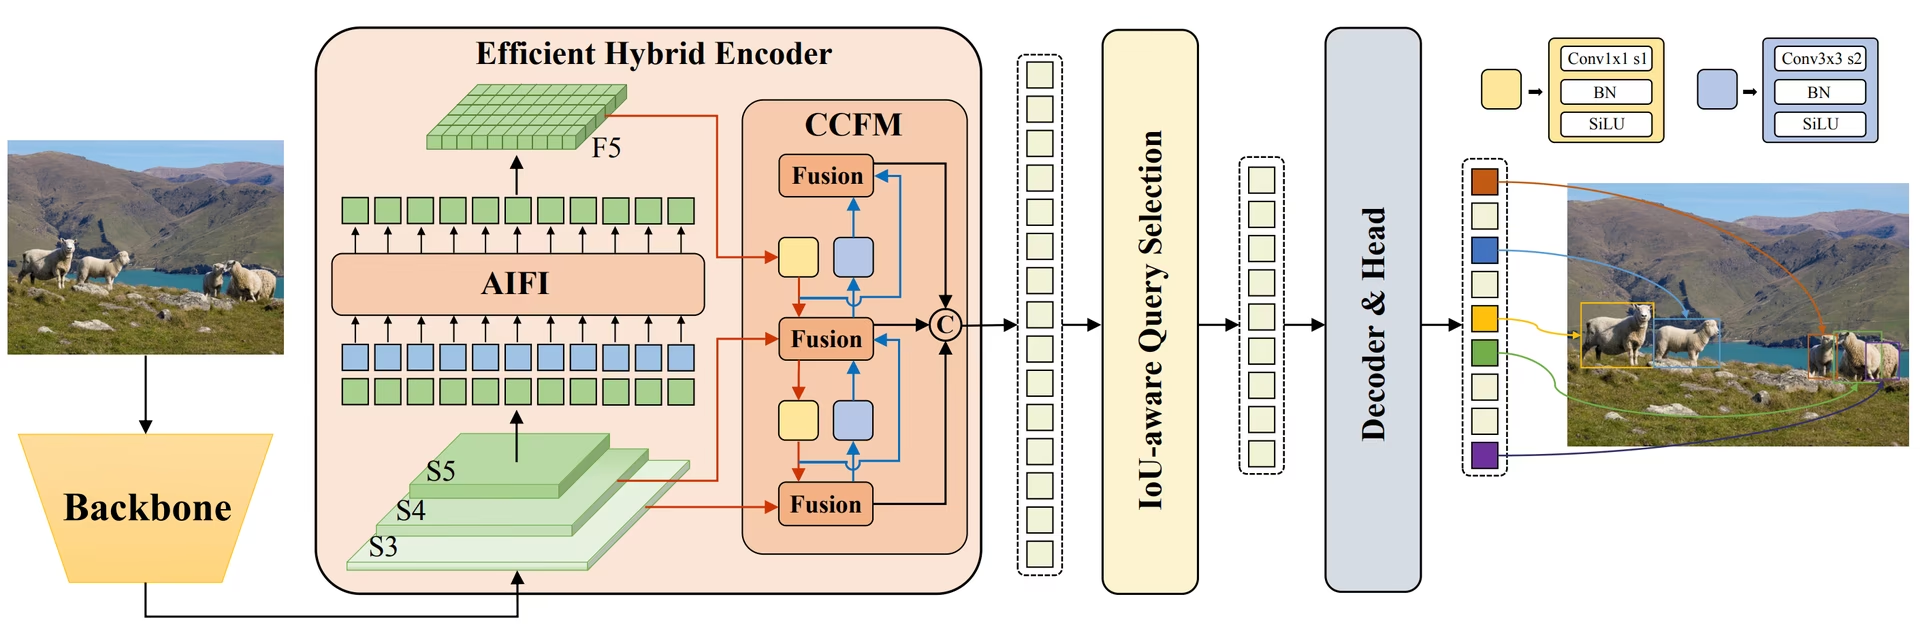 نظرة عامة على RT-DETR من Baidu. يوضّح مخطط بنية نموذج RT-DETR المراحل الثلاث الأخيرة من العمود الفقري {S3, S4, S5} بوصفها مدخلات للمشفّر. يحوّل المشفّر الهجين الفعّال الميزات متعددة المقاييس إلى سلسلة من ميزات الصور من خلال التفاعل بين الميزات على المقياس نفسه (AIFI) ووحدة دمج الميزات عبر المقاييس (CCFM). ويُستخدم اختيار الاستعلامات المراعي لـ IoU لاختيار عدد ثابت من ميزات الصور لتكون استعلامات الأجسام الأولية لمفكّك الترميز. وأخيرًا، يعمل مفكّك الترميز المزود برؤوس تنبؤ مساعدة على تحسين استعلامات الأجسام تكراريًا لإنشاء الصناديق ودرجات الثقة (المصدر).
الميزات الرئيسية#
- مشفّر هجين فعّال: يستخدم RT-DETR من Baidu مشفّرًا هجينًا فعّالًا يعالج الميزات متعددة المقاييس عبر فصل التفاعل داخل المقياس عن الدمج بين المقاييس. وتقلل هذه البنية القائمة على المحوّلات تكاليف الحوسبة، وتتيح كشف الكائنات في الوقت الفعلي.
- اختيار الاستعلامات المراعي لـ IoU: يحسّن RT-DETR من Baidu تهيئة استعلامات الكائنات باستخدام اختيار استعلامات يراعي IoU. وهذا يتيح للنموذج التركيز على الكائنات الأكثر صلة في المشهد، ما يعزز دقة الكشف.
- سرعة استدلال قابلة للتكيّف: يدعم RT-DETR من Baidu الضبط المرن لسرعة الاستدلال باستخدام طبقات مفكّك ترميز مختلفة من دون الحاجة إلى إعادة التدريب. وتسهّل هذه القدرة على التكيّف تطبيق النموذج عمليًا في سيناريوهات مختلفة للكشف الآني عن الأجسام.
- إطار عمل خالٍ من NMS: استنادًا إلى DETR، يلغي RT-DETR الحاجة إلى المعالجة اللاحقة عبر كبت غير الأعظميات، ما يبسّط مسار الكشف وقد يحسّن الكفاءة.
- الكشف الخالي من المراسي: يبسّط RT-DETR، بوصفه كاشفًا خاليًا من المراسي، عملية الكشف وقد يحسّن التعميم على مجموعات البيانات المختلفة.
النماذج المدربة مسبقًا#
توفر واجهة Python البرمجية من Ultralytics نماذج RT-DETR من PaddlePaddle مدرّبة مسبقًا وبمقاييس مختلفة:
- RT-DETR-L: 53.0% AP على مجموعة التحقق val2017 من COCO، و114 إطارًا في الثانية على GPU من نوع T4
- RT-DETR-X: 54.8% AP على COCO val2017، و74 إطارًا في الثانية على وحدة GPU من طراز T4
أصدرت Baidu نموذج RTDETRv2 في يوليو 2024، وأدخلت فيه مزيدًا من التحسينات على البنية الأصلية.
أمثلة الاستخدام#
تعرض الأمثلة أدناه شيفرة بسيطة لـتدريب RT-DETR والاستدلال به. ويمكن أيضًا تدريب النماذج على وحدات GPU سحابية عبر منصة Ultralytics.
from ultralytics import RTDETR
# تحميل نموذج RT-DETR-l مدرّب مسبقًا على COCO
model = RTDETR("rtdetr-l.pt")
# عرض معلومات النموذج (اختياري)
model.info()
# تدريب النموذج على مجموعة بيانات المثال COCO8 لمدة 100 حقبة
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)
# إجراء الاستدلال باستخدام نموذج RT-DETR-l على الصورة 'bus.jpg'
results = model("path/to/bus.jpg")اضبط deterministic=False عند تدريب RT-DETR على CUDA باستخدام PyTorch 2.0 أو إصدار أحدث. تستخدم آلية الانتباه القابلة للتشوه F.grid_sample، التي لا توفر تمريرًا عكسيًا حتميًا على CUDA، لذا لا يستطيع deterministic=True جعل التشغيل قابلًا لإعادة الإنتاج، وقد يقلل من معدل إنتاجية التدريب. يظل seed يتحكم في تهيئة الأوزان وترتيب البيانات وأخذ عينات التعزيز.
تدعم الأوزان المدرّبة مسبقًا لـ RT-DETR إعدادين أثناء الاستدلال لتقليل زمن الاستجابة من دون إعادة التدريب:
eval_idx: أوقف فك الترميز مبكرًا. بالنسبة إلى مفكّك الترميز الافتراضي ذي الطبقات الست، استخدم فهرسًا يبدأ من الصفر (0–5). يستخدمeval_idx=5جميع الطبقات، بينما يستخدمeval_idx=3أربع طبقات. على وحدة GPU من طراز T4 مع TensorRT v10.11، يتحسن RT-DETR-L من 8.0 مللي ثانية / 52.7 mAP إلى 7.4 مللي ثانية / 52.5 mAP باستخدام أربع طبقات.num_queries: قلّل عدد استعلامات الأجسام (القيمة الافتراضية: 300). يمكن أن يؤدي خفض العدد إلى 100 إلى تحقيق 7.4 مللي ثانية / 51.7 mAP على COCO ضمن الإعداد نفسه. يكون انخفاض mAP أصغر عادةً في مجموعات البيانات التي تضم أجسامًا أقل في كل صورة، لكن احرص على أن تتجاوز القيمة الحد الأقصى المتوقع لعدد الأجسام في الصورة.
يمكن أن يؤدي كلا الإعدادين إلى خفض mAP؛ لذا تحقّق من هذه المقايضة على مجموعة بياناتك قبل النشر.
from ultralytics import RTDETR
rtdetr = RTDETR("rtdetr-l.pt")
head = rtdetr.model.model[-1]
# اختر أحد الإعدادين أو كليهما بعد التحقق من مقايضة السرعة والدقة.
head.decoder.eval_idx = 3 # استخدم 4 من أصل 6 طبقات لمفكّك الترميز.
head.num_queries = 100 # استخدم عددًا أقل من استعلامات الأجسام.
results = rtdetr("path/to/image.jpg")
# يستخدم التصدير إعدادات مفكّك الترميز والاستعلامات نفسها، بما في ذلك عمليات التصدير إلى TensorRT.
rtdetr.export(format="engine", device=0, quantize=16)المهام والأوضاع المدعومة#
يعرض هذا الجدول أنواع النماذج والأوزان المحددة المدرّبة مسبقًا والمهام التي يدعمها كل نموذج والأوضاع المدعومة (التدريب والتحقق والتنبؤ والتصدير)، والمشار إليها برموز ✅.
| نوع النموذج | الأوزان المدرّبة مسبقاً | المهام المدعومة | التدريب | التحقق | الاستدلال | التصدير |
|---|---|---|---|---|---|---|
| RT-DETR كبير | rtdetr-l.pt | كشف الكائنات | ✅ | ✅ | ✅ | ✅ |
| RT-DETR كبير جدًا | rtdetr-x.pt | كشف الكائنات | ✅ | ✅ | ✅ | ✅ |
يُوزّع rtdetr-resnet50.yaml وrtdetr-resnet101.yaml كبنيتين بصيغة YAML فقط. تصدر Ultralytics الأوزان المدرّبة مسبقًا لـ rtdetr-l وrtdetr-x فقط. أنشئ متغيرات ResNet من ملفات YAML (مثل RTDETR("rtdetr-resnet50.yaml"))، ثم درّبها أو حسّن تدريبها حسب الحاجة.
حالات الاستخدام المثالية#
يناسب RT-DETR على نحو خاص التطبيقات التي تتطلب دقة عالية وأداءً آنيًا معًا:
- القيادة الذاتية: لتحقيق إدراك موثوق للبيئة في أنظمة القيادة الذاتية، حيث تُعد السرعة والدقة عاملين حاسمين.
- الروبوتات المتقدمة: تمكين الروبوتات من أداء مهام معقدة تتطلب التعرف الدقيق على الكائنات والتفاعل معها في بيئات ديناميكية.
- التصوير الطبي: للتطبيقات في الرعاية الصحية، حيث قد تكون دقة كشف الكائنات ضرورية للتشخيص.
- أنظمة المراقبة: للتطبيقات الأمنية التي تتطلب مراقبة آنية بدقة كشف عالية. تعرّف على أنظمة الإنذار الأمني.
- تحليل صور الأقمار الصناعية: للتحليل التفصيلي للصور عالية الدقة، حيث يكون فهم السياق العالمي مهمًا. اقرأ عن الرؤية الحاسوبية في صور الأقمار الصناعية.
الاستشهادات والشكر والتقدير#
إذا استخدمت RT-DETR من Baidu في أبحاثك أو أعمال التطوير، فيُرجى الاستشهاد بـالورقة البحثية الأصلية:
@misc{lv2023detrs,
      title={DETRs Beat YOLOs on Real-time Object Detection},
      author={Wenyu Lv and Shangliang Xu and Yian Zhao and Guanzhong Wang and Jinman Wei and Cheng Cui and Yuning Du and Qingqing Dang and Yi Liu},
      year={2023},
      eprint={2304.08069},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
يمكنك الاستشهاد بـورقة 2024 الخاصة بـ RTDETRv2:
@misc{lv2024rtdetrv2,
      title={RT-DETRv2: Improved Baseline with Bag-of-Freebies for Real-Time Detection Transformer},
      author={Wenyu Lv and Yian Zhao and Qinyao Chang and Kui Huang and Guanzhong Wang and Yi Liu},
      year={2024},
      eprint={2407.17140},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
نود الإشادة بـ Baidu وفريق PaddlePaddle لإنشاء هذا المورد القيّم وصيانته لخدمة مجتمع الرؤية الحاسوبية. ونقدّر كثيرًا تطويرهم RT-DETR، كاشف الكائنات الآني القائم على المحوّلات.
الأسئلة الشائعة#
يُعد RT-DETR (محوّل الكشف في الزمن الفعلي) من Baidu كاشفًا للكائنات قائمًا على بنية Transformer ويعمل في الزمن الفعلي. ويعالج الميزات متعددة المقاييس بكفاءة من خلال فصل التفاعل داخل المقياس عن الدمج بين المقاييس عبر المشفّر الهجين الفعال. وباستخدام اختيار الاستعلامات الواعي بـ IoU، يركز النموذج على الكائنات الأكثر صلة، ما يعزز دقة الاكتشاف. وتتيح إمكانية ضبط سرعة الاستدلال، من خلال تعديل طبقات مفكّك الترميز دون إعادة التدريب، استخدام RT-DETR في سيناريوهات متنوعة لاكتشاف الكائنات في الزمن الفعلي.
استخدم واجهة Python البرمجية من Ultralytics لتحميل نماذج RT-DETR المدرّبة مسبقًا على PaddlePaddle. على سبيل المثال، لتحميل نموذج RT-DETR-l المدرّب مسبقًا على COCO، وضبطه الدقيق، ثم تنفيذ الاستدلال:
مثالfrom ultralytics import RTDETR # تحميل نموذج RT-DETR-l مدرّب مسبقًا على COCO model = RTDETR("rtdetr-l.pt") # عرض معلومات النموذج (اختياري) model.info() # تدريب النموذج على مجموعة بيانات المثال COCO8 لمدة 100 حقبة results = model.train(data="coco8.yaml", epochs=100, imgsz=640) # إجراء الاستدلال باستخدام نموذج RT-DETR-l على الصورة 'bus.jpg' results = model("path/to/bus.jpg")يجمع RT-DETR من Baidu بين مشفّر هجين فعّال واختيار استعلامات يراعي IoU، ما يقلل تكلفة الحوسبة مع الحفاظ على دقة عالية. وتضيف قدرته على ضبط سرعة الاستدلال باستخدام طبقات مفكك ترميز مختلفة دون إعادة التدريب مرونةً مفيدةً للتطبيقات الآنية على الواجهات الخلفية المسرّعة، مثل CUDA مع TensorRT. كما تلتقط بنية المحوّلات سياقًا عامًا أوسع مما تلتقطه الكواشف التقليدية القائمة على الشبكات العصبية الالتفافية.
يتيح RT-DETR من Baidu ضبط سرعة الاستدلال بمرونة باستخدام طبقات مفكك ترميز مختلفة دون الحاجة إلى إعادة التدريب. وهذا يسمح بالموازنة بين السرعة والدقة في مهام كشف الكائنات الآنية: استخدم عددًا أقل من طبقات مفكك الترميز لمعالجة أسرع بدقة أقل قليلًا، أو استخدم جميع الطبقات للحصول على أدق عمليات الكشف. وتكتسب هذه الميزة أهمية خاصة عند نشر النماذج على أجهزة تختلف قدراتها الحاسوبية.
لا. في RT-DETR، يحدّ
max_detمن عدد التنبؤات التي تُعاد بعد الاستدلال، لكنه لا يزيد عدد استعلامات الأجسام التي ينتجها مفكّك الترميز. تستخدم نقاط التحقق المدرّبة مسبقًا لـ RT-DETR من Ultralytics عدد 300 من استعلامات الأجسام، لذا لا يمكنها إعادة أكثر من 300 كشف لكل صورة، حتى إذا ضبطتmax_detعلى قيمة أكبر.استخدم
max_detلتقليل عدد الكشوف المُعادة، مثلmax_det=100، عندما تحتاج إلى عدد أقل من التنبؤات عالية الثقة فقط. إذا كان من الممكن أن تحتوي مجموعة بياناتك على أكثر من 300 جسم في الصورة، فدرّب نموذج RT-DETR مخصصًا بعدد أكبر من استعلامات مفكّك الترميز (nq) في YAML الخاص بالنموذج؛ فتغيير هذه القيمة في نقطة تحقق مدرّبة مسبقًا بعد التدريب ليس مكافئًا لذلك، ويتطلب إعادة التدريب لتعلّم الاستعلامات الإضافية.


التعليقات148
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.
PhucPhamSy
Hi all, Could you please let me know how to use all parameters in the appendix of the original paper, "https://arxiv.org/pdf/2304.08069"? Thanks!
1 Glenn JocherUltralytics
Hey there! 👋
We're really glad you're interested in diving deep into the parameters detailed in the original paper. Specifically, for utilizing parameters as mentioned in the RT-DETR paper ("DETRs Beat YOLOs on Real-time Object Detection"), I recommend focusing on the key components such as the Efficient Hybrid Encoder, IoU-aware Query Selection, and adaptability in Inference Speed adjustments that make RT-DETR efficient.
Details on these components can be extrapolated to parameter usage within your model through our Python API. For instance, when initializing the RT-DETR model or adjusting inference speed, you would consider the different scales of pre-trained models available:
from ultralytics import RTDETR

# For a larger model with potentially higher accuracy but lower FPS (Frames Per Second)
model = RTDETR('rtdetr-l.pt')

# For an extra-large model prioritizing accuracy over speed
model_x = RTDETR('rtdetr-x.pt')
Adjustments for inference speed and applying IoU-aware query selection can directly correlate with your focus during the
.train()or.predict()processes, especially understanding what goes behind each configuration setting in these functions.Unfortunately, we don't provide a direct mapping for every parameter mentioned in the appendix to code-level argument settings as the implementation abstracts many complexities for user convenience and to maintain the API's simplicity. However, understanding the RT-DETR's key features and translating that understanding into practical API usage is a great way to leverage the power of RT-DETR. 😊
For more tailored guidance, always feel free to ask or refer to our official documentation for specific examples and deeper insights.
Happy coding! 🚀
 Murat Raimbekov
hey @wba-zzu, thanks for raising this.
quick rundown of where things stand:
resnet50 / resnet101 - the architectures are already shipped as yaml configs:
you can build and train them straight from yaml:
from ultralytics import RTDETR

model = RTDETR("rtdetr-resnet50.yaml")
model.train(data="coco.yaml", epochs=100, imgsz=640)
however, ultralytics does not publish pretrained weights for these. the only official rt-detr checkpoints in the ultralytics/assets releases are
rtdetr-l.ptandrtdetr-x.pt, both of which use the hgnetv2 backbone (not resnet). this is also flagged in the model docs under "architecture-only variants".resnet18 - not shipped. there is no
rtdetr-resnet18.yamlin the repo, so a resnet18 variant would need its own yaml and corresponding modules added.loading external pretrained weights: ultralytics builds the model from yaml, so the state_dict keys follow a pattern like
model.<index>.layer.<...>.conv.weight. weights from another implementation will not load directly - they would need a key-mapping / conversion step to match this layout.hope this helps!
 Boao Wang
想要将原版RT-DETR中的ResNet50和ResNet18以及ResNet101完全移植到Ultralytics,并且获得其预训练模型
995742853
您好,我想请问一下,在哪里有基于rtdetr-resnet50的预训练pt权重,我知道看到rtdetr-l以及x的预训练权重
- Glenn JocherUltralytics
目前 RT-DETR 文档 里公开提供的 Ultralytics 预训练权重只有
rtdetr-l.pt和rtdetr-x.pt;如果你找的是 ResNet50 版本,建议查看 Baidu 官方的 RT-DETR PyTorch 权重列表,其中提供的是rtdetr_r50vd_*.pth,不是 Ultralytics 直接发布的rtdetr-resnet50.pt,也欢迎直接在这里继续提问,方便 Ultralytics 团队跟进。 (docs.ultralytics.com) 谢谢您的回复
maitianstudio-arch
How to use RT-DETRv2?
- Glenn JocherUltralytics
Ultralytics currently exposes the original RT-DETR pretrained weights (
rtdetr-l.pt,rtdetr-x.pt) via theRTDETRAPI; RT-DETRv2 pretrained weights/configs aren’t packaged inultralyticsyet, so if you share what RT-DETRv2 checkpoint you have (Paddle vs PyTorch) and how you’re trying to run it, we can point you to the right conversion/workflow—meanwhile you can use RT-DETR as shown in the RT-DETR docs.from ultralytics import RTDETR model = RTDETR("rtdetr-l.pt") results = model("path/to/image.jpg")
fxc0627
你好,请问RE-DETR模型适用于小目标工业缺陷检测吗?对于小目标检测有什么天然的优势?
wang18382140151-hub
你好,最近deim,dfine等对于rtdetr有了很好的改进,尤其是deim能很好的加速训练的速度,能将其整合进rtdetr中吗?
yuwencool
您好RT-DETR模型的推理支持model.track模式吗?
liyansong123456
RT-DETRv3 has been released. Does Ultralytics have plans to integrate it?
AK993
你好,rt-detr支持在转为rknn格式,并在rk3588上部署吗