التكامل مع ClearML#

نبذة عن ClearML#
منصة ClearML هي منصة مفتوحة المصدر لإدارة عمليات تعلّم الآلة، صُممت لتبسيط سير العمل وتوفير وقت المهندسين.
- 🔨 تتبّع كل تشغيل تدريبي لـ YOLOv5 في مدير التجارب.
- 🔧 أدر إصدارات بيانات التدريب المخصصة لديك ووصّل إليها باستخدام أداة إدارة إصدارات البيانات المدمجة في ClearML.
- 🔦 درّب عمليات تشغيل YOLOv5 وراقبها عن بُعد باستخدام وكيل ClearML.
- 🔬 اعثر على أفضل mAP باستخدام تحسين المعلمات الفائقة في ClearML.
- 🔭 حوّل نموذج YOLOv5 إلى API باستخدام ClearML Serving وبضعة أوامر.
استخدم من هذه الأدوات ما تحتاج إليه، سواءً أكان قليلًا أم كثيرًا؛ ابدأ بمدير التجارب وحده، أو اربط الأدوات كلها معًا لتكوين مسار عمل متكامل.
🦾 إعداد النظام#
يحتاج ClearML إلى الاتصال بخادم لتتبّع تجاربك وبياناتك. لديك خياران:
- سجّل في خدمة ClearML المستضافة المجانية، أو
- انشر خادم ClearML خاصًا بك؛ فهو مفتوح المصدر، لذا يظل خيارًا مناسبًا حتى للبيانات الحساسة.
بعد ذلك، ثبّت حزمة Python clearml وصِل SDK بالخادم:
pip install clearmlأنشئ بيانات الاعتماد من الإعدادات ← مساحة العمل ← إنشاء بيانات اعتماد جديدة (في أعلى يسار واجهة ClearML)، ثم شغّل:
clearml-initاتبع التعليمات. هذا كل شيء — اكتمل الإعداد.
🚀 تدريب YOLOv5 باستخدام ClearML#
لتمكين تتبّع التجارب، ثبّت حزمة pip الخاصة بـ ClearML إن لم تكن قد ثبّتها بعد:
pip install clearmlسيؤدي ذلك إلى تفعيل التكامل مع البرنامج النصي لتدريب YOLOv5. ومن الآن فصاعدًا، سيسجّل مدير التجارب في ClearML كل تشغيل تدريبي ويخزّنه.
لتخصيص اسمي المشروع والمهمة، مرّر --project و--name إلى train.py. القيم الافتراضية هي YOLOv5 وTraining. يستخدم ClearML / فاصلًا بين المشاريع الفرعية، لذا تجنّب / في أسماء المشاريع المخصصة.
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheأو استخدم أسماء مخصصة:
python train.py --project my_project --name my_training --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheيسجّل كل تشغيل ما يلي:
- الشيفرة المصدرية والتغييرات غير الملتزم بها
- الحزم المثبّتة
- المعلمات الفائقة
- نقاط تحقق النموذج (استخدم
--save-period nللحفظ كلnحقبة) - مخرجات وحدة التحكم
- القيم العددية (mAP_0.5 وmAP_0.5:0.95 والدقة والاستدعاء والخسائر ومعدلات التعلّم)
- تفاصيل الجهاز ومدة التشغيل وتاريخ الإنشاء
- المخططات المُنشأة، مثل مخطط ارتباط التسميات ومصفوفة الالتباس
- صور تتضمن مربعات إحاطة لكل حقبة
- تصوّرات الفسيفساء لكل حقبة
- صور التحقق لكل حقبة
تظهر جميع البيانات في واجهة ClearML، لتتمكن من مراقبة التدريب في مكان واحد. أضف أعمدة مخصصة (مثل mAP_0.5) للترتيب حسب النموذج الأفضل أداءً، أو حدّد تجارب متعددة لمقارنتها جنبًا إلى جنب.
تابع القراءة للاطلاع على تحسين المعلمات الفائقة والتنفيذ عن بُعد.
🔗 إدارة إصدارات مجموعات البيانات#
تسهّل إدارة إصدارات البيانات بصورة منفصلة عن الشيفرة جلب أحدث إصدار، وتضمن إمكانية إعادة الإنتاج بالكامل. يقبل هذا المستودع معرّف إصدار مجموعة البيانات، ويجلب البيانات تلقائيًا إذا لم تكن موجودة، ويسجّل المعرّف بوصفه معلمة للمهمة، حتى تعرف دائمًا البيانات المستخدمة في كل تجربة.
إعداد مجموعة البيانات#
يدعم مستودع YOLOv5 العديد من مجموعات البيانات عبر ملفات إعداد YAML. تُنزّل مجموعات البيانات افتراضيًا إلى المجلد ../datasets نسبةً إلى جذر المستودع. بعد تنزيل coco128، يصبح هيكل المجلدات كما يلي:
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ LICENSE
        |_ README.txt
يمكن استخدام أي مجموعة بيانات، شريطة الحفاظ على هذا الهيكل.
بعد ذلك، انسخ ملف YAML الخاص بمجموعة البيانات إلى مجلدها الجذر؛ إذ يقرأ ClearML هذا الملف لاستخدام مجموعة البيانات على النحو الصحيح. يمكنك كتابة ملف YAML خاص بك باتباع نموذج التخطيط، مع التأكد من تعريف path وtrain وtest وval وnc وnames.
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ coco128.yaml  # <---- HERE
        |_ LICENSE
        |_ README.txt
رفع مجموعة البيانات#
لتسجيل مجموعة البيانات على أنها مجموعة بيانات ذات إصدارات في ClearML، انتقل إلى مجلدها الجذر وشغّل:
cd ../datasets/coco128
clearml-data sync --project YOLOv5 --name coco128 --folder .
clearml-data sync اختصار للتسلسل التالي، الذي يمكنك تشغيله صراحةً أيضًا:
# Add --parent <parent_dataset_id> to base this version on a previous one.
# Duplicate files are not re-uploaded.
clearml-data create --name coco128 --project YOLOv5
clearml-data add --files .
clearml-data close
التدريب على مجموعة بيانات في ClearML#
بعد تسجيل مجموعة البيانات، وجّه التدريب إليها باستخدام المعرّف:
python train.py --img 640 --batch 16 --epochs 3 --data clearml://YOUR_DATASET_ID --weights yolov5s.pt --cache👀 تحسين المعلمات الفائقة#
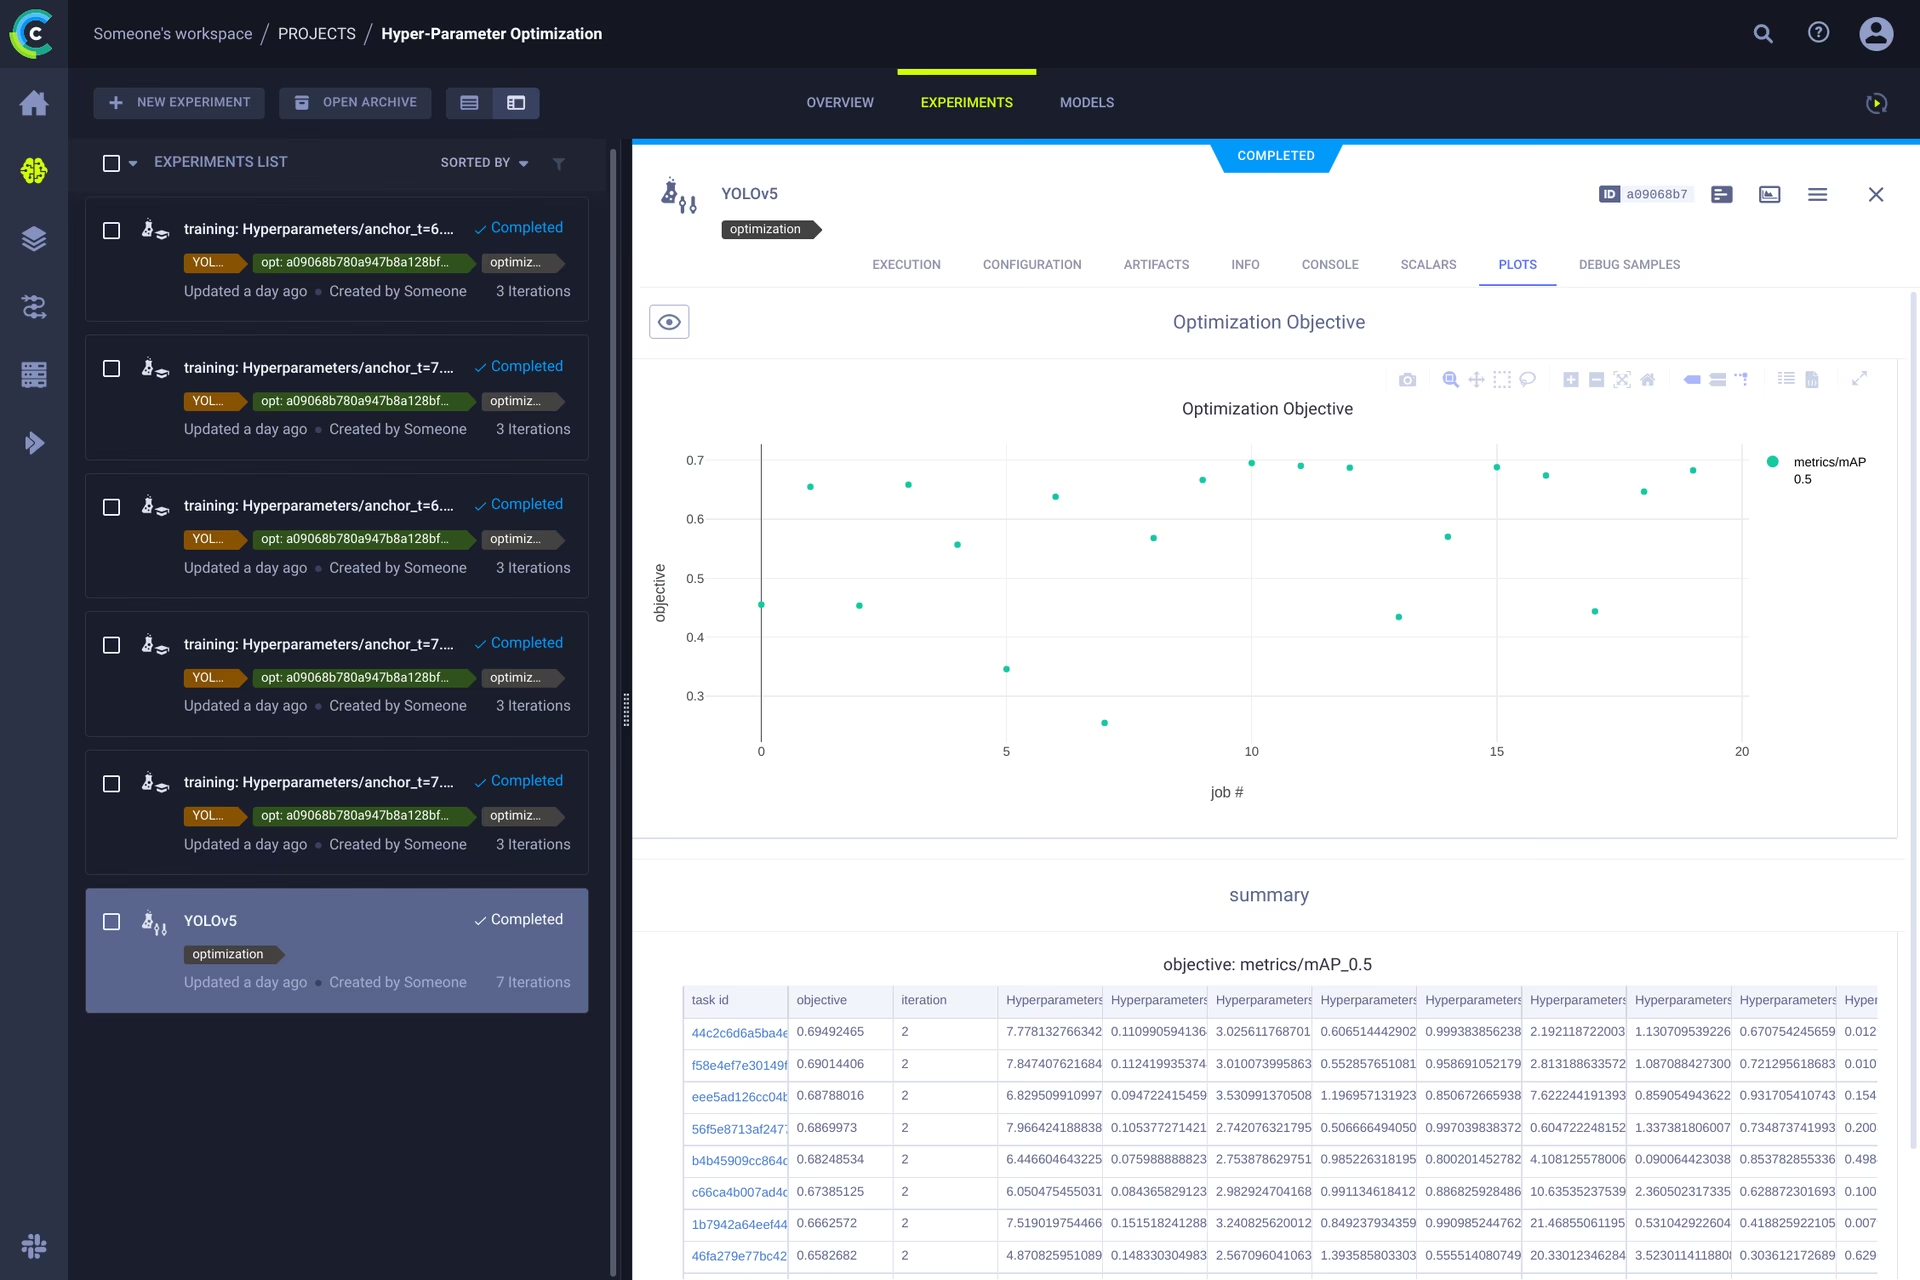
بعد إدارة إصدارات التجارب والبيانات، يمكنك البناء عليها. وبما أن كل تجربة متتبعة تسجّل البيئة كاملةً — الشيفرة والحزم المثبّتة والإعدادات — فإن عمليات التشغيل قابلة لإعادة الإنتاج بالكامل. يتيح لك ClearML استنساخ تجربة وتغيير معلماتها وإعادة تشغيلها تلقائيًا، وهذا هو أساس تحسين المعلمات الفائقة (HPO).
لتشغيل HPO محليًا، استخدم البرنامج النصي المضمّن. تأكد أولًا من وجود مهمة تدريب في مدير التجارب؛ فالبرنامج النصي يستنسخها ويغيّر معلماتها الفائقة.
أدخل معرّف المهمة النموذجية في utils/loggers/clearml/hpo.py، ثم شغّل:
# Install Optuna or change the optimizer to RandomSearch.
pip install optuna
python utils/loggers/clearml/hpo.py
لتشغيل التجارب على وكلاء بعيدين بدلًا من ذلك، استبدل optimizer.start_locally() بـ optimizer.start() واضبط execution_queue في استدعاء HyperParameterOptimizer على قائمة الانتظار التي يستمع إليها وكلاؤك.
🤯 التنفيذ عن بُعد (متقدم)#
يُعد تشغيل HPO محليًا خيارًا ملائمًا، لكنك ستحتاج غالبًا إلى تشغيل التجارب على أجهزة أقوى — مثل جهاز GPU محلي أو مثيل سحابي. وهنا يأتي دور وكيل ClearML:
تتضمن كل تجربة متتبعة كل ما يلزم لإعادة إنتاجها على جهاز آخر (الحزم المثبّتة والتغييرات غير الملتزم بها والإعدادات). يستمع وكيل ClearML إلى قائمة انتظار، ويلتقط المهام الواردة، ويعيد إنشاء البيئة، وينفّذ المهمة، ثم يرسل القيم العددية والمخططات إلى مدير التجارب.
حوّل أي جهاز — كآلة افتراضية سحابية أو جهاز محلي مزود بوحدة GPU أو حاسوب محمول — إلى وكيل ClearML باستخدام:
clearml-agent daemon --queue QUEUES_TO_LISTEN_TO [--docker]الاستنساخ والتحرير وإضافة المهام إلى قائمة الانتظار#
بعد تشغيل وكيل، يمكنك إسناد العمل إليه مباشرةً من الواجهة:
- 🪄 انقر بزر الماوس الأيمن على تجربة واستنسخها.
- 🎯 حرّر معلماتها الفائقة.
- ⏳ انقر بزر الماوس الأيمن على المهمة المستنسخة وأضفها إلى قائمة انتظار مستهدفة.
تنفيذ مهمة عن بُعد#
يمكنك أيضًا تحديد برنامج نصي قيد التشغيل لتنفيذه عن بُعد برمجيًا، وذلك بإضافة task.execute_remotely() بعد إنشاء مسجّل ClearML. أضف السطر المميز إلى train.py:
# ...
# Loggers
data_dict = None
if RANK in {-1, 0}:
loggers = Loggers(save_dir=save_dir, weights=weights, opt=opt, hyp=hyp, logger=LOGGER)
if loggers.clearml:
loggers.clearml.task.execute_remotely(queue="my_queue") # <------ أضف هذا السطر
# ...
# معالجة رابط عنصر مجموعة بيانات مخصص
data_dict = loggers.remote_dataset
# ...بعد هذا التغيير، ينفّذ تشغيل البرنامج النصي التدريبي التعليمات حتى ذلك السطر، ثم يحزم الشيفرة ويرسلها إلى قائمة الانتظار.
توسيع نطاق العمال تلقائيًا#
يتضمن ClearML أدوات للتوسيع التلقائي تُشغّل أجهزة بعيدة على AWS أو GCP أو Azure عند وجود تجارب معلقة في قائمة انتظار، وتحولها إلى وكلاء ClearML، ثم توقفها عند انتهاء العمل — وبذلك لا تدفع إلا مقابل موارد الحوسبة التي تعمل فعليًا.
شاهد فيديو البدء أدناه:
معرفة المزيد#
لمزيد من المعلومات حول تكامل ClearML مع نماذج Ultralytics، اطّلع على دليل تكامل ClearML، واستكشف كيف يمكنك تحسين سير عمل MLOps باستخدام أدوات أخرى لتتبّع التجارب.
الأسئلة الشائعة#
لا. تعمل الخدمة المستضافة المجانية على app.clear.ml مباشرةً بعد
clearml-init. الاستضافة الذاتية اختيارية، وهي الخيار المعتاد عندما يتعذر إخراج البيانات من شبكتك.يفعّل YOLOv5 التكامل كلما أمكن استيراد الحزمة
clearml، لذا أزل تثبيتها باستخدامpip uninstall clearmlلتعطيل التتبع أثناء التشغيل.سجّل مجموعة البيانات باستخدام
clearml-data sync، ثم مرّر معرّفها كوسيطة للبيانات:python train.py --data clearml://YOUR_DATASET_ID --weights yolov5s.pt. يُسجَّل المعرّف في المهمة، بحيث تعرف كل تجربة البيانات التي استخدمتها بدقة.نعم. ابدأ
clearml-agent daemonعلى كل جهاز، ثم أدرج التجارب المستنسخة في قائمة الانتظار من واجهة المستخدم، أو عدّلutils/loggers/clearml/hpo.pyلاستدعاءoptimizer.start()مع ضبطexecution_queueكي يدفع المحسّن التجارب إلى قائمة الانتظار.