تجميع نماذج YOLOv5#
📚 يشرح هذا الدليل كيفية استخدام تجميع النماذج في Ultralytics YOLOv5 🚀 أثناء الاختبار والاستدلال لتحسين mAP والاستدعاء.
من التعلّم التجميعي:
نمذجة التجميع عملية تُنشأ فيها نماذج متعددة ومتنوعة للتنبؤ بنتيجة، إما باستخدام خوارزميات نمذجة مختلفة أو مجموعات مختلفة من بيانات التدريب. ثم يجمع النموذج التجميعي تنبؤات كل نموذج أساسي لينتج تنبؤًا نهائيًا واحدًا للبيانات غير المرئية. ويتمثل الدافع لاستخدام النماذج التجميعية في تقليل خطأ التعميم في التنبؤ. ما دامت النماذج الأساسية متنوعة ومستقلة، ينخفض خطأ التنبؤ عند استخدام نهج التجميع. ويسعى هذا النهج إلى الاستفادة من حكمة الجماعة في التنبؤ. وعلى الرغم من أن النموذج التجميعي يضم عدة نماذج أساسية، فإنه يعمل ويؤدي وظيفته كنموذج واحد.
قبل البدء#
استنسخ المستودع وثبّت requirements.txt في بيئة Python>=3.8.0، بما في ذلك PyTorch>=1.8. تُنزّل النماذج ومجموعات البيانات تلقائيًا من إصدار YOLOv5 الأحدث.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
الاختبار بالطريقة المعتادة#
قبل التجميع، حدّد أداءً أساسيًا لنموذج واحد. يختبر هذا الأمر YOLOv5x على COCO val2017 بحجم صورة يبلغ 640 بكسلًا. يُعد yolov5x.pt أكبر النماذج المتاحة وأكثرها دقة. وتشمل الخيارات الأخرى yolov5n.pt وyolov5s.pt وyolov5m.pt وyolov5l.pt، أو نقطة التحقق الخاصة بك الناتجة عن تدريب مجموعة بيانات مخصصة، أي runs/train/exp/weights/best.pt. للاطلاع على تفاصيل جميع النماذج المتاحة، انظر جدول نقاط التحقق المدرّبة مسبقًا.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfالمخرجات:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients

val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2846.03it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [02:30<00:00,  1.05it/s]
                 all       5000      36335      0.746      0.626       0.68       0.49
Speed: 0.1ms pre-process, 22.4ms inference, 1.4ms NMS per image at shape (32, 3, 640, 640)  # <--- baseline speed

Evaluating pycocotools mAP... saving runs/val/exp/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.504  # <--- baseline mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.688
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.546
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.351
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.551
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.644
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.382
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.628
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.681  # <--- baseline mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.524
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.735
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.826
اختبار التجميع#
يمكن تجميع عدة نماذج مدرّبة مسبقًا معًا أثناء الاختبار والاستدلال، وذلك ببساطة بإلحاق نماذج إضافية بالوسيطة --weights في أي أمر قائم من val.py أو detect.py. يختبر هذا المثال تجميع نموذجين معًا:
- YOLOv5x
- YOLOv5l6
python val.py --weights yolov5x.pt yolov5l6.pt --data coco.yaml --img 640 --halfيمكنك إدراج أي عدد تريده من نقاط التحقق، بما فيها الأوزان المخصصة مثل runs/train/exp5/weights/best.pt. سيشغّل YOLOv5 كل نموذج تلقائيًا، ويضمّ تنبؤاتها لكل صورة قبل تنفيذ NMS.
المخرجات:
val: data=./data/coco.yaml, weights=['yolov5x.pt', 'yolov5l6.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.6, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients  # Model 1
Fusing layers...
Model Summary: 501 layers, 77218620 parameters, 0 gradients  # Model 2
Ensemble created with ['yolov5x.pt', 'yolov5l6.pt']  # Ensemble notice

val: Scanning '../datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:00<00:00, 49695545.02it/s]
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [03:58<00:00,  1.52s/it]
                 all       5000      36335      0.747      0.637      0.692      0.502
Speed: 0.1ms pre-process, 39.5ms inference, 2.0ms NMS per image at shape (32, 3, 640, 640)  # <--- ensemble speed

Evaluating pycocotools mAP... saving runs/val/exp3/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.515  # <--- ensemble mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.699
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.557
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.356
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.563
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.668
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.387
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.638
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.689  # <--- ensemble mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.526
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.743
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.844
استدلال التجميع#
ألحِق نماذج إضافية بالوسيطة --weights لتشغيل الاستدلال التجميعي:
python detect.py --weights yolov5x.pt yolov5l6.pt --img 640 --source data/imagesالمخرجات:
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients
Fusing layers...
Model Summary: 501 layers, 77218620 parameters, 0 gradients
Ensemble created with ['yolov5x.pt', 'yolov5l6.pt']

image 1/2 /content/yolov5/data/images/bus.jpg: 640x512 4 persons, 1 bus, 1 tie, Done. (0.063s)
image 2/2 /content/yolov5/data/images/zidane.jpg: 384x640 3 persons, 2 ties, Done. (0.056s)
Results saved to runs/detect/exp2
Done. (0.223s)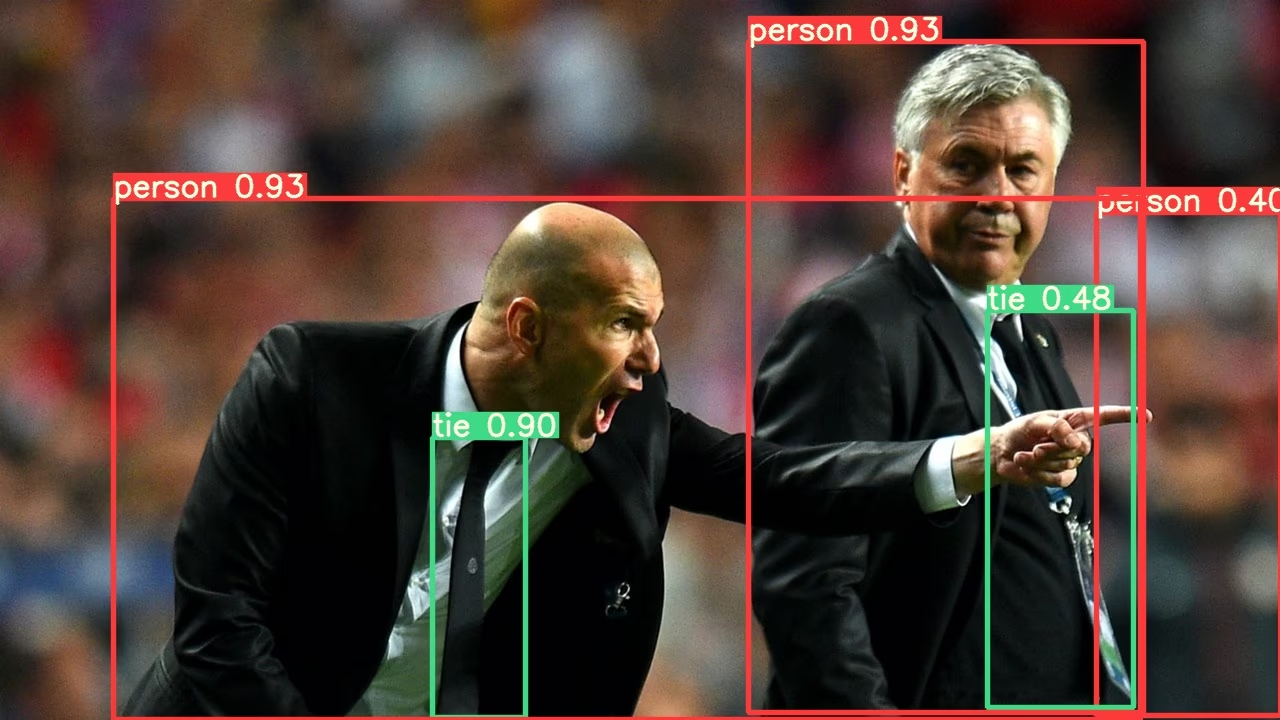
فوائد تجميع النماذج#
يوفر تجميع النماذج باستخدام YOLOv5 عدة مزايا:
- دقة محسّنة: كما توضح الأمثلة أعلاه، يزيد تجميع عدة نماذج mAP من 0.504 إلى 0.515، وmAR من 0.681 إلى 0.689.
- تعميم أفضل: يساعد الجمع بين النماذج المتنوعة على الحد من فرط التكيّف وتحسين الأداء على البيانات المتنوعة.
- متانة معززة: تكون النماذج التجميعية عادةً أكثر متانة في مواجهة الضوضاء والقيم المتطرفة في البيانات.
- نقاط قوة متكاملة: قد تتفوق النماذج المختلفة في اكتشاف أنواع مختلفة من الكائنات أو في ظروف بيئية متباينة.
تتمثل المفاضلة الأساسية في زيادة زمن الاستدلال، كما توضح مقاييس السرعة (22.4ms للنموذج الواحد مقابل 39.5ms للتجميع).
متى يُستخدم تجميع النماذج#
ضع في اعتبارك استخدام تجميع النماذج في الحالات التالية:
- عندما تكون الدقة أهم من سرعة الاستدلال
- في التطبيقات الحساسة التي يجب فيها تقليل السلبيات الكاذبة إلى أدنى حد
- عند معالجة الصور الصعبة ذات الإضاءة المتفاوتة أو الحجب أو اختلاف المقياس
- أثناء المسابقات أو المقارنات المعيارية التي تتطلب أقصى أداء
قد يكون الاستدلال بنموذج واحد أنسب للتطبيقات الفورية ذات متطلبات زمن استجابة صارمة.
البيئات المدعومة#
توفر Ultralytics مجموعة من البيئات الجاهزة للاستخدام، وكل منها مثبت مسبقًا به التبعيات الأساسية مثل CUDA وCUDNN وPython وPyTorch، لتتمكن من بدء مشاريعك.
- دفاتر GPU مجانية:


- Google Cloud: دليل البدء السريع لـ GCP
- Amazon: دليل البدء السريع لـ AWS
- Azure: دليل البدء السريع لـ AzureML
- Docker: دليل البدء السريع لـ Docker

حالة المشروع#

تشير هذه الشارة إلى اجتياز جميع اختبارات التكامل المستمر (CI) الخاصة بـ إجراءات YOLOv5 على GitHub بنجاح. وتتحقق اختبارات CI بدقة من وظائف YOLOv5 وأدائه في جوانب رئيسية متعددة: التدريب والتحقق والاستدلال والتصدير واختبارات الأداء. وهي تضمن التشغيل المتسق والموثوق على macOS وWindows وUbuntu، مع إجراء الاختبارات كل 24 ساعة وعند كل إيداع جديد.
الأسئلة الشائعة#
أي عدد. أدرج كل نقاط التحقق بعد
--weights، مثل--weights yolov5x.pt yolov5l6.pt runs/train/exp/weights/best.pt. يزداد زمن الاستدلال تقريبًا بما يتناسب مع عدد النماذج.نعم. تُضمّ التنبؤات قبل تنفيذ NMS، لذا يجب تدريب كل نموذج على قائمة الفئات نفسها وبالترتيب نفسه. ويمكن أن تختلف أحجام الإدخال والبنى.
نعم. أضف
--augmentإلى الأمر نفسهval.pyأوdetect.pyلتطبيق TTA على كل نموذج في التجميع.تُعالج وحدة PyTorch
Ensembleفيmodels/experimental.pyعملية التجميع، لذا لا ينطبق إلا على نقاط تحقق.pt. صدّر كل نموذج على حدة إذا كنت بحاجة إلى ملفات ONNX أو TensorRT.