التعزيز أثناء الاختبار#
📚 يشرح هذا الدليل كيفية استخدام التعزيز أثناء الاختبار (TTA) خلال الاختبار والاستدلال لتحسين mAP والاستدعاء باستخدام YOLOv5 🚀.
قبل البدء#
استنسخ المستودع وثبّت requirements.txt في بيئة Python>=3.8.0، بما في ذلك PyTorch>=1.8. تُنزّل النماذج ومجموعات البيانات تلقائيًا من إصدار YOLOv5 الأحدث.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
الاختبار بالطريقة المعتادة#
قبل تجربة TTA، نريد تحديد أداء أساسي للمقارنة به. يختبر هذا الأمر YOLOv5x على مجموعة التحقق COCO val2017 بحجم صورة يبلغ 640 بكسل. yolov5x.pt هو أكبر النماذج المتاحة وأكثرها دقة. وتشمل الخيارات الأخرى yolov5n.pt وyolov5s.pt وyolov5m.pt وyolov5l.pt، أو نقطة تحقق خاصة بك من تدريب مجموعة بيانات مخصصة، مثل runs/train/exp/weights/best.pt. للاطلاع على تفاصيل جميع النماذج المتاحة، راجع وثائق YOLOv5.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfالمخرجات:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients

val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2846.03it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [02:30<00:00,  1.05it/s]
                 all       5000      36335      0.746      0.626       0.68       0.49
Speed: 0.1ms pre-process, 22.4ms inference, 1.4ms NMS per image at shape (32, 3, 640, 640)  # <--- baseline speed

Evaluating pycocotools mAP... saving runs/val/exp/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.504  # <--- baseline mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.688
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.546
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.351
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.551
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.644
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.382
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.628
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.681  # <--- baseline mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.524
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.735
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.826
الاختبار باستخدام TTA#
ألحِق --augment بأي أمر val.py موجود لتمكين TTA، وزِد حجم الصورة بنحو 30% لتحسين النتائج. يُرجى ملاحظة أن الاستدلال مع تمكين TTA يستغرق عادةً نحو ضعفين إلى ثلاثة أضعاف مدة الاستدلال العادي، لأن الصور تُقلب أفقيًا وتُعالَج بثلاثة مقاييس مختلفة، ثم تُدمج المخرجات قبل NMS. يعود جزء من انخفاض السرعة ببساطة إلى زيادة حجم الصور (832 بدلًا من 640)، بينما يعود جزء آخر إلى عمليات TTA نفسها؛ لذا تأكد من توفر ذاكرة كافية في GPU قبل زيادة --img.
python val.py --weights yolov5x.pt --data coco.yaml --img 832 --augment --halfالمخرجات:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=832, conf_thres=0.001, iou_thres=0.6, task=val, device=, single_cls=False, augment=True, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
/usr/local/lib/python3.7/dist-packages/torch/nn/functional.py:718: UserWarning: Named tensors and all their associated APIs are an experimental feature and subject to change. Please do not use them for anything important until they are released as stable. (Triggered internally at  /pytorch/c10/core/TensorImpl.h:1156.)
  return torch.max_pool2d(input, kernel_size, stride, padding, dilation, ceil_mode)
Model Summary: 476 layers, 87730285 parameters, 0 gradients
val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2885.61it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [07:29<00:00,  2.86s/it]
                 all       5000      36335      0.718      0.656      0.695      0.503
Speed: 0.2ms pre-process, 80.6ms inference, 2.7ms NMS per image at shape (32, 3, 832, 832)  # <--- TTA speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.516  # <--- TTA mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.701
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.562
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.361
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.564
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.656
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.388
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.640
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.696  # <--- TTA mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.553
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.744
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.833
الاستدلال باستخدام TTA#
يعمل استدلال TTA باستخدام detect.py بالطريقة نفسها تمامًا التي يعمل بها استدلال TTA باستخدام val.py: ما عليك سوى إلحاق --augment بأي أمر detect.py موجود:
python detect.py --weights yolov5s.pt --img 832 --source data/images --augmentالمخرجات:
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Downloading https://github.com/ultralytics/yolov5/releases/download/v5.0/yolov5s.pt to yolov5s.pt...
100% 14.1M/14.1M [00:00<00:00, 81.9MB/s]

Fusing layers...
Model Summary: 224 layers, 7266973 parameters, 0 gradients
image 1/2 /content/yolov5/data/images/bus.jpg: 832x640 4 persons, 1 bus, 1 fire hydrant, Done. (0.029s)
image 2/2 /content/yolov5/data/images/zidane.jpg: 480x832 3 persons, 3 ties, Done. (0.024s)
Results saved to runs/detect/exp
Done. (0.156s)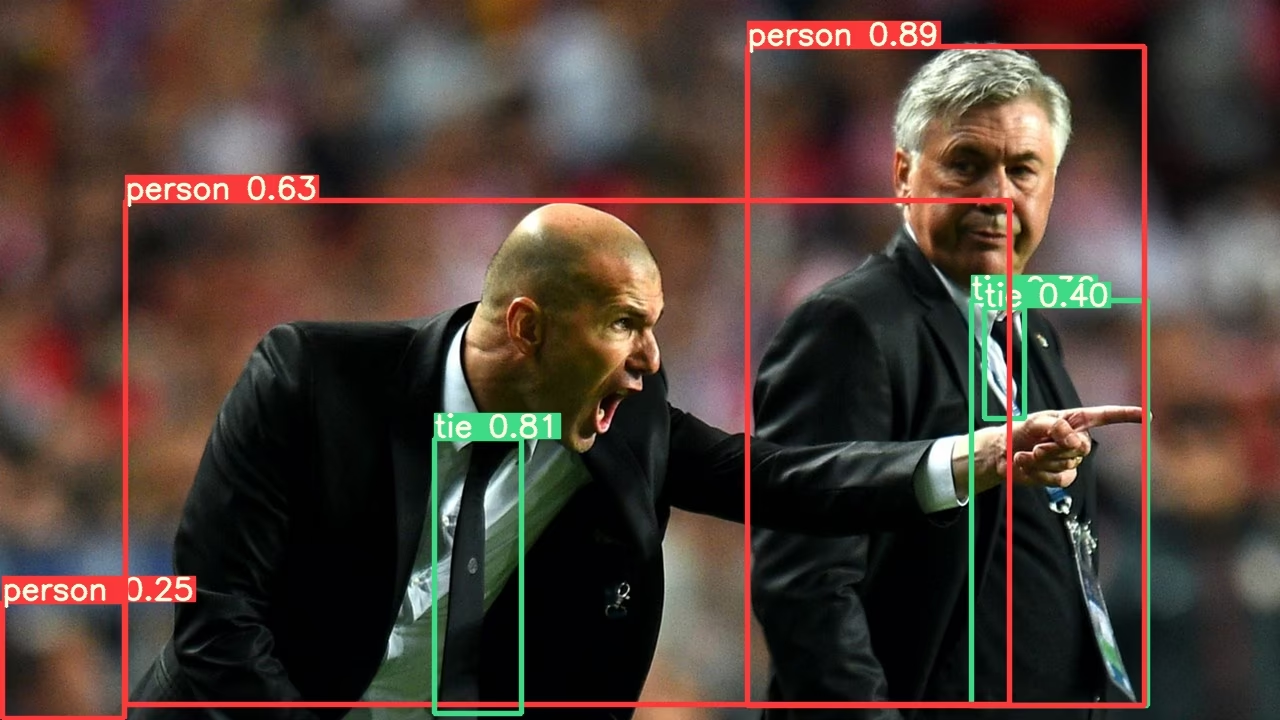
TTA باستخدام PyTorch Hub#
يُدمج TTA تلقائيًا في جميع نماذج YOLOv5 على PyTorch Hub، ويمكن استخدامه بتمرير augment=True أثناء الاستدلال.
import torch
# Model
model = torch.hub.load("ultralytics/yolov5", "yolov5s") # أو yolov5m أو yolov5x أو نموذج مخصص
# Images
img = "https://ultralytics.com/images/zidane.jpg" # أو ملف أو PIL أو OpenCV أو numpy أو عدة عناصر
# Inference
results = model(img, augment=True) # <--- استدلال TTA
# Results
results.print() # or .show(), .save(), .crop(), .pandas()، إلخ.تخصيص#
يمكنك تخصيص عمليات TTA المُطبَّقة في طريقة YOLOv5 forward_augment().
مزايا التعزيز أثناء الاختبار#
يوفّر التعزيز أثناء الاختبار عدة مزايا رئيسية لمهام اكتشاف الكائنات:
- تحسين الدقة: كما توضح النتائج أعلاه، يزيد TTA قيمة mAP من 0.504 إلى 0.516، وقيمة mAR من 0.681 إلى 0.696.
- تحسين اكتشاف الكائنات الصغيرة: يعزز TTA اكتشاف الكائنات الصغيرة بوجه خاص، إذ ترتفع قيمة AP للمساحات الصغيرة من 0.351 إلى 0.361.
- زيادة المتانة: من خلال اختبار تنويعات متعددة لكل صورة، يقلل TTA من تأثير زاوية الرؤية والإضاءة والعوامل البيئية الأخرى.
- سهولة التنفيذ: لا يتطلب سوى إضافة الخيار
--augmentإلى الأوامر الحالية.
تتمثل المفاضلة في زيادة زمن الاستدلال، ما يجعل TTA أنسب للتطبيقات التي تعطي الأولوية للدقة على حساب السرعة.
البيئات المدعومة#
توفر Ultralytics مجموعة من البيئات الجاهزة للاستخدام، وكل منها مثبت مسبقًا به التبعيات الأساسية مثل CUDA وCUDNN وPython وPyTorch، لتتمكن من بدء مشاريعك.
- دفاتر GPU مجانية:


- Google Cloud: دليل البدء السريع لـ GCP
- Amazon: دليل البدء السريع لـ AWS
- Azure: دليل البدء السريع لـ AzureML
- Docker: دليل البدء السريع لـ Docker

حالة المشروع#

تشير هذه الشارة إلى اجتياز جميع اختبارات التكامل المستمر (CI) الخاصة بـ إجراءات YOLOv5 على GitHub بنجاح. وتتحقق اختبارات CI بدقة من وظائف YOLOv5 وأدائه في جوانب رئيسية متعددة: التدريب والتحقق والاستدلال والتصدير واختبارات الأداء. وهي تضمن التشغيل المتسق والموثوق على macOS وWindows وUbuntu، مع إجراء الاختبارات كل 24 ساعة وعند كل إيداع جديد.
الأسئلة الشائعة#
تُعالَج كل صورة بثلاثة مقاييس وبقلب أفقي، ثم تُدمج التنبؤات قبل NMS. وتحسّن المشاهد الإضافية الاستدعاء، ولا سيما للكائنات الصغيرة، على حساب زيادة العمليات الحاسوبية.
توقّع أن يستغرق الاستدلال نحو ضعفين إلى ثلاثة أضعاف المدة المعتادة. ويعود جزء من هذا العبء إلى زيادة حجم
--img، لذا تأكد من توفر ذاكرة كافية في GPU قبل زيادته.إن التشغيل بدقة أعلى بنحو 30%، مثل 832 بدلًا من 640، يمنح عمليات المرور متعددة المقاييس تفاصيل أكثر للعمل عليها، وقد حقق أفضل النتائج في المعايير أعلاه.
لا. تُنفَّذ المرور الأمامي المُعزَّز في PyTorch
DetectionModel، لذا لا يؤثر--augmentإلا في نقاط تحقق.pt. وتتجاهله صيغ ONNX وTensorRT وغيرها من الصيغ المُصدَّرة.