درّب YOLOv5 على بيانات مخصصة#
يشرح هذا الدليل كيفية تدريب مجموعة بيانات مخصصة باستخدام نموذج YOLOv5. يُعد تدريب النماذج المخصصة خطوة أساسية لتكييف حلول الرؤية الحاسوبية مع تطبيقات محددة في العالم الحقيقي، تتجاوز اكتشاف الكائنات العام.
قبل البدء#
أولاً، تأكد من إعداد البيئة اللازمة. استنسخ مستودع YOLOv5 وثبّت التبعيات المطلوبة من requirements.txt. من الضروري توفر بيئة Python>=3.8.0 مع PyTorch>=1.8. تُنزَّل النماذج ومجموعات البيانات تلقائياً من أحدث إصدار من YOLOv5 إذا لم تكن موجودة محلياً.
git clone https://github.com/ultralytics/yolov5 # Clone the repository
cd yolov5
pip install -r requirements.txt # Install dependencies
التدريب على بيانات مخصصة#
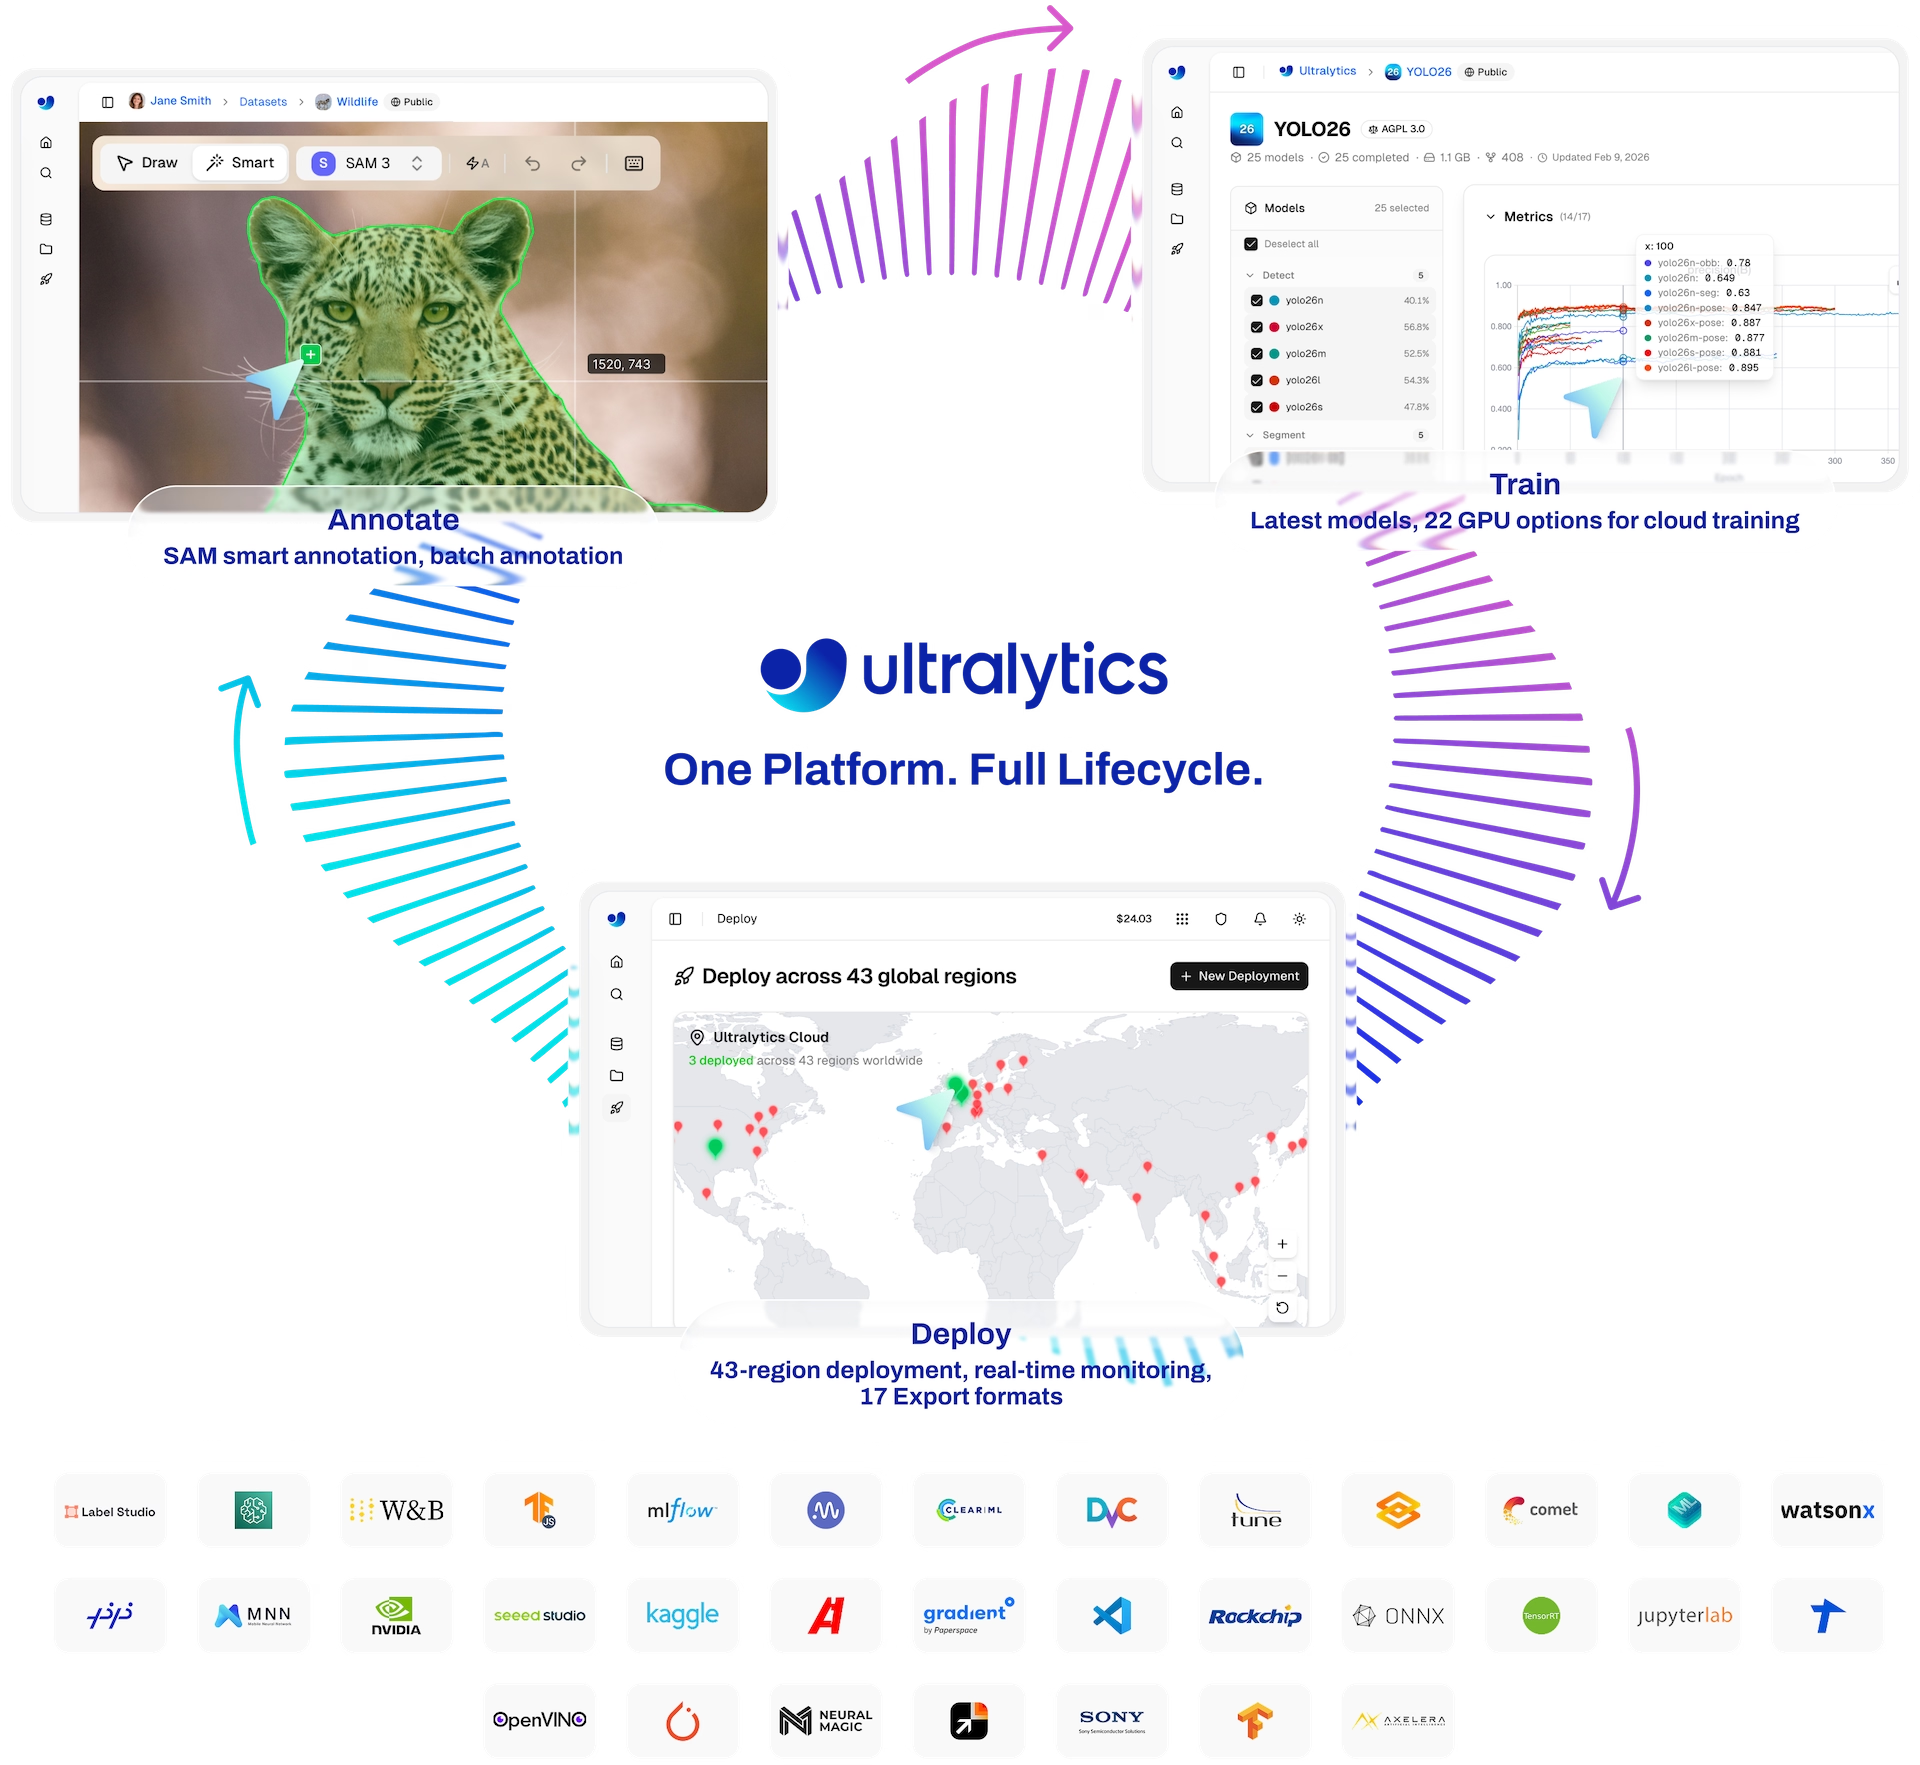
يُعد تطوير نموذج مخصص لـاكتشاف الأجسام عملية تكرارية:
- جمع الصور وتنظيمها: اجمع صوراً ذات صلة بمهمتك المحددة. فالبيانات عالية الجودة والمتنوعة بالغة الأهمية. راجع دليلنا حول جمع البيانات وتعليقها.
- وضع تسميات للأجسام: علّق بدقة على الأجسام محل الاهتمام داخل صورك.
- تدريب نموذج: استخدم البيانات الموسومة لتدريب نموذج YOLOv5 الخاص بك. استفد من التعلّم بالنقل بالبدء بأوزان مدرّبة مسبقاً.
- النشر والتنبؤ: استخدم النموذج المدرّب للاستدلال على بيانات جديدة لم يسبق للنموذج رؤيتها.
- جمع الحالات الحدية: حدّد الحالات التي يكون فيها أداء النموذج ضعيفاً (الحالات الحدية)، وأضف بيانات مشابهة إلى مجموعة بياناتك لتحسين المتانة. كرر الدورة.
توفر منصة Ultralytics حلًا دون كتابة التعليمات البرمجية لدورة عمليات التعلم الآلي (MLOps) بأكملها، بما في ذلك إدارة مجموعات البيانات وتدريب النماذج ونشرها.
توفر Ultralytics خيارين للترخيص لتلبية حالات الاستخدام المتنوعة:
- ترخيص AGPL-3.0: هذا الترخيص مفتوح المصدر المعتمد من OSI مثالي للطلاب والباحثين والمتحمسين للتعاون المفتوح وتبادل المعرفة. ويشترط مشاركة الأعمال المشتقة بموجب الترخيص نفسه. راجع ملف LICENSE للاطلاع على التفاصيل الكاملة.
- ترخيص المؤسسات: يتيح هذا الترخيص دمج برامج Ultralytics ونماذج الذكاء الاصطناعي في منتجات وخدمات الأعمال لأغراض التطوير والإنتاج، بما في ذلك الأدوات الداخلية وسير العمل المؤتمت وعمليات النشر الإنتاجية، مع تجاوز متطلبات المصدر المفتوح في AGPL-3.0. للبدء، يُرجى التواصل معنا عبر ترخيص Ultralytics.
تعرّف على مزيد من التفاصيل حول خيارات الترخيص لدينا في صفحة تراخيص Ultralytics.
من الضروري إعداد مجموعة البيانات قبل بدء التدريب.
1. إنشاء مجموعة بيانات#
تتطلب نماذج YOLOv5 بيانات موسومة لتعلّم الخصائص المرئية لفئات الأجسام. ويُعد تنظيم مجموعة البيانات بشكل صحيح أمراً أساسياً.
1.1 إنشاء dataset.yaml#
يوضح ملف إعداد مجموعة البيانات (مثل coco128.yaml) بنية مجموعة البيانات وأسماء الفئات والمسارات إلى أدلة الصور. تُعد COCO128 مجموعة بيانات صغيرة نموذجية تضم أول 128 صورة من مجموعة بيانات COCO الكبيرة. وهي مفيدة لاختبار مسار التدريب بسرعة وتشخيص المشكلات المحتملة مثل فرط التكيّف.
تتضمن بنية ملف dataset.yaml ما يلي:
path: الدليل الجذر الذي يحتوي على مجموعة البيانات.trainوvalوtest: مسارات نسبية منpathإلى الأدلة التي تحتوي على الصور أو الملفات النصية التي تسرد مسارات الصور لمجموعات التدريب والتحقق والاختبار.names: قاموس يربط فهارس الفئات (بدءاً من 0) بأسماء الفئات المقابلة.
يمكنك تعيين path إلى دليل ذي مسار مطلق (مثل /home/user/datasets/coco128) أو إلى مسار نسبي مثل ../datasets/coco128 عند بدء التدريب من الدليل الجذر لمستودع YOLOv5.
فيما يلي بنية coco128.yaml (عرض على GitHub):
# Dataset root directory relative to the yolov5 directory
path: ../datasets/coco128

# Train/val/test sets: specify directories, *.txt files, or lists
train: images/train2017 # 128 images for training
val: images/train2017 # 128 images for validation
test: # Optional path to test images

# Classes (example using 80 COCO classes)
names:
    0: person
    1: bicycle
    2: car
    # ... (remaining COCO classes)
    77: teddy bear
    78: hair drier
    79: toothbrush
1.2 الاستفادة من النماذج لوضع التسميات آلياً#
يُعد وضع التسميات يدوياً نهجاً شائعاً، لكنه يستغرق وقتاً طويلاً. ويمكن للنماذج التأسيسية أتمتة التعليق أو شبه أتمتته وتسريع إنشاء مجموعات البيانات. ومن أمثلة النماذج التي يمكن أن تساعد في إنشاء التسميات:
- Google Gemini: تتمتع النماذج الكبيرة متعددة الوسائط مثل Gemini بقدرات قوية على فهم الصور. ويمكن توجيهها للتعرّف على الكائنات وتحديد مواقعها داخل الصور، وإنشاء مربعات إحاطة أو أوصاف يمكن تحويلها إلى تسميات بتنسيق YOLO، كما هو موضح في دفتر الملاحظات التعليمي المرتبط. وتقارن لوحة صدارة VLM من Ultralytics مدى دقة Gemini وغيرها من نماذج الرؤية واللغة في إضافة تسميات توضيحية تلقائية إلى مجموعات بيانات اكتشاف الكائنات في العالم الحقيقي.
- SAM2 (نموذج تقسيم كل شيء 2): تستطيع النماذج التأسيسية المركزة على التقسيم، مثل SAM2، تحديد الأجسام وتعيين حدودها بدقة عالية. وعلى الرغم من استخدامها أساساً للتقسيم، يمكن غالباً تحويل الأقنعة الناتجة إلى تعليقات توضيحية بمربعات إحاطة مناسبة لمهام اكتشاف الأجسام.
- YOLO-World: يوفر هذا النموذج إمكانات اكتشاف بمفردات مفتوحة. يمكنك تقديم أوصاف نصية للكائنات التي تهمك، وسيتمكن YOLO-World من تحديد مواقعها في الصور دون تدريب مسبق على تلك الفئات تحديدًا. ويمكن استخدامه نقطة انطلاق لإنشاء تسميات أولية ثم تنقيحها.
يمكن أن توفر هذه النماذج خطوة «إضافة تسميات أولية»، فتقلل الجهد اليدوي المطلوب. توفر ميزة التعليقات التوضيحية الذكية في منصة Ultralytics إضافة تسميات أولية باستخدام SAM وYOLO ونماذج الرؤية واللغة من المتصفح دون كتابة التعليمات البرمجية. لكن من الضروري مراجعة التسميات التي أُنشئت تلقائيًا وتنقيحها لضمان الدقة والاتساق، إذ تؤثر جودتها مباشرةً في أداء نموذج YOLOv5 المدرّب. بعد إنشاء تسمياتك (وتنقيحها عند الحاجة)، تأكد من توافقها مع تنسيق YOLO: ملف *.txt واحد لكل صورة، يمثل كل سطر فيه كائنًا بتنسيق class_index x_center y_center width height (إحداثيات مطبّعة وفئة يبدأ ترقيمها من الصفر). إذا لم تتضمن الصورة أي كائنات محل اهتمام، فلا حاجة إلى ملف *.txt مقابل لها.
مواصفات ملف *.txt بتنسيق YOLO دقيقة:
- صف واحد لكل جسم محدّد بمربع إحاطة.
- يجب أن يحتوي كل صف على:
class_index x_center y_center width height. - يجب تطبيع الإحداثيات لتقع ضمن نطاق يتراوح بين 0 و1. ولتحقيق ذلك، اقسم قيم البكسل لكل من
x_centerوwidthعلى العرض الكلي للصورة، واقسمy_centerوheightعلى الارتفاع الكلي للصورة. - تبدأ فهارس الفئات من الصفر (أي إن الفئة الأولى تُمثَّل بـ
0، والثانية بـ1، وهكذا).
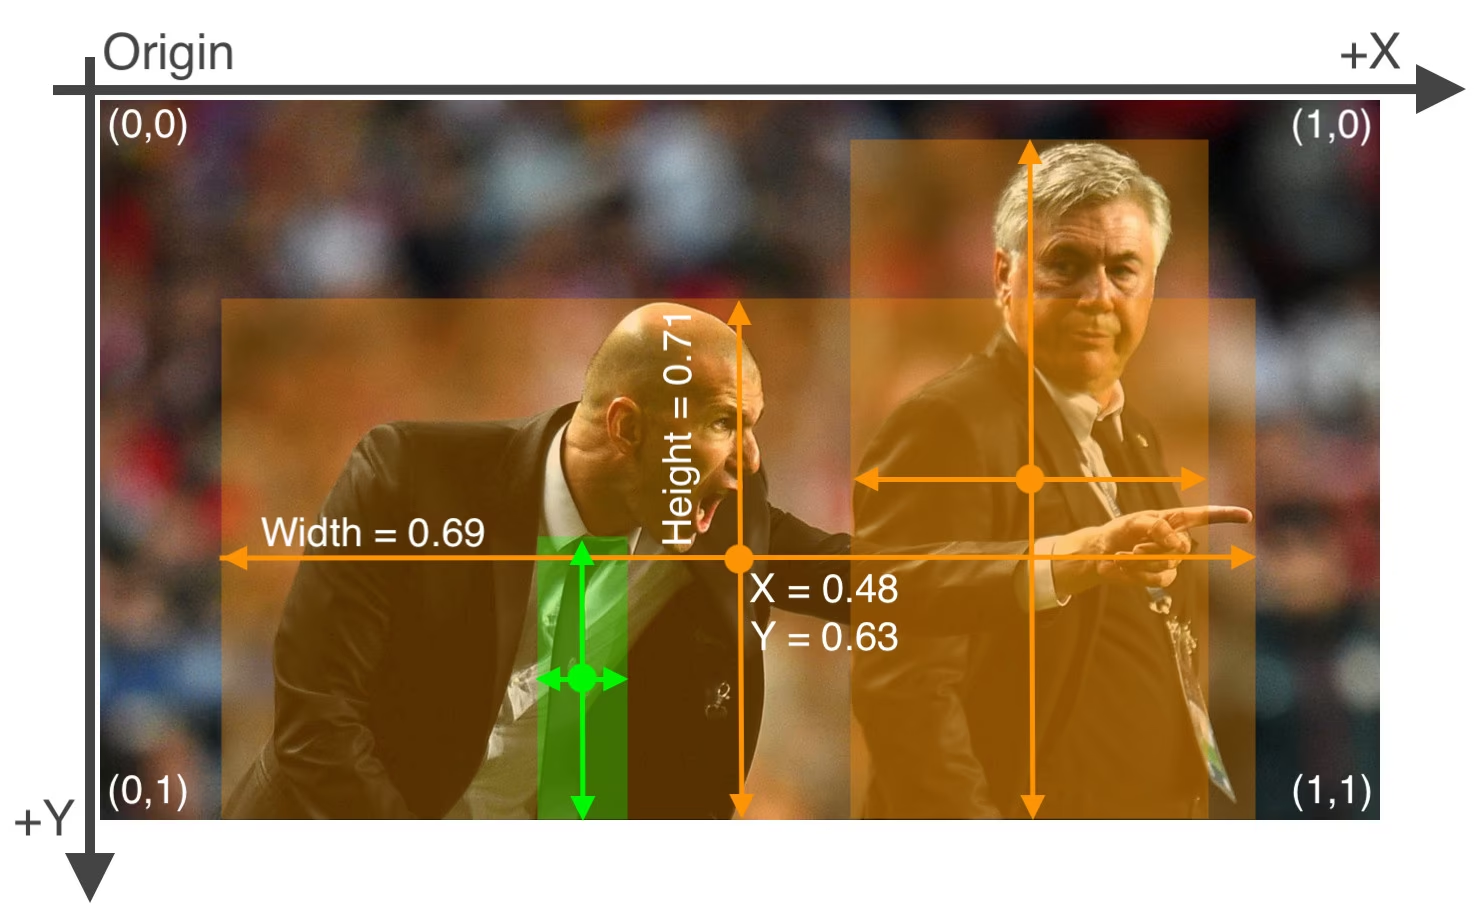
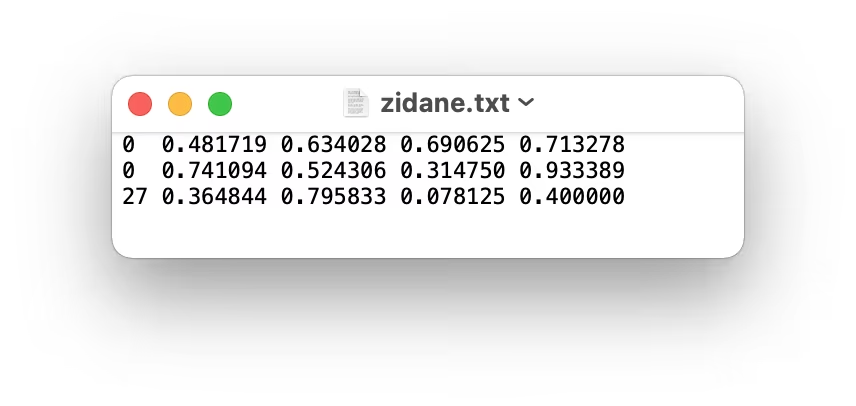
سيبدو ملف التسميات المقابل للصورة أعلاه، والذي يحتوي على كائنين من فئة 'person' (فهرس الفئة 0) وكائن واحد من فئة 'tie' (فهرس الفئة 27)، كما يلي:
1.3 تنظيم الأدلة#
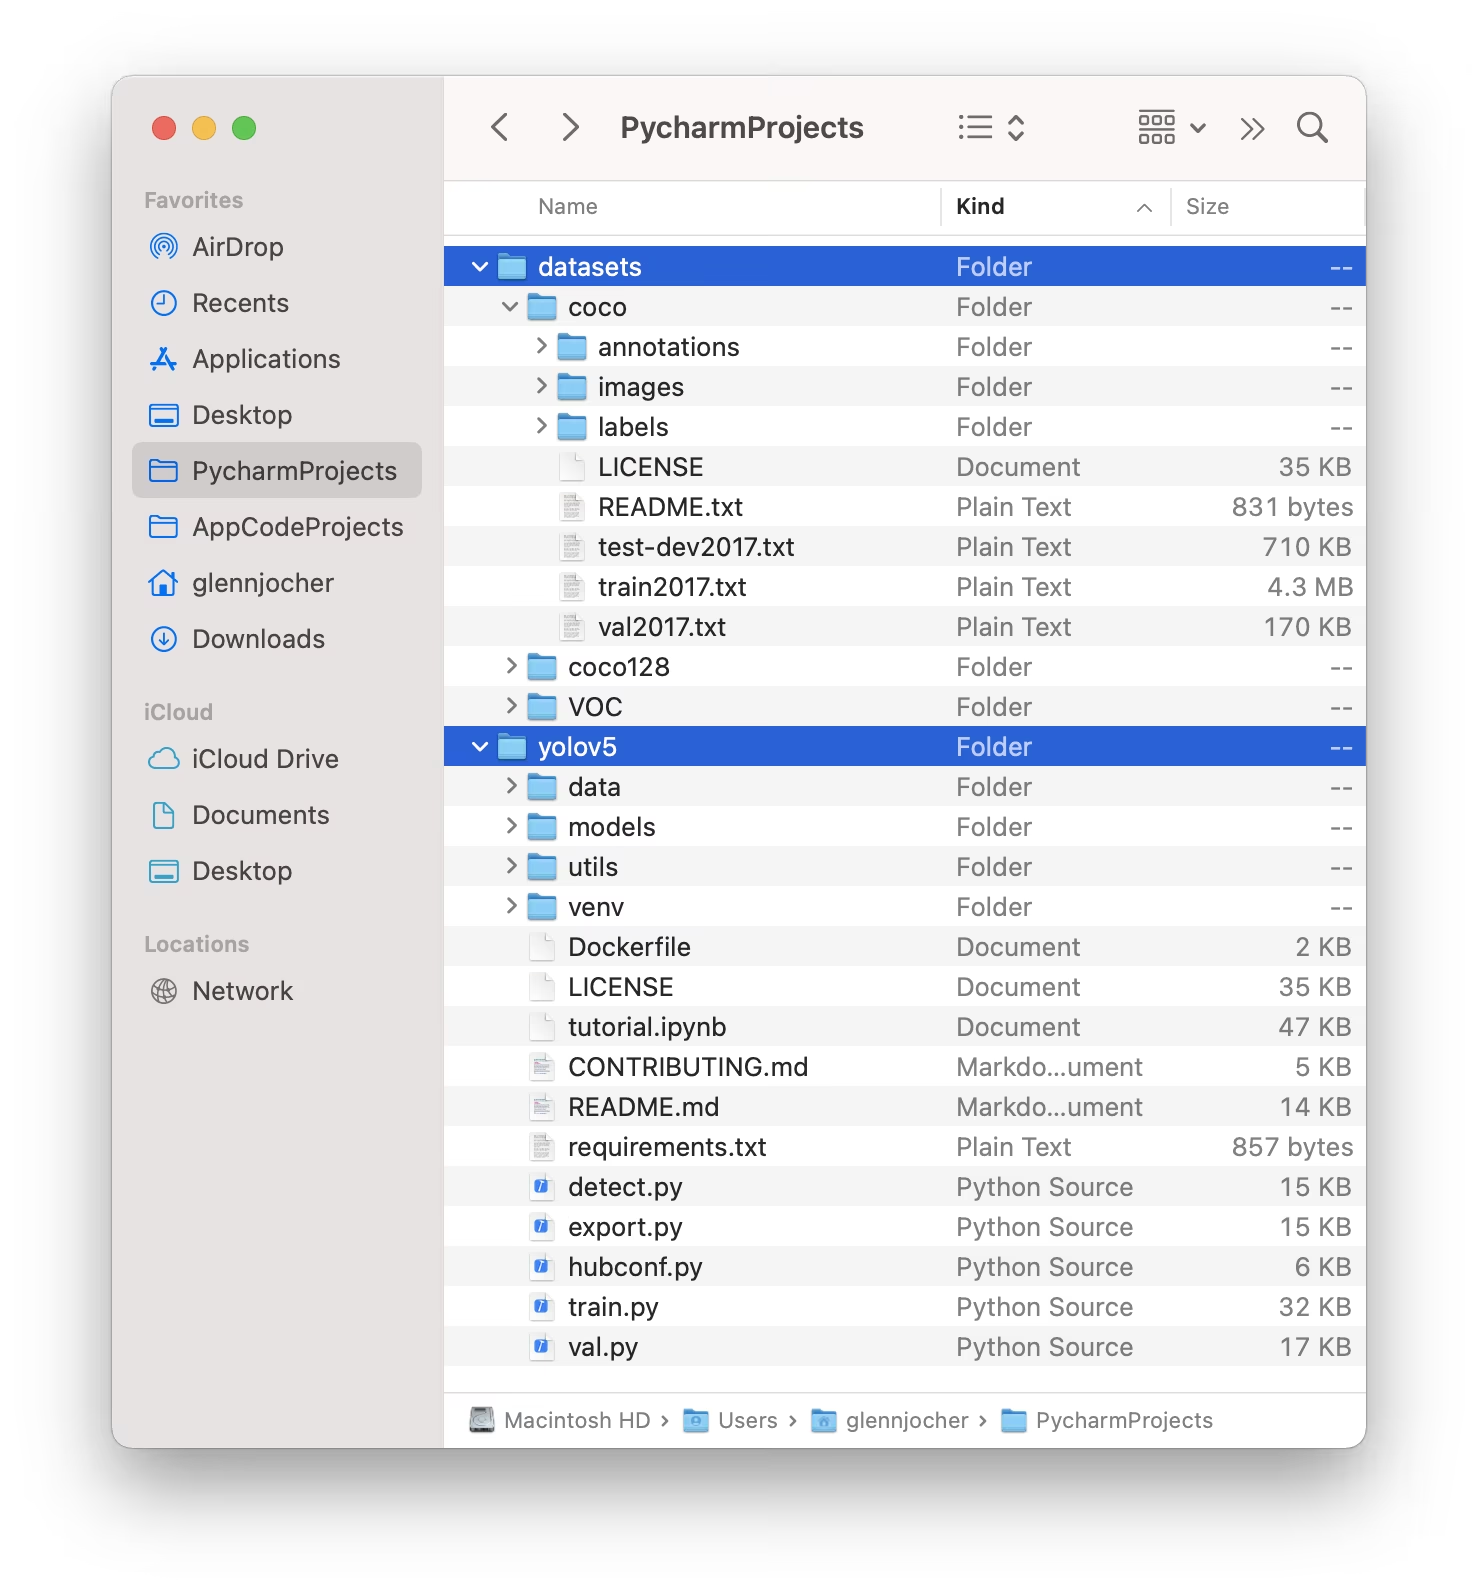
نظّم دليل مجموعات البيانات كما هو موضح أدناه. يتوقع YOLOv5 افتراضيًا وجود دليل مجموعة البيانات (مثل /coco128) داخل مجلد /datasets المجاور لدليل مستودع /yolov5.
يعثر YOLOv5 تلقائياً على تسميات كل صورة من خلال استبدال آخر ظهور لـ/images/ في مسار الصورة بـ/labels/. على سبيل المثال:
../datasets/coco128/images/im0.jpg # Path to the image file
../datasets/coco128/labels/im0.txt # Path to the corresponding label file
بنية الأدلة الموصى بها هي:
/datasets/
└── coco128/  # Dataset root
    ├── images/
    │   ├── train2017/  # Training images
    │   │   ├── 000000000009.jpg
    │   │   └── ...
    │   └── val2017/    # Validation images (optional if using same set for train/val)
    │       └── ...
    └── labels/
        ├── train2017/  # Training labels
        │   ├── 000000000009.txt
        │   └── ...
        └── val2017/    # Validation labels (optional if using same set for train/val)
            └── ...
2. اختيار نموذج#
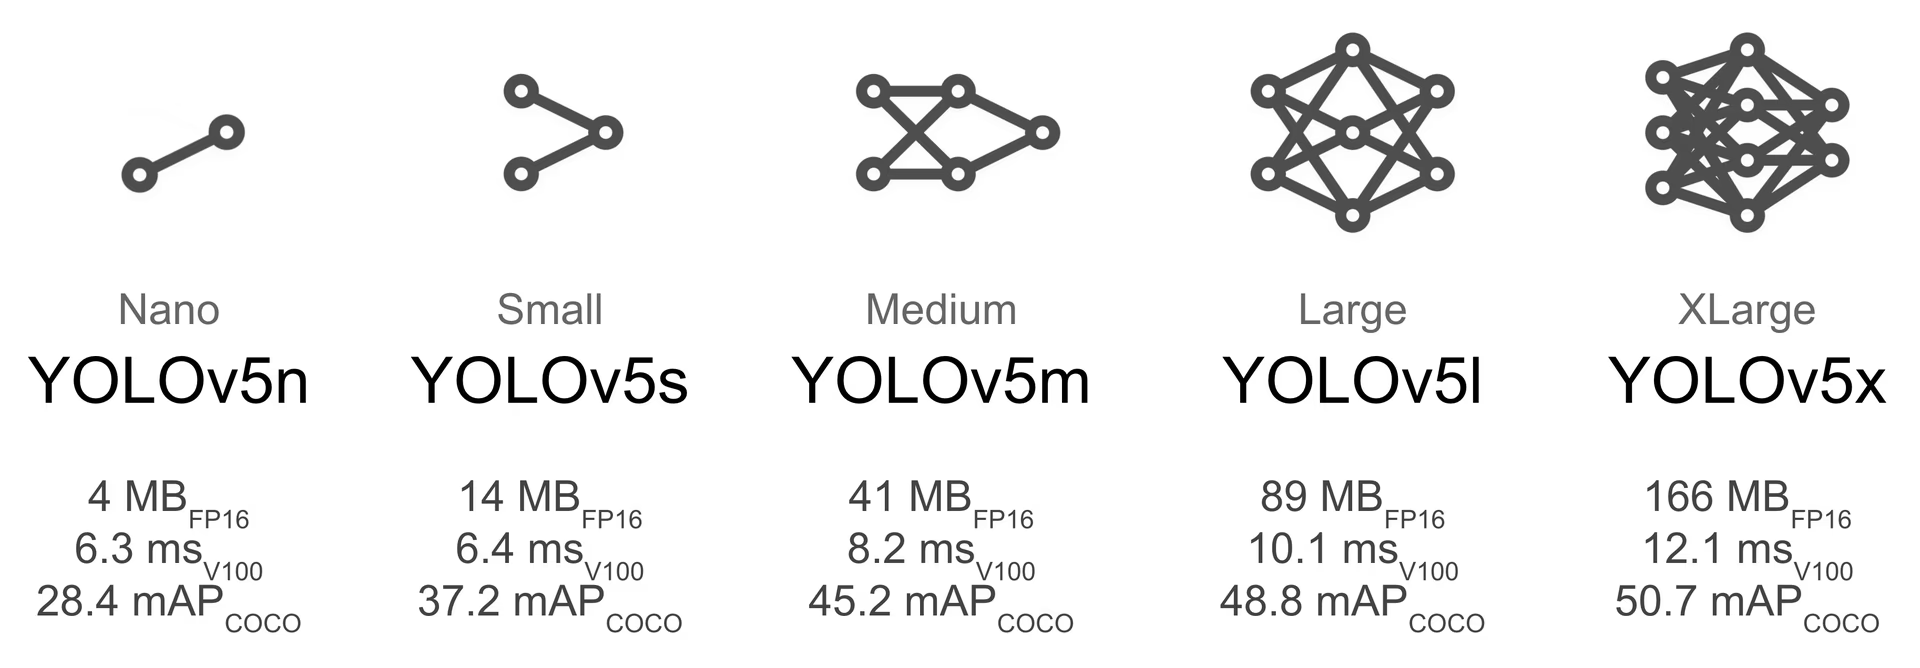
اختر نموذجًا مدرّبًا مسبقًا لبدء عملية التدريب. يؤدي البدء بأوزان مدرّبة مسبقًا إلى تسريع التعلم وتحسين الأداء بدرجة كبيرة مقارنةً بالتدريب من الصفر. يقدم YOLOv5 أحجامًا متعددة للنماذج، يوازن كل منها بين السرعة والدقة على نحو مختلف. فعلى سبيل المثال، يُعد YOLOv5s ثاني أصغر نموذج وثاني أسرعها، وهو مناسب للبيئات محدودة الموارد.
3. التدريب#
ابدأ تدريب النموذج باستخدام البرنامج النصي train.py. وتتضمن الوسائط الأساسية ما يلي:
--img: يحدد حجم صورة الإدخال (مثل--img 640). تؤدي الأحجام الأكبر عموماً إلى دقة أفضل، لكنها تتطلب مزيداً من ذاكرة GPU.--batch: يحدد حجم الدفعة (مثل--batch 16). اختر أكبر حجم يمكن أن تتعامل معه GPU لديك.--epochs: يحدد إجمالي عدد حقب التدريب (مثل--epochs 100). تمثل الحقبة مروراً كاملاً على مجموعة بيانات التدريب بأكملها.--data: مسار ملفdataset.yaml(مثل--data coco128.yaml).--weights: مسار ملف الأوزان الأولية. يُوصى باستخدام أوزان مدرّبة مسبقًا (مثل--weights yolov5s.pt) لتسريع التقارب وتحسين النتائج. للتدريب من الصفر (وهو غير مستحسن إلا إذا كانت لديك مجموعة بيانات كبيرة جدًا واحتياجات محددة)، استخدم--weights '' --cfg yolov5s.yaml.
تُنزَّل الأوزان المدرّبة مسبقاً تلقائياً من أحدث إصدار من YOLOv5 إذا لم تكن موجودة محلياً.
# Example: Train YOLOv5s on the COCO128 dataset for 3 epochs
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.ptاستخدم --cache ram أو --cache disk لتخزين صور مجموعة البيانات مؤقتًا في RAM أو على القرص المحلي، على التوالي. يمكن أن يؤدي ذلك إلى تسريع التدريب بدرجة كبيرة، لا سيما عندما تشكل عمليات الإدخال/الإخراج لمجموعة البيانات عنق زجاجة. لاحظ أن ذلك يتطلب مساحة كبيرة في RAM أو على القرص.
درّب دائمًا باستخدام مجموعات بيانات مخزنة محليًا. قد يكون الوصول إلى البيانات عبر محركات أقراص الشبكة (مثل Google Drive) أو التخزين البعيد أبطأ بكثير ويعيق أداء التدريب. وغالبًا ما يكون نسخ مجموعة بياناتك إلى SSD محلي أفضل ممارسة.
تُحفظ جميع مخرجات التدريب، بما فيها الأوزان والسجلات، في دليل runs/train/. وتنشئ كل جلسة تدريب دليلاً فرعياً جديداً (مثل runs/train/exp وruns/train/exp2 وما إلى ذلك). ولتجربة تفاعلية وعملية، استكشف قسم التدريب في دفاتر البرنامج التعليمي الرسمية لدينا: 

4. التصور#
يتكامل YOLOv5 مع أدوات متنوعة لتصوير تقدم التدريب وتقييم النتائج ومراقبة الأداء في الوقت الفعلي.
تسجيل Comet والتصور#
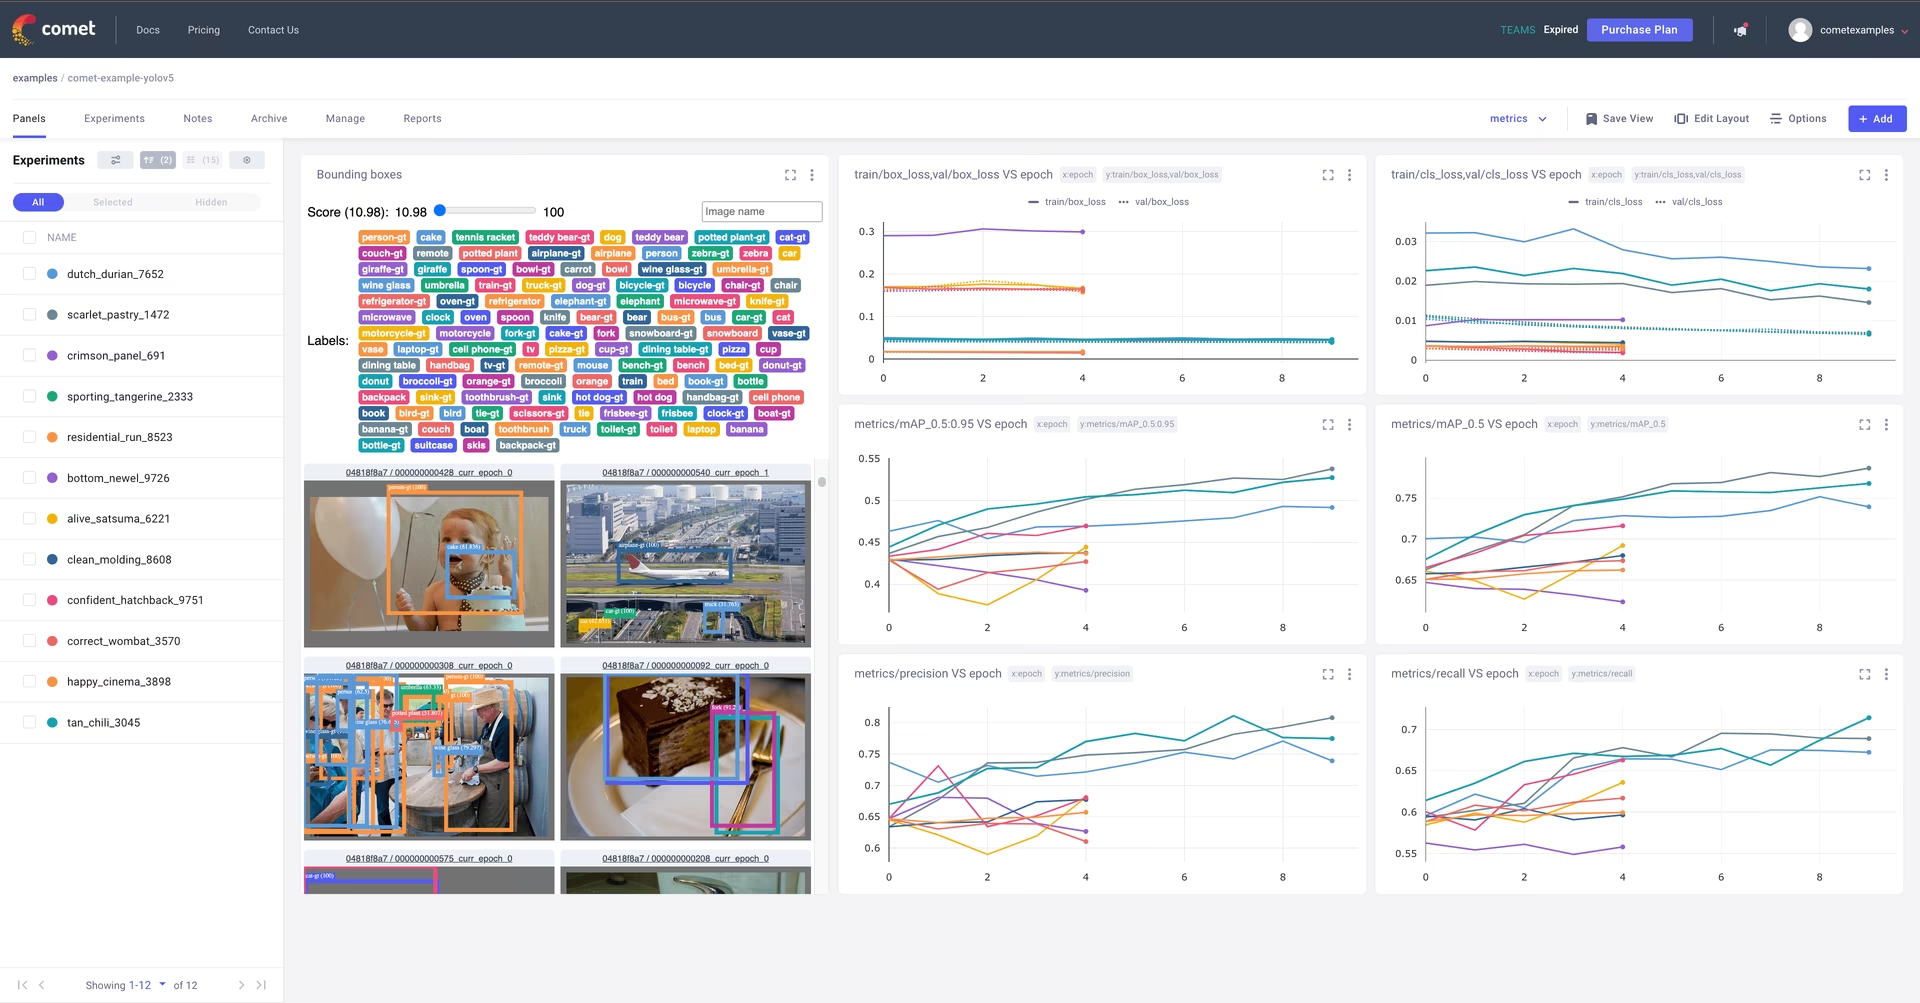
يتكامل Comet لتوفير تتبع شامل للتجارب. صوّر المقاييس مباشرةً، واحفظ المعلمات الفائقة، وأدر مجموعات البيانات ونقاط حفظ النماذج، وحلّل تنبؤات النماذج باستخدام لوحات Comet المخصصة التفاعلية.
البدء سهل ومباشر:
pip install comet_ml                                                          # 1. Install Comet library
export COMET_API_KEY=YOUR_API_KEY_HERE                                        # 2. Set your Comet API key (create a free account at Comet.ml)
python train.py --img 640 --epochs 3 --data coco128.yaml --weights yolov5s.pt # 3. Train your model - Comet automatically logs everything!
جرّب دفتر Comet Colab التفاعلي:
تسجيل ClearML والأتمتة#
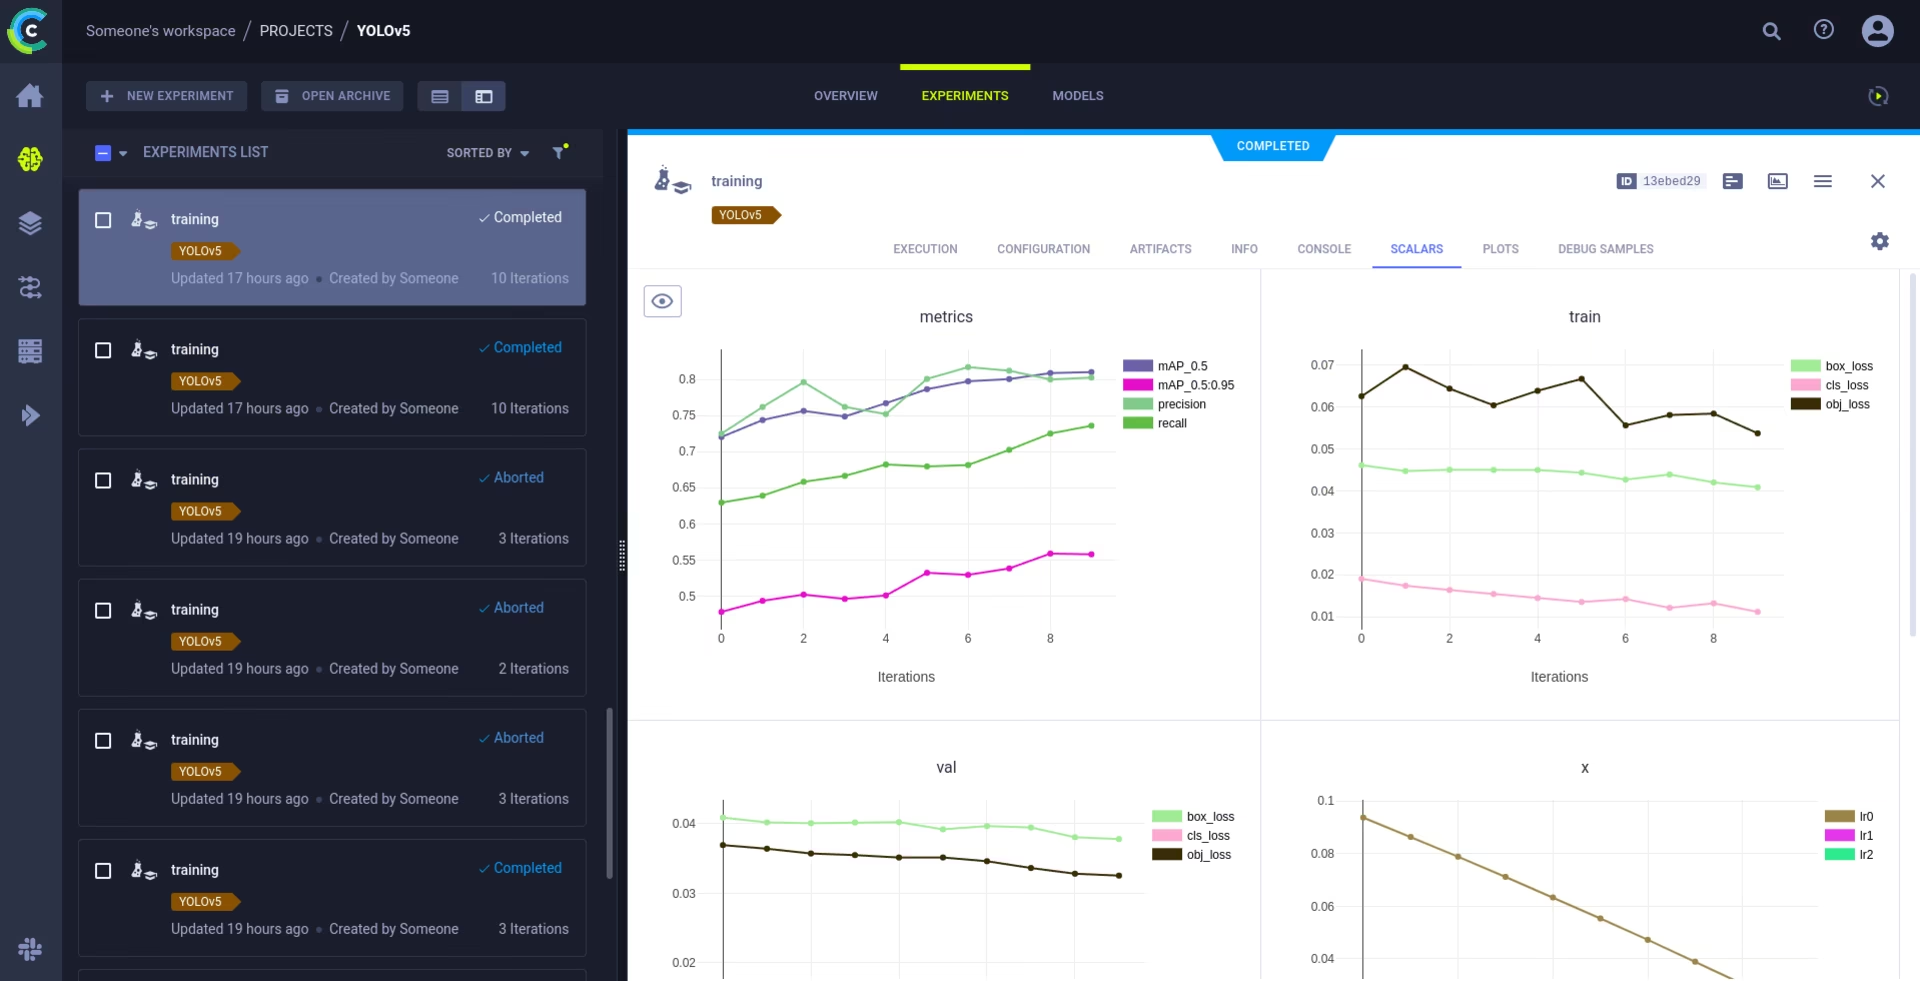
يتيح التكامل مع ClearML تتبعًا مفصلًا للتجارب وإدارة إصدارات مجموعات البيانات، وحتى التنفيذ عن بُعد لعمليات التدريب. فعّل ClearML باتباع الخطوات التالية:
- ثبّت الحزمة:
pip install clearml - هيّئ ClearML: شغّل
clearml-initمرة واحدة للاتصال بخادم ClearML لديك (سواء أكان مستضافاً ذاتياً أم ضمن الفئة المجانية).
يلتقط ClearML تلقائيًا تفاصيل التجربة وعمليات تحميل النماذج والمقارنات وتغييرات التعليمات البرمجية غير الملتزم بها والحزم المثبتة، ما يضمن إمكانية إعادة الإنتاج بالكامل. يمكنك جدولة مهام التدريب على وكلاء بعيدين وإدارة إصدارات مجموعات البيانات باستخدام ClearML Data.
التسجيل المحلي#
تُسجّل نتائج التدريب تلقائياً باستخدام TensorBoard، وتُحفظ في ملفات CSV ضمن دليل التجربة المحدد (مثل runs/train/exp). وتشمل البيانات المسجلة ما يلي:
- خسارة التدريب والتحقق ومقاييس الأداء.
- صور نموذجية تعرض عمليات زيادة البيانات المطبقة (مثل الفسيفساء).
- التسميات المرجعية إلى جانب تنبؤات النموذج للفحص البصري.
- مقاييس التقييم الرئيسية مثل منحنيات الإحكام-الاستدعاء (PR).
- مصفوفات الالتباس لتحليل الأداء تفصيلياً حسب الفئة.
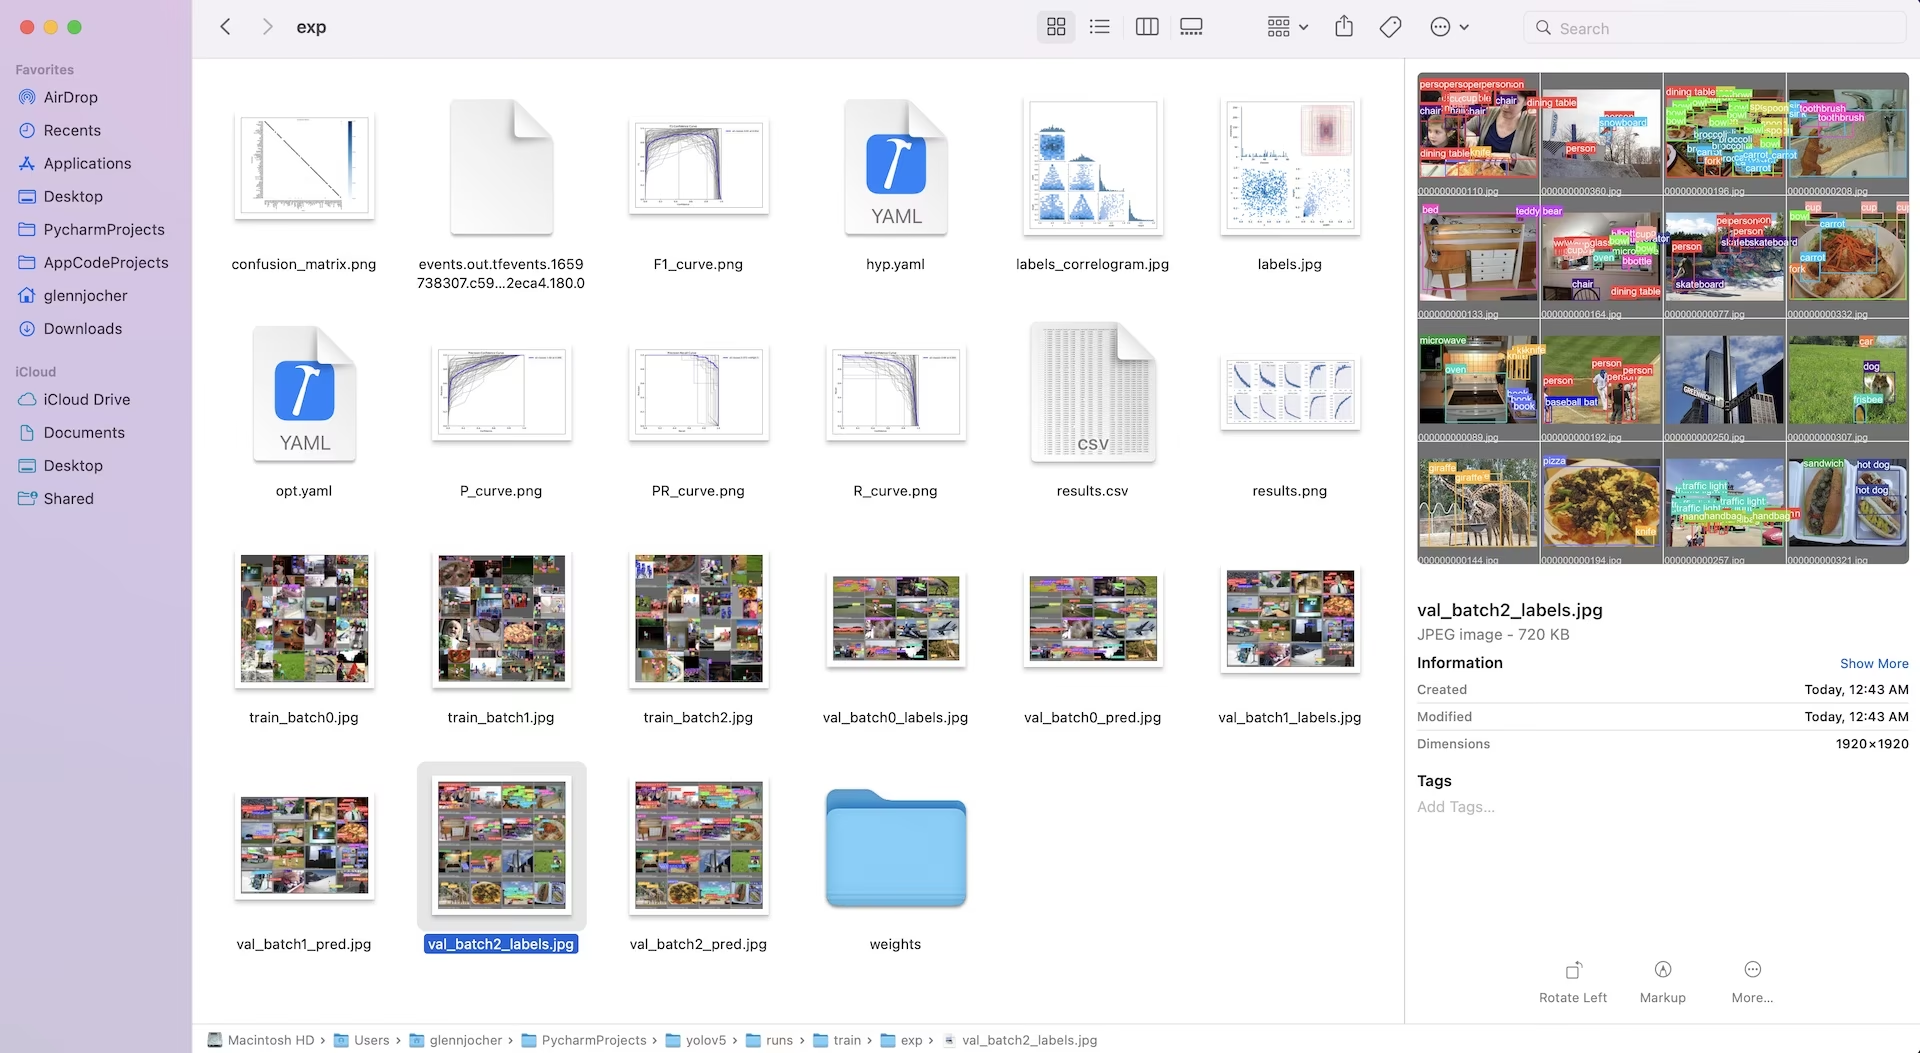
يُحدَّث ملف results.csv بعد كل حقبة، ويُرسم بصيغة results.png عند انتهاء التدريب. ويمكنك أيضاً رسم أي ملف results.csv يدوياً باستخدام دالة الأداة المساعدة المرفقة:
from utils.plots import plot_results
# ارسم النتائج من دليل تشغيل تدريب محدد
plot_results("runs/train/exp/results.csv") # سينشئ هذا الملف 'results.png' في الدليل نفسه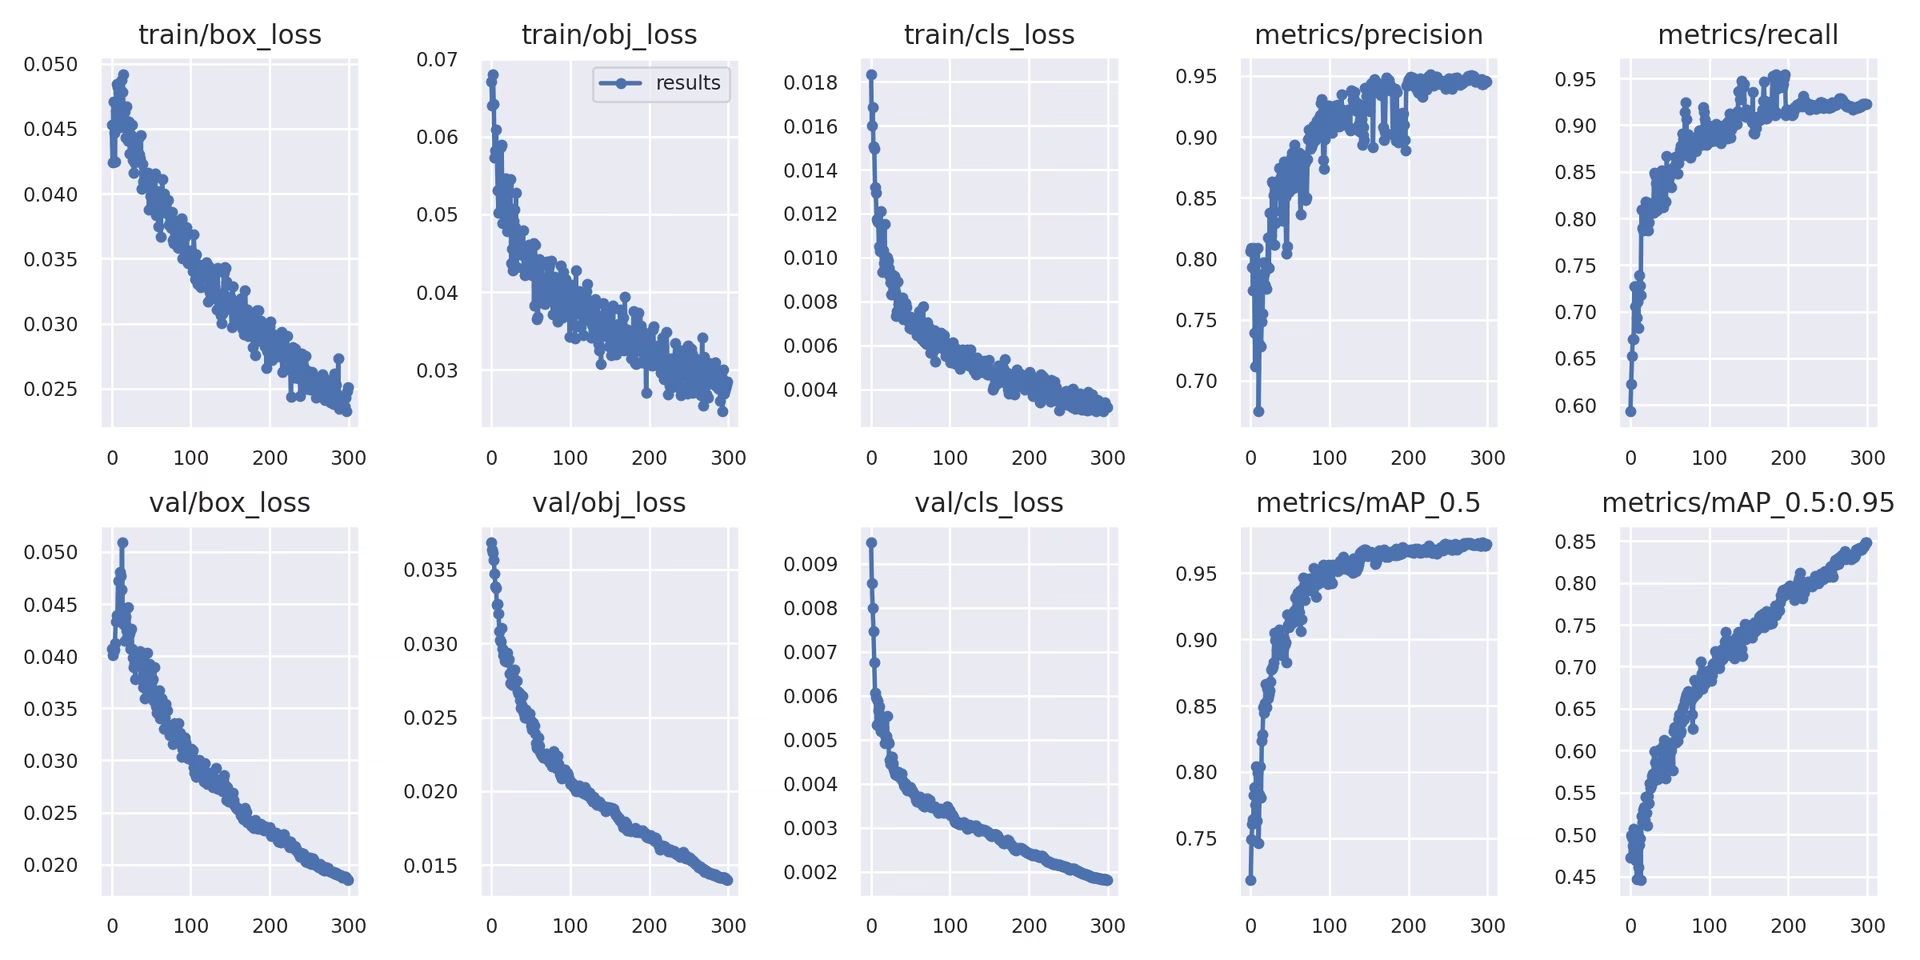
5. الخطوات التالية#
بعد اكتمال التدريب بنجاح، تُحفظ نقطة التحقق الخاصة بأفضل نموذج أداءً (best.pt) وتصبح جاهزة للنشر أو لمزيد من التحسين. وتشمل الخطوات التالية المحتملة:
- شغّل الاستدلال على صور أو مقاطع فيديو جديدة باستخدام النموذج المدرّب عبر CLI أو Python.
- شغّل
val.pyلتقييم دقة النموذج وقدرته على التعميم على تقسيمات بيانات مختلفة (مثل مجموعة اختبار محجوبة). - صدّر النموذج إلى تنسيقات نشر متنوعة مثل ONNX أو TensorFlow SavedModel أو TensorRT لإجراء استدلال محسّن على منصات متنوعة.
- استخدم تطوير المعلمات الفائقة لتحقيق مكاسب إضافية محتملة في الأداء.
- واصل تحسين نموذجك باتباع نصائح للحصول على أفضل نتائج التدريب، وإضافة المزيد من البيانات المتنوعة والصعبة بصورة تكرارية استناداً إلى تحليل الأداء.
البيئات المدعومة#
توفر Ultralytics بيئات جاهزة للاستخدام ومزوّدة بالتبعيات الأساسية مثل CUDA وcuDNN وPython وPyTorch، لتسهيل البدء.
- دفاتر GPU المجانية:
- المنصات السحابية:
- Google Cloud: دليل البدء السريع لـ GCP
- Amazon AWS: دليل البدء السريع لـ AWS
- Microsoft Azure: دليل البدء السريع لـ AzureML
- الإعداد المحلي:
- Docker: دليل البدء السريع لـ Docker
- Docker: دليل البدء السريع لـ Docker


حالة المشروع#

تشير هذه الشارة إلى اجتياز جميع اختبارات GitHub Actions الخاصة بـالتكامل المستمر (CI) في YOLOv5 بنجاح. تغطي اختبارات CI هذه الوظائف الأساسية، بما فيها التدريب والتحقق من الصحة والاستدلال والتصدير والمعايير، على أنظمة التشغيل macOS وWindows وUbuntu. وتُنفذ الاختبارات تلقائيًا كل 24 ساعة وعند كل عملية إيداع لتغييرات التعليمات البرمجية.
الأسئلة الشائعة#
يتضمن تدريب YOLOv5 على مجموعة بيانات مخصصة عدة خطوات أساسية:
- إعداد مجموعة البيانات: اجمع الصور وأضف إليها التسميات التوضيحية. تأكد من أن التعليقات التوضيحية تتبع تنسيق YOLO المطلوب. نظّم الصور والتسميات في الدليلين
train/وval/(وفيtest/اختياريًا). فكّر في استخدام نماذج مثل Google Gemini أو SAM2 أو YOLO-World للمساعدة في عملية وضع التسميات أو أتمتتها (راجع القسم 1.2). - إعداد بيئتك: استنسخ مستودع YOLOv5 وثبّت التبعيات باستخدام
pip install -r requirements.txt.git clone https://github.com/ultralytics/yolov5 cd yolov5 pip install -r requirements.txt - إنشاء إعدادات مجموعة البيانات: حدّد مسارات مجموعة البيانات وعدد الفئات وأسماءها في ملف
dataset.yaml. - بدء التدريب: نفّذ البرنامج النصي
train.py، مع تمرير مساراتdataset.yamlوالأوزان المدرّبة مسبقًا المطلوبة (مثلyolov5s.pt) وحجم الصورة وحجم الدفعة وعدد الحِقَب.python train.py --img 640 --batch 16 --epochs 100 --data path/to/your/dataset.yaml --weights yolov5s.pt
- إعداد مجموعة البيانات: اجمع الصور وأضف إليها التسميات التوضيحية. تأكد من أن التعليقات التوضيحية تتبع تنسيق YOLO المطلوب. نظّم الصور والتسميات في الدليلين
تغطي منصة Ultralytics دورة حياة تطوير نماذج YOLO بالكامل، وغالبًا دون الحاجة إلى كتابة أي تعليمات برمجية. وتشمل فوائدها الرئيسية:
- تبسيط التدريب: درّب النماذج في بيئات سحابية مُهيأة مسبقًا عبر واجهة ويب.
- إدارة متكاملة للبيانات: حمّل مجموعات البيانات وأدر إصداراتها وأدرها ضمن المنصة.
- مراقبة آنية: تابع تقدّم التدريب واعرض مقاييس الأداء بصريًا فور ورودها.
- ميزات التعاون: تيسّر العمل الجماعي من خلال الموارد المشتركة وأدوات إدارة المشاريع ومشاركة النماذج بسهولة.
- النشر دون كتابة شيفرة: انشر النماذج المدرّبة مباشرةً على أهداف متنوعة.
للاطلاع على شرح عملي، راجع تدوينة مدونتنا: كيفية تدريب نماذجك المخصصة باستخدام منصة Ultralytics.
سواء أضفت التعليقات التوضيحية يدويًا أو استخدمت أدوات مؤتمتة (مثل الأدوات المذكورة في القسم 1.2)، يجب أن تكون التسميات النهائية بالصيغة المحددة YOLO التي يتطلبها YOLOv5:
- أنشئ ملف
.txtواحدًا لكل صورة. يجب أن يطابق اسم الملف اسم الصورة (مثلًا، يقابلimage1.jpgالملفimage1.txt). ضع هذه الملفات في مجلدlabels/موازٍ لمجلدimages/(مثلًا،../datasets/mydataset/labels/train/). - يمثل كل سطر في ملف
.txtتعليقًا توضيحيًا لكائن واحد، ويتبع التنسيق التالي:class_index center_x center_y width height. - يجب أن تكون الإحداثيات (
center_xوcenter_yوwidthوheight) مطبّعة (أي قيمًا بين 0.0 و1.0) بالنسبة إلى أبعاد الصورة. - تبدأ فهارس الفئات من الصفر (الفئة الأولى هي
0، والثانية هي1، وهكذا).
تتيح كثير من أدوات التعليق التوضيحي اليدوي التصدير مباشرةً إلى صيغة YOLO. عند استخدام النماذج المؤتمتة، ستحتاج إلى نصوص برمجية أو إجراءات لتحويل مخرجاتها (مثل إحداثيات مربعات الإحاطة وأقنعة التجزئة) إلى تنسيق النص المطبّع المحدد هذا. تأكد من توافق بنية مجموعة البيانات النهائية مع المثال الوارد في الدليل. لمزيد من التفاصيل، راجع دليل جمع البيانات وإضافة التعليقات التوضيحية.
- أنشئ ملف
توفر Ultralytics خيارات ترخيص مرنة تلائم الاحتياجات المختلفة:
- ترخيص AGPL-3.0: يناسب هذا الترخيص مفتوح المصدر الأبحاث الأكاديمية والمشاريع الشخصية والحالات التي يكون فيها الامتثال لمتطلبات المصادر المفتوحة مقبولًا. ويشترط إتاحة التعديلات والأعمال المشتقة أيضًا كمصدر مفتوح بموجب AGPL-3.0. راجع تفاصيل ترخيص AGPL-3.0.
- ترخيص المؤسسات: ترخيص تجاري موجّه إلى الشركات التي تدمج YOLOv5 في منتجات أو خدمات مملوكة. يلغي هذا الترخيص التزامات المصادر المفتوحة المنصوص عليها في AGPL-3.0، ما يتيح التوزيع مغلق المصدر. تفضل بزيارة صفحة التراخيص لمزيد من التفاصيل أو لطلب ترخيص المؤسسات.
اختر الترخيص الأنسب لمتطلبات مشروعك ونموذج توزيعه.
التعليقات
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.