أفضل الممارسات والنصائح للتعلّم الآلي وتدريب النماذج
مقدمة#
من أهم الخطوات عند العمل على مشروع رؤية حاسوبية تدريب النموذج. وقبل الوصول إلى هذه الخطوة، عليك تحديد أهدافك وجمع بياناتك والتعليق عليها. وبعد معالجة البيانات مسبقًا للتأكد من نظافتها واتساقها، يمكنك الانتقال إلى تدريب النموذج.
تدريب النموذج هو عملية تعليم النموذج التعرّف على الأنماط المرئية وإجراء التنبؤات انطلاقًا من بياناتك، وهو يؤثر مباشرةً في دقة تطبيقك. يستعرض هذا الدليل أفضل الممارسات وتقنيات التحسين ونصائح استكشاف الأخطاء وإصلاحها لمساعدتك على تدريب نماذج الرؤية الحاسوبية بفاعلية.
شاهد: نصائح تدريب النماذج | كيفية التعامل مع مجموعات البيانات الكبيرة | حجم الدفعة، واستخدام GPU، والدقة المختلطة
كيفية تدريب نموذج تعلّم آلي#
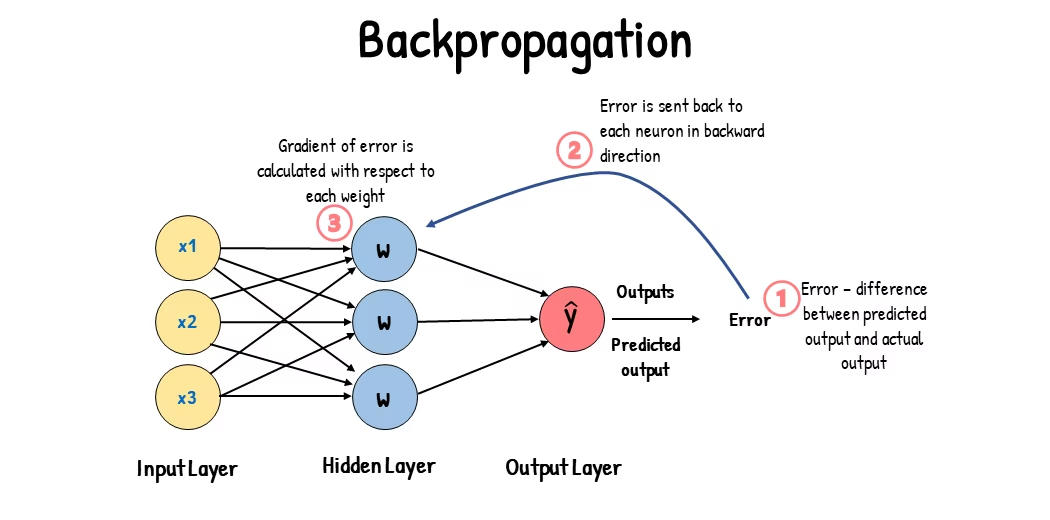
يُدرَّب نموذج الرؤية الحاسوبية بتعديل معلماته الداخلية لتقليل الأخطاء. في البداية، يُزوَّد النموذج بمجموعة كبيرة من الصور المصنّفة. ثم يتنبأ بمحتوى هذه الصور، وتُقارَن تنبؤاته بالتسميات أو المحتويات الفعلية لحساب الأخطاء. وتوضح هذه الأخطاء مدى ابتعاد تنبؤات النموذج عن القيم الصحيحة.
أثناء التدريب، يجري النموذج تنبؤات تكرارية، ويحسب الأخطاء، ويحدّث معلماته عبر عملية تُسمى الانتشار العكسي. وفي هذه العملية، يعدّل النموذج معلماته الداخلية (الأوزان والانحيازات) لتقليل الأخطاء. ومن خلال تكرار هذه الدورة مرات عديدة، تتحسن دقته تدريجيًا. ومع مرور الوقت، يتعلم التعرّف على الأنماط المعقدة مثل الأشكال والألوان والأنسجة.
تتيح عملية التعلم هذه لنموذج الرؤية الحاسوبية تنفيذ مهام متعددة، منها اكتشاف الأجسام وتجزئة المثيلات والتجزئة الدلالية وتصنيف الصور. والهدف النهائي هو إنشاء نموذج يعمم ما تعلمه على صور جديدة لم يسبق له رؤيتها، بحيث يتمكن من فهم البيانات المرئية بدقة في التطبيقات الواقعية.
بعد أن عرفنا ما يحدث خلف الكواليس عند تدريب نموذج، فلنلقِ نظرة على النقاط التي ينبغي مراعاتها أثناء تدريب النموذج.
التدريب على مجموعات بيانات كبيرة#
ثمة جوانب مختلفة ينبغي التفكير فيها عند التخطيط لاستخدام مجموعة بيانات كبيرة لتدريب نموذج. فعلى سبيل المثال، يمكنك ضبط حجم الدفعة، والتحكم في استخدام GPU، واختيار التدريب متعدد المقاييس، وغير ذلك. لنستعرض كل خيار من هذه الخيارات بالتفصيل.
حجم الدفعة واستخدام GPU#
عند تدريب النماذج على مجموعات بيانات كبيرة، يُعد الاستخدام الفعال لـ GPU أمرًا أساسيًا. وحجم الدفعة عامل مهم، فهو عدد عينات البيانات التي يعالجها نموذج التعلّم الآلي في تكرار تدريبي واحد. وباستخدام أكبر حجم دفعة يدعمه GPU، يمكنك الاستفادة الكاملة من إمكاناته وتقليل مدة تدريب النموذج. لكن ينبغي تجنب نفاد ذاكرة GPU. وإذا واجهت أخطاء في الذاكرة، فقلّل حجم الدفعة تدريجيًا إلى أن يعمل التدريب بسلاسة.
شاهد: كيفية تسريع استدلال Ultralytics YOLO26 بمقدار 2× باستخدام المعالجة الدفعية | Python وGPU | MLOps 🚀
فيما يتعلق بـ YOLO26، يمكنك ضبط المعلمة batch في وسائط وضع التدريب لتناسب سعة وحدة GPU لديك. على مُسرِّع واحد، يقيّم batch=-1 النموذج ويختار حجم دفعة يستهدف استخدامًا للذاكرة يقارب 60%؛ وتستهدف قيمة كسرية مثل batch=0.70 نسبة مختلفة. تتطلب عمليات التشغيل باستخدام وحدات GPU متعددة تحديد حجم دفعة إجمالي صريح لا يقل عن عدد الأجهزة. على CPU وأجهزة Apple silicon، يصدر AutoBatch تحذيرًا ويعود إلى batch=16.
التدريب على مجموعة فرعية#
يُعد التدريب على مجموعة فرعية استراتيجية عملية تتضمن تدريب النموذج على مجموعة بيانات أصغر تمثّل مجموعة البيانات الأكبر. ويمكن أن يوفر الوقت والموارد، لا سيما خلال المراحل الأولى من تطوير النموذج واختباره. وإذا كان وقتك محدودًا أو كنت تجرّب إعدادات مختلفة للنموذج، فالتدريب على مجموعة فرعية خيار مناسب.
فيما يتعلق بـ YOLO26، يمكنك تنفيذ التدريب على مجموعة فرعية باستخدام المعلمة fraction. استخدم نسبة مثل fraction=0.1 لتحديد 10% من بيانات التدريب، أو عددًا صحيحًا مثل fraction=300 لاختيار 300 صورة تدريب بالضبط، أو قائمة [train, val, test] مثل fraction=[300, 100, 0] لتقييد كل تقسيم وتخطي صور الاختبار. تُبقي القوائم المؤلفة من عنصرين، مثل [300, 100]، تقسيم الاختبار كاملًا. تختار مجموعات بيانات NDJSON السجلات المتباعدة بالتساوي قبل تنزيلها، لذا تعيد عمليات التشغيل المتكررة استخدام المجموعة الفرعية نفسها تمامًا. تختار مجموعات بيانات التصنيف المستندة إلى مجلدات الصور أيضًا عينات متباعدة بالتساوي. أما مجموعات بيانات مجلدات الصور الأخرى، فتختار fraction أول N صورة بحسب الترتيب المصنّف لمسارات الصور، لا عينة عشوائية؛ لذا نسّق المجموعات الفرعية يدويًا عندما يُحتمل أن يؤدي الترتيب إلى استبعاد مصادر أو فئات. عند إعداد تقسيمات التدريب والتحقق، أبقِ مجموعات الصور شبه المكررة ضمن تقسيم واحد بالكامل.
التدريب متعدد المقاييس#
التدريب متعدد المقاييس تقنية تحسّن قدرة النموذج على التعميم عبر تدريبه على صور بأحجام مختلفة. ويمكن للنموذج أن يتعلم اكتشاف الأجسام بمقاييس ومسافات مختلفة وأن يصبح أكثر متانة.
عند تدريب YOLO26، يمكنك تفعيل زيادة المقياس بضبط المعلمة scale. تعدّل هذه المعلمة حجم صور التدريب بعامل محدد، لمحاكاة ظهور الأجسام على مسافات مختلفة. فعلى سبيل المثال، يؤدي ضبط scale=0.5 إلى تكبير صور التدريب عشوائيًا بعامل يتراوح بين 0.5 و1.5 أثناء التدريب. ويتيح ضبط هذه المعلمة للنموذج التعامل مع مجموعة متنوعة من مقاييس الصور وتحسين قدراته على الكشف عن أحجام مختلفة من الأجسام وفي سيناريوهات متنوعة.
تدعم Ultralytics أيضًا التدريب متعدد المقاييس بحجم الصورة عبر المعلمة multi_scale. وعلى خلاف scale، التي تكبّر الصور ثم تضيف إليها الحشو أو تقصّها لتعود إلى imgsz، تغيّر multi_scale قيمة imgsz نفسها مع كل دفعة (مع تقريبها إلى أقرب قيمة توافق خطوة النموذج). فعلى سبيل المثال، مع imgsz=640 وmulti_scale=0.25، يُختار حجم التدريب عشوائيًا من 480 إلى 800 بخطوات توافق خطوة النموذج (مثل 480 و512 و544 و... و800)، بينما يحافظ multi_scale=0.0 على حجم ثابت.
التخزين المؤقت#
التخزين المؤقت تقنية مهمة لتحسين كفاءة تدريب نماذج التعلّم الآلي. فبتخزين الصور المعالجة مسبقًا في الذاكرة، يقلّل التخزين المؤقت الوقت الذي يقضيه GPU في انتظار تحميل البيانات من القرص. ويمكن للنموذج تلقي البيانات باستمرار من دون تأخير تسببه عمليات الإدخال والإخراج للقرص.
يمكن التحكم في التخزين المؤقت عند تدريب YOLO26 باستخدام المعلمة cache:
cache=True: يخزّن صور مجموعة البيانات في RAM، ما يوفر أسرع وصول إليها مقابل زيادة استخدام الذاكرة.cache='disk': يخزّن الصور على القرص، وهو أبطأ من RAM لكنه أسرع من تحميل البيانات من جديد في كل مرة.cache=False: يعطّل التخزين المؤقت ويعتمد بالكامل على عمليات الإدخال والإخراج للقرص، وهو الخيار الأبطأ.
التدريب بدقة مختلطة#
يستخدم التدريب بالدقة المختلطة نوعي الفاصلة العائمة ذوي 16 بت (FP16) و32 بت (FP32): يُستخدم FP16 لتسريع العمليات الحسابية، وFP32 للحفاظ على الدقة عند الحاجة. تُنفذ معظم عمليات الشبكة العصبية باستخدام FP16 للاستفادة من سرعة الحساب الأعلى والاستهلاك الأقل للذاكرة. ومع ذلك، تُحفظ نسخة رئيسية من أوزان النموذج باستخدام FP32 لضمان الدقة أثناء تحديث الأوزان. ويمكنك التعامل مع نماذج أكبر أو أحجام دفعات أكبر ضمن قيود الأجهزة نفسها.
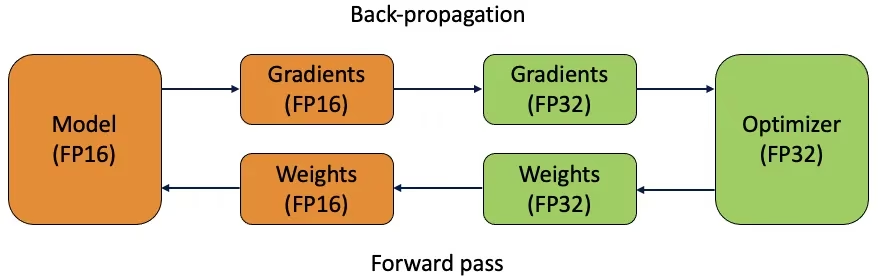
لتطبيق التدريب بدقة مختلطة، عليك تعديل نصوص التدريب والتأكد من أن أجهزتك (مثل وحدات GPU) تدعمه. وتوفر أطر عمل التعلّم العميق الحديثة العديدة، مثل PyTorch وTensorFlow، دعمًا مضمّنًا للدقة المختلطة.
التدريب بالدقة المختلطة سهل عند العمل باستخدام YOLO26: إذ يكون AMP مفعّلًا افتراضيًا بالفعل (amp=True). على GPU يعمل بـCUDA، يجري YOLO فحصًا لمرة واحدة للقدرات عند بدء التدريب، ويعود إلى FP32 الكامل إذا فشل الفحص؛ أما على CPU وشرائح Apple، فيُتجاوز AMP بالكامل. اضبط amp=False لفرض استخدام FP32، أو amp="bf16" للتدريب باستخدام bfloat16 على وحدات GPU المدعومة.
الأوزان المدرّبة مسبقاً#
يُعد استخدام الأوزان المدربة مسبقًا وسيلة فعالة لتسريع تدريب نموذجك. تأتي هذه الأوزان من نماذج سبق تدريبها على مجموعات بيانات كبيرة، مما يمنح نموذجك بداية متقدمة. ويكيّف التعلّم بالنقل النماذج المدربة مسبقًا مع مهام جديدة ذات صلة. ويتضمن الضبط الدقيق لنموذج مدرب مسبقًا البدء بهذه الأوزان ثم مواصلة التدريب على مجموعة بياناتك المحددة. تؤدي طريقة التدريب هذه إلى تقليل وقت التدريب وتحسين الأداء غالبًا، لأن النموذج يبدأ بفهم راسخ للسمات الأساسية.
تأتي الأوزان المدرّبة مسبقًا من الوسيطة model، لذا يبدأ model=yolo26n.pt بالفعل باستخدام أوزان COCO. وتتحكم المعلمة pretrained في الاحتفاظ بهذه الأوزان (True، وهو الإعداد الافتراضي)، أو التخلص منها (False)، أو استبدالها بنقطة تحقق أخرى (pretrained=path/to/best.pt). ولا يؤدي تعيين pretrained=True لنموذج *.yaml إلى جلب الأوزان تلقائيًا. راجع كيفية ضبط YOLO بدقة على مجموعة بيانات مخصصة للاطلاع على سير العمل الكامل للتعلّم بالنقل.
تقنيات أخرى ينبغي مراعاتها عند التعامل مع مجموعة بيانات كبيرة#
ثمة تقنيتان أخريان يجدر التفكير فيهما عند التعامل مع مجموعة بيانات كبيرة:
- مجدولات معدل التعلّم: يتيح تطبيق مجدولات معدل التعلّم ضبط معدل التعلّم ديناميكيًا أثناء التدريب. ويمكن لمعدل تعلّم مضبوط جيدًا أن يمنع النموذج من تجاوز نقاط الحد الأدنى ويحسّن الاستقرار. وعند تدريب YOLO26، تساعد المعلمة
lrfعلى إدارة جدولة معدل التعلّم عبر تعيين معدل التعلّم النهائي ككسر من المعدل الأولي. وللتحكم في سلوك لا تتيحه أي وسيطة، مثل معدلات التعلّم لكل طبقة أو قصّ التدرّج، أنشئ فئة فرعية من المدرّب. - التدريب الموزع: عند التعامل مع مجموعات بيانات كبيرة، يقلل التدريب الموزع وقت التدريب بتوزيع عبء العمل على عدة وحدات GPU أو أجهزة. ويكتسب هذا النهج أهمية خاصة في المشاريع ذات النطاق المؤسسي التي تتوفر لها موارد حاسوبية كبيرة.
- تنسيق الذاكرة بترتيب القنوات أخيرًا: يستخدم التدريب على NVIDIA CUDA تلقائيًا تخطيط الذاكرة NHWC الأسرع مع PyTorch 1.11 والإصدارات الأحدث، باستثناء Windows، حيث أظهرت القياسات أنه أبطأ. يحافظ التدريب على AMD ROCm على تنسيق NCHW، الذي أظهرت القياسات أنه أسرع في هذه الحالة. اضبط
channels_last=Trueلفرض استخدامه أوchannels_last=Falseللإبقاء على NCHW؛ ويظل PyTorch 1.10 والإصدارات الأقدم، وCPU، وMPS على تنسيق NCHW افتراضيًا.
عدد حقب التدريب#
عند تدريب نموذج، تشير الحقبة إلى مرور كامل واحد على مجموعة بيانات التدريب بأكملها. وخلال الحقبة، يعالج النموذج كل مثال في مجموعة التدريب مرة واحدة ويحدّث معلماته استنادًا إلى خوارزمية التعلّم. وعادةً ما تلزم حقب متعددة كي يتعلم النموذج ويصقل معلماته بمرور الوقت.
من الأسئلة الشائعة كيفية تحديد عدد الحقب التي ينبغي تدريب النموذج خلالها. وتُعدّ 300 حقبة نقطة بداية جيدة. إذا أفرط النموذج في التخصيص مبكرًا، يمكنك تقليل عدد الحقب. وإذا لم يحدث فرط التخصيص بعد 300 حقبة، يمكنك تمديد التدريب إلى 600 أو 1200 حقبة أو أكثر.
ومع ذلك، قد يختلف العدد المثالي للحقب بحسب حجم مجموعة بياناتك وأهداف المشروع. فقد تتطلب مجموعات البيانات الأكبر عددًا أكبر من الحقب كي يتعلم النموذج بفاعلية، بينما قد تحتاج مجموعات البيانات الأصغر إلى عدد أقل لتجنب فرط التخصيص. وبالنسبة إلى YOLO26، يمكنك ضبط المعلمة epochs في نص التدريب.
الإيقاف المبكر#
الإيقاف المبكر تقنية مفيدة لتحسين تدريب النموذج. فمن خلال مراقبة الأداء على بيانات التحقق، يمكنك إيقاف التدريب عندما يتوقف النموذج عن التحسن. وبذلك يمكنك توفير موارد الحوسبة ومنع فرط التخصيص.
تتضمن العملية تعيين معلمة للصبر تحدد عدد الحقب التي ينبغي انتظارها لرصد تحسن في مقاييس التحقق قبل إيقاف التدريب. وإذا لم يتحسن أداء النموذج خلال هذه الحقب، يُوقَف التدريب لتجنب إهدار الوقت والموارد.
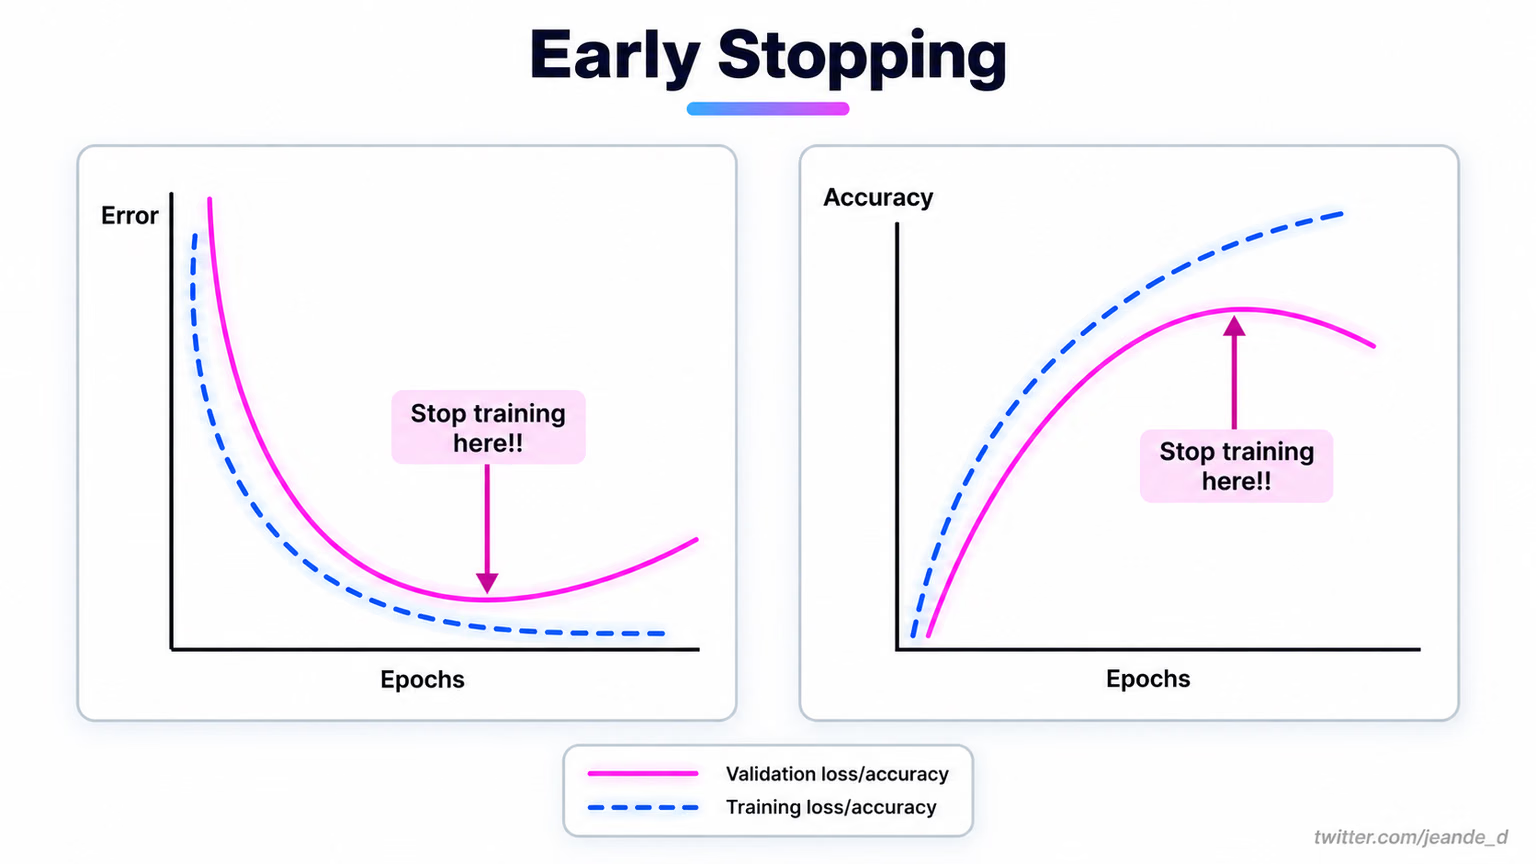
في YOLO26، يمكنك تفعيل الإيقاف المبكر بضبط معلمة patience في إعدادات التدريب. فعلى سبيل المثال، تعني patience=5 أن التدريب سيتوقف إذا لم يحدث أي تحسن في مقاييس التحقق خلال 5 عصور تدريب متتالية. وهذا يحافظ على كفاءة التدريب ويتجنب العمليات الحسابية غير الضرورية.
الاختيار بين التدريب السحابي والمحلي#
يتوفر خياران لتدريب النموذج: التدريب السحابي والتدريب المحلي.
يوفر التدريب السحابي قابلية التوسع وأجهزة قوية، وهو مثالي للتعامل مع مجموعات البيانات الكبيرة والنماذج المعقدة. وتوفر منصات مثل Google Cloud وAWS وAzure إمكانية الوصول عند الطلب إلى وحدات GPU وTPU عالية الأداء، مما يقلل وقت التدريب ويتيح إجراء التجارب باستخدام نماذج أكبر. كما توفر Ultralytics Platform تدريبًا سحابيًا مُدارًا لنماذج YOLO. لكن التدريب السحابي قد يكون مكلفًا، لا سيما لفترات طويلة، وقد تضيف عملية نقل البيانات إلى التكاليف وزمن الاستجابة.
يوفر التدريب المحلي تحكمًا وتخصيصًا أكبر، إذ يتيح لك تهيئة بيئتك وفقًا لاحتياجات محددة وتجنب التكاليف السحابية المستمرة. وقد يكون أوفر للمشروعات طويلة الأمد، كما أن بقاء بياناتك داخل المؤسسة يجعله أكثر أمانًا. ومع ذلك، قد تكون موارد الأجهزة المحلية محدودة وقد تتطلب صيانة، ما قد يؤدي إلى إطالة أوقات تدريب النماذج الكبيرة.
اختيار المُحسِّن#
المُحسِّن خوارزمية تضبط أوزان شبكتك العصبية لتقليل دالة الخسارة، التي تقيس مدى جودة أداء النموذج. وبعبارة أبسط، يساعد المُحسِّن النموذج على التعلم عبر تعديل معلماته لتقليل الأخطاء. ويؤثر اختيار المُحسِّن المناسب مباشرةً في سرعة تعلم النموذج ودقته.
يمكنك أيضًا ضبط معلمات المُحسِّن لتحسين أداء النموذج. يحدد تعديل معدل التعلم حجم الخطوات عند تحديث المعلمات. ولتحقيق الاستقرار، يمكنك البدء بمعدل تعلم متوسط وخفضه تدريجيًا بمرور الوقت لتحسين التعلم على المدى الطويل. بالإضافة إلى ذلك، يحدد ضبط الزخم مدى تأثير التحديثات السابقة في التحديثات الحالية. وتبلغ القيمة الشائعة للزخم نحو 0.9، وهي تحقق عمومًا توازنًا جيدًا.
المُحسِّنات الشائعة#
تتفاوت نقاط القوة والضعف بين المحسّنات المختلفة. إليك بعض المحسّنات الشائعة.
-
SGD (الانحدار المتدرج العشوائي):
- يحدّث معلمات النموذج باستخدام تدرج دالة الخسارة بالنسبة إلى المعلمات.
- بسيط وفعّال، لكنه قد يتقارب ببطء وقد يعلق في نقاط دنيا محلية.
-
Adam (تقدير العزم التكيفي):
- يجمع مزايا كل من SGD مع الزخم وRMSProp.
- يضبط معدل التعلم لكل معلمة بناءً على تقديرات العزمين الأول والثاني للتدرجات.
- مناسب تمامًا للبيانات المشوشة والتدرجات المتناثرة.
- فعّال ويتطلب عمومًا ضبطًا أقل. في جولات التدريب الأقصر، يختار
optimizer=autoفي YOLO26 الخيار AdamW وثيق الصلة بدلًا من Adam نفسه.
-
RMSProp (انتشار متوسط المربعات الجذرية):
- يضبط معدل التعلم لكل معلمة بقسمة التدرج على متوسط متحرك لمقادير التدرجات الحديثة.
- يساعد على معالجة مشكلة تلاشي التدرج، وهو فعّال مع الشبكات العصبية المتكررة.
-
MuSGD (مزيج هجين من Muon وSGD):
- يجمع بين التحديثات بأسلوب SGD وسلوك مستوحى من Muon لتحسين الاستقرار في التدريب واسع النطاق.
- خيار جيد عندما تريد تعميمًا شبيهًا بـ SGD، لكنك تحتاج إلى تقارب أكثر سلاسة من SGD التقليدي.
- له أهمية خاصة في وصفات تدريب YOLO26؛ وإذا لم تكن متأكدًا، فابدأ باستخدام
optimizer=autoوقارنه بـ MuSGD على مجموعة بياناتك.
في YOLO26، تتيح لك المعلمة optimizer الاختيار من بين عدة محسّنات، بما فيها SGD وMuSGD وAdam وAdamax وAdamW وNAdam وRAdam وRMSProp، أو ضبطها على auto للاختيار تلقائيًا استنادًا إلى عدد تكرارات التدريب (يُستخدم AdamW للتشغيلات الأقصر، وMuSGD لأكثر من 10,000 تكرار).
yolo train model=yolo26n.pt data=coco8.yaml optimizer=MuSGDالتواصل مع المجتمع#
يمكن أن تساعدك المشاركة في مجتمع من المهتمين بالرؤية الحاسوبية على حل المشكلات والتعلم بسرعة أكبر. إليك بعض الطرق للتواصل وطلب المساعدة ومشاركة الأفكار.
موارد المجتمع#
- مشكلات GitHub: تفضل بزيارة مستودع YOLO26 على GitHub واستخدم علامة التبويب Issues لطرح الأسئلة والإبلاغ عن الأخطاء واقتراح ميزات جديدة. يتميز المجتمع والقائمون على الصيانة بنشاطهم واستعدادهم للمساعدة.
- خادم Ultralytics على Discord: انضم إلى خادم Ultralytics على Discord للدردشة مع المستخدمين والمطورين الآخرين، والحصول على الدعم، ومشاركة تجاربك.
سيساعدك استخدام هذه الموارد على حل التحديات ومواكبة أحدث الاتجاهات والممارسات في مجتمع الرؤية الحاسوبية.
أهم النتائج#
يتطلب تدريب نماذج الرؤية الحاسوبية اتباع ممارسات جيدة، وتحسين الاستراتيجيات، وحل المشكلات عند ظهورها. ويمكن لتقنيات مثل تعديل أحجام الدفعات، والتدريب بالدقة المختلطة، والبدء بأوزان مدربة مسبقًا أن تحسن أداء النماذج وتسرّع تدريبها. وتساعدك أساليب مثل التدريب على مجموعة فرعية والإيقاف المبكر على توفير الوقت والموارد. كما أن التواصل المستمر مع المجتمع ومواكبة الاتجاهات الجديدة سيساعدانك على مواصلة تطوير مهاراتك في تدريب النماذج.
الأسئلة الشائعة#
لتحسين استخدام GPU، اضبط المعلمة
batchعلى أكبر حجم تدعمه وحدة GPU لديك. على مُسرِّع واحد، يقيّمbatch=-1النموذج ويستهدف استخدامًا للذاكرة يقارب 60%. ويعود إلىbatch=16على CPU وأجهزة Apple silicon، بينما تتطلب عمليات التشغيل باستخدام وحدات GPU متعددة تحديد حجم دفعة إجمالي صريح لا يقل عن عدد الأجهزة. لمزيد من المعلومات، راجع وسائط وضع التدريب.يستخدم التدريب بدقة مختلطة أنواع الأعداد العائمة ذات 16 بت (FP16) و32 بت (FP32) لتحقيق توازن بين سرعة الحوسبة والدقة. ويكون هذا الخيار مفعّلًا افتراضيًا في YOLO26 عبر
amp=True؛ اضبطamp=Falseلفرض استخدام FP32. ولا يُستخدم AMP على CPU أو شرائح Apple.يعزز التدريب متعدد المقاييس أداء النموذج من خلال تدريبه على صور بأحجام مختلفة، ما يسمح له بالتعميم على نحو أفضل عبر المقاييس والمسافات المختلفة. يوفر YOLO26 معلمتين منفصلتين لهذا الغرض. تأخذ
scale=0.5عينةً لمعامل تكبير يتراوح بين 0.5 و1.5، ثم تضيف الحشو أو تقتطع الصورة للعودة إلى قيمة ثابتة لـimgsz، بينما تغيّرmulti_scale=0.25قيمةimgszنفسها في كل دفعة بخطوات مقدارها خطوة المسح. للاطلاع على الإعدادات ومزيد من التفاصيل، راجع وثائق وضع التدريب.يمكن أن يؤدي استخدام الأوزان المدرّبة مسبقًا إلى تسريع التدريب بدرجة كبيرة وتحسين دقة النموذج، وذلك بالاستفادة من نموذج تعرّف مسبقًا على السمات البصرية الأساسية. حمّل الأوزان عبر الوسيط
model، كما فيmodel=yolo26n.pt؛ ثم تحددpretrainedما إذا كانت هذه الأوزان ستُحتفظ بها (True، وهو الإعداد الافتراضي)، أو ستُستبعد (False)، أو ستُستبدل بنقطة تحقق أخرى (pretrained=path/to/best.pt، وهي طريقة نقل الأوزان إلى بنيةmodel=*.yaml). تعرّف على المزيد في وثائق وضع التدريب.يشير عدد الحقب إلى مرات المرور الكاملة على مجموعة بيانات التدريب أثناء تدريب النموذج. وتُعد 300 حقبة نقطة بداية معتادة. إذا فرط نموذجك في التكيّف مبكرًا، يمكنك تقليل العدد. أما إذا لم يظهر فرط التكيّف، فيمكنك تمديد التدريب إلى 600 أو 1200 حقبة أو أكثر. لضبط ذلك في YOLO26، استخدم المعلمة
epochsفي برنامج التدريب النصي. لمزيد من الإرشادات حول تحديد العدد المثالي للحقب، راجع هذا القسم عن عدد الحقب.


التعليقات12
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.
puzzlemindgames
Hello
I'm working on a browser-based puzzle solver that uses a custom YOLO model to detect visible objects from game screenshots.
Some examples include: Transparent ice/frost overlays on the lower part of objects Semi-transparent cloth or curtain overlays Small decorative objects inside larger objects (for example, keys inside containers) The visible objects are usually detected correctly, but these overlays often cause false negatives or incorrect class predictions.
At the moment I'm considering a few approaches: Training with many more occlusion-heavy examples Splitting the detection into multiple stages instead of one larger model
python results = model.predict( source="level_512.png", conf=0.25, iou=0.45, imgsz=1280 ) for box in results[0].boxes: print(box.cls, box.conf)
For anyone who has trained YOLO models on UI or game screenshots which approach gave you the biggest improvement? Or is there another strategy that tends to work better for partially occluded objects?
I'd really appreciate hearing about real-world experiences before I spend time retraining the dataset.
 Glenn JocherUltralytics
Start with targeted data: add representative occluded examples, keep annotations consistent for partially visible objects, and synthetically composite the actual frost/cloth overlays at realistic opacity and placement. Measure recall per class on a dedicated occlusion-heavy validation split, then tune
mosaic,mixup, orcutmixconservatively; higherimgszor tiled inference can help nested small objects. A multi-stage pipeline is usually worthwhile only if the first stage can reliably isolate containers or overlay regions. Please continue sharing results and questions here so the Ultralytics team and community can see them.1Thanks! I followed your suggestions and added more occluded samples. The main objects/tubes are much more stable as well as the colors now but I'm still struggling with very small objects.
i cant able to attach model training screenshots here for you to review.
For example, tiny keys or tags inside transparent containers are often missed or detected as the wrong class. For context the screenshots come from a puzzle game with objects similar to these shown in sample pictures embedded at product homepage: https://aimagicsortsolver.com/
results = model.predict( source="level.png", imgsz=1280, conf=0.35, iou=0.45 ) Would you recommend keep improving a single model or train a second YOLO model just for these small objects?
- Glenn JocherUltralytics(تم التعديل)
Keep the single model first: audit tiny-object annotations, add more balanced close-up examples, and test cropped or SAHI tiled inference so keys and tags occupy more pixels; also compare
conf=0.15–0.25, since higher thresholds may suppress weak detections. Train a second specialized model only if the first model reliably detects each container, allowing its crop to be passed to the small-object model at higher effective resolution.1 Thank you for your suggestions. I'll tweak it as per the recommendations.
TSHSLU
What is the minimum Dataset Size required if i use a pretrained model for custom projects. i barely find any sources online which recommend a minimum dataset size.
- Glenn JocherUltralytics
There isn’t a fixed “minimum” dataset size when fine-tuning a pretrained model; if your domain is close to the pretrained data and labels are clean, you can often start getting useful signal with ~50–200 images per class (or a few hundred labeled object instances), but for reliably robust results across different lighting/viewpoints/backgrounds you’ll usually want 500–2000+ images per class with good diversity—one practical way to find your true minimum is to train on a small pilot subset, check validation failures, then add data specifically where the model breaks (the
fractionworkflow in the Model training tips guide helps iterate quickly).from ultralytics import YOLO model = YOLO("yolo26n.pt") model.train(data="data.yaml", epochs=100, fraction=0.1)1
VeeranjaneyuluToka
Hi, I just noticed a thing, looks like the optimizer is getting chosen based on no.of iterations, would you mind telling me the reason for the same? I mean how does iterations matter when we choose optimizer?
Imran-ml
First of all its great to have another powerful model and congratulations. I have fine tuned and trained yolo11x.pt for my custom objects but I'm facing some issues. My images data resolution is around 6000 x 2000 but while trained the model I set the imgsz=(1280, 640). It work well when I adjust the video stream by zoom in-out and detect all my 60 objects well (objects are small) but when there is some zoom or squeezed then it completely dont detect any object or few only.
Please let me know if I'm missing something or I have to do something else? I have labelled the data on my original images so resizing making any issues? any ratio issues? Please guide me properly so I can use this power yolo11 model effectively.
- Glenn JocherUltralytics
@Imran-ml it sounds like the issue might be related to image resizing affecting object detection. Consider enabling multiscale training by adjusting the
scaleparameter to help the model generalize better across different image sizes. This can improve detection performance when objects appear at varying scales. For more detailed guidance, you can refer to our model training tips at https://docs.ultralytics.com/guides/model-training-tips/.
Taufiq-Ahmed
Hi I have a question. I am using Yolov8s for trained a dataset that has four class. fire, smoke, person, animal. all the images has areal view to detect forest fire . In my dataset I have forest fire images from drone so after training it detect fire smoke quite accurately. however, I do not have any dataset that has person or animal in forest fire. so I have to collect some other dataset from roboflow that has person and animal and the n I have merged them with my own dataset ( have changed the label of animal and person accordingly so 0 means smoke, 1 means fire, 2 means person and 3 means animal and also updated the data.yaml file) . this time the problem is it could not detect the animal and person properly some times it can detect them. The main reasons seems to me is that the drone is flying in a high altitude so it does not detect person and animal properly because in the dataset of person and animal the view of the drone is not that much high. is there any technique to solve this problem and detect all the objects as many as possible?
- Glenn JocherUltralytics
@Taufiq-Ahmed it sounds like the altitude difference between your training and test datasets is causing the detection issues. To address this, consider using data augmentation techniques to simulate higher altitude views in your training data. You can also try multiscale training to help the model generalize better across different scales. Additionally, fine-tuning the model with a mix of high-altitude and low-altitude images might improve its performance. For more detailed strategies, you can refer to our model training tips.