نصائح لتحقيق أفضل نتائج التدريب باستخدام YOLOv5#
📚 يشرح هذا الدليل كيفية تحقيق أفضل mAP ونتائج تدريب باستخدام YOLOv5 🚀.
يمكن غالبًا الحصول على نتائج جيدة من دون إجراء تغييرات على النماذج أو إعدادات التدريب، شريطة أن تكون مجموعة البيانات كبيرة بما يكفي وموسومة جيدًا. إذا لم تحصل على نتائج جيدة من المحاولة الأولى، فقد تتمكن من تحسينها باتباع بعض الخطوات، لكننا نوصي دائمًا بأن يبدأ المستخدمون التدريب باستخدام جميع الإعدادات الافتراضية قبل التفكير في أي تغييرات. يساعد ذلك على تحديد خط أساس للأداء ورصد مجالات التحسين.
إذا كانت لديك أسئلة حول نتائج التدريب، فنوصي بتقديم أكبر قدر ممكن من المعلومات لتلقّي إجابة مفيدة، بما في ذلك مخططات النتائج (خسائر التدريب والتحقق، وP وR وmAP)، ومنحنى PR، ومصفوفة الالتباس، وصور الفسيفساء التدريبية، ونتائج الاختبار، وصور إحصاءات مجموعة البيانات مثل labels.png. توجد كل هذه الملفات في مجلد project/name، وعادةً في yolov5/runs/train/exp.
أعددنا أدناه دليلًا كاملًا للمستخدمين الراغبين في تحقيق أفضل النتائج عند تدريب YOLOv5.
مجموعة البيانات#
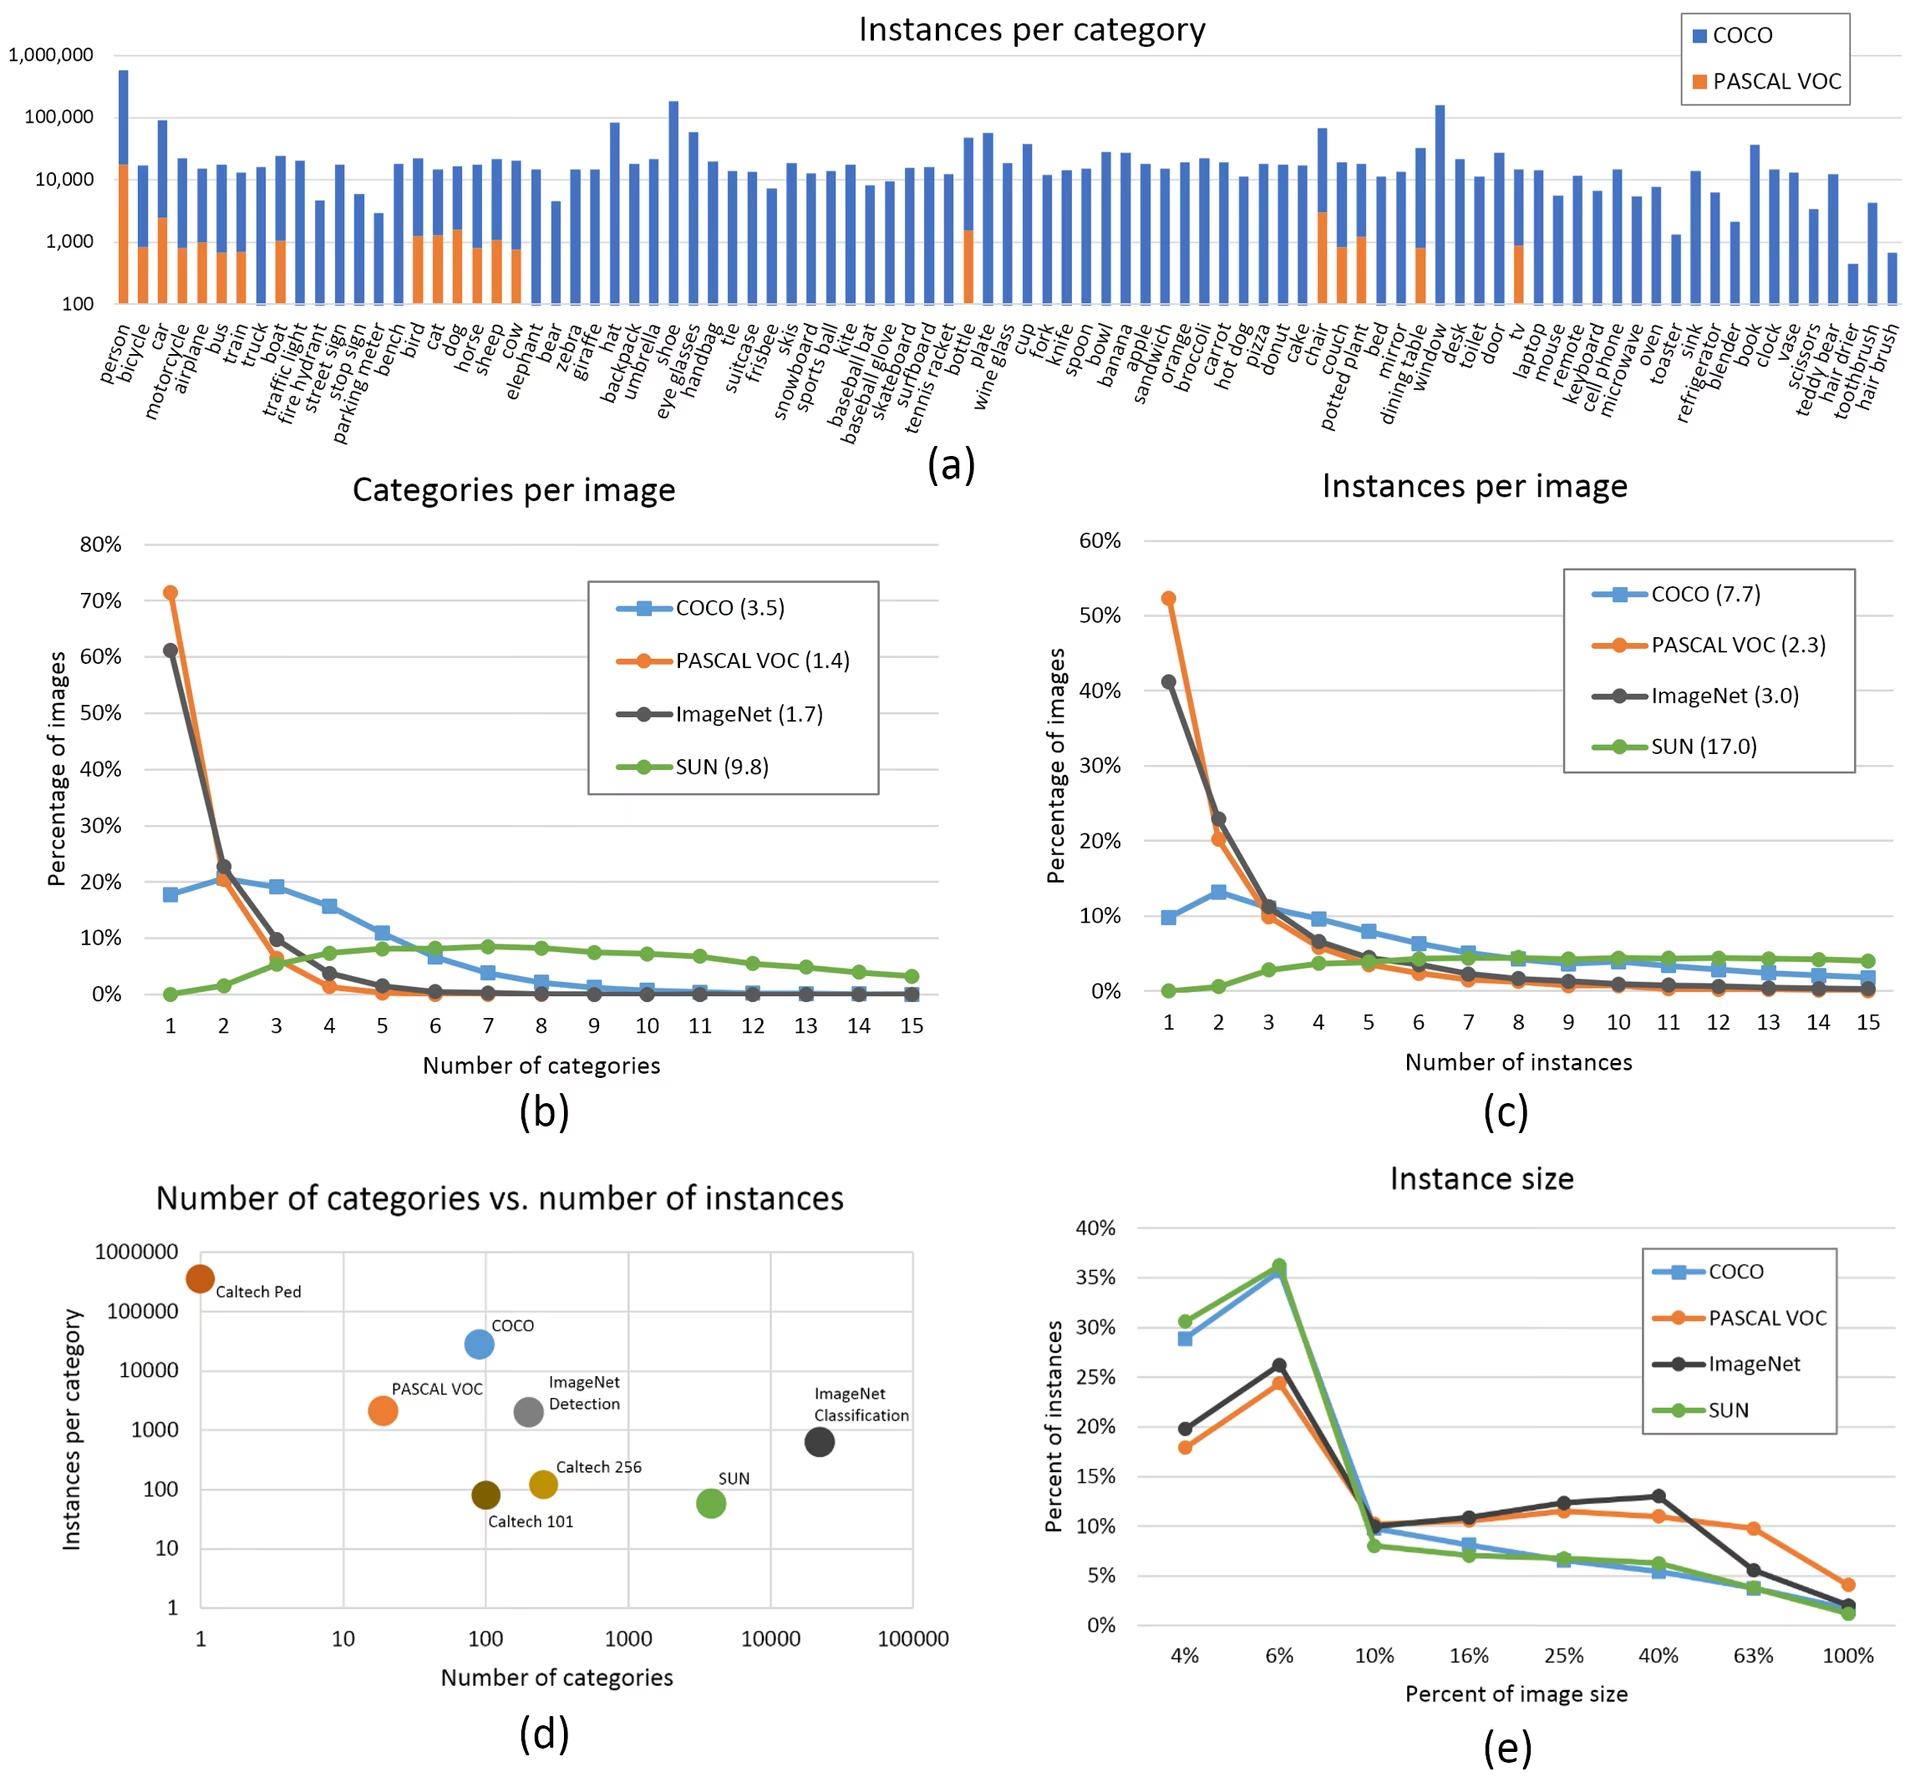
- الصور لكل فئة. يُوصى باستخدام ≥ 1500 صورة لكل فئة
- العينات لكل فئة. يُوصى باستخدام ≥ 10000 عينة (كائنات موسومة) لكل فئة
- تنوع الصور. يجب أن تمثل الصور بيئة النشر. ونوصي، لحالات الاستخدام الواقعية، بصور ملتقطة في أوقات مختلفة من اليوم وفصول مختلفة وأحوال جوية مختلفة وظروف إضاءة مختلفة وزوايا مختلفة ومصادر مختلفة (مجمّعة من الإنترنت، أو محلية، أو ملتقطة بكاميرات مختلفة)، إلخ.
- اتساق التسميات. يجب تسمية جميع عينات الفئات كافةً في جميع الصور. لن تنجح عملية وضع التسميات جزئيًا.
- دقة التسميات. يجب أن تحدد التسميات كل كائن بدقة. يجب ألا توجد مسافة بين الكائن ومربع الإحاطة الخاص به. يجب ألا يُترك أي كائن دون تسمية.
- الالتزام بتقسيمات التدريب والتحقق. تأكد من عدم ظهور صور التحقق والاختبار مطلقًا في مجموعة التدريب، لتجنب مقاييس متفائلة أكثر من اللازم. وحافظ على تقارب توزيعات الفئات بين التقسيمات.
- التحقق من التسميات. اعرض
train_batch*.jpgعند بدء التدريب للتحقق من صحة ظهور التسميات، أي اعرض فسيفساء مثال. - صور الخلفية. صور الخلفية هي صور لا تحتوي على كائنات، وتُضاف إلى مجموعة البيانات للحد من الإيجابيات الكاذبة (FP). نوصي بأن تشكّل صور الخلفية نحو 0-10% للمساعدة في الحد من الإيجابيات الكاذبة (تضم COCO عدد 1000 صورة خلفية مرجعية، أي 1% من الإجمالي). لا يلزم وضع تسميات لصور الخلفية.
اختيار النموذج#
تقدم النماذج الأكبر مثل YOLOv5x وYOLOv5x6 نتائج أفضل في جميع الحالات تقريبًا، لكنها تضم معلمات أكثر، وتتطلب ذاكرة CUDA أكبر للتدريب، ويكون تشغيلها أبطأ. نوصي باستخدام YOLOv5s/m لعمليات النشر على الأجهزة المحمولة، وYOLOv5l/x لعمليات النشر السحابية. راجع جدول ملف README للمقارنة الكاملة بين جميع النماذج.

-
ابدأ بأوزان مدرّبة مسبقًا. يُوصى بذلك لمجموعات البيانات الصغيرة إلى المتوسطة (مثل VOC وVisDrone وGlobalWheat). مرّر اسم النموذج إلى الوسيط
--weights. تُنزّل النماذج تلقائيًا من أحدث إصدار من YOLOv5.python train.py --data custom.yaml --weights yolov5s.pt python train.py --data custom.yaml --weights yolov5m.pt python train.py --data custom.yaml --weights yolov5l.pt python train.py --data custom.yaml --weights yolov5x.pt python train.py --data custom.yaml --weights custom_pretrained.pt -
ابدأ من الصفر. يُوصى بذلك لمجموعات البيانات الكبيرة (مثل COCO وObjects365 وOIv6). مرّر ملف YAML الخاص ببنية النموذج الذي تريده، إلى جانب وسيط
--weights ''فارغ:python train.py --data custom.yaml --weights '' --cfg yolov5s.yaml python train.py --data custom.yaml --weights '' --cfg yolov5m.yaml python train.py --data custom.yaml --weights '' --cfg yolov5l.yaml python train.py --data custom.yaml --weights '' --cfg yolov5x.yaml
إعدادات التدريب#
قبل تعديل أي شيء، ابدأ التدريب أولًا بالإعدادات الافتراضية لتحديد خط أساس للأداء. يمكنك العثور على القائمة الكاملة لإعدادات train.py في محلل الوسائط train.py.
- الحِقَب. ابدأ بـ 300 حقبة. إذا حدث فرط التكيّف مبكرًا، يمكنك تقليل عدد الحِقَب. إذا لم يحدث فرط التكيّف بعد 300 حقبة، فأطل التدريب، مثلًا إلى 600 أو 1200 حقبة، إلخ.
- حجم الصورة. يُدرّب COCO بالدقة الأصلية
--img 640، لكن نظرًا إلى كثرة الكائنات الصغيرة في مجموعة البيانات، قد يستفيد التدريب من دقات أعلى مثل--img 1280. إذا كانت هناك كائنات صغيرة كثيرة، فستستفيد مجموعات البيانات المخصصة من التدريب بالدقة الأصلية أو بدقة أعلى. تتحقق أفضل نتائج الاستدلال عند استخدام--imgنفسها التي استُخدمت في التدريب؛ أي إذا درّبت باستخدام--img 1280، فعليك أيضًا الاختبار والكشف باستخدام--img 1280. - حجم الدفعة. استخدم أكبر قيمة
--batch-sizeتسمح بها أجهزتك. تؤدي أحجام الدفعات الصغيرة إلى إحصاءات ضعيفة لـتطبيع الدفعة، لذا ينبغي تجنبها. يمكنك استخدام--batch-size -1لتحديد حجم الدفعة الأمثل لوحدة GPU تلقائيًا. - معدل التعلّم. يعمل جدول معدل التعلّم الافتراضي جيدًا في معظم الحالات. لتسريع التقارب، يمكنك تجربة استخدام الخيار
--cos-lrلتفعيل جدولة معدل التعلّم وفق منحنى جيب التمام، إذ يخفض معدل التعلّم تدريجيًا وفق منحنى جيب التمام على امتداد الحِقَب. - زيادة البيانات. يتضمن YOLOv5 تقنيات متنوعة لزيادة البيانات، مثل الفسيفساء التي تجمع صور تدريب متعددة. اضبط قوة زيادة البيانات باستخدام المعامل الفائق
mosaicفي ملف--hypللمساعدة على استقرار التدريب. - المعاملات الفائقة. توجد المعاملات الفائقة الافتراضية في hyp.scratch-low.yaml. نوصي بالتدريب أولًا باستخدام المعاملات الفائقة الافتراضية قبل التفكير في تعديل أي منها. عمومًا، يؤدي رفع قيم معاملات زيادة البيانات الفائقة إلى الحد من فرط التكيّف وتأخيره، ما يسمح بإطالة التدريب وتحقيق mAP نهائي أعلى. ويساعد خفض معاملات كسب مكونات الخسارة الفائقة، مثل
hyp['obj']، على الحد من فرط التكيّف في مكونات الخسارة المحددة تلك. للاطلاع على طريقة مؤتمتة لتحسين هذه المعاملات الفائقة، راجع الدليل التعليمي للتطور بالمعاملات الفائقة. - التدريب بـالدقة المختلطة. يفعّل YOLOv5 تلقائيًا الدقة المختلطة التلقائية (AMP) عند اكتشاف وحدة GPU مدعومة، ما يسرّع التدريب ويقلل استهلاك الذاكرة من دون التضحية بدقة النموذج.
- التدريب باستخدام وحدات GPU متعددة. إذا كانت لديك وحدات GPU متعددة، فاستخدم
--device 0,1,2,3لتوزيع التدريب عليها، ما قد يقلل مدة التدريب بدرجة كبيرة. - الإيقاف المبكر. استخدم
--patience 50لإيقاف التدريب إذا لم تتحسن مقاييس التحقق خلال 50 حقبة، توفيرًا للوقت ومنعًا لفرط التكيّف.
تقنيات التحسين المتقدمة#
- التعلّم بالنقل. في مجموعات البيانات المتخصصة، ابدأ بأوزان مدرّبة مسبقًا، ويمكنك اختياريًا تجميد الطبقات باستخدام
--freezeلتهيئة النموذج لمهمتك المحددة. - تقليص النموذج. بعد التدريب، فكّر في تقليص النموذج لإزالة الأوزان الزائدة وتقليل حجمه دون خسارة كبيرة في الأداء.
- تجميع النماذج. في التطبيقات الحساسة، درّب نماذج متعددة بإعدادات مختلفة واجمع تنبؤاتها لتحسين الدقة.
- زيادة البيانات أثناء الاختبار. فعّل TTA أثناء الاستدلال باستخدام
--augmentلتحسين دقة التنبؤ من خلال حساب متوسط النتائج المستخلصة من نسخ معززة من صورة الإدخال.
قراءات إضافية#
إذا أردت معرفة المزيد، فبداية جيدة هي مقالة Karpathy «وصفة تدريب الشبكات العصبية»، التي تتضمن أفكارًا رائعة للتدريب تنطبق على نطاق واسع في جميع مجالات تعلّم الآلة: https://karpathy.github.io/2019/04/25/recipe/
حظًا موفقًا 🍀، وأخبرنا إن كانت لديك أي أسئلة أخرى!
الأسئلة الشائعة#
قد يعاني نموذجك من فرط التكيّف إذا استمرت خسارة التدريب في الانخفاض بينما بدأت خسارة التحقق في الارتفاع. راقب mAP الخاص بالتحقق؛ فإذا استقر أو انخفض بينما واصلت خسارة التدريب التحسن، فهذه علامة على فرط التكيّف. تشمل الحلول إضافة مزيد من بيانات التدريب، وزيادة تعزيز البيانات، أو تطبيق تقنيات التنظيم.
يعتمد حجم الدفعة الأمثل على سعة ذاكرة GPU لديك. توفر أحجام الدفعات الأكبر عمومًا إحصاءات أفضل لتطبيع الدفعة واستقرارًا أكبر للتدريب. استخدم أكبر حجم دفعة تستطيع أجهزتك معالجته من دون نفاد الذاكرة. يمكنك استخدام
--batch-size -1لتحديد حجم الدفعة الأمثل لإعداداتك تلقائيًا.لتسريع التدريب، جرّب استخدام وحدات GPU متعددة مع
--device 0,1,2,3، وتخزين مجموعة البيانات مؤقتًا باستخدام--cache، وتحسين حجم الدفعة (تُفعّل الدقة المختلطة تلقائيًا على وحدات GPU المدعومة). فكّر أيضًا في استخدام إصدار أصغر من النموذج مثل YOLOv5s إذا لم تكن الدقة القصوى ضرورية.