تطوّر المعلمات الفائقة في YOLOv5#
📚 يشرح هذا الدليل تطوّر المعلمات الفائقة في YOLOv5 🚀. وتطوّر المعلمات الفائقة أسلوبٌ لتحسين المعلمات الفائقة باستخدام خوارزمية جينية (GA).
تتحكم المعلمات الفائقة في تعلّم الآلة في جوانب مختلفة من التدريب، وقد يكون العثور على القيم المثلى لها تحديًا. إذ قد تصبح الطرق التقليدية، مثل البحث الشبكي، غير عملية سريعًا بسبب:
- اتساع فضاء البحث عالي الأبعاد
- عدم معرفة الارتباطات بين الأبعاد
- ارتفاع تكلفة تقييم الملاءمة عند كل نقطة
وهذا ما يجعل الخوارزميات الجينية خيارًا مناسبًا للبحث عن المعلمات الفائقة.
قبل البدء#
استنسخ المستودع وثبّت requirements.txt في بيئة Python>=3.8.0، بما في ذلك PyTorch>=1.8. تُنزّل النماذج ومجموعات البيانات تلقائيًا من إصدار YOLOv5 الأحدث.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
1. تهيئة المعلمات الفائقة#
يحتوي YOLOv5 على نحو 30 معلمة فائقة تُستخدم لإعدادات تدريب متنوعة. وهي محددة في ملفات *.yaml ضمن الدليل /data/hyps. تؤدي التخمينات الأولية الأفضل إلى نتائج نهائية أفضل، لذا من المهم تهيئة هذه القيم على نحو صحيح قبل تطويرها. وإذا لم تكن متأكدًا، فاستخدم القيم الافتراضية، إذ جرى تحسينها لتدريب YOLOv5 على COCO من الصفر.
# YOLOv5 🚀 by Ultralytics, AGPL-3.0 license
# Hyperparameters for low-augmentation COCO training from scratch
# python train.py --batch 64 --cfg yolov5n6.yaml --weights '' --data coco.yaml --img 640 --epochs 300 --linear
# See tutorials for hyperparameter evolution https://github.com/ultralytics/yolov5#tutorials

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.01 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
2. تعريف دالة الملاءمة#
الملاءمة هي القيمة التي نسعى إلى تعظيمها. نعرّف في YOLOv5 دالة ملاءمة افتراضية بوصفها مزيجًا موزونًا من المقاييس: تسهم mAP@0.5 بنسبة 10% من الوزن، بينما تسهم mAP@0.5:0.95 بنسبة 90% المتبقية، مع استبعاد الدقة الإحكامية (P) والاستدعاء (R). يمكنك تعديل هذه الأوزان كما تراه مناسبًا، أو استخدام تعريف الملاءمة الافتراضي في utils/metrics.py (موصى به). تحدد هذه الملاءمة النتيجة التي تُحفَظ في hyp_evolve.yaml؛ أما الخوارزمية الجينية نفسها فترتّب الآباء والنخبة استنادًا إلى mAP@0.5 وحده، لذا لا يغيّر تعديل هذه الأوزان اختيار الآباء.
def fitness(x):
"""Return model fitness as the sum of weighted metrics [P, R, mAP@0.5, mAP@0.5:0.95]."""
w = [0.0, 0.0, 0.1, 0.9] # الأوزان لـ [P, R, mAP@0.5, mAP@0.5:0.95]
return (x[:, :4] * w).sum(1)3. التطوير#
يُجرى التطوير انطلاقًا من سيناريو أساسي نسعى إلى تحسينه. في هذا المثال، يتمثل السيناريو الأساسي في الضبط الدقيق لمجموعة COCO128 لمدة 10 حقب باستخدام YOLOv5s مدرّب مسبقًا. أمر تدريب السيناريو الأساسي هو:
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cacheلتطوير المعلمات الفائقة المخصصة لهذا السيناريو، بدءًا من القيم الأولية المحددة في القسم 1.، وتعظيم قيمة الملاءمة المحددة في القسم 2.، أضف --evolve:
# Single-GPU
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --evolve

# Multi-GPU with delay
for i in {0..7}; do
  sleep $((30 * i)) # 30-second delay (optional)
  echo "Starting GPU $i..."
  nohup python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log" &
done

# Continuous training (use with caution)
# for i in {0..7}; do
#   sleep $((30 * i))  # 30-second delay (optional)
#   echo "Starting continuous training on GPU $i..."
#   (
#     while true; do
#       python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log"
#     done
#   ) &
# done
تُشغّل إعدادات التطوير الافتراضية 300 جيل، ويدرّب كل جيل السيناريو الأساسي مرة واحدة لكل فرد من الأفراد الخمسين في المجموعة. يمكنك تعديل عدد الأجيال باستخدام الوسيطة --evolve، مثلًا python train.py --evolve 1000.
المشغّلان الوراثيان الرئيسيان هما التقاطع والطفرة. يدرّب كل جيل كل فرد ويقيّمه وفقًا لـ mAP@0.5، ويختار الآباء باستخدام الانتقاء بالبطولات مع إضافة أفضل الأفراد إلى مجموعة الآباء، ثم ينشئ المجموعة التالية عبر التقاطع والطفرة، بمعدلات تتكيف مع تقدم عملية التطوير. تُسجّل النتائج في runs/evolve/exp/evolve.csv، ويُحفظ النسل صاحب أعلى قيمة ملاءمة في كل جيل باسم runs/evolve/exp/hyp_evolve.yaml:
# YOLOv5 Hyperparameter Evolution Results
# Best generation: 287
# Last generation: 300
#    metrics/precision,       metrics/recall,      metrics/mAP_0.5, metrics/mAP_0.5:0.95,         val/box_loss,         val/obj_loss,         val/cls_loss
#              0.54634,              0.55625,              0.58201,              0.33665,             0.056451,             0.042892,             0.013441

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.2 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
نوصي بما لا يقل عن 300 جيل من التطوير للحصول على أفضل النتائج. تجدر الإشارة إلى أن التطوير مكلف عمومًا ويستغرق وقتًا طويلًا، إذ يُدرّب السيناريو الأساسي آلاف المرات، وقد يتطلب ذلك مئات أو آلاف الساعات من استخدام GPU.
عند انتهاء التطوير، أعد استخدام الإعدادات المكتشفة بتوجيه التدريب إلى الملف المحفوظ، مثلًا python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.
4. التصور#
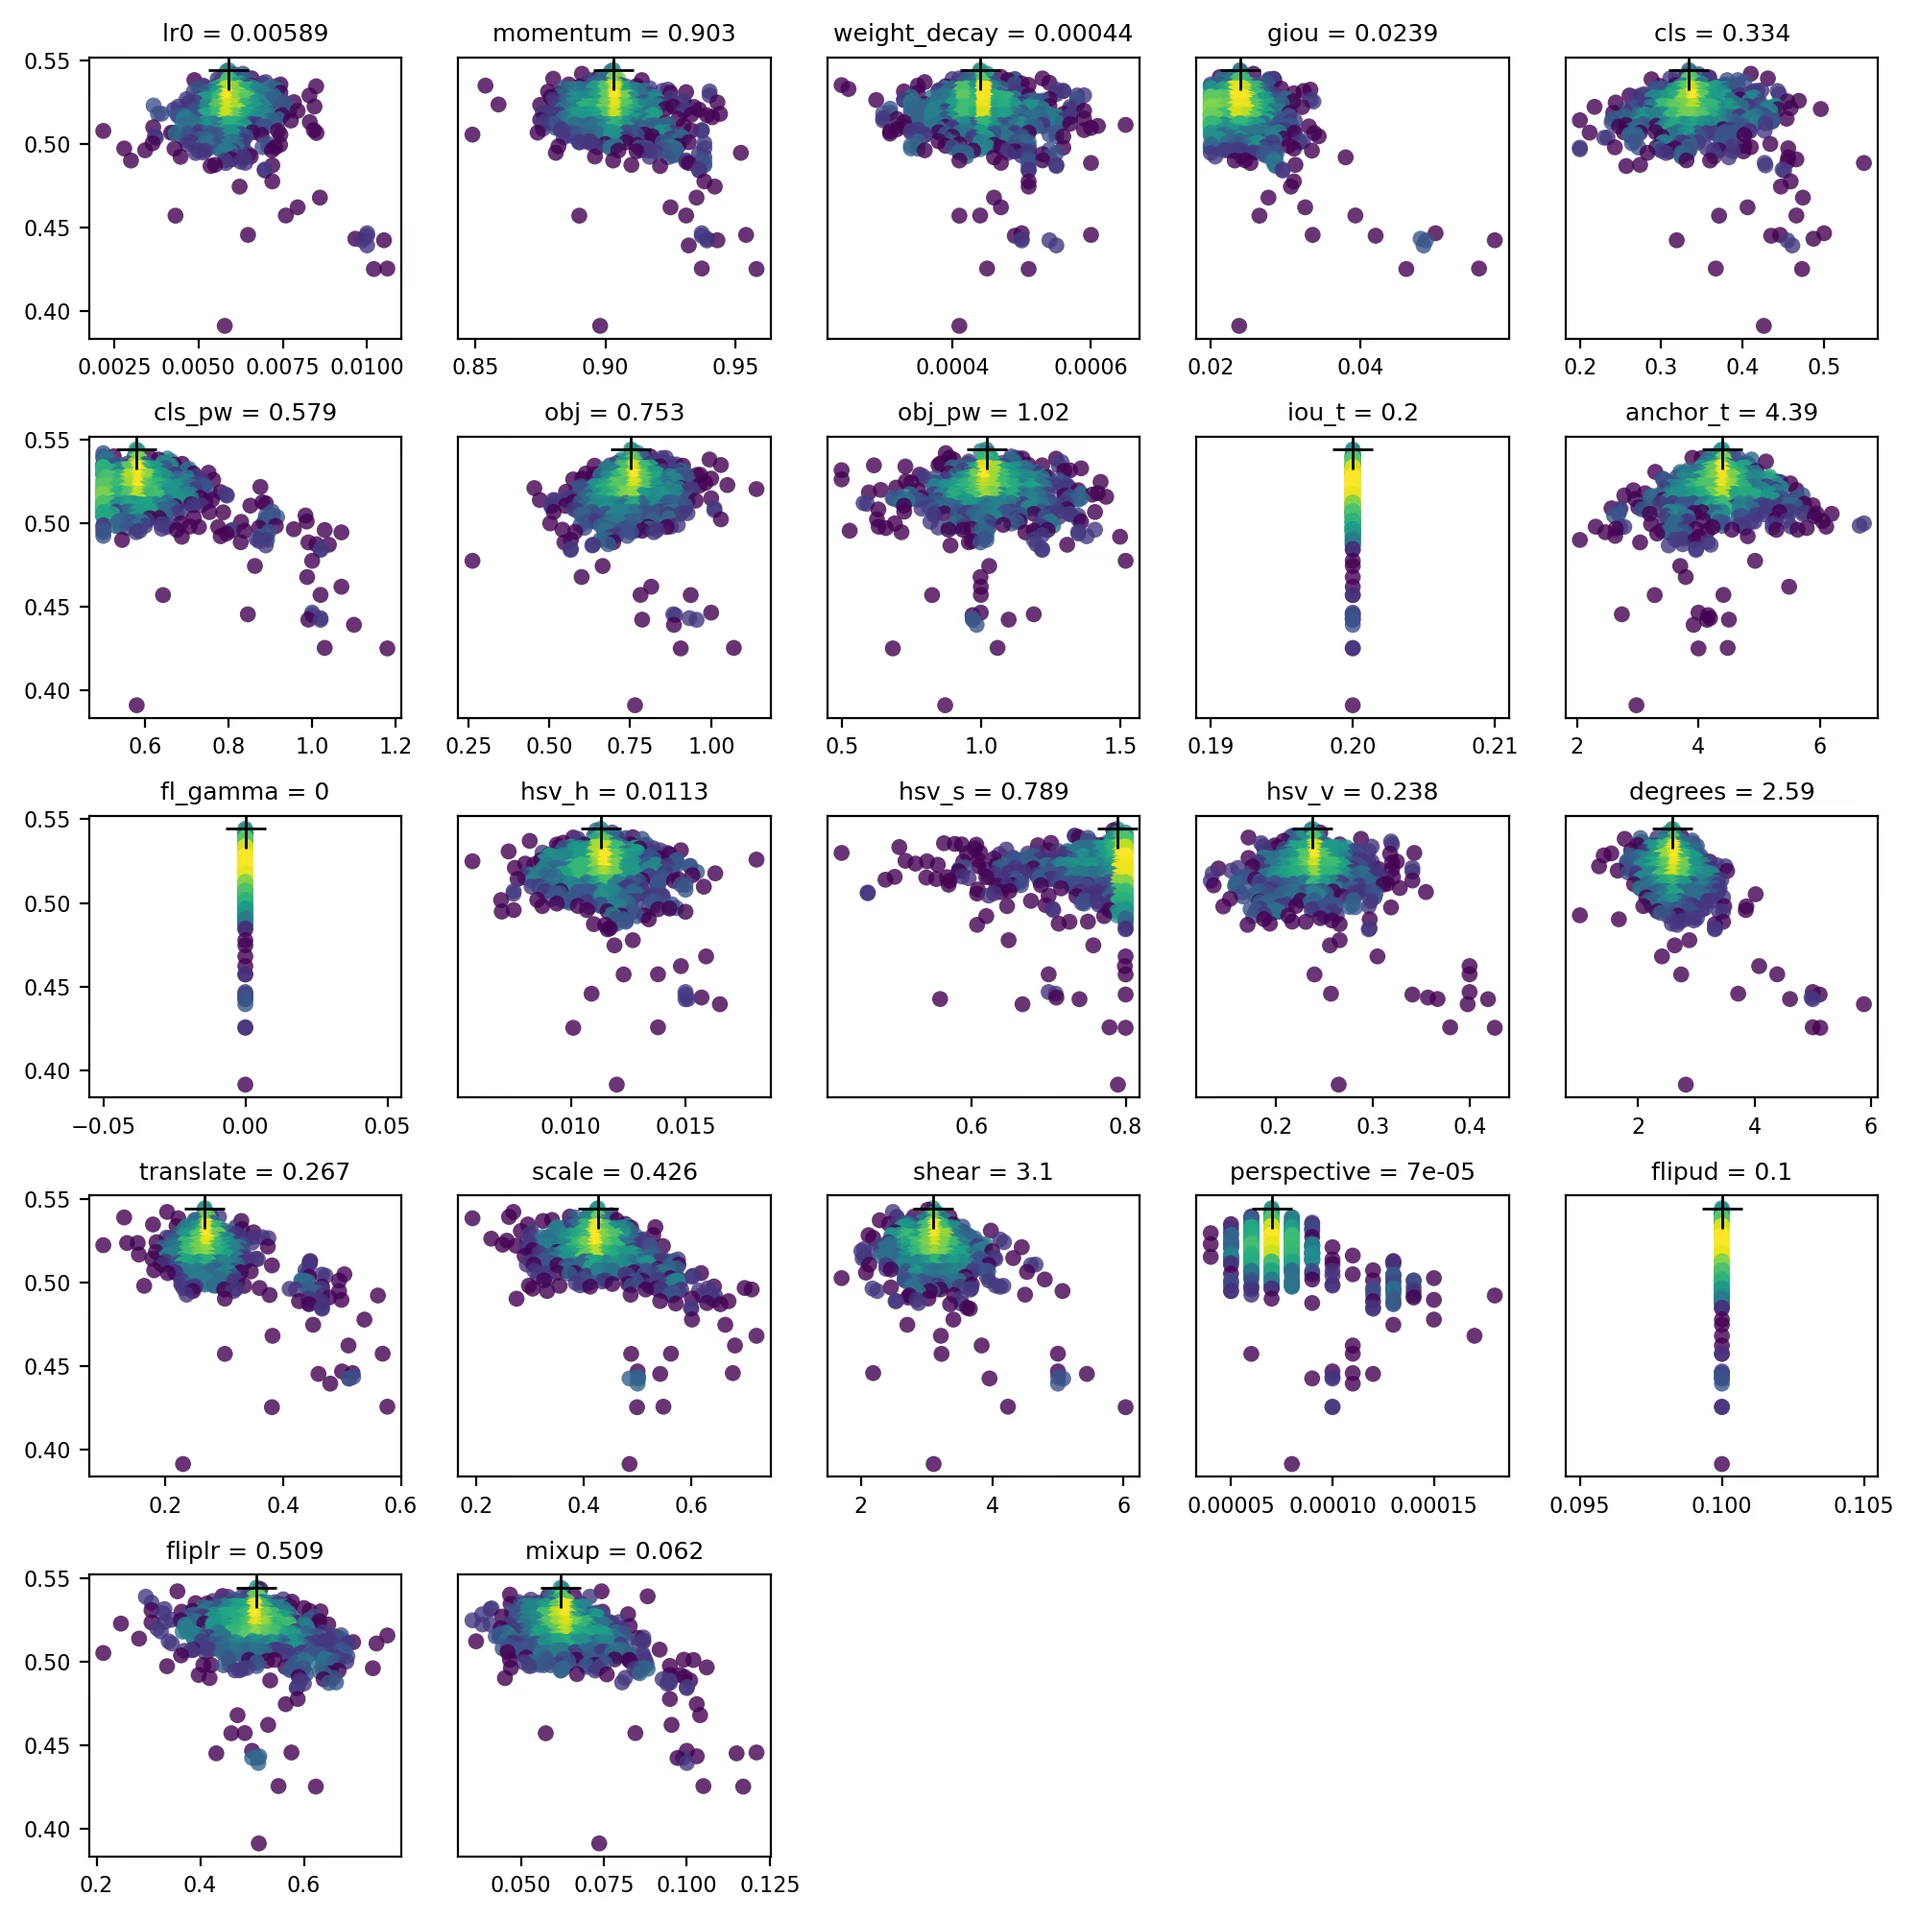
يُرسم evolve.csv على هيئة evolve.png بواسطة utils.plots.plot_evolve() بعد انتهاء التطوير، مع مخطط فرعي لكل معلمة فائقة يعرض الملاءمة (المحور y) مقابل قيم المعلمة الفائقة (المحور x). يشير اللون الأصفر إلى تركيزات أعلى. وتشير التوزيعات العمودية إلى تعطيل معلمة وعدم حدوث طفرات فيها. ويمكن للمستخدم تحديد ذلك في القاموس meta في train.py، ويُفيد هذا الخيار في تثبيت المعلمات ومنع تطورها.
البيئات المدعومة#
توفر Ultralytics مجموعة من البيئات الجاهزة للاستخدام، وكل منها مثبت مسبقًا به التبعيات الأساسية مثل CUDA وCUDNN وPython وPyTorch، لتتمكن من بدء مشاريعك.
- دفاتر GPU مجانية:


- Google Cloud: دليل البدء السريع لـ GCP
- Amazon: دليل البدء السريع لـ AWS
- Azure: دليل البدء السريع لـ AzureML
- Docker: دليل البدء السريع لـ Docker

حالة المشروع#

تشير هذه الشارة إلى اجتياز جميع اختبارات التكامل المستمر (CI) الخاصة بـ إجراءات YOLOv5 على GitHub بنجاح. وتتحقق اختبارات CI بدقة من وظائف YOLOv5 وأدائه في جوانب رئيسية متعددة: التدريب والتحقق والاستدلال والتصدير واختبارات الأداء. وهي تضمن التشغيل المتسق والموثوق على macOS وWindows وUbuntu، مع إجراء الاختبارات كل 24 ساعة وعند كل إيداع جديد.
الأسئلة الشائعة#
يدرّب كل جيل السيناريو الأساسي مرة واحدة لكل فرد في المجموعة المكوّنة من 50 فردًا، لذا فإن 300 جيل لتشغيل COCO128 مدته 10 حقب تكلّف نحو 15,000 ضعف تكلفة تشغيل واحد من هذا النوع. اجعل السيناريو الأساسي قصيرًا وممثلًا. تبدأ الحلقة متعددة GPU الموضحة أعلاه عملية بحث مستقلة على كل GPU بدلًا من مشاركة عملية بحث واحدة، لذا خفّض قيمة
--evolveلكل عملية إذا كنت تعمل ضمن ميزانية ثابتة.نعم. القيمة الافتراضية للوسيطة
--evolveهي 300 جيل؛ مرّر عددًا مثل--evolve 1000لتشغيل عدد أكبر.اضبط القيمة الأولى في مدخلها ضمن القاموس
metaفيtrain.pyعلىFalse. تحتفظ المعلمات المستثناة بقيمتها الأولية وتظهر كخطوط عمودية فيevolve.png.مرّر الملف المحفوظ إلى تشغيل تدريب عادي:
python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.