مجموعة بيانات COCO#
مجموعة بيانات COCO (الأجسام الشائعة في السياق) هي مجموعة بيانات واسعة النطاق لكشف الأجسام وتقسيمها وإنشاء التسميات التوضيحية. صُممت لتشجيع الأبحاث حول مجموعة واسعة من فئات الأجسام، وتُستخدم عادةً لقياس أداء نماذج الرؤية الحاسوبية. وهي مجموعة بيانات أساسية للباحثين والمطورين الذين يعملون على مهام كشف الأجسام وتقسيمها وتقدير الوضعيات.
Watch: Ultralytics COCO Dataset Overview
النماذج المدرَّبة مسبقًا على COCO#
| النموذج | الحجم (بكسل) | mAPval 50-95 | mAPval 50-95(e2e) | السرعة CPU ONNX (مللي ثانية) | السرعة T4 TensorRT10 (مللي ثانية) | المعاملات (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|
| YOLO26n | 640 | 40.9 | 40.1 | 38.9 ± 0.7 | 1.7 ± 0.0 | 2.4 | 5.5 |
| YOLO26s | 640 | 48.6 | 47.8 | 87.2 ± 0.9 | 2.5 ± 0.0 | 9.5 | 20.9 |
| YOLO26m | 640 | 53.1 | 52.5 | 220.0 ± 1.4 | 4.7 ± 0.1 | 20.4 | 68.4 |
| YOLO26l | 640 | 55.0 | 54.4 | 286.2 ± 2.0 | 6.2 ± 0.2 | 24.8 | 86.8 |
| YOLO26x | 640 | 57.5 | 56.9 | 525.8 ± 4.0 | 11.8 ± 0.2 | 55.7 | 194.4 |
الميزات الرئيسية#
- تحتوي COCO على 330 ألف صورة، منها 200 ألف صورة تتضمن تعليقات توضيحية لمهام كشف الأجسام وتقسيمها وإنشاء التسميات التوضيحية.
- تتألف مجموعة البيانات من 80 فئة من الأجسام، تشمل أجسامًا شائعة مثل السيارات والدراجات والحيوانات، إضافةً إلى فئات أكثر تحديدًا مثل المظلات وحقائب اليد والمعدات الرياضية.
- تشمل التعليقات التوضيحية مربعات الإحاطة بالأجسام وأقنعة التقسيم والتسميات التوضيحية لكل صورة.
- توفر COCO مقاييس تقييم موحّدة مثل متوسط الدقة (mAP) لكشف الأجسام، ومتوسط الاستدعاء (mAR) لمهام التقسيم، مما يجعلها مناسبة لمقارنة أداء النماذج.
بنية مجموعة البيانات#
تنقسم مجموعة بيانات COCO إلى ثلاث مجموعات فرعية:
- Train2017: 118,287 صورة لتدريب نماذج كشف الأجسام وتقسيمها وإنشاء التسميات التوضيحية.
- Val2017: 5,000 صورة تُستخدم للتحقق أثناء تدريب النموذج.
- Test2017: 20,288 صورة test-dev تُستخدم لقياس أداء النماذج المدرَّبة. لا تتوفر التعليقات التوضيحية للحقيقة الأساسية لهذه المجموعة الفرعية للعامة، وتُرسل النتائج إلى خادم تقييم COCO لتقييم الأداء.
التطبيقات#
تُستخدم مجموعة بيانات COCO على نطاق واسع لتدريب نماذج التعلم العميق وتقييمها في كشف الأجسام (مثل Ultralytics YOLO وFaster R-CNN وSSD)، وتقسيم المثيلات (مثل Mask R-CNN)، وكشف النقاط المفتاحية (مثل OpenPose). وتجعل مجموعة فئات الأجسام المتنوعة في مجموعة البيانات، والعدد الكبير من الصور المشروحة، ومقاييس التقييم الموحّدة منها موردًا أساسيًا لباحثي الرؤية الحاسوبية والممارسين فيها.
تتبع التعليقات التوضيحية المُصدَّرة من أدوات وضع التسميات في COCO JSON البنية نفسها. لتدريب نموذج على بياناتك الخاصة بتنسيق COCO، راجع تحويل تعليقات COCO التوضيحية إلى YOLO.
YAML مجموعة البيانات#
يُستخدم ملف YAML لتعريف إعدادات مجموعة البيانات. ويحتوي على معلومات حول مسارات مجموعة البيانات وفئاتها وغيرها من المعلومات ذات الصلة. في حالة مجموعة بيانات COCO، يُدار الملف coco.yaml في https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO 2017 dataset https://cocodataset.org by Microsoft
# Documentation: https://docs.ultralytics.com/datasets/detect/coco
# Example usage: yolo train data=coco.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco ← downloads here (20.3 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco # dataset root dir
train: train2017.txt # train images (relative to 'path') 118287 images
val: val2017.txt # val images (relative to 'path') 5000 images
test: test-dev2017.txt # 20288 of 40670 images, submit via https://cocodataset.org/#detection-eval

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: |
  from pathlib import Path

  from ultralytics.utils import ASSETS_URL
  from ultralytics.utils.downloads import download

  # Download labels
  segments = True  # segment or box labels
  dir = Path(yaml["path"])  # dataset root dir
  urls = [ASSETS_URL + ("/coco2017labels-segments.zip" if segments else "/coco2017labels.zip")]  # labels
  download(urls, dir=dir.parent)

  # Download data (test2017.zip excluded: ground truth is withheld, only used for the eval-server test-dev split)
  urls = [
      "http://images.cocodataset.org/zips/train2017.zip",  # 19G, 118k images
      "http://images.cocodataset.org/zips/val2017.zip",  # 1G, 5k images
  ]
download(urls, dir=dir / "images", threads=3)الاستخدام#
تُنزَّل بيانات التدريب والتحقق COCO2017 (بحجم 20.3 جيجابايت) تلقائيًا عند بدء التدريب للمرة الأولى. لتدريب نموذج YOLO26n على COCO لمدة 100 حقبة وبحجم صورة قدره 640، يمكنك استخدام مقتطفات الشيفرة التالية. للحصول على قائمة شاملة بالوسائط المتاحة، راجع صفحة التدريب الخاصة بالنموذج. يمكنك أيضًا تشغيل تدريب COCO سحابيًا باستخدام Ultralytics Platform.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="coco.yaml", epochs=100, imgsz=640)
الصور والتعليقات التوضيحية النموذجية#
تحتوي مجموعة بيانات COCO على مجموعة متنوعة من الصور التي تضم فئات مختلفة من الأجسام ومشاهد معقدة. فيما يلي بعض أمثلة الصور من مجموعة البيانات، إلى جانب التعليقات التوضيحية المقابلة لها:
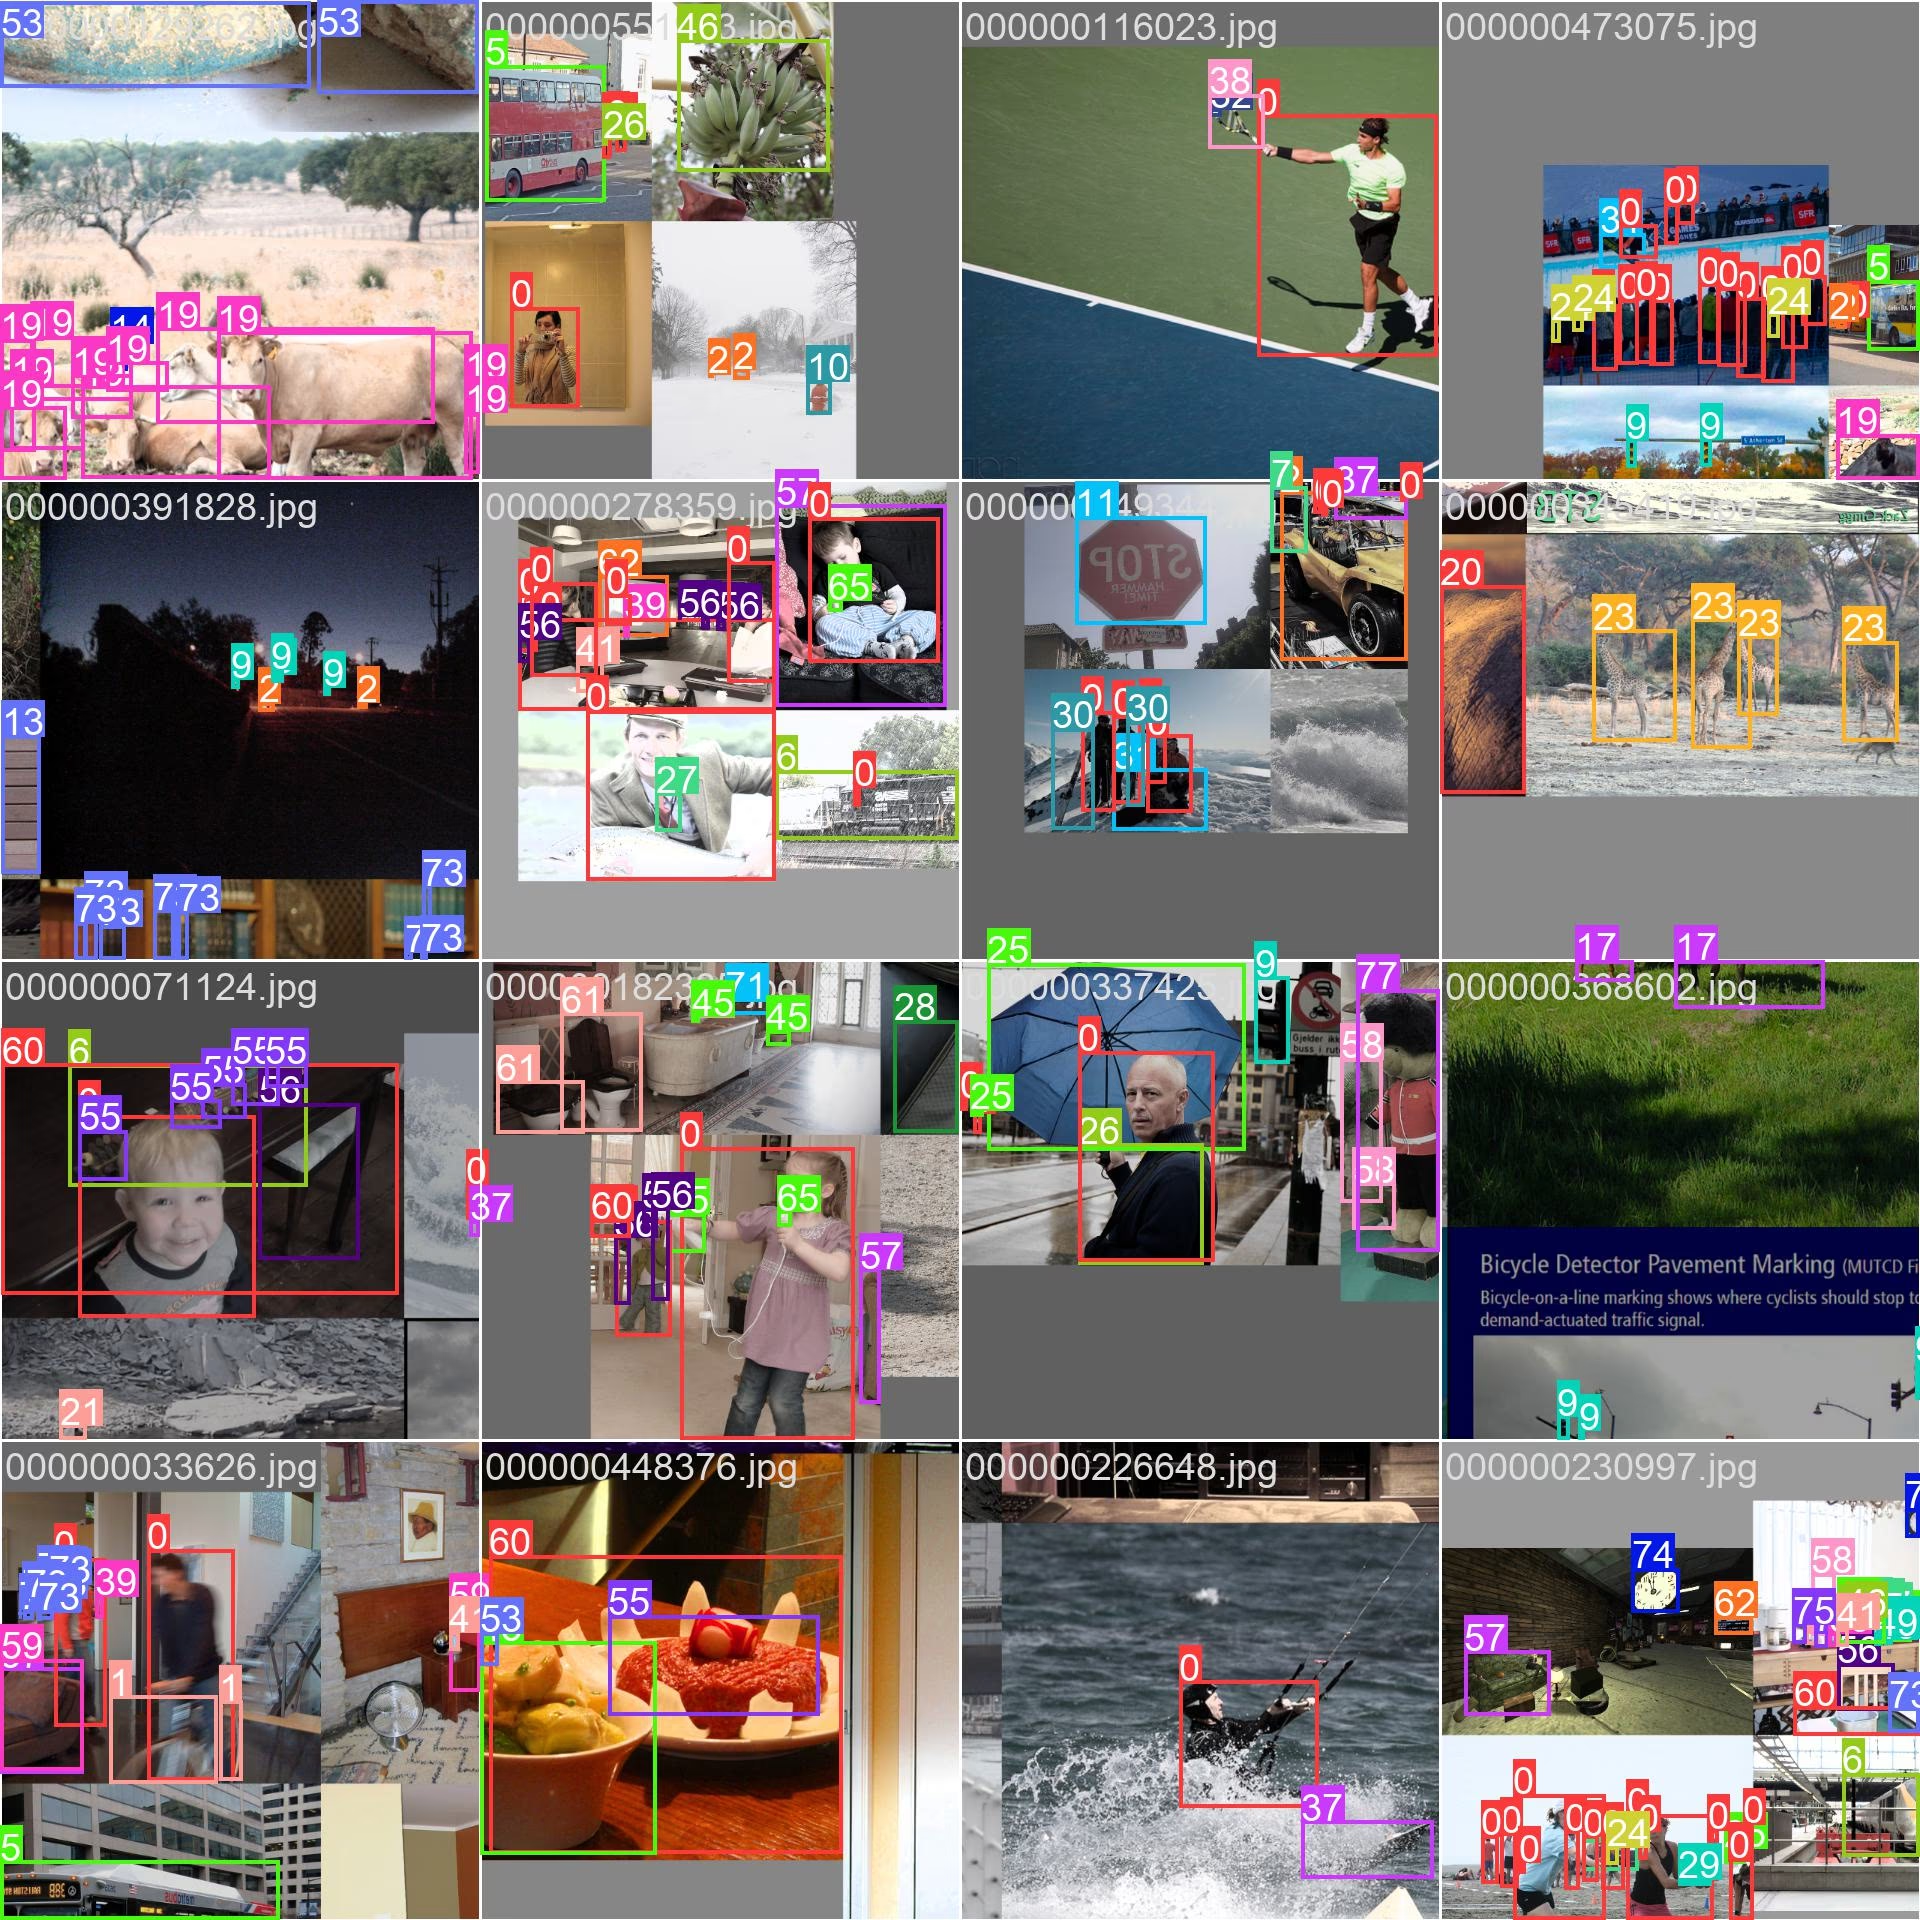
- الصورة الموزاييكية: توضح هذه الصورة دفعة تدريب مكوّنة من صور موزاييكية من مجموعة البيانات. والموزاييك تقنية تُستخدم أثناء التدريب وتجمع صورًا متعددة في صورة واحدة لزيادة تنوع الأجسام والمشاهد ضمن كل دفعة تدريب. ويساعد ذلك على تحسين قدرة النموذج على التعميم على أحجام الأجسام ونِسَب العرض إلى الارتفاع والسياقات المختلفة.
يوضح المثال تنوع الصور وتعقيدها في مجموعة بيانات COCO، وفوائد استخدام الموزاييك أثناء عملية التدريب.
الاقتباسات والشكر والتقدير#
إذا استخدمت مجموعة بيانات COCO في أبحاثك أو أعمال التطوير الخاصة بك، فيُرجى الاستشهاد بالورقة البحثية التالية:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
نود الإقرار بجهود اتحاد COCO في إنشاء هذا المورد القيّم لمجتمع الرؤية الحاسوبية والحفاظ عليه. لمزيد من المعلومات حول مجموعة بيانات COCO ومنشئيها، تفضل بزيارة موقع مجموعة بيانات COCO.
الأسئلة الشائعة#
مجموعة بيانات COCO (الأجسام الشائعة في السياق) هي مجموعة بيانات واسعة النطاق تُستخدم في كشف الأجسام والتقسيم وإنشاء التسميات التوضيحية. وتحتوي على 330 ألف صورة مع تعليقات توضيحية مفصلة لـ80 فئة من الأجسام، مما يجعلها أساسية لقياس أداء نماذج الرؤية الحاسوبية وتدريبها. يستخدم الباحثون COCO بفضل فئاتها المتنوعة ومقاييس التقييم الموحّدة، مثل متوسط الدقة (mAP).
لتدريب نموذج YOLO26 باستخدام مجموعة بيانات COCO، يمكنك استخدام مقتطفات الشيفرة التالية:
مثال على التدريبfrom ultralytics import YOLO # Load a model model = YOLO("yolo26n.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="coco.yaml", epochs=100, imgsz=640)راجع صفحة التدريب لمزيد من التفاصيل حول الوسائط المتاحة.
تتضمن مجموعة بيانات COCO ما يلي:
- 330 ألف صورة، منها 200 ألف صورة مشروحة لكشف الأجسام وتقسيمها وإنشاء التسميات التوضيحية.
- 80 فئة من الأجسام، تتراوح بين عناصر شائعة مثل السيارات والحيوانات وأخرى محددة مثل حقائب اليد والمعدات الرياضية.
- مقاييس تقييم موحّدة لكشف الأجسام (mAP) وتقسيمها (متوسط الاستدعاء، mAR).
- تقنية الموزاييك في دفعات التدريب لتعزيز قدرة النموذج على التعميم عبر أحجام الأجسام والسياقات المختلفة.
تنقسم مجموعة بيانات COCO إلى ثلاث مجموعات فرعية:
- Train2017: 118,287 صورة للتدريب.
- Val2017: 5,000 صورة للتحقق أثناء التدريب.
- Test2017: 20,288 صورة test-dev لقياس أداء النماذج المدرَّبة. يجب إرسال النتائج إلى خادم تقييم COCO لتقييم الأداء.
يتوفر ملف إعداد YAML لمجموعة البيانات على coco.yaml، وهو يعرّف المسارات والفئات وتفاصيل مجموعة البيانات.