تصدير YOLO26 إلى TensorRT
TensorRT هو SDK من NVIDIA لاستدلال التعلّم العميق عالي السرعة. يؤدي تصدير نموذج Ultralytics YOLO26 باستخدام format="engine" إلى إنشاء ملف .engine محسّن لوحدة GPU من NVIDIA التي أُنشئ عليها، بدقة FP32 أو FP16 أو INT8.
يضبط TensorRT المحرك ليتناسب مع وحدة GPU التي أُنشئ عليها. أنشئ المحرك على وحدة GPU المستخدمة للنشر، أو على وحدة من الطراز نفسه وبإصدار TensorRT نفسه؛ فملف .engine ليس تنسيق نموذج قابلًا للنقل. للنشر الطرفي، تتيح منصة Ultralytics ثمانية خيارات لأهداف Jetson، مع توثيق حالة الإنشاء والتحقق الفعليين لكل منها، أو يمكنك التصدير محليًا على الجهاز المستهدف.
لمحة سريعة#
| الخاصية | التفاصيل |
|---|---|
وسيطة format | engine (الأسماء المستعارة: tensorrt، trt) |
| المخرجات | yolo26n.engine، ملف واحد يبدأ بترويسة بيانات وصفية بصيغة JSON (أسماء الفئات والمهمة وحجم الصورة). ويبقى الملف الوسيط yolo26n.onnx بجانبه |
| يعمل على | وحدات GPU من NVIDIA: مراكز البيانات ومحطات العمل وJetson، بما فيها أنوية Jetson DLA (غير متاحة في TensorRT 11) |
| بيئة التشغيل | TensorRT 7.0 أو أحدث (الإصدار 10.2.0 غير مدعوم) |
| الدقة | FP32 وFP16 وINT8 |
| جهاز التصدير | جهاز مزوّد بوحدة GPU من NVIDIA وCUDA. أنشئ المحرك على وحدة GPU المستخدمة للنشر أو على وحدة من الطراز نفسه |
يمكن لمنصة Ultralytics إنشاء محرك TensorRT لك على نوع وحدة GPU الذي تختاره، بما في ذلك أهداف NVIDIA Jetson، فلا تحتاج إلى بيئة تصدير محلية.
البدء السريع#
ثبّت حزمة Ultralytics على جهاز مزوّد بوحدة GPU من NVIDIA وCUDA. على Linux، يثبّت التصدير الأول حزمة TensorRT لـ Python المطابقة لإصدار CUDA لديك إن لم تكن مثبتة. على NVIDIA Jetson، استخدم إصدار TensorRT المرفق مع JetPack. على Windows، ثبّت TensorRT بنفسك قبل التصدير.
pip install ultralyticsللاطلاع على طرق تثبيت أخرى، راجع دليل التثبيت. ثم صدّر نموذجك وحمّل المحرك المُصدَّر لتشغيل الاستدلال أو التحقق من دقته. يتطلب الاستدلال والتحقق وحدة GPU من NVIDIA. يستغرق إنشاء محرك YOLO26n من دقيقة إلى ثلاث دقائق على NVIDIA T4.
from ultralytics import YOLO
# تحميل نموذج YOLO26
model = YOLO("yolo26n.pt")
# صدّر النموذج إلى تنسيق TensorRT
model.export(format="engine") # ينشئ 'yolo26n.engine'
# أو صدّر محرك FP16 بدلًا من ذلك
model.export(format="engine", quantize=16) # ينشئ 'yolo26n.engine'from ultralytics import YOLO
# تحميل نموذج TensorRT المُصدَّر
model = YOLO("yolo26n.engine")
# تنفيذ الاستدلال
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# تحميل نموذج TensorRT المُصدَّر
model = YOLO("yolo26n.engine")
# # التحقق من الدقة على مجموعة بيانات COCO8
metrics = model.val(data="coco8.yaml")المهام المدعومة#
يدعم تصدير TensorRT مهام Ultralytics السبع كلها باستخدام نماذج YOLOv8 وYOLO11 وYOLO26: الكشف والتجزئة والتجزئة الدلالية وتقدير العمق والتصنيف وتقدير الوضعية وOBB. لا يتوفر كل من التجزئة الدلالية وتقدير العمق إلا في YOLO26، وهي العائلة الوحيدة التي تتضمن رأسيْن لهاتين المهمتين.
وسيطات التصدير#
| المعامل | النوع | الافتراضي | الوصف |
|---|---|---|---|
format | str | 'engine' | التنسيق المستهدف للنموذج المُصدَّر، ويحدد مدى توافقه مع بيئات النشر المختلفة. |
imgsz | int أو tuple | 640 | حجم الصورة المطلوب كمدخل للنموذج. يمكن تحديده كعدد صحيح للصور المربعة أو كصف (height, width) للأبعاد المحددة. |
quantize | int أو str | None | دقة التكميم: 16 (FP16) أو 8 (INT8/PTQ؛ يتطلب data/fraction للمعايرة)؛ أما 32/غير المعيّن فيعني FP32. تُصدّر نقطة تحقق دُرّبت باستخدام quantize=8 بصيغة INT8 اعتمادًا على النطاقات التي تتضمنها، دون معايرة، وكذلك عندما يكون quantize غير معيّن؛ ويؤدي quantize=16 أو quantize=32 إلى حدوث خطأ. يحل ذلك محل العلامتين المهجورتين half/int8. |
dynamic | bool | False | ينشئ محركًا يقبل أحجام دفعات من 1 إلى batch وأحجام صور من 32 بكسل إلى ضعفي imgsz؛ ويكون الحد الأدنى أعلى في محركات INT8 الديناميكية على وحدات GPU الأقدم. عند False، لا يقبل المحرك إلا batch وimgsz الخاصتين بالتصدير. |
simplify | bool | True | يُبسّط مخطط النموذج باستخدام onnxslim، ما قد يحسّن الأداء والتوافق. |
opset | int | None | يحدد إصدار مجموعة عمليات ONNX للرسم البياني الوسيط لـ ONNX. إذا لم يُحدَّد، يُستخدم الإصدار 18 من مجموعة العمليات (أقل في PyTorch < 2.4)، على ألا يتجاوز الإصدار المثبّت onnx. |
workspace | float أو None | None | الحد الأعلى للذاكرة بوحدة GiB التي يستخدمها TensorRT أثناء إنشاء المحرك. اتركها على None ليخصّص TensorRT الذاكرة تلقائيًا. |
nms | bool، اختياري | None | اختر المخرجات الخام (None، الافتراضي) أو NMS المضمّن (True) أو الرأس الخالي من NMS (False). عند nms=True، تُثبّت conf (القيمة الافتراضية 0.25) وiou وmax_det وagnostic_nms وقت التصدير؛ ويُتجاهل nms=True مع نماذج التجزئة الدلالية والعمق، ويؤدي إلى خطأ مع نماذج التصنيف. |
batch | int | 1 | حجم دفعة المحرك، أو الحد الأقصى لحجم الدفعة عند استخدام dynamic=True. وهو أيضًا حجم الدفعة المستخدم لمعايرة INT8. |
data | str | None | مسار ملف YAML الخاص بـمجموعة البيانات، والمستخدم لمعايرة INT8؛ أما التصنيف فيتطلب دليل مجموعة بيانات أو اسم مجموعة بيانات مضمّنة. تستخدم المعايرة التقسيم val ما لم يُعيَّن split. إذا لم يُحدَّد ذلك مع quantize=8، تستخدم Ultralytics مجموعة البيانات الافتراضية الصغيرة الخاصة بمهمة النموذج، مثل coco8.yaml للكشف؛ ولا تحتاج نقطة التحقق المدرّبة باستخدام quantize=8 إلى مجموعة بيانات. |
fraction | float أو int أو list | 1.0 | مجموعة فرعية للمعايرة محددة كنسبة أو عدد صور أو نسب/أعداد [train, val, test]. تترك القوائم المكوّنة من عنصرين test كاملة، بينما تتجاوزها 0. |
device | str | None | يحدّد الجهاز المستخدم للتصدير: وحدة GPU (device=0، وتُستخدم عند عدم التعيين)، أو DLA لـNVIDIA Jetson (device=dla:0 أو device=dla:1، مع quantize=16 أو quantize=8). |
على NVIDIA Jetson، تُصدّر Ultralytics باستخدام وقت تشغيل TensorRT الخاص بإصدار JetPack لديك. على JetPack 7، يتطلب التصدير TensorRT 10.15 أو أحدث وأقل من 11. يؤدي device=dla:0 وdevice=dla:1 إلى خطأ مع TensorRT 11. تذكر NVIDIA أن TensorRT 10.7 هو آخر إصدار من سلسلة 10.x يدعم DLA، وأن TensorRT 11.4.1 يضيف دعم JetPack 7.2.2، وهو ما لم تستخدمه Ultralytics بعد.
للاطلاع على الوسيطات المشتركة بين جميع التنسيقات، راجع وثائق وضع التصدير.
تصدير TensorRT باستخدام تكميم INT8#
ينشئ quantize=8 محرك INT8 باستخدام التكميم بعد التدريب (PTQ): إذ يمرّر التصدير صور المعايرة عبر النموذج لقياس نطاق القيم لكل موتر. أما نقطة التحقق التي ضُبطت دقيقًا باستخدام quantize=8 عبر التدريب المراعي للتكميم، فتتضمن نطاقات INT8 مسبقًا، لذا يتجاوز تصديرها المعايرة.
تتطابق الوسيطتان quantize وdata في جميع إصدارات TensorRT، لكن تصدير نقطة تحقق لم تُدرَّب باستخدام quantize=8 يختلف في التنفيذ الداخلي:
| TensorRT 7-10 | TensorRT 11 | |
|---|---|---|
| طريقة INT8 | تكميم ضمني باستخدام الواجهة IInt8Calibrator | تكميم صريح: تُدرج NVIDIA ModelOpt عُقد Q/DQ في مخطط ONNX |
| خوارزمية المعايرة | MINMAX_CALIBRATION على GPU، وENTROPY_CALIBRATION_2 لـDLA | max من ModelOpt، ويُشغّل على CPU |
| صور المعايرة المستخدمة | كل دفعة كاملة من التقسيم | نحو 512 صورة بترتيب عشوائي، أو كل دفعة كاملة من تقسيم أصغر |
dynamic=True مع quantize=8 | غير مشمول في الاختبارات؛ صدّر دون dynamic=True | مدعوم |
FP16 (quantize=16) | علامة منشئ TensorRT | تحويل الدقة المختلطة التلقائي من ModelOpt |
يُثبَّت ModelOpt عند أول استخدام. لا تعيد Ultralytics استخدام ذاكرة التخزين المؤقت للمعايرة، لذا تُجرى المعايرة مجددًا مع كل عملية تصدير. لمعرفة تفاصيل الطريقتين، راجع العمل مع الأنواع المكمّمة في وثائق TensorRT.
لنقطة تحقق لم تُدرَّب باستخدام quantize=8، مرّر صور المعايرة باستخدام data، مثل data="my_dataset.yaml". تستخدم المعايرة التقسيم val من مجموعة البيانات ما لم تعيّن split، ويحدّ fraction عدد الصور. توصي NVIDIA باستخدام 500 صورة على الأقل تمثّل بيانات النشر، ويسجّل التصدير تحذيرًا إذا كان العدد أقل من 300. عند عدم تحديد data، يسجّل التصدير تحذيرًا ويستخدم مجموعة البيانات التجريبية الصغيرة الخاصة بمهمة النموذج، مثل coco8.yaml للكشف. يحتوي تقسيم التحقق فيها على 4 صور، وهو عدد كافٍ لاختبار التصدير، لكنه لا يكفي لمعايرة نموذج للنشر.
from ultralytics import YOLO
model = YOLO("yolo26n.pt")
# عاير باستخدام 10% من صور التحقق في COCO (500 صورة)؛ واستبدل coco.yaml بمجموعة بياناتك الخاصة
model.export(format="engine", quantize=8, data="coco.yaml", fraction=0.1)
# حمّل محرك INT8 المُصدَّر وشغّل الاستدلال
model = YOLO("yolo26n.engine")
result = model.predict("https://ultralytics.com/images/bus.jpg")على وحدة GPU المستخدمة في الاختبارات المعيارية، كانت محركات INT8 أسرع من محركات FP32 بمقدار 1.04 إلى 2.3 مرة، لكنها كانت أسرع من محركات FP16 في ثلاثة نماذج فقط من أصل عشرة. تراجع mAP بمقدار 1.7 إلى 2.9 نقطة مع النماذج من YOLO26n إلى YOLO26l، وكان التراجع أكبر بكثير مع YOLO26x وYOLO26n-pose. كان محرك YOLO26n INT8 أكبر من محرك FP32 المقابل له (30 MB مقابل 11 MB)، بينما تقلّصت أحجام النماذج الكبيرة (53 MB مقابل 103 MB لـYOLO26l). قد يغيّر INT8 قيم الثقة أيضًا، لذا اختر عتبة الثقة استنادًا إلى منحنى F1 الخاص بمحرك INT8 نفسه. راجع القياسات المعيارية لكل نموذج.
تنسيق المخرجات#
يأخذ المحرك مدخلًا واحدًا اسمه images ويعيد المخرجات نفسها التي يعيدها تصدير ONNX الذي أُنشئ منه، مع استثناء واحد: في إصدارات TensorRT الأقدم من 10، تعيد النماذج الدلالية درجات فئات عائمة بالشكل (batch, classes, height, width) بدلًا من خريطة الفئات uint8. راجع تنسيق مخرجات ONNX للاطلاع على شكل مخرجات كل مهمة وكل إعداد من إعدادات nms.
تحميل المحرك خارج Ultralytics#
ملف .engine من Ultralytics ليس محرك TensorRT عاديًا. يبدأ بطول بيانات وصفية من 4 بايتات بترتيب little-endian، تتبعه بيانات JSON الوصفية بهذا الطول، ثم المحرك المتسلسل. تُرجع deserialize_cuda_engine في TensorRT القيمة None عند تمرير الملف كاملًا إليها. تخطَّ الترويسة لتحميل المحرك باستخدام TensorRT API:
import json
import tensorrt as trt
with open("yolo26n.engine", "rb") as f:
n = int.from_bytes(f.read(4), byteorder="little") # طول ترويسة البيانات الوصفية
metadata = json.loads(f.read(n)) # أسماء الفئات والمهمة وimgsz والدفعة ووسيطات التصدير
engine = trt.Runtime(trt.Logger(trt.Logger.WARNING)).deserialize_cuda_engine(f.read())عندما تتطلب أداة أخرى ملف محرك TensorRT عاديًا، اكتب البايتات التي تلي الترويسة في ملف جديد، أو أنشئ المحرك في تلك الأداة من ملف yolo26n.onnx الذي يتركه التصدير بجوار المحرك. في TensorRT 11، تترك عمليات التصدير FP16 وINT8 المعايرة أيضًا الملفين yolo26n.fp16.onnx وyolo26n.int8.onnx؛ وأنشئ محرك INT8 في أداة أخرى من ملف .int8.onnx. بالنسبة إلى نقطة تحقق دُرّبت باستخدام quantize=8، يحتوي yolo26n.onnx مسبقًا على عُقد Q/DQ، ولا يُكتب ملف .int8.onnx؛ ويترك ذلك التصدير في TensorRT 11 الملف yolo26n.fp16.onnx، وهو مخطط Q/DQ نفسه مع تنفيذ طبقاته الأخرى بدقة FP16.
النشر#
يحمّل YOLO("yolo26n.engine") المحرك باستخدام وقت تشغيل TensorRT لـPython. يعمل المحرك على GPU 0 افتراضيًا، حتى عند تمرير device="cpu". مرّر device=1 لتشغيله على وحدة GPU أخرى من الطراز نفسه. ويعمل المحرك المُصدَّر باستخدام device=dla:0 أو device=dla:1 على نواة DLA تلك.
يكون للإدخال شكل ثابت في المحرك المُصدَّر دون dynamic=True. يستخدم كل من predict وval قيمة imgsz الخاصة بالتصدير، ويتجاهلان وسيط imgsz إذا اختلف. تقسّم Ultralytics الدفعات الأكبر إلى دفعات بحجم التصدير، وتضيف حشوًا إلى الدفعات الأصغر، لذا يعمل المحرك مع أي عدد من الصور. يقبل المحرك المُصدَّر باستخدام dynamic=True كل أحجام الدفعات والصور ضمن نطاقه، ويُصدر ValueError: input size ... is outside the TensorRT optimization profile عند تجاوز الشكل ذلك النطاق. عند استخدام nms=True، تُقسّم الدفعة التي تتجاوز النطاق إلى دفعات بحجم التصدير بدلًا من ذلك.
أدلة النشر#
-
NVIDIA Triton Inference Server: قدّم نموذج ONNX مُصدَّرًا باستخدام مسرّع TensorRT في Triton، الذي ينشئ المحرك على وحدة GPU في الخادم.
-
البدء السريع مع NVIDIA Jetson: أعدّ Ultralytics على أجهزة Jetson وصدّر محركات TensorRT باستخدام JetPack، بما في ذلك DLA.
-
البدء السريع مع NVIDIA DGX Spark: أعدّ Ultralytics وTensorRT على NVIDIA DGX Spark.
-
DeepStream على NVIDIA Jetson: شغّل النماذج المُصدَّرة ضمن مسارات معالجة الفيديو في NVIDIA DeepStream.
-
NVIDIA TensorRT على GitHub: الشيفرة المصدرية والعينات والأدوات الخاصة بـTensorRT.
القيود واستكشاف الأخطاء وإصلاحها#
- المحركات غير قابلة للنقل: يُنشأ المحرك لطراز واحد من وحدات GPU وإصدار واحد من TensorRT. أعد إنشاءه عند تغيير وحدة GPU أو إصدار TensorRT أو إصدار JetPack. عندما يتعذر تحميل محرك، تسجّل Ultralytics
TensorRT model exported with a different version than expected. - تتطلب العملية وحدة GPU: يستخدم التصدير
device=0عند عدم تعيينdevice، ويفشل معexport running on CPU but must be on GPUعند استخدامdevice=cpu. - لا يُحمَّل المحرك في الأدوات الأخرى: يبدأ الملف
.engineبترويسة بيانات وصفية، لذا لا يمكن لـTensorRT API قراءته مباشرةً. راجع تحميل المحرك خارج Ultralytics. - إصدار TensorRT: تتطلب Ultralytics الإصدار 7.0.0 أو أحدث من TensorRT. الإصدار 10.2.0 غير مدعوم، ويتجاوزه التثبيت التلقائي. على JetPack 7 وأنظمة NVIDIA DGX، يتطلب التصدير TensorRT 10.15 أو أحدث (وأقل من 11 على Jetson)، ويحاول تثبيته عندما يكون الإصدار المثبّت خارج هذا النطاق.
- الرأس الخالي من NMS على إصدارات TensorRT القديمة: لا يمكن لإصدارات TensorRT الأقدم من 8.5.0 إنشاء الرأس الخالي من NMS في YOLO26. يسجّل التصدير تحذيرًا ويكتب تنبؤات خامًا تتطلب NMS. حدّث TensorRT إلى الإصدار 8.5.0 أو أحدث للتصدير باستخدام
nms=False. - INT8 على JetPack 6: مع TensorRT 10.3.0 على JetPack 6، يفشل تصدير INT8 باستخدام
nms=True، ويرجع تصدير INT8 باستخدامnms=Falseإلى التنبؤات الخام. راجع دليل Jetson لمعرفة الحل. - INT8 على TensorRT 10.16: فشل تصدير INT8 باستخدام TensorRT 10.16.1 على وحدات NVIDIA RTX PRO 6000 Blackwell وRTX 6000D GPU مع
Could not find any implementation for node. على RTX PRO 6000 Blackwell، أنشأت إصدارات TensorRT 10.13 و10.14 و10.15 و11.4 محرك INT8. - DLA: لا يعمل
device=dla:0وdevice=dla:1إلا على NVIDIA Jetson، ومعquantize=16أوquantize=8فقط. يُصدر التصدير خطأً على TensorRT 11. وتُشغّل الطبقات التي لا يدعمها DLA على وحدة GPU. - الأشكال الديناميكية: يتطلب
dynamic=Trueتحديد الحد الأقصى لحجم الدفعة، لذا عيّن أيضًاbatch، مثلbatch=8. دون ذلك، يسجّل التصدير تحذيرًا ويكون الحد الأقصى لحجم الدفعة 1. يقبل المحرك دفعات من 1 إلىbatchوأحجام صور من 32 بكسل حتى ضعفي قيمة التصديرimgsz. على سبيل المثال، يعمل محرك مُصدَّر باستخدامimgsz=320 batch=4عند 640 بكسل، ويرفض 704 بكسل أو دفعة من 6 باستخدامinput size ... is outside the TensorRT optimization profile. اجمعdynamic=Trueمعquantize=8على TensorRT 11 فقط. على وحدات GPU ذات قدرة حوسبة 7.5 أو أقل، مثل T4، يكون الحد الأدنى لحجم محركات INT8 الديناميكية هذه 64 بكسل (و128 لنماذج P6). - حجم إدخال ثابت: يعمل المحرك المُصدَّر دون
dynamic=Trueدائمًا بحجم التصديرimgsz. لا يؤثر تمرير قيمة أخرى لـimgszإلى predict أو val، لذا أعد التصدير لتغيير حجم الإدخال. - تصدير INT8 دون
data: ما لم تكن نقطة التحقق قد دُرّبت باستخدامquantize=8، يعاير التصدير على مجموعة البيانات الافتراضية الصغيرة للمهمة، التي تحتوي على 4 صور تحقق للكشف، ويسجّل تحذيرًا. مرّرdataمع صور تمثيلية؛ ويصدر التصدير تحذيرًا إذا كان العدد أقل من 300. - بطء عمليات الاستدلال الأولى: تستغرق الاستدعاءات الأولى القليلة وقتًا أطول من الاستدعاءات اللاحقة عند استخدام محرك جديد أو قيمة
imgszجديدة مع محرك ديناميكي.
للاطلاع على الأخطاء الأخرى، راجع دليل المشكلات الشائعة.
المعايير المرجعية#
تعرض صفحة نموذج YOLO26 سرعة TensorRT 10 لكل نموذج على وحدة NVIDIA T4 GPU لجميع المهام باستثناء التجزئة الدلالية.
مقارنة FP32 وFP16 وINT8#
تقارن الجداول أدناه بين PyTorch ومحركات TensorRT 11.4 بدقة FP32 وFP16 وINT8 لجميع نماذج الكشف YOLO26، ولنموذج YOLO26n في خمس مهام أخرى. قِيست جميع القيم على وحدة GPU واحدة من طراز NVIDIA RTX PRO 6000 Blackwell Server Edition.
الزمن بالمللي ثانية لكل صورة، والأقل أفضل. التنسيق الأسرع لكل نموذج مكتوب بالخط العريض؛ واستُبعد محرك YOLO26x INT8 بسبب عدم استقرار دقته.
| النموذج | imgsz | PyTorch | TensorRT FP32 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| YOLO26n | 640 | 2.85 | 0.67 | 0.48 | 0.53 |
| YOLO26s | 640 | 2.98 | 1.15 | 0.61 | 0.66 |
| YOLO26m | 640 | 3.29 | 2.22 | 1.03 | 1.08 |
| YOLO26l | 640 | 4.70 | 3.03 | 1.49 | 1.43 |
| YOLO26x | 640 | 5.93 | 4.31 | 2.09 | 1.84 |
| YOLO26n-seg | 640 | 3.18 | 0.93 | 0.65 | 0.72 |
| YOLO26n-sem | 1024 | 1.74 | 0.74 | 0.45 | 0.71 |
| YOLO26n-cls | 224 | 1.75 | 0.29 | 0.24 | 0.20 |
| YOLO26n-pose | 640 | 3.39 | 0.76 | 0.51 | 0.59 |
| YOLO26n-obb | 1024 | 4.55 | 1.03 | 0.64 | 0.88 |
- حافظ FP16 على دقة FP32 ضمن 0.1 نقطة في كل نموذج. وفي نماذج الكشف، كان أسرع بمقدار 1.4 إلى 2.2 مرة من محرك FP32، وبمقدار 2.8 إلى 5.9 مرات من PyTorch.
- كان زمن استجابة INT8 ضمن 12% من زمن استجابة FP16 في نماذج الكشف، لكنه خسر 1.7 إلى 2.9 mAP في YOLO26n وYOLO26s وYOLO26m وYOLO26l. وعلى وحدة GPU هذه، لم يكن أسرع من FP16 إلا في YOLO26l وYOLO26x وYOLO26n-cls.
- تراجعت دقة YOLO26x INT8 إلى ما بين 25.3 و38.5 mAP عبر ثلاثة إصدارات، مقابل 57.5 في FP32. وتراجعت دقة YOLO26n-pose INT8 من 56.7 إلى 33.4 في mAP للوضعيات. تحقّق من كل محرك INT8 باستخدام بياناتك قبل نشره.
- طابقت محركات YOLO26n وYOLO26s بدقتي FP32 وFP16 في TensorRT 10.16 دقة TensorRT 11.4. وكانت محركات FP16 أسرع بنحو 7%، بينما كانت محركات FP32 أبطأ بنسبة 4% إلى 9% مقارنةً بـ TensorRT 11.4.
للاطّلاع على NVIDIA Jetson وDGX Spark، راجع معايير أداء Jetson ودليل DGX Spark.
أُجريت القياسات باستخدام ultralytics 8.4.211 وTensorRT 11.4.0 وPyTorch 2.15.0 وCUDA 13.2 على batch=1 في 13 نوفمبر 2026. زمن الاستجابة هو زمن مرحلة الاستدلال التي يبلغ عنها val، ولا يشمل المعالجة المسبقة أو اللاحقة.
نبذة عن TensorRT#
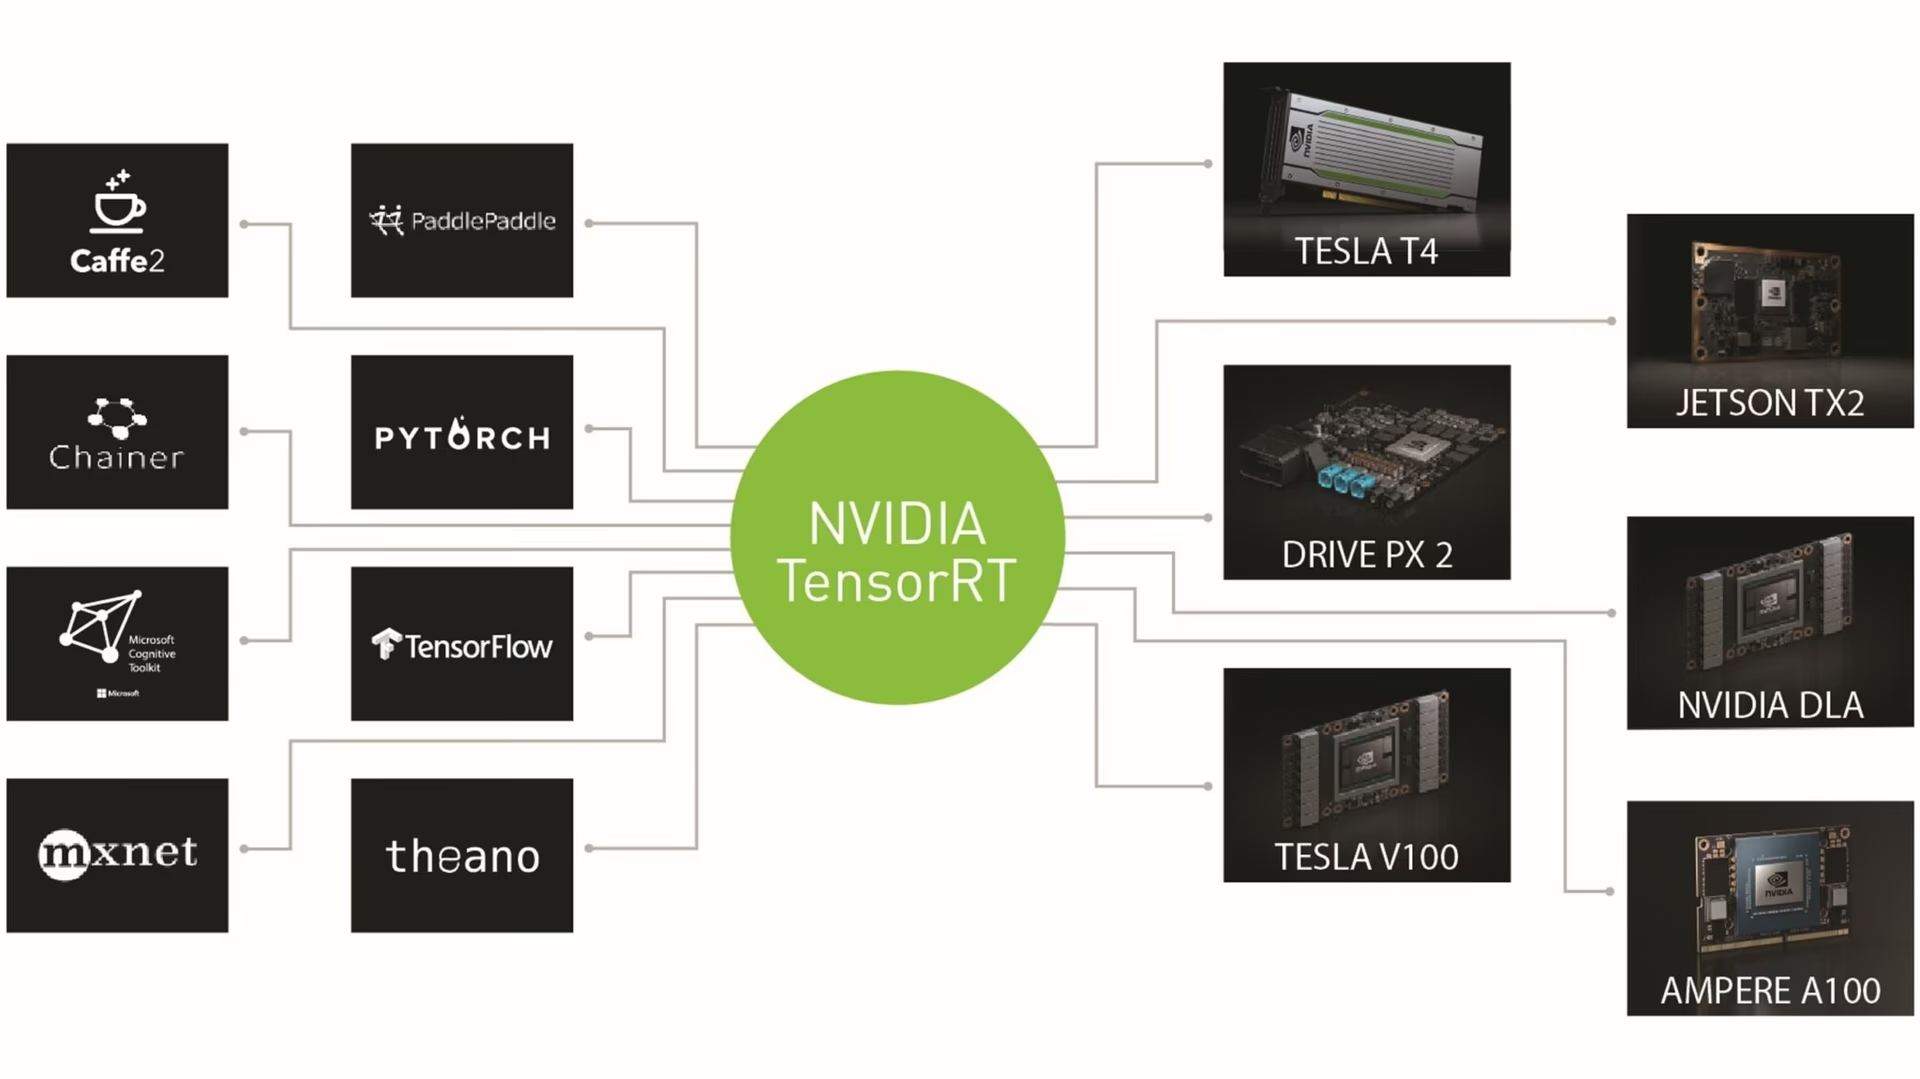
ينشئ TensorRT محركًا من خلال دمج الطبقات، واختيار أسرع نواة لكل طبقة على وحدة GPU المستخدمة في الإنشاء، وخفض الدقة اختياريًا إلى FP16 أو INT8. للاطّلاع على المرجع الكامل، راجع وثائق TensorRT.
الأسئلة الشائعة#
فقط على وحدة GPU من الطراز نفسه وبإصدار TensorRT نفسه. يُنشأ المحرك لطراز واحد من وحدات GPU وإصدار واحد من TensorRT. لمشاركة ملف واحد بين أجهزة مختلفة، صدّر إلى ONNX وأنشئ المحرك على كل جهاز. وبالنسبة إلى NVIDIA Jetson، يمكن لـ Ultralytics Platform إنشاء محركات لثمانية أهداف Jetson.
ابدأ بـ FP16 (
quantize=16). فهو لا يحتاج إلى بيانات معايرة ويحافظ على دقة FP32. في معايير الأداء على NVIDIA RTX PRO 6000 Blackwell مع TensorRT 11.4، خفّض FP16 زمن استجابة YOLO26s من 1.15 ms إلى 0.61 ms لكل صورة، مع الحفاظ على mAPمجموعة التحقق 50-95 البالغة 48.5. حقق INT8 (quantize=8) زمنًا قدره 0.66 ms وmAPمجموعة التحقق 50-95 قدره 46.3، لذا لم يكن أسرع من FP16 على وحدة GPU هذه، كما أنه يحتاج إلى بيانات معايرة ممثّلة، إلا إذا دُرّبت نقطة التحقق باستخدامquantize=8. وقد يكون INT8 مفيدًا على أجهزة أخرى: تعرض معايير أداء Jetson نتائج FP16 وINT8 للأجهزة المضمّنة. قِس أداء الدقتين على جهاز النشر قبل اختيار INT8.صدّر باستخدام
dynamic=Trueواضبطbatchعلى أكبر حجم دفعة تخطط لتشغيله. عندها يقبل المحرك دفعات من 1 إلىbatch، وأحجام صور تبدأ من 32 بكسل وتصل إلى ضعفيimgszالمُصدَّر، مع حد أدنى أعلى لـ محركات INT8 الديناميكية على وحدات GPU الأقدم. من دونdynamic=True، يكون للمحرك شكل إدخال ثابت واحد، ويقسّم Ultralytics كل دفعة أو يضيف إليها حشوًا لتلائم هذا الشكل.محرك ديناميكيfrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="engine", dynamic=True, batch=8, quantize=16) model = YOLO("yolo26n.engine") results = model(["https://ultralytics.com/images/bus.jpg"] * 4, batch=4) # دفعة من 4 صورنفّذ التصدير على جهاز Jetson نفسه باستخدام إصدار TensorRT المضمّن في إصدار JetPack لديك. لاستخدام نواة DLA، أضف
device=dla:0معquantize=16أوquantize=8. راجع دليل NVIDIA Jetson لمعرفة خطوات الإعداد ومعايير الأداء.التصدير على Jetsonfrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="engine", quantize=16) # محرك FP16 على وحدة GPU في Jetson # أو أنشئ محرك FP16 لنواة DLA 0 بدلًا من ذلك model.export(format="engine", quantize=16, device="dla:0")يصدّر دليل Triton Inference Server النموذج إلى ONNX ويفعّل مسرّع TensorRT في Triton ضمن
config.pbtxt. بعد ذلك، ينشئ Triton محرك TensorRT على وحدة GPU للخادم عند التحميل الأول ويخزّنه مؤقتًا، لذا يتوافق المحرك دائمًا مع وحدة GPU للخادم وإصدار TensorRT. يغطي الدليل تخطيط مستودع النماذج وحاوية الخادم واستدلال العميل باستخدام Ultralytics.


التعليقات116
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.
AgbajeAyomipo
Hi Ultralytics team, I’ve trained a YOLOv11 model on (1024x1024) images from a camera feed and now I’m trying to run real-time inference on live streams using a Jetson Orin Nano. I want to maintain full resolution for inference because of accuracy requirements, but currently I'm getting only 1-2 FPS. When I reduce the input size, the FPS improves significantly, but it's not acceptable due to missed detections at lower resolutions. I attempted to export the model to TensorRT using:
model.export(format="engine", imgsz=(2592, 1944), half=True) but it fails silently. If I use a dynamic=true without specifying the imgsz parameter, the export succeeds and uses (1024, 1024). My questions:
Is TensorRT export for such high-resolution input supported/recommended with YOLOv11? If not, is there any known limitation or workaround? Are there ways to improve performance with high-res inference on Jetson Orin Nano? What hardware would you recommend for real-time inference on 1-3 camera streams with 5MP inputs, assuming we need at least ~15-20 FPS per stream? Device: AAEON BOXER-8621AI Module: NVIDIA® Jetson Orin Nano™ (4GB LPDDR5, Super Mode Enabled) Memory: 4 GB LPDDR5 I/O: USB 3.2 Gen 2, M.2 Expansion Operating System: JetPack 5.1.4 (L4T 35.6.0, Ubuntu 20.04) Use Case: Real-time multi-stream 5MP video inference
1martinmclee
Have you gotten any workaround? Perhaps with the YOLO26?
Hi Ultralytics team, I’ve trained a YOLOv11 model on full-size 5MP (2592x1944) images from a camera feed and now I’m trying to run real-time inference on live streams using a Jetson Orin Nano. I want to maintain full resolution for inference because of accuracy requirements, but currently I'm getting only 1-2 FPS. When I reduce the input size, the FPS improves significantly, but it's not acceptable due to missed detections at lower resolutions. I attempted to export the model to TensorRT using:
model.export(format="engine", imgsz=(2592, 1944), half=True)but it fails silently. If I use a dynamic=true, the export succeeds and uses (1024, 1024). My questions:- Is TensorRT export for such high-resolution input supported/recommended with YOLOv11? If not, is there any known limitation or workaround?
- Are there ways to improve performance with high-res inference on Jetson Orin Nano?
- What hardware would you recommend for real-time inference on 1-3 camera streams with 5MP inputs, assuming we need at least ~15-20 FPS per stream? Device: AAEON BOXER-8621AI Module: NVIDIA® Jetson Orin Nano™ (4GB LPDDR5, Super Mode Enabled) Memory: 4 GB LPDDR5 I/O: USB 3.2 Gen 2, M.2 Expansion Operating System: JetPack 5.1.4 (L4T 35.6.0, Ubuntu 20.04) Use Case: Real-time multi-stream 5MP video inference
1020423lzl
m的模型大小比n大的多,速度也慢了很多,输入图像尺寸越大,越吃显存,速度也越慢
李子乐控制工程 @.***
---Original--- From: @.> Date: Sat, May 9, 2026 10:30 AM To: @.>; Cc: @.@.>; Subject: Re: [ultralytics/ultralytics] zh/integrations/tensorrt/ (Discussion #9868)
现在有一个奇怪的现象,我导出的tensorrt模型的推理速度几乎和原来的.pt几乎没有差别甚至更慢,并且导出的tensorrt模型的推理结果和.pt模型的差别很大。 我的设备是i914900k+64G RAM+RTX A6000 我的环境是cuda12.4.131+tensorrt10.10.0.31+torch2.5.1+ultralytics8.3.252 导出命令: yolo export model=yolo11m.pt imgsz=1280 format='engine 推理代码为: model.predict(stream_path, imgsz=1280, classes=[14], conf=0.2, iou=0.5, stream=True, task='detect')
另外我试了下yolo11n.pt的640输入尺寸导出,推理速度就有明显提升,当然推理结果差别仍然较大。 请问这是什么道理,有什么解决办法?
— Reply to this email directly, view it on GitHub, or unsubscribe. Triage notifications on the go with GitHub Mobile for iOS or Android. You are receiving this because you commented.Message ID: @.***>
 User
能不能读完再说话,肯定是m和m比,n和n比,同样尺寸输入和同样尺寸输入的比啊。 该显卡的RT core算力是普通fp32算力的近两倍。
 Glenn JocherUltralytics
是的,性能应当在同一模型、同一
imgsz、同一batch、同一后处理参数下比较;m比n更大、1280比640更吃显存且更慢是正常现象。对 RTX A6000 来说,FP32的 TensorRT 往往不会比.pt明显更快,建议先按 TensorRT 导出文档 用half=True重新导出,并在相同输入上预热后再统计平均耗时;如果engine与.pt结果仍明显不一致,请贴出!yolo checks、完整控制台日志文本和一个最小可复现示例,我们好继续排查环境或后处理差异。
- User
现在有一个奇怪的现象,我导出的tensorrt模型的推理速度几乎和原来的.pt几乎没有差别甚至更慢,并且导出的tensorrt模型的推理结果和.pt模型的差别很大。 我的设备是i914900k+64G RAM+RTX A6000 我的环境是cuda12.4.131+tensorrt10.10.0.31+torch2.5.1+ultralytics8.3.252 导出命令:
yolo export model=yolo11m.pt imgsz=1280 format='engine推理代码为:model.predict(stream_path, imgsz=1280, classes=[14], conf=0.2, iou=0.5, stream=True, task='detect')另外我试了下yolo11n.pt的640输入尺寸导出,推理速度就有明显提升,当然推理结果差别仍然较大。 请问这是什么道理,有什么解决办法?
etson@yahboom:~/ultralytics/ultralytics$ yolo predict model=best.engine source=0 save=False show WARNING ⚠️ Unable to automatically guess model task, assuming 'task=detect'. Explicitly define task for your model, i.e. 'task=detect', 'segment', 'classify','pose' or 'obb'. Ultralytics 8.3.172 🚀 Python-3.10.12 torch-2.5.0a0+872d972e41.nv24.08 CUDA:0 (Orin, 7620MiB) Loading best.engine for TensorRT inference... [12/18/2025-17:11:05] [TRT] [I] Loaded engine size: 75 MiB [12/18/2025-17:11:05] [TRT] [I] [MS] Running engine with multi stream info [12/18/2025-17:11:05] [TRT] [I] [MS] Number of aux streams is 7 [12/18/2025-17:11:05] [TRT] [I] [MS] Number of total worker streams is 8 [12/18/2025-17:11:05] [TRT] [I] [MS] The main stream provided by execute/enqueue calls is the first worker stream [12/18/2025-17:11:05] [TRT] [I] [MemUsageChange] TensorRT-managed allocation in IExecutionContext creation: CPU +1, GPU +88, now: CPU 1, GPU 158 (MiB)
[ WARN:0@2.771] global cap_gstreamer.cpp:1777 open OpenCV | GStreamer warning: Cannot query video position: status=0, value=-1, duration=-1 1/1: 0... Success ✅ (inf frames of shape 1920x1080 at 5.00 FPS)
Traceback (most recent call last): File "/home/jetson/.local/bin/yolo", line 7, in sys.exit(entrypoint()) File "/home/jetson/Downloads/ultralytics-main/ultralytics/cfg/init.py", line 983, in entrypoint getattr(model, mode)(**overrides) # default args from model File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/model.py", line 555, in predict return self.predictor.predict_cli(source=source) if is_cli else self.predictor(source=source, stream=stream) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 247, in predict_cli for _ in gen: # sourcery skip: remove-empty-nested-block, noqa File "/usr/local/lib/python3.10/dist-packages/torch/utils/_contextlib.py", line 36, in generator_context response = gen.send(None) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 351, in stream_inference s[i] += self.write_results(i, Path(paths[i]), im, s) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 434, in write_results string += f"{result.verbose()}{result.speed['inference']:.1f}ms" File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/results.py", line 694, in verbose return "".join(f"{n} {self.names[i]}{'s' * (n > 1)}, " for i, n in enumerate(counts) if n > 0) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/results.py", line 694, in return "".join(f"{n} {self.names[i]}{'s' * (n > 1)}, " for i, n in enumerate(counts) if n > 0) KeyError: 171 terminate called without an active exception Aborted (core dumped) jetson@yahboom:~/ultralytics/ultralytics$ How to solve it
- Glenn JocherUltralytics
KeyError: 171表示模型输出了类别171,但当前names里没有这个索引(通常是自定义数据集的标签类别编号不在0..nc-1范围内、data.yaml里的names数量与nc不匹配,或导出/推理用的模型与数据配置不一致导致的元数据错配);请先把所有标注.txt的 class id 修正为连续的0..nc-1,同步修正data.yaml的nc/names,修正后删除数据集labels/下的*.cache,再用同一套环境从best.pt重新导出.engine(参考 TensorRT 导出文档),并在推理时显式加上task=detect。另外请把下面命令的完整输出(文本)贴在这个 discussion 里,以及你当时的导出命令,方便我们确认是否有多环境/路径冲突:yolo checks Thank you for your reply. The issue has been resolved. I was using the RT-DETR model, but I mistakenly used "from ultralytics import YOLO" when exporting
- Glenn JocherUltralytics
Glad you found it — RT-DETR models should be loaded/exported with
RTDETR(...)(mixing them withYOLO(...)can produce mismatched metadata likenames), see the RT-DETR model docs for details:from ultralytics import RTDETR model = RTDETR("best.pt") model.export(format="engine") # creates best.engine
fly2skyToEnjoy
May I ask : The following command exports the file, whether the box and mask are both nmsed at the same time ???
from ultralytics import YOLO
Load the YOLO11 model
model = YOLO("yolo11n.pt")
Export the model to TensorRT format
model.export(format="engine") # creates 'yolo11n.engine'
Load the exported TensorRT model
tensorrt_model = YOLO("yolo11n.engine")
Run inference
results = tensorrt_model("https://ultralytics.com/images/bus.jpg")
AK993
这个方法适用于rt-detr吗
dilanpatel195
I am trying to prediction model for the YOLOv11n-seg, I have exported the .py to .engine to back it run faster but keep getting a KEY error message:
KeyError Traceback (most recent call last) Cell In[4], line 109 106 # Inside the main loop after grabbing a frame 107 if inference_active and not inpainting_active: 108 # Perform YOLO inference --> 109 results = model(rgb_frame)[0] 110 masked_image = rgb_frame.copy() # Make a copy for masking 112 # Process YOLO masks (original functionality remains unchanged)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\model.py:176, in Model.call(self, source, stream, **kwargs) 147 def call( 148 self, 149 source: Union[str, Path, int, Image.Image, list, tuple, np.ndarray, torch.Tensor] = None, 150 stream: bool = False, 151 **kwargs, 152 ) -> list: 153 """ 154 Alias for the predict method, enabling the model instance to be callable for predictions. 155 (...) 174 ... print(f"Detected {len(r)} objects in image") 175 """ --> 176 return self.predict(source, stream, **kwargs)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\model.py:554, in Model.predict(self, source, stream, predictor, **kwargs) 552 if prompts and hasattr(self.predictor, "set_prompts"): # for SAM-type models 553 self.predictor.set_prompts(prompts) --> 554 return self.predictor.predict_cli(source=source) if is_cli else self.predictor(source=source, stream=stream)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:168, in BasePredictor.call(self, source, model, stream, *args, **kwargs) 166 return self.stream_inference(source, model, *args, **kwargs) 167 else: --> 168 return list(self.stream_inference(source, model, *args, **kwargs))
File c:\ProgramData\miniconda3\Lib\site-packages\torch\utils_contextlib.py:36, in _wrap_generator..generator_context(*args, **kwargs) 33 try: 34 # Issuing None to a generator fires it up 35 with ctx_factory(): ---> 36 response = gen.send(None) 38 while True: 39 try: 40 # Forward the response to our caller and get its next request
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:274, in BasePredictor.stream_inference(self, source, model, *args, **kwargs) 268 self.results[i].speed = { 269 "preprocess": profilers[0].dt * 1e3 / n, 270 "inference": profilers[1].dt * 1e3 / n, 271 "postprocess": profilers[2].dt * 1e3 / n, 272 } 273 if self.args.verbose or self.args.save or self.args.save_txt or self.args.show: --> 274 s[i] += self.write_results(i, Path(paths[i]), im, s) 276 # Print batch results 277 if self.args.verbose:
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:334, in BasePredictor.write_results(self, i, p, im, s) 332 result = self.results[i] 333 result.save_dir = self.save_dir.str() # used in other locations --> 334 string += f"{result.verbose()}{result.speed['inference']:.1f}ms" 336 # Add predictions to image 337 if self.args.save or self.args.show:
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\results.py:663, in Results.verbose(self) 661 for c in boxes.cls.unique(): 662 n = (boxes.cls == c).sum() # detections per class --> 663 log_string += f"{n} {self.names[int(c)]}{'s' * (n > 1)}, " 664 return log_string
KeyError: 2
Any help would be greatly appreciated!
Ranjith3436
Now, My TensorRT Sengment model used for track. if any detections not there the processing FPS is 75-80 in jetson. But once the person or people detected suddenly reused to 15-20. processing time going to 40ms. only when the object detected. What's the issue in model.track(), could i run all the tracking thing on GPU.
- Glenn JocherUltralytics(تم التعديل)
@Ranjith3436 the performance drop when objects are detected is expected behavior, as tracking introduces additional computational overhead. When objects are detected, the model.track() method performs several CPU-bound operations including feature extraction, association, and trajectory management.
To improve performance:
- Try using a smaller model variant (like YOLO26n-seg instead of larger variants)
- Consider reducing the image resolution for tracking
- Optimize tracking parameters by setting
persist=Trueand adjustingconfthresholds higher to track fewer objects - Use
half=True(FP16) orint8=Truewhen exporting your model to TensorRT for maximum GPU acceleration
For the tracking components specifically, the BoT-SORT or ByteTrack algorithms used by Ultralytics do have some CPU-bound operations, but you can minimize their impact with the above optimizations. For more details on tracking optimization, check our tracking documentation.
1
I convert Classification model that i retrained. But it throw the error "amax(): Expected reduction dim 1 to have non-zero size."
- Glenn JocherUltralytics
@Ranjith3436 this error typically occurs when TensorRT encounters an empty dimension during model conversion. For classification models, this could happen if:
- Your model architecture was modified or if you're using a custom architecture
- There might be an issue with batch normalization layers during export
- The class count in your retrained model might be causing dimension mismatches
Try these solutions:
- Ensure your model's forward pass works correctly before export
- Try exporting with
simplify=Falseto preserve the original graph structure - Check if your classification model has the correct output dimension for your number of classes
If the issue persists, share more details about your model architecture and export command for better assistance. For more guidance, refer to our TensorRT integration documentation.
The model trained use yolov8l-cls.pt and the error come from jetson device.
(model): ClassificationModel( (model): Sequential( (0): Conv( (conv): Conv2d(3, 64, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (1): Conv( (conv): Conv2d(64, 128, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (2): C2f( (cv1): Conv( (conv): Conv2d(128, 128, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(320, 128, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-2): 3 x Bottleneck( (cv1): Conv( (conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (3): Conv( (conv): Conv2d(128, 256, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (4): C2f( (cv1): Conv( (conv): Conv2d(256, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(1024, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-5): 6 x Bottleneck( (cv1): Conv( (conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (5): Conv( (conv): Conv2d(256, 512, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (6): C2f( (cv1): Conv( (conv): Conv2d(512, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(2048, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-5): 6 x Bottleneck( (cv1): Conv( (conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (7): Conv( (conv): Conv2d(512, 1024, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (8): C2f( (cv1): Conv( (conv): Conv2d(1024, 1024, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(2560, 1024, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-2): 3 x Bottleneck( (cv1): Conv( (conv): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (9): Classify( (conv): Conv( (conv): Conv2d(1024, 1280, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1280, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (pool): AdaptiveAvgPool2d(output_size=1) (drop): Dropout(p=0.0, inplace=True) (linear): Linear(in_features=1280, out_features=2, bias=True) ) ) ) )
model architecture
This error sorted out