Datensatz für medizinische Pillen#
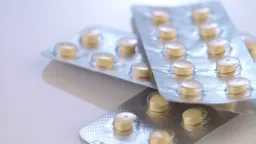
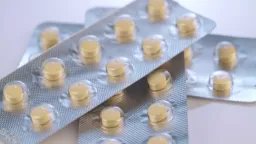
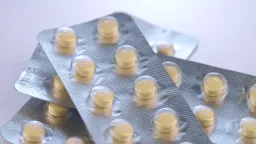
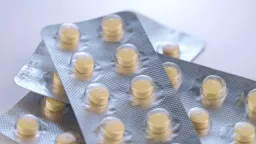

Der Ultralytics-Datensatz Medical Pills ist ein Machbarkeitsnachweis (POC) für die Objekterkennung. Er umfasst 115 gelabelte Bilder mit einer einzigen Klasse, pill — 92 für das Training und 23 für die Validierung. Der Datensatz veranschaulicht den Einsatz von Computer-Vision-Modellen in pharmazeutischen Anwendungen wie Qualitätskontrolle, Verpackungsautomatisierung und Sortierung.
Ansehen: So trainierst du ein Ultralytics-YOLO-Modell mit dem Datensatz zur Erkennung medizinischer Tabletten in Google Colab
Datensatzstruktur#
Der Medical-Pills-Datensatz enthält 115 Bilder, die einer einzigen Klasse, pill, zugeordnet und in zwei durch die Konfiguration medical-pills.yaml definierte Teilmengen aufgeteilt sind:
| Aufteilung | Bilder | Beschreibung |
|---|---|---|
| Trainieren | 92 | Annotierte Bilder für das Modelltraining |
| Validierung | 23 | Zurückgehaltene Bilder für die Evaluierung und das Benchmarking |
Erkunde Medical Pills auf der Ultralytics Platform, um die Bilder mit eingeblendeten Annotationen zu durchsuchen, die Klassenverteilung und Begrenzungsrahmen-Wärmekarten im Tab Charts anzusehen und den Datensatz zu klonen, um dein eigenes Modell in der Cloud zu trainieren.
Anwendungsfälle#
Der Einsatz von Computer Vision zur Erkennung medizinischer Pillen ermöglicht die Automatisierung in der Pharmaindustrie und unterstützt Aufgaben wie:
- Sortierung von Arzneimitteln: Automatisiere die Sortierung von Pillen nach Größe, Form oder Farbe, um die Produktionseffizienz zu steigern.
- KI-Forschung und -Entwicklung: Dient als Benchmark für die Entwicklung und Erprobung von Computer-Vision-Algorithmen für pharmazeutische Anwendungsfälle.
- Digitale Bestandssysteme: Ermöglicht intelligente Lösungen zur Bestandsverwaltung durch automatisierte Pillenerkennung für die Echtzeitüberwachung des Lagerbestands und die Planung der Nachbestellung.
- Qualitätskontrolle: Sichert die gleichbleibende Qualität der Pillenproduktion, indem Fehler, Unregelmäßigkeiten oder Verunreinigungen erkannt werden.
- Erkennung gefälschter Arzneimittel: Hilft dabei, potenziell gefälschte Medikamente zu erkennen, indem ihre visuellen Merkmale mit bekannten Standards verglichen werden.
YAML-Datei des Datensatzes#
Die Datei medical-pills.yaml definiert die Dataset-Konfiguration — die Dataset-Pfade, Klassennamen und weitere Metadaten. Sie wird im Ultralytics-Repository unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/medical-pills.yaml gepflegt.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Medical-pills dataset by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/medical-pills
# Example usage: yolo train data=medical-pills.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── medical-pills ← downloads here (8.19 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: medical-pills # dataset root dir
train: images/train # train images (relative to 'path') 92 images
val: images/val # val images (relative to 'path') 23 images

# Classes
names:
  0: pill

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/medical-pills.zipVerwendung#
Verwende die folgenden Beispiele, um ein YOLO26n-Modell 100 Epochen lang mit einer Bildgröße von 640 auf dem Medical-Pills-Datensatz zu trainieren. Ausführliche Angaben zu den Argumenten findest du auf der Seite Training des Modells.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Das Modell trainieren
results = model.train(data="medical-pills.yaml", epochs=100, imgsz=640)from ultralytics import YOLO
# Ein Modell laden
model = YOLO("path/to/best.pt") # Ein feinabgestimmtes Modell laden
# Inferenz mit dem Modell
results = model.predict("https://ultralytics.com/assets/medical-pills-sample.jpg")Beispielbilder und Annotationen#
Der Medical-Pills-Datensatz enthält gelabelte Bilder, die die Vielfalt der Pillen zeigen. Unten siehst du ein Beispiel für einen gekachelten Trainingsbatch aus dem Datensatz:
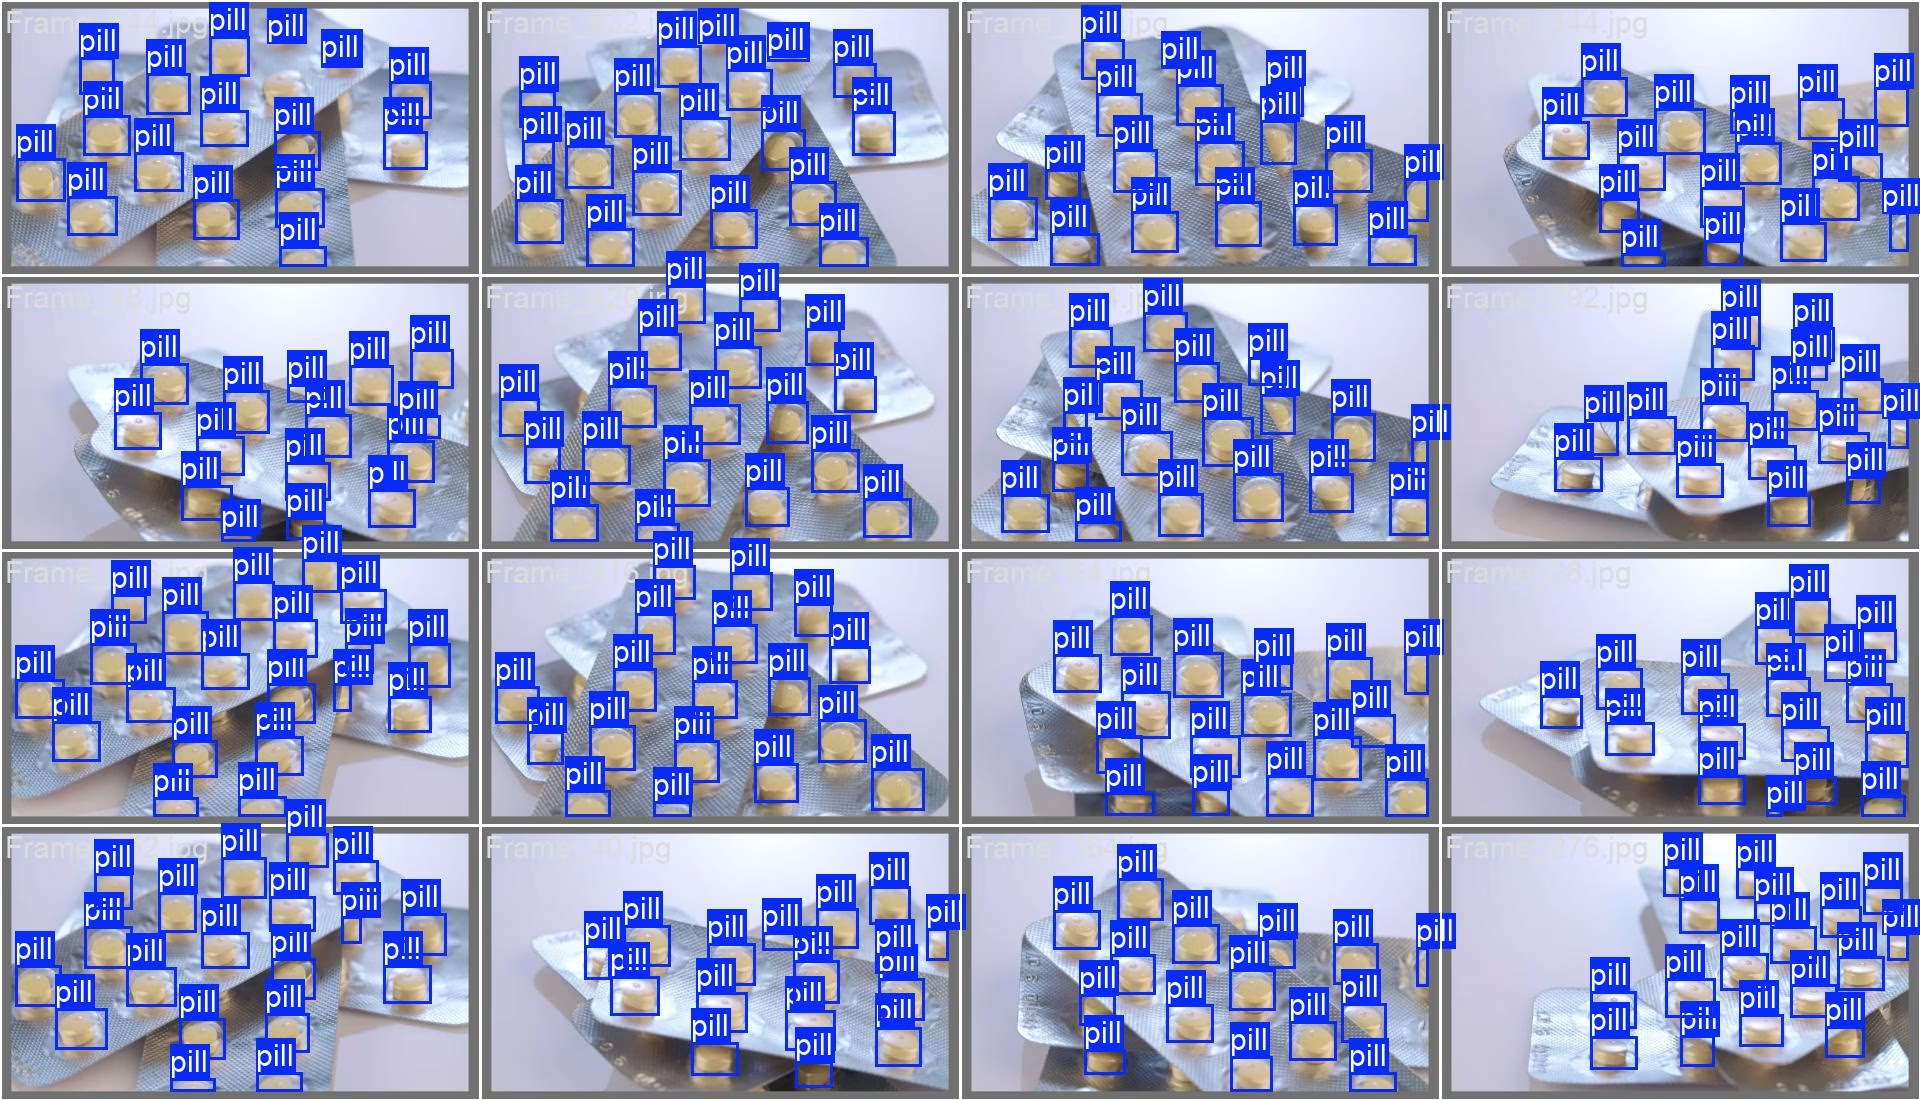
- Mosaikbild: Zu sehen ist ein Trainingsbatch aus mosaikierten Dataset-Bildern. Die Mosaikdarstellung erhöht die Vielfalt der Trainingsdaten, indem mehrere Bilder zu einem zusammengefügt werden, wodurch die Generalisierungsfähigkeit des Modells verbessert wird.
Integration mit anderen Datensätzen#
Für umfassendere pharmazeutische Analysen kannst du den Datensatz Medical Pills mit anderen verwandten Datensätzen kombinieren, etwa mit package-seg zur Identifizierung von Verpackungen oder mit Bildgebungsdatensätzen aus der Medizin wie brain-tumor, um durchgängige KI-Lösungen für das Gesundheitswesen zu entwickeln.
Zitate und Danksagungen#
Der Datensatz ist unter der AGPL-3.0-Lizenz verfügbar.
Wenn du den Datensatz Medical Pills für deine Forschung oder Entwicklungsarbeit verwendest, zitiere ihn bitte mit den genannten Angaben:
@dataset{Jocher_Ultralytics_Datasets_2024,
    author = {Jocher, Glenn and Rizwan, Muhammad},
    license = {AGPL-3.0},
    month = {Dec},
    title = {Ultralytics Datasets: Medical-pills Detection Dataset},
    url = {https://docs.ultralytics.com/datasets/detect/medical-pills},
    version = {1.0.0},
    year = {2024}
}
Häufig gestellte Fragen#
Der Datensatz Medical Pills umfasst insgesamt 115 Bilder – 92 für das Training und 23 für die Validierung – und hat keinen separaten Testsatz. Jedes Bild ist mit einer einzigen Klasse annotiert:
pill. Der Datensatz wird als automatischer Download mit einer Größe von 8,19 MB bereitgestellt, der in der Konfigurationmedical-pills.yamldefiniert ist.Du kannst ein YOLO26-Modell mit den bereitgestellten Python- oder CLI-Methoden 100 Epochen lang mit einer Bildgröße von 640 px trainieren. Ausführliche Anweisungen findest du im Abschnitt Trainingsbeispiel. Weitere Informationen zu den Modellfunktionen enthält die YOLO26-Dokumentation.
Der Datensatz ermöglicht die Automatisierung der Pillenerkennung und trägt so zur Fälschungsprävention, Qualitätssicherung und Optimierung pharmazeutischer Prozesse bei. Außerdem ist er eine wertvolle Ressource für die Entwicklung von KI-Lösungen, die die Arzneimittelsicherheit und die Effizienz der Lieferkette verbessern können.
Die Inferenz lässt sich mit Python- oder CLI-Methoden und einem feinabgestimmten YOLO26-Modell durchführen. Codebeispiele findest du im Abschnitt Inferenzbeispiel; weitere Optionen werden in der Dokumentation zum Vorhersagemodus beschrieben.
Die YAML-Datei ist unter medical-pills.yaml verfügbar. Sie enthält Dataset-Pfade, Klassen und weitere Konfigurationsdetails, die für das Training von Modellen mit diesem Datensatz erforderlich sind.