Wissensdestillation#
Schnellstart#
Trainiere ein kleineres Schülermodell mithilfe eines größeren Lehrermodells, indem du das Argument distill_model hinzufügst:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt")
Was ist Wissensdestillation?#
Bei der Wissensdestillation wird Wissen von einem großen, präzisen Lehrermodell auf ein kleineres Schülermodell übertragen. Das Schülermodell lernt, die internen Merkmalsrepräsentationen des Lehrermodells nachzubilden, und erreicht dabei oft eine höhere Genauigkeit als beim Training von Grund auf.
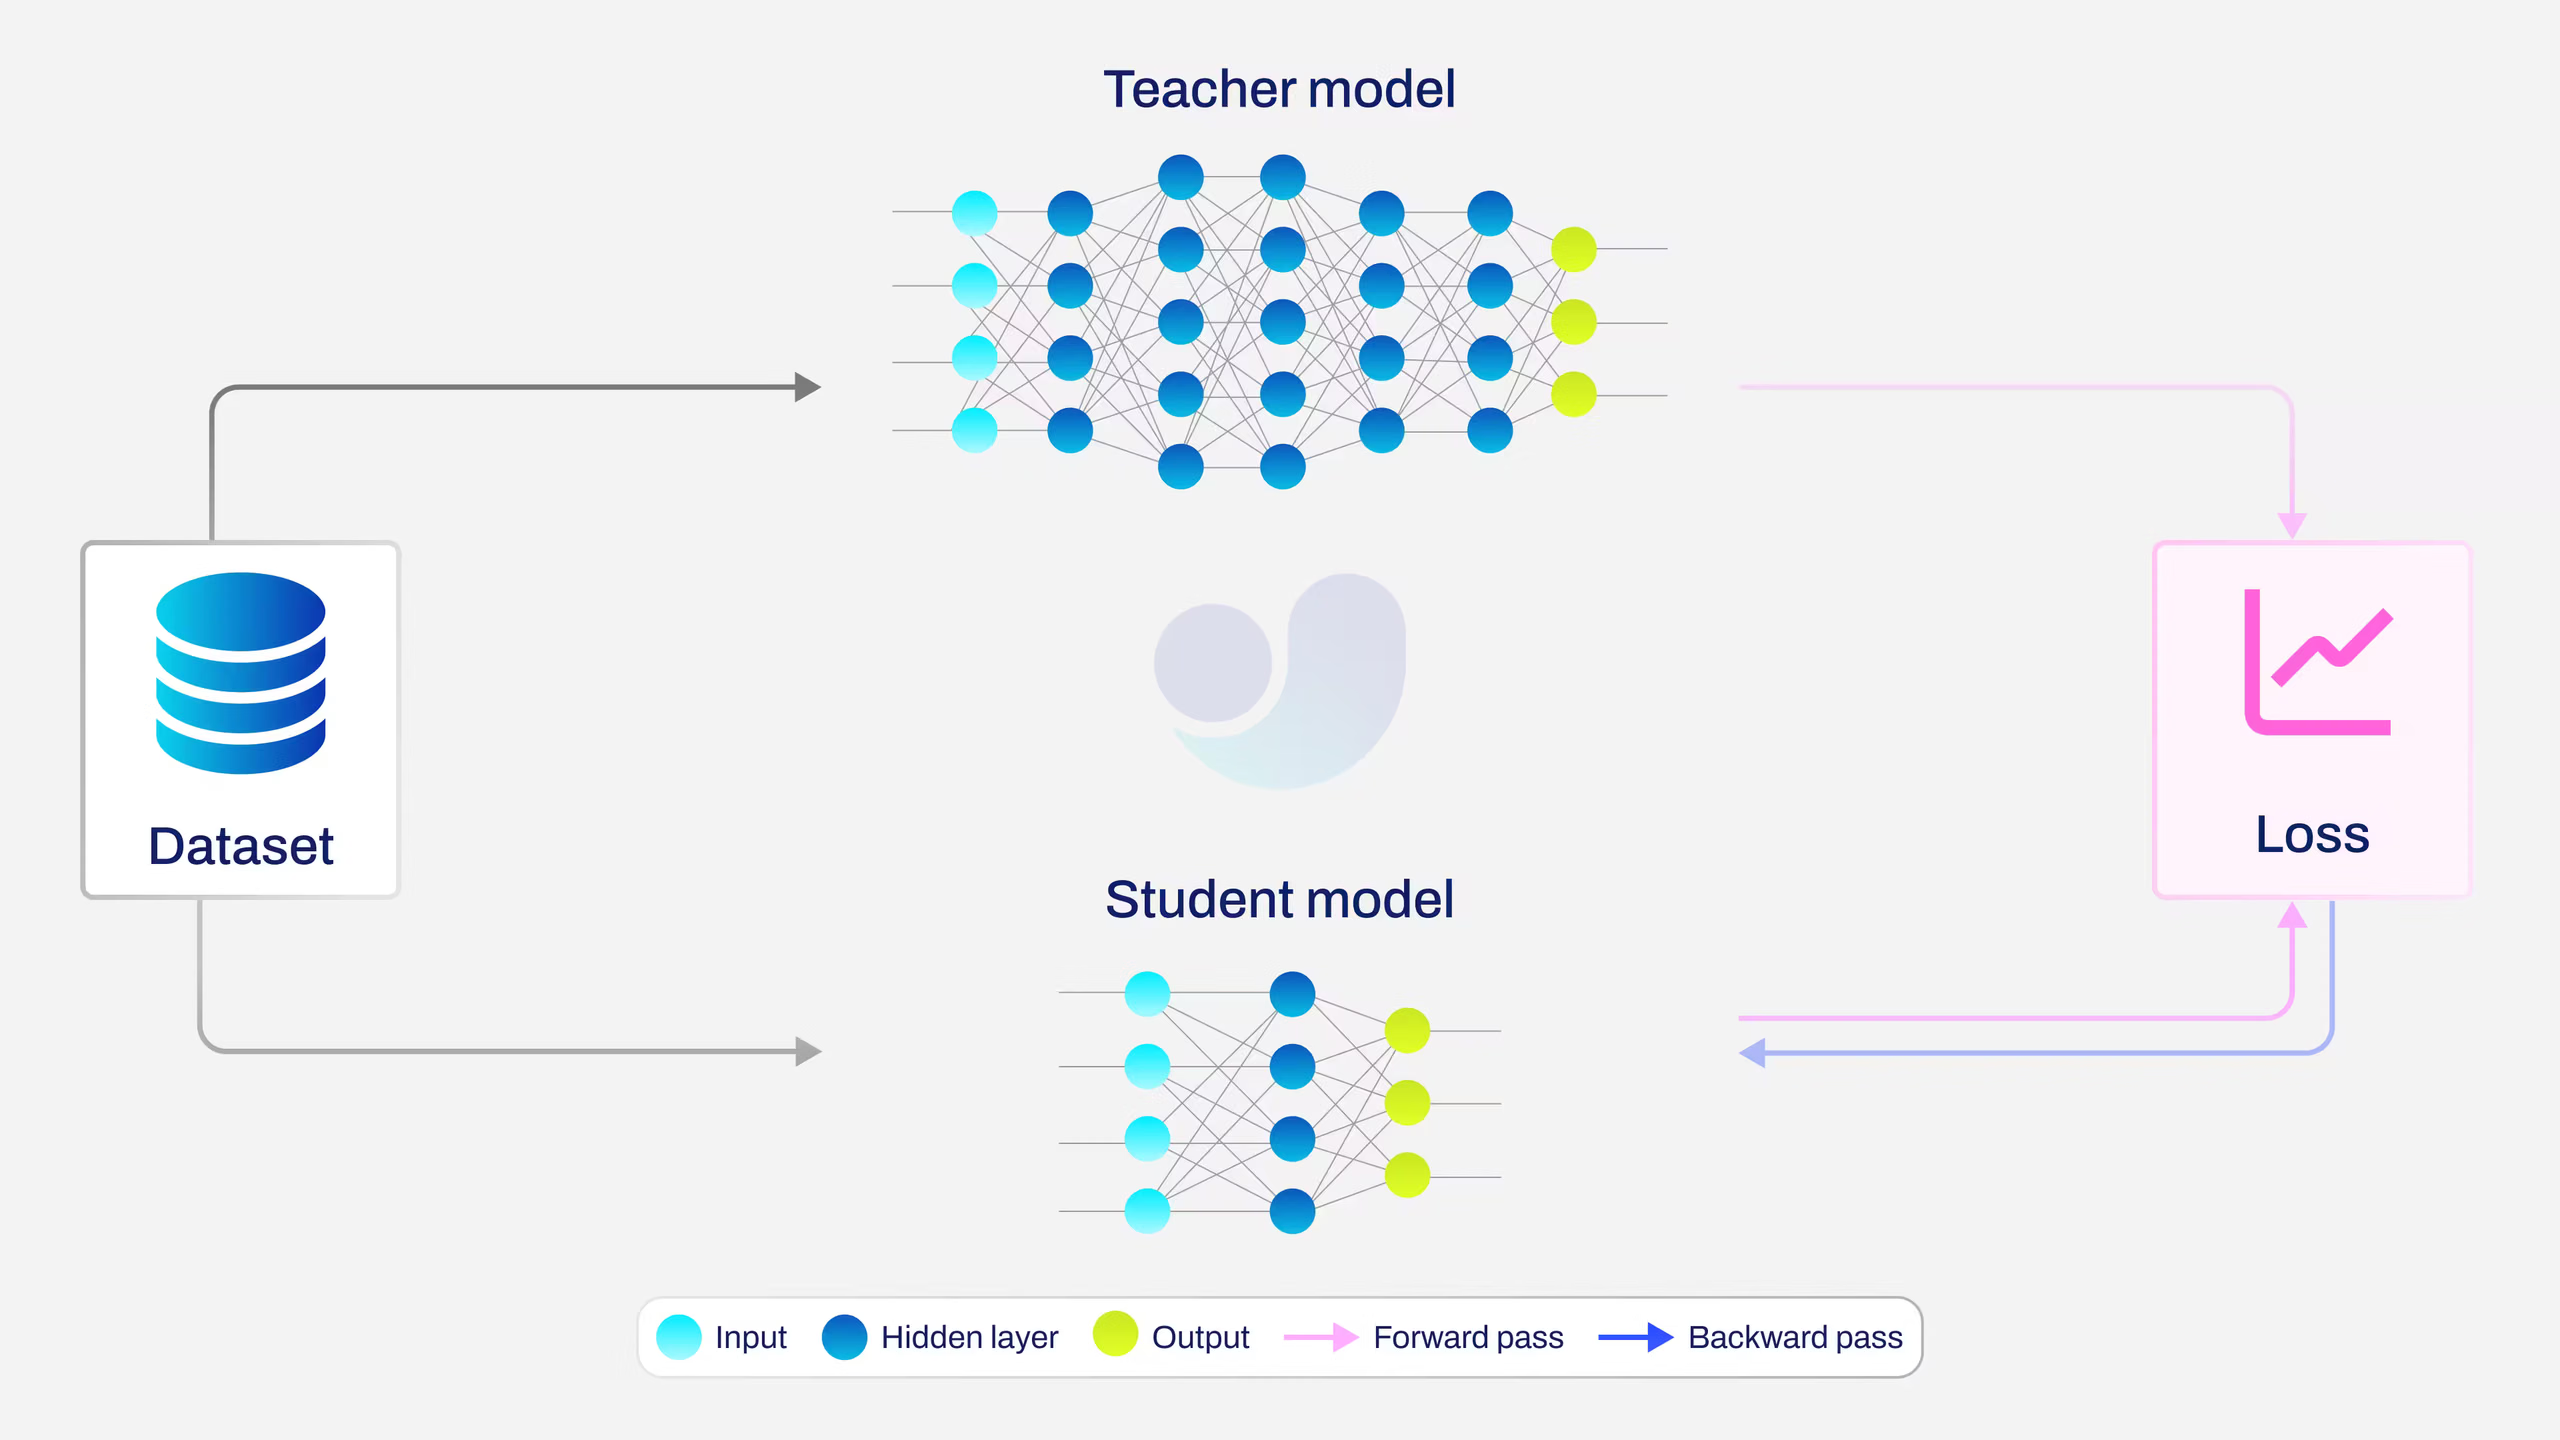
Setze Destillation ein, wenn:
- du ein kleineres, schnelleres Modell für den Einsatz benötigst
- du ein hochpräzises Lehrermodell hast, das mit denselben Daten trainiert wurde
- du eine höhere Genauigkeit erzielen möchtest, als sie beim standardmäßigen Training möglich ist
Wissensdestillation ist für die Aufgaben detect, segment, pose und obb implementiert. Bisher wurde nur detect experimentell auf Genauigkeitsverbesserungen überprüft.
Leistung#
Die Wissensdestillation verbessert die mAP der Schülermodelle in der gesamten YOLO26-Familie auf COCO, ohne die Inferenzkosten zu erhöhen. Die folgende Tabelle vergleicht die standardmäßigen YOLO26-Modelle (Basiswerte) mit denselben Modellen, die mithilfe des jeweils empfohlenen Lehrermodells destilliert trainiert wurden.
| Modell | Größe (Pixel) | mAPval 50-95 Basiswert | mAPval 50-95 destilliert | mAPval 50-95 (e2e) Basiswert | mAPval 50-95 (e2e) destilliert |
|---|---|---|---|---|---|
| YOLO26n-distill | 640 | 40.9 | 41.5 | 40.1 | 40.9 |
| YOLO26s-distill | 640 | 48.6 | 49.2 | 47.8 | 48.6 |
| YOLO26m-distill | 640 | 53.1 | 53.9 | 52.5 | 53.3 |
| YOLO26l-distill | 640 | 55.0 | 56.0 | 54.4 | 55.5 |
| YOLO26x-distill | 640 | 57.5 | 57.9 | 56.9 | 57.4 |
- Die Werte für mAPval beziehen sich auf einen einzelnen Modelllauf mit einer Skala auf dem Datensatz COCO val2017.
Erzeuge eine destillierte Tabellenzeile mityolo val detect model=yolo26n-distill.pt data=coco.yaml device=0; fügenms=Falsefür die e2e-Spalte hinzu. - Die e2e-Werte verwenden den NMS-freien Inferenzpfad (
nms=False); die Werte ohne e2e nutzen die standardmäßige NMS-Nachverarbeitung (nms=None). Einzelheiten findest du unter End-to-End-Objekterkennung.
Voraussetzungen#
Stelle vor dem Start sicher, dass du die folgenden Voraussetzungen erfüllst:
- Trainiertes Lehrermodell: ein
.pt-Checkpoint aus derselben YOLO-Familie wie das Schülermodell. - Übereinstimmende Aufgabe: Verwende ein Lehrermodell für dieselbe Aufgabe wie das Schülermodell und trainiere es mit relevanten Daten.
- GPU-Ressourcen: ausreichend Speicher für beide Modelle; das Lehrermodell führt nur Vorwärtsdurchläufe aus, ohne Gradienten oder Optimiererzustand.
Empfohlene Modellpaare#
| Schülermodell | Empfohlenes Lehrermodell |
|---|---|
yolo26n.pt | yolo26s.pt |
yolo26s.pt | yolo26m.pt |
yolo26m.pt | yolo26x.pt |
yolo26l.pt | yolo26x.pt |
Die Destillation zwischen verschiedenen Modellfamilien (z. B. ein YOLO11-Lehrermodell mit einem YOLO26-Schülermodell) wird nicht unterstützt.
Wichtige Parameter#
| Parameter | Typ | Standard | Beschreibung |
|---|---|---|---|
distill_model | str | None | Pfad zur Modelldatei des Lehrermodells (z. B. yolo26x.pt). Wenn du diesen Parameter festlegst, wird die Wissensdestillation aktiviert. |
dis | float | 6.0 | Gewicht der Destillationsverlustfunktion. Legt fest, welchen Anteil die Destillationsverlustfunktion am gesamten Trainingsverlust hat. |
So funktioniert es#
- Das Lehrermodell bleibt im Modus
evaleingefroren und führt für jeden Batch eine Inferenz aus. - Das Schülermodell wird mit den standardmäßigen aufgabenspezifischen Verlustfunktionen und zusätzlicher Anleitung durch die Destillation trainiert.
- Merkmale werden bei beiden Modellen aus den drei Neck-Schichten extrahiert, die den Kopf der Detect-Familie speisen.
- Ein Projektor aus zwei 1×1-Faltungen mit ReLU passt jede Merkmalskarte des Schülermodells an die Kanalzahl des Lehrermodells an.
- Eine bewertungsgewichtete L2-Verlustfunktion vergleicht die projizierten Merkmale des Schülermodells mit denen des Lehrermodells. Dabei werden die Merkmale entsprechend der Klassifikationssicherheit des Lehrermodells gewichtet.
- Die Destillationsverlustfunktion wird mithilfe des Gewichts
dismit den standardmäßigen Verlustfunktionen kombiniert.
flowchart TD
    A[Input Image Batch]:::start --> T[Teacher Model<br/>frozen, eval mode]:::extern
    A --> S[Student Model<br/>trainable]:::proc

    T --> |Detect head inputs| TF[Teacher Features]:::extern
    S --> |Detect head inputs| SF[Student Features]:::proc

    SF --> P[1×1 Conv Projector<br/>with ReLU]:::decide
    P --> AF[Aligned Student Features]:::proc

    TF --> SW[Score-weighted L2 Loss]:::proc
    AF --> SW

    S --> D[Detection Head]:::proc
    D --> DL[box_loss + cls_loss + l1_loss]:::proc

    SW --> |× dis| DIS[distillation loss]:::proc
    DL --> TOTAL[Total Loss]:::out
    DIS --> TOTAL

    TOTAL --> BP[Backpropagate<br/>Student + Projector only]:::out

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
    classDef decide fill:#FF9800,color:#fff
    classDef out fill:#9C27B0,color:#fff
    classDef extern fill:#607D8B,color:#fff
Unterstützte Aufgaben#
Die Destillationsimplementierung extrahiert Merkmale aus den drei Neck-Schichten, die den Kopf der Detect-Familie des Modells speisen. Da die Köpfe für segment, pose und obb von derselben Architektur Detect abgeleitet sind, ist die Destillation technisch auch mit diesen Aufgaben kompatibel.
Klassifikation, semantische Segmentierung, Tiefenschätzung und RT-DETR verwenden keinen kompatiblen Kopf der Detect-Familie und werden nicht unterstützt.
Nur detect wurde experimentell geprüft und verifiziert. Du kannst Destillation für segment, pose oder obb ausführen, aber Genauigkeitsverbesserungen für diese Aufgaben sind noch nicht validiert.
from ultralytics import YOLO

# Segment
model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=100, distill_model="yolo26s-seg.pt")

# Pose
model = YOLO("yolo26n-pose.pt")
model.train(data="coco8-pose.yaml", epochs=100, distill_model="yolo26s-pose.pt")

# OBB
model = YOLO("yolo26n-obb.pt")
model.train(data="dota8.yaml", epochs=100, distill_model="yolo26s-obb.pt")Training#
Grundlegendes Training#
Das Training mit Destillation funktioniert genauso wie das standardmäßige Training. Gib den Pfad distill_model an, um die Destillation zu aktivieren:
from ultralytics import YOLO

# Schülermodell laden
student = YOLO("yolo26m.pt")

# Mit Wissensdestillation durch ein größeres Lehrermodell trainieren
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26x.pt")
Gewicht der Destillationsverlustfunktion anpassen#
Der Parameter dis (Standardwert: 6.0) legt den Beitrag der Destillationsverlustfunktion fest:
from ultralytics import YOLO

student = YOLO("yolo26n.pt")
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt", dis=10.0)
Destillationstraining fortsetzen#
Das Destillationstraining kann anhand von Checkpoints fortgesetzt werden. Das Lehrermodell wird automatisch anhand des im Checkpoint gespeicherten Pfads distill_model neu erstellt:
from ultralytics import YOLO

student = YOLO("runs/detect/train/weights/last.pt")
results = student.train(resume=True)Trainingsausgabe#
Wenn die Destillation aktiviert ist, erscheint in den Trainingsprotokollen eine zusätzliche Spalte dis_loss:
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss   dis_loss  Instances       Size
      1/80      46.2G      1.566      5.404    0.003249      6.658        231        640
Das exportierte Modell enthält nur die Gewichte des Schülermodells – Dateigröße und Inferenzgeschwindigkeit entsprechen denen eines regulär trainierten Schülermodells.
Häufig gestellte Fragen#
- Prüfe, ob das Lehrermodell und das Schülermodell aus derselben YOLO-Generation stammen.
- Vergewissere dich, dass der Pfad
distill_modelkorrekt ist und die Datei geladen werden kann. - Erhöhe
dis, wenn der Verlustwert sehr klein ist. - Stelle sicher, dass das Lehrermodell mit demselben Datensatz trainiert wurde.
Füge den Parameter
distill_modelhinzu – alles andere funktioniert genauso. Während des Trainings wird zusätzlich eine Destillationsverlustfunktion berechnet, aber das gespeicherte Modell ist ein standardmäßiges YOLO-Modell ohne zusätzlichen Aufwand.Ja. Das Lehrermodell führt für jeden Batch einen zusätzlichen Vorwärtsdurchlauf aus. Der Zeit- und Speicheraufwand hängt daher vom jeweiligen Lehrer-Schüler-Paar ab. Das Lehrermodell läuft im Modus
eval, ohne Gradienten oder Optimiererzustand.Wissensdestillation funktioniert mit den Aufgaben detect, segment, pose und obb, da dabei Merkmale aus den drei Neck-Schichten destilliert werden, die den Kopf der Detect-Familie speisen. classify, semantic, depth und RT-DETR werden nicht unterstützt.
Nur detect wurde experimentell auf Genauigkeitsverbesserungen überprüft. Segmentierung, Pose und OBB sind technisch kompatibel, wurden aber noch nicht benchmarkseitig bewertet.
Lehrermodell und Schülermodell müssen zur selben YOLO-Familie gehören (z. B. YOLOv8, YOLO11 oder YOLO26). Eine familienübergreifende Destillation (z. B. mit YOLO11 als Lehrermodell und YOLO26 als Schülermodell) wird nicht unterstützt.