Von Ultralytics YOLO26 unterstützte Computer-Vision-Aufgaben
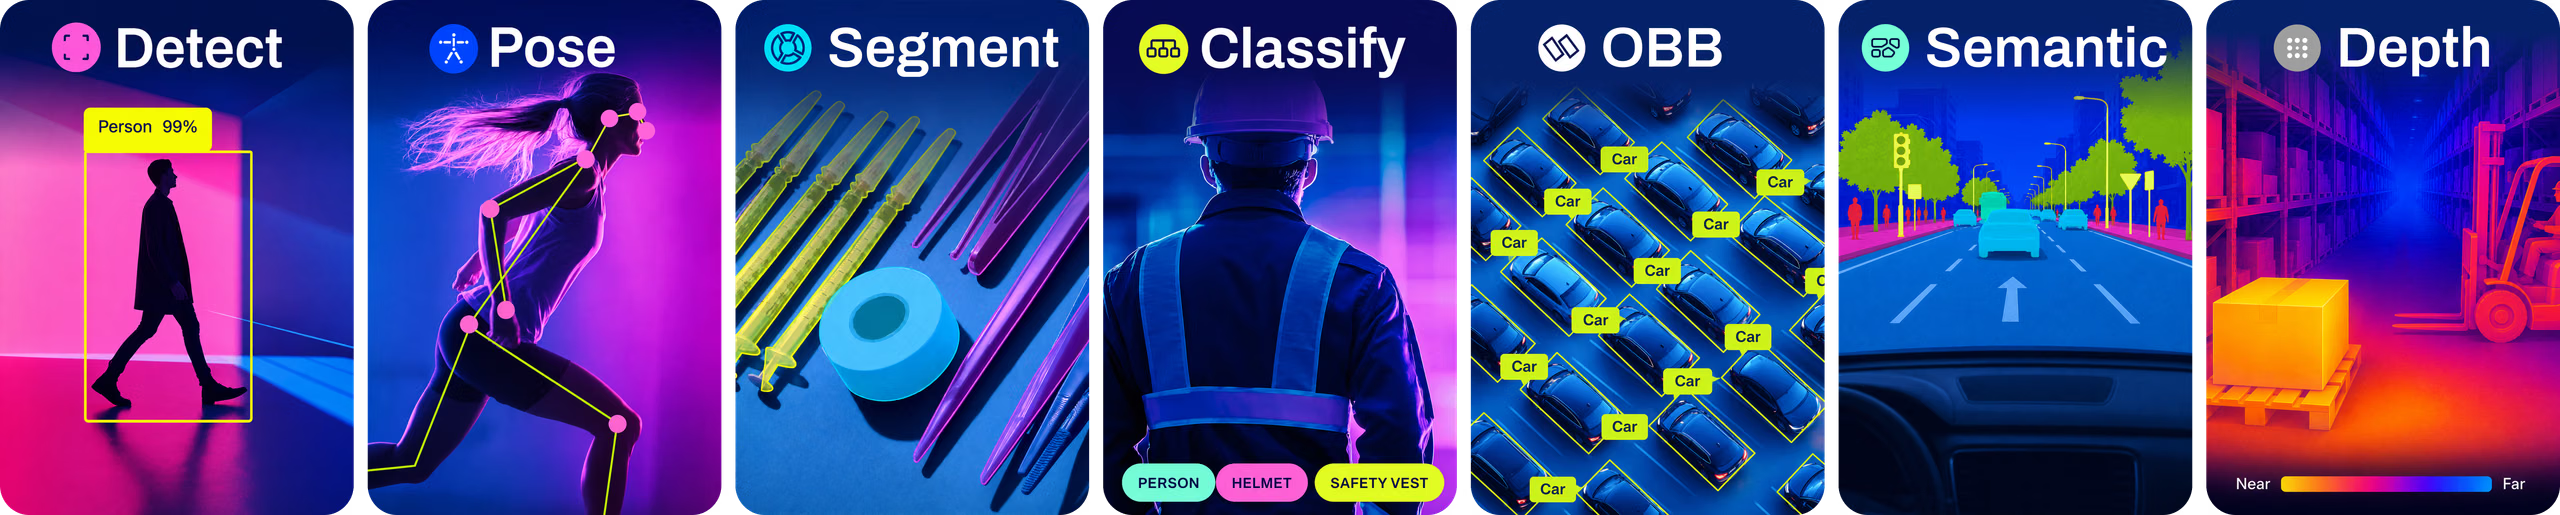
Ultralytics YOLO26 unterstützt mehrere Aufgaben im Bereich Computer Vision: Objekterkennung, Segmentierung, semantische Segmentierung, Tiefenschätzung, Klassifizierung, Pose-Schätzung und OBB. Jede Aufgabe hat ein anderes Ziel und Einsatzgebiet, sodass du mit einem einzigen Framework eine Vielzahl von Problemen im Bereich Computer Vision lösen kannst.
Informationen zur geplanten Unterstützung von YOLO27 findest du in der YOLO27-Vorschau. YOLO27 erscheint in Kürze und ist noch nicht verfügbar; in diesem Leitfaden kommen veröffentlichte YOLO26-Modelle zum Einsatz.
Ansehen: Entdecke die Aufgaben von Ultralytics YOLO26: Objekterkennung, Instanzsegmentierung, semantische Segmentierung, Tiefenschätzung, Klassifizierung, Pose-Schätzung und OBB.
Erkennung#
Objekterkennung ist die wichtigste von YOLO26 unterstützte Aufgabe. Dabei werden Objekte in einem Bild oder Videobild erkannt und mit Begrenzungsrahmen umrandet. Die erkannten Objekte werden anhand ihrer Merkmale verschiedenen Kategorien zugeordnet. YOLO26 erkennt schnell genug mehrere Objekte in einem einzelnen Bild oder Videobild für Echtzeitanwendungen wie Überwachungssysteme und autonome Fahrzeuge.
Instanzsegmentierung#
Die Instanzsegmentierung geht über die Objekterkennung hinaus und erzeugt Pixelmasken für jedes Objekt. Diese Präzision ist für Anwendungen wie medizinische Bildgebung, landwirtschaftliche Analysen und Qualitätskontrolle in der Fertigung nützlich.
Semantische Segmentierung#
Die semantische Segmentierung weist jedem Pixel eines Bildes eine Klassenbezeichnung zu und erstellt so eine dichte Klassenkarte der gesamten Szene. Anders als bei der Instanzsegmentierung werden einzelne Objekte derselben Klasse nicht voneinander unterschieden. Das macht sie besonders geeignet für autonomes Fahren, Szeneninterpretation und Landbedeckungskartierung, bei denen das Verständnis der gesamten räumlichen Anordnung wichtiger ist als die Identifizierung einzelner Objekte.
Beispiele zur semantischen Segmentierung
Tiefenschätzung#
Die monokulare Tiefenschätzung sagt anhand eines einzelnen RGB-Bildes eine Tiefenkarte in Metern für jedes Pixel voraus. Die Ausgabe ist eine dichte Gleitkommakarte, die am Eingabebild ausgerichtet ist. Dadurch eignet sie sich für die 3D-Szenenrekonstruktion, die Navigation von Robotern und AR-/VR-Anwendungen, bei denen die räumliche Anordnung aus einer einzelnen Kamera abgeleitet werden muss.
Klassifizierung#
Bei der Bildklassifizierung werden ganze Bilder anhand ihres Inhalts kategorisiert. Diese Aufgabe eignet sich für Anwendungen wie die Produktkategorisierung im E-Commerce, die Inhaltsmoderation und die Überwachung von Wildtieren.
Posenschätzung#
Die Pose-Schätzung erkennt bestimmte Schlüsselpunkte in Bildern oder Videobildern, um Bewegungen zu verfolgen oder Posen zu schätzen. Diese Schlüsselpunkte können menschliche Gelenke, Gesichtsmerkmale oder andere wichtige Punkte darstellen. Die Pose-Modelle von YOLO26 erkennen Schlüsselpunkte in Echtzeit und eignen sich daher für Fitnessanwendungen, Sportanalysen und die Mensch-Computer-Interaktion.
OBB#
Die Erkennung orientierter Begrenzungsrahmen (OBB) erweitert die herkömmliche Objekterkennung um einen Ausrichtungswinkel, mit dem gedrehte Objekte genauer lokalisiert werden. Diese Funktion ist besonders wertvoll für die Analyse von Luftbildern, die Dokumentenverarbeitung und industrielle Anwendungen, bei denen Objekte in verschiedenen Winkeln erscheinen. Die OBB-Modelle von YOLO26 sind mit dem Luftbilddatensatz DOTAv1 vortrainiert.
Wie geht es weiter?#
Hast du dich für eine Aufgabe entschieden? Formatiere deine Daten dafür mit dem Leitfaden zu Datensätzen und trainiere anschließend mit deinen eigenen Bildern.
Häufig gestellte Fragen#
Ultralytics YOLO26 unterstützt die folgenden Computer-Vision-Aufgaben:
- Objekterkennung: Objekte in Bildern oder Videobildern erkennen und lokalisieren, indem Begrenzungsrahmen um sie gezogen werden.
- Instanzsegmentierung: Für jedes erkannte Objekt eine Maske auf Pixelebene erstellen, was beispielsweise für medizinische Bildgebung nützlich ist.
- Semantische Segmentierung: Jedem Pixel in einem Bild eine Klassenbezeichnung zuweisen, um eine dichte Szenenerfassung zu ermöglichen.
- Tiefenschätzung: Aus einem einzelnen RGB-Bild eine Tiefenkarte in Metern für jedes Pixel vorhersagen.
- Klassifizierung: Ganze Bilder anhand ihres Inhalts kategorisieren.
- Posenschätzung: Bestimmte Schlüsselpunkte in einem Bild oder Videobild erkennen, um Bewegungen oder Posen zu verfolgen.
- Erkennung orientierter Objekte (OBB): Gedrehte Objekte mit einem zusätzlichen Ausrichtungswinkel erkennen, um die Genauigkeit zu erhöhen.
Gehe wie folgt vor, um Ultralytics YOLO26 zur Objekterkennung zu verwenden:
- Bereite deinen Datensatz im passenden Format vor.
- Trainiere das YOLO26-Modell mit der Erkennungsaufgabe.
- Lass das Modell Vorhersagen erstellen, indem du neue Bilder oder Videobilder einspeist.
Beispielfrom ultralytics import YOLO # Ein vortrainiertes YOLO-Modell laden (den Modelltyp bei Bedarf anpassen) model = YOLO("yolo26n.pt") # Versionen n, s, m, l und x verfügbar # Objekterkennung in einem Bild durchführen results = model.predict(source="image.jpg") # Du kannst auch ein Video, ein Verzeichnis, eine URL usw. verwenden. # Ergebnisse anzeigen results[0].show() # Ergebnisse des ersten Bildes anzeigenAusführlichere Anweisungen findest du in unseren Beispielen zur Erkennung.
Die Verwendung von YOLO26 für Segmentierungsaufgaben bietet mehrere Vorteile:
- Hohe Genauigkeit: Die Segmentierungsaufgabe liefert präzise Masken auf Pixelebene.
- Geschwindigkeit: YOLO26 ist für Echtzeitanwendungen optimiert und verarbeitet auch hochauflösende Bilder schnell.
- Vielfältige Anwendungen: Das Modell eignet sich ideal für die medizinische Bildgebung, autonomes Fahren und andere Anwendungen, die eine detaillierte Bildsegmentierung erfordern.
Weitere Informationen zu den Vorteilen und Anwendungsfällen von YOLO26 für die Segmentierung findest du im Abschnitt zur Bildsegmentierung.
Ja. Die Pose-Modelle von YOLO26 erkennen Schlüsselpunkte, zum Beispiel menschliche Gelenke, in Bildern und Videobildern und verbinden sie zu Posen. Das ist nützlich, um Bewegungen in Sportanalysen, im Gesundheitswesen und bei Anwendungen zur Mensch-Computer-Interaktion zu verfolgen.
Weitere Informationen und Hinweise zur Implementierung findest du in unseren Beispielen zur Posenschätzung.
Die Erkennung orientierter Objekte (OBB) mit YOLO26 sagt für jeden Rahmen einen zusätzlichen Winkelparameter voraus. Dadurch werden gedrehte Objekte genauer lokalisiert als mit achsenparallelen Rahmen. Das ist für Anwendungen vorteilhaft, die eine präzise Lokalisierung gedrehter Objekte erfordern, etwa die Analyse von Luftbildern und die Lagerautomatisierung.
- Enger anliegende Rahmen: Gedrehte Rahmen enthalten weniger Hintergrund und helfen dabei, dicht gedrängte oder schräg ausgerichtete Objekte voneinander abzugrenzen.
- Vielfältige Einsatzmöglichkeiten: Nützlich für Aufgaben in der Geodatenanalyse, der Robotik usw.
Weitere Informationen und Beispiele findest du im Abschnitt zur Erkennung orientierter Objekte.


Kommentare15
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
adhinajay
I quantized a YOLOv8 model. Now I want to fine tune it, so how can I convert the ONNX file back to a .pt file?
DukeZacharia
Yes, you can utilize Explainable AI (XAI) with YOLOv9 or YOLOv11,
even though these versions are unofficial or experimental extensions beyond YOLOv8.
YOLO is fundamentally a convolutional neural network (CNN),
which means that many XAI techniques applicable to CNNs or object detection models can be adapted for use with these versions.
On Thu, 12 Jun 2025 at 17:27, Md Saimul Haque Shanto < @.***> wrote:
Can I use XAI with YOLOv11 or YOLOv9 ? If so, how can I apply it to an object detection task?
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/16241#discussioncomment-13443327, or unsubscribe https://github.com/notifications/unsubscribe-auth/AGZSZVZYSGD2CDV75M5O7KD3DE2XNAVCNFSM6AAAAABOCSRMJGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTGNBUGMZTENY . You are receiving this because you were mentioned.Message ID: @.*** com>
Saimul-Shanto
Can I use XAI with YOLOv11 or YOLOv9 ? If so, how can I apply it to an object detection task?
AashishThakur1321
how can I provide different object ids in videos to same types of objects like there are 5 persons in a video frame, then how to provide different ids to these persons such that it tracks these objects with same id throughout the videos
 Glenn JocherUltralytics(bearbeitet)
@AashishThakur1321 to track multiple persons with unique IDs in videos using YOLO, utilize the built-in tracking mode with
tracker=botsort.yamlortracker=bytetrack.yamlconfiguration. Example CLI command:
yolo track model=yolo26n.pt source=video.mp4
This automatically assigns unique IDs to each person and maintains them across frames. For customization, see our tracking documentation.
Good, Afternoon, does Yolo work for Human Action Detection in realtime?
- Glenn JocherUltralytics
@DukeZacharia good afternoon! YOLO can be used for real-time human action detection through pose estimation. For more details, please explore the pose estimation section in the Ultralytics documentation.
1
NasserAlqeifi
Hi there! Could anyone point me to the papers for YOLOv8 and YOLOv11 Instance Segmentation? Thank you!
- Glenn JocherUltralytics(bearbeitet)
@NasserAlqeifi hello! Ultralytics has not published formal research papers for YOLOv8 and YOLO11. YOLO26 does have a paper, see the YOLO26 docs. For detailed information on segmentation, please refer to the Ultralytics documentation. If you have further questions, feel free to ask!
1 Hi @glenn-jocher ,
Thank you for the information! I'm a master's student currently using the YOLOv8 Instance Segmentation model for my thesis. I've also tried using YOLOv11 and noticed that the documentation mentions it utilizes a variant of the U-Net architecture for segmentation.
I would love to know more about how segmentation and object detection work in YOLOv11, as well as the key differences between YOLOv8 and YOLOv11 in these tasks. Any additional insights would be greatly appreciated!
Thank you!
- Glenn JocherUltralytics(bearbeitet)
Thank you for your interest! Instance segmentation in YOLOv8 and YOLO11 is not based on U-Net. It uses the YOLO detection head with an additional prototype-mask branch that produces the masks. For more details, please refer to the segmentation docs; for new projects we recommend YOLO26.
hrbjoern
Would be nice to have examples for tracking, too ...
- Glenn JocherUltralytics
@hrbjoern thank you for your suggestion! We currently have tracking examples in our documentation. You can explore them for more insights on implementing tracking with YOLOv8.
OK, thanks. I just figured that since it's mentioned in the beginning of the page (photo), it should also be explained ...
- Glenn JocherUltralytics
Yes sorry for the confusion. We've placed the Tracking docs under Modes rather than Tasks here: https://docs.ultralytics.com/modes/track/
1