K-fache Kreuzvalidierung mit Ultralytics
Einführung#
Dieser Leitfaden zeigt, wie du K-fache Kreuzvalidierung für Objekterkennungs-Datensätze im Ultralytics-Ökosystem implementierst. Anhand des YOLO-Erkennungsformats und Python-Bibliotheken wie scikit-learn, pandas und PyYAML führt er dich durch die Einrichtung, die Erstellung von Merkmalsvektoren und die Aufteilung eines Datensatzes für die K-fache Kreuzvalidierung.
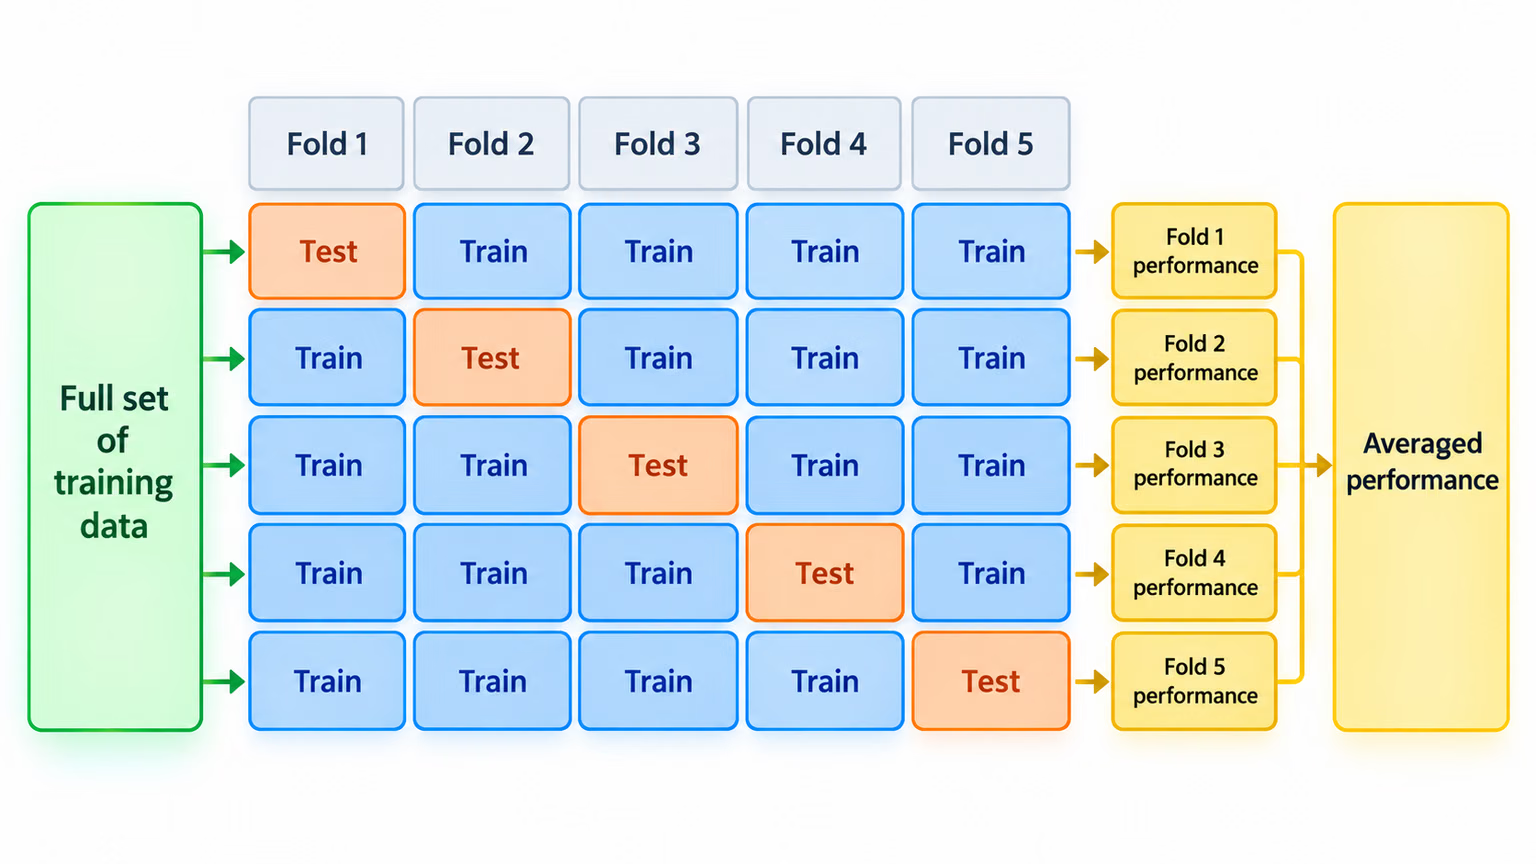
Ob dein Projekt den Fruit Detection-Datensatz oder eine benutzerdefinierte Datenquelle verwendet – dieses Tutorial hilft dir dabei, die K-fache Kreuzvalidierung zu verstehen und anzuwenden, um die Zuverlässigkeit und Robustheit deiner Modelle für maschinelles Lernen zu verbessern. In diesem Tutorial verwenden wir k=5 Folds. Beachte jedoch, dass die optimale Anzahl der Folds je nach Datensatz und den Anforderungen deines Projekts variieren kann. Besonders hilfreich ist die K-fache Kreuzvalidierung bei kleinen, verrauschten oder stark variierenden Datensätzen. Bei großen, vielfältigen Datensätzen reicht in der Regel eine sorgfältig erstellte Aufteilung in Trainings-, Validierungs- und Testdaten aus.
Einrichtung#
-
Deine Annotationen sollten im YOLO-Erkennungsformat vorliegen.
-
Diese Anleitung setzt voraus, dass die Annotationsdateien lokal verfügbar sind.
-
Für unsere Demonstration verwenden wir den Datensatz Fruit Detection.
- Dieser Datensatz umfasst insgesamt 8479 Bilder.
- Er enthält 6 Klassenbezeichnungen. Die Gesamtzahl der Instanzen pro Klasse ist unten aufgeführt.
| Klassenbezeichnung | Anzahl der Instanzen |
|---|---|
| Apfel | 7049 |
| Trauben | 7202 |
| Ananas | 1613 |
| Orange | 15549 |
| Banane | 3536 |
| Wassermelone | 1976 |
-
Zu den benötigten Python-Paketen gehören:
ultralyticssklearnpandaspyyaml
-
In diesem Tutorial verwenden wir
k=5Folds. Du solltest jedoch die für deinen konkreten Datensatz am besten geeignete Anzahl an Folds ermitteln.
-
Erstelle eine neue virtuelle Python-Umgebung (
venv) für dein Projekt und aktiviere sie. Installiere das Paket mitpipoder deinem bevorzugten Paketmanager:- Die Ultralytics-Bibliothek:
pip install -U ultralytics. Alternativ kannst du das offizielle Repository klonen. - Scikit-learn, pandas und PyYAML:
pip install -U scikit-learn pandas pyyaml.
- Die Ultralytics-Bibliothek:
-
Vergewissere dich, dass deine Annotationen im YOLO-Erkennungsformat vorliegen.
- Für dieses Tutorial befinden sich alle Annotationsdateien im Verzeichnis
Fruit-Detection/labels.
- Für dieses Tutorial befinden sich alle Annotationsdateien im Verzeichnis
Merkmalsvektoren für einen Objekterkennungsdatensatz erstellen#
-
Erstelle zunächst eine neue Python-Datei namens
example.py, um die folgenden Schritte auszuführen. -
Lade die Trainings- und Validierungsbilder, die in der YAML-Datei deines Datensatzes aufgeführt sind, mit der Ultralytics-Klasse
YOLODataset. Lass die Testdaten unverändert.from pathlib import Path from ultralytics.data.dataset import YOLODataset from ultralytics.data.utils import check_det_dataset yaml_file = "path/to/data.yaml" data = check_det_dataset(yaml_file) dataset_path = Path(data["path"]) sources = [] for split in ("train", "val"): source = data.get(split) if source: sources.extend(source if isinstance(source, list) else [source]) dataset = YOLODataset(sources, data=data, augment=False) images = [Path(p) for p in dataset.im_files] -
Lies nun den Inhalt der YAML-Datei des Datensatzes aus und extrahiere die Indizes der Klassenbezeichnungen.
classes = data["names"] cls_idx = sorted(classes.keys()) -
Initialisiere einen leeren
pandas-DataFrame.import pandas as pd labels_df = pd.DataFrame(0.0, columns=cls_idx, index=images) -
Zähle die Instanzen jeder Klassenbezeichnung in den Annotationsdateien.
from collections import Counter for image, label in zip(images, dataset.labels): lbl_counter = Counter(label["cls"].flatten().astype(int)) labels_df.loc[image, list(lbl_counter)] = list(lbl_counter.values()) -
Die folgende Ansicht zeigt beispielhaft den ausgefüllten DataFrame:
                                                       0    1    2    3    4    5
'0000a16e4b057580_jpg.rf.00ab48988370f64f5ca8ea4...'  0.0  0.0  0.0  0.0  0.0  7.0
'0000a16e4b057580_jpg.rf.7e6dce029fb67f01eb19aa7...'  0.0  0.0  0.0  0.0  0.0  7.0
'0000a16e4b057580_jpg.rf.bc4d31cdcbe229dd022957a...'  0.0  0.0  0.0  0.0  0.0  7.0
'00020ebf74c4881c_jpg.rf.508192a0a97aa6c4a3b6882...'  0.0  0.0  0.0  1.0  0.0  0.0
'00020ebf74c4881c_jpg.rf.5af192a2254c8ecc4188a25...'  0.0  0.0  0.0  1.0  0.0  0.0
 ...                                                  ...  ...  ...  ...  ...  ...
'ff4cd45896de38be_jpg.rf.c4b5e967ca10c7ced3b9e97...'  0.0  0.0  0.0  0.0  0.0  2.0
'ff4cd45896de38be_jpg.rf.ea4c1d37d2884b3e3cbce08...'  0.0  0.0  0.0  0.0  0.0  2.0
'ff5fd9c3c624b7dc_jpg.rf.bb519feaa36fc4bf630a033...'  1.0  0.0  0.0  0.0  0.0  0.0
'ff5fd9c3c624b7dc_jpg.rf.f0751c9c3aa4519ea3c9d6a...'  1.0  0.0  0.0  0.0  0.0  0.0
'fffe28b31f2a70d4_jpg.rf.7ea16bd637ba0711c53b540...'  0.0  6.0  0.0  0.0  0.0  0.0
Die Zeilen verwenden absolute Bildpfade, während die Spalten den Klassenbezeichnungsindizes entsprechen. Fehlende Bezeichnungen ergeben Zeilen, die ausschließlich aus Nullen bestehen und den Hintergrund darstellen. Diese Datenstruktur ermöglicht die Anwendung der K-fachen Kreuzvalidierung auf einen Objekterkennungsdatensatz.
Aufteilung des Datensatzes in k Folds#
-
Nun verwenden wir die Klasse
KFoldaussklearn.model_selection, um den Datensatz inkFolds aufzuteilen.- Wichtig:
- Mit
shuffle=Truestellst du sicher, dass die Klassen zufällig auf deine Folds verteilt werden. - Wenn du
random_state=Mauf einen ausgewählten ganzzahligen Wert fürMsetzt, erhältst du wiederholbare Ergebnisse.
- Mit
from sklearn.model_selection import KFold ksplit = 5 kf = KFold(n_splits=ksplit, shuffle=True, random_state=20) # random_state für wiederholbare Ergebnisse festlegen kfolds = list(kf.split(labels_df)) - Wichtig:
-
Der Datensatz ist nun in
kFolds aufgeteilt. Jeder Fold enthält eine Liste mit Indizes fürtrainundval. Wir erstellen einen DataFrame, um diese Ergebnisse übersichtlicher darzustellen.folds = [f"split_{n}" for n in range(1, ksplit + 1)] folds_df = pd.DataFrame(index=labels_df.index, columns=folds) for i, (train, val) in enumerate(kfolds, start=1): folds_df.loc[labels_df.index[train], f"split_{i}"] = "train" folds_df.loc[labels_df.index[val], f"split_{i}"] = "val" -
Nun berechnen wir für jeden Fold die Verteilung der Klassenbezeichnungen als Verhältnis der in
valvorhandenen Klassen zu den intrainvorhandenen Klassen.fold_lbl_distrb = pd.DataFrame(index=folds, columns=cls_idx) for n, (train_indices, val_indices) in enumerate(kfolds, start=1): train_totals = labels_df.iloc[train_indices].sum() val_totals = labels_df.iloc[val_indices].sum() # To avoid division by zero, we add a small value (1E-7) to the denominator ratio = val_totals / (train_totals + 1e-7) fold_lbl_distrb.loc[f"split_{n}"] = ratioIm Idealfall sind die Klassenverhältnisse in jeder Aufteilung und über alle Klassen hinweg möglichst ähnlich. Was sich erreichen lässt, hängt jedoch von den Besonderheiten deines Datensatzes ab.
-
Schreibe für jede Aufteilung Bildlisten und eine YAML-Datei des Datensatzes. Textlisten vermeiden, dass der Datensatz
k-mal kopiert werden muss.import yaml save_path = dataset_path.parent / f"{ksplit}-Fold_Cross-val" save_path.mkdir(parents=True, exist_ok=True) ds_yamls = [] for split in folds_df.columns: for partition in ("train", "val"): split_images = folds_df.index[folds_df[split] == partition] paths = "\n".join(map(str, split_images)) (save_path / f"{split}_{partition}.txt").write_text(f"{paths}\n") dataset_yaml = save_path / f"{split}.yaml" ds_yamls.append(dataset_yaml) with open(dataset_yaml, "w") as ds_y: yaml.safe_dump( { "path": save_path.as_posix(), "train": f"{split}_train.txt", "val": f"{split}_val.txt", "names": classes, }, ds_y, )
Datensätze speichern (optional)#
Optional kannst du die Datensätze zur Aufteilung in k Folds und zur Verteilung der Bezeichnungen als CSV-Dateien speichern, um später darauf zurückzugreifen.
folds_df.to_csv(save_path / "kfold_datasplit.csv")
fold_lbl_distrb.to_csv(save_path / "kfold_label_distribution.csv")
YOLO mit k-fachen Datenaufteilungen trainieren#
-
Lade zunächst das YOLO-Modell.
from ultralytics import YOLO weights_path = "path/to/weights.pt" # für ein kleines Modell yolo26n.pt verwenden model = YOLO(weights_path, task="detect") -
Durchlaufe als Nächstes die YAML-Dateien des Datensatzes, um das Training auszuführen. Die Ergebnisse werden in einem Verzeichnis gespeichert, das durch die Argumente
projectundnameangegeben wird. Standardmäßig ist dieses Verzeichnisruns/detect/train#, wobei#eine ganzzahlige Indexnummer ist.results = {} # Define your additional arguments here batch = 16 project = "kfold_demo" epochs = 100 for k, dataset_yaml in enumerate(ds_yamls): model = YOLO(weights_path, task="detect") results[k] = model.train( data=dataset_yaml, epochs=epochs, batch=batch, project=project, name=f"fold_{k + 1}" ) # include any additional train arguments -
Du kannst auch die Autosplit-Funktion von Ultralytics verwenden, um Datensätze automatisch aufzuteilen:
from ultralytics.data.split import autosplit

# Datensatz automatisch in Trainings-, Validierungs- und Testdaten aufteilen
autosplit(path="path/to/images", weights=(0.8, 0.2, 0.0), annotated_only=True)
Fazit#
In dieser Anleitung haben wir untersucht, wie du die k-fache Kreuzvalidierung zum Trainieren eines YOLO-Objekterkennungsmodells einsetzt. Wir haben gelernt, den Pool aus Trainings- und Validierungsdaten in K Partitionen aufzuteilen und anhand der erzeugten Verhältnistabelle die Klassenverteilung nach der zufälligen Aufteilung zu überprüfen.
Außerdem haben wir uns angesehen, wie du DataFrames für Berichte erstellst, um die Datenaufteilungen und die Verteilung der Labels über die einzelnen Teilmengen hinweg zu visualisieren. So erhältst du einen klaren Überblick über die Struktur deiner Trainings- und Validierungsdaten.
Optional haben wir unsere Datensätze für spätere Zwecke gespeichert. Das kann besonders bei umfangreichen Projekten oder bei der Fehlersuche im Zusammenhang mit der Modellleistung hilfreich sein.
Zum Schluss haben wir das Modell tatsächlich trainiert, indem wir in einer Schleife jede Aufteilung verwendet und die Trainingsergebnisse für weitere Analysen und Vergleiche gespeichert haben.
Die k-fache Kreuzvalidierung ist eine robuste Methode, um deine verfügbaren Daten bestmöglich zu nutzen. Sie trägt dazu bei, eine zuverlässige und konsistente Modellleistung über verschiedene Teilmengen der Daten hinweg sicherzustellen. Das Ergebnis ist ein besser verallgemeinerbares und zuverlässigeres Modell, das weniger dazu neigt, sich an bestimmte Datenmuster übermäßig anzupassen.
Denk daran: Auch wenn wir in dieser Anleitung YOLO verwendet haben, lassen sich diese Schritte größtenteils auf andere Machine-Learning-Modelle übertragen. Wenn du sie verstehst, kannst du die Kreuzvalidierung auch in deinen eigenen Machine-Learning-Projekten effektiv einsetzen.
Häufig gestellte Fragen#
Bei der k-fachen Kreuzvalidierung wird der Datensatz in „k“ Teilmengen (Folds) aufgeteilt, um die Modellleistung zuverlässiger zu bewerten. Jeder Fold dient sowohl als Trainings- als auch als Validierungsdatensatz. Bei der Objekterkennung trägt die k-fache Kreuzvalidierung dazu bei, die Robustheit und Verallgemeinerbarkeit deines Ultralytics-YOLO-Modells über verschiedene Datenaufteilungen hinweg sicherzustellen und so seine Zuverlässigkeit zu erhöhen. Eine ausführliche Anleitung zur Einrichtung der k-fachen Kreuzvalidierung mit Ultralytics YOLO findest du unter K-fache Kreuzvalidierung mit Ultralytics.
Gehe wie folgt vor, um die k-fache Kreuzvalidierung mit Ultralytics YOLO zu implementieren:
- Vergewissere dich, dass die Annotationen im YOLO-Erkennungsformat vorliegen.
- Verwende Python-Bibliotheken wie
sklearn,pandasundpyyaml. - Erstelle Merkmalsvektoren aus deinem Datensatz.
- Teile deinen Datensatz mit
KFoldaussklearn.model_selectionauf. - Trainiere das YOLO-Modell auf jeder Aufteilung.
Eine ausführliche Anleitung findest du im Abschnitt Datensatz in k Folds aufteilen unserer Dokumentation.
Der Arbeitsablauf in dieser Anleitung ist auf das YOLO-Erkennungsformat ausgerichtet, lässt sich aber auf alle YOLO-Aufgaben übertragen – die Aufgabe beeinflusst, wie du die Folds zusammenstellst, nicht, ob die Kreuzvalidierung hilfreich ist:
Aufgabe Gestaltung der Folds detectTeile die Daten auf Bildebene auf und gleiche die Verteilung von Objekten und Klassen über die Folds hinweg aus. Zusammengehörige Bilder (etwa vom selben Patienten, aus derselben Videosequenz, von derselben Kamera oder vom selben Standort) sollten im selben Fold bleiben. segmentVerwende dieselbe Strategie auf Bildebene wie bei der Erkennung und achte zusätzlich darauf, dass Masken und Klassen in jedem Fold abgedeckt sind. classifyBevorzuge stratifizierte Folds, damit die Klassenhäufigkeiten in Trainings- und Validierungsdaten ausgewogen bleiben. poseTeile die Daten nach Person oder Sequenz auf, damit dieselbe Person oder dasselbe Tier nicht auf beiden Seiten eines Folds auftaucht. obbTeile die Daten auf Bildebene auf und halte Kacheln oder Ausschnitte derselben Szene zusammen – das ist besonders bei Luftbildern wichtig. Halte unabhängig von der Aufgabe nahezu identische und verwandte Beispiele aus unterschiedlichen Folds heraus. Diese Art von Datenleckage lässt die Validierungsmetriken deutlich besser aussehen, als die tatsächliche Leistung des Modells im Produktiveinsatz sein wird.
Ultralytics YOLO ermöglicht Objekterkennung auf dem neuesten Stand der Technik in Echtzeit mit hoher Genauigkeit und Effizienz. Das vielseitige Modell unterstützt verschiedene Aufgaben der Computer Vision, darunter Erkennung, Instanzsegmentierung, semantische Segmentierung und Klassifizierung. Außerdem lässt es sich mit Tools wie der Ultralytics Platform für das Modelltraining und die Bereitstellung ohne Code integrieren.
Deine Annotationen sollten dem YOLO-Erkennungsformat entsprechen. Jede Annotationsdatei muss die Objektklasse sowie die Koordinaten der zugehörigen Bounding Box im Bild enthalten. Das YOLO-Format ermöglicht eine optimierte und standardisierte Datenverarbeitung für das Training von Objekterkennungsmodellen. Weitere Informationen zur korrekten Formatierung von Annotationen findest du in der Anleitung zum YOLO-Erkennungsformat.
Ja, du kannst die k-fache Kreuzvalidierung mit jedem benutzerdefinierten Datensatz verwenden, solange die Annotationen im YOLO-Erkennungsformat vorliegen. Ersetze die Datensatzpfade und Klassenbezeichnungen durch die Angaben für deinen eigenen Datensatz. Dank dieser Flexibilität kann jedes Objekterkennungsprojekt von einer robusten Modellbewertung mit k-facher Kreuzvalidierung profitieren. Ein praktisches Beispiel findest du im Abschnitt Merkmalsvektoren erstellen.


Kommentare21
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
jingieboy
does this work with yolov8-cls? if so how would the folder structure look like? how are the data splits
 Glenn JocherUltralytics(bearbeitet)
Yes—K‑Fold works the same for classification; use the standard ImageNet-style layout per fold, and train each fold separately (YOLO infers classes from folder names). For YOLO26 (recommended) you can do:
dataset/
  split_1/
    train/
      class_a/ ...
      class_b/ ...
    val/
      class_a/ ...
      class_b/ ...
  split_2/
    train/...
    val/...
  ...
from ultralytics import YOLO weights = "yolo26n-cls.pt" # swap to 'yolov8n-cls.pt' if you prefer YOLOv8 splits = ["dataset/split_1", "dataset/split_2", "dataset/split_3"] for d in splits: model = YOLO(weights) model.train(data=d, epochs=20, batch=16) # d must contain 'train/' and 'val/' subfoldersFor building folds, use
StratifiedKFoldon image-level labels derived from parent folder names to keep class balance, or use the random splitter shown in the autosplit reference if stratification isn’t required. Classification usage details are in the classification task docs.thank you for this! I have also notice that everytime I run model.val(), the accuracies and confusion matrix values are slightly different this time. Is this normal or during evaluation, there is a small randomness when calling the function.
- Glenn JocherUltralytics
@jingieboy minor variations can occur from non-deterministic CUDA ops or multi-threading; validation itself doesn’t add randomness by default—set seeds and force deterministic ops to lock results:
import random, numpy as np, torch

seed = 0
random.seed(seed); np.random.seed(seed); torch.manual_seed(seed)
torch.backends.cudnn.deterministic = True
torch.backends.cudnn.benchmark = False

model.val()  # run evaluation
If differences are still large, double-check your eval args in the validation mode docs.
Nehasq
Hi, I am applying K-fold validation using the leave-one-out technique. My dataset consists of a single class and includes 21 images in total. For each split, I use 20 images for training and 1 image for testing. I am implementing the leave-one-out technique with the code above, setting ksplit=21.
I am not using a separate validation dataset, only training and testing data. Here is the code I am using:
results = {}
Define additional arguments here
batch = 16 project = "kfold_demo" epochs = 100
for k in range(ksplit): dataset_yaml = ds_yamls[k] model = YOLO(weights_path, task="detect") model.train(data=dataset_yaml, epochs=epochs, batch=batch, project=project) # Include any train arguments results[k] = model.metrics # Save output metrics for further analysis
In my data.yaml file, I have provided the validation path as the test set. When it trains and validates on the "1 test data," does this mean the model is being tested on data it has never seen during training? This is my first point of confusion.
my data.yaml file for each split looks like this: names:
- pothole path: ../ 2024-12-10_21-Fold_Cross-val/split_1 train: train val: test
My second question is about calculating the final performance. When I ran the above code, it calculated scores for each individual split. Do I need to calculate the final performance metrics manually, or is there any functionality in YOLOv8 to compute the aggregated performance automatically?
- Glenn JocherUltralytics
@Nehasq to address your first question, yes, the model is being tested on unseen data during each split, as the test set (1 image) is excluded from training and only used for validation. Regarding your second question, YOLO does not automatically aggregate metrics across splits. You need to compute the final performance metrics manually by averaging the results from all splits. For reference, you can review the K-Fold Cross Validation guide.
Thanks for your reply. I understand your point. So, are you saying that, for example, in my case, where I have 21 scores (precision, recall, etc.), I should simply add all the precision values together and divide the sum by 21 to get the final precision of the model? Is that correct?
Also, in y case of 20 images( training) and 1 images for test, what batch size would you suggest?
- Glenn JocherUltralytics
Yes, to calculate the final precision (or any metric), you average the values across all splits, i.e., sum all precision scores and divide by the number of splits (21 in your case). As for the batch size, given your small dataset, you could keep it low (e.g., 1 or 2) to ensure efficient utilization of the data while avoiding overfitting.
Thanks, that really helps! With a batch size of 1, I am keeping the epochs at 10. Should it be fewer? Also, to check for overfitting, I need to review the result graphs for each split. However, I can't definitively determine if it is overfitting since each split is separate, right?
- Glenn JocherUltralytics
Keeping epochs at 10 with a batch size of 1 is reasonable given your small dataset size. To check for overfitting, reviewing result graphs from each split can help, but overfitting may be harder to detect since each split involves different training and test data. Consider comparing trends across splits for consistent insights. For further details, you can reference the K-Fold Cross Validation guide.
semyon-v-dot
After the loop:
for ext in supported_extensions:
    images.extend(sorted((dataset_path / "images").rglob(f"*{ext}")))
Should be this line of code:
images = sorted(images)For
imagesmatching withlabelslist:labels = sorted(dataset_path.rglob("*labels/*.txt"))Otherwise the script creates background images because some images missing their labels.
- Glenn JocherUltralytics
@semyon-v-dot thank you for your suggestion. Sorting the
imageslist after extending it with supported extensions is a good practice to ensure alignment with thelabelslist. This helps prevent issues with missing labels.1
 sangeun jo
K-폴드 데이터 세트 분할 4번에서
images.extend(sorted((dataset_path / "images").rglob(f"*{ext}")))이 코드를images.extend(sorted(dataset_path.rglob(f"*images/*{ext}")))로 변환해야 작동했습니다.- Glenn JocherUltralytics
@sangeun-jo thank you for pointing that out. Your modification to
images.extend(sorted(dataset_path.rglob(f"*images/*{ext}")))is indeed correct and ensures the code works as intended. If you have any further questions or need additional assistance, feel free to ask!
kh-diab
is it usefult to use this k fold approach when I just have one class only but my issue is the class is detected as background or vice versa as per the attached Confusion matrix
- Glenn JocherUltralytics
@kh-diab using K-Fold Cross Validation can still be beneficial even with a single class. It helps ensure that your model's performance is robust and not overly dependent on a particular subset of the data. This can be particularly useful if you're experiencing issues with class detection accuracy, as it allows you to validate the model's performance across multiple splits and identify any inconsistencies. If your class is being detected as background or vice versa, K-Fold Cross Validation can help diagnose whether this issue is consistent across different data splits or specific to certain subsets. For more details, you can refer to our guide on K-Fold Cross Validation: https://docs.ultralytics.com/guides/kfold-cross-validation/.
alexander-sony
Good guide, consider adding it in a colab notebook.
In section "Train YOLO using K-Fold Data Splits", model should be re-initialized foe every k, i.e. it should be inside the for-loop: for k in range(ksplit).
- Glenn JocherUltralytics
@alexander-sony thank you for your feedback and suggestion! 😊
You're absolutely right about re-initializing the model within the loop for each fold to ensure a fresh start for every training iteration. This can help avoid any potential carryover effects from previous folds. Here's the corrected code snippet for the training section:
from ultralytics import YOLO

weights_path = "path/to/weights.pt"
results = {}

# Define your additional arguments here
batch = 16
project = "kfold_demo"
epochs = 100

for k in range(ksplit):
    model = YOLO(weights_path, task="detect")  # Re-initialize the model inside the loop
    dataset_yaml = ds_yamls[k]
    model.train(data=dataset_yaml, epochs=epochs, batch=batch, project=project)  # include any train arguments
    results[k] = model.metrics  # save output metrics for further analysis
Regarding your suggestion to add this guide to a Colab notebook, that's a fantastic idea! It would make the process more interactive and accessible for users. We'll consider creating a Colab version of this guide in the future.
For more details on K-Fold Cross Validation, you can refer to our comprehensive guide.
Thanks again for your valuable input! If you have any more suggestions or questions, feel free to share. Happy coding! 🚀
Likhith-Sugganahalli
@alexander-sony
woudnt that be a new model trained on each split, giving us n different models trained on 1/nth of the dataset?
 Fazri Gading
Is there any way to implement Stratified K-Fold Cross Validation with YOLOv8?
 Paula DerrengerUltralytics
Yes, you can implement Stratified K-Fold Cross Validation with YOLOv8! Stratified K-Fold ensures that each fold has a similar distribution of class labels, which can be particularly useful for imbalanced datasets.
To achieve this, you can use
StratifiedKFoldfromsklearn.model_selectioninstead ofKFold. Here's a brief example of how to modify the K-Fold implementation:from sklearn.model_selection import StratifiedKFold # Assuming labels_df is your DataFrame with class counts ksplit = 5 skf = StratifiedKFold(n_splits=ksplit, shuffle=True, random_state=20) # Generate stratified splits kfolds = list(skf.split(labels_df, labels_df.idxmax(axis=1))) # The rest of the process remains the sameFor a detailed guide on K-Fold Cross Validation, please refer to the Ultralytics documentation. If you have any more questions, feel free to ask! 😊
1