Bewährte Vorgehensweisen für die Modellbereitstellung
Einführung#
Die Modellbereitstellung ist der Schritt in einem Computer-Vision-Projekt, der ein Modell aus der Entwicklungsphase in eine reale Anwendung überführt. Es gibt verschiedene Möglichkeiten zur Modellbereitstellung: Die Bereitstellung in der Cloud bietet Skalierbarkeit und einfachen Zugriff, die Edge-Bereitstellung verringert die Latenz, indem sie das Modell näher an die Datenquelle bringt, und die lokale Bereitstellung gewährleistet Datenschutz und Kontrolle. Welche Strategie die richtige ist, hängt von den Anforderungen deiner Anwendung ab und davon, wie du Geschwindigkeit, Sicherheit und Skalierbarkeit abwägst.
Ansehen: So optimierst und veröffentlichst du KI-Modelle: Best Practices, Fehlerbehebung und Sicherheitsaspekte
Es ist außerdem wichtig, bei der Bereitstellung eines Modells bewährte Vorgehensweisen einzuhalten, da die Bereitstellung die Wirksamkeit und Zuverlässigkeit der Modellleistung erheblich beeinflussen kann. In diesem Leitfaden zeigen wir dir, wie du eine reibungslose, effiziente und sichere Modellbereitstellung sicherstellst.
Optionen für die Modellbereitstellung#
Nachdem ein Modell trainiert, bewertet und getestet wurde, muss es häufig in bestimmte Formate konvertiert werden, damit es effektiv in verschiedenen Umgebungen wie der Cloud, am Netzwerkrand oder auf lokalen Geräten bereitgestellt werden kann.
Mit YOLO26 kannst du dein Modell je nach Bereitstellungsanforderungen in verschiedene Formate exportieren. Zum Beispiel ist der Export von YOLO26 nach ONNX unkompliziert und eignet sich ideal, um Modelle zwischen Frameworks zu übertragen. Weitere Integrationsoptionen und Hinweise für eine reibungslose Bereitstellung in verschiedenen Umgebungen findest du in unserem Katalog zur Modellintegration.
Eine Bereitstellungsumgebung auswählen#
Die Wahl des Bereitstellungsorts für dein Computer-Vision-Modell hängt von mehreren Faktoren ab. Verschiedene Umgebungen bieten jeweils eigene Vorteile und stellen unterschiedliche Herausforderungen dar. Daher solltest du die Umgebung wählen, die am besten zu deinen Anforderungen passt.
Bereitstellung in der Cloud#
Die Bereitstellung in der Cloud eignet sich besonders für Anwendungen, die schnell skaliert werden und große Datenmengen verarbeiten müssen. Plattformen wie AWS, Google Cloud und Azure erleichtern die Verwaltung deiner Modelle vom Training bis zur Bereitstellung. Sie bieten Dienste wie Amazon SageMaker, Google Vertex AI und Azure Machine Learning, die dich während des gesamten Prozesses unterstützen. Auch die Ultralytics Platform stellt YOLO-Modelle in dedizierten Endpunkten in 42 Regionen weltweit bereit.
Die Nutzung der Cloud kann jedoch teuer sein, insbesondere bei hohem Datenaufkommen. Außerdem kann es zu Latenzproblemen kommen, wenn sich deine Nutzer weit entfernt von den Rechenzentren befinden. Um Kosten und Leistung im Griff zu behalten, solltest du die Ressourcennutzung optimieren und die Vorschriften zum Datenschutz einhalten.
Edge-Bereitstellung#
Die Edge-Bereitstellung eignet sich gut für Anwendungen, die Echtzeitantworten und geringe Latenz benötigen, insbesondere an Orten mit eingeschränktem oder fehlendem Internetzugang. Wenn du Modelle auf Edge-Geräten wie Smartphones oder IoT-Geräten bereitstellst, werden Daten schnell und lokal verarbeitet, was den Datenschutz verbessert. Durch die geringere Datenmenge, die an die Cloud gesendet wird, spart die Edge-Bereitstellung außerdem Bandbreite.
Edge-Geräte verfügen jedoch häufig nur über begrenzte Rechenleistung, daher musst du deine Modelle optimieren. Laufzeitumgebungen und Hardwareplattformen wie LiteRT und NVIDIA Jetson können dabei helfen. Trotz dieser Vorteile kann die Wartung und Aktualisierung vieler Geräte eine Herausforderung sein.
Lokale Bereitstellung#
Die lokale Bereitstellung ist am besten geeignet, wenn der Datenschutz entscheidend ist oder der Internetzugang unzuverlässig ist oder ganz fehlt. Wenn du Modelle auf lokalen Servern oder Desktop-Computern ausführst, behältst du die volle Kontrolle und schützt deine Daten. Außerdem kann sich die Latenz verringern, wenn sich der Server in der Nähe der Nutzer befindet.
Eine lokale Bereitstellung lässt sich jedoch nur schwer skalieren, und die Wartung kann zeitaufwendig sein. Tools wie Docker für die Containerisierung und Kubernetes für die Verwaltung können die lokale Bereitstellung effizienter machen. Regelmäßige Aktualisierungen und Wartungsarbeiten sind erforderlich, damit alles reibungslos läuft.
Containerisierung für eine vereinfachte Bereitstellung#
Containerisierung bündelt dein Modell und alle zugehörigen Abhängigkeiten in einer standardisierten Einheit, einem sogenannten Container. Diese Technik sorgt für eine konsistente Leistung in unterschiedlichen Umgebungen und vereinfacht die Bereitstellung.
Vorteile von Docker für die Modellbereitstellung#
Docker hat sich aus mehreren Gründen als Branchenstandard für die Containerisierung bei der Bereitstellung von Modellen für maschinelles Lernen etabliert:
- Einheitliche Umgebungen: Docker-Container kapseln dein Modell und alle zugehörigen Abhängigkeiten. So vermeiden sie das Problem „Auf meinem Rechner funktioniert es“ und gewährleisten einheitliches Verhalten in Entwicklungs-, Test- und Produktionsumgebungen.
- Isolierung: Container isolieren Anwendungen voneinander und verhindern Konflikte zwischen unterschiedlichen Softwareversionen oder Bibliotheken.
- Portabilität: Docker-Container können auf jedem System ausgeführt werden, das Docker unterstützt. So lassen sich deine Modelle ganz einfach ohne Änderungen auf verschiedenen Plattformen bereitstellen.
- Skalierbarkeit: Container lassen sich je nach Bedarf problemlos hoch- oder herunterskalieren. Orchestrierungswerkzeuge wie Kubernetes können diesen Prozess automatisieren.
- Versionsverwaltung: Docker-Images lassen sich versionieren, sodass du Änderungen nachverfolgen und bei Bedarf zu früheren Versionen zurückkehren kannst.
Docker für die Bereitstellung von YOLO26 einsetzen#
Um dein YOLO26-Modell zu containerisieren, kannst du eine Dockerfile erstellen, in der alle erforderlichen Abhängigkeiten und Konfigurationen festgelegt sind. Hier ist ein einfaches Beispiel:
FROM ultralytics/ultralytics:latest

WORKDIR /app

# Copy your model and any additional files
COPY ./models/yolo26n.pt /app/models/
COPY ./scripts /app/scripts/

# Set up any environment variables
ENV MODEL_PATH=/app/models/yolo26n.pt

# Command to run when the container starts
CMD ["python", "/app/scripts/predict.py"]
Mit diesem Ansatz lässt sich deine Modellbereitstellung in Entwicklungs-, Test- und Produktionsumgebungen reproduzierbar und einheitlich gestalten.
Verfahren zur Modelloptimierung#
Durch die Optimierung deines Computervision-Modells läuft es effizienter, insbesondere bei der Bereitstellung in Umgebungen mit begrenzten Ressourcen, etwa auf Edge-Geräten. Hier sind einige wichtige Techniken zur Optimierung deines Modells.
Modell-Pruning#
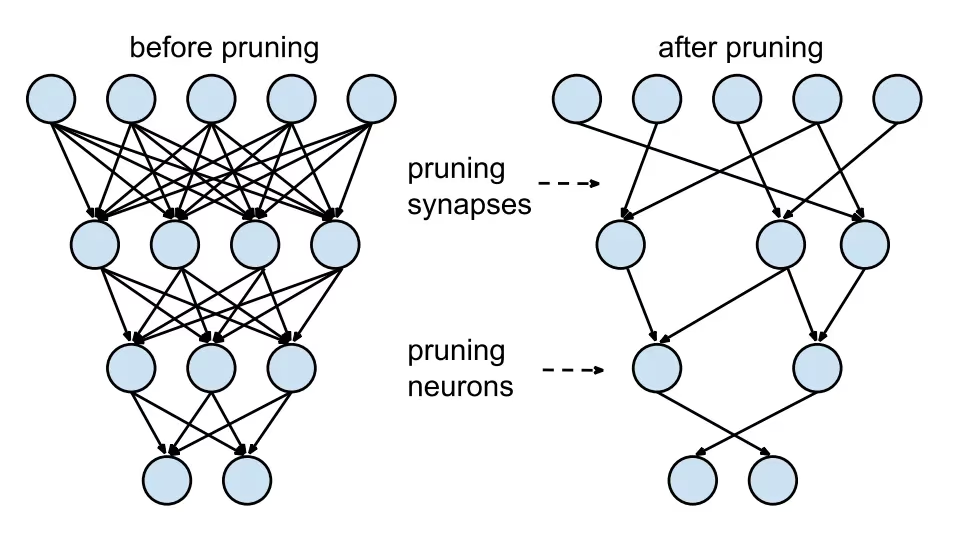
Pruning verkleinert das Modell, indem Gewichte entfernt werden, die nur wenig zum Endergebnis beitragen. Dadurch wird das Modell kleiner und schneller, ohne dass die Genauigkeit wesentlich beeinträchtigt wird. Beim Pruning werden unnötige Parameter identifiziert und entfernt. So entsteht ein schlankeres Modell, das weniger Rechenleistung benötigt. Das ist besonders nützlich, wenn Modelle auf Geräten mit begrenzten Ressourcen bereitgestellt werden.
Modellquantisierung#
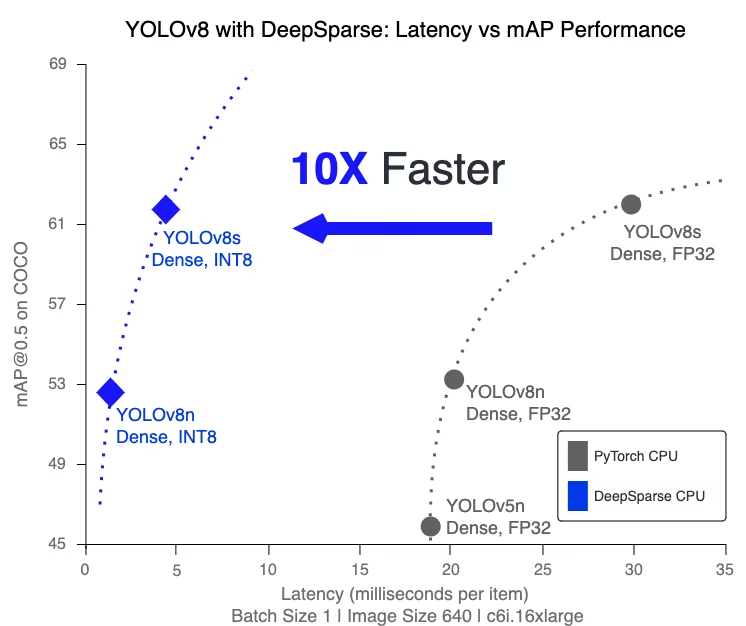
Quantisierung wandelt die Gewichte und Aktivierungen des Modells von hoher Genauigkeit (z. B. 32-Bit-Gleitkommazahlen) in eine geringere Genauigkeit um (z. B. 8-Bit-Ganzzahlen). Durch die Verringerung der Modellgröße wird die Inferenz beschleunigt. Quantisierungsbewusstes Training (QAT) ist ein Verfahren, bei dem das Modell mit Blick auf die Quantisierung trainiert wird. Dadurch bleibt die Genauigkeit besser erhalten als bei einer Quantisierung nach dem Training. Indem die Quantisierung bereits während des Trainings berücksichtigt wird, lernt das Modell, sich an die geringere Genauigkeit anzupassen. So bleibt die Leistung erhalten und der Rechenaufwand sinkt. Setze bei Ultralytics YOLO quantize=8 beim Export für die INT8-Quantisierung nach dem Training oder während des Trainings für QAT.
Wissensdestillation#
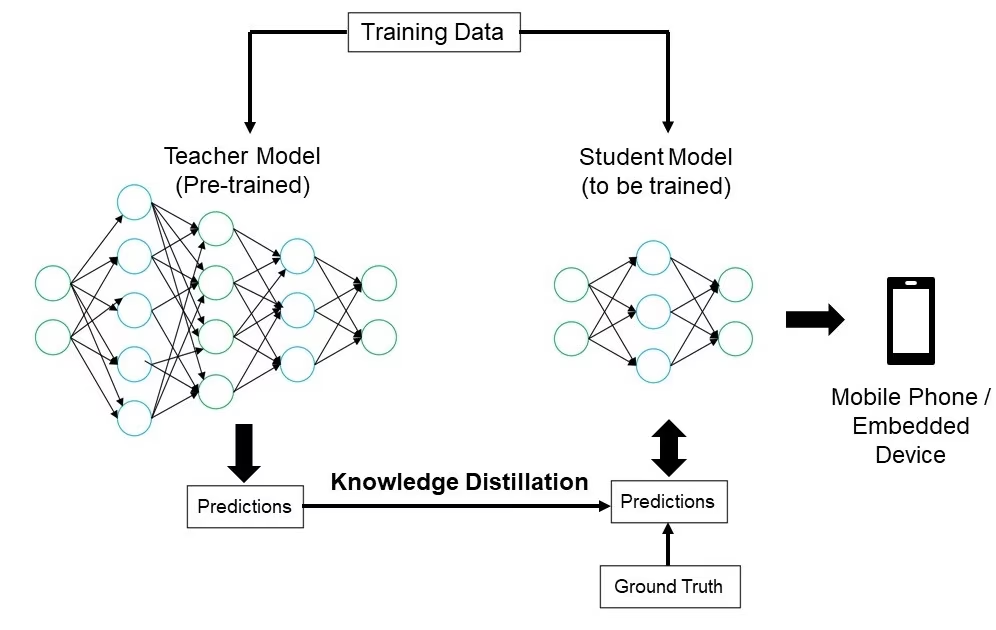
Bei der Wissensdestillation wird ein kleineres, einfacheres Modell (der Schüler) darauf trainiert, die Ausgaben eines größeren, komplexeren Modells (des Lehrers) nachzuahmen. Das Schülermodell lernt, die Vorhersagen des Lehrermodells nachzubilden. So entsteht ein kompaktes Modell, das einen Großteil der Genauigkeit des Lehrermodells beibehält. Diese Technik eignet sich, um effiziente Modelle für die Bereitstellung auf Edge-Geräten mit begrenzten Ressourcen zu erstellen. Ultralytics YOLO unterstützt sie über das Trainingsargument distill_model.
Probleme bei der Bereitstellung beheben#
Bei der Bereitstellung deiner Computer-Vision-Modelle können Herausforderungen auftreten. Wenn du häufige Probleme und ihre Lösungen kennst, läuft der Prozess reibungsloser. Hier findest du allgemeine Tipps zur Fehlerbehebung und bewährte Vorgehensweisen, die dir bei Problemen mit der Bereitstellung helfen.
Dein Modell ist nach der Bereitstellung weniger genau#
Ein Rückgang der Genauigkeit deines Modells nach der Bereitstellung kann verschiedene Ursachen haben. Mit den folgenden Schritten kannst du das Problem erkennen und beheben:
- Datenkonsistenz prüfen: Stelle sicher, dass die Daten, die dein Modell nach der Bereitstellung verarbeitet, mit den Trainingsdaten übereinstimmen. Unterschiede in der Datenverteilung, Qualität oder im Format können die Leistung erheblich beeinträchtigen.
- Vorverarbeitungsschritte überprüfen: Stelle sicher, dass bei der Bereitstellung dieselben Vorverarbeitungsschritte wie beim Training konsistent angewendet werden. Dazu gehören das Ändern der Bildgröße, das Normalisieren der Pixelwerte und andere Datentransformationen.
- Modellumgebung überprüfen: Stelle sicher, dass die während der Bereitstellung verwendeten Hardware- und Softwarekonfigurationen mit denen beim Training übereinstimmen. Unterschiede bei Bibliotheken, Versionen und Hardwarefunktionen können zu Abweichungen führen.
- Modellinferenz überwachen: Protokolliere Eingaben und Ausgaben in verschiedenen Phasen der Inferenzpipeline, um Anomalien zu erkennen. So lassen sich Probleme wie beschädigte Daten oder eine unsachgemäße Verarbeitung der Modellausgaben erkennen.
- Modellexport und -konvertierung überprüfen: Exportiere das Modell erneut und stelle sicher, dass der Konvertierungsprozess die Integrität der Modellgewichte und der Architektur bewahrt.
- Mit einem kontrollierten Datensatz testen: Stelle das Modell in einer Testumgebung mit einem von dir kontrollierten Datensatz bereit und vergleiche die Ergebnisse mit denen aus der Trainingsphase. So kannst du feststellen, ob das Problem an der Bereitstellungsumgebung oder den Daten liegt.
Bei der Bereitstellung von YOLO26 können verschiedene Faktoren die Modellgenauigkeit beeinträchtigen. Bei der Konvertierung von Modellen in Formate wie TensorRT kommen Optimierungen wie die Quantisierung von Gewichten und das Zusammenführen von Schichten zum Einsatz, die zu geringfügigen Genauigkeitsverlusten führen können. Die Verwendung von FP16 (halber Genauigkeit) statt FP32 (voller Genauigkeit) kann die Inferenz beschleunigen, aber auch numerische Genauigkeitsfehler verursachen. Auch Hardwarebeschränkungen, etwa beim Jetson Nano, können sich auf die Leistung auswirken, da dort weniger CUDA-Kerne und eine geringere Speicherbandbreite zur Verfügung stehen.
Inferenz dauert länger als erwartet#
Bei der Bereitstellung von maschinellen Lernmodellen ist es wichtig, dass sie effizient ausgeführt werden. Dauert die Inferenz länger als erwartet, kann das die Nutzererfahrung und die Wirksamkeit deiner Anwendung beeinträchtigen. Mit den folgenden Schritten kannst du das Problem erkennen und beheben:
- Aufwärmläufe durchführen: Bei den ersten Läufen fällt häufig zusätzlicher Aufwand für die Einrichtung an, was die Latenzmessungen verfälschen kann. Führe vor der Latenzmessung einige Inferenzläufe zum Aufwärmen durch. Wenn du diese ersten Läufe nicht berücksichtigst, erhältst du eine genauere Messung der Modellleistung.
- Inferenz-Engine optimieren: Prüfe, ob die Inferenz-Engine vollständig für die Architektur deiner GPU optimiert ist. Verwende die neuesten Treiber und Softwareversionen, die auf deine Hardware abgestimmt sind, um maximale Leistung und Kompatibilität sicherzustellen.
- Asynchrone Verarbeitung verwenden: Mit asynchroner Verarbeitung lassen sich Arbeitslasten effizienter verwalten. Verwende asynchrone Verfahren, um mehrere Inferenzen gleichzeitig auszuführen. So kannst du die Last verteilen und Wartezeiten verkürzen.
- Inferenzpipeline profilieren: Wenn du Engpässe in der Inferenzpipeline erkennst, kannst du die Ursache für Verzögerungen eingrenzen. Analysiere mit Profiling-Tools jeden Schritt des Inferenzprozesses und erkenne und behebe Phasen, die erhebliche Verzögerungen verursachen, etwa ineffiziente Layer oder Probleme bei der Datenübertragung.
- Passende Genauigkeit verwenden: Eine höhere Genauigkeit als nötig kann die Inferenz verlangsamen. Probiere eine geringere Genauigkeit wie FP16 (
quantize=16beim Export) statt FP32 (voller Genauigkeit) aus. FP16 kann zwar die Inferenzzeit verkürzen, aber auch die Modellgenauigkeit beeinträchtigen.
Wenn dieses Problem bei der Bereitstellung von YOLO26 auftritt, beachte, dass YOLO26 Modelle in verschiedenen Größen bietet, etwa YOLO26n (Nano) für Geräte mit geringerem Speicher und YOLO26x (Extra Large) für leistungsstärkere GPUs. Mit der passenden Modellvariante für deine Hardware kannst du Speicherbedarf und Verarbeitungszeit in Einklang bringen.
Beachte außerdem, dass die Größe der Eingabebilder den Speicherbedarf und die Verarbeitungszeit unmittelbar beeinflusst. Niedrigere Auflösungen reduzieren den Speicherbedarf und beschleunigen die Inferenz, während höhere Auflösungen die Genauigkeit verbessern, aber mehr Speicher und Rechenleistung erfordern.
Sicherheitsaspekte bei der Modellbereitstellung#
Ein weiterer wichtiger Aspekt der Bereitstellung ist die Sicherheit. Die Sicherheit deiner bereitgestellten Modelle ist entscheidend, um sensible Daten und geistiges Eigentum zu schützen. Hier sind einige bewährte Vorgehensweisen für eine sichere Modellbereitstellung.
Sichere Datenübertragung#
Die Sicherung von Daten, die zwischen Clients und Servern übertragen werden, ist wichtig, damit sie nicht abgefangen oder von Unbefugten eingesehen werden. Du kannst Verschlüsselungsprotokolle wie TLS (Transport Layer Security) verwenden, um Daten während der Übertragung zu verschlüsseln. Selbst wenn jemand die Daten abfängt, kann er sie nicht lesen. Außerdem kannst du eine Ende-zu-Ende-Verschlüsselung einsetzen, die die Daten vom Ausgangspunkt bis zum Ziel schützt, sodass niemand dazwischen auf sie zugreifen kann.
Zugriffskontrollen#
Es ist wichtig zu kontrollieren, wer auf dein Modell und seine Daten zugreifen kann, um eine unbefugte Nutzung zu verhindern. Verwende starke Authentifizierungsverfahren, um die Identität von Personen oder Systemen zu überprüfen, die auf das Modell zugreifen möchten, und erwäge zusätzliche Sicherheit durch Mehr-Faktor-Authentifizierung (MFA). Richte eine rollenbasierte Zugriffskontrolle (RBAC) ein, um Berechtigungen anhand der Benutzerrollen zu vergeben und sicherzustellen, dass alle nur auf das zugreifen können, was sie benötigen. Führe detaillierte Audit-Protokolle, um alle Zugriffe und Änderungen am Modell und seinen Daten nachzuverfolgen, und überprüfe diese Protokolle regelmäßig auf verdächtige Aktivitäten.
Modellverschleierung#
Du kannst dein Modell durch Modellverschleierung vor Reverse Engineering und Missbrauch schützen. Dabei werden Modellparameter wie Gewichte und Bias-Werte in neuronalen Netzen verschlüsselt, damit Unbefugte das Modell nur schwer verstehen oder verändern können. Du kannst auch die Modellarchitektur verschleiern, indem du Layer und Parameter umbenennst oder Dummy-Layer hinzufügst. Das erschwert Angreifern das Reverse Engineering. Wenn du das Modell in einer sicheren Umgebung bereitstellst, etwa in einem Secure Enclave oder einer vertrauenswürdigen Ausführungsumgebung (TEE), bietet das während der Inferenz zusätzlichen Schutz.
Fazit und nächste Schritte#
Wir haben einige bewährte Vorgehensweisen für die Bereitstellung von Computer-Vision-Modellen vorgestellt. Wenn du Daten schützt, Zugriffe kontrollierst und Modelldetails verschleierst, kannst du sensible Informationen schützen und zugleich dafür sorgen, dass deine Modelle reibungslos laufen. Außerdem haben wir besprochen, wie sich häufige Probleme wie geringere Genauigkeit und langsame Inferenz mit Strategien wie Aufwärmläufen, optimierten Engines, asynchroner Verarbeitung, Profiling der Pipelines und der Wahl der passenden Genauigkeit beheben lassen.
Nach der Bereitstellung deines Modells besteht der nächste Schritt darin, deine Anwendung zu überwachen, zu warten und zu dokumentieren. Regelmäßige Überwachung hilft dabei, Probleme schnell zu erkennen und zu beheben. Durch Wartung bleiben deine Modelle aktuell und funktionsfähig, und eine gute Dokumentation hält alle Änderungen und Aktualisierungen fest. Diese Schritte helfen dir, die Ziele deines Computervision-Projekts zu erreichen.
Häufig gestellte Fragen#
Bei der Bereitstellung eines Modells für maschinelles Lernen, insbesondere mit Ultralytics YOLO26, solltest du einige bewährte Vorgehensweisen beachten, um Effizienz und Zuverlässigkeit sicherzustellen. Wähle zunächst die Bereitstellungsumgebung, die zu deinen Anforderungen passt: Cloud, Edge oder lokal. Optimiere dein Modell mit Verfahren wie Pruning, Quantisierung und Wissensdestillation, damit es effizient in Umgebungen mit begrenzten Ressourcen eingesetzt werden kann. Erwäge die Containerisierung mit Docker, um die Konsistenz zwischen verschiedenen Umgebungen sicherzustellen. Achte schließlich darauf, dass Datenkonsistenz und Vorverarbeitungsschritte denen der Trainingsphase entsprechen, damit die Leistung erhalten bleibt. Weitere ausführliche Richtlinien findest du unter Optionen für die Modellbereitstellung.
Die Fehlerbehebung bei Problemen mit der Bereitstellung lässt sich in einige wichtige Schritte unterteilen. Wenn die Genauigkeit deines Modells nach der Bereitstellung sinkt, prüfe die Datenkonsistenz, kontrolliere die Vorverarbeitungsschritte und stelle sicher, dass die Hardware- und Softwareumgebung der beim Training verwendeten Umgebung entspricht. Bei langsamer Inferenz solltest du Aufwärmläufe durchführen, deine Inferenz-Engine optimieren, asynchrone Verarbeitung einsetzen und deine Inferenzpipeline profilieren. Eine ausführliche Anleitung zu diesen bewährten Vorgehensweisen findest du unter Fehlerbehebung bei Problemen mit der Bereitstellung.
Bei der Optimierung von Ultralytics YOLO26-Modellen für Edge-Geräte kommen Verfahren wie Pruning zur Verkleinerung des Modells, Quantisierung zur Umwandlung der Gewichte in niedrigere Genauigkeit und Wissensdestillation zum Trainieren kleinerer Modelle zum Einsatz, die größere Modelle nachbilden. So läuft das Modell auch auf Geräten mit begrenzter Rechenleistung effizient. Tools wie LiteRT und NVIDIA Jetson eignen sich besonders für diese Optimierungen. Mehr über diese Verfahren erfährst du im Abschnitt zur Modelloptimierung.
Sicherheit hat bei der Bereitstellung von Modellen für maschinelles Lernen höchste Priorität. Sorge mit Verschlüsselungsprotokollen wie TLS für eine sichere Datenübertragung. Richte robuste Zugriffskontrollen ein, darunter starke Authentifizierung und rollenbasierte Zugriffskontrolle (RBAC). Verfahren zur Modellverschleierung, beispielsweise das Verschlüsseln von Modellparametern und die Bereitstellung von Modellen in einer sicheren Umgebung wie einer vertrauenswürdigen Ausführungsumgebung (TEE), bieten zusätzlichen Schutz. Ausführliche Hinweise findest du unter Sicherheitsaspekte.
Welche Bereitstellungsumgebung für dein Ultralytics YOLO26-Modell am besten geeignet ist, hängt von den konkreten Anforderungen deiner Anwendung ab. Die Bereitstellung in der Cloud bietet Skalierbarkeit und einfachen Zugriff und eignet sich daher ideal für Anwendungen mit großen Datenmengen. Die Bereitstellung am Netzwerkrand eignet sich am besten für Anwendungen mit geringer Latenz, die Echtzeitreaktionen erfordern, und nutzt Tools wie LiteRT. Die lokale Bereitstellung ist für Szenarien geeignet, die strenge Anforderungen an Datenschutz und Kontrolle stellen. Eine umfassende Übersicht zu den einzelnen Umgebungen findest du im Abschnitt Auswahl einer Bereitstellungsumgebung.


Kommentare10
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
 TaoBenHui
shafa~hahaha
Taufiq-Ahmed
Hi, I Have trained my custom dataset on yolov8s model. Now I want to optimized the model by using pruning and quantization. could you please tell me How I can implement it and what is the python code of it?
 Paula DerrengerUltralytics
@Taufiq-Ahmed to optimize your YOLOv8 model using pruning and quantization, you can follow these steps:
-
Pruning: This involves removing weights that contribute little to the final output, making the model smaller and faster. You can use libraries like TensorFlow Model Optimization Toolkit or PyTorch's pruning methods.
-
Quantization: This converts the model's weights and activations from high precision (e.g., 32-bit floats) to lower precision (e.g., 8-bit integers), reducing model size and speeding up inference. You can use TensorFlow Lite for post-training quantization or PyTorch's quantization tools.
For detailed guidance and code examples, please refer to the Ultralytics documentation on model optimization. This resource provides comprehensive instructions and best practices for deploying and optimizing your models effectively.
-
Thank you so much for your reply. One think I would like to know, is it possible to do pruning and quantization in my YOLOv8 best.pt model with TensorFlow Model Optimization Toolkit or PyTorch's pruning methods. Do do I need to convert it and also need to convert my dataset from YOLO format to any other format?
- Paula DerrengerUltralytics
Yes, you can perform pruning and quantization on your YOLOv8 model using TensorFlow Model Optimization Toolkit or PyTorch's pruning methods. You don't need to convert your dataset format, but you may need to convert your model to a compatible format like ONNX if using TensorFlow tools. For PyTorch, you can directly apply pruning and quantization techniques. For detailed steps, please refer to the Ultralytics documentation on model deployment practices.
Thank you for your reply. could you please give me any git hub repositories or any coding example on how to apply pruning and quantization techniques on the best.pt model on custom dataset. and how will i maintain the accuracy of the model.
- Paula DerrengerUltralytics
@Taufiq-Ahmed for pruning and quantization of your YOLOv8 model, you can use PyTorch's built-in functionalities. You don't need to convert your dataset format. For pruning, you can use
torch.nn.utils.prune, and for quantization, you can usetorch.quantization. If you need specific code examples, please let me know. For more detailed guidance, you can refer to the Ultralytics documentation on model deployment practices. Thank you for your reply. it would be better for me if you share a coding example of how to prune and quantize the model on the custom data to reduce it's size and weights using pytorch and how to ´maintain it's accuracy. do I need to train it again or there is some other way to maintain it's accuracy.
Hi could you please check whether this idea works:
import torch import torch.nn as nn from torch.nn.utils import prune from ultralytics import YOLO
model = YOLO('best.pt')
def gradual_prune_model(model, prune_step=0.05, prune_iterations=10): for i in range(prune_iterations):
    for name, module in model.model.named_modules():
        if isinstance(module, nn.Conv2d):
            prune.l1_unstructured(module, name='weight', amount=prune_step)
            prune.remove(module, 'weight')  # Remove pruning reparameterization

    print(f'Fine-tuning after pruning iteration {i+1}/{prune_iterations}')
    model.train(data='dataset.yaml', epochs=2, lr=1e-4)
gradual_prune_model(model, prune_step=0.05, prune_iterations=10)
print('Final fine-tuning after pruning') model.train(data='/path/to/your/dataset.yaml', epochs=10, lr=1e-5)
model.save('pruned_yolov8.pt')
is this pruned technique works? and after pruning is this the right way to regain it's accuracy?
- Paula DerrengerUltralytics
Your approach to pruning looks good. Gradual pruning followed by fine-tuning can help maintain accuracy. After pruning, fine-tuning with a lower learning rate is essential to regain any lost accuracy. For quantization, you can use PyTorch's quantization tools. Ensure you validate the model's performance after each step. For more detailed guidance, refer to the Ultralytics documentation on model deployment practices.