SAM 3: Alles anhand von Konzepten segmentieren
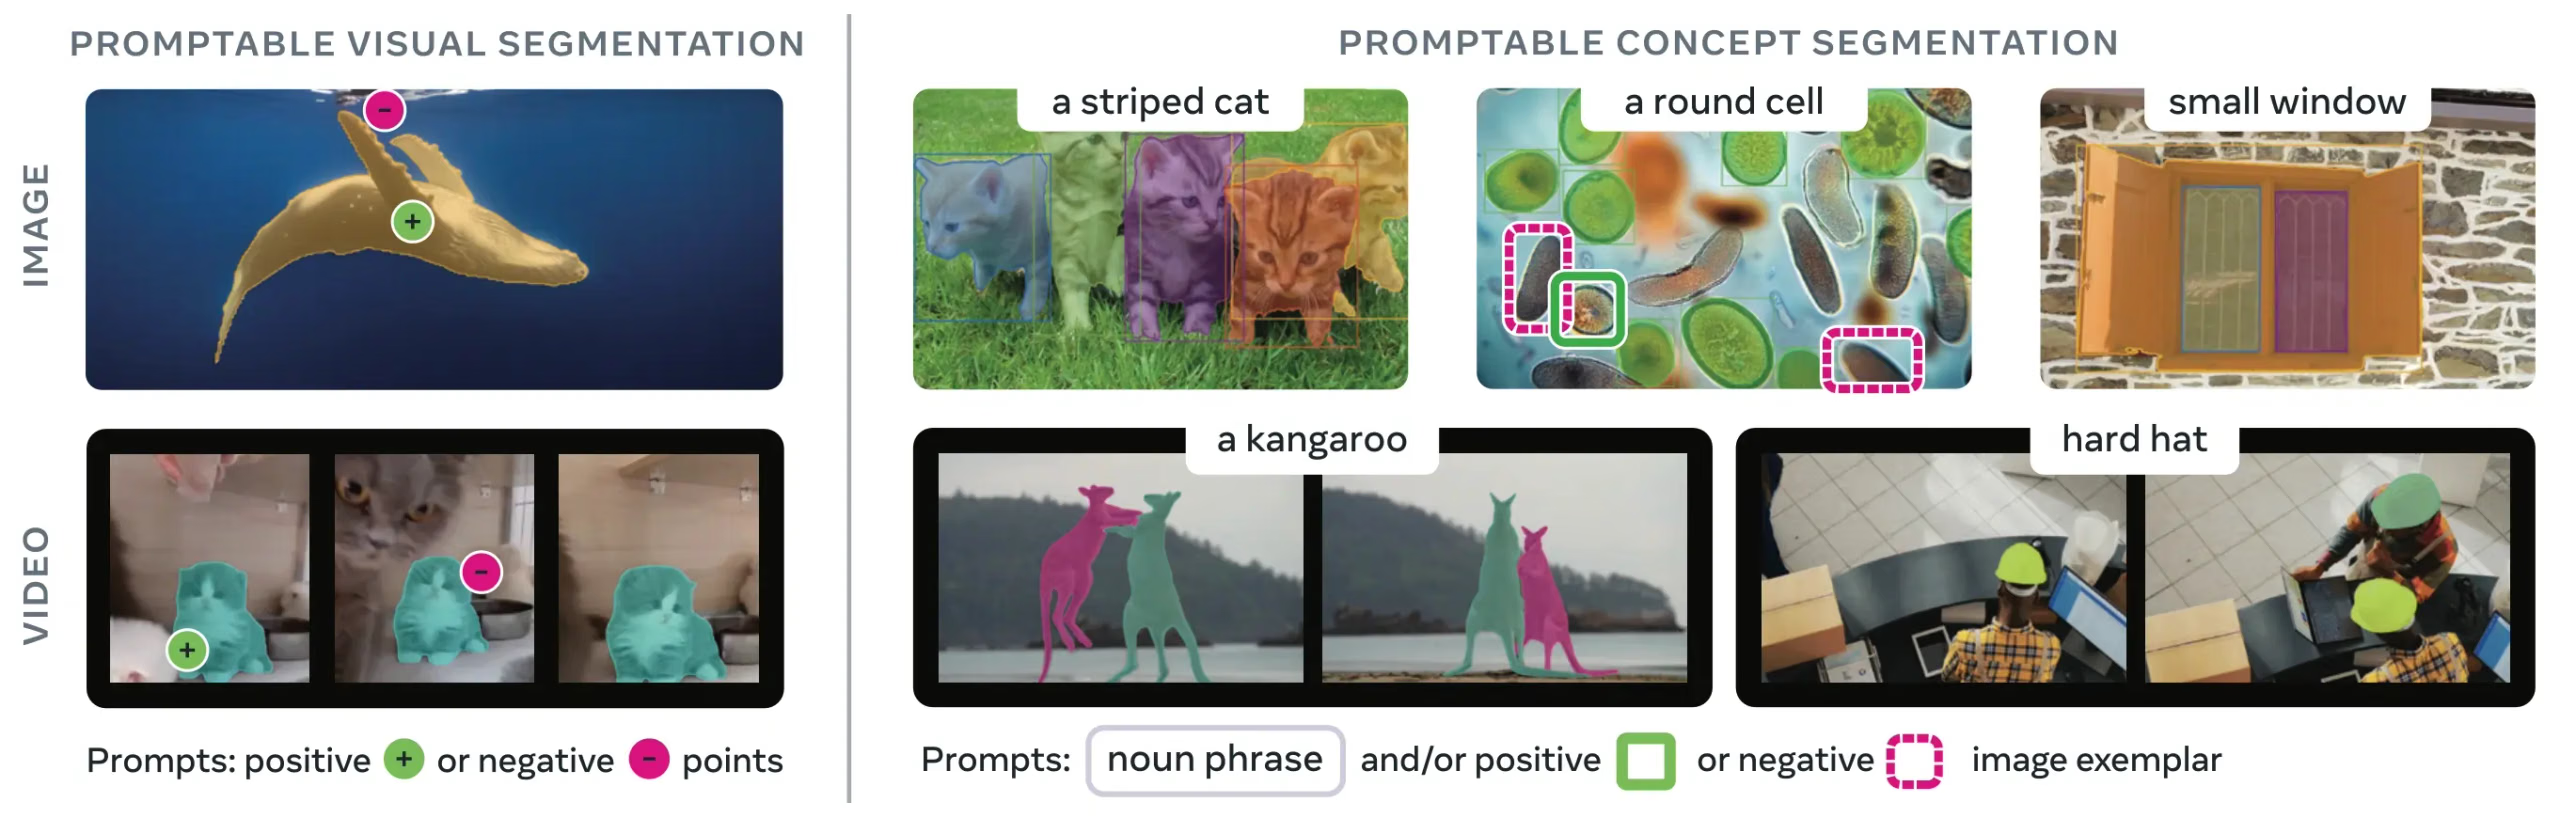
SAM 3 (Segment Anything Model 3) ist Metas Basismodell für die promptbasierte Konzeptsegmentierung (PCS). Aufbauend auf SAM 2 führt SAM 3 eine neue Fähigkeit ein: Alle Instanzen eines visuellen Konzepts zu erkennen, zu segmentieren und zu verfolgen, wenn dieses durch Texteingaben, Bildbeispiele oder beides beschrieben wird. Anders als frühere SAM-Versionen, die pro Eingabeaufforderung einzelne Objekte segmentieren, kann SAM 3 jedes Vorkommen eines Konzepts überall in Bildern oder Videos finden und segmentieren. Damit entspricht das Modell den Zielen der offenen Vokabularisierung in der modernen Instanzsegmentierung.
Ansehen: So verwendest du Meta Segment Anything 3 mit Ultralytics | Segmentierung von Bildern und Videos anhand von Textvorgaben
SAM 3 ist vollständig in das Paket ultralytics integriert und unterstützt nativ die Konzeptsegmentierung anhand von Textvorgaben, Beispielbildern und Videoverfolgung. Der neuere SAM 3.1-Checkpoint wird für Bildvorhersagen unterstützt.
Übersicht#
SAM 3 erzielt bei der promptbasierten Konzeptsegmentierung eine um 2× höhere Leistung als bestehende Systeme und behält zugleich die Fähigkeiten von SAM 2 für die interaktive visuelle Segmentierung bei und verbessert sie. Das Modell eignet sich besonders für die Segmentierung mit offenem Vokabular: Du kannst Konzepte mit einfachen Nominalphrasen wie „gelber Schulbus“ oder „getigerte Katze“ angeben oder Beispielbilder des Zielobjekts bereitstellen. In Ultralytics läuft SAM 3 im Modus predict; für die Verfolgung stehen spezielle Videoprädiktoren zur Verfügung.
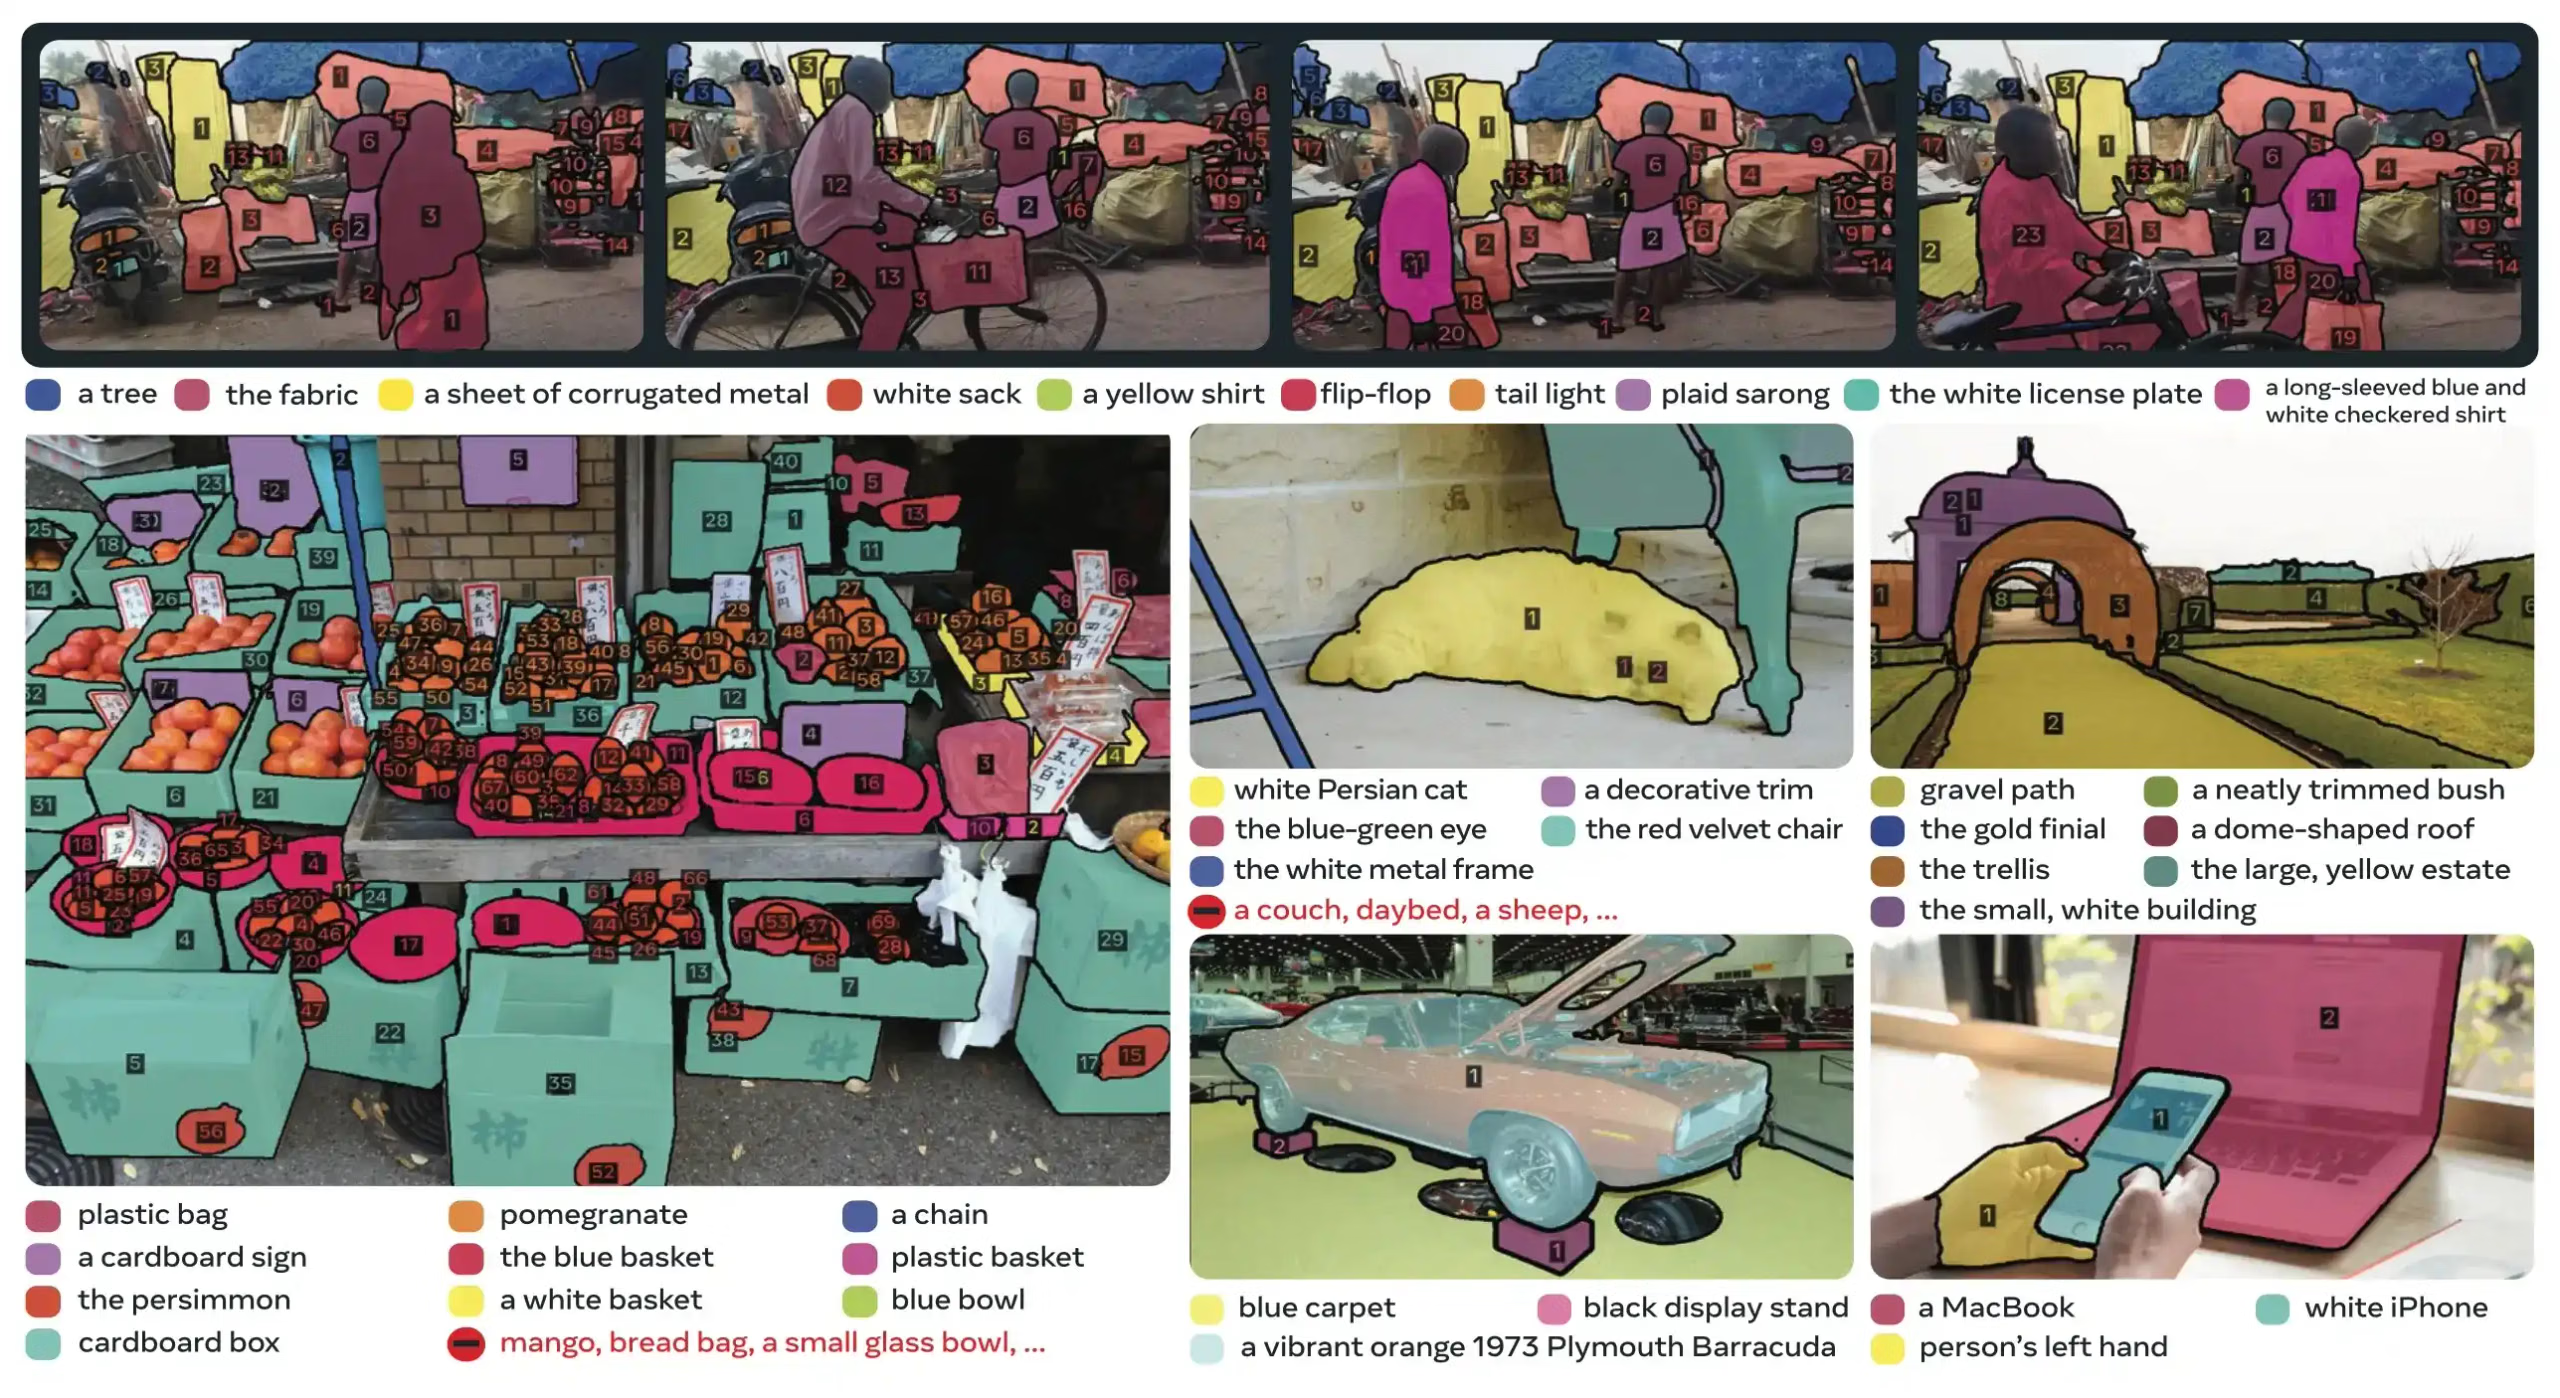
Was ist konzeptgesteuerte Segmentierung (PCS)?#
Die PCS-Aufgabe erhält eine Konzeptaufforderung als Eingabe und gibt Segmentierungsmasken mit eindeutigen Kennungen für alle passenden Objektinstanzen zurück. Als Konzeptaufforderung sind möglich:
- Text: Einfache Nominalgruppen wie „roter Apfel“ oder „Person mit Hut“, ähnlich wie beim Zero-Shot-Lernen
- Beispielbilder: Begrenzungsboxen um Beispielobjekte (positiv oder negativ) zur schnellen Verallgemeinerung
- Kombiniert: Text und Beispielbilder gemeinsam für eine präzise Steuerung
Dies unterscheidet sich von herkömmlichen visuellen Vorgaben (Punkte, Boxen, Masken), die nur eine einzelne, bestimmte Objektinstanz segmentieren – ein Ansatz, der durch die ursprüngliche SAM-Familie bekannt wurde.
Wichtige Leistungskennzahlen#
| Kennzahl | Ergebnis von SAM 3 |
|---|---|
| LVIS-Masken-AP im Zero-Shot-Verfahren | 47.0 (gegenüber dem bisherigen Bestwert von 38.5: Verbesserung um 22 %) |
| SA-Co-Benchmark | Doppelt so gut wie bestehende Systeme |
| Inferenzgeschwindigkeit (H200-GPU) | 30 ms pro Bild mit über 100 erkannten Objekten |
| Videoleistung | Nahezu in Echtzeit für ~5 gleichzeitig verfolgte Objekte |
| MOSEv2-VOS-Benchmark | 60.1 J&F (25.5 % besser als SAM 2.1, 17 % besser als der bisherige Spitzenwert) |
| Interaktive Verfeinerung | Verbesserung um +18.6 CGF1 nach 3 Beispielvorgaben |
| Abstand zur menschlichen Leistung | Erreicht 88 % der geschätzten Untergrenze bei SA-Co/Gold |
Hintergrundinformationen zu Modellkennzahlen und Kompromissen im Produktionseinsatz findest du unter Einblicke in die Modellbewertung und YOLO-Leistungskennzahlen.
SAM 3.1#
SAM 3.1, das Meta am 27. März 2026 veröffentlicht hat, ist ein neuer SAM 3-Checkpoint, der Object Multiplex einführt – einen Ansatz für die Videoverfolgung mehrerer Objekte mit gemeinsam genutztem Speicher. Statt jedes verfolgte Objekt einzeln zu verarbeiten, gruppiert SAM 3.1 die Objekte in Buckets mit fester Kapazität und verarbeitet sie gemeinsam. Laut Meta ist das bei 128 Objekten auf einer einzelnen H100-GPU etwa 7-mal schneller. Der Bilddetektor und der interaktive Kopf für Punktvorgaben behalten die SAM 3-Architektur bei.
| Benchmark | Kennzahl | SAM 3 | SAM 3.1 |
|---|---|---|---|
| SA-Co/VEval SA-V (Test) | cgF1 | 30.3 | 30.5 |
| SA-Co/VEval YT-Temporal-1B (Test) | cgF1 | 50.8 | 52.9 |
| SA-Co/VEval SmartGlasses (Test) | cgF1 | 36.4 | 36.3 |
| MOSEv1 (Validierung) | J&F | 78.4 | 79.6 |
| DAVIS17 (Validierung) | J&F | 92.2 | 92.7 |
| SA-V (Test) | J&F | 84.4 | 85.1 |
| YTVOS19 (Validierung) | G | 89.7 | 89.3 |
| MOSEv2 (Validierung) | J&Ḟ | 60.3 | 62.3 |
Ultralytics lädt den SAM 3.1-Checkpoint (sam3.1_multiplex.pt) in die SAM 3-Bildprädiktoren: SAM("sam3.1_multiplex.pt") für Punkt- und Boxvorgaben sowie SAM3SemanticPredictor für Text- und Beispielvorgaben. Die Videoverfolgung mit Object Multiplex wird noch nicht unterstützt. Verwende daher weiterhin sam3.pt mit SAM3VideoPredictor und SAM3VideoSemanticPredictor.
Architektur#
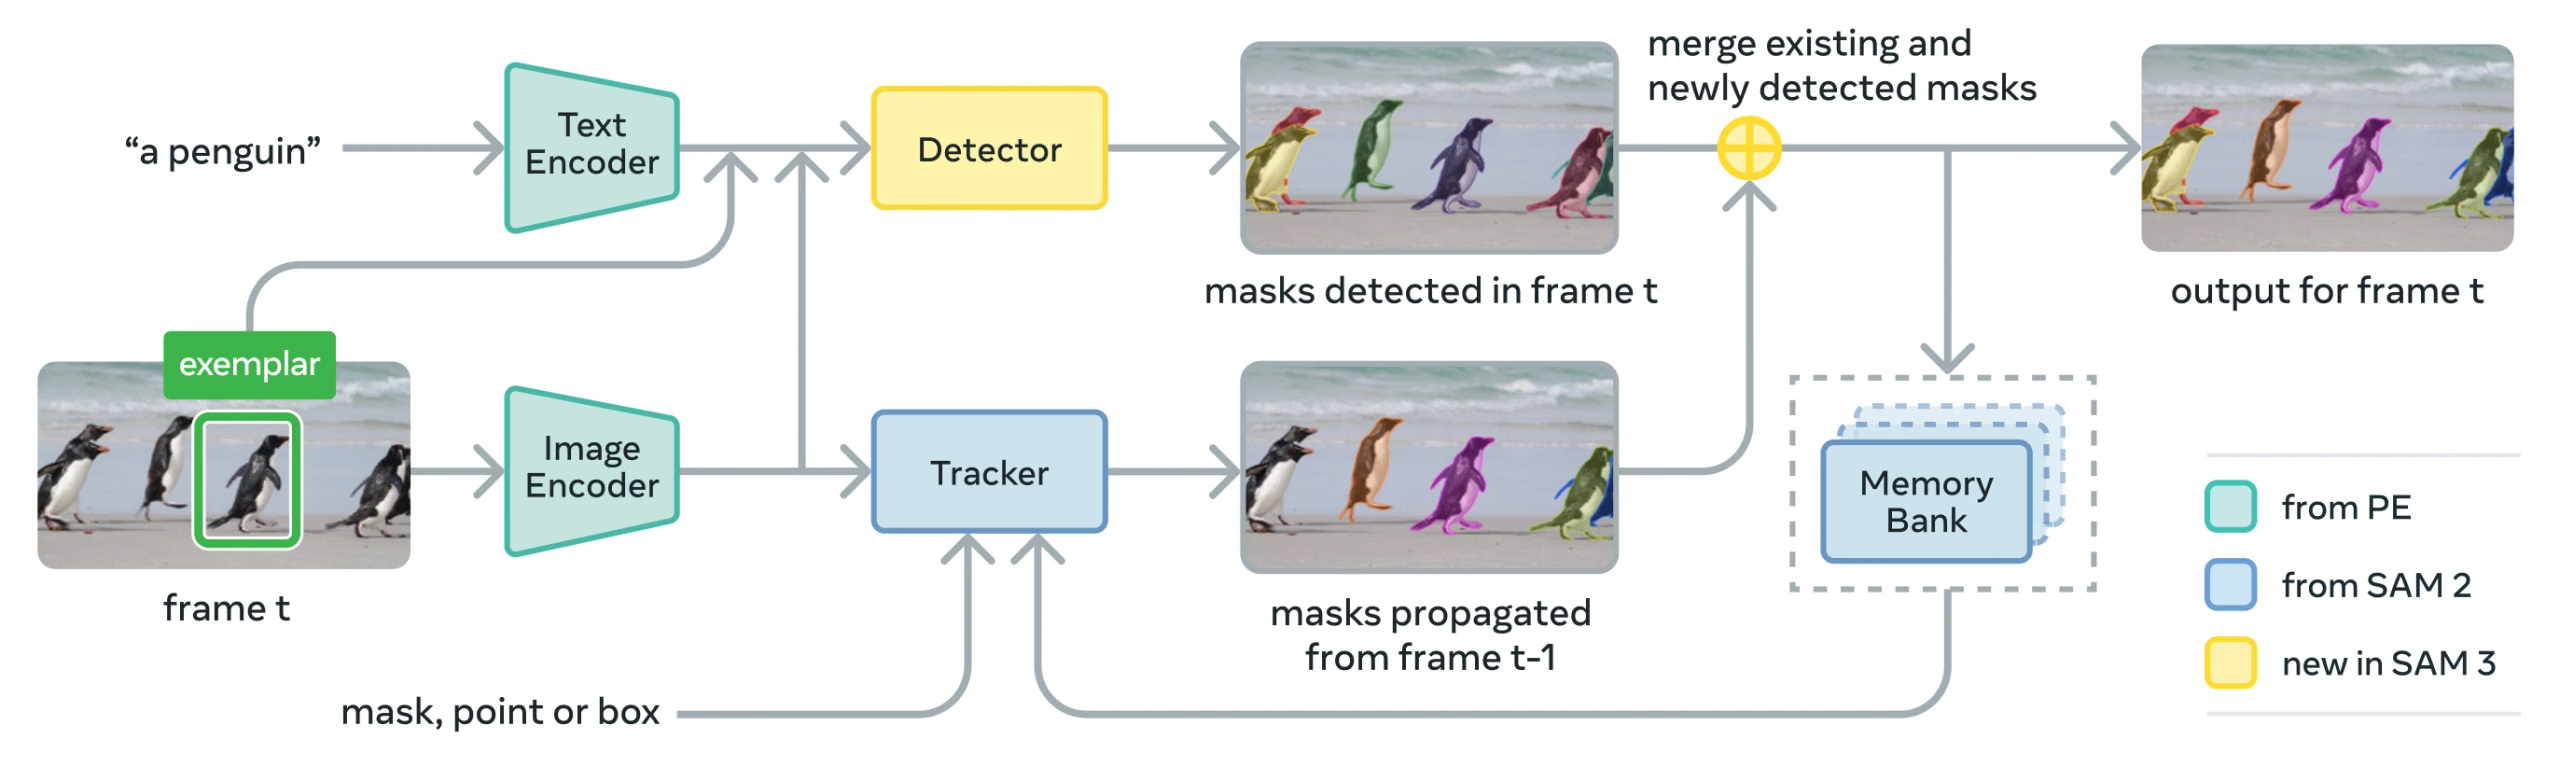
SAM 3 besteht aus einem Detektor und einem Tracker, die sich eine Bildverarbeitungs-Backbone namens Perception Encoder (PE) teilen. Dieses entkoppelte Design vermeidet Konflikte zwischen Aufgaben und ermöglicht sowohl die Erkennung auf Bildebene als auch die Verfolgung auf Videoebene. Die Schnittstelle ist mit der Python-Nutzung und der CLI-Nutzung von Ultralytics kompatibel.
Kernkomponenten#
-
Detektor: DETR-basierte Architektur zur Erkennung von Konzepten auf Bildebene
- Textencoder für Vorgaben in Form von Nominalgruppen
- Beispielbild-Encoder für bildbasierte Vorgaben
- Fusionsencoder, der Bildmerkmale anhand der Vorgaben konditioniert
- Neuartiger Präsenzkopf, der Erkennung („was“) und Lokalisierung („wo“) voneinander trennt
- Maskenkopf zur Erzeugung von Instanzsegmentierungsmasken
-
Tracker: Von SAM 2 übernommene, speicherbasierte Videosegmentierung
- Vorgaben-Encoder, Maskendekodierer, Speicher-Encoder
- Speicherbank zum Speichern des Erscheinungsbilds von Objekten über mehrere Frames hinweg
-
Präsenztoken: Ein trainiertes globales Token, das vorhersagt, ob das Zielkonzept im Bild oder Frame vorhanden ist. Dadurch wird die Erkennung verbessert, indem sie von der Lokalisierung getrennt wird.
Wichtige Innovationen#
- Entkoppelte Erkennung und Lokalisierung: Der Presence-Head sagt das globale Vorhandensein eines Konzepts voraus, während sich Proposal-Queries ausschließlich auf die Lokalisierung konzentrieren und so widersprüchliche Ziele vermeiden.
- Einheitliche Konzept- und visuelle Prompts: Unterstützt PCS (Konzept-Prompts) und PVS (visuelle Prompts wie Klicks/Boxen in SAM 2) in einem einzigen Modell.
- Interaktive Verfeinerung mit Beispielen: Nutzer können positive oder negative Bildbeispiele hinzufügen, um die Ergebnisse schrittweise zu verfeinern. Das Modell verallgemeinert dabei auf ähnliche Objekte, statt nur einzelne Instanzen zu korrigieren.
- Zeitliche Disambiguierung: Verwendet Masklet-Erkennungsscores und regelmäßige erneute Prompts, um Verdeckungen, überfüllte Szenen und Tracking-Fehler in Videos zu bewältigen und orientiert sich dabei an den Best Practices für Instanzsegmentierung und Tracking.
SA-Co-Datensatz#
SAM 3 wird mit Segment Anything with Concepts (SA-Co) trainiert, dem bisher größten und vielfältigsten Segmentierungsdatensatz von Meta, der über gängige Benchmarks wie COCO und LVIS hinausgeht.
Trainingsdaten#
| Datensatzkomponente | Beschreibung | Umfang |
|---|---|---|
| SA-Co/HQ | Hochwertige, von Menschen annotierte Bilddaten aus einer vierphasigen Datenpipeline | 5,2 Mio. Bilder, 4 Mio. einzigartige Nominalphrasen |
| SA-Co/SYN | Synthetischer Datensatz, der ohne menschliche Beteiligung durch KI annotiert wurde | 38 Mio. Nominalphrasen, 1,4 Mrd. Masken |
| SA-Co/EXT | 15 externe Datensätze, ergänzt um schwierige Negativbeispiele | Je nach Quelle unterschiedlich |
| SA-Co/VIDEO | Videoannotationen mit zeitlichem Tracking | 52,5 Tsd. Videos, 24,8 Tsd. einzigartige Nominalphrasen |
Benchmarkdaten#
Der SA-Co-Evaluierungsbenchmark umfasst 214 Tsd. einzigartige Phrasen aus 126 Tsd. Bildern und Videos und bietet damit über 50-mal mehr Konzepte als bestehende Benchmarks. Er umfasst:
- SA-Co/Gold: 7 Domänen, dreifach annotiert, um die Grenzen der menschlichen Leistung zu messen
- SA-Co/Silver: 10 Domänen, jeweils einmal von Menschen annotiert
- SA-Co/Bronze und SA-Co/Bio: 9 bestehende Datensätze, angepasst für die Konzeptsegmentierung
- SA-Co/VEval: Videobenchmark mit 3 Domänen (SA-V, YT-Temporal-1B, SmartGlasses)
Innovationen bei der Datenpipeline#
Die skalierbare Datenpipeline von SAM 3 mit Menschen und Modellen im Regelkreis erreicht durch Folgendes einen 2-mal höheren Annotationsdurchsatz:
- KI-Annotationstools: Auf Llama basierende Modelle schlagen verschiedene Nominalphrasen vor, darunter auch schwierige Negativbeispiele
- KI-Prüfer: Feinabgestimmte multimodale LLMs überprüfen die Maskenqualität und Vollständigkeit nahezu auf menschlichem Leistungsniveau
- Aktive Suche: Konzentriert den menschlichen Aufwand auf schwierige Fehlerfälle, bei denen KI an ihre Grenzen stößt
- Ontologiegestützt: Verwendet eine umfangreiche, auf Wikidata basierende Ontologie zur Abdeckung von Konzepten
Installation#
Installiere das Paket ultralytics oder aktualisiere es:
pip install -U ultralyticsIm Gegensatz zu anderen Ultralytics-Modellen werden die Gewichte von SAM 3 (sam3.pt) nicht automatisch heruntergeladen. Du musst zuerst auf der SAM 3-Modellseite auf Hugging Face Zugriff auf die Modellgewichte beantragen und nach der Genehmigung sam3.pt von dieser Seite herunterladen. Lege die heruntergeladene Datei sam3.pt in deinem Arbeitsverzeichnis ab oder gib beim Laden des Modells den vollständigen Pfad an.
Die Gewichte von SAM 3.1 (sam3.1_multiplex.pt) sind auf der SAM 3.1-Modellseite auf dieselbe Weise zugangsbeschränkt. Übergib sam3.1_multiplex.pt überall dort, wo die folgenden Bildbeispiele sam3.pt verwenden.
Wenn dieser Fehler bei der Vorhersage auftritt, ist das falsche Paket clip installiert. Installiere das richtige Paket clip mit folgendem Befehl:
pip uninstall clip -y
pip install git+https://github.com/ultralytics/CLIP.git
SAM 3 verwenden: Vielseitigkeit bei der Konzeptsegmentierung#
SAM 3 unterstützt Aufgaben der Prompt-basierten Konzeptsegmentierung (PCS) und der Prompt-basierten visuellen Segmentierung (PVS) über unterschiedliche Predictor-Schnittstellen:
Unterstützte Aufgaben und Modelle#
| Aufgabentyp | Prompt-Typen | Ausgabe |
|---|---|---|
| Konzeptsegmentierung (PCS) | Text (Nominalphrasen), Bildbeispiele | Alle Instanzen, die dem Konzept entsprechen |
| Visuelle Segmentierung (PVS) | Punkte, Boxen, Masken | Einzelne Objektinstanz (wie bei SAM 2) |
| Interaktive Verfeinerung | Beispiele oder Klicks schrittweise hinzufügen/entfernen | Verfeinerte Segmentierung mit höherer Genauigkeit |
Beispiele für die Konzeptsegmentierung#
Segmentierung mit Text-Prompts#
Finde und segmentiere alle Instanzen eines Konzepts mithilfe einer Textbeschreibung. Für Text-Prompts ist die Schnittstelle SAM3SemanticPredictor erforderlich.
from ultralytics.models.sam import SAM3SemanticPredictor

# Predictor mit Konfiguration initialisieren
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "model": "sam3.pt",
    "quantize": 16,  # FP16 für schnellere Inferenz verwenden
    "save": True,
}
predictor = SAM3SemanticPredictor(overrides=overrides)

# Bild einmalig für mehrere Abfragen festlegen
predictor.set_image("path/to/image.jpg")

# Mit mehreren Text-Prompts abfragen
results = predictor(text=["person", "bus", "glasses"])

# Funktioniert mit beschreibenden Phrasen
results = predictor(text=["person with red cloth", "person with blue cloth"])

# Mit einem einzelnen Konzept abfragen
results = predictor(text=["a person"])
Segmentierung mit Bildbeispielen#
Verwende Begrenzungsrahmen als visuelle Prompts, um alle ähnlichen Instanzen zu finden. Für den konzeptbasierten Abgleich ist außerdem SAM3SemanticPredictor erforderlich.
from ultralytics.models.sam import SAM3SemanticPredictor

# Predictor initialisieren
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16, "save": True}
predictor = SAM3SemanticPredictor(overrides=overrides)

# Bild festlegen
predictor.set_image("path/to/image.jpg")

# Beispiele mit Begrenzungsrahmen bereitstellen, um ähnliche Objekte zu segmentieren
results = predictor(bboxes=[[480.0, 290.0, 590.0, 650.0]])

# Mehrere Begrenzungsrahmen als Beispiele für dasselbe visuelle Konzept
results = predictor(bboxes=[[539, 599, 589, 639], [343, 267, 499, 662]])
Merkmalsbasierte Inferenz für mehr Effizienz#
Extrahiere Bildmerkmale einmal und verwende sie für mehrere Segmentierungsabfragen wieder, um die Effizienz zu steigern.
import cv2

from ultralytics.models.sam import SAM3SemanticPredictor
from ultralytics.utils.plotting import Annotator, colors

# Predictors initialisieren
overrides = {"conf": 0.50, "task": "segment", "mode": "predict", "model": "sam3.pt", "verbose": False}
predictor = SAM3SemanticPredictor(overrides=overrides)
predictor2 = SAM3SemanticPredictor(overrides=overrides)

# Merkmale mit dem ersten Predictor extrahieren
source = "path/to/image.jpg"
predictor.set_image(source)
src_shape = cv2.imread(source).shape[:2]

# Zweiten Predictor einrichten und Merkmale wiederverwenden
predictor2.setup_model()

# Inferenz mit gemeinsam genutzten Merkmalen und Text-Prompt ausführen
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, text=["person"])

# Inferenz mit gemeinsam genutzten Merkmalen und Begrenzungsrahmen-Prompt ausführen
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, bboxes=[[439, 437, 524, 709]])

# Ergebnisse visualisieren
if masks is not None:
    masks, boxes = masks.cpu().numpy(), boxes.cpu().numpy()
    im = cv2.imread(source)
    annotator = Annotator(im, pil=False)
    annotator.masks(masks, [colors(x, True) for x in range(len(masks))])

    cv2.imshow("result", annotator.result())
cv2.waitKey(0)Videokonzeptsegmentierung#
Konzepte über ein Video hinweg mit Begrenzungsrahmen verfolgen#
Erkenne und verfolge Objektinstanzen über Videobilder hinweg mithilfe von Begrenzungsrahmen-Prompts.
from ultralytics.models.sam import SAM3VideoPredictor

# Video-Predictor erstellen
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16}
predictor = SAM3VideoPredictor(overrides=overrides)

# Objekte mithilfe von Begrenzungsrahmen-Prompts verfolgen
results = predictor(source="path/to/video.mp4", bboxes=[[706.5, 442.5, 905.25, 555], [598, 635, 725, 750]], stream=True)

# Ergebnisse verarbeiten und anzeigen
for r in results:
    r.show()  # Bild mit Segmentierungsmasken anzeigen
Konzepte mit Text-Prompts verfolgen#
Verfolge alle Instanzen von Konzepten, die per Text angegeben werden, über Videobilder hinweg.
from ultralytics.models.sam import SAM3VideoSemanticPredictor

# Semantischen Video-Predictor initialisieren
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "imgsz": 640,
    "model": "sam3.pt",
    "quantize": 16,
    "save": True,
}
predictor = SAM3VideoSemanticPredictor(overrides=overrides)

# Konzepte mithilfe von Text-Prompts verfolgen
results = predictor(source="path/to/video.mp4", text=["person", "bicycle"], stream=True)

# Ergebnisse verarbeiten
for r in results:
    r.show()  # Bild mit verfolgten Objekten anzeigen

# Alternative: Mit Begrenzungsrahmen-Prompts verfolgen
results = predictor(
    source="path/to/video.mp4",
    bboxes=[[864, 383, 975, 620], [705, 229, 782, 402]],
    labels=[1, 1],  # Positive Bezeichnungen
    stream=True,
)
Visuelle Prompts (Kompatibilität mit SAM 2)#
SAM 3 ist vollständig abwärtskompatibel mit dem visuellen Prompting von SAM 2 für die Segmentierung einzelner Objekte:
Die grundlegende Schnittstelle SAM verhält sich genau wie SAM 2 und segmentiert ausschließlich den durch visuelle Prompts (Punkte, Boxen oder Masken) angegebenen Bereich.
from ultralytics import SAM

model = SAM("sam3.pt")

# Einzelpunkt-Prompt – segmentiert das Objekt an einer bestimmten Position
results = model.predict(source="path/to/image.jpg", points=[900, 370], labels=[1])
results[0].show()

# Mehrere Punkte – segmentiert ein einzelnes Objekt anhand mehrerer Punkthinweise
results = model.predict(source="path/to/image.jpg", points=[[400, 370], [900, 370]], labels=[1, 1])

# Box-Prompt – segmentiert das Objekt innerhalb einer Begrenzungsbox
results = model.predict(source="path/to/image.jpg", bboxes=[100, 150, 300, 400])
results[0].show()Mit SAM("sam3.pt") und visuellen Prompts (Punkten/Boxen/Masken) wird nur das jeweilige Objekt an dieser Position segmentiert, genau wie bei SAM 2. Um alle Instanzen eines Konzepts zu segmentieren, verwende SAM3SemanticPredictor mit Text- oder Beispiel-Prompts wie oben gezeigt.
Leistungsbenchmarks#
Bildsegmentierung#
SAM 3 erzielt Spitzenwerte in mehreren Benchmarks, darunter bei realen Datensätzen wie LVIS und COCO für die Segmentierung:
| Benchmark | Kennzahl | SAM 3 | Bisheriger Bestwert | Verbesserung |
|---|---|---|---|---|
| LVIS (Zero-Shot) | Masken-AP | 47.0 | 38.5 | +22.1% |
| SA-Co/Gold | CGF1 | 65.0 | 34,3 (OWLv2) | +89.5% |
| COCO (Zero-Shot) | Box-AP | 53.5 | 52.2 (T-Rex2) | +2.5% |
| ADE-847 (semantische Segmentierung) | mIoU | 14.7 | 9.2 (APE-D) | +59.8% |
| PascalConcept-59 | mIoU | 59.4 | 58.5 (APE-D) | +1.5% |
| Cityscapes (semantische Segmentierung) | mIoU | 65.1 | 44.2 (APE-D) | +47.3% |
Entdecke Datensatzoptionen für schnelle Experimente in Ultralytics-Datensätzen.
Leistung bei der Videosegmentierung#
SAM 3 bietet deutliche Verbesserungen gegenüber SAM 2 und bisherigen Spitzenmodellen in Videobenchmarks wie DAVIS 2017 und YouTube-VOS:
| Benchmark | Kennzahl | SAM 3 | SAM 2.1 L | Verbesserung |
|---|---|---|---|---|
| MOSEv2 | J&F | 60.1 | 47.9 | +25.5% |
| DAVIS 2017 | J&F | 92.0 | 90.7 | +1.4% |
| LVOSv2 | J&F | 88.2 | 79.6 | +10.8% |
| SA-V | J&F | 84.6 | 78.4 | +7.9% |
| YTVOS19 | J&F | 89.6 | 89.3 | +0.3% |
Few-Shot-Anpassung#
SAM 3 lässt sich mit wenigen Beispielen an neue Domänen anpassen. Das ist für datenzentrierte KI-Workflows relevant:
| Benchmark | AP mit 0 Beispielen | AP mit 10 Beispielen | Bisheriger Bestwert (10 Beispiele) |
|---|---|---|---|
| ODinW13 | 59.9 | 71.6 | 67.9 (gDino1.5-Pro) |
| RF100-VL | 14.3 | 35.7 | 33.7 (gDino-T) |
Effektivität der interaktiven Verfeinerung#
Das exemplarbasierte Prompting auf Konzeptebene von SAM 3 konvergiert deutlich schneller als visuelles Prompting:
| Hinzugefügte Prompts | CGF1-Wert | Zuwachs gegenüber nur Text | Zuwachs gegenüber der PVS-Baseline |
|---|---|---|---|
| Nur Text | 46.4 | Baseline | Baseline |
| +1 Beispiel | 57.6 | +11.2 | +6.7 |
| +2 Beispiele | 62.2 | +15.8 | +9.7 |
| +3 Beispiele | 65.0 | +18.6 | +11.2 |
| +4 Beispiele | 65.7 | +19.3 | +11.5 (Plateau) |
Genauigkeit der Objektzählung#
SAM 3 zählt genau, indem alle Instanzen segmentiert werden – eine häufige Anforderung bei der Objektzählung:
| Benchmark | Genauigkeit | MAE | gegenüber dem besten MLLM |
|---|---|---|---|
| CountBench | 95.6% | 0.11 | 92.4% (Gemini 2.5) |
| PixMo-Count | 87.3% | 0.22 | 88.8% (Molmo-72B) |
Vergleich von SAM 3, SAM 2 und YOLO#
Hier vergleichen wir die Fähigkeiten von SAM 3 mit SAM 2 und den YOLO26-Modellen:
| Fähigkeit | SAM 3 | SAM 2 | YOLO26n-seg |
|---|---|---|---|
| Konzeptsegmentierung | ✅ Alle Instanzen anhand von Text/Beispielen | ❌ Nicht unterstützt | ❌ Nicht unterstützt |
| Visuelle Segmentierung | ✅ Einzelne Instanz (kompatibel mit SAM 2) | ✅ Einzelne Instanz | ✅ Alle Instanzen |
| Zero-Shot-Fähigkeit | ✅ Offenes Vokabular | ✅ Geometrische Prompts | ❌ Geschlossene Klassenmenge |
| Interaktive Verfeinerung | ✅ Beispiele + Klicks | ✅ Nur Klicks | ❌ Nicht unterstützt |
| Video-Tracking | ✅ Mehrere Objekte mit Identitäten | ✅ Mehrere Objekte | ✅ Mehrere Objekte |
| LVIS-Masken-AP (Zero-Shot) | 47.0 | Nicht zutreffend | Nicht zutreffend |
| MOSEv2 J&F | 60.1 | 47.9 | Nicht zutreffend |
| Geschwindigkeit (GPU, ms/Bild) | 2921 | 857 | 8.4 |
| Modellgröße | 3.45 GB | 162 MB (Basis) | 6.4 MB |
Geschwindigkeit gemessen auf NVIDIA RTX PRO 6000 mit torch==2.9.1 und ultralytics==8.4.19.
Wichtigste Erkenntnisse:
- SAM 3: Am besten für die Konzeptsegmentierung mit offenem Vokabular geeignet, um alle Instanzen eines Konzepts anhand von Text- oder Beispiel-Prompts zu finden
- SAM 2: Am besten für die interaktive Segmentierung einzelner Objekte in Bildern und Videos mit geometrischen Prompts geeignet
- YOLO26: Am besten für echtzeitfähige, schnelle Segmentierung mit optionaler NMS-freier End-to-End-Inferenz geeignet; für den Einsatz auf GPUs, CPUs und Edge-Geräten in viele Formate exportierbar
- YOLOE: Am besten geeignet für Echtzeit-Erkennung mit offenem Vokabular und Segmentierung anhand von Text- oder visuellen Prompts
Vergleich von SAM und YOLO#
Vergleich von SAM 3, SAM 2, SAM, MobileSAM und FastSAM mit den Ultralytics-Segmentierungsmodellen YOLO (YOLOv8, YOLO11, YOLO26) hinsichtlich Größe, Parameteranzahl und GPU-Inferenzgeschwindigkeit:
| Modell | Größe (MB) | Parameter (M) | Geschwindigkeit (GPU) (ms/Bild) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 1306 |
| Meta SAM2-b | 162 | 80.8 | 857 |
| Meta SAM2-t | 78.1 | 38.9 | 668 |
| Meta SAM3 | 3450 | 473.6 | 2921 |
| MobileSAM | 40.7 | 10.1 | 605 |
| FastSAM-s mit YOLOv8-Backbone | 23.7 | 11.8 | 55.9 |
| Ultralytics YOLOv8n-seg | 6.7 (515-mal kleiner) | 3.4 (139.1-mal weniger) | 17.4 (167-mal schneller) |
| Ultralytics YOLO11n-seg | 5.9 (585-mal kleiner) | 2.9 (163.1-mal weniger) | 12.6 (231-mal schneller) |
| Ultralytics YOLO26n-seg | 6.4 (539-mal kleiner) | 2.7 (175.2-mal weniger) | 8.4 (347-mal schneller) |
Dieser Vergleich zeigt die erheblichen Unterschiede bei Modellgrößen und Geschwindigkeiten zwischen SAM-Varianten und YOLO-Segmentierungsmodellen. SAM bietet zwar einzigartige Möglichkeiten zur automatischen Segmentierung, doch YOLO-Modelle, insbesondere YOLOv8n-seg, YOLO11n-seg und YOLO26n-seg, sind deutlich kleiner, schneller und recheneffizienter.
Die Tests wurden mit torch==2.9.1 und ultralytics==8.4.19 auf einer NVIDIA RTX PRO 6000 mit 96 GB VRAM ausgeführt. So kannst du den Test reproduzieren:
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# SAM3, SAM2-t, SAM2-b, SAM-b und MobileSAM profilieren
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt", "sam3.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# FastSAM-s profilieren
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# YOLO-Modelle profilieren
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
model(ASSETS, nms=False) # NMS-freier YOLO26-Head; für YOLOv8/YOLO11 ohne FunktionEvaluierungsmetriken#
SAM 3 führt neue Metriken für die PCS-Aufgabe ein, die bekannte Kennzahlen wie F1-Score, Präzision und Recall ergänzen.
Klassifikationsgesteuerter F1-Score (CGF1)#
Die zentrale Metrik, die Lokalisierung und Klassifizierung kombiniert:
CGF1 = 100 × pmF1 × IL_MCC
Dabei gilt:
- pmF1 (Positive Macro F1): Misst die Lokalisierungsqualität bei positiven Beispielen
- IL_MCC (Matthews-Korrelationskoeffizient auf Bildebene): Misst die Genauigkeit der binären Klassifizierung („Ist das Konzept vorhanden?“)
Warum diese Metriken?#
Herkömmliche AP-Kennzahlen berücksichtigen die Kalibrierung nicht, was den praktischen Einsatz von Modellen erschwert. Indem nur Vorhersagen mit einer Konfidenz von über 0,5 bewertet werden, setzen die Kennzahlen von SAM 3 eine gute Kalibrierung voraus und bilden reale Nutzungsmuster in interaktiven Vorhersage- und Verfolgungsschleifen nach.
Wichtige Ablationen und Erkenntnisse#
Einfluss des Presence-Heads#
Der Presence-Head entkoppelt die Erkennung von der Lokalisierung und führt so zu deutlichen Verbesserungen:
| Konfiguration | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| Ohne Presence | 57.6 | 0.77 | 74.7 |
| Mit Presence | 63.3 | 0.82 | 77.1 |
Der Presence-Head sorgt für eine CGF1-Steigerung um +5,7 (+9,9 %) und verbessert vor allem die Erkennungsfähigkeit (IL_MCC +6,5 %).
Auswirkung schwieriger Negativbeispiele#
| Schwierige Negativbeispiele pro Bild | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 0 | 31.8 | 0.44 | 70.2 |
| 5 | 44.8 | 0.62 | 71.9 |
| 30 | 49.2 | 0.68 | 72.3 |
Schwierige Negativbeispiele sind für die Erkennung mit offenem Vokabular entscheidend und verbessern IL_MCC um 54,5 % (0,44 → 0,68).
Skalierung der Trainingsdaten#
| Datenquellen | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| Nur externe Daten | 30.9 | 0.46 | 66.3 |
| Externe + synthetische Daten | 39.7 | 0.57 | 70.6 |
| Externe Daten + HQ | 51.8 | 0.71 | 73.2 |
| Alle drei | 54.3 | 0.74 | 73.5 |
Hochwertige Annotationen von Menschen führen zu deutlichen Verbesserungen gegenüber synthetischen oder ausschließlich externen Daten. Hintergrundinformationen zu Praktiken für die Datenqualität findest du unter Datenerfassung und Annotation.
Anwendungsfälle#
Die Fähigkeit von SAM 3 zur Konzeptsegmentierung ermöglicht neue Anwendungsfälle:
- Inhaltsmoderation: Finde alle Vorkommen bestimmter Inhaltstypen in Medienbibliotheken
- E-Commerce: Segmentiere alle Produkte eines bestimmten Typs in Katalogbildern und unterstütze so die automatische Annotation
- Medizinische Bildgebung: Alle Vorkommen bestimmter Gewebetypen oder Anomalien erkennen
- Autonome Systeme: Verfolge alle Verkehrsschilder, Fußgänger oder Fahrzeuge einer bestimmten Kategorie
- Videoanalyse: Zähle und verfolge alle Personen, die bestimmte Kleidung tragen oder bestimmte Handlungen ausführen
- Datensatzannotation: Annotiere schnell alle Vorkommen seltener Objektkategorien
- Wissenschaftliche Forschung: Quantifiziere und analysiere alle Proben, die bestimmten Kriterien entsprechen
SAM 3 Agent: Erweitertes Sprachverständnis#
SAM 3 lässt sich mit multimodalen großen Sprachmodellen (MLLMs) kombinieren, um komplexe Anfragen zu bearbeiten, die Schlussfolgerungen erfordern – ähnlich wie Systeme mit offenem Vokabular wie OWLv2 und T-Rex.
Leistung bei Schlussfolgerungsaufgaben#
| Benchmark | Kennzahl | SAM 3 Agent (Gemini 2.5 Pro) | Bisheriger Bestwert |
|---|---|---|---|
| ReasonSeg (Validierung) | gIoU | 76.0 | 65.0 (Spitzenwert) |
| ReasonSeg (Test) | gIoU | 73.8 | 61.3 (Spitzenwert) |
| OmniLabel (Validierung) | AP | 46.7 | 36.5 (REAL) |
| RefCOCO+ | Acc | 91.2 | 89.3 (LISA) |
Beispiele für komplexe Anfragen#
SAM 3 Agent kann Anfragen bearbeiten, die Schlussfolgerungen erfordern:
- „Personen, die sich hinsetzen, aber keine Geschenkbox in den Händen halten“
- „Der Hund, der der Kamera am nächsten ist und kein Halsband trägt“
- „Rote Objekte, die größer als die Hand der Person sind“
Das MLLM schlägt SAM 3 einfache Anfragen in Form von Nominalphrasen vor, analysiert die zurückgegebenen Masken und wiederholt den Vorgang, bis es zufrieden ist.
Einschränkungen#
SAM 3 hat folgende Einschränkungen:
- Komplexität von Phrasen: Am besten für einfache Nominalphrasen geeignet; lange beschreibende Ausdrücke oder komplexe Schlussfolgerungen erfordern möglicherweise die Integration eines MLLM
- Umgang mit Mehrdeutigkeit: Manche Konzepte bleiben grundsätzlich mehrdeutig (z. B. „kleines Fenster“, „gemütliches Zimmer“)
- Rechenanforderungen: Größer und langsamer als spezialisierte Erkennungsmodelle wie YOLO
- Umfang des Vokabulars: Auf elementare visuelle Konzepte ausgerichtet; ohne Unterstützung durch ein MLLM sind die Möglichkeiten zum kompositionalen Schlussfolgern begrenzt
- Seltene Konzepte: Die Leistung kann bei äußerst seltenen oder feingranularen Konzepten nachlassen, die in den Trainingsdaten nur unzureichend vertreten sind
Zitat#
@misc{carion2025sam3,
  title         = {SAM 3: Segment Anything with Concepts},
  author        = {Nicolas Carion and Laura Gustafson and Yuan-Ting Hu and Shoubhik Debnath and Ronghang Hu and Didac Suris and Chaitanya Ryali and Kalyan Vasudev Alwala and Haitham Khedr and Andrew Huang and Jie Lei and Tengyu Ma and Baishan Guo and Arpit Kalla and Markus Marks and Joseph Greer and Meng Wang and Peize Sun and Roman R{\"a}dle and Triantafyllos Afouras and Effrosyni Mavroudi and Katherine Xu and Tsung-Han Wu and Yu Zhou and Liliane Momeni and Rishi Hazra and Shuangrui Ding and Sagar Vaze and Francois Porcher and Feng Li and Siyuan Li and Aishwarya Kamath and Ho Kei Cheng and Piotr Doll{\'a}r and Nikhila Ravi and Kate Saenko and Pengchuan Zhang and Christoph Feichtenhofer},
  year          = {2025},
  eprint        = {2511.16719},
  archivePrefix = {arXiv},
  primaryClass  = {cs.CV},
  url           = {https://arxiv.org/abs/2511.16719}
}
Häufig gestellte Fragen#
SAM 3 wurde am 19. November 2025 von Meta veröffentlicht und ist vollständig in das Paket
ultralyticsintegriert. Über spezielle Prädiktoren werden Bildvorhersagen und Videoverfolgung unterstützt.Ja. SAM 3 ist vollständig in das Ultralytics-Python-Paket integriert und unterstützt Konzeptsegmentierung, visuelle Eingabeaufforderungen nach Art von SAM 2 sowie die Verfolgung mehrerer Objekte in Videos. SAM 3 und SAM 3.1 ermöglichen außerdem die Funktion intelligente Annotation auf der Ultralytics Platform. Dort ist SAM 3.1 das Standardmodell, und du kannst Bilder mit nur wenigen Klicks annotieren. Bei Erkennungsdatensätzen mit 1–200 Klassen erstellen SAM 3 Text und SAM 3.1 Text außerdem automatisch Annotationen anhand deiner Klassennamen. Die VLM-Bestenliste vergleicht ihre Genauigkeit mit der von Vision-Language-Modellen.
Ja, für Bildvorhersagen. Lade
sam3.1_multiplex.ptüberall dort, wo in den Bildbeispielen auf dieser Seitesam3.ptverwendet wird:SAM("sam3.1_multiplex.pt")für Punkt- und Box-Prompts undSAM3SemanticPredictorfür Text- und Beispiel-Prompts. Die Videoverfolgung mit Object Multiplex wird noch nicht unterstützt. Verwende daher weiterhinsam3.ptmit den Videovorhersagern. Unter SAM 3.1 findest du die Benchmarks von Meta.PCS ist eine neue, mit SAM 3 eingeführte Aufgabe, bei der alle Vorkommen eines visuellen Konzepts in einem Bild oder Video segmentiert werden. Im Gegensatz zur herkömmlichen Segmentierung, die auf ein bestimmtes Objektvorkommen abzielt, findet PCS jedes Vorkommen einer Kategorie. Zum Beispiel:
- Text-Prompt: „gelber Schulbus“ → segmentiert alle gelben Schulbusse in der Szene
- Bildbeispiel: Einen Hund einkreisen → alle Hunde im Bild segmentieren
- Kombiniert: „gestreifte Katze“ + Beispielbox → alle gestreiften Katzen segmentieren, die dem Beispiel entsprechen
Merkmal SAM 2 SAM 3 Aufgabe Ein einzelnes Objekt pro Prompt Alle Instanzen eines Konzepts Prompt-Typen Punkte, Boxen, Masken + Textphrasen, Bildbeispiele Erkennungsfähigkeit Benötigt einen externen Detektor Integrierter Detektor mit offenem Vokabular Erkennung Nur geometriebasiert Text- und visuelle Erkennung Architektur Nur Tracker Detektor + Tracker mit Presence-Head Zero-Shot-Leistung Nicht zutreffend (benötigt visuelle Prompts) 47,0 AP auf LVIS, 2× besser auf SA-Co Interaktive Verfeinerung Nur Klicks Klicks + Verallgemeinerung anhand von Beispielen SAM 3 behält die Abwärtskompatibilität mit visuellen Prompts von SAM 2 bei und ergänzt sie um Konzeptfunktionen.
SAM 3 wird mit dem Datensatz Segment Anything with Concepts (SA-Co) trainiert:
Trainingsdaten:
- 5,2 Mio. Bilder mit 4 Mio. einzigartigen Nominalphrasen (SA-Co/HQ) – hochwertige Annotationen von Menschen
- 52,5 Tsd. Videos mit 24,8 Tsd. einzigartigen Nominalphrasen (SA-Co/VIDEO)
- 1,4 Mrd. synthetische Masken für 38 Mio. Nominalphrasen (SA-Co/SYN)
- 15 externe Datensätze, ergänzt um schwierige Negativbeispiele (SA-Co/EXT)
Benchmark-Daten:
- 214 Tsd. einzigartige Konzepte in 126 Tsd. Bildern/Videos
- 50× mehr Konzepte als in bestehenden Benchmarks (z. B. umfasst LVIS ~4 Tsd. Konzepte)
- Dreifachannotation auf SA-Co/Gold zur Bestimmung der Grenzen menschlicher Leistung
Dieser Umfang und diese Vielfalt bilden die Grundlage für die Zero-Shot-Generalisierung von SAM 3 über Konzepte mit offenem Vokabular hinweg.
SAM 3 und YOLO26 eignen sich für unterschiedliche Anwendungsfälle:
Vorteile von SAM 3:
- Offenes Vokabular: Segmentiert jedes Konzept anhand von Text-Prompts, ohne dass ein Training erforderlich ist
- Zero-Shot: Funktioniert sofort mit neuen Kategorien
- Interaktiv: Die Verfeinerung anhand von Beispielen lässt sich auf ähnliche Objekte übertragen
- Konzeptbasiert: Findet automatisch alle Instanzen einer Kategorie
- Genauigkeit: 47,0 AP bei der Zero-Shot-Instanzsegmentierung auf LVIS
Vorteile von YOLO26:
- Geschwindigkeit: Die Inferenz ist um Größenordnungen schneller; optional steht ein durchgängiger Head ohne NMS zur Verfügung
- Effizienz: 539× kleinere Modelle (6,4 MB gegenüber 3,45 GB)
- Ressourcenschonend: Läuft auf Edge-Geräten und Mobilgeräten
- Echtzeit: Für den Einsatz in Produktivumgebungen optimiert
Empfehlung:
- Verwende SAM 3 für flexible Segmentierung mit offenem Vokabular, wenn du alle Instanzen von Konzepten finden möchtest, die durch Text oder Beispiele beschrieben werden.
- Verwende YOLO26 für den schnellen Einsatz in Produktivumgebungen, wenn die Kategorien im Voraus bekannt sind.
- Verwende SAM 2 für die interaktive Segmentierung einzelner Objekte mit geometrischen Prompts.
SAM 3 ist für einfache Nominalphrasen ausgelegt (z. B. „roter Apfel“, „Person mit Hut“). Bei komplexen Anfragen, die Schlussfolgerungen erfordern, kannst du SAM 3 mit einem MLLM als SAM 3 Agent kombinieren:
Einfache Anfragen (SAM 3 nativ):
- „gelber Schulbus“
- „gestreifte Katze“
- „Person mit rotem Hut“
Komplexe Anfragen (SAM 3 Agent mit MLLM):
- „Personen, die sitzen, aber keine Geschenkbox halten“
- „Der Hund, der der Kamera am nächsten ist und kein Halsband trägt“
- „Rote Objekte, die größer als die Hand der Person sind“
SAM 3 Agent erreicht 76,0 gIoU auf der Validierungsmenge von ReasonSeg (gegenüber dem bisherigen Bestwert von 65,0, eine Verbesserung um +16,9 %), indem die Segmentierung von SAM 3 mit den Schlussfolgerungsfähigkeiten eines MLLM kombiniert wird.
Auf dem SA-Co/Gold-Benchmark mit dreifacher menschlicher Annotation:
- Untere Grenze menschlicher Leistung: 74,2 CGF1 (konservativste annotierende Person)
- Leistung von SAM 3: 65,0 CGF1
- Ergebnis: 88 % der geschätzten unteren Grenze menschlicher Leistung
- Obere Grenze menschlicher Leistung: 81,4 CGF1 (großzügigste annotierende Person)
SAM 3 erzielt eine starke Leistung und nähert sich bei der Segmentierung von Konzepten mit offenem Vokabular der Genauigkeit von Menschen an. Der Unterschied zeigt sich vor allem bei mehrdeutigen oder subjektiven Konzepten (z. B. „kleines Fenster“, „gemütliches Zimmer“).


Kommentare105
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
 Glenn JocherUltralytics(bearbeitet)
SAM 3 looks like a big step forward for open-vocabulary segmentation, and it is now supported natively in
ultralytics. This page covers text, exemplar and video prompts; thesam3.ptweights are gated and must be requested from Meta on Hugging Face first.Feel free to drop questions or comments for the team below!
7koolfox
Incredible, when you think it’s available for use?
2- Glenn JocherUltralytics(bearbeitet)
SAM 3 is available now in
ultralytics: runpip install -U ultralyticsand see this page for usage. Thesam3.ptweights must be requested from Meta first. Abdulhady-WITCo
Appreciate the effort, and can't wait for your implementation. It's resource heavy already but I'm sure your optimisation will make a difference. Best of luck.
- Glenn JocherUltralytics(bearbeitet)
Thanks for the kind words—most of the credit goes to the Meta SAM team and the Ultralytics community. SAM 3 is now available in
ultralytics, and this page covers exactly those trade-offs, so you can balance its open-vocabulary power against lighter options like YOLO26 or SAM 2 on your hardware.
mishaogui
sam3如何把預訓練模型導出onnx進行推理,目前官方好像還不支持導出,求導出和推理。
1- Glenn JocherUltralytics(bearbeitet)
目前
ultralytics里 SAM 3 只支持predict/track推理,还没有提供把sam3.pt导出 ONNX 的官方流程(yolo export主要面向 YOLO 等可部署导出管线的模型);建议先按 SAM 3 使用文档 用 PyTorch 方式部署推理。如果你的目标是 ONNX 部署分割(固定类别/已知类别),更推荐直接用可导出的 YOLO26 分割 并参考 Export 模式;若你这边是“必须 SAM3→ONNX”的需求,麻烦在 Ultralytics 新建 Issue 说明场景并附上
yolo checks和最小复现脚本,方便我们评估支持路径。
tomer196
Hi, thanks for the great work. I am trying to use sam3.1. Is it supported? I tried using sam3.1 weights, and it seems to work, but each frame the objects get new IDs. Am I doing something wrong? Thanks
- Glenn JocherUltralytics(bearbeitet)
SAM 3.1 is supported for image prediction: load
sam3.1_multiplex.ptwherever the image examples usesam3.pt(SAM("sam3.1_multiplex.pt")for point and box prompts,SAM3SemanticPredictorfor text and exemplar prompts). Object Multiplex video tracking is not supported yet, so usesam3.ptwithSAM3VideoPredictororSAM3VideoSemanticPredictor. For stable identities across frames, run a video predictor on the full video rather than image inference frame-by-frame, since per-frame inference assigns fresh IDs each time. See the SAM 3 docs and the SAM predictor reference, and if you’re already doing that please drop a minimal repro plusyolo checksoutput here so the team can take a closer look.
yccckid
你好,我测试下来输入的常见的类别的提示词(包括一些限定词)都是可以分割的。不过提示词输入得越多确实MLLM时间会更长,sam分割倒是挺快的。你说的这个“ 只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象 ”是在分割什么物体?物体的表面纹理是不是比较sparsely textured?怎么解决的?谢谢
On Thu, 23 Apr 2026 at 09:11, Yiwang2333 @.***> wrote:
我之前使用MLLM与SAM3结合起来成为SAM 3 Agent进行测试并没有发现分割的掩码出现空洞问题,他们都是完整的,只不过会出现分割不了提示词中的内容,而且耗时这方面会增加,这也正常。只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/22441?email_source=notifications&email_token=APKLLPPMDYK4F36HG6B3BOL4XFUUJA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRWG43TCMBVUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16677105, or unsubscribe https://github.com/notifications/unsubscribe-auth/APKLLPKUZ2OAWS3Y672TETD4XFUUJAVCNFSM6AAAAACJTVH7HGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMNRXG4YTANI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
这种情况更像是
SAM("sam3.pt")的视觉提示分割问题而不是概念分割本身:单点或粗掩码在细长边界、低对比度或稀疏纹理目标上更容易出现碎片和空洞,通常可通过增加正负点、改用更紧的框提示,或直接用SAM3SemanticPredictor做文本/示例提示来改善,相关用法见 SAM 3 文档;如果你愿意,也欢迎把一张示例图和最小复现代码直接发在这个讨论里,我们可以按你的具体 case 看看。 Yiwang2333
其实我也想把示例和代码文件展示出来,但是可能我太蠢了不知道怎么发在这个讨论中,我已急哭😭
- Glenn JocherUltralytics
没关系,直接发在这里就可以:图片可直接拖到评论框上传,代码按 GitHub Markdown 写法 用代码块贴出;如果文件太大,就先发一个最小复现示例,只保留
model初始化、输入图像、提示词和实际输出即可,例如:from ultralytics import SAM model = SAM("sam3.pt") results = model.predict("test.jpg", points=[900, 370], labels=[1]) print(results[0].masks.data.shape if results[0].masks is not None else None)如果暂时不方便传图,也可以先把异常现象和文字版输出贴出来,我们继续帮你看。
一、单点分割 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
正样本(1) + 负样本(0),点数与标签一一对应
point_coords = np.array([ [900.0, 370.0], # 前景点:点在目标上 [800.0, 400.0], # 背景点:点在要排除的区域 ]) point_labels = np.array([1, 0])
masks, scores, logits = model.predict_inst( inference_state, point_coords=point_coords, point_labels=point_labels, multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
二、交互式细化 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
若需要文本提示(与 demo 一致):
inference_state = processor.set_text_prompt(state=inference_state, prompt="your english prompt")
init_x = 900.0 init_y = 370.0 refinement_points = [[910.0, 380.0], [920.0, 360.0]] refinement_labels = [1, 0]
all_points = [[init_x, init_y]] + refinement_points all_labels = [1] + refinement_labels
masks, scores, logits = model.predict_inst( inference_state, point_coords=np.array(all_points), point_labels=np.array(all_labels), multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
测试使用的是同一张图片,分割的内容是图中汽车,在单点分割和交互式细化中正负样本点结合使用会出现分割车辆边缘出现参差不齐零碎现象
- Glenn JocherUltralytics
感谢把代码贴出来,这更像是交互式点提示的行为而不是“汽车”这个类别本身:车窗反光、轮胎空隙和细长边界会让负点一旦靠近车身就容易把掩码边缘切碎或挖空,而且
multimask_output=True返回的最高分候选也不一定是最平滑的那个;建议先把负点移到目标外更远的位置、在断裂边缘补几个正点,或直接改用框/示例提示,如果你的目标是稳定分割整辆车,SAM3SemanticPredictor的文本/示例提示通常比稀疏点提示更稳,相关接口可参考 SAM 3 文档里的视觉提示与概念分割说明。 感谢您的回答,我还有一个问题,就是文本提示分割时,文本提示词可以对多张图片起作用,能做输入一个文本可以对所有图片进行分割,这一个功能已经实现。 但是有一个我实在是难以实现,就是比如有多张图片A、B、C、D...,在纯框选示例提示分割下,能不能做到只在A图上进行框选,然后进行纯框选示例提示分割时可以对A、B、C、D...多张图片进行分割呢。也就是实现一批图片中,只在一张图片上进行框选就能进行所有图片的分割,类似于图片搜索一样,在一批图片中随机挑一张图片,在这张挑选的图片中框选出汽车然后所有图片中的汽车都能被分割出来(类似在一批图片中框选后搜索出有汽车的图片进行分割)。我不知道这个功能是否能做到。 目前我使用的方法是在框选时将框选的目标进行切块,然后拼接在每一张待搜索图片上,最后根据拼接图片中的小目标切块进行示例提示分割,来实现一张图中框选能对所有图片进行分割,不过这种方法的效果有些一般,有时候分割不到东西或者是遗漏一些需要分割的目标。 还有一种方法是评论区向我提供的思路,将几何特征缓存下来,然后再另一张图片上应用这个几何特征,参考https://github.com/leon0514/trt-sam3,但是这位先生也提到了效果不好,目前我也正在尝试实现这种方法。 或者是理解在单图时框选示例提示分割到底在做什么,然后将这个行为重复作用于其他图片,这样是否也能实现呢?
- Glenn JocherUltralytics
目前原生
SAM3SemanticPredictor还不支持“在 A 图框一次,然后直接对 B/C/D 这类独立图片做纯示例检索+分割”;bboxes示例提示是作用在当前set_image()的那张图上,而文档里的inference_features()也是复用同一张图的特征、不是跨图迁移,所以更可靠的做法还是先用文本提示或检索/检测筛出候选图,再逐张做 SAM 3 分割,接口细节可参考 SAM3SemanticPredictor 参考。 好的,谢谢您的回复
shspc
ultralytics支持从其他图像中抽取特征作为视觉提示吗
在SAM3中
- Glenn JocherUltralytics
目前公开接口里,SAM 3 支持用
SAM3SemanticPredictor的bboxes做 exemplar 式视觉提示,也支持用inference_features()复用已提取特征,但文档里的用法主要是对当前图像做特征复用,不是直接把“另一张图像”的特征当作 prompt 传入;你可以先参考 SAM 3 文档 和 predictor API,如果你的目标是跨图像 exemplar prompting,欢迎把最小复现流程贴在这里,团队会继续看。 aoaoy288-oss
想知道,sam3是否能导成ONNX等格式
ZePequeno25
gostei bastante da para integrar diferentes modelos
SWTZJD
想请问SAM3最低支持的python版本和pytorch版本
- Glenn JocherUltralytics
欢迎直接把环境信息贴在这里,团队会看到;按目前公开信息,
SAM 3自ultralytics>=8.3.237起已集成,而ultralytics的基础要求是 Python>=3.8、PyTorch>=1.8,所以SAM 3目前至少按这组版本起步,参考 SAM 3 文档 和 Ultralytics PyPI 安装说明。 (docs.ultralytics.com)
cyt1990cyt1990-dev
运行环境为:Ultralytics 8.4.21 Python-3.11.8 torch-2.5.1+cu121 CUDA:0 (NVIDIA GeForce RTX 4070, 12282MiB) 运行使用掩码提示的概念分割的示例程序报错如下:WARNING imgsz=[640] must be multiple of max stride 14, updating to [644] Traceback (most recent call last): File "C:\Users\admin\PycharmProjects\PythonProject\testMasks.py", line 12, in results = predictor(source=img_path, masks=[rough]) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 225, in call return list(self.stream_inference(source, model, *args, **kwargs)) # merge list of Results into one ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\utils_contextlib.py", line 36, in generator_context response = gen.send(None) ^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 330, in stream_inference preds = self.inference(im, *args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 205, in inference return self.prompt_inference(im, bboxes, points, labels, masks, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 236, in prompt_inference return self._inference_features(features, *prompts, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 814, in _inference_features pred_masks, pred_scores, _, _ = self.model.sam_mask_decoder( ^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1736, in _wrapped_call_impl return self._call_impl(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1747, in _call_impl return forward_call(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 334, in forward masks, iou_pred, mask_tokens_out, object_score_logits = self.predict_masks( ^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 398, in predict_masks src = src + dense_prompt_embeddings ~~~~^~~~~~~~~~~~~~~~~~~~~~~~~ RuntimeError: The size of tensor a (46) must match the size of tensor b (161) at non-singleton dimension 3
运行代码如下所示: import cv2 import numpy as np from ultralytics.models.sam import SAM3Predictor
predictor = SAM3Predictor(overrides=dict(task="segment", mode="predict", model="sam/sam3.pt")) img_path = "测试图片/测试图片1/Out.jpg" rough = cv2.imread("测试图片/测试图片1/rough.jpg", cv2.IMREAD_GRAYSCALE) rough = (rough > 0).astype(np.uint8)
results = predictor(source=img_path, masks=[rough]) for result in results: annotated_img = result.plot() cv2.imshow("SAM with Mask Prompt", annotated_img) cv2.waitKey(0) cv2.destroyAllWindows()
图片Out.jpg,rough.jpg是大小为4024*3036,位深度为8的灰度图片
- Glenn JocherUltralytics
感谢补充代码,这个报错看起来不是图片分辨率本身的问题,而是
SAM3Predictor走masks=提示时出现了特征尺寸不匹配;按 SAM 3 文档 当前概念分割应使用SAM3SemanticPredictor配合text或示例bboxes,而SAM("sam3.pt")/SAM3Predictor主要是单对象视觉提示流程。若你在最新版本下仍需要masks提示,请新开一个 issue 并附上yolo checks输出、完整文本回溯和最小可复现脚本,方便我们确认这是否是 SAM 3 的一个 bug。
max-dev-14
I'd compared facebook/sam3 and ultralytics/sam3. I set up both the models for inference as follow: imgsz=1008, half=True, conf=0.5 and prompts = [ "person", "car", "truck", "tractor", "building", "combine harvester", "power lines", "clear sky", "trees", "crop field", "harvested field", "grassy field", "dark frame edges", "farm lane", "windrow" ] I'd attached scripts I used for inference: ul-sam3.py - ultralytics/sam3 inference. fb-sam3.py - facebook/sam3 inference.
I expected that there would be the same results of inference on the same videos and paramteres above. But I'd got different segments, as it can be seen on the screens below (there are original frame to the left, facebook/sam3 segmentation on the middle and ultralytics/sam3 segmentation to the right).
Can someone explain me why it's happened like this?
- Glenn JocherUltralytics
Thanks for raising it here — exact parity with
facebookresearch/sam3isn’t expected, because the Ultralytics integration uses its own SAM 3 predictor path for resizing/preprocessing and postprocessing, so matchingimgsz,half,conf, and prompts alone won’t guarantee identical masks; see the SAM 3 docs and the predictor reference. If you’d like us to check whether this is a bug rather than an implementation difference, please open a new issue with a minimal reproducible example, confirm both runs use the samesam3.pt, and includeyolo checksplus the full text outputs from both scripts.