YOLOv7: Trainierbare Sammlung kostenloser Verbesserungen
YOLOv7, veröffentlicht im Juli 2022, bedeutete bei seiner Veröffentlichung einen bedeutenden Fortschritt bei der Objekterkennung in Echtzeit. Mit 56,8 % AP erzielte es die höchste Genauigkeit unter Echtzeitdetektoren, die mit mindestens 30 FPS auf einer V100 GPU liefen. YOLOv7 übertraf zeitgenössische Objektdetektoren wie YOLOR, YOLOX, Scaled-YOLOv4 und YOLOv5 hinsichtlich Geschwindigkeit und Genauigkeit. Das Modell wurde ohne weitere Datensätze oder vortrainierte Gewichte von Grund auf auf dem MS-COCO-Datensatz trainiert. Der Quellcode von YOLOv7 ist auf GitHub verfügbar. Beachte, dass neuere Modelle wie YOLO26 und YOLO11 inzwischen eine höhere Genauigkeit bei besserer Effizienz erzielen.
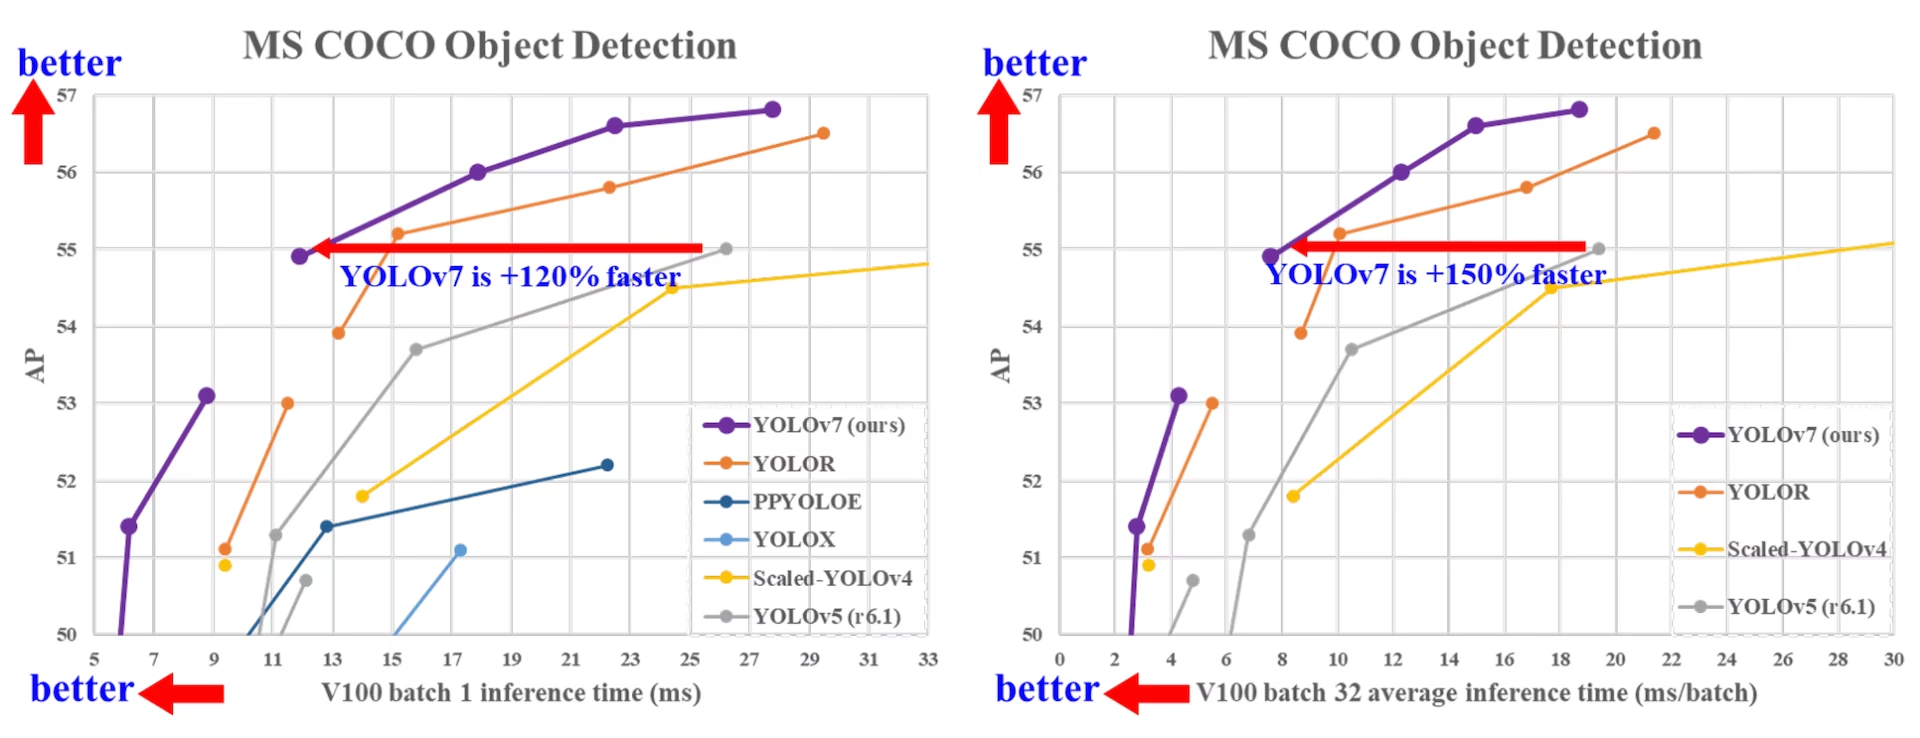
Vergleich führender Objektdetektoren#
Laut der Vergleichstabelle im YOLOv7-Paper bietet YOLOv7 insgesamt den besten Kompromiss zwischen Geschwindigkeit und Genauigkeit. Im Vergleich zu YOLOv5-N (r6.1) ist YOLOv7-tiny-SiLU um 127 fps schneller und bei der AP um 10,7 % genauer. Außerdem erreicht YOLOv7 eine AP von 51,4 % bei 161 fps, während PPYOLOE-L dieselbe AP bei nur 78 fps erzielt. YOLOv7 benötigt zudem 41 % weniger Parameter als PPYOLOE-L.
Im Vergleich zu YOLOv5-L (r6.1) mit 99 fps erreicht YOLOv7-X 114 fps und verbessert die AP um 3,9 %. Im Vergleich zum ähnlich großen YOLOv5-X (r6.1) ist YOLOv7-X um 31 fps schneller, benötigt 22 % weniger Parameter und 8 % weniger Rechenleistung und verbessert die AP um 2,2 % (Quelle).
| Modell | Parameter (M) | FLOPs (G) | Größe (Pixel) | FPS | APtest / val50-95 | APtest50 | APtest75 | APtestS | APtestM | APtestL |
|---|---|---|---|---|---|---|---|---|---|---|
| YOLOX-S | 9.0 | 26.8 | 640 | 102 | 40.5% / 40.5% | - | - | - | - | - |
| YOLOX-M | 25.3 | 73.8 | 640 | 81 | 47.2% / 46.9% | - | - | - | - | - |
| YOLOX-L | 54.2 | 155.6 | 640 | 69 | 50.1% / 49.7% | - | - | - | - | - |
| YOLOX-X | 99.1 | 281.9 | 640 | 58 | 51.5% / 51.1% | - | - | - | - | - |
| PPYOLOE-S | 7.9 | 17.4 | 640 | 208 | 43.1% / 42.7% | 60.5% | 46.6% | 23.2% | 46.4% | 56.9% |
| PPYOLOE-M | 23.4 | 49.9 | 640 | 123 | 48.9% / 48.6% | 66.5% | 53.0% | 28.6% | 52.9% | 63.8% |
| PPYOLOE-L | 52.2 | 110.1 | 640 | 78 | 51.4% / 50.9% | 68.9% | 55.6% | 31.4% | 55.3% | 66.1% |
| PPYOLOE-X | 98.4 | 206.6 | 640 | 45 | 52.2% / 51.9% | 69.9% | 56.5% | 33.3% | 56.3% | 66.4% |
| YOLOv5-N (r6.1) | 1.9 | 4.5 | 640 | 159 | - / 28.0% | - | - | - | - | - |
| YOLOv5-S (r6.1) | 7.2 | 16.5 | 640 | 156 | - / 37.4% | - | - | - | - | - |
| YOLOv5-M (r6.1) | 21.2 | 49.0 | 640 | 122 | - / 45.4% | - | - | - | - | - |
| YOLOv5-L (r6.1) | 46.5 | 109.1 | 640 | 99 | - / 49.0% | - | - | - | - | - |
| YOLOv5-X (r6.1) | 86.7 | 205.7 | 640 | 83 | - / 50.7% | - | - | - | - | - |
| YOLOR-CSP | 52.9 | 120.4 | 640 | 106 | 51.1% / 50.8% | 69.6% | 55.7% | 31.7% | 55.3% | 64.7% |
| YOLOR-CSP-X | 96.9 | 226.8 | 640 | 87 | 53.0% / 52.7% | 71.4% | 57.9% | 33.7% | 57.1% | 66.8% |
| YOLOv7-tiny-SiLU | 6.2 | 13.8 | 640 | 286 | 38.7% / 38.7% | 56.7% | 41.7% | 18.8% | 42.4% | 51.9% |
| YOLOv7 | 36.9 | 104.7 | 640 | 161 | 51.4% / 51.2% | 69.7% | 55.9% | 31.8% | 55.5% | 65.0% |
| YOLOv7-X | 71.3 | 189.9 | 640 | 114 | 53.1% / 52.9% | 71.2% | 57.8% | 33.8% | 57.1% | 67.4% |
| YOLOv5-N6 (r6.1) | 3.2 | 18.4 | 1280 | 123 | - / 36.0% | - | - | - | - | - |
| YOLOv5-S6 (r6.1) | 12.6 | 67.2 | 1280 | 122 | - / 44.8% | - | - | - | - | - |
| YOLOv5-M6 (r6.1) | 35.7 | 200.0 | 1280 | 90 | - / 51.3% | - | - | - | - | - |
| YOLOv5-L6 (r6.1) | 76.8 | 445.6 | 1280 | 63 | - / 53.7% | - | - | - | - | - |
| YOLOv5-X6 (r6.1) | 140.7 | 839.2 | 1280 | 38 | - / 55.0% | - | - | - | - | - |
| YOLOR-P6 | 37.2 | 325.6 | 1280 | 76 | 53.9% / 53.5% | 71.4% | 58.9% | 36.1% | 57.7% | 65.6% |
| YOLOR-W6 | 79.8 | 453.2 | 1280 | 66 | 55.2% / 54.8% | 72.7% | 60.5% | 37.7% | 59.1% | 67.1% |
| YOLOR-E6 | 115.8 | 683.2 | 1280 | 45 | 55.8% / 55.7% | 73.4% | 61.1% | 38.4% | 59.7% | 67.7% |
| YOLOR-D6 | 151.7 | 935.6 | 1280 | 34 | 56.5% / 56.1% | 74.1% | 61.9% | 38.9% | 60.4% | 68.7% |
| YOLOv7-W6 | 70.4 | 360.0 | 1280 | 84 | 54.9% / 54.6% | 72.6% | 60.1% | 37.3% | 58.7% | 67.1% |
| YOLOv7-E6 | 97.2 | 515.2 | 1280 | 56 | 56.0% / 55.9% | 73.5% | 61.2% | 38.0% | 59.9% | 68.4% |
| YOLOv7-D6 | 154.7 | 806.8 | 1280 | 44 | 56.6% / 56.3% | 74.0% | 61.8% | 38.8% | 60.1% | 69.5% |
| YOLOv7-E6E | 151.7 | 843.2 | 1280 | 36 | 56.8% / 56.8% | 74.4% | 62.1% | 39.3% | 60.5% | 69.0% |
Übersicht#
Die Objekterkennung in Echtzeit ist ein wichtiger Bestandteil vieler Computer-Vision-Systeme, darunter die Verfolgung mehrerer Objekte, autonomes Fahren, Robotik und die medizinische Bildanalyse. In den letzten Jahren lag der Schwerpunkt bei der Entwicklung von Echtzeit-Objekterkennung auf effizienten Architekturen und der Verbesserung der Inferenzgeschwindigkeit verschiedener CPUs, GPUs und neuronaler Verarbeitungseinheiten (NPUs). YOLOv7 unterstützt sowohl mobile GPUs als auch GPU-Geräte – vom Netzwerkrand bis zur Cloud.
Im Gegensatz zu herkömmlichen Echtzeit-Objektdetektoren, die sich auf die Optimierung der Architektur konzentrieren, setzt YOLOv7 auf die Optimierung des Trainingsprozesses. Dazu gehören Module und Optimierungsmethoden, die die Genauigkeit der Objekterkennung verbessern sollen, ohne die Inferenzkosten zu erhöhen – ein Konzept, das als „trainable bag-of-freebies“ bekannt ist.
Wichtige Funktionen#
YOLOv7 führt mehrere wichtige Funktionen ein:
-
Modell-Reparametrisierung: YOLOv7 schlägt ein gezielt reparametrisiertes Modell vor. Diese Strategie lässt sich auf Schichten in verschiedenen Netzwerken anwenden und basiert auf dem Konzept des Gradientenflusses.
-
Dynamische Labelzuweisung: Das Training eines Modells mit mehreren Ausgabeschichten wirft eine neue Frage auf: „Wie lassen sich dynamische Zielwerte den Ausgaben verschiedener Zweige zuweisen?“ Um dieses Problem zu lösen, führt YOLOv7 eine neue Methode zur Labelzuweisung ein, die als grob-zu-fein-geleitete Labelzuweisung bezeichnet wird.
-
Erweiterte und zusammengesetzte Skalierung: YOLOv7 schlägt Methoden zur „Erweiterung“ und „zusammengesetzten Skalierung“ für Echtzeit-Objektdetektoren vor, mit denen sich Parameter und Rechenleistung effektiv nutzen lassen.
-
Effizienz: Das von YOLOv7 vorgeschlagene Verfahren reduziert die Parameteranzahl um etwa 40 % und den Rechenaufwand um 50 % gegenüber hochmodernen Echtzeitdetektoren und erzielt zugleich eine schnellere Inferenz und höhere Erkennungsgenauigkeit.
Anwendungsbeispiele#
Ultralytics veröffentlicht keine vortrainierten Gewichte yolov7.pt oder YAML-Dateien ultralytics/cfg/models/v7/. Natives Training und native Inferenz von YOLOv7 mit PyTorch werden vom Ultralytics-Python-Paket nicht unterstützt. Du kannst jedoch einen im YOLOv7-Repository des Originalprojekts trainierten YOLOv7-Checkpoint in Ultralytics einbinden, indem du ihn wie unten gezeigt nach ONNX oder TensorRT exportierst.
ONNX-Export#
So verwendest du ein YOLOv7-ONNX-Modell mit Ultralytics:
-
(Optional) Installiere Ultralytics und exportiere ein ONNX-Modell, damit die erforderlichen Abhängigkeiten automatisch installiert werden:
pip install ultralytics yolo export model=yolo26n.pt format=onnx -
Exportiere das gewünschte YOLOv7-Modell mit dem Exporter im YOLOv7-Repository:
git clone https://github.com/WongKinYiu/yolov7 cd yolov7 python export.py --weights yolov7-tiny.pt --grid --end2end --simplify --topk-all 100 --iou-thres 0.65 --conf-thres 0.35 --img-size 640 640 --max-wh 640 -
Passe den ONNX-Modellgraphen mit dem folgenden Skript an, damit er mit Ultralytics kompatibel ist:
import numpy as np import onnx from onnx import helper, numpy_helper # Load the ONNX model model_path = "yolov7/yolov7-tiny.onnx" # Replace with your model path model = onnx.load(model_path) graph = model.graph # Fix input shape to batch size 1 input_shape = graph.input[0].type.tensor_type.shape input_shape.dim[0].dim_value = 1 # Define the output of the original model original_output_name = graph.output[0].name # Create slicing nodes sliced_output_name = f"{original_output_name}_sliced" # Define initializers for slicing (remove the first value) start = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_start") end = numpy_helper.from_array(np.array([7], dtype=np.int64), name="slice_end") axes = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_axes") steps = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_steps") graph.initializer.extend([start, end, axes, steps]) slice_node = helper.make_node( "Slice", inputs=[original_output_name, "slice_start", "slice_end", "slice_axes", "slice_steps"], outputs=[sliced_output_name], name="SliceNode", ) graph.node.append(slice_node) # Define segment slicing seg1_start = numpy_helper.from_array(np.array([0], dtype=np.int64), name="seg1_start") seg1_end = numpy_helper.from_array(np.array([4], dtype=np.int64), name="seg1_end") seg2_start = numpy_helper.from_array(np.array([4], dtype=np.int64), name="seg2_start") seg2_end = numpy_helper.from_array(np.array([5], dtype=np.int64), name="seg2_end") seg3_start = numpy_helper.from_array(np.array([5], dtype=np.int64), name="seg3_start") seg3_end = numpy_helper.from_array(np.array([6], dtype=np.int64), name="seg3_end") graph.initializer.extend([seg1_start, seg1_end, seg2_start, seg2_end, seg3_start, seg3_end]) # Create intermediate tensors for segments segment_1_name = f"{sliced_output_name}_segment1" segment_2_name = f"{sliced_output_name}_segment2" segment_3_name = f"{sliced_output_name}_segment3" # Add segment slicing nodes graph.node.extend( [ helper.make_node( "Slice", inputs=[sliced_output_name, "seg1_start", "seg1_end", "slice_axes", "slice_steps"], outputs=[segment_1_name], name="SliceSegment1", ), helper.make_node( "Slice", inputs=[sliced_output_name, "seg2_start", "seg2_end", "slice_axes", "slice_steps"], outputs=[segment_2_name], name="SliceSegment2", ), helper.make_node( "Slice", inputs=[sliced_output_name, "seg3_start", "seg3_end", "slice_axes", "slice_steps"], outputs=[segment_3_name], name="SliceSegment3", ), ] ) # Concatenate the segments concat_output_name = f"{sliced_output_name}_concat" concat_node = helper.make_node( "Concat", inputs=[segment_1_name, segment_3_name, segment_2_name], outputs=[concat_output_name], axis=1, name="ConcatSwapped", ) graph.node.append(concat_node) # Reshape to [1, -1, 6] reshape_shape = numpy_helper.from_array(np.array([1, -1, 6], dtype=np.int64), name="reshape_shape") graph.initializer.append(reshape_shape) final_output_name = f"{concat_output_name}_batched" reshape_node = helper.make_node( "Reshape", inputs=[concat_output_name, "reshape_shape"], outputs=[final_output_name], name="AddBatchDimension", ) graph.node.append(reshape_node) # Get the shape of the reshaped tensor shape_node_name = f"{final_output_name}_shape" shape_node = helper.make_node( "Shape", inputs=[final_output_name], outputs=[shape_node_name], name="GetShapeDim", ) graph.node.append(shape_node) # Extract the second dimension dim_1_index = numpy_helper.from_array(np.array([1], dtype=np.int64), name="dim_1_index") graph.initializer.append(dim_1_index) second_dim_name = f"{final_output_name}_dim1" gather_node = helper.make_node( "Gather", inputs=[shape_node_name, "dim_1_index"], outputs=[second_dim_name], name="GatherSecondDim", ) graph.node.append(gather_node) # Subtract from 100 to determine how many values to pad target_size = numpy_helper.from_array(np.array([100], dtype=np.int64), name="target_size") graph.initializer.append(target_size) pad_size_name = f"{second_dim_name}_padsize" sub_node = helper.make_node( "Sub", inputs=["target_size", second_dim_name], outputs=[pad_size_name], name="CalculatePadSize", ) graph.node.append(sub_node) # Build the [2, 3] pad array: # 1st row -> [0, 0, 0] (no padding at the start of any dim) # 2nd row -> [0, pad_size, 0] (pad only at the end of the second dim) pad_starts = numpy_helper.from_array(np.array([0, 0, 0], dtype=np.int64), name="pad_starts") graph.initializer.append(pad_starts) zero_scalar = numpy_helper.from_array(np.array([0], dtype=np.int64), name="zero_scalar") graph.initializer.append(zero_scalar) pad_ends_name = "pad_ends" concat_pad_ends_node = helper.make_node( "Concat", inputs=["zero_scalar", pad_size_name, "zero_scalar"], outputs=[pad_ends_name], axis=0, name="ConcatPadEnds", ) graph.node.append(concat_pad_ends_node) pad_values_name = "pad_values" concat_pad_node = helper.make_node( "Concat", inputs=["pad_starts", pad_ends_name], outputs=[pad_values_name], axis=0, name="ConcatPadStartsEnds", ) graph.node.append(concat_pad_node) # Create Pad operator to pad with zeros pad_output_name = f"{final_output_name}_padded" pad_constant_value = numpy_helper.from_array( np.array([0.0], dtype=np.float32), name="pad_constant_value", ) graph.initializer.append(pad_constant_value) pad_node = helper.make_node( "Pad", inputs=[final_output_name, pad_values_name, "pad_constant_value"], outputs=[pad_output_name], mode="constant", name="PadToFixedSize", ) graph.node.append(pad_node) # Update the graph's final output to [1, 100, 6] new_output_type = onnx.helper.make_tensor_type_proto( elem_type=graph.output[0].type.tensor_type.elem_type, shape=[1, 100, 6] ) new_output = onnx.helper.make_value_info(name=pad_output_name, type_proto=new_output_type) # Replace the old output with the new one graph.output.pop() graph.output.extend([new_output]) # Save the modified model onnx.save(model, "yolov7-ultralytics.onnx") -
Anschließend kannst du das angepasste ONNX-Modell laden und wie gewohnt damit in Ultralytics Inferenz ausführen:
from ultralytics import ASSETS, YOLO

model = YOLO("yolov7-ultralytics.onnx", task="detect")

results = model(ASSETS / "bus.jpg")
TensorRT-Export#
-
Befolge die Schritte 1–2 im Abschnitt ONNX-Export.
-
Installiere das Python-Paket
TensorRT:pip install tensorrt -
Führe das folgende Skript aus, um das modifizierte ONNX-Modell in eine TensorRT-Engine umzuwandeln:
from ultralytics.utils.export import onnx2engine onnx2engine("yolov7-ultralytics.onnx", quantize=16) -
Lade das Modell in Ultralytics und führe es aus:
from ultralytics import ASSETS, YOLO

model = YOLO("yolov7-ultralytics.engine", task="detect")

results = model(ASSETS / "bus.jpg")
Zitate und Danksagungen#
Wir möchten den YOLOv7-Autoren für ihre bedeutenden Beiträge im Bereich der Echtzeit-Objekterkennung danken:
@inproceedings{wang2023yolov7,
  title={YOLOv7: Trainable Bag-of-Freebies Sets New State-of-the-Art for Real-Time Object Detectors},
  author={Wang, Chien-Yao and Bochkovskiy, Alexey and Liao, Hong-Yuan Mark},
  booktitle={Proceedings of the IEEE/CVF conference on Computer Vision and Pattern Recognition (CVPR)},
  pages={7464--7475},
  year={2023}
}
Das offizielle YOLOv7-Paper wurde auf der CVPR 2023 veröffentlicht und ist über CVF Open Access verfügbar; ein Vorabdruck ist auf arXiv zu finden. Die Autoren haben ihre Arbeit öffentlich zugänglich gemacht. Die Codebasis ist auf GitHub verfügbar. Wir würdigen die Bemühungen, das Fachgebiet voranzubringen und die Arbeit einer breiteren Community zugänglich zu machen.
Häufig gestellte Fragen#
YOLOv7, veröffentlicht im Juli 2022, war ein Echtzeit-Objekterkennungsmodell, das zum Zeitpunkt seiner Veröffentlichung führend bei Geschwindigkeit und Genauigkeit war. Bei der Parameternutzung und Inferenzgeschwindigkeit übertraf es zeitgenössische Modelle wie YOLOX, YOLOv5 und PPYOLOE. Zu den besonderen Merkmalen von YOLOv7 gehören die Reparametrisierung des Modells und die dynamische Labelzuweisung. Diese optimieren die Leistung, ohne die Inferenzkosten zu erhöhen.
YOLOv7 führt mehrere Neuerungen ein, darunter die Modell-Reparametrisierung und die dynamische Labelzuweisung, die den Trainingsprozess verbessern und die Inferenzgenauigkeit erhöhen. Im Vergleich zu YOLOv5 steigert YOLOv7 Geschwindigkeit und Genauigkeit deutlich. So verbessert YOLOv7-X beispielsweise die Genauigkeit um 2,2 % und reduziert die Anzahl der Parameter im Vergleich zu YOLOv5-X um 22 %. Detaillierte Vergleiche findest du in der Leistungstabelle YOLOv7 im Vergleich zu hochmodernen Objektdetektoren.
Derzeit unterstützt Ultralytics nur die Inferenz mit YOLOv7 ONNX und TensorRT. Informationen dazu, wie du die exportierte ONNX- und TensorRT-Version von YOLOv7 mit Ultralytics ausführst, findest du im Abschnitt Anwendungsbeispiele.
Gehe folgendermaßen vor, um ein benutzerdefiniertes YOLOv7-Modell zu installieren und zu trainieren:
-
Klone das YOLOv7-Repository:
git clone https://github.com/WongKinYiu/yolov7 -
Wechsle in das geklonte Verzeichnis und installiere die Abhängigkeiten:
cd yolov7 pip install -r requirements.txt -
Bereite deinen Datensatz vor und konfiguriere die Modellparameter gemäß den im Repository bereitgestellten Nutzungshinweisen.
-
Nach dem Training kannst du das Modell wie in den Anwendungsbeispielen gezeigt nach ONNX oder TensorRT exportieren, um es in Ultralytics zu verwenden.
-
YOLOv7 führt mehrere wichtige Funktionen für die Objekterkennung in Echtzeit ein:
- Modell-Reparametrisierung: Verbessert die Modellleistung durch Optimierung der Gradientenflusswege.
- Dynamische Labelzuweisung: Weist den Ausgaben verschiedener Zweige mithilfe eines grob-zu-fein-geleiteten Verfahrens dynamische Zielwerte zu und verbessert so die Genauigkeit.
- Erweiterte und zusammengesetzte Skalierung: Nutzt Parameter und Rechenleistung effizient, um das Modell für verschiedene Echtzeitanwendungen zu skalieren.
- Effizienz: Reduziert die Anzahl der Parameter um 40 % und den Rechenaufwand um 50 % im Vergleich zu anderen hochmodernen Modellen und erzielt zugleich höhere Inferenzgeschwindigkeiten.


Kommentare2
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
naps22
YOLOv7's approach as a trainable bag-of-freebies really stands out, especially in how it optimizes performance without additional inference cost. It's impressive how techniques like re-parameterization and dynamic label assignment enhance accuracy. However, after doing a YOLOv8 comparison, it’s clear that while YOLOv8 brings some architectural improvements and streamlined workflows, YOLOv7 still holds strong in many real-time detection scenarios due to its training-time flexibility.
 Glenn JocherUltralytics(bearbeitet)
You're absolutely right about YOLOv7's innovative "trainable bag-of-freebies" approach - it was a game-changing concept that improved accuracy purely through training optimizations rather than architectural changes. The re-parameterization and dynamic label assignment techniques were particularly clever solutions that set new standards for efficiency.
While YOLOv7 remains excellent for real-time detection scenarios, you might want to explore YOLO26 as well - it's our latest model that builds upon these innovations with even better performance across detection, segmentation, and other tasks, all within the streamlined Ultralytics framework.