Dataset CIFAR-100#
El dataset CIFAR-100 (Instituto Canadiense de Investigación Avanzada) es un referente de clasificación de imágenes compuesto por 60.000 imágenes en color de 32x32 píxeles, distribuidas uniformemente entre 100 clases detalladas (600 imágenes cada una), que a su vez se agrupan en 20 superclases generales. Creado por Alex Krizhevsky, incluye una división predefinida de 50.000 imágenes de entrenamiento y 10.000 de prueba, lo que lo convierte en el equivalente más difícil y detallado del dataset CIFAR-10.
Explora CIFAR-100 en Ultralytics Platform para previsualizar muestras, consultar las estadísticas del dataset y clonarlo para entrenar.
Características principales#
- CIFAR-100 contiene 60.000 imágenes en color de 32x32 píxeles, divididas uniformemente en 100 clases.
- Cada clase contiene exactamente 600 imágenes — 500 para entrenamiento y 100 para pruebas —, por lo que el dataset está perfectamente equilibrado.
- Las 100 clases detalladas se agrupan en 20 superclases generales para realizar una clasificación de nivel superior.
- El conjunto de datos incluye una división predefinida de entrenamiento/prueba, por lo que no es necesario dividirlo de forma manual o automática.
- CIFAR-100 es un referente estándar para la investigación sobre clasificación de imágenes detallada y reconocimiento de objetos.
Estructura del dataset#
CIFAR-100 incluye una división oficial predefinida, por lo que no es necesario particionarlo de forma automática ni manual:
- Clases: 100 clases detalladas, agrupadas en 20 superclases generales
- Imágenes totales: 60.000 (en color, 32x32)
- Conjunto de entrenamiento: 50.000 imágenes (500 por clase)
- Conjunto de prueba: 10.000 imágenes (100 por clase)
CIFAR-100 no tiene una carpeta de validación independiente, por lo que Ultralytics utiliza el conjunto de prueba de 10.000 imágenes como división de validación durante el entrenamiento de forma predeterminada. El entrenamiento con data="cifar100" aprende las 100 clases detalladas.
Aplicaciones#
CIFAR-100 se utiliza ampliamente para entrenar y evaluar modelos de clasificación de imágenes, desde las clásicas redes neuronales convolucionales (CNNs) y máquinas de vectores de soporte (SVMs) hasta arquitecturas profundas modernas. Sus 100 clases detalladas y el reducido tamaño de las imágenes lo convierten en un referente exigente para la investigación en aprendizaje automático, la comparación de algoritmos y la experimentación en visión por ordenador.
Uso#
Entrena un modelo YOLO con CIFAR-100 durante 100 épocas y con un tamaño de imagen de 32. Para consultar la lista completa de argumentos disponibles, visita la página de entrenamiento y la guía de la tarea de clasificación de imágenes.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="cifar100", epochs=100, imgsz=32)
Imágenes de ejemplo y anotaciones#
Imágenes de muestra del dataset CIFAR-100:
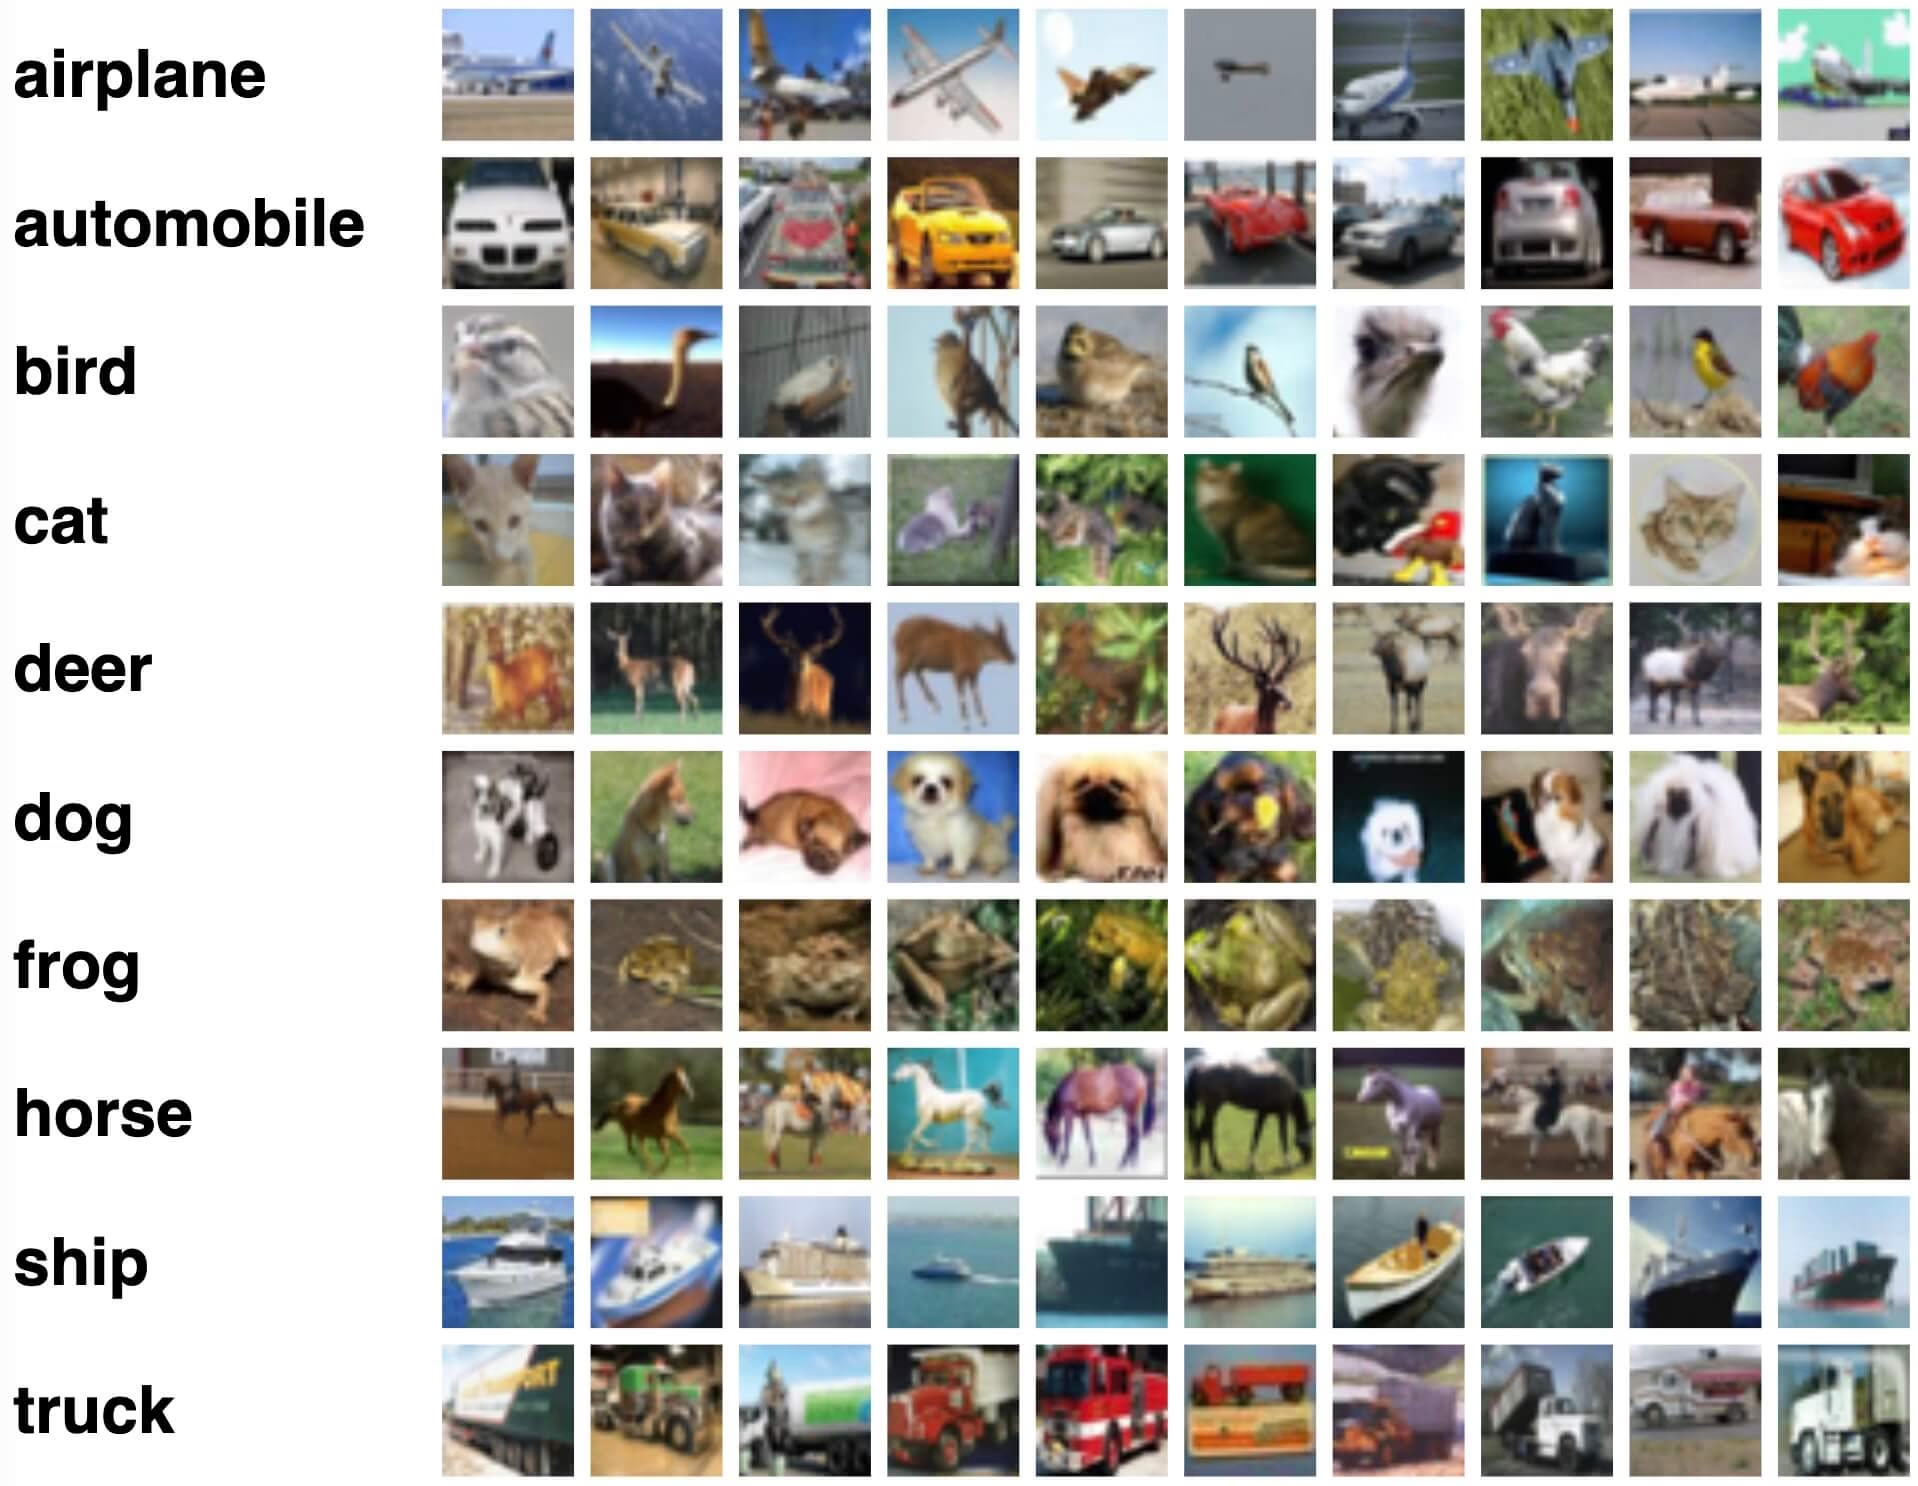
Las muestras muestran la diversidad de los objetos del dataset CIFAR-100 y ponen de relieve el valor de contar con un dataset variado para entrenar modelos robustos de clasificación de imágenes.
Citas y agradecimientos#
Si utilizas el dataset CIFAR-100 en tu trabajo de investigación o desarrollo, cita el siguiente artículo:
@TECHREPORT{Krizhevsky09learningmultiple,
            author={Alex Krizhevsky},
            title={Learning multiple layers of features from tiny images},
            institution={},
            year={2009}
}
Queremos reconocer la labor de Alex Krizhevsky por crear y mantener el dataset CIFAR-100 como un recurso valioso para la comunidad de investigación en aprendizaje automático y visión por ordenador. Para obtener más información sobre el dataset CIFAR-100 y su creador, visita el sitio web del dataset CIFAR-100.
Preguntas frecuentes#
El dataset CIFAR-100 se utiliza ampliamente para entrenar y evaluar modelos de clasificación de imágenes detallada y reconocimiento de objetos. Contiene 60.000 imágenes en color de 32x32 píxeles distribuidas entre 100 clases agrupadas en 20 superclases, lo que lo convierte en un referente más exigente que CIFAR-10 para algoritmos como las redes neuronales (CNNs) convolucionales y las máquinas de vectores de soporte (SVMs), así como para evaluar modelos de aprendizaje profundo desarrollados con Ultralytics YOLO.
Para entrenar un modelo Ultralytics YOLO con CIFAR-100, utiliza los fragmentos de código siguientes. El dataset se descarga automáticamente la primera vez que se utiliza. Para consultar la lista completa de argumentos, visita la página de entrenamiento del modelo.
Ejemplo de entrenamientofrom ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="cifar100", epochs=100, imgsz=32)CIFAR-100 tiene 100 clases detalladas — como manzana, delfín, arce, motocicleta y cohete — con exactamente 600 imágenes cada una, lo que suma 60.000 imágenes en total. Estas 100 clases también se agrupan en 20 superclases generales (por ejemplo, la superclase de árboles incluye arce, roble, palmera, pino y sauce). El entrenamiento con
data="cifar100"utiliza las 100 clases detalladas.CIFAR-100 incluye una división predefinida de 50.000 imágenes de entrenamiento y 10.000 imágenes de prueba, con exactamente 500 imágenes de entrenamiento y 100 de prueba por clase. A diferencia de los datasets de clasificación basados en carpetas, que Ultralytics divide automáticamente, la partición oficial de CIFAR-100 se utiliza tal cual y el conjunto de prueba sirve como división de validación durante el entrenamiento de forma predeterminada.
Sí. Ultralytics Platform te permite gestionar datasets, entrenar modelos de clasificación de imágenes y desplegarlos sin necesidad de programar demasiado. Es una forma práctica de ejecutar experimentos con CIFAR-100 en la nube, y puedes consultar más opciones en nuestra descripción general de datasets de clasificación.