Conjunto de datos Global Wheat Head#
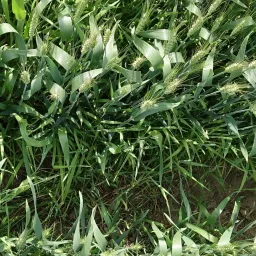
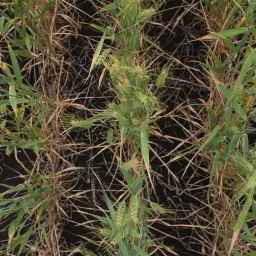
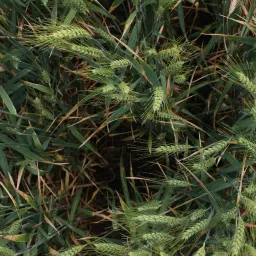
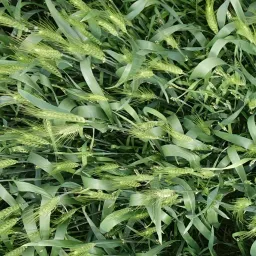
El conjunto de datos Global Wheat Head (GWHD) es un conjunto de datos de detección de objetos de una sola clase para detectar espigas de trigo —las espigas de la planta de trigo que contienen los granos— en imágenes de campos al aire libre. Proporciona 3.422 imágenes de entrenamiento, 748 de validación y 1.276 de prueba, capturadas en varias regiones de cultivo. Lo creó una colaboración de nueve institutos de investigación de siete países para que los modelos generalicen en distintos entornos. La detección precisa de espigas de trigo permite estimar su densidad, tamaño y rendimiento potencial en el fenotipado vegetal y la gestión de cultivos.
Características principales#
- Imágenes reales de campos al aire libre que reflejan la variabilidad natural del aspecto de las espigas de trigo, la iluminación y las fases de crecimiento.
- Creado por nueve institutos de investigación de siete países, abarca regiones de cultivo de Europa, Norteamérica, Asia y Australia para lograr una sólida generalización entre entornos.
- Anotaciones de cuadros delimitadores para una sola clase,
wheat_head, listas para las canalizaciones de detección de objetos y seguimiento. - Las imágenes de prueba proceden de genotipos y regiones que no aparecen en el entrenamiento, por lo que ofrecen una evaluación real de la capacidad de generalización.
Estructura del conjunto de datos#
El conjunto de datos Global Wheat Head está organizado en tres subconjuntos definidos en la configuración GlobalWheat2020.yaml, todos anotados con una sola clase, wheat_head:
| División | Imágenes | Regiones |
|---|---|---|
| Entrenar | 3,422 | Europa (Francia, Reino Unido, Suiza), Norteamérica (Canadá) |
| Validación | 748 | Suiza (ETH Zürich) |
| Prueba | 1,276 | Australia, Japón, China |
El conjunto de validación (748 imágenes) es el subconjunto ethz_1, que también está incluido en el conjunto de entrenamiento, por lo que las métricas de validación se calculan con imágenes con las que el modelo también se entrena. El conjunto de prueba reservado, procedente de Australia, Japón y China, mide la capacidad de generalización a entornos que no se han visto durante el entrenamiento.
Aplicaciones#
El Global Wheat Head Dataset se utiliza ampliamente para entrenar y evaluar modelos de aprendizaje profundo destinados a detectar espigas de trigo. Sus diversas imágenes, tomadas en distintas regiones, con diferentes genotipos y en condiciones variadas, lo convierten en un valioso recurso para el fenotipado vegetal y la gestión de cultivos, ya que permite estimar el rendimiento, supervisar la salud de los cultivos y realizar análisis fenotípicos.
Para anotar imágenes de campo, entrenar y gestionar versiones de conjuntos de datos desde el navegador, ejecuta todo el flujo de trabajo con Ultralytics Platform.
YAML del conjunto de datos#
Se utiliza un archivo YAML para definir la configuración del conjunto de datos. En él se especifican las rutas, las clases y otros detalles de configuración del conjunto de datos. En el caso del Global Wheat Head Dataset, el archivo GlobalWheat2020.yaml se mantiene en https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/GlobalWheat2020.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Global Wheat 2020 dataset https://www.global-wheat.com/ by University of Saskatchewan
# Documentation: https://docs.ultralytics.com/datasets/detect/globalwheat2020
# Example usage: yolo train data=GlobalWheat2020.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── GlobalWheat2020 ← downloads here (7.0 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: GlobalWheat2020 # dataset root dir
train: # train images (relative to 'path') 3422 images
  - images/arvalis_1
  - images/arvalis_2
  - images/arvalis_3
  - images/ethz_1
  - images/rres_1
  - images/inrae_1
  - images/usask_1
val: # val images (relative to 'path') 748 images (WARNING: train set contains ethz_1)
  - images/ethz_1
test: # test images (optional) 1276 images
  - images/utokyo_1
  - images/utokyo_2
  - images/nau_1
  - images/uq_1

# Classes
names:
  0: wheat_head

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  from pathlib import Path

  from ultralytics.utils.downloads import download

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  urls = [
      "https://zenodo.org/record/4298502/files/global-wheat-codalab-official.zip",
      "https://github.com/ultralytics/assets/releases/download/v0.0.0/GlobalWheat2020_labels.zip",
  ]
  download(urls, dir=dir)

  # Make Directories
  for p in "annotations", "images", "labels":
      (dir / p).mkdir(parents=True, exist_ok=True)

  # Move
  for p in (
      "arvalis_1",
      "arvalis_2",
      "arvalis_3",
      "ethz_1",
      "rres_1",
      "inrae_1",
      "usask_1",
      "utokyo_1",
      "utokyo_2",
      "nau_1",
      "uq_1",
  ):
      (dir / "global-wheat-codalab-official" / p).rename(dir / "images" / p)  # move to /images
      f = (dir / "global-wheat-codalab-official" / p).with_suffix(".json")  # json file
      if f.exists():
f.rename((dir / "annotations" / p).with_suffix(".json")) # move to /annotationsUso#
Para entrenar un modelo YOLO26n con el Global Wheat Head Dataset durante 100 épocas y con un tamaño de imagen de 640, puedes utilizar los siguientes fragmentos de código. El conjunto de datos (~7.0 GB) se descarga automáticamente la primera vez que se utiliza. Consulta la página de entrenamiento del modelo para ver una lista completa de los argumentos disponibles.
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n.pt")  # Carga un modelo preentrenado (recomendado para el entrenamiento)

# Entrenar el modelo
results = model.train(data="GlobalWheat2020.yaml", epochs=100, imgsz=640)
Imágenes de muestra y anotaciones#
El Global Wheat Head Dataset contiene un conjunto diverso de imágenes de campos al aire libre que recoge la variabilidad natural del aspecto de las espigas de trigo, los entornos y las condiciones. Aquí tienes un ejemplo de imagen del conjunto de datos junto con sus anotaciones correspondientes:
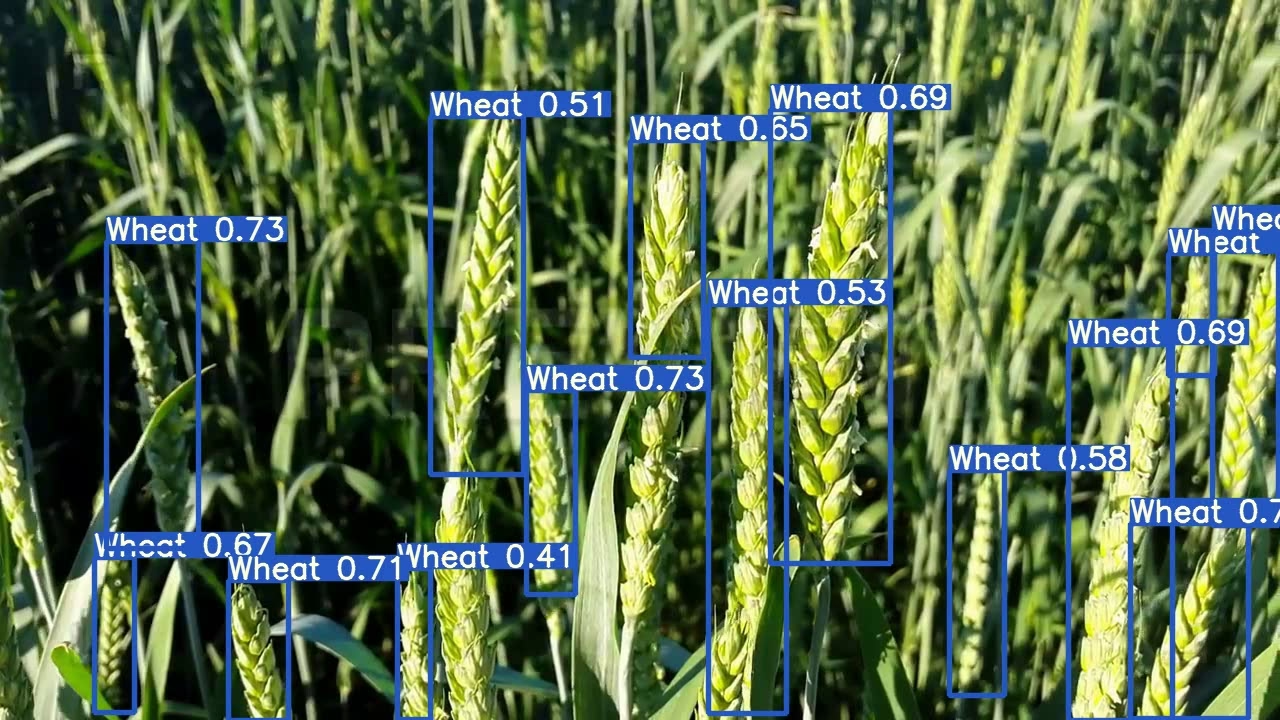
- Detección de espigas de trigo: Las espigas de trigo se anotan con cuadros delimitadores para la detección de objetos, en diversas condiciones de campo que reflejan la variedad y complejidad del conjunto de datos.
Citas y agradecimientos#
Si utilizas el Global Wheat Head Dataset en tu trabajo de investigación o desarrollo, cita el siguiente artículo:
@article{david2020global,
         title={Global Wheat Head Detection (GWHD) Dataset: A Large and Diverse Dataset of High-Resolution RGB-Labelled Images to Develop and Benchmark Wheat Head Detection Methods},
         author={David, Etienne and Madec, Simon and Sadeghi-Tehran, Pouria and Aasen, Helge and Zheng, Bangyou and Liu, Shouyang and Kirchgessner, Norbert and Ishikawa, Goro and Nagasawa, Koichi and Badhon, Minhajul and others},
         journal={arXiv preprint arXiv:2005.02162},
         year={2020}
}
Queremos reconocer la labor de los investigadores e instituciones que han contribuido a crear y mantener el Global Wheat Head Dataset como un valioso recurso para la comunidad de investigación en fenotipado vegetal y gestión de cultivos. Para obtener más información sobre el conjunto de datos y sus creadores, visita el sitio web del Global Wheat Head Dataset.
Preguntas frecuentes#
El Global Wheat Head Dataset se utiliza principalmente para desarrollar y entrenar modelos de aprendizaje profundo destinados a detectar espigas de trigo. Esto es fundamental para aplicaciones de fenotipado del trigo y gestión de cultivos, ya que permite estimar con mayor precisión la densidad y el tamaño de las espigas, así como el potencial de rendimiento general del cultivo. Los métodos de detección precisos ayudan a evaluar la salud y madurez de los cultivos, algo esencial para gestionarlos de forma eficiente.
El Global Wheat Head Dataset tiene una sola clase,
wheat_head, y se divide en tres subconjuntos: 3422 imágenes de entrenamiento, 748 imágenes de validación y 1276 imágenes de prueba. Las imágenes de entrenamiento y validación proceden de Europa y Norteamérica, mientras que el conjunto de prueba incluye imágenes de Australia, Japón y China para evaluar la capacidad de generalización a entornos no vistos.Para entrenar un modelo YOLO26n con el Global Wheat Head Dataset, puedes utilizar los siguientes fragmentos de código. Asegúrate de tener el archivo de configuración
GlobalWheat2020.yamlcon las rutas y las clases del conjunto de datos:Ejemplo de entrenamientofrom ultralytics import YOLO # Carga un modelo preentrenado (recomendado para el entrenamiento) model = YOLO("yolo26n.pt") # Entrenar el modelo results = model.train(data="GlobalWheat2020.yaml", epochs=100, imgsz=640)Consulta la página de entrenamiento del modelo para ver una lista completa de los argumentos disponibles.
El conjunto de datos (~7.0 GB) se descarga automáticamente la primera vez que entrenas con
data="GlobalWheat2020.yaml"; no hace falta ningún paso manual. Ultralytics descarga las imágenes y las etiquetas, y las descomprime en el directorio local de conjuntos de datos. Puedes consultar otros conjuntos de datos relacionados en la descripción general de los conjuntos de datos de detección.El archivo YAML de configuración del Global Wheat Head Dataset, denominado
GlobalWheat2020.yaml, está disponible en GitHub. Puedes acceder a él en https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/GlobalWheat2020.yaml. Este archivo contiene las rutas, las clases y otros detalles de configuración del conjunto de datos que necesitas para entrenar modelos con Ultralytics YOLO.La detección de espigas de trigo es fundamental para gestionar los cultivos, ya que permite estimar con precisión la densidad y el tamaño de las espigas, aspectos esenciales para evaluar la salud, la madurez y el potencial de rendimiento de los cultivos. Gracias a los modelos de aprendizaje profundo entrenados con conjuntos de datos como el Global Wheat Head Dataset, agricultores e investigadores pueden supervisar y gestionar mejor los cultivos, lo que mejora la productividad y optimiza el uso de recursos en las prácticas agrícolas. Este avance tecnológico respalda las iniciativas de agricultura sostenible y seguridad alimentaria.
Para obtener más información sobre las aplicaciones de la IA en la agricultura, visita IA en la agricultura.