Conjunto de datos SKU-110K
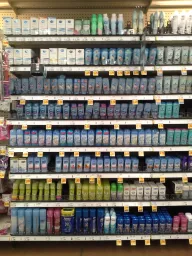
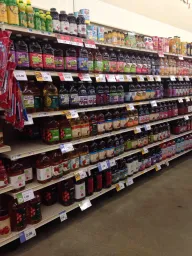
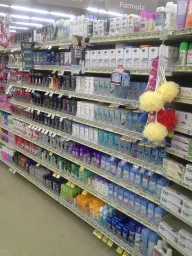
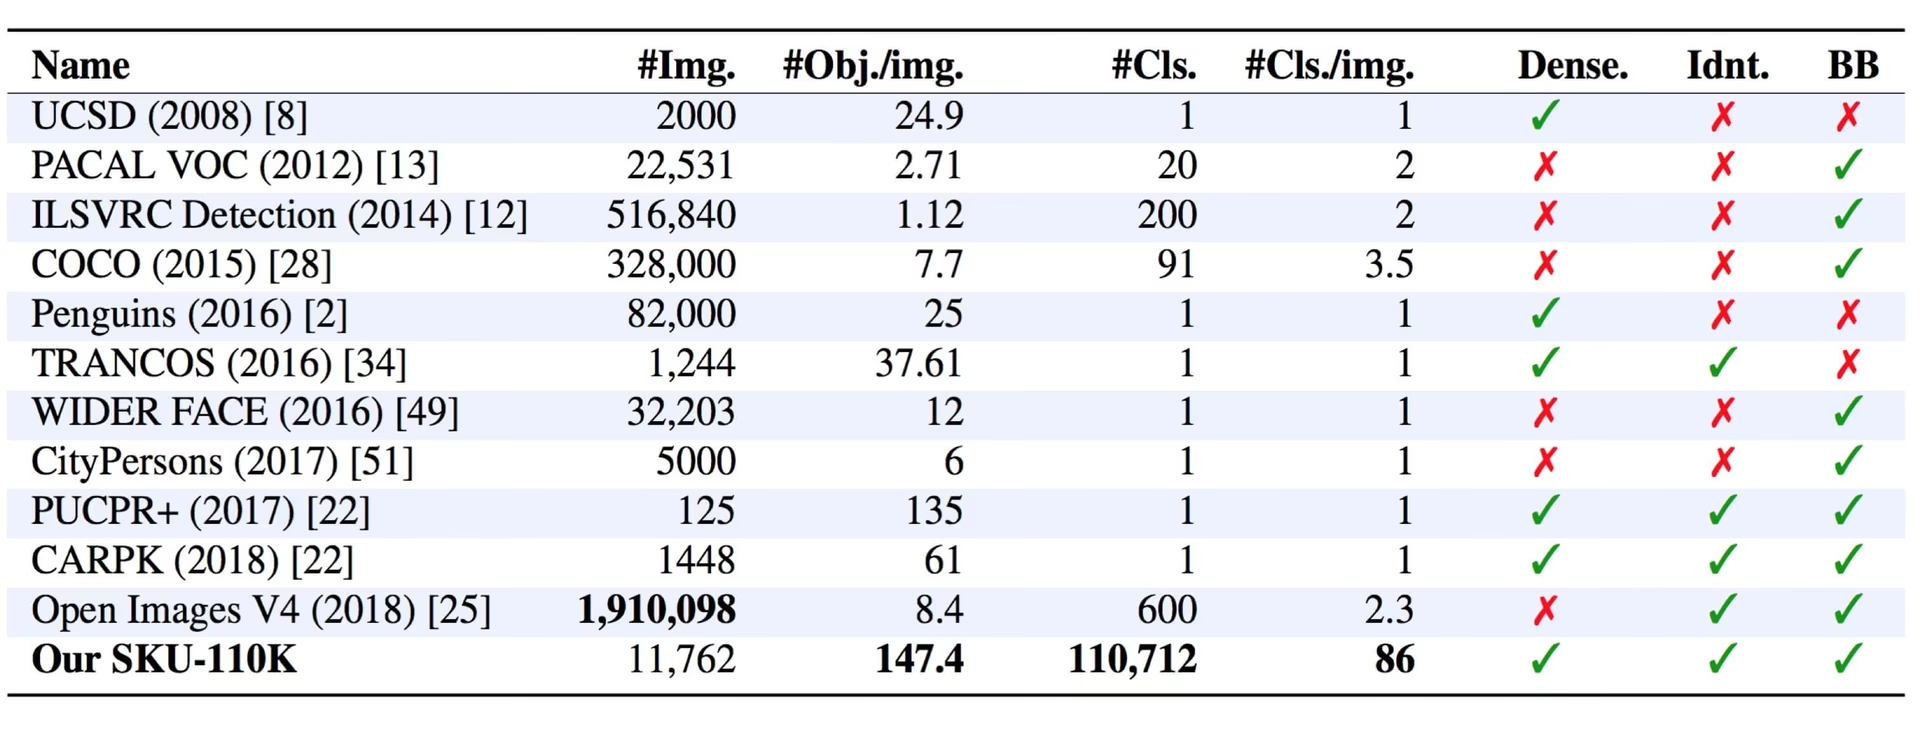
El conjunto de datos SKU-110K es un conjunto de datos de una sola clase para la detección de objetos, compuesto por 11.743 imágenes de estanterías comerciales con productos densamente agrupados, dividido en 8.219 imágenes de entrenamiento, 588 de validación y 2.936 de prueba. Cada producto está anotado con una caja delimitadora bajo una única clase, object: el nombre hace referencia a las más de 110.000 unidades de mantenimiento de existencias (SKUs) únicas que aparecen en las escenas, no a 110.000 clases de detección. Creado por Eran Goldman y otros para el artículo de CVPR 2019 Precise Detection in Densely Packed Scenes, contiene más de 1,7 millones de productos anotados —una media de unos 147 por imagen—, lo que lo convierte en un exigente banco de pruebas para modelos de visión artificial en entornos comerciales concurridos.
Ver: Cómo entrenar Ultralytics YOLO26 para detectar todos los productos de una estantería | SKU-110K 🛒
Características principales#
- Detección de una sola clase: Cada producto tiene una caja delimitadora asociada a una única clase,
object(names: {0: object}); las anotaciones no incluyen etiquetas de categoría por SKU. - Densidad extrema de objetos: Las imágenes de estanterías de tiendas de todo el mundo contienen una media aproximada de 147 productos muy juntos, cuyos objetos suelen parecerse mucho o incluso ser idénticos y estar colocados muy cerca unos de otros.
- Gran escala: Más de 110.000 SKU únicos y más de 1,7 millones de cajas delimitadoras anotadas en 11.743 imágenes ponen a prueba los detectores de objetos más avanzados.
Estructura del conjunto de datos#
El conjunto de datos SKU-110K se divide en tres subconjuntos, todos con la misma clase object:
| División | Imágenes | Descripción |
|---|---|---|
| Entrenar | 8,219 | Imágenes y anotaciones para entrenar el modelo |
| Validación | 588 | Imágenes reservadas para la evaluación durante el entrenamiento |
| Prueba | 2,936 | Imágenes para la evaluación final del modelo entrenado |
Aplicaciones#
El conjunto de datos SKU-110K se utiliza ampliamente para entrenar y evaluar modelos de aprendizaje profundo en tareas de detección de objetos, especialmente en escenas densamente pobladas, como las estanterías de tiendas. Entre sus aplicaciones se incluyen:
- Gestión de inventario y automatización en comercios minoristas
- Reconocimiento de productos en plataformas de comercio electrónico
- Verificación del cumplimiento de planogramas
- Sistemas de autopago en tiendas
- Recogida y clasificación robóticas en almacenes
Para anotar tus propias imágenes de estanterías, entrenar y gestionar conjuntos de datos de detección minorista desde el navegador, ejecuta todo el flujo de trabajo con Ultralytics Platform.
YAML del conjunto de datos#
El archivo SKU-110K.yaml define la configuración del conjunto de datos: las rutas, los nombres de las clases y otros metadatos. Se mantiene en el repositorio de Ultralytics en https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/SKU-110K.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# SKU-110K retail items dataset https://github.com/eg4000/SKU110K_CVPR19 by Trax Retail
# Documentation: https://docs.ultralytics.com/datasets/detect/sku-110k
# Example usage: yolo train data=SKU-110K.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── SKU-110K ← downloads here (13.6 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: SKU-110K # dataset root dir
train: train.txt # train images (relative to 'path') 8219 images
val: val.txt # val images (relative to 'path') 588 images
test: test.txt # test images (optional) 2936 images

# Classes
names:
  0: object

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import shutil
  from pathlib import Path

  import numpy as np
  import polars as pl

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download
  from ultralytics.utils.ops import xyxy2xywh

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  parent = Path(dir.parent)  # download dir
  urls = ["http://trax-geometry.s3.amazonaws.com/cvpr_challenge/SKU110K_fixed.tar.gz"]
  download(urls, dir=parent)

  # Rename directories
  if dir.exists():
      shutil.rmtree(dir)
  (parent / "SKU110K_fixed").rename(dir)  # rename dir
  (dir / "labels").mkdir(parents=True, exist_ok=True)  # create labels dir

  # Convert labels
  names = "image", "x1", "y1", "x2", "y2", "class", "image_width", "image_height"  # column names
  for d in "annotations_train.csv", "annotations_val.csv", "annotations_test.csv":
      x = pl.read_csv(dir / "annotations" / d, has_header=False, new_columns=names, infer_schema_length=None).to_numpy()  # annotations
      images, unique_images = x[:, 0], np.unique(x[:, 0])
      with open((dir / d).with_suffix(".txt").__str__().replace("annotations_", ""), "w", encoding="utf-8") as f:
          f.writelines(f"./images/{s}\n" for s in unique_images)
      for im in TQDM(unique_images, desc=f"Converting {dir / d}"):
          cls = 0  # single-class dataset
          with open((dir / "labels" / im).with_suffix(".txt"), "a", encoding="utf-8") as f:
              for r in x[images == im]:
                  w, h = r[6], r[7]  # image width, height
                  xywh = xyxy2xywh(np.array([[r[1] / w, r[2] / h, r[3] / w, r[4] / h]]))[0]  # instance
f.write(f"{cls} {xywh[0]:.5f} {xywh[1]:.5f} {xywh[2]:.5f} {xywh[3]:.5f}\n") # write labelUso#
SKU-110K se descarga automáticamente la primera vez que entrenas y necesita unos 13,6 GB de espacio libre en disco para sus 11.743 imágenes. El script de descarga también obtiene las anotaciones originales y las convierte al formato YOLO, lo que puede tardar unos minutos.
Para entrenar un modelo YOLO26n con el conjunto de datos SKU-110K durante 100 épocas y con un tamaño de imagen de 640, puedes utilizar los siguientes fragmentos de código.
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n.pt")  # Carga un modelo preentrenado (recomendado para el entrenamiento)

# Entrenar el modelo
results = model.train(data="SKU-110K.yaml", epochs=100, imgsz=640)
Datos de ejemplo y anotaciones#
Las imágenes de SKU-110K muestran productos muy juntos en estanterías de tiendas reales, donde decenas de artículos casi idénticos están uno al lado del otro. Aquí tienes un ejemplo de imagen con sus anotaciones:
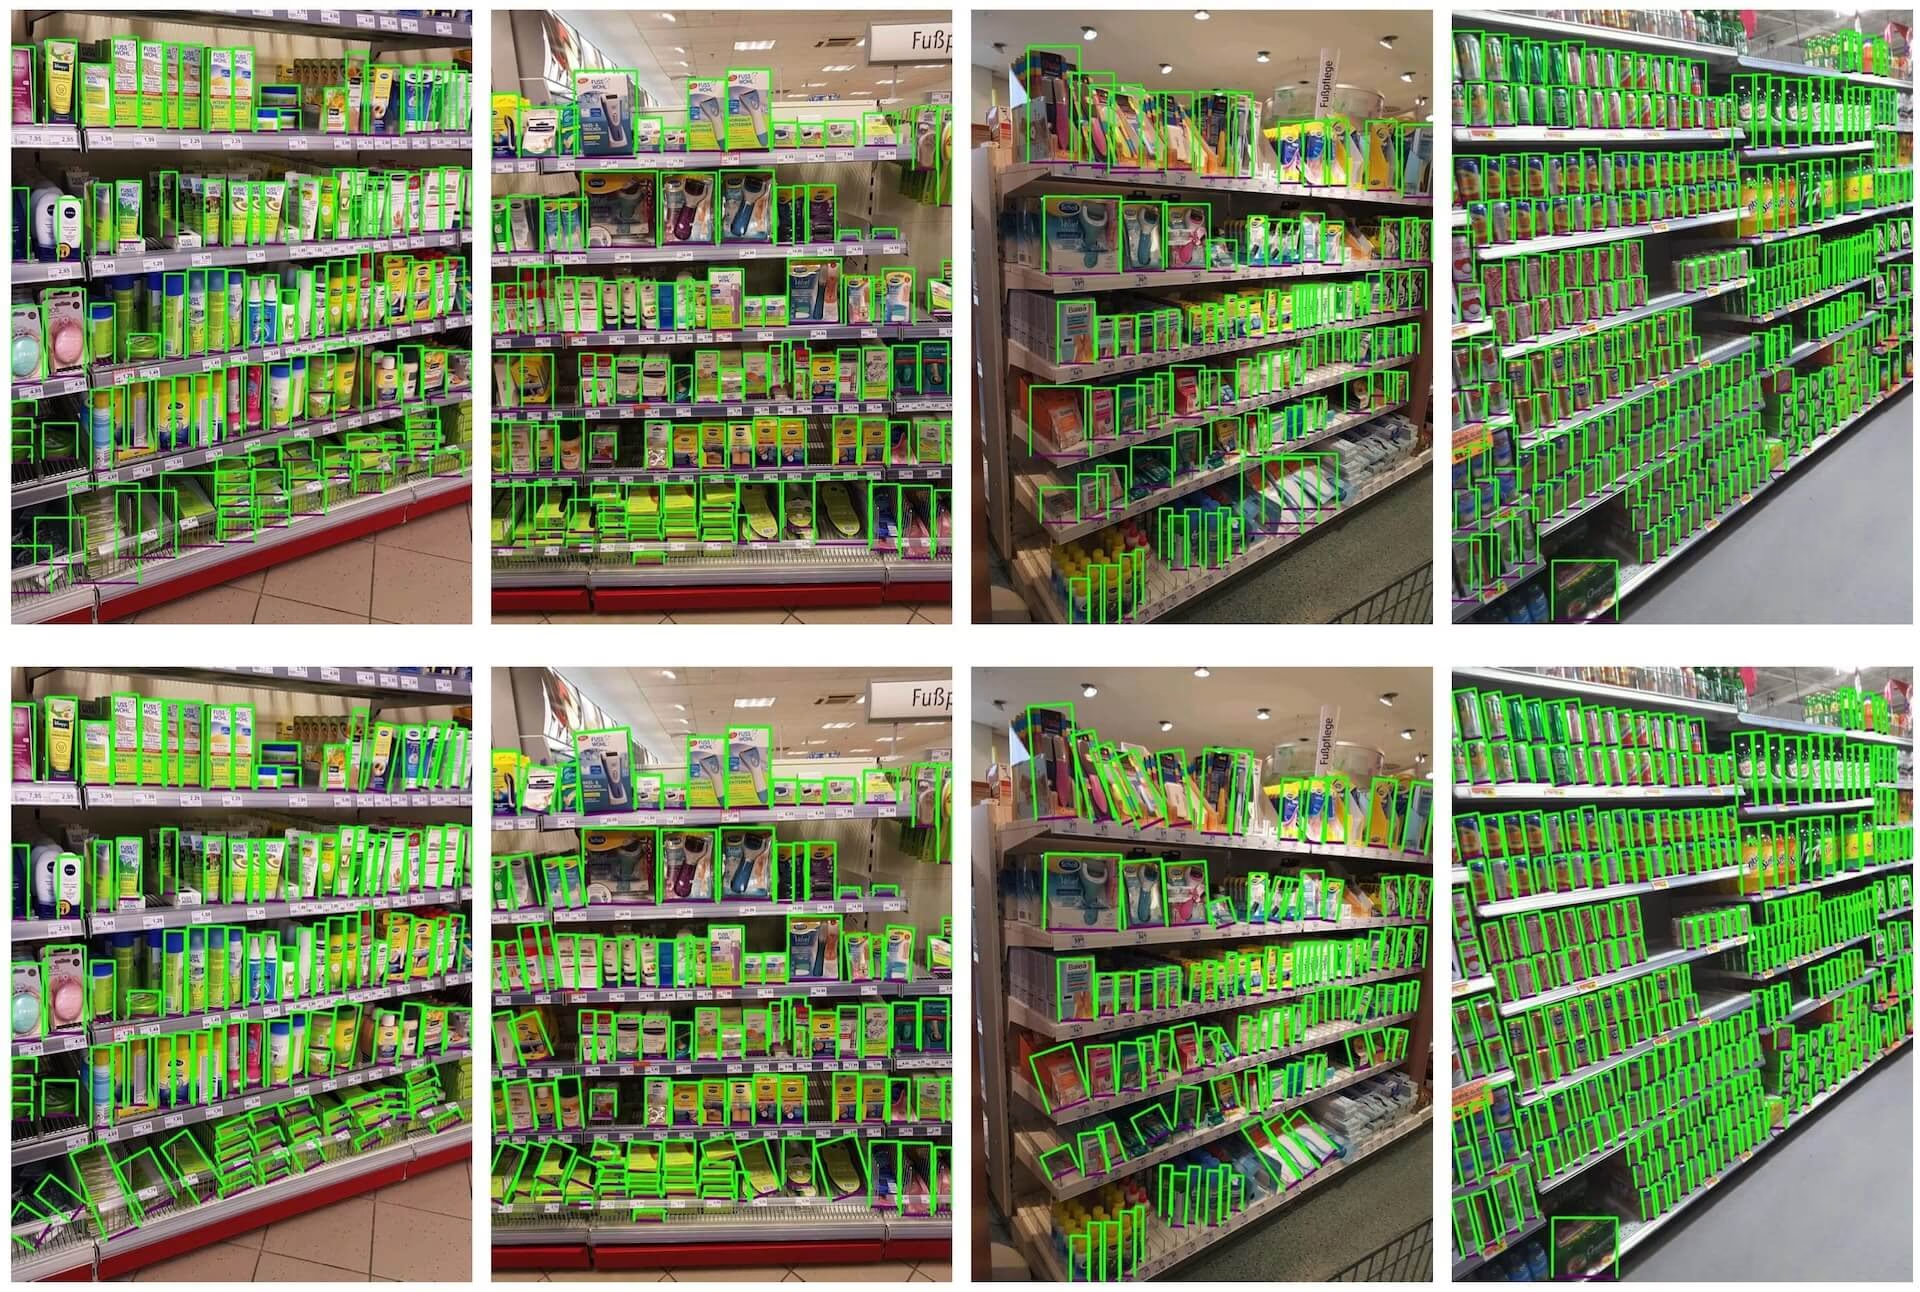
- Imagen de una estantería comercial con productos densamente agrupados: Esta imagen muestra un ejemplo de objetos muy juntos en una estantería comercial. Los objetos están anotados con cajas delimitadoras de la única clase
object.
La distribución densa de los productos hace que SKU-110K sea especialmente valioso para desarrollar soluciones de visión artificial sólidas orientadas al comercio minorista, ya que la gran cantidad de objetos por imagen lleva a los detectores mucho más allá de los bancos de pruebas habituales.
Citas y agradecimientos#
Si utilizas el conjunto de datos SKU-110K en tu investigación o trabajo de desarrollo, cita el siguiente artículo:
@inproceedings{goldman2019dense,
  author    = {Eran Goldman and Roei Herzig and Aviv Eisenschtat and Jacob Goldberger and Tal Hassner},
  title     = {Precise Detection in Densely Packed Scenes},
  booktitle = {Proc. Conf. Comput. Vision Pattern Recognition (CVPR)},
  year      = {2019}
}
Queremos reconocer la labor de Eran Goldman y otros por crear y mantener el conjunto de datos SKU-110K como recurso valioso para la comunidad de investigación en visión artificial. Para obtener más información sobre el conjunto de datos SKU-110K y sus creadores, visita el repositorio de GitHub del conjunto de datos SKU-110K.
Preguntas frecuentes#
El conjunto de datos SKU-110K es un conjunto de datos de detección de objetos de una sola clase, formado por 11 743 imágenes de estanterías de comercios con productos muy juntos, creado por Eran Goldman y otros investigadores para su artículo de CVPR 2019. Cada producto está etiquetado con un cuadro delimitador
object, y las imágenes abarcan más de 110 000 unidades de mantenimiento de existencias (SKUs) distintas, lo que lo convierte en una sólida referencia para detectar objetos en escenas abarrotadas y crear sistemas de visión artificial para comercios minoristas.No. SKU-110K tiene una sola clase: cada producto está anotado con una caja delimitadora bajo la clase
object(names: {0: object}). El «110K» del nombre hace referencia al número de unidades de mantenimiento de existencias (SKUs) únicas que aparecen en las imágenes, no al número de clases de detección.El conjunto de datos SKU-110K contiene 11.743 imágenes —8.219 para entrenamiento, 588 para validación y 2.936 para prueba— y una única clase de detección,
object. Consulta la sección Estructura del conjunto de datos y la configuraciónSKU-110K.yamlpara obtener más información.SKU-110K ocupa unos 13,6 GB y se descarga automáticamente la primera vez que entrenas con
data="SKU-110K.yaml"; no es necesario descargarlo manualmente. Para explorar opciones más pequeñas, consulta el resumen de conjuntos de datos de detección.Entrenar un modelo YOLO26 con el conjunto de datos SKU-110K es sencillo. Aquí tienes un ejemplo para entrenar un modelo YOLO26n durante 100 épocas con un tamaño de imagen de 640:
Ejemplo de entrenamientofrom ultralytics import YOLO # Cargar un modelo model = YOLO("yolo26n.pt") # Carga un modelo preentrenado (recomendado para el entrenamiento) # Entrenar el modelo results = model.train(data="SKU-110K.yaml", epochs=100, imgsz=640)


Comentarios6
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
syafiqmuda
Hi, newbie here, I try to use this dataset to compare and see the accuracy for this dataset with my own, but during training almost all the file were show
Corrupt JPEG data: 786 extraneous bytes before marker 0xd9and sometimesCorrupt JPEG data: premature end of data segment. can I know why? my code look like this:training.py
from ultralytics import YOLO, checks, hub checks() def main(): hub.login('something') model = YOLO('https://hub.ultralytics.com/models/ukr3hHHq88WJASNn3aUz') results = model.train(device=[0,1,2,3]) if __name__ == '__main__': main() Glenn JocherUltralytics
Those messages are PIL JPEG warnings from a handful of non-standard images in SKU-110K; Ultralytics usually auto-recovers/filters these during dataloading via
ultralytics.data.utils.verify_image()(see theverify_image()reference), so if training continues it’s safe to ignore—if it actually crashes, re-download/re-extract the dataset (or re-encode the specific bad JPGs), then delete any*.cacheunder yourlabels/folder and rerun; if you share the text output ofyolo checksplus the full traceback (not a screenshot) we can pinpoint whether it’s data corruption or an environment issue.
ApodiAlsurihi
Hi, thank you for this amazing and detailed explanation! Your work is incredibly helpful and inspiring. I would deeply appreciate it if you could share the trained model after the training process. It would make a significant difference in advancing my project and learning. Thank you so much for your generosity and support!
- Glenn JocherUltralytics
@ApodiAlsurihi thank you for your kind words! Unfortunately, we cannot share trained models directly. However, you can train your own model using the SKU-110K dataset by following the instructions provided in the documentation.
serna01
Are this warnings OK, when training? the batch=0.1 I used it to avoid a memory error. yolo detect train data=SKU-110K.yaml model=yolov8n.pt epochs=50 imgsz=640 batch=0.1
AutoBatch: Using batch-size 2 for CUDA:0 0.49G/3.81G (13%) ✅ train: Scanning /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels... 8216 train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_1797.jpg: 3 duplicate labels removed train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_4222.jpg: ignoring corrupt image/label: image file is truncated (23 bytes not processed) train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_882.jpg: ignoring corrupt image/label: image file is truncated (3 bytes not processed) train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_924.jpg: ignoring corrupt image/label: image file is truncated (10 bytes not processed)
al: Scanning /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels... 588 ima val: New cache created: /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels.cache Corrupt JPEG data: 305 extraneous bytes before marker 0xd9 Corrupt JPEG data: 786 extraneous bytes before marker 0xd9 Plotting labels to runs/detect/train5/labels.jpg... optimizer: 'optimizer=auto' found, ignoring 'lr0=0.01' and 'momentum=0.937' and determining best 'optimizer', 'lr0' and 'momentum' automatically... optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups 57 weight(decay=0.0), 64 weight(decay=0.0005), 63 bias(decay=0.0) TensorBoard: model graph visualization added ✅ Image sizes 640 train, 640 val Using 8 dataloader workers Logging results to runs/detect/train5 Starting training for 50 epochs...
  Epoch    GPU_mem   box_loss   cls_loss   dfl_loss  Instances       Size
   1/50      1.14G      2.504      3.041       1.53        378        640:   5Corrupt JPEG data: premature end of data segment
   1/50      1.15G      2.382      2.658      1.454        331        640:   7Corrupt JPEG data: 562 extraneous bytes before marker 0xd9
   1/50      1.42G      2.273      2.314      1.382        314        640:  11Corrupt JPEG data: bad Huffman code
   1/50      1.42G      2.266      2.295      1.378        578        64       1/50      1.42G      2.266      2.293      1.377        678        64       1/50      1.42G      2.266      2.293      1.377        678        64       1/50      1.42G      2.265      2.292      1.377        723        64       1/50      1.42G      2.265      2.292      1.377        723        64       1/50      1.42G      2.266       2.29      1.377        695        64       1/50      1.42G      2.266          1/50      1.42G      2.255      2.2       1/50      1.42G      2.254      2.247       1.3       1/50      1       1/50              1/50                          1/50      1.42G      2.232      2.187      1.358        608        640:  13Corrupt JPEG data: bad Huffman code
   1/50      1.42G      2.216      2.138      1.347        437        640:  14Corrupt JPEG data: premature end of data segment
   1/50      1.42G      2.164      1.993      1.318        478        640:  17Corrupt JPEG data: 41 extraneous bytes before marker 0xd9
   1/50      1.42G      2.157      1.967      1.312        308        640:  17Corrupt JPEG data: premature end of data segment
   1/50      1.42G      2.011       1.61      1.239        173        640:  30Corrupt JPEG data: premature end of data segment
   1/50      1.42G      1.987      1.556      1.227        461        640:  33Corrupt JPEG data: 96 extraneous bytes before marker 0xd9
   1/50      1.42G      1.978      1.537      1.223        214        640:  34Corrupt JPEG data: bad Huffman code
   1/50      1.42G      1.959      1.497      1.215        250        640:  37Corrupt JPEG data: bad Huffman code
   1/50      1.42G      1.915      1.403      1.197        500        640:  46Corrupt JPEG data: premature end of data segment
   1/50      1.42G      1.888      1.345      1.185        616        640:  52Corrupt JPEG data: premature end of data segment
Thanks.
- Glenn JocherUltralytics
@serna01 the warnings you see are generally okay and indicate that the training process is handling issues like duplicate labels and corrupt images. Using
batch=0.1to avoid memory errors is fine, but consider adjusting your batch size to better utilize your GPU memory. If the warnings persist or cause issues, ensure you're using the latest version of the package. For more details on the SKU-110k dataset, visit SKU-110k Dataset Documentation.