Validación cruzada K-Fold con Ultralytics
Introducción#
Esta guía muestra cómo implementar la validación cruzada K-Fold para conjuntos de datos de detección de objetos en el ecosistema de Ultralytics. Usa el formato de detección YOLO y bibliotecas de Python como scikit-learn, pandas y PyYAML para explicar la configuración, la generación de vectores de características y la división del conjunto de datos en pliegues K-Fold.
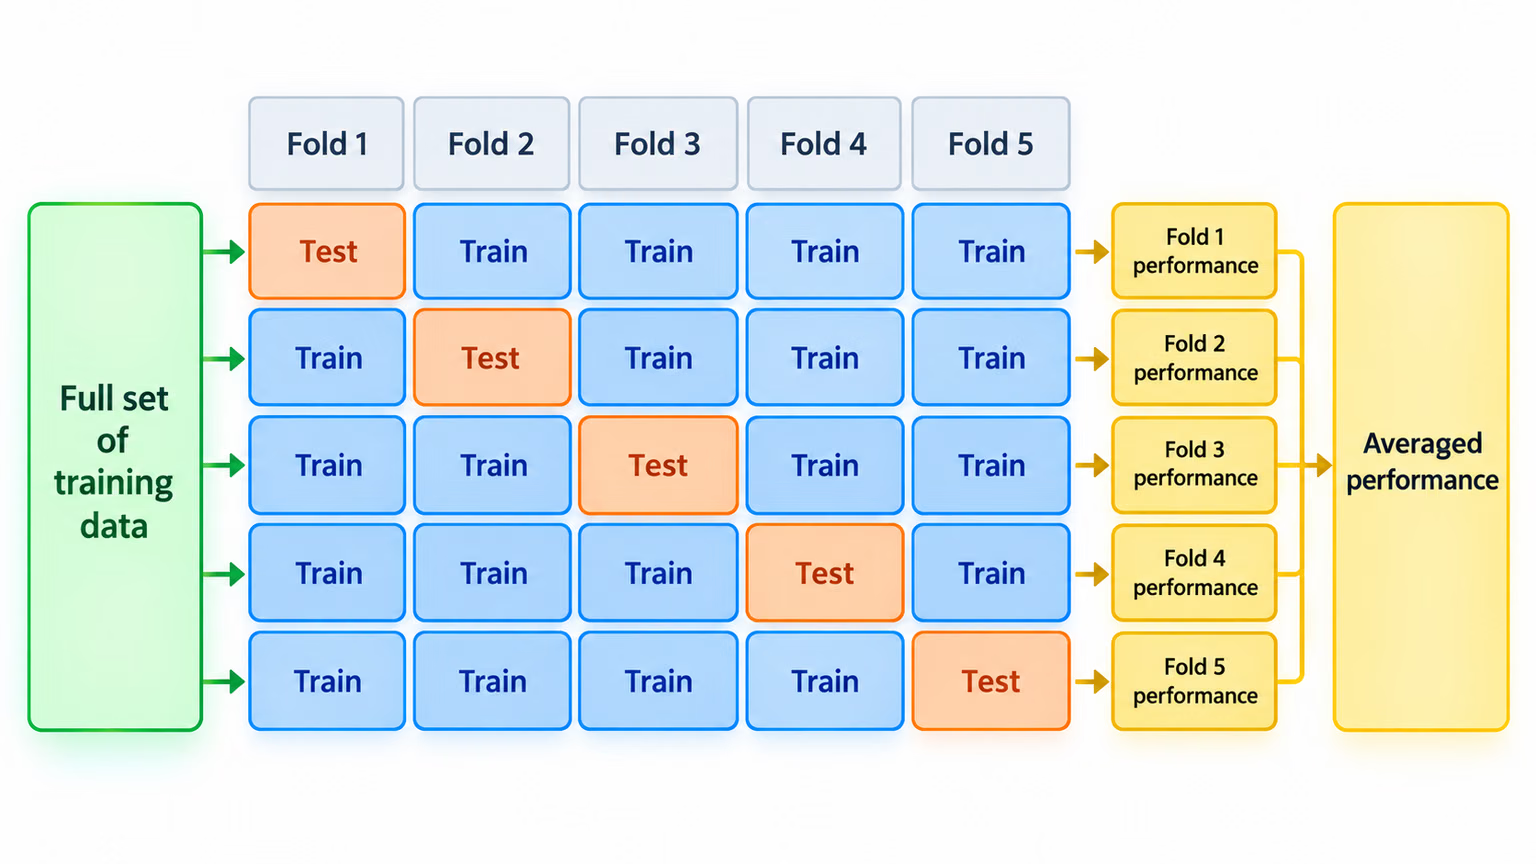
Tanto si tu proyecto usa el conjunto de datos Fruit Detection como una fuente de datos personalizada, este tutorial te ayudará a comprender y aplicar la validación cruzada K-Fold para mejorar la fiabilidad y la robustez de tus modelos de aprendizaje automático. Aunque en este tutorial usamos k=5 pliegues, ten en cuenta que el número óptimo de pliegues puede variar según el conjunto de datos y las características de tu proyecto. La validación cruzada K-Fold es más útil cuando el conjunto de datos es pequeño, ruidoso o muy variable; para conjuntos de datos grandes y diversos, suele bastar con una división bien diseñada en entrenamiento, validación y prueba.
Configuración#
-
Las anotaciones deben estar en el formato de detección YOLO.
-
Esta guía presupone que los archivos de anotaciones están disponibles localmente.
-
Para nuestra demostración, usamos el conjunto de datos Fruit Detection.
- Este conjunto de datos contiene un total de 8479 imágenes.
- Incluye 6 etiquetas de clase, cuyos recuentos totales de instancias se indican a continuación.
| Etiqueta de clase | Recuento de instancias |
|---|---|
| Manzana | 7049 |
| Uvas | 7202 |
| Piña | 1613 |
| Naranja | 15549 |
| Plátano | 3536 |
| Sandía | 1976 |
-
Los paquetes de Python necesarios son:
ultralyticssklearnpandaspyyaml
-
En este tutorial se trabaja con
k=5particiones. Sin embargo, debes determinar el número de particiones más adecuado para tu conjunto de datos.
-
Crea y activa un entorno virtual de Python (
venv) para tu proyecto. Usapip(o el gestor de paquetes que prefieras) para instalar:- La biblioteca Ultralytics:
pip install -U ultralytics. También puedes clonar el repositorio oficial. - Scikit-learn, pandas y PyYAML:
pip install -U scikit-learn pandas pyyaml.
- La biblioteca Ultralytics:
-
Comprueba que tus anotaciones estén en el formato de detección YOLO.
- En este tutorial, todos los archivos de anotaciones se encuentran en el directorio
Fruit-Detection/labels.
- En este tutorial, todos los archivos de anotaciones se encuentran en el directorio
Generación de vectores de características para un conjunto de datos de detección de objetos#
-
Empieza creando un nuevo archivo de Python
example.pypara seguir los pasos que se indican a continuación. -
Carga las imágenes de entrenamiento y validación enumeradas en el YAML de tu conjunto de datos con la clase
YOLODatasetde Ultralytics, sin modificar la división de prueba.from pathlib import Path from ultralytics.data.dataset import YOLODataset from ultralytics.data.utils import check_det_dataset yaml_file = "path/to/data.yaml" data = check_det_dataset(yaml_file) dataset_path = Path(data["path"]) sources = [] for split in ("train", "val"): source = data.get(split) if source: sources.extend(source if isinstance(source, list) else [source]) dataset = YOLODataset(sources, data=data, augment=False) images = [Path(p) for p in dataset.im_files] -
A continuación, lee el contenido del archivo YAML del conjunto de datos y extrae los índices de las etiquetas de clase.
classes = data["names"] cls_idx = sorted(classes.keys()) -
Inicializa un DataFrame
pandasvacío.import pandas as pd labels_df = pd.DataFrame(0.0, columns=cls_idx, index=images) -
Cuenta las instancias de cada etiqueta de clase que aparece en los archivos de anotación.
from collections import Counter for image, label in zip(images, dataset.labels): lbl_counter = Counter(label["cls"].flatten().astype(int)) labels_df.loc[image, list(lbl_counter)] = list(lbl_counter.values()) -
A continuación se muestra un ejemplo del DataFrame con datos:
                                                       0    1    2    3    4    5
'0000a16e4b057580_jpg.rf.00ab48988370f64f5ca8ea4...'  0.0  0.0  0.0  0.0  0.0  7.0
'0000a16e4b057580_jpg.rf.7e6dce029fb67f01eb19aa7...'  0.0  0.0  0.0  0.0  0.0  7.0
'0000a16e4b057580_jpg.rf.bc4d31cdcbe229dd022957a...'  0.0  0.0  0.0  0.0  0.0  7.0
'00020ebf74c4881c_jpg.rf.508192a0a97aa6c4a3b6882...'  0.0  0.0  0.0  1.0  0.0  0.0
'00020ebf74c4881c_jpg.rf.5af192a2254c8ecc4188a25...'  0.0  0.0  0.0  1.0  0.0  0.0
 ...                                                  ...  ...  ...  ...  ...  ...
'ff4cd45896de38be_jpg.rf.c4b5e967ca10c7ced3b9e97...'  0.0  0.0  0.0  0.0  0.0  2.0
'ff4cd45896de38be_jpg.rf.ea4c1d37d2884b3e3cbce08...'  0.0  0.0  0.0  0.0  0.0  2.0
'ff5fd9c3c624b7dc_jpg.rf.bb519feaa36fc4bf630a033...'  1.0  0.0  0.0  0.0  0.0  0.0
'ff5fd9c3c624b7dc_jpg.rf.f0751c9c3aa4519ea3c9d6a...'  1.0  0.0  0.0  0.0  0.0  0.0
'fffe28b31f2a70d4_jpg.rf.7ea16bd637ba0711c53b540...'  0.0  6.0  0.0  0.0  0.0  0.0
Las filas usan rutas absolutas a las imágenes y las columnas corresponden a los índices de las etiquetas de clase. Las etiquetas que faltan se representan como filas de fondo con todos los valores a cero. Esta estructura de datos permite aplicar la validación cruzada K-Fold a un conjunto de datos de detección de objetos.
Partición K-Fold del conjunto de datos#
-
Ahora usaremos la clase
KFolddesklearn.model_selectionpara generarkparticiones del conjunto de datos.- Importante:
- Al establecer
shuffle=True, se garantiza una distribución aleatoria de las clases en las particiones. - Si estableces
random_state=MconMcomo un entero elegido, obtendrás resultados reproducibles.
- Al establecer
from sklearn.model_selection import KFold ksplit = 5 kf = KFold(n_splits=ksplit, shuffle=True, random_state=20) # establecer random_state para obtener resultados reproducibles kfolds = list(kf.split(labels_df)) - Importante:
-
El conjunto de datos ya está dividido en
kparticiones, cada una con una lista de índicestrainyval. Crearemos un DataFrame para mostrar estos resultados con más claridad.folds = [f"split_{n}" for n in range(1, ksplit + 1)] folds_df = pd.DataFrame(index=labels_df.index, columns=folds) for i, (train, val) in enumerate(kfolds, start=1): folds_df.loc[labels_df.index[train], f"split_{i}"] = "train" folds_df.loc[labels_df.index[val], f"split_{i}"] = "val" -
Ahora calcularemos la distribución de las etiquetas de clase de cada partición como la proporción entre las clases presentes en
valy las presentes entrain.fold_lbl_distrb = pd.DataFrame(index=folds, columns=cls_idx) for n, (train_indices, val_indices) in enumerate(kfolds, start=1): train_totals = labels_df.iloc[train_indices].sum() val_totals = labels_df.iloc[val_indices].sum() # To avoid division by zero, we add a small value (1E-7) to the denominator ratio = val_totals / (train_totals + 1e-7) fold_lbl_distrb.loc[f"split_{n}"] = ratioLo ideal es que las proporciones de todas las clases sean razonablemente similares en cada partición y entre las distintas clases. Sin embargo, esto dependerá de las características de tu conjunto de datos.
-
Escribe listas de imágenes y un YAML del conjunto de datos para cada partición. Las listas de texto evitan copiar el conjunto de datos
kveces.import yaml save_path = dataset_path.parent / f"{ksplit}-Fold_Cross-val" save_path.mkdir(parents=True, exist_ok=True) ds_yamls = [] for split in folds_df.columns: for partition in ("train", "val"): split_images = folds_df.index[folds_df[split] == partition] paths = "\n".join(map(str, split_images)) (save_path / f"{split}_{partition}.txt").write_text(f"{paths}\n") dataset_yaml = save_path / f"{split}.yaml" ds_yamls.append(dataset_yaml) with open(dataset_yaml, "w") as ds_y: yaml.safe_dump( { "path": save_path.as_posix(), "train": f"{split}_train.txt", "val": f"{split}_val.txt", "names": classes, }, ds_y, )
Guardar registros (opcional)#
Si quieres, puedes guardar como archivos CSV los registros de la partición K-Fold y los DataFrames de distribución de etiquetas para consultarlos más adelante.
folds_df.to_csv(save_path / "kfold_datasplit.csv")
fold_lbl_distrb.to_csv(save_path / "kfold_label_distribution.csv")
Entrenar YOLO con particiones de datos K-Fold#
-
Primero, carga el modelo YOLO.
from ultralytics import YOLO weights_path = "path/to/weights.pt" # usa yolo26n.pt para un modelo pequeño model = YOLO(weights_path, task="detect") -
A continuación, itera por los archivos YAML del conjunto de datos para ejecutar el entrenamiento. Los resultados se guardarán en el directorio especificado por los argumentos
projectyname. De forma predeterminada, este directorio esruns/detect/train#, donde#es un índice entero.results = {} # Define your additional arguments here batch = 16 project = "kfold_demo" epochs = 100 for k, dataset_yaml in enumerate(ds_yamls): model = YOLO(weights_path, task="detect") results[k] = model.train( data=dataset_yaml, epochs=epochs, batch=batch, project=project, name=f"fold_{k + 1}" ) # include any additional train arguments -
También puedes usar la función autosplit de Ultralytics para dividir automáticamente el conjunto de datos:
from ultralytics.data.split import autosplit

# Dividir automáticamente el conjunto de datos en train/val/test
autosplit(path="path/to/images", weights=(0.8, 0.2, 0.0), annotated_only=True)
Conclusión#
En esta guía, hemos explicado cómo usar la validación cruzada K-Fold para entrenar el modelo YOLO de detección de objetos. Hemos aprendido a dividir el conjunto de entrenamiento y validación en K particiones y a utilizar la tabla de proporciones generada para analizar el equilibrio entre clases después de la división aleatoria.
También hemos explicado cómo crear DataFrames de informes para visualizar las divisiones de los datos y la distribución de las etiquetas en cada una, y obtener así una visión clara de la estructura de los conjuntos de entrenamiento y validación.
De forma opcional, hemos guardado nuestros registros para consultarlos más adelante, algo que puede resultar especialmente útil en proyectos a gran escala o al investigar problemas de rendimiento del modelo.
Por último, hemos implementado el entrenamiento del modelo propiamente dicho mediante un bucle que utiliza cada partición y guarda los resultados del entrenamiento para analizarlos y compararlos más adelante.
Esta técnica de validación cruzada K-Fold permite aprovechar al máximo los datos disponibles y ayuda a garantizar que el rendimiento del modelo sea fiable y uniforme en distintos subconjuntos de datos. Así se obtiene un modelo más generalizable y fiable, con menos probabilidades de sobreajustarse a patrones de datos concretos.
Ten en cuenta que, aunque en esta guía hemos usado YOLO, estos pasos se pueden aplicar en gran medida a otros modelos de aprendizaje automático. Si los comprendes, podrás aplicar la validación cruzada con eficacia en tus propios proyectos de aprendizaje automático.
Preguntas frecuentes#
La validación cruzada K-Fold es una técnica que divide el conjunto de datos en «k» subconjuntos (particiones) para evaluar el rendimiento del modelo de forma más fiable. Cada partición se utiliza tanto como datos de entrenamiento como de validación. En la detección de objetos, la validación cruzada K-Fold ayuda a garantizar que el rendimiento de tu modelo Ultralytics YOLO sea sólido y generalizable en distintas particiones de datos, lo que mejora su fiabilidad. Para consultar instrucciones detalladas sobre cómo configurar la validación cruzada K-Fold con Ultralytics YOLO, visita Validación cruzada K-Fold con Ultralytics.
Para implementar la validación cruzada K-Fold con Ultralytics YOLO, sigue estos pasos:
- Comprueba que las anotaciones estén en el formato de detección YOLO.
- Usa bibliotecas de Python como
sklearn,pandasypyyaml. - Crea vectores de características a partir de tu conjunto de datos.
- Divide el conjunto de datos con
KFolddesklearn.model_selection. - Entrena el modelo YOLO con cada partición.
Encontrarás una guía completa en la sección Partición K-Fold del conjunto de datos de nuestra documentación.
El flujo de trabajo de esta guía está pensado para el formato de detección YOLO, pero el mismo enfoque se adapta a todas las tareas de YOLO: la tarea determina cómo se componen las particiones, no si la validación cruzada resulta útil:
Tarea Diseño de las particiones detectDivide las imágenes y equilibra la distribución de objetos y clases entre las particiones. Mantén las imágenes relacionadas (del mismo paciente, secuencia de vídeo, cámara o ubicación) en una sola partición. segmentUsa la misma estrategia por imagen que en detección y, además, garantiza que haya máscaras y clases representadas en cada partición. classifyDa preferencia a las particiones estratificadas para mantener equilibrada la frecuencia de las clases entre el entrenamiento y la validación. poseDivide por sujeto o secuencia para que la misma persona o animal nunca aparezca en ambos lados de una partición. obbDivide las imágenes y mantén juntos los mosaicos o recortes de una misma escena; esto es especialmente importante en las imágenes aéreas. Sea cual sea la tarea, evita que las muestras casi duplicadas y relacionadas aparezcan en pliegues distintos: este tipo de filtración infla las métricas de validación muy por encima del rendimiento que el modelo alcanzará en producción.
Ultralytics YOLO ofrece detección de objetos en tiempo real de última generación con gran precisión y eficiencia. Es versátil y admite varias tareas de visión artificial, como la detección, la segmentación de instancias, la segmentación semántica y la clasificación. Además, se integra con herramientas como Ultralytics Platform para entrenar e implementar modelos sin código.
Tus anotaciones deben seguir el formato de detección YOLO. Cada archivo de anotaciones debe indicar la clase del objeto y las coordenadas de su caja delimitadora en la imagen. El formato YOLO garantiza un procesamiento de datos optimizado y estandarizado para entrenar modelos de detección de objetos. Para obtener más información sobre el formato correcto de las anotaciones, consulta la guía del formato de detección YOLO.
Sí, puedes usar la validación cruzada K-Fold con cualquier conjunto de datos personalizado, siempre que las anotaciones estén en el formato de detección YOLO. Sustituye las rutas del conjunto de datos y las etiquetas de clase por las correspondientes a tu conjunto de datos personalizado. Esta flexibilidad permite que cualquier proyecto de detección de objetos se beneficie de una evaluación robusta del modelo mediante la validación cruzada K-Fold. Para ver un ejemplo práctico, consulta la sección Generación de vectores de características.


Comentarios21
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
jingieboy
does this work with yolov8-cls? if so how would the folder structure look like? how are the data splits
 Glenn JocherUltralytics(editado)
Yes—K‑Fold works the same for classification; use the standard ImageNet-style layout per fold, and train each fold separately (YOLO infers classes from folder names). For YOLO26 (recommended) you can do:
dataset/
  split_1/
    train/
      class_a/ ...
      class_b/ ...
    val/
      class_a/ ...
      class_b/ ...
  split_2/
    train/...
    val/...
  ...
from ultralytics import YOLO weights = "yolo26n-cls.pt" # swap to 'yolov8n-cls.pt' if you prefer YOLOv8 splits = ["dataset/split_1", "dataset/split_2", "dataset/split_3"] for d in splits: model = YOLO(weights) model.train(data=d, epochs=20, batch=16) # d must contain 'train/' and 'val/' subfoldersFor building folds, use
StratifiedKFoldon image-level labels derived from parent folder names to keep class balance, or use the random splitter shown in the autosplit reference if stratification isn’t required. Classification usage details are in the classification task docs.thank you for this! I have also notice that everytime I run model.val(), the accuracies and confusion matrix values are slightly different this time. Is this normal or during evaluation, there is a small randomness when calling the function.
- Glenn JocherUltralytics
@jingieboy minor variations can occur from non-deterministic CUDA ops or multi-threading; validation itself doesn’t add randomness by default—set seeds and force deterministic ops to lock results:
import random, numpy as np, torch

seed = 0
random.seed(seed); np.random.seed(seed); torch.manual_seed(seed)
torch.backends.cudnn.deterministic = True
torch.backends.cudnn.benchmark = False

model.val()  # run evaluation
If differences are still large, double-check your eval args in the validation mode docs.
Nehasq
Hi, I am applying K-fold validation using the leave-one-out technique. My dataset consists of a single class and includes 21 images in total. For each split, I use 20 images for training and 1 image for testing. I am implementing the leave-one-out technique with the code above, setting ksplit=21.
I am not using a separate validation dataset, only training and testing data. Here is the code I am using:
results = {}
Define additional arguments here
batch = 16 project = "kfold_demo" epochs = 100
for k in range(ksplit): dataset_yaml = ds_yamls[k] model = YOLO(weights_path, task="detect") model.train(data=dataset_yaml, epochs=epochs, batch=batch, project=project) # Include any train arguments results[k] = model.metrics # Save output metrics for further analysis
In my data.yaml file, I have provided the validation path as the test set. When it trains and validates on the "1 test data," does this mean the model is being tested on data it has never seen during training? This is my first point of confusion.
my data.yaml file for each split looks like this: names:
- pothole path: ../ 2024-12-10_21-Fold_Cross-val/split_1 train: train val: test
My second question is about calculating the final performance. When I ran the above code, it calculated scores for each individual split. Do I need to calculate the final performance metrics manually, or is there any functionality in YOLOv8 to compute the aggregated performance automatically?
- Glenn JocherUltralytics
@Nehasq to address your first question, yes, the model is being tested on unseen data during each split, as the test set (1 image) is excluded from training and only used for validation. Regarding your second question, YOLO does not automatically aggregate metrics across splits. You need to compute the final performance metrics manually by averaging the results from all splits. For reference, you can review the K-Fold Cross Validation guide.
Thanks for your reply. I understand your point. So, are you saying that, for example, in my case, where I have 21 scores (precision, recall, etc.), I should simply add all the precision values together and divide the sum by 21 to get the final precision of the model? Is that correct?
Also, in y case of 20 images( training) and 1 images for test, what batch size would you suggest?
- Glenn JocherUltralytics
Yes, to calculate the final precision (or any metric), you average the values across all splits, i.e., sum all precision scores and divide by the number of splits (21 in your case). As for the batch size, given your small dataset, you could keep it low (e.g., 1 or 2) to ensure efficient utilization of the data while avoiding overfitting.
Thanks, that really helps! With a batch size of 1, I am keeping the epochs at 10. Should it be fewer? Also, to check for overfitting, I need to review the result graphs for each split. However, I can't definitively determine if it is overfitting since each split is separate, right?
- Glenn JocherUltralytics
Keeping epochs at 10 with a batch size of 1 is reasonable given your small dataset size. To check for overfitting, reviewing result graphs from each split can help, but overfitting may be harder to detect since each split involves different training and test data. Consider comparing trends across splits for consistent insights. For further details, you can reference the K-Fold Cross Validation guide.
semyon-v-dot
After the loop:
for ext in supported_extensions:
    images.extend(sorted((dataset_path / "images").rglob(f"*{ext}")))
Should be this line of code:
images = sorted(images)For
imagesmatching withlabelslist:labels = sorted(dataset_path.rglob("*labels/*.txt"))Otherwise the script creates background images because some images missing their labels.
- Glenn JocherUltralytics
@semyon-v-dot thank you for your suggestion. Sorting the
imageslist after extending it with supported extensions is a good practice to ensure alignment with thelabelslist. This helps prevent issues with missing labels.1
 sangeun jo
K-폴드 데이터 세트 분할 4번에서
images.extend(sorted((dataset_path / "images").rglob(f"*{ext}")))이 코드를images.extend(sorted(dataset_path.rglob(f"*images/*{ext}")))로 변환해야 작동했습니다.- Glenn JocherUltralytics
@sangeun-jo thank you for pointing that out. Your modification to
images.extend(sorted(dataset_path.rglob(f"*images/*{ext}")))is indeed correct and ensures the code works as intended. If you have any further questions or need additional assistance, feel free to ask!
kh-diab
is it usefult to use this k fold approach when I just have one class only but my issue is the class is detected as background or vice versa as per the attached Confusion matrix
- Glenn JocherUltralytics
@kh-diab using K-Fold Cross Validation can still be beneficial even with a single class. It helps ensure that your model's performance is robust and not overly dependent on a particular subset of the data. This can be particularly useful if you're experiencing issues with class detection accuracy, as it allows you to validate the model's performance across multiple splits and identify any inconsistencies. If your class is being detected as background or vice versa, K-Fold Cross Validation can help diagnose whether this issue is consistent across different data splits or specific to certain subsets. For more details, you can refer to our guide on K-Fold Cross Validation: https://docs.ultralytics.com/guides/kfold-cross-validation/.
alexander-sony
Good guide, consider adding it in a colab notebook.
In section "Train YOLO using K-Fold Data Splits", model should be re-initialized foe every k, i.e. it should be inside the for-loop: for k in range(ksplit).
- Glenn JocherUltralytics
@alexander-sony thank you for your feedback and suggestion! 😊
You're absolutely right about re-initializing the model within the loop for each fold to ensure a fresh start for every training iteration. This can help avoid any potential carryover effects from previous folds. Here's the corrected code snippet for the training section:
from ultralytics import YOLO

weights_path = "path/to/weights.pt"
results = {}

# Define your additional arguments here
batch = 16
project = "kfold_demo"
epochs = 100

for k in range(ksplit):
    model = YOLO(weights_path, task="detect")  # Re-initialize the model inside the loop
    dataset_yaml = ds_yamls[k]
    model.train(data=dataset_yaml, epochs=epochs, batch=batch, project=project)  # include any train arguments
    results[k] = model.metrics  # save output metrics for further analysis
Regarding your suggestion to add this guide to a Colab notebook, that's a fantastic idea! It would make the process more interactive and accessible for users. We'll consider creating a Colab version of this guide in the future.
For more details on K-Fold Cross Validation, you can refer to our comprehensive guide.
Thanks again for your valuable input! If you have any more suggestions or questions, feel free to share. Happy coding! 🚀
Likhith-Sugganahalli
@alexander-sony
woudnt that be a new model trained on each split, giving us n different models trained on 1/nth of the dataset?
 Fazri Gading
Is there any way to implement Stratified K-Fold Cross Validation with YOLOv8?
 Paula DerrengerUltralytics
Yes, you can implement Stratified K-Fold Cross Validation with YOLOv8! Stratified K-Fold ensures that each fold has a similar distribution of class labels, which can be particularly useful for imbalanced datasets.
To achieve this, you can use
StratifiedKFoldfromsklearn.model_selectioninstead ofKFold. Here's a brief example of how to modify the K-Fold implementation:from sklearn.model_selection import StratifiedKFold # Assuming labels_df is your DataFrame with class counts ksplit = 5 skf = StratifiedKFold(n_splits=ksplit, shuffle=True, random_state=20) # Generate stratified splits kfolds = list(skf.split(labels_df, labels_df.idxmax(axis=1))) # The rest of the process remains the sameFor a detailed guide on K-Fold Cross Validation, please refer to the Ultralytics documentation. If you have any more questions, feel free to ask! 😊
1