Exportación a Rockchip RKNN
RKNN es el formato de modelo de las NPU de procesadores Rockchip como el RK3588 y el RK3566. Al exportar un modelo Ultralytics YOLO26 con format="rknn" se crea un directorio yolo26n_rknn_model/ que contiene un archivo .rknn compilado para un chip Rockchip, que eliges con el argumento name, con precisión FP16 o INT8.
Resumen#
| Propiedad | Detalles |
|---|---|
Argumento format | rknn |
| Salida | yolo26n_rknn_model/, un directorio con yolo26n-rk3588.rknn y metadata.yaml; las exportaciones INT8 de modelos de detección, segmentación, pose y OBB añaden tail.onnx |
| Se ejecuta en | La NPU de un chip Rockchip por exportación: RK3588, RK3576, RK3566, RK3568, RK3562, RK2118, RV1126B, RV1103, RV1106, RV1103B o RV1106B; consulta Chips de destino |
| Entorno de ejecución | RKNN Toolkit Lite2 (el paquete de Python rknn-toolkit-lite2) en el dispositivo Rockchip |
| Precisión | FP16 (predeterminado) e INT8; solo INT8 en RV1103, RV1106, RV1103B y RV1106B. No hay exportación FP32. YOLO26n para el RK3588 ocupa 7,4 MB en FP16 y 4,3 MB en INT8 |
| Equipo de exportación | Linux x86-64 con Python 3.12 o anterior. Exporta en un PC y copia el directorio exportado al dispositivo Rockchip |
Ultralytics Platform puede exportar un modelo entrenado a RKNN para el chip Rockchip que elijas, por lo que no necesitas un entorno de exportación local.
Inicio rápido#
Instala el paquete Ultralytics en un entorno virtual independiente en una máquina Linux x86-64, junto con las versiones protobuf y numpy que necesita el toolkit RKNN:
pip install ultralytics "protobuf<7" "numpy<2.4"La primera exportación instala onnx, onnxslim, onnxruntime y rknn-toolkit2 con sus dependencias, si no están ya instalados. Con un pip install ultralytics normal, la primera exportación también sustituye numpy, protobuf y setuptools cuando sus versiones quedan fuera de los intervalos indicados a continuación, así que utiliza un entorno independiente. Si tiene que sustituir protobuf o numpy, esa exportación falla y la siguiente se completa correctamente en un proceso nuevo. La exportación requiere estas versiones:
| Paquete | Versión requerida |
|---|---|
| Python | 3.12 o anterior, la versión más reciente para la que rknn-toolkit2 2.3.2 tiene compilaciones |
rknn-toolkit2 | 2.3.2, la única versión disponible en PyPI dentro del intervalo requerido (2.3.2 o posterior y anterior a 2.5) |
onnx | 1.16.1 o posterior y anterior a 1.19.0 |
numpy | anterior a 2.4 |
protobuf | anterior a 7 |
setuptools | anterior a 82 |
Para otros métodos de instalación, consulta la guía de instalación. Después, exporta el modelo en el PC, copia el directorio exportado al dispositivo Rockchip y cárgalo allí para ejecutar inferencias o validar su precisión.
from ultralytics import YOLO

# Carga un modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporta el modelo al formato RKNN para el RK3588 en FP16
model.export(format="rknn", name="rk3588")  # creates 'yolo26n_rknn_model/'

# O exporta en su lugar un modelo RKNN cuantizado a INT8 con datos de calibración
model.export(format="rknn", name="rk3588", quantize=8, data="coco8.yaml")  # creates 'yolo26n_rknn_model/'
Ambas exportaciones escriben el mismo directorio yolo26n_rknn_model/, por lo que la segunda sustituye a la primera. Predict y Validate solo se ejecutan en un dispositivo Rockchip:
from ultralytics import YOLO

# Carga el modelo RKNN exportado en el dispositivo Rockchip
model = YOLO("yolo26n_rknn_model")

# Ejecutar inferencia
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carga el modelo RKNN exportado en el dispositivo Rockchip
model = YOLO("yolo26n_rknn_model")
# Valida la precisión con el conjunto de datos COCO8
metrics = model.val(data="coco8.yaml")Tareas compatibles#
La exportación RKNN es compatible con las siete tareas de Ultralytics con modelos YOLOv8, YOLO11 y YOLO26: detección, segmentación, segmentación semántica, estimación de profundidad, clasificación, estimación de pose y OBB. La segmentación semántica y la estimación de profundidad solo están disponibles con YOLO26, la única familia que incluye esas cabezas.
Argumentos de exportación#
| Argumento | Tipo | Predeterminado | Descripción |
|---|---|---|---|
format | str | 'rknn' | Formato de destino del modelo exportado, que define su compatibilidad con distintos entornos de implementación. |
name | str | 'rk3588' | Chip Rockchip para el que se compila el modelo, en mayúsculas o minúsculas. Consulta Chips de destino. |
imgsz | int o tuple | 640 | Tamaño de imagen de la entrada del modelo: un entero para imágenes cuadradas o una tupla (height, width). Si no se especifica, la exportación utiliza el tamaño con el que se entrenó el punto de control. Los puntos de control oficiales de YOLO26 utilizan 640 para modelos de detección, segmentación y pose, y para modelos semánticos preentrenados en ADE20K; 1024 para modelos OBB y modelos semánticos preentrenados en Cityscapes; 768 para profundidad; y 224 para clasificación. |
quantize | int o str | None | Precisión: 16 o no especificarlo genera una compilación FP16, mientras que 8 genera una compilación INT8 calibrada con data. En los chips que solo admiten INT8, no especificar el valor genera una compilación INT8 y 16 provoca un error. 32 provoca un error, y no se puede exportar a RKNN un punto de control entrenado con quantize=8; consulta Limitaciones y solución de problemas. Sustituye las opciones obsoletas half/int8. |
data | str | None | Archivo YAML del conjunto de datos usado para la calibración INT8; en clasificación, en su lugar se indica un directorio de conjunto de datos o un nombre de conjunto de datos integrado. La calibración usa la partición val, salvo que se establezca split. Si se omite con quantize=8, Ultralytics usa el pequeño conjunto de datos predeterminado para la tarea del modelo, como coco8.yaml para detección. |
fraction | float, int o list | 1.0 | Subconjunto de calibración: una proporción, un número de imágenes (enteros superiores a 1) o una lista [train, val, test], de la que se utiliza la entrada de la partición de calibración. |
batch | int | 1 | Tamaño del lote del modelo exportado, fijado en la forma de entrada. |
simplify | bool | True | Simplifica el grafo ONNX intermedio con onnxslim. |
opset | int | None | Versión del opset de ONNX del grafo ONNX intermedio. Si no se especifica, utiliza 19 y reduce los valores superiores a 19. |
nms | bool, opcional | None | Los modelos RKNN siempre devuelven predicciones sin procesar para aplicar NMS externamente. La cabeza sin NMS (False) y la NMS integrada (True) no están disponibles; consulta Limitaciones y solución de problemas. |
device | str | None | Dispositivo que traza el grafo ONNX intermedio: cpu (el predeterminado) o 0 para una GPU CUDA. |
Para consultar los argumentos comunes a todos los formatos, visita la documentación del modo de exportación.
Chips de destino#
Un archivo .rknn se compila para un chip; name lo selecciona. Los tamaños corresponden a un modelo de detección YOLO26n exportado con imgsz=640 y sin especificar quantize:
name | Precisiones | Si no se especifica quantize, se genera | Archivo YOLO26n | Tamaño |
|---|---|---|---|---|
rk3588 | FP16, INT8 | FP16 | yolo26n-rk3588.rknn | 7.4 MB |
rk3576 | FP16, INT8 | FP16 | yolo26n-rk3576.rknn | 10.5 MB |
rk3566 | FP16, INT8 | FP16 | yolo26n-rk3566.rknn | 6.8 MB |
rk3568 | FP16, INT8 | FP16 | yolo26n-rk3568.rknn | 6.8 MB |
rk3562 | FP16, INT8 | FP16 | yolo26n-rk3562.rknn | 6.8 MB |
rk2118 | FP16, INT8 | FP16 | yolo26n-rk2118.rknn | 6.8 MB |
rv1126b | FP16, INT8 | FP16 | yolo26n-rv1126b.rknn | 7.1 MB |
rv1103 | INT8 | INT8 | yolo26n-rv1103.rknn | 4.2 MB |
rv1106 | INT8 | INT8 | yolo26n-rv1106.rknn | 4.2 MB |
rv1103b | INT8 | INT8 | yolo26n-rv1103b.rknn | 4.2 MB |
rv1106b | INT8 | INT8 | yolo26n-rv1106b.rknn | 4.2 MB |
Los cuatro chips que solo admiten INT8 se calibran con el valor predeterminado coco8.yaml de esta tabla, y sus exportaciones también escriben tail.onnx.
Cuantización#
quantize selecciona la precisión del archivo .rknn. Los tamaños corresponden a una exportación con imgsz=640 y batch=1:
quantize | Precisión | Datos de calibración | Archivos para YOLO26n y rk3588 | Tamaño |
|---|---|---|---|---|
sin especificar o 16 | FP16 | No | yolo26n-rk3588.rknn | 7.4 MB |
8 | INT8 | Sí | yolo26n-rk3588.rknn y tail.onnx | 4,3 MB y 0,2 MB |
- FP16: es el valor predeterminado en los siete chips que lo admiten. No necesita datos de calibración.
- INT8:
quantize=8ejecuta imágenes de calibración en el modelo y almacena los pesos y las activaciones como enteros de 8 bits. La exportación calibra con la particiónvaldedata, o con la partición que configures mediantesplit, y muestra una advertencia si hay menos de 300 imágenes. Utilizafractionpara limitar el número de imágenes. - Precisión mixta: en los siete chips que admiten FP16, una exportación INT8 permite que RKNN Toolkit mantenga capas en FP16 cuando la cuantización altera demasiado su salida (
auto_hybrid). Los cuatro chips que solo admiten INT8 omiten este paso. - Cabeza de detección: en los modelos de detección, segmentación, pose y OBB, el archivo INT8
.rknntermina en las convoluciones de salida de la cabeza. Las operaciones que decodifican esas salidas en cajas se guardan entail.onnxy se ejecutan en coma flotante en la CPU del dispositivo, porque INT8 por tensor no puede representar los valores del intervalo de píxeles de la decodificación de cajas. - Modelos de profundidad: las exportaciones INT8 de profundidad se calibran con imágenes de un conjunto de datos de profundidad que tengan mapas de profundidad asociados. Elige imágenes de calibración que abarquen el intervalo de profundidad cercano y lejano de la escena de despliegue. Con el valor predeterminado
depth8.yaml, que tiene 4 imágenes de validación, un modelo YOLO26n-depth INT8 en el simulador rknn-toolkit2 devolvió profundidades de hasta 3,9 para una imagen de una calle, mientras que el modelo FP16 devolvió valores de hasta 13,9. - Estado en el dispositivo: las exportaciones INT8 de todas las tareas se ejecutaron en el simulador rknn-toolkit2 y se compararon con el modelo ONNX en una sola imagen. Su precisión no se ha medido en un conjunto de datos ni en hardware Rockchip, así que valida un modelo INT8 en tu dispositivo y con tus propios datos antes de desplegarlo.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# Calibra con el 10 % de las imágenes de validación de COCO (500 imágenes); sustituye coco.yaml por tu propio conjunto de datos
model.export(format="rknn", name="rk3588", quantize=8, data="coco.yaml", fraction=0.1)
Formato de salida#
La exportación escribe un directorio:
| Archivo | Contenido |
|---|---|
yolo26n-rk3588.rknn | El modelo, con el chip establecido por name en el nombre del archivo |
tail.onnx | Solo para modelos INT8 de detección, segmentación, pose y OBB: las operaciones que decodifican las salidas de la cabeza en predicciones sin procesar, para ejecutarlas en la CPU |
metadata.yaml | Nombres de las clases, tarea, tamaño de imagen, tamaño del lote, stride y argumentos de exportación, que Ultralytics lee al cargar el modelo |
El archivo intermedio yolo26n.onnx se mantiene junto al directorio. El modelo .rknn recibe una entrada con la forma (batch, height, width, 3): RGB, canales al final (NHWC), uint8 con valores de 0 a 255. La división entre 255 forma parte del modelo, así que no escales la imagen por tu cuenta. Esto difiere de la exportación ONNX, que recibe imágenes con los canales primero, float32, escaladas de 0 a 1.
Las salidas dependen de la tarea y la precisión. Las formas que se indican a continuación corresponden a los puntos de control oficiales YOLO26n con el tamaño de exportación predeterminado, y al punto de control de Cityscapes yolo26n-sem.pt para segmentación semántica:
| Tarea | Valor predeterminado imgsz | Salida FP16 y salida tail.onnx para INT8 | Salida INT8 .rknn |
|---|---|---|---|
| Detección | 640 | (1, 84, 8400) | 6 tensores de la cabeza, decodificados por tail.onnx |
| Segmentación | 640 | (1, 116, 8400) y (1, 32, 160, 160) | 9 tensores de la cabeza y (1, 32, 160, 160), decodificados por tail.onnx |
| Semántica | 1024 | (1, 19, 1024, 1024), una puntuación para cada clase y píxel | Igual que FP16 |
| Profundidad | 768 | (1, 1, 768, 768), mapa de profundidad | Igual que FP16 |
| Clasificar | 224 | (1, 1000), probabilidades de clase | Igual que FP16 |
| Pose | 640 | (1, 56, 8400) | 9 tensores de la cabeza, decodificados por tail.onnx |
| OBB | 1024 | (1, 20, 21504) | 9 tensores de la cabeza, decodificados por tail.onnx |
- Predicciones sin procesar: los modelos FP16 y
tail.onnxpara modelos INT8 devuelven las mismas predicciones sin procesar que una exportación ONNX predeterminada: para cada ancla, el centro x de la caja, el centro y, el ancho y el alto en píxeles de entrada; después, las puntuaciones de clase y, por último, los valores de la tarea (32 coeficientes de máscara, 17 x 3 valores de puntos clave o el ángulo OBB en radianes). Aplica NMS por tu cuenta. Consulta el formato de salida ONNX para ver la estructura de cada tarea. - Tensores de cabeza INT8: un modelo de detección INT8 devuelve dos tensores para cada una de las tres escalas de detección, uno con los valores de las cajas y otro con las puntuaciones de clase; los modelos de segmentación, pose y OBB devuelven un tensor más por escala con sus valores adicionales. Pásalos a
tail.onnxen el orden en que los devuelve el modelo; un modelo de segmentación también pasa sus prototipos de máscara portail.onnxsin modificarlos. - Segmentación semántica: la salida contiene una puntuación para cada clase y píxel, no el mapa de clases de la exportación ONNX, así que calcula el argmax sobre el eje de clases en tu propio código.
- NMS: no hay salida sin NMS ni con NMS integrada; consulta Limitaciones y solución de problemas.
YOLO("yolo26n_rknn_model") lee la estructura de metadata.yaml, ejecuta tail.onnx y aplica NMS, así que solo necesitas estos detalles si ejecutas el modelo en tu propio código. Las claves de metadata.yaml incluyen names, task, imgsz, stride, batch, end2end, args y, para modelos de pose, kpt_shape.
Ejecutar con RKNN Toolkit Lite2#
Para ejecutar el modelo en el dispositivo fuera del paquete Ultralytics, cárgalo con el paquete rknn-toolkit-lite2 y, en el caso de un modelo INT8 de detección, segmentación, pose u OBB, pasa sus salidas a tail.onnx con ONNX Runtime:
# Exporta primero: yolo export model=yolo26n.pt format=rknn name=rk3588 quantize=8 data=coco8.yaml
import numpy as np
import onnxruntime as ort
from rknnlite.api import RKNNLite

rknn = RKNNLite()
assert rknn.load_rknn("yolo26n_rknn_model/yolo26n-rk3588.rknn") == 0
assert rknn.init_runtime() == 0

image = np.zeros((1, 640, 640, 3), dtype=np.uint8)  # tu imagen con letterbox: RGB, NHWC, 0-255
outputs = rknn.inference(inputs=[image])  # seis tensores de cabeza para un modelo de detección INT8

tail = ort.InferenceSession("yolo26n_rknn_model/tail.onnx", providers=["CPUExecutionProvider"])
feed = {t.name: x.astype(np.float32) for t, x in zip(tail.get_inputs(), outputs)}
predictions = tail.run(None, feed)[0]  # forma (1, 84, 8400), predicciones sin procesar que requieren NMS
assert predictions.shape == (1, 84, 8400), "export a detection model at imgsz=640 with quantize=8"
tail.onnx tiene un tamaño de lote de 1, sea cual sea el valor de exportación batch, así que ejecútalo una vez por imagen si el modelo se ha exportado con un lote mayor. Un modelo FP16 no tiene tail.onnx, y outputs[0] ya contiene las predicciones sin procesar.
Despliega#
En el dispositivo Rockchip, instala el paquete con pip install ultralytics y copia allí el directorio yolo26n_rknn_model/; las versiones protobuf y numpy de la guía de inicio rápido solo son necesarias para la exportación. Después, YOLO("yolo26n_rknn_model") ejecuta el modelo en la NPU con el paquete de Python rknn-toolkit-lite2, que Ultralytics instala en el primer uso junto con onnxruntime cuando el directorio contiene un tail.onnx. El dispositivo necesita Python 3.12 o anterior, la versión más reciente para la que rknn-toolkit-lite2 tiene compilaciones.
- Se necesita un dispositivo Rockchip: Ultralytics solo carga un modelo RKNN en sistemas Linux ARM de 64 bits cuyo campo
compatibledel árbol de dispositivos termine con uno de los nombres de chip compatibles. En cualquier otro entorno, la carga falla; consulta Limitaciones y solución de problemas.rknn-toolkit-lite2también tiene compilaciones solo para Linux ARM de 64 bits, así que, en un destino que no cumpla estas condiciones, ejecuta el archivo.rknncon la API C de Rockchip y ejecutatail.onnxo implementa la misma decodificación en tu propio código. - Chip correspondiente: exporta con el valor
namedel chip de tu placa. - Forma de entrada fija: el modelo siempre se ejecuta con los valores
imgszybatchde la exportación, que Ultralytics lee demetadata.yaml. Se ignora unimgszpasado apredictoval. Los lotes más grandes se dividen en bloques del tamaño de lote de exportación y los más pequeños se rellenan, así que se admite cualquier número de imágenes. device: no hay ningún dispositivo que seleccionar. El modelo.rknnse ejecuta mediante el tiempo de ejecución RKNN, ytail.onnxse ejecuta con ONNX Runtime en la CPU.
Una versión anterior de este flujo de trabajo se probó en una Radxa Rock 5B (RK3588) y una Radxa Zero 3W (RK3566). La exportación INT8 actual aún no se ha ejecutado en hardware.
Guías de despliegue#
- Configuración de la placa: instala primero un sistema operativo, tal como se describe en las guías de inicio de Radxa Rock 5B y Radxa Zero 3W.
- RKNN Toolkit2 en GitHub: el toolkit de conversión, el tiempo de ejecución RKNN Toolkit Lite2 y la biblioteca de tiempo de ejecución
librknnrt.socon su API C. - RKNN Model Zoo: ejemplos de despliegue de Rockchip en C y Python.
- Despliega Ultralytics YOLO en Rockchip: una descripción general del flujo de trabajo en el blog de Ultralytics.
- Opciones de despliegue de modelos: compara RKNN con los demás formatos de exportación.
Limitaciones y solución de problemas#
-
Equipo anfitrión de exportación: exporta en una máquina Linux x86-64. En macOS, la exportación no puede instalar
rknn-toolkit2y falla conNo module named 'rknn'; el paquete no tiene compilaciones para macOS ni Windows. La exportación en Linux ARM64, incluidas las placas Rockchip, no se ha probado y no es compatible: Ultralytics solo prueba la exportación RKNN en Linux x86-64. -
Versión de Python:
rknn-toolkit22.3.2 tiene compilaciones para Python 3.12 y anteriores. Si utilizas una versión más reciente de Python, crea el entorno con Python 3.12. -
Primera exportación en un entorno nuevo: en un entorno sin las versiones
protobufynumpyde la guía de inicio rápido, la primera exportación sustituye estos paquetes durante la ejecución y falla. Si sustituyeprotobuf7, que pip instala junto cononnx, el error esAttributeError: 'google._upb._message.FieldDescriptor' object has no attribute 'label'; si solo sustituyenumpy, el error esTypeError: only 0-dimensional arrays can be converted to Python scalars. Vuelve a ejecutar la exportación en un proceso nuevo (reinicia el kernel si utilizas un cuaderno) o instala"protobuf<7" "numpy<2.4"antes de la primera exportación, como se indica en la guía de inicio rápido. -
Los modelos RKNN no se ejecutan en un PC: predecir o validar con
YOLO("yolo26n_rknn_model")falla conRKNN inference is only supported on Rockchip devices.en un PC y en una placa cuyo campo/proc/device-tree/compatibleno termine con uno de los nombres de chip compatibles. Muéstralo concat /proc/device-tree/compatible. -
FP32:
quantize=32falla conquantize=32 (FP32) is not supported; format='rknn' supports quantize=16 (FP16), 8 (INT8). -
Chips que solo admiten INT8: para
rv1103,rv1106,rv1103byrv1106b, una exportación sinquantizeregistraRockchip target 'rv1106' requires INT8 quantization, enabling it.y genera un modelo INT8, mientras quequantize=16falla conRockchip target 'rv1106' only supports INT8, but got quantize=16. -
Falta
nameo no es válido: si no se especificaname, la exportación registraRockchip RKNN export requires a missing 'name' arg for processor type. Using default name='rk3588'.. Un valor desconocido falla conInvalid processor name 'rk9999' for Rockchip RKNN export., seguido de los nombres válidos. -
Cabeza sin NMS: los modelos RKNN siempre devuelven predicciones sin procesar que requieren NMS. Con
nms=False, la exportación de un modelo YOLO26 o YOLOv10 registraThis export format does not support end2end models, disabling the end2end branch.y utiliza la cabeza uno a muchos; para otros modelos de detección, segmentación, pose y OBB, como YOLO11, registraThis model has no one-to-one head; using one-to-many outputs.. Los modelos de clasificación, segmentación semántica y profundidad ignorannms=False. -
NMS integrada:
nms=Trueregistraformat=rknn does not support embedded NMS; exporting native outputs for external NMS.y escribe la salida sin procesar. -
Puntos de control entrenados con
quantize=8: un punto de control ajustado mediante entrenamiento con cuantización consciente falla conformat='rknn' cannot export a QAT model: its Q/DQ ranges are only read by the 'onnx' and 'engine' backends. En su lugar, exporta conquantize=8el punto de control del que partiste para el ajuste fino. -
RT-DETR: con
rknn-toolkit22.3.2, la exportación de un modelo RT-DETR falla dentro del toolkit tanto en FP16 como en INT8, parartdetr-l.ptenimgsz=640conValueError: operands could not be broadcast together with shapes (256,256) (8400,1). -
Forma de entrada fija:
dynamic=Truefalla conargument 'dynamic' is not supported for format='rknn'. Vuelve a exportar para cambiar el tamaño de imagen o el tamaño de lote. -
Calibración sin
data: una exportaciónquantize=8de un modelo de detección registraINT8 export requires a missing 'data' arg for calibration. Using default 'data=coco8.yaml'.y calibra con ese pequeño conjunto de datos; las demás tareas indican su propio conjunto de datos predeterminado. Pasadatacon imágenes que representen los datos de despliegue. -
Tamaño de calibración: la exportación registra
>300 images recommended for INT8 calibration, found 4 images.cuando la partición de calibración contiene menos de 300 imágenes.coco8.yamlsolo tiene 4 imágenes de validación, suficientes para probar la exportación, pero no para calibrar un modelo para su despliegue. -
Directorio de salida: cada exportación de un punto de control escribe el mismo directorio
yolo26n_rknn_model/, independientemente de sus valoresname,quantize,imgszobatch, y elimina primero el contenido anterior. Cambia el nombre del directorio antes de exportar para un segundo chip o una segunda precisión, e incluye_rknn_modelen el nombre, por ejemployolo26n_rk3566_rknn_model/, porque Ultralytics reconoce el formato por ese nombre. -
opset de ONNX: un
opsetsuperior a 19 registrarknn-toolkit2 requires opset<=19, setting opset=19. -
Modelos INT8 de versiones anteriores: vuelve a exportar los modelos de detección, segmentación, pose y OBB en INT8 que se exportaron antes de
ultralytics8.4.191, la versión que añadiótail.onnx. Esos modelos devuelven las coordenadas de las cajas y los puntos clave relativas al tamaño de entrada; las versiones actuales ya no las reescalan, por lo que los modelos se cargan sin errores, pero devuelven cajas incorrectas. -
Incompatibilidad de versiones del entorno de ejecución: si el registro del dispositivo indica que la versión del entorno de ejecución de RKNN no coincide con la versión de RKNN Toolkit y falla la inferencia, sustituye
/usr/lib/librknnrt.sopor el archivo oficiallibrknnrt.so.
Para otros errores, consulta la guía de problemas habituales.
Pruebas de rendimiento#
El equipo de Ultralytics ejecutó los siguientes benchmarks de YOLO26 en una Radxa Rock 5B basada en Rockchip RK3588, con el formato de modelo rknn, para medir la velocidad y la precisión.
| Modelo | Formato | Precisión | Estado | Tamaño (MB) | mAP50-95(B) | Tiempo de inferencia (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n | rknn | FP16 | ✅ | 7.2 | 0.477 | 58.5 |
| YOLO26n | rknn | INT8 | ✅ | 4.1 | 0.463 | 41.2 |
| YOLO26s | rknn | FP16 | ✅ | 21.0 | 0.569 | 93.8 |
| YOLO26s | rknn | INT8 | ✅ | 12.0 | 0.554 | 61.9 |
| YOLO26m | rknn | FP16 | ✅ | 43.0 | 0.608 | 226.3 |
| YOLO26m | rknn | INT8 | ✅ | 22.0 | 0.603 | 122.0 |
| YOLO26l | rknn | FP16 | ✅ | 53.0 | 0.628 | 264.7 |
| YOLO26l | rknn | INT8 | ✅ | 28.0 | 0.617 | 145.3 |
| YOLO26x | rknn | FP16 | ✅ | 113.0 | 0.664 | 655.4 |
| YOLO26x | rknn | INT8 | ✅ | 58.0 | 0.649 | 287.4 |
Evaluado con ultralytics 8.4.60
La validación de los benchmarks anteriores se realizó con el conjunto de datos COCO128. El tiempo de inferencia no incluye el preprocesamiento ni el posprocesamiento. Las filas INT8 se actualizarán cuando se valide en hardware Rockchip la ruta de exportación INT8 actual (decodificación en el host y auto_hybrid).
Los tamaños de la tabla se registraron con esa versión anterior; los tamaños que aparecen en el resto de esta página corresponden al archivo .rknn de una exportación actual, en MB (10^6 bytes). La página de modelos YOLO26 muestra la precisión de los puntos de control de PyTorch en el conjunto de validación completo de COCO.
Acerca de RKNN#
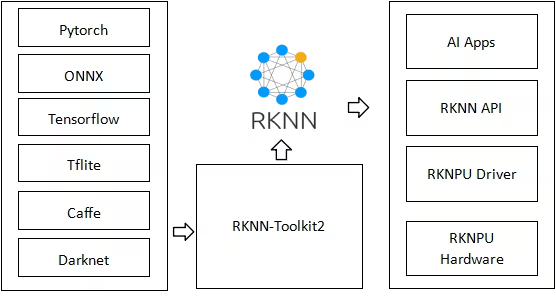
Rockchip diseña sistemas en chip basados en ARM con NPU integradas, que se utilizan en ordenadores de placa única y productos integrados de empresas como Radxa, ASUS, Pine64, Orange Pi, Odroid, Khadas y Banana Pi. RKNN, abreviatura de Rockchip Neural Network, es el formato de modelo de esas NPU, y el RKNN Toolkit convierte los modelos a ese formato en un PC y los ejecuta en el dispositivo.
Preguntas frecuentes#
Usa el nombre del procesador de la placa, no el nombre de la placa:
rk3588para una Radxa Rock 5B, por ejemplo, ork3566para una Radxa Zero 3W. En la placa,cat /proc/device-tree/compatiblemuestra la cadena que Ultralytics utiliza para identificar el chip. Un modelo exportado para un chip no sirve para otro, así que exporta uno para cada chip. Consulta Chips de destino para ver los nombres admitidos.Empieza con FP16, que es la opción predeterminada. No necesita datos de calibración y devuelve sus predicciones sin procesar sin ejecutar un segundo modelo en la CPU. Elige INT8 (
quantize=8) si necesitas un modelo más pequeño y rápido o si el chip solo admite INT8: YOLO26n para el RK3588 ocupa 4.3 MB en INT8 frente a 7.4 MB en FP16, y en las pruebas de rendimiento, realizadas con una exportación anterior, INT8 ejecutó YOLO26n en 41.2 ms por imagen, frente a 58.5 ms en FP16. INT8 necesita datos de calibración representativos y, en los modelos de detección, segmentación, pose y OBB, ejecuta la decodificación de cajas en la CPU contail.onnx. Mide la latencia y la precisión en tu dispositivo antes de decidir.No con
YOLO(), que solo carga modelos RKNN en dispositivos Rockchip. Para comprobar el propio modelo en el PC, valida el punto de control de PyTorch o el archivo intermedioyolo26n.onnxque la exportación deja junto al directorio, con ONNX Runtime: el modelo RKNN se convierte a partir de ese grafo. Esto no sustituye la validación en el dispositivo, especialmente en INT8, porque la cuantización cambia las salidas.Sí, con el formato de exportación de cada acelerador: un modelo RKNN solo se ejecuta en NPU de Rockchip. Consulta TensorRT para NVIDIA Jetson, Hailo, Axelera, DeepX y Coral Edge TPU, o la guía de opciones de implementación de modelos para obtener una visión general.


Comentarios45
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
as-jackson
We are pleased to confirm that the following ArmSoM boards based on Rockchip RK3576 have been successfully tested with Ultralytics projects (e.g., YOLO11n):
Validation Scope:
Model training/inference pipeline
1yizi72
I tried to convert the yolo11n.pt into a rknn model through codes below: from ultralytics import YOLO model = YOLO("yolo11n.pt") model.export(format="rknn", name="rk3588") and everything went correct. A rknn model named yolo11n-rk3588.rknn was build and used to infer a very traditional yolo demo image "bus"(a blue bus with several people in front of it), but no detection result was obtained.
I tried to convert the yolol11n.pt into onnx model through above codes firstly, and then used a convert.py offered by rknn_model_zoo/examples/yolo11/python,
import sys from rknn.api import RKNN
DATASET_PATH = '../../../datasets/COCO/coco_subset_20.txt' DEFAULT_RKNN_PATH = '/home/yizi/model/yolo11/yolodet.rknn' DEFAULT_QUANT = False
def parse_arg(): if len(sys.argv) < 3: print("Usage: python3 {} onnx_model_path [platform] [dtype(optional)] [output_rknn_path(optional)]".format(sys.argv[0])) print(" platform choose from [rk3562,rk3566,rk3568,rk3588,rk3576,rk1808,rv1109,rv1126]") print(" dtype choose from [i8, fp] for [rk3562,rk3566,rk3568,rk3588,rk3576]") print(" dtype choose from [u8, fp] for [rk1808,rv1109,rv1126]") exit(1)
model_path = sys.argv[1]
platform = sys.argv[2]

do_quant = DEFAULT_QUANT
if len(sys.argv) > 3:
    model_type = sys.argv[3]
    if model_type not in ['i8', 'u8', 'fp']:
        print("ERROR: Invalid model type: {}".format(model_type))
        exit(1)
    elif model_type in ['i8', 'u8']:
        do_quant = True
    else:
        do_quant = False

if len(sys.argv) > 4:
    output_path = sys.argv[4]
else:
    output_path = DEFAULT_RKNN_PATH

return model_path, platform, do_quant, output_path
if name == 'main': model_path, platform, do_quant, output_path = parse_arg()
# Create RKNN object
rknn = RKNN(verbose=False)

# Pre-process config
print('--> Config model')
rknn.config(mean_values=[[0, 0, 0]], std_values=[[255, 255, 255]], target_platform=platform)
print('done')

# Load model
print('--> Loading model')
ret = rknn.load_onnx(model=model_path)
if ret != 0:
    print('Load model failed!')
    exit(ret)
print('done')

# Build model
print('--> Building model')
ret = rknn.build(do_quantization=do_quant, dataset=DATASET_PATH)
if ret != 0:
    print('Build model failed!')
    exit(ret)
print('done')

# Export rknn model
print('--> Export rknn model')
ret = rknn.export_rknn(output_path)
if ret != 0:
    print('Export rknn model failed!')
    exit(ret)
print('done')

# Release
rknn.release()
Still everything went correct. A rknn model was created and applied to "bus.jpg", and there was no detection at all. I wonder what's wrong in the whole process?
1 Glenn JocherUltralytics
@yizi72 thanks for the detailed report. For RKNN inference issues with YOLO11, please ensure:
- You're using matching RKNN Toolkit and runtime versions (update both if needed)
- Input images are 640x640 with pixel values normalized 0-255
- You load models via
YOLO('./yolo11n_rknn_model')as shown in our RKNN deployment docs
If issues persist, please share your full environment details and validation results from both export methods.
1、I used rknn-toolkit2-2.3.0 which is the latest version ,bu I still did "pip install rknn-toolkit2 --upgrade" again. 2、The input image is 640*640, uchar, 0-255. 3. I used the following setting to transfer yolo11n.pt to onnx, from ultralytics import YOLO
加载一个模型,路径为 YOLO 模型的 .pt 文件
model = YOLO("yolo11n.pt")
导出模型,设置多种参数
model.export( format="onnx", imgsz=(640, 640),
keras=False,
optimize=True,
half=False,
int8=False,
dynamic=False,
simplify=True,
opset=12,
#workspace=4.0,
nms=False,
batch=1
) and applied the following codes to verify yolo11n.onnx model:from ultralytics import YOLO from PIL import Image
Load a model
model = YOLO("/home/yizi/models/yolo11/yolo11n.onnx") # load an official model
Predict with the model
results = model("bus.jpg") # predict on an image #results = rknn_model("bus.jpg")
Access the results
for result in results: xywh = result.boxes.xywh # center-x, center-y, width, height xywhn = result.boxes.xywhn # normalized xyxy = result.boxes.xyxy # top-left-x, top-left-y, bottom-right-x, bottom-right-y xyxyn = result.boxes.xyxyn # normalized names = [result.names[cls.item()] for cls in result.boxes.cls.int()] # class name of each box confs = result.boxes.conf # confidence score of each box
The results are good. All objects in bus.jpg were detected. Then I run the following code to transfer onnx to rknn:
from rknn.api import RKNN import cv2 import numpy as np
if name == 'main': rknn = RKNN(verbose=True,verbose_file="log.txt") rknn.config( mean_values=[[0, 0, 0]], std_values=[[255, 255, 255]], target_platform="rk3588", optimization_level=3 )
rknn.load_onnx(
    model="/home/yizi/models/yolo11/yolo11n.onnx",
    input_size_list=[[1,3,640,640]],
)
rknn.build(
    do_quantization=False
)

rknn.export_rknn(
    export_path="/home/yizi/models/yolo11/yolo11n.rknn"
)

rknn.release()
The transferring process went smooth, two problems appeared.
Firstly,when this rknn model was pushed into a rk3588 tablet, and run with a binary executable file generated by cross-compilation, no result was detected.
Secondly, I tried to run the following codes:
from ultralytics import YOLO from PIL import Image
rknn_model = YOLO("/home/yizi/models/yolo11/yolo11n.rknn", task=detect)
results = model("bus.jpg")
An error message, "model='/home/yizi/models/yolo11/yolo11n.rknn' is not a supported model format. Ultralytics supports: ('PyTorch', 'TorchScript', 'ONNX', 'OpenVINO', 'TensorRT', 'CoreML', 'TensorFlow SavedModel', 'TensorFlow GraphDef', 'TensorFlow Lite', 'TensorFlow Edge TPU', 'TensorFlow.js', 'PaddlePaddle', 'MNN', 'NCNN', 'IMX', 'RKNN') See https://docs.ultralytics.com/modes/predict for help. " appeared.
Last question, how many outputs does yolo11 yield? one or six?
- Glenn JocherUltralytics
@yizi72 thank you for the detailed report. For RKNN deployment issues:
- When using Ultralytics RKNN export, load models via the exported directory (not .rknn file), as shown in our RKNN deployment docs:
model = YOLO('./yolo11n_rknn_model') # directory path-
Ensure your RK3588 runtime uses matching librknnrt.so versions with your RKNN Toolkit 2.3.0 installation
-
YOLO11 detection models output 3 tensors by default (different from older YOLO versions). For conversion issues, we recommend using our native
model.export(format='rknn')rather than manual ONNX conversion.
Let me know if you still face issues after verifying these points.
Thanks for replies. I did verify all points you've mentioned above. When running model("bus.jpg"), error messages show:
File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/ultralytics/engine/model.py", line 182, in call return self.predict(source, stream, **kwargs) File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/ultralytics/engine/model.py", line 543, in predict self.predictor.setup_model(model=self.model, verbose=is_cli) File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/ultralytics/engine/predictor.py", line 378, in setup_model self.model = AutoBackend( File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/torch/utils/_contextlib.py", line 116, in decorate_context return func(*args, **kwargs) File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/ultralytics/nn/autobackend.py", line 495, in init raise OSError("RKNN inference is only supported on Rockchip devices.") OSError: RKNN inference is only supported on Rockchip devices.
It's very strange because I did connect a RK3588 tablet with my virtual machine.
I still have a quesiton on yolo11n output: yolo11n.pt has one output with shape (1, 84, 8400), and yolo11n-rk3588.rknn has one output with shape (1,84, 8400, 0). Are they correct? If so, can I use the similar codes to analyze rknn output, such as :
for result in results: xywh = result.boxes.xywh # center-x, center-y, width, height xywhn = result.boxes.xywhn # normalized xyxy = result.boxes.xyxy # top-left-x, top-left-y, bottom-right-x, bottom-right-y xyxyn = result.boxes.xyxyn # normalized names = [result.names[cls.item()] for cls in result.boxes.cls.int()] # class name of each box confs = result.boxes.conf
- Glenn JocherUltralytics
@yizi72 thanks for the details. For the RKNN inference error: ensure your Python script is running directly on the RK3588 hardware (not through a VM) as RKNN models require native Rockchip NPU access. Regarding outputs, YOLO11 detection models produce 3 output tensors by default (see our RKNN deployment docs), but your code should work if using the exported RKNN directory with the included postprocessing. Let me know if you still face issues after verifying native hardware execution.
 Yufeng Wu
Hello, Ultralytics team. I wonder if it's possible to port yolo26n-pose to rknn? I'm not sure if it's difficult to work out on my own? Is there any model architecture problems that prevent porting the pose models to rknn?
- Glenn JocherUltralytics
@kamosmkey exports fine. See https://platform.ultralytics.com/glenn-jocher/example-project/exp-24?tab=export
2
montemadjo
It appears it does not support rv1106 platform yet
When I try to export the model using this command
model.export(format="rknn", name="rv1106", imgsz=320)It gives the following error
E build: Current target_platform(rv1106) not support do_quantization = False!
E export_rknn: RKNN model does not exist, please load & build model first!
🤔
- Glenn JocherUltralytics(editado)
rv1106is an INT8-only target, so it needs a quantized RKNN build. Older Ultralytics releases always built withdo_quantization=False, which fails with the message you saw. Current releases support it: upgrade withpip install -U ultralyticsand export withquantize=8plus calibration data:model.export(format="rknn", name="rv1106", imgsz=320, quantize=8, data="coco8.yaml")See the Rockchip RKNN export guide. If it still fails, share your
!yolo checksoutput andrknn-toolkit2version here and we can sanity-check the environment.1 Here's the quick workaround for those who want to work with yolo26 on RV1106 chip (like Luckfox pico etc). I ran into a couple of issues there, including quantization erasing my confidence results.
Long story short - first you need to monkey-patch head.Detect.forward function in order to get two tensors - one for bboxes and one for scores. That way you escape all the heavy non-supported tensor functions. Then you export your yolo26 model to onnx format and finally to rknn like this
import torch
from ultralytics.nn.modules import head

# 1. First we monkey-patch the forward function
def patched_forward(self, x):
    if self.end2end:
        h = self.one2one
    else:
        h = self.one2many

    box_head = h["box_head"]
    cls_head = h["cls_head"]

    if box_head is None or cls_head is None:
        raise RuntimeError("Head moduls are None")

    bs = x[0].shape[0]
    boxes = torch.cat([box_head[i](x[i]).view(bs, 4 * self.reg_max, -1) for i in range(self.nl)], dim=-1)
    scores = torch.cat([cls_head[i](x[i]).view(bs, self.nc, -1) for i in range(self.nl)], dim=-1)

    preds = {"boxes": boxes, "scores": scores, "feats": x}
    y = self._inference(preds)

    # We are splitting into 2 tensors - both gets its own scale/zp at INT8 quantization
    bboxes = y[:, :4, :]   # [1, 4, 2100] — range 0-640
    scores = y[:, 4:, :]   # [1, 1, 2100] — range 0-1 (already sigmoid-ed)
    score_max_idx = scores[0, 0, :].argmax()
    return bboxes, scores

head.Detect.forward = patched_forward

# 2. Then we export to onnx model (we got best.pt model from ultralytics platform)
from ultralytics import YOLO
model = YOLO("best.pt")
model.export(format="onnx", dynamic=False, opset=12, imgsz=320)

# 3. Then we export to RKNN format
from rknn.api import RKNN

rknn = RKNN()

# 3.1. Konfiguracija specifična za RV1106
rknn.config(
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
    target_platform='rv1106',
    quantized_algorithm='normal', # Ili 'mmse' za bolju preciznost
    quantized_dtype='asymmetric_quantized-8'
)

# 3.2. Load the ONNX model
print("Loading ONNX model...")
rknn.load_onnx(model='best.onnx')

# 3.3. Build modela sa INT8 kvantizacijom
# calib.txt should contain paths to calibration images
print("Building RKNN model with quantization...")
rknn.build(do_quantization=True, dataset='./calib.txt')

# 3.4. Exporting final .rknn file
print("Exporting RKNN model...")
rknn.export_rknn('./yolo26_rv1106_model_optimized.rknn')

rknn.release()
After this you need to postprocess those two outputs like this
yolo26_postprocess.h
/**
 * YOLO26 Post-processing header for Fish Counter
 *
 * Supports YOLO26 2-output format: boxes [1, 4, N] + scores [1, nc, N]
 *
 * Based on the working rknn_minimal_test example.
 */

#ifndef _YOLO26_POSTPROCESS_H_
#define _YOLO26_POSTPROCESS_H_

#include <stdint.h>
#include <vector>
#include "rknn_api.h"
#include "rknn_detector.h"

// YOLO26 model configuration defaults
#define YOLO26_CONF_THRESHOLD 0.25f
#define YOLO26_NMS_THRESHOLD 0.45f

// Detection result (same structure as postprocess.h for compatibility)
typedef struct
{
    float x1, y1, x2, y2; // Bounding box (in model coordinates)
    float confidence;
    int class_id;
} yolo26_detection_t;

// YOLO26 context for format detection and caching
typedef struct
{
    int num_predictions;
    int num_classes;
    bool boxes_transposed; // true = [1, 4, N], false = [1, N, 4]
} yolo26_context_t;

/**
 * Initialize YOLO26 post-processing
 * Detects the output format from model attributes
 *
 * @param app_ctx The RKNN app context with model info
 * @param yolo26_ctx Output: YOLO26 context for format info
 * @return 0 on success, -1 on error
 */
int yolo26_init_postprocess(rknn_app_context_t *app_ctx, yolo26_context_t *yolo26_ctx);

/**
 * Deinitialize YOLO26 post-processing
 */
void yolo26_deinit_postprocess();

/**
 * YOLO26 post_process: processes model outputs and returns detections
 * Uses 2-output format: boxes [1, 4, N] + scores [1, nc, N]
 *
 * @param app_ctx The RKNN app context
 * @param yolo26_ctx YOLO26 context from init
 * @param outputs Pointer to output tensor memory array
 * @param letter_box Letterbox transform info for coordinate mapping
 * @param conf_threshold Confidence threshold
 * @param nms_threshold NMS threshold
 * @param od_results Output: detection results (compatible with existing code)
 * @return 0 on success, -1 on error
 */
int yolo26_post_process(rknn_app_context_t *app_ctx, yolo26_context_t *yolo26_ctx,
                        void *outputs, letterbox_t *letter_box,
                        float conf_threshold, float nms_threshold,
                        object_detect_result_list *od_results);

#endif // _YOLO26_POSTPROCESS_H_
yolo26_postprocess.cc
/**
 * YOLO26 Post-processing for Fish Counter on RV1106
 *
 * Supports YOLO26 2-output format: boxes [1, 4, N] + scores [1, nc, N]
 *
 * Based on the working rknn_minimal_test example.
 */

#include "yolo26_postprocess.h"

#include <math.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <algorithm>
#include <vector>

// Clamp value to range
inline static int clamp(float val, int min, int max)
{
    return val > min ? (val < max ? val : max) : min;
}

// Dequantize INT8 to float
static inline float dequantize(int8_t qnt, int32_t zp, float scale)
{
    return ((float)qnt - (float)zp) * scale;
}

// Sigmoid function
static inline float sigmoid(float x)
{
    return 1.0f / (1.0f + expf(-x));
}

// Calculate IoU between two boxes
static float calculate_iou(float x1_a, float y1_a, float x2_a, float y2_a,
                           float x1_b, float y1_b, float x2_b, float y2_b)
{
    float x1 = std::max(x1_a, x1_b);
    float y1 = std::max(y1_a, y1_b);
    float x2 = std::min(x2_a, x2_b);
    float y2 = std::min(y2_a, y2_b);

    float inter_w = std::max(0.0f, x2 - x1);
    float inter_h = std::max(0.0f, y2 - y1);
    float inter_area = inter_w * inter_h;

    float area_a = (x2_a - x1_a) * (y2_a - y1_a);
    float area_b = (x2_b - x1_b) * (y2_b - y1_b);
    float union_area = area_a + area_b - inter_area;

    return union_area > 0 ? inter_area / union_area : 0;
}

// Non-Maximum Suppression for YOLO26 detections
static std::vector<yolo26_detection_t> yolo26_nms(std::vector<yolo26_detection_t> &detections, float nms_threshold)
{
    // Sort by confidence (descending)
    std::sort(detections.begin(), detections.end(),
              [](const yolo26_detection_t &a, const yolo26_detection_t &b)
              { return a.confidence > b.confidence; });

    std::vector<yolo26_detection_t> result;
    std::vector<bool> suppressed(detections.size(), false);

    for (size_t i = 0; i < detections.size(); i++)
    {
        if (suppressed[i])
            continue;

        result.push_back(detections[i]);

        for (size_t j = i + 1; j < detections.size(); j++)
        {
            if (suppressed[j])
                continue;

            // Only suppress same class
            if (detections[i].class_id != detections[j].class_id)
                continue;

            float iou = calculate_iou(
                detections[i].x1, detections[i].y1, detections[i].x2, detections[i].y2,
                detections[j].x1, detections[j].y1, detections[j].x2, detections[j].y2);

            if (iou > nms_threshold)
            {
                suppressed[j] = true;
            }
        }
    }

    return result;
}

// Parse YOLO26 2-output format: boxes [1, 4, N] + scores [1, nc, N]
static std::vector<yolo26_detection_t> parse_yolo26_2output(
    rknn_tensor_mem **output_mems,
    rknn_tensor_attr *output_attrs,
    int model_width, int model_height,
    float conf_threshold, int num_classes,
    bool boxes_transposed)
{
    std::vector<yolo26_detection_t> detections;

    int8_t *boxes_data = (int8_t *)output_mems[0]->virt_addr;
    int32_t boxes_zp = output_attrs[0].zp;
    float boxes_scale = output_attrs[0].scale;

    int8_t *scores_data = (int8_t *)output_mems[1]->virt_addr;
    int32_t scores_zp = output_attrs[1].zp;
    float scores_scale = output_attrs[1].scale;

    // Determine number of anchors
    int num_anchors;
    if (boxes_transposed)
    {
        num_anchors = output_attrs[0].dims[2];
    }
    else
    {
        num_anchors = output_attrs[0].dims[1];
    }

    // Check if scores are already sigmoid or logits
    float scores_min = 9999, scores_max = -9999;
    for (int i = 0; i < (int)output_attrs[1].n_elems; i++)
    {
        float val = dequantize(scores_data[i], scores_zp, scores_scale);
        if (val < scores_min)
            scores_min = val;
        if (val > scores_max)
            scores_max = val;
    }
    bool scores_are_sigmoid = (scores_min >= -0.1f && scores_max <= 1.1f);

    for (int i = 0; i < num_anchors; i++)
    {
        // Get box coordinates
        float x1, y1, x2, y2;
        if (boxes_transposed)
        {
            // [1, 4, N] - channel first
            x1 = dequantize(boxes_data[0 * num_anchors + i], boxes_zp, boxes_scale);
            y1 = dequantize(boxes_data[1 * num_anchors + i], boxes_zp, boxes_scale);
            x2 = dequantize(boxes_data[2 * num_anchors + i], boxes_zp, boxes_scale);
            y2 = dequantize(boxes_data[3 * num_anchors + i], boxes_zp, boxes_scale);
        }
        else
        {
            // [1, N, 4] - anchor first
            x1 = dequantize(boxes_data[i * 4 + 0], boxes_zp, boxes_scale);
            y1 = dequantize(boxes_data[i * 4 + 1], boxes_zp, boxes_scale);
            x2 = dequantize(boxes_data[i * 4 + 2], boxes_zp, boxes_scale);
            y2 = dequantize(boxes_data[i * 4 + 3], boxes_zp, boxes_scale);
        }

        // Check if format is xywh instead of xyxy
        if (x2 < x1 || y2 < y1)
        {
            // Assume xywh format: convert to xyxy
            float cx = x1, cy = y1, w = x2, h = y2;
            x1 = cx - w / 2.0f;
            y1 = cy - h / 2.0f;
            x2 = cx + w / 2.0f;
            y2 = cy + h / 2.0f;
        }

        // Find max class score
        float max_score = -9999;
        int max_class = 0;
        for (int c = 0; c < num_classes; c++)
        {
            float score;
            if (boxes_transposed)
            {
                // [1, nc, N]
                score = dequantize(scores_data[c * num_anchors + i], scores_zp, scores_scale);
            }
            else
            {
                // [1, N, nc]
                score = dequantize(scores_data[i * num_classes + c], scores_zp, scores_scale);
            }

            if (!scores_are_sigmoid)
            {
                score = sigmoid(score);
            }

            if (score > max_score)
            {
                max_score = score;
                max_class = c;
            }
        }

        if (max_score < conf_threshold)
            continue;

        // Clamp to model bounds
        x1 = std::max(0.0f, std::min(x1, (float)model_width));
        y1 = std::max(0.0f, std::min(y1, (float)model_height));
        x2 = std::max(0.0f, std::min(x2, (float)model_width));
        y2 = std::max(0.0f, std::min(y2, (float)model_height));

        // Skip invalid boxes
        if (x2 <= x1 || y2 <= y1)
            continue;

        yolo26_detection_t det;
        det.x1 = x1;
        det.y1 = y1;
        det.x2 = x2;
        det.y2 = y2;
        det.confidence = max_score;
        det.class_id = max_class;

        detections.push_back(det);
    }

    return detections;
}

int yolo26_init_postprocess(rknn_app_context_t *app_ctx, yolo26_context_t *yolo26_ctx)
{
    if (!app_ctx || !yolo26_ctx)
    {
        printf("[YOLO26] ERROR: Invalid parameters\n");
        return -1;
    }

    memset(yolo26_ctx, 0, sizeof(yolo26_context_t));

    int n_output = app_ctx->io_num.n_output;

    printf("[YOLO26] Initializing 2-output format (%d outputs)...\n", n_output);

    // Print output tensor info
    for (int i = 0; i < n_output; i++)
    {
        printf("  Output %d: dims=[%d,%d,%d,%d], size=%d\n", i,
               app_ctx->output_attrs[i].dims[0],
               app_ctx->output_attrs[i].dims[1],
               app_ctx->output_attrs[i].dims[2],
               app_ctx->output_attrs[i].dims[3],
               app_ctx->output_attrs[i].size);
    }

    if (n_output != 2)
    {
        printf("[YOLO26] ERROR: Expected 2 outputs (boxes + scores), got %d\n", n_output);
        return -1;
    }

    // Parse 2-output format: boxes + scores
    int boxes_dim1 = app_ctx->output_attrs[0].dims[1];
    int boxes_dim2 = app_ctx->output_attrs[0].dims[2];
    int scores_dim1 = app_ctx->output_attrs[1].dims[1];
    int scores_dim2 = app_ctx->output_attrs[1].dims[2];

    if (boxes_dim1 == 4)
    {
        // [1, 4, N] boxes format
        yolo26_ctx->num_predictions = boxes_dim2;
        yolo26_ctx->boxes_transposed = true;
        yolo26_ctx->num_classes = scores_dim1;
        printf("[YOLO26] Format: boxes [1,4,%d], scores [1,%d,%d]\n",
               boxes_dim2, scores_dim1, scores_dim2);
    }
    else if (boxes_dim2 == 4)
    {
        // [1, N, 4] boxes format
        yolo26_ctx->num_predictions = boxes_dim1;
        yolo26_ctx->boxes_transposed = false;
        yolo26_ctx->num_classes = scores_dim2;
        printf("[YOLO26] Format: boxes [1,%d,4], scores [1,%d,%d]\n",
               boxes_dim1, scores_dim1, scores_dim2);
    }
    else
    {
        printf("[YOLO26] ERROR: Invalid boxes dimensions [1,%d,%d], expected [1,4,N] or [1,N,4]\n",
               boxes_dim1, boxes_dim2);
        return -1;
    }

    printf("[YOLO26] Predictions: %d, Classes: %d\n",
           yolo26_ctx->num_predictions, yolo26_ctx->num_classes);

    return 0;
}

void yolo26_deinit_postprocess()
{
    // Nothing to cleanup currently
}

int yolo26_post_process(rknn_app_context_t *app_ctx, yolo26_context_t *yolo26_ctx,
                        void *outputs, letterbox_t *letter_box,
                        float conf_threshold, float nms_threshold,
                        object_detect_result_list *od_results)
{
    if (!app_ctx || !yolo26_ctx || !outputs || !letter_box || !od_results)
    {
        return -1;
    }

    rknn_tensor_mem **output_mems = (rknn_tensor_mem **)outputs;

    int model_width = app_ctx->model_width;
    int model_height = app_ctx->model_height;

    // Parse 2-output format
    std::vector<yolo26_detection_t> raw_detections = parse_yolo26_2output(
        output_mems,
        app_ctx->output_attrs,
        model_width, model_height,
        conf_threshold,
        yolo26_ctx->num_classes > 0 ? yolo26_ctx->num_classes : 1,
        yolo26_ctx->boxes_transposed);

    // Apply NMS
    std::vector<yolo26_detection_t> final_detections = yolo26_nms(raw_detections, nms_threshold);

    // Convert to output format with letterbox coordinate mapping
    memset(od_results, 0, sizeof(object_detect_result_list));
    int count = 0;

    for (const auto &det : final_detections)
    {
        if (count >= OBJ_NUMB_MAX_SIZE)
            break;

        // Map coordinates back to original image space
        float x1 = det.x1 - letter_box->x_pad;
        float y1 = det.y1 - letter_box->y_pad;
        float x2 = det.x2 - letter_box->x_pad;
        float y2 = det.y2 - letter_box->y_pad;

        // Scale back to original coordinates
        od_results->results[count].box.left = (int)(clamp(x1, 0, model_width) / letter_box->scale);
        od_results->results[count].box.top = (int)(clamp(y1, 0, model_height) / letter_box->scale);
        od_results->results[count].box.right = (int)(clamp(x2, 0, model_width) / letter_box->scale);
        od_results->results[count].box.bottom = (int)(clamp(y2, 0, model_height) / letter_box->scale);
        od_results->results[count].prop = det.confidence;
        od_results->results[count].cls_id = det.class_id;

        count++;
    }

    od_results->count = count;

    return 0;
}
And you're good to go! 🚀
- Glenn JocherUltralytics(editado)
Thanks for sharing this—splitting the head into 2 outputs (boxes + scores) is a sensible RV1106 workaround to keep RKNN-friendly ops and avoid INT8 scale/zero-point coupling issues; just note that monkey-patching
head.Detect.forwardis inherently version-fragile. Current Ultralytics already provides an INT8 flow for RV1106 viaquantize=8withdata=calibration images (see the Rockchip RKNN export guide), so please try that first. If you still need your custom split, open a GitHub issue linking back to this thread and include!yolo checks, yourrknn-toolkit2version, and a minimal calibration set description so we can evaluate it.
dttvn0010
99ms per image is too bad. Using rknn native with 3 npu cores, I can achieve ~11ms per image
NikolayKash
Hi, what did you done to achieve this performance?
- Glenn JocherUltralytics
@Arshapjoy thanks for the detailed info; for YOLO11 detection heads the export output shape is
(1, nc + 4, 8400)(4 box coords plusncclass scores), so with 2 classes(1, 6, 8400)is expected and both classes are present, whereas a postprocessor assuming5 + nc(old YOLO layout with an extra objectness channel) will effectively drop one class. I’d suggest updating your RKNN-side decoder to treat channels[0:4]as[x, y, w, h]and[4:]as class logits for allncclasses; if you still see a true(1, 7, 8400)PyTorch output on the same checkpoint, please share yourultralyticsversion andyolo checksoutput so we can dig deeper. The overall YOLO11 head behaviour is also outlined in the YOLO11 model documentation.@BakhtiariB the high-level
YOLO("./yolo11n_rknn_model")interface is designed to keep preprocessing, NPU inference and postprocessing together, so if you need to run only the core RKNN inference on the NPU while fully controlling pre/post on the CPU you’ll need to load the exported.rknnwith Rockchip’sRKNNAPI directly and implement your own preprocessing and YOLO11 postprocessing around it.@dttvn0010 the ~99 ms figure is a conservative end-to-end pipeline measurement on our RK3588 test setup, so seeing ~11 ms from a highly tuned RKNN deployment using all three NPU cores is quite reasonable; if you are open to sharing your exact model variant, quantization mode, input size and NPU core configuration, we can use that to cross-check and better explain the gap between baseline and fully optimized numbers.
@NikolayKash in practice, large gains like that usually come from combining INT8-quantized RKNN models, all three NPU cores enabled, a suitable input resolution and very lean Python-side pre/postprocessing, so it would be great if @dttvn0010 can share their exact script and RK3588 configuration for others to replicate.
guojieli
he YOLO11 benchmark was run by the Ultralytics team on a Radxa Rock 5B based on the Rockchip RK3588, using the RKNN model format to evaluate speed and accuracy. Could you please clarify whether this was an INT8-quantized model?
- Glenn JocherUltralytics(editado)
Those RKNN benchmarks were not INT8-quantized; they used the floating-point RKNN build. INT8 RKNN export is now available with
quantize=8anddata=for calibration; see the Rockchip RKNN export guide.
BakhtiariB
I used ultralytics for rk3588 by below code, but i want do inference in NPU and do preprocess and postprocess in CPU, how can separate them. while, in below code, line: "results = rknn_model("https://ultralytics.com/images/bus.jpg")" just all of them!
from ultralytics import YOLO
Load the exported RKNN model
rknn_model = YOLO("./yolo11n_rknn_model")
Run inference
results = rknn_model("https://ultralytics.com/images/bus.jpg")
Arshapjoy
Exported RKNN/ONNX model only has 1 output class instead of 2
Overview
I’m using Ultralytics YOLOv11s with two custom classes and exporting it to ONNX and RKNN formats. After conversion, inference on the RKNN device only detects a single class, and the output tensor shape is
(1, 6, 8400)instead of the expected(1, 7, 8400). I’ve validated that the source.ptmodel correctly reports 2 classes, but both ONNX and RKNN exports drop one class.
Model Details
- Checkpoint path:
path/to/yolo11s_custom.pt - Number of classes: 2
- Input size: 640×640
from ultralytics import YOLO
Load the YOLO11 model
model = YOLO("custom_yolo11s.pt")
Export the model to RKNN format
rknn_path = model.export(format="rknn", name="rk3588") print(f"RKNN model saved to: {rknn_path}")
Actual Behavior
- Received ONNX , RKNN and metadata.yaml after conversion
- Exported ONNX model output shape:
(1, 6, 8400) - Exported RKNN model output shape:
(1, 6, 8400) - Only one class is detected during inference on the RK3588 board.
7. Logs & Metadata
- metadata.yaml generated alongside the RKNN model:
model: name: yolo11s_custom format: rknn input_shape: [1, 3, 640, 640] output_shape: [1, 6, 8400] classes: 2 - ONNX graph info: Attached minimal
onnx.shape_inferencelog shows only 6 channels in the final layer.
8. Additional Notes
- Manual ONNX export yields the same issue, so it’s unlikely to be an Ultralytics export bug alone.
- I’ve confirmed that the PyTorch forward pass on the
.ptcheckpoint produces a shape(1, 7, 8400).
9. Request Could you please:
- Confirm whether there’s an option/flag in the YOLO-Ultralytics or RKNN export pipeline I’m missing to preserve all classes.
- Suggest any workarounds or patches to ensure correct output-channel dimensionality.
- Identify if this might be a known issue in RKNN-Toolkit 1.5.0 or Ultralytics YOLO v11.
Thank you for your assistance!
- Checkpoint path:
WeiIIzz
Hello, when I exported the rknn model, I performed int8 quantization, but I had an error like this: E build: If set do_quantization = True, dataset file need be provided. But it`s value is None! E export_rknn: RKNN model does not exist, please load build model first! My export code is: from ultralytics import YOLO
model = YOLO("/home/ky/dfxw/runs/detect/train3/weights/best.pt") model.export(format="rknn", name="rk3576", int8=True, data="/home/ky/rknn_yolo_test/data.yaml") The path pointed to by data is the same as the training dataset. How to solve it
The content of data.yaml is as follows path: /home/ky/dfxw/split_jiaqian # dataset root dir train: images/train val: images/val
names: 0: 0 1: 1
- Glenn JocherUltralytics(editado)
@WeiIIzz INT8 export for RKNN is supported with
quantize=8(it replaces the deprecatedint8=True) together withdatapointing to a dataset YAML, which Ultralytics converts into the calibration image list that RKNN needs:from ultralytics import YOLO model = YOLO("/home/ky/dfxw/runs/detect/train3/weights/best.pt") model.export(format="rknn", name="rk3576", quantize=8, data="/home/ky/rknn_yolo_test/data.yaml")The error you saw comes from an older version that did not pass a calibration dataset to RKNN, so run
pip install -U ultralyticsand retry. Make sure the YAML points to existing images. Let us know if this resolves your issue! @glenn-jocher I followed your steps to modify the code as follows. But I still encountered the same problem.
from ultralytics import YOLO

model = YOLO("/home/ky/dfxw/runs/detect/train3/weights/best.pt")
model.export(format="rknn", name="rk3576", int8=True, data="/home/ky/rknn_yolo_test/images")
Is there only images in the data path?
- Glenn JocherUltralytics(editado)
@WeiIIzz older releases ignored
int8=Truefor RKNN and built the model without quantization. Current Ultralytics supports INT8 RKNN export, so afterpip install -U ultralyticsyou can export with:model.export(format="rknn", name="rk3576", quantize=8, data="data.yaml")Here
datais used for the calibration images. Withoutquantize, the export builds a floating-point (FP16) model.
VictorAboba
Good day,
Is RKNN available for obb tasks? I tried to use it directly, but got an error saying that some operations (cos) are not available in RKNN. As a fix, RKNN suggested adding disable_rules = ['reduce_reshape_op_around_concat'] to my configuration. I actually did this inside the YOLO library. Model was exported first to ONNX and then from ONNX to RKNN works and returns the responses in the format (1,6,21504), which seems what I expected. However, if I use this model through YOLO ("path_to_rknn_model", task = 'obb'), will I still get the results in the standard YOLO format? I just don't want to prescribe pre - and post-processing on my own :)
Thank you!
- Glenn JocherUltralytics(editado)
@VictorAboba thank you for your question! RKNN export now supports all seven Ultralytics tasks, including OBB, so you can export OBB models directly with
format="rknn"and load the exported_rknn_modeldirectory withYOLO(...)to get standard YOLO results without writing your own pre- and post-processing. See the Rockchip RKNN guide for details. Spidrre
Hey! Did you notice any significant decrease in quality of your model after conversion? I am also trying to find a way to convert from OBB onnx to RKNN without 'reduce_reshape_op_around_concat'.
Hey! Did you notice any significant decrease in quality of your model after conversion? I am also trying to find a way to convert from OBB onnx to RKNN without 'reduce_reshape_op_around_concat'.
Hello, after @glenn-jocher answer, I didn't attempt to convert the OBB model. We have a few other models, and all of them except YOLO were converted to the RKNN format. We will try using this stuff (YOLO without an NPU and others with it) ^_^ After conversion, the OCR model, for example, has almost the same quality, but it doesn't need 'reduce_reshape_op_around_concat' to be used.