Exportar un modelo YOLO26 al formato de modelo TF.js#
Desde Ultralytics 8.4.83, se ha eliminado el formato de exportación tfjs (TensorFlow.js) y se ha sustituido por el formato unificado Google LiteRT. LiteRT se ejecuta en el navegador mediante LiteRT.js (con aceleración WebGPU), cubriendo los casos de uso en el navegador y Node.js que antes cubría TF.js, además de los usos en móviles, sistemas integrados y dispositivos edge, todo a partir de un único modelo .tflite.
format="tfjs" sigue funcionando, pero muestra un aviso de obsolescencia y exporta un modelo LiteRT. A partir de ahora, usa format="litert"; para consultar las instrucciones actuales de exportación y el método de despliegue en navegador, visita la guía de exportación de LiteRT.
Desplegar modelos de aprendizaje automático directamente en el navegador o en Node.js puede ser complicado. Tienes que asegurarte de que el formato del modelo esté optimizado para ofrecer un mayor rendimiento y que pueda ejecutar aplicaciones interactivas localmente en el dispositivo del usuario. El formato de modelo TensorFlow.js, o TF.js, está diseñado para consumir poca energía y ofrecer un rendimiento rápido.
La función «exportar al formato de modelo TF.js» permite optimizar tus modelos Ultralytics YOLO26 para realizar inferencias de detección de objetos de alta velocidad y en local. En esta guía te explicamos cómo convertir tus modelos al formato TF.js, para que funcionen mejor en distintos navegadores locales y aplicaciones Node.js.
¿Por qué exportar a TF.js?#
Exportar tus modelos de aprendizaje automático a TensorFlow.js, desarrollado por el equipo de TensorFlow como parte del ecosistema general de TensorFlow, ofrece numerosas ventajas para desplegar aplicaciones de aprendizaje automático. Ayuda a mejorar la privacidad y la seguridad de los usuarios al mantener los datos confidenciales en el dispositivo. La imagen siguiente muestra la arquitectura de TensorFlow.js y cómo se convierten y despliegan los modelos de aprendizaje automático en navegadores web y Node.js.
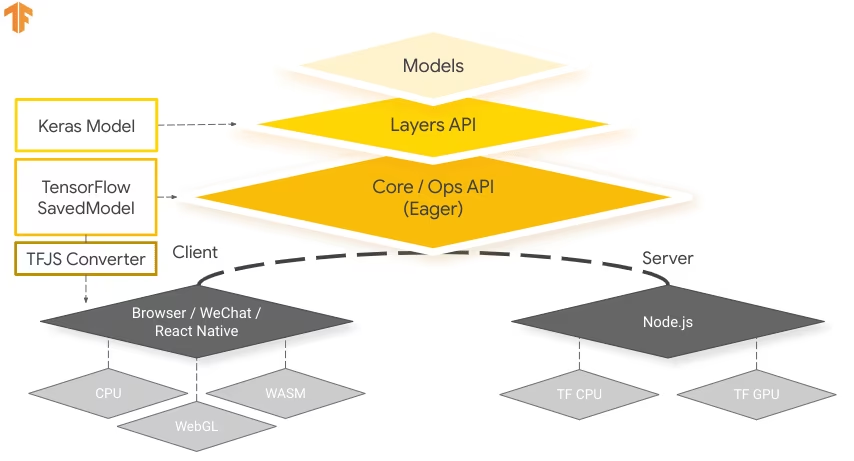
Ejecutar modelos localmente también reduce la latencia y ofrece una experiencia de usuario más ágil. TensorFlow.js también funciona sin conexión, lo que permite usar tu aplicación aunque no haya conexión a Internet. TF.js está diseñado para ejecutar modelos complejos de forma eficiente en dispositivos con recursos limitados y ofrecer escalabilidad, además de admitir aceleración de GPU.
Características principales de TF.js#
Estas son las principales características que hacen de TF.js una herramienta potente para desarrolladores:
-
Compatibilidad multiplataforma: TensorFlow.js se puede usar tanto en navegadores como en entornos Node.js, lo que ofrece flexibilidad para desplegarlo en distintas plataformas. Permite a los desarrolladores crear y desplegar aplicaciones con mayor facilidad.
-
Compatibilidad con varios backends: TensorFlow.js admite distintos backends de cálculo, como CPU, WebGL para la aceleración de GPU, WebAssembly (WASM) para una velocidad de ejecución casi nativa y WebGPU para capacidades avanzadas de aprendizaje automático en el navegador.
-
Funcionamiento sin conexión: Con TensorFlow.js, los modelos se pueden ejecutar en el navegador sin conexión a Internet, lo que permite desarrollar aplicaciones que funcionan sin conexión.
Opciones de despliegue con TensorFlow.js#
Antes de explicar cómo exportar modelos YOLO26 al formato TF.js, veamos algunos escenarios de despliegue habituales en los que se utiliza este formato.
TF.js ofrece distintas opciones para desplegar tus modelos de aprendizaje automático:
-
Aplicaciones de aprendizaje automático en el navegador: Puedes crear aplicaciones web que ejecuten modelos de aprendizaje automático directamente en el navegador. Así, se elimina la necesidad de realizar cálculos en el servidor y se reduce la carga del servidor.
-
Aplicaciones Node.js: TensorFlow.js también admite el despliegue en entornos Node.js, lo que permite desarrollar aplicaciones de aprendizaje automático en el servidor. Resulta especialmente útil para aplicaciones que necesitan la capacidad de procesamiento de un servidor o acceder a datos del servidor.
-
Extensiones de Chrome: Un escenario de despliegue interesante es crear extensiones de Chrome con TensorFlow.js. Por ejemplo, puedes desarrollar una extensión que permita a los usuarios hacer clic con el botón derecho en una imagen de cualquier página web para clasificarla con un modelo de aprendizaje automático preentrenado. TensorFlow.js se puede integrar en la navegación web diaria para ofrecer información inmediata o mejoras basadas en el aprendizaje automático.
Exportar modelos YOLO26 a TensorFlow.js#
Puedes ampliar la compatibilidad y flexibilidad de despliegue de los modelos convirtiendo los modelos YOLO26 a TF.js.
Instalación#
Para instalar el paquete necesario, ejecuta:
# Install the required package for YOLO26
pip install ultralytics
Para obtener instrucciones detalladas y buenas prácticas relacionadas con el proceso de instalación, consulta nuestra guía de instalación de Ultralytics. Si tienes dificultades al instalar los paquetes necesarios para YOLO26, consulta nuestra guía sobre problemas habituales, donde encontrarás soluciones y consejos.
Uso#
Todos los modelos Ultralytics YOLO26 están diseñados para admitir la exportación desde el primer momento, lo que facilita su integración en el flujo de trabajo de implementación que prefieras. Puedes consultar la lista completa de formatos de exportación y opciones de configuración compatibles para elegir la configuración más adecuada para tu aplicación.
El argumento tfjs ahora exporta un modelo .tflite de LiteRT, que admite los modos Export, Predict y Validate localmente, y se ejecuta en el navegador mediante LiteRT.js. Consulta la guía de exportación de LiteRT para conocer el método actual de despliegue en navegador y en el dispositivo.
from ultralytics import YOLO

# Carga un modelo YOLO26
model = YOLO("yolo26n.pt")

# Exportar el modelo al formato LiteRT (sustituye a TF.js)
model.export(format="litert", imgsz=640) # usa imgsz=224 para clasificaciónEl modelo LiteRT .tflite exportado se carga directamente con yolo predict y yolo val, y se ejecuta en el navegador mediante LiteRT.js. Consulta la guía de exportación de LiteRT.
Argumentos de exportación#
| Argumento | Tipo | Predeterminado | Descripción |
|---|---|---|---|
format | str | 'litert' | Formato de destino del modelo exportado; el valor obsoleto 'tfjs' exporta a LiteRT. |
imgsz | int o tuple | 640 | Tamaño de imagen deseado para la entrada del modelo. Puede ser un número entero para imágenes cuadradas o una tupla (height, width) para dimensiones específicas. |
quantize | int o str | None | Precisión de cuantización: 8 (INT8 estático, pesos int8 + activaciones int8; necesita datos de calibración data/fraction), 'w8a16' (estático, pesos int8 + activaciones int16; necesita datos de calibración data/fraction), 'w8a32' (INT8 dinámico, pesos int8 + activaciones FP32; no necesita calibración) o 32/sin especificar (FP32). FP16 no se exporta por separado: un modelo FP32 se ejecuta automáticamente en FP16 con delegados de GPU. Sustituye a las opciones obsoletas half/int8. |
batch | int | 1 | Especifica el tamaño del lote de inferencia del modelo exportado o el número máximo de imágenes que el modelo exportado procesará simultáneamente en el modo predict. |
data | str | None | Ruta al archivo YAML del conjunto de datos, imprescindible para la cuantización; en clasificación se utiliza una carpeta de conjunto de datos o el nombre de uno integrado. Si se omite con quantize=8 o 'w8a16', Ultralytics selecciona el conjunto de datos de calibración predeterminado para la tarea del modelo. |
fraction | float, int o list | 1.0 | Subconjunto de calibración expresado como proporción, número de imágenes o proporciones/recuentos [train, val, test]. Las listas de dos elementos dejan completo test, mientras que 0 lo omite. |
device | str | None | Especifica el dispositivo para la exportación: CPU (device=cpu) o MPS para Apple silicon (device=mps). |
Para obtener más información sobre el proceso de exportación, visita la página de documentación de Ultralytics sobre exportación.
Desplegar modelos YOLO26 TensorFlow.js exportados#
Ahora que has exportado tu modelo YOLO26, el siguiente paso es desplegarlo. La exportación genera un modelo .tflite de LiteRT que se ejecuta en el dispositivo y en el navegador mediante LiteRT.js. Consulta la guía de exportación de LiteRT para conocer el método actual.
Como referencia, a continuación se muestran los recursos del entorno de ejecución heredado de TensorFlow.js:
-
Extensión de Chrome: Consulta la documentación para desarrolladores sobre cómo desplegar tus modelos TF.js en una extensión de Chrome.
-
Ejecutar TensorFlow.js en Node.js: Una entrada del blog de TensorFlow sobre cómo ejecutar TensorFlow.js directamente en Node.js.
-
Desplegar TensorFlow.js: proyecto Node en una plataforma en la nube: Una entrada del blog de TensorFlow sobre cómo desplegar un modelo TensorFlow.js en una plataforma en la nube.
Resumen#
En esta guía, hemos aprendido a exportar modelos Ultralytics YOLO26 al formato TensorFlow.js. Al exportar a TF.js, obtienes la flexibilidad de optimizar, desplegar y escalar tus modelos YOLO26 en una amplia variedad de plataformas.
Para obtener más información sobre el uso, visita la documentación oficial de TensorFlow.js.
Para obtener más información sobre la integración de Ultralytics YOLO26 con otras plataformas y frameworks, no olvides consultar nuestra página de guías de integración. Incluye recursos muy útiles para sacar el máximo partido a YOLO26 en tus proyectos.
Preguntas frecuentes#
Exportar modelos Ultralytics YOLO26 al formato TensorFlow.js (TF.js) es muy sencillo. Sigue estos pasos:
Usofrom ultralytics import YOLO # Carga un modelo YOLO26 model = YOLO("yolo26n.pt") # Exportar el modelo al formato LiteRT (sustituye a TF.js) model.export(format="litert", imgsz=640) # usa imgsz=224 para clasificación # El modelo '.tflite' exportado se ejecuta en el navegador mediante LiteRT.js o localmente con yolo predict/val.Para obtener más información sobre las opciones de exportación admitidas, visita la página de documentación de Ultralytics sobre las opciones de despliegue.
Exportar modelos YOLO26 a TensorFlow.js ofrece varias ventajas, entre ellas:
- Ejecución local: Los modelos se pueden ejecutar directamente en el navegador o en Node.js, lo que reduce la latencia y mejora la experiencia del usuario.
- Compatibilidad multiplataforma: TF.js admite varios entornos, lo que ofrece flexibilidad para el despliegue.
- Funcionamiento sin conexión: Permite que las aplicaciones funcionen sin conexión a Internet, lo que garantiza su fiabilidad y privacidad.
- Aceleración de GPU: Aprovecha WebGL para acelerar la GPU y optimizar el rendimiento en dispositivos con recursos limitados.
TensorFlow.js está diseñado específicamente para ejecutar modelos de aprendizaje automático de forma eficiente en navegadores y entornos Node.js. Estas son sus ventajas para las aplicaciones basadas en navegador:
- Reduce la latencia: Ejecuta modelos de aprendizaje automático localmente y ofrece resultados inmediatos sin depender de cálculos en el servidor.
- Mejora la privacidad: Mantiene los datos confidenciales en el dispositivo del usuario y reduce al mínimo los riesgos de seguridad.
- Permite trabajar sin conexión: Los modelos pueden funcionar sin conexión a Internet, lo que garantiza un funcionamiento constante.
- Admite varios backends: Ofrece flexibilidad con backends como CPU, WebGL, WebAssembly (WASM) y WebGPU para distintas necesidades de cálculo.
¿Quieres saber más sobre TF.js? Consulta la guía oficial de TensorFlow.js.
Estas son las principales características de TensorFlow.js:
- Compatibilidad multiplataforma: TF.js se puede usar tanto en navegadores web como en Node.js, lo que ofrece una gran flexibilidad de despliegue.
- Varios backends: Admite CPU, WebGL para la aceleración de GPU, WebAssembly (WASM) y WebGPU para operaciones avanzadas.
- Funcionamiento sin conexión: Los modelos se pueden ejecutar directamente en el navegador sin conexión a Internet, por lo que es ideal para desarrollar aplicaciones web ágiles.
Para conocer los escenarios de despliegue y obtener información más detallada, consulta nuestra sección sobre opciones de despliegue con TensorFlow.js.
Sí, TensorFlow.js permite desplegar modelos YOLO26 en entornos Node.js. Esto permite crear aplicaciones de aprendizaje automático del lado del servidor que aprovechan su capacidad de procesamiento y acceden a datos del servidor. Entre los casos de uso habituales se incluyen el procesamiento de datos en tiempo real y las canalizaciones de aprendizaje automático en servidores backend.
Para empezar a desplegar en Node.js, consulta la guía de TensorFlow Ejecutar TensorFlow.js en Node.js.